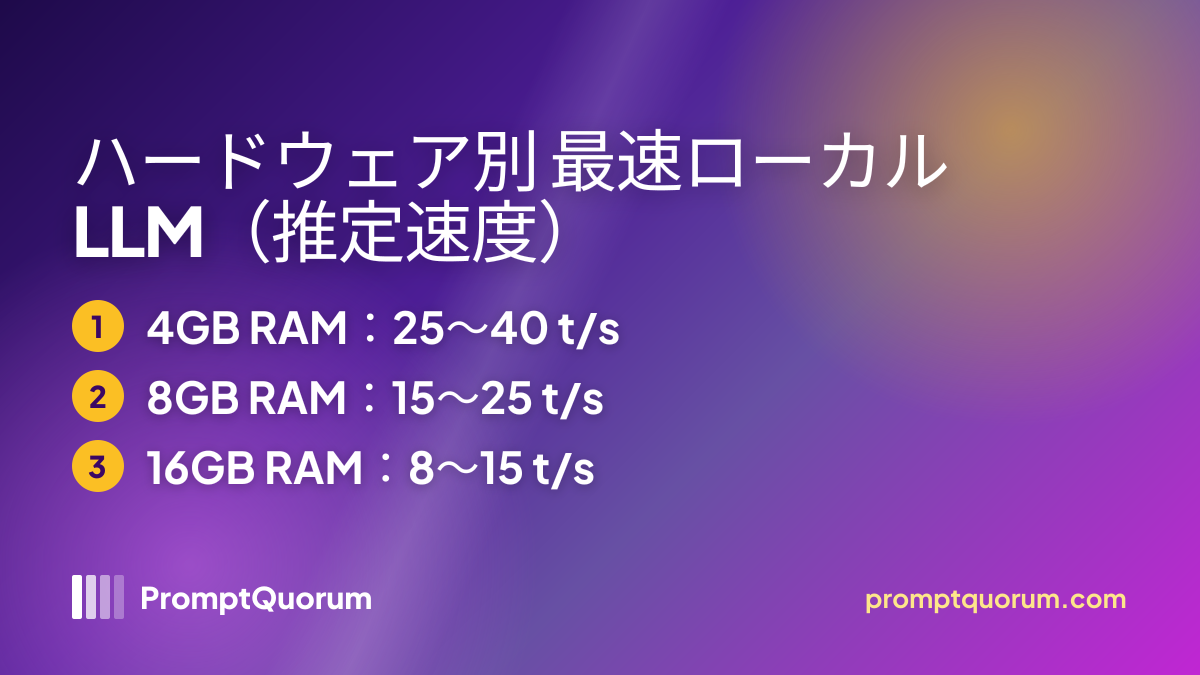
あなたのハードウェアに最速のモデルは?
ハードウェアに合ったモデルを選択してください — 誤った選択で4〜10倍の速度を無駄にします。以下の階層は特記なき限りすべてCPU専用です。速度はデュアルチャネルRAMを前提としたPromptQuorumの推定値であり、実験室での測定値ではありません。シングルチャネルRAMや古いDDR4ノートPCではこれより低くなります。
お使いのハードウェア | 推奨モデル | Ollamaコマンド | 期待速度 |
|---|---|---|---|
| RAM 4 GB、CPU専用 | Qwen3 1.7B Q4_K_M | ollama run qwen3:1.7b | 25〜40トークン/秒 |
| RAM 8 GB、CPU専用 | Phi-4-mini 3.8B Q4_K_M | ollama run phi4-mini | 15〜25トークン/秒 |
| RAM 8 GB + Intel Iris iGPU | Qwen3 4B Q4_K_M | ollama run qwen3:4b | 12〜20トークン/秒 |
| RAM 16 GB、CPU専用 | Qwen3 8B Q4_K_M | ollama run qwen3:8b | 8〜15トークン/秒 |
| RAM 16 GB + iGPU | Llama 3.2 3B Q4_K_M | ollama run llama3.2:3b | 20〜35トークン/秒 |
どのモデルを使うべきか?
あなたの状況に合ったモデルを選びましょう — これが最も重要な決定です:
- RAM 8 GBのノートPC(専用GPUなし): Phi-4-mini(3.8B)Q4_K_M — 15〜25トークン/秒、コーディングと推論に対応。`ollama run phi4-mini`
- RAM 4 GB、非常に古いPC: Qwen3 1.7B Q4_K_M — 25〜40トークン/秒、最小RAMで最速の応答。`ollama run qwen3:1.7b`
- RAM 16 GB、GPUなし: Qwen3 8B Q4_K_M — 8〜15トークン/秒、高い品質。`ollama run qwen3:8b`
- RAM 8 GB + Intel Iris iGPU: Qwen3 4B — OllamaがiGPUを使う場合、推定12〜20トークン/秒(`ollama ps`を実行してPROCESSOR列を確認)。`ollama run qwen3:4b`
- 長いコンテキストが欲しい: Qwen3 4B(Ollamaで256Kコンテキスト)またはLlama 3.2 3B(128K)。Qwen3 1.7Bと8Bは40Kと表記されています。
- 新世代で最小のファイル: Qwen3.5 0.8B(Ollamaで1.2 GB)はQwen3 1.7B(1.4 GB)より小さいため、同じCPUでは品質が下がる代わりに高速に動作するはずです。Qwen3.5 2B(2.7 GB)と4B(3.3 GB)はPhi-4-mini(2.5 GB)やQwen3 4B(2.5 GB)よりファイルが大きいため、より低速になると見込まれます。`ollama run qwen3.5:0.8b`。PromptQuorumは、このガイドのハードウェアでQwen3.5の速度を計測していません。
- RAM 8 GBで試す価値もあり: Gemma 4 E2B(Google、2026年4月リリース)。実効パラメータは約23億ですが、埋め込みテーブルのためOllamaのダウンロードは4.6 GBから始まり、1.5〜2 GBのモデルではありません。`ollama run gemma4:e2b`。メモリ種別ごとの推定速度はCPU専用モデルガイドを参照。
- RAM階層別の推奨と発熱対策については ノートPCでローカルLLMを実行する方法を参照。
ハードウェア別おすすめローカルLLM
以下の階層はすべてCPU専用またはiGPUです。Q4_K_Mでお使いのRAMに収まり、OSとコンテキスト用の余裕を残せる最大のモデルを選んでください。速度は推定値です。
Hardware | Model | Quant | Speed | Experience |
|---|---|---|---|---|
| RAM 4 GB、CPU専用 | Qwen3 1.7B | Q4_K_M | 25〜40 t/s | 高速、使える品質 |
| RAM 8 GB、CPU専用 | Phi-4-mini 3.8B | Q4_K_M | 15〜25 t/s | コーディング+推論 |
| RAM 8 GB + iGPU Iris | Qwen3 4B | Q4_K_M | 12〜20 t/s | iGPU使用時 |
| RAM 16 GB、CPU専用 | Qwen3 8B | Q4_K_M | 8〜15 t/s | 高い品質 |
| RAM 16 GB + iGPU | Llama 3.2 3B | Q4_K_M | 20〜35 t/s | iGPU使用時 |

GPU vs CPU:低スペックハードウェアでどちらが速い?
専用GPU: 同じモデルでCPU専用の通常5〜10倍高速です。VRAMはシステムRAMよりメモリ帯域幅がはるかに大きいためです。中古のRTX 4060 8 GB(価格は変動)は一般的な予算アップグレードです。費用対効果の高い選択肢はバジェットGPUガイドを参照。
iGPU(統合グラフィックス): CPUとシステムRAMを共有するため、主なボトルネックであるメモリ帯域幅は変わりません。効果は通常わずかで、ドライバの対応状況に左右されます。Ollamaのドキュメントによると、WindowsとLinuxでのVulkan GPUサポートはバックエンドがインストールされていればデフォルトで有効で、AMD Ryzen AIのiGPUはROCmの項目に記載されています。Intel統合GPUはサポート表に記載されていません。`ollama ps`を確認してください。PROCESSOR列に、モデルがCPU、GPU、またはその分割のどれで動いているかが表示されます。
CPU専用: ドライバ設定なしでどのPCでも動作します。速度はおおよそメモリ帯域幅 ÷ モデルのファイルサイズで決まるため、CPUクロックよりもデュアルチャネルRAMと小さなQ4_K_Mファイルのほうが重要です。
ルール: 専用GPUがあれば使用してください。なければ、同じプロンプトをiGPUありとなしで実行し(`OLLAMA_VULKAN=0`でVulkan GPUをオフにできます)、速いほうを採用します。

低スペックPCで小型モデルが速い理由
モデルサイズが速度を直接決定します。 1B〜3Bモデルはシステムメモリに完全に収まるため、CPUまたはGPUがデータを継続的にストリーミングできます。大型モデルはメモリスワッピングが必要 — RAMとディスク間でデータを移動することで生成速度が大幅に低下します(ボトルネックはディスクI/Oであり、計算ではない)。
上記のハードウェア判定テーブルはこの原則を反映しています:最も小さいファイルが最高速度を出し、スワッピングが支配的になるため13B+モデルは低スペックハードウェアには実用的ではありません。
- 1B〜3Bモデル: 4〜8GB RAMに収まる → 最速生成 → 品質許容範囲
- 7Bモデル: 8GBシステムでギリギリ → メモリプレッシャーで低速 → 高品質
- 13B+モデル: 16GB+のRAMが必要、またはスワップが多発 → 低スペックPCでのインタラクティブ使用には遅すぎる
低スペックPCでローカルLLMはどのくらい速い?
CPU専用システムでの推定速度の目安:
- 3Bモデル → 15〜40トークン/秒(旧CPU:10〜15、新しいデュアルチャネルDDR5システム:30〜40)
- 7B〜8Bモデル → 8〜15トークン/秒(デュアルチャネルRAMのQ4_K_M;シングルチャネルRAMではこれより低くなります)
- 割り算ひとつで自分の速度を見積もれます。 トークンを1つ生成するたびにモデル全体をRAMから1回読み出す必要があるため、1秒あたりのトークン数はメモリ帯域幅 ÷ モデルのファイルサイズを超えられません。ピーク帯域幅 = 転送レート(MT/s)× 8バイト × チャネル数です。
- 計算例(予測ではなく上限値):デュアルチャネルDDR4-3200では3200 × 8 × 2 = 51.2 GB/s、これを2.5 GBのPhi-4-miniのファイルで割ると最大で約20トークン/秒。デュアルチャネルDDR5-5600では89.6 GB/sで、同じファイルなら最大で約36トークン/秒。シングルチャネルDDR4-3200のノートPCでは25.6 GB/sで、最大で約10トークン/秒。実際の速度は上限値より低くなります。
- Intel N100のミニPCはメモリチャネルが1つです(Intelの仕様:DDR4-3200、DDR5-4800、LPDDR5-4800)。DDR4-3200では、1.4 GBのQwen3 1.7Bファイルの上限は約18トークン/秒、DDR5-4800では約27トークン/秒です。N100は本ガイドのデュアルチャネルの範囲を下回ると考えてください。
- クラウドのチャットボットより低速ですが、インタラクティブ使用には十分です。 25トークン/秒の3Bモデルは500トークンのレスポンスを20秒で生成 — コードレビュー、要約、創作など時間に余裕のあるタスクに許容範囲。
量子化は低スペックPCの速度にどう影響する?
Q4(4ビット): 標準的な選択肢です。16ビット版のファイルサイズの約4分の1で、ほとんどのタスクで品質低下は小さく抑えられます。全量子化レベルの詳細はガイドを参照。
Q3(3ビット): Q4よりファイルが小さく、品質低下は大きくなります。Q4がRAMに収まらない場合のチャット用途なら許容範囲です。
Q2(2ビット): 最小のファイルサイズですが、品質低下も最大です。リスクあり;Q4とQ3でメモリ不足になる場合のみ使用。
速度への影響: CPUのデコード速度はメモリ帯域幅で制限されるため、ファイルが小さいほどほぼその比率で高速に生成できます。Q3とQ2のファイルはQ4より高速ですが、これほど小さいモデルでは品質低下に見合わないことが多いです。
戦略:まずモデルサイズを決め、そのうえでQ4_K_Mを使います。小型モデルのQ4_K_Mは、Q2まで圧縮した大型モデルより良い結果になることが多く、後者は精度が落ちるうえにRAMも多く必要です。
高速モデルは品質と引き換えに速度を得ていますが、温度とtop-pを調整することで多くの品質を回復できます。高速モデルに低い温度(0.1~0.3)を設定することで、デフォルト設定より一貫性のある出力が得られます。温度とtop-pについてで正確な設定を確認してください。

CPU専用推論を高速化する方法
- 両方のメモリチャネルを埋める: 同じ規格のRAMを2枚挿すと、1枚の場合に比べてピークのメモリ帯域幅が2倍になり、CPU専用PCで最も大きな高速化になります。RAMが1枚のノートPCやミニPCは、上限が半分になります。
- コンテキストウィンドウを縮小: KVキャッシュはコンテキスト長に応じて大きくなります。`OLLAMA_CONTEXT_LENGTH=2048`を設定するか(Ollamaのデフォルトは4096)、`ollama run`の中で`/set parameter num_ctx 2048`を実行します。
- KVキャッシュを量子化: `OLLAMA_FLASH_ATTENTION=1`と`OLLAMA_KV_CACHE_TYPE=q8_0`を併用すると、デフォルトのf16に比べてKVキャッシュのメモリがおよそ半分になり、RAM 4 GBや8 GBのマシンで特に効果があります。
- モデルをロードしたままにする: Ollamaはデフォルトで5分後にモデルをアンロードします。`OLLAMA_KEEP_ALIVE=30m`を設定すると、セッションのたびにファイルを読み込み直さずに済みます。
- メモリを多く使うアプリを閉じる: タブを多く開いたブラウザはモデルをスワップに追い出し、生成が何倍も遅くなります。
- iGPUを試す: モデルをロードした状態で`ollama ps`を実行します。PROCESSORが100% CPUなら、GPUで動かした場合と比較してください。iGPUが不安定な場合は`OLLAMA_VULKAN=0`を設定します。
RAM 2 GBでローカルRAGは動かせる?
はい、小規模な文書セットなら可能です。回答用のQwen3 0.6B(Ollamaで523 MB)と、検索用の埋め込みモデルnomic-embed-text(274 MB)を合わせても、モデルファイルは約0.8 GBです。 RAM 2 GBが実際に空いていれば収まります。たとえば軽量なLinux環境、古いネットブック、他のアプリを閉じたPCです。深い推論ではなく、文書から引き出した単純な回答を想定してください。
- チャットモデル: `ollama pull qwen3:0.6b`(523 MB、Ollamaで40Kコンテキスト)。空きRAMにもう少し余裕があれば、新世代の小型モデル`qwen3.5:0.8b`(1.2 GB)も選べます。
- 埋め込みモデル: `ollama pull nomic-embed-text`(274 MB、2Kコンテキストウィンドウ)。各チャンクが2Kウィンドウに収まるよう、文書は数百トークンずつのチャンクに分割します。
- 取得するチャンクは少なく: 一致した上位2〜3チャンクだけをチャットモデルに渡します。チャンクが増えるほどコンテキストが長くなり、KVキャッシュも大きくなります。
- コンテキストは短く: `OLLAMA_CONTEXT_LENGTH=2048`を設定して、KVキャッシュを小さく保ちます。
- 回答を確認する: 0.6Bモデルは取得した文章から事実を拾い出すのは得意ですが、複数段階の推論は苦手です。重要な回答は元の文章と照合してください。
- RAM 2 GBでは足りないとき: RAM 4 GBならQwen3 1.7B(1.4 GB)、RAM 8 GBならPhi-4-miniに上げ、埋め込みモデルは同じものを使い続けます。
これらのモデルはどのくらい速い?推定速度
ハードウェアクラス別の推定速度であり、実験室での測定値ではありません。この範囲はPromptQuorum独自の概算で、各クラスのメモリ帯域幅の上限から導いたものです。Ollamaのデフォルト設定とQ4_K_Mファイルが前提です。正常な環境での上限値と考えてください。実際のトークン/秒は、ご自身の`ollama run <model> --verbose`の出力で確認できます:
- Intel N100ミニPC(シングルチャネルRAM、RAM 4 GB階層)+ Qwen3 1.7B Q4_K_M:DDR4-3200で最大約18トークン/秒、DDR5-4800で約27トークン/秒(帯域幅の上限値)。`ollama run qwen3:1.7b`
- デュアルチャネルの最新i5/Ryzen 5(RAM 4 GB階層)+ Qwen3 1.7B Q4_K_M:推定25〜40トークン/秒。`ollama run qwen3:1.7b`
- Core i5-1235U級のノートPC(RAM 8 GB)+ Phi-4-mini Q4_K_M:LPDDR5で推定15〜22トークン/秒。DDR4のノートPCはこれより低くなります。`ollama run phi4-mini`
- Ryzen 5 5600G級のデスクトップ(RAM 8 GB)+ Qwen3 4B Q4_K_M:推定15〜20トークン/秒(デュアルチャネルDDR4-3200の上限は約20)。iGPUも同じRAM帯域幅を共有するため、それ以上は期待しないでください。
- Intel Iris Xe級のノートPC(RAM 8 GB)+ Qwen3 4B Q4_K_M:推定12〜18トークン/秒。`ollama run qwen3:4b`
- Ryzen 7 7700X級のデスクトップ(RAM 16 GB、デュアルチャネルDDR5)+ Qwen3 8B Q4_K_M:推定8〜13トークン/秒。`ollama run qwen3:8b`
- Iris Xe級のノートPC(RAM 16 GB)+ Llama 3.2 3B Q4_K_M:推定20〜30トークン/秒。`ollama run llama3.2:3b`
ローカルLLMで実際に「速い」とは?
速度の感じ方はタスクによって異なります — 次を参考にしてください:
モデルが15トークン/秒を下回る場合は、新しいハードウェアを購入する前にモデルサイズを縮小(7B → 3B)するか、量子化レベルを一段下げてください(Q5 → Q4)。
- 10トークン/秒未満 → 壊れているように感じる。 単語が一つずつ、目立つ間隔をあけて表示されます。インタラクティブなチャットには使用不可。
- 15〜25トークン/秒 → 許容範囲。 ほとんどのユーザーにとって読みやすい速度。Q&A、要約、コーディング支援に適しています。
- 30トークン/秒以上 → スムーズ。 本物のアシスタントのように感じられます。すべてのインタラクティブなタスクに快適。
- 60トークン/秒以上 → 瞬時。 読むより速い。リアルタイムのオートコンプリートや高速なイテレーションに最適。

低スペックPCで避けること
- 13B+モデルは実行しない — RAMの限界を超えます。 Q4の13Bモデルはファイルだけで約8 GBが必要で、OSの分を考えるとRAM 8 GBのPCには収まりません。RAM 16 GBなら8B以下、RAM 8 GBなら4B以下にとどめてください。
- Q8量子化は避ける — 品質向上が最小限で遅い。 Q8はQ4のおよそ2倍のファイルサイズになり、帯域幅が制限要因のCPUではファイルが大きいほど1秒あたりのトークン数が減ります。4GBシステムではQ8は非実用的;8GBシステムではQ4が最適。Q4でメモリ不足になる場合のみQ3を検討。
- リアルタイムオートコンプリートは期待しない。 CPU上の3トークン/秒では50トークン生成に約17秒かかります。インタラクティブなオートコンプリートにははるかに高い速度が必要です。低スペックCPU上のローカルLLMはバッチチャット、下書き、レビューに適しています — ライブオートコンプリートやコードタイプには不向きです。
- CPU専用推論を本番チャットボットに使用しない。 内部ツール、プロトタイプ、オフラインバッチ作業には許容範囲。低スペックCPUは低速で一度に1人のユーザーしか処理できませんが、ホスト型APIは多数のユーザーに対応できます。プライバシー重視またはオフラインシナリオにはローカル推論が適していますが、速度重視には不向きです。
よくある間違い
- 間違い:RAMを1枚だけで使う。 問題:メモリチャネルが1つだとピーク帯域幅が半分になり、同じモデルでも生成速度がおよそ半分になります。解決策:より速いCPUを買う前に、同じ規格のRAMを2枚挿す(またはデュアルチャネルのミニPCを選ぶ)。
- 間違い:CPUのモデル名だけで速度を判断する。 問題:トークン生成はメモリ帯域幅に制限されるため、新しいCPUでも低速なシングルチャネルDDR4では、古いCPUのデュアルチャネルDDR5より遅くなることがあります。解決策:RAMの速度とチャネル数を比較し、実際の値は`ollama run <model> --verbose`で確認。
- 間違い:7Bを4GBに収めるためにQ2を強制。 問題:Q2量子化は推論中のKVキャッシュオーバーヘッドによりOOMクラッシュを起こしやすく、出力品質も大きく低下します。解決策:代わりにQ4の3Bモデルを使用。
- 間違い:コンテキストウィンドウを大きいままにする。 問題:長いコンテキストはKVキャッシュを大きくし、小型マシンをスワップに追い込みます。解決策:長い文書が必要でない限り`OLLAMA_CONTEXT_LENGTH=2048`を設定。
- 間違い:モデルに誤ったOllama slugを使用。 問題:`ollama run phi`はPhi-4-miniではなくPhi-2をロードします。解決策:現行のPhi miniモデルには`ollama run phi4-mini`を使用。常にollama.com/libraryで正確なモデルタグを確認してください。
低スペックPCのローカルLLM:地域別コンテキスト
日本(METI AIガバナンス): 経済産業省(METI)などが公表する日本のAI事業者向けガイドラインは、データの責任ある取り扱いを重視しています。低スペックハードウェアでのCPU推論は低速ですが、プロンプトが端末内にとどまります。モデルをダウンロードした後は、推論自体にAPIコールは必要ありません。日本語タスクで上記の範囲のCPU速度でQwen3を動かす場合、1文あたり数秒の応答は、時間に余裕のある文書要約であれば許容範囲です。
EU / GDPR: 低スペックハードウェアでのローカル実行では、オフライン時は推論データが端末を離れません — 多くの中小企業やフリーランサーにとって、GDPR第44条の移転リスクを回避する技術的にシンプルな方法です。EU AI法やその他の義務が利用に適用されるかどうかは、システムを誰がどのような目的で導入するかによって異なります。本ガイドは法的助言ではありません。文書を端末内にとどめれば第三者の処理者に送信せずに済みますが、データ保護の全体的なコンプライアンスは推論アーキテクチャだけでなく、運用全体に依存します。
中国: Qwen3やDeepSeek-R1蒸留モデルを消費者向けハードウェアでローカル推論することは、非中国製のクラウドAPIにアクセスできない中国のユーザーにとって選択肢の一つです。Qwen3 0.6B、1.7B、4BはCPU専用ハードウェアで動作し、ハードウェアが限られたユーザーにクラウドAPIの実用的な代替手段を提供します。
低スペックPCでのローカルLLM実行に関するよくある質問
低スペックPCでのローカルLLMとは何ですか?
低スペックPCでのローカルLLMとは、専用GPUのないCPU専用マシンで、システムRAMが4〜16 GBのものです。Intel IrisやAMD Radeon統合グラフィックスを搭載するほとんどのノートPC、専用GPUのない古いデスクトップPC、Intel N100などのミニPCが該当します。重要な制約はCPU速度ではなく、モデルの重みを保持するためのシステムRAMです。
GPUなしで7Bクラスのモデルを実行できますか?
はい — Qwen3 8B(Q4_K_M)はRAM 16 GB、CPU専用で推定8〜15トークン/秒で動作します(デュアルチャネルのRyzen 7 7700X級デスクトップでの推定値)。より小さいモデルより遅いですが、品質は明らかに優れています。RAM 8 GBの場合はPhi-4-mini(3.8B)を使用してください — 8Bモデル(Q4_K_M)は8 GBシステムでは確実に確保できない余裕を必要とします。
CPU推論はチャットボットに使用できますか?
はい、適切なモデルサイズを選べばインタラクティブ用途にも使えます。Phi-4-mini(15〜25トークン/秒、RAM 8 GB)とQwen3 1.7B(25〜40トークン/秒、RAM 4 GB)はどちらもリアルタイムチャットに十分な速度です。CPU上の7Bクラスモデル(8〜15トークン/秒)はライブの会話よりも、下書き、要約、オフラインレビューなどのバッチタスクに向いています。
CPU専用ハードウェアではPhi-4-miniとQwen3 1.7Bのどちらを使うべきですか?
RAM 8 GBがあればPhi-4-mini(3.8B)を使用 — コーディングと推論を15〜25トークン/秒で処理します。RAM 4 GBしかない、または最速の応答(25〜40トークン/秒)を優先する場合はQwen3 1.7Bを使用 — ただし複雑なタスクでは品質が多少犠牲になります。
GPUがあるかどうかはどう確認しますか?
NVIDIA専用GPUの場合はターミナルで`nvidia-smi`を実行。「command not found」が返る場合は、`lspci`(Linux)またはデバイスマネージャー(Windows)でIntel Iris XeまたはAMD RadeonのiGPUを確認してください — OllamaがiGPUを使えるかどうかはドライバーとバックエンドの対応状況によるため、`ollama ps`で確認してください。
量子化は推論速度にどう影響しますか?
量子化は主に計算ではなくメモリ帯域幅要件を削減します。Q2(2ビット)のファイルはQ4(4ビット)より小さいため、CPUがトークンごとに読み出すバイト数が減り、ファイルサイズにほぼ比例して高速に生成できます。ただしQ2は出力品質の低下がはるかに大きくなります。実用的なルール:本ガイドのすべての階層でデフォルトはQ4_K_M、RAMに収まらない場合のみQ3に切り替え。
Q2以下の量子化は可能ですか?
技術的には可能です(llama.cppには1ビットのIQ1形式があります)が、そのサイズでは出力品質が崩壊します。本ガイドのRAM 4GB階層を含め、実用的なユースケースには推奨しません — 代わりにQ4_K_Mのより小さいモデルを選んでください。
CPU + iGPUハイブリッド推論はサポートされていますか?
場合によります。OllamaはサポートされるGPUバックエンドを見つけると、モデルをCPUとGPUに分割できます。分割の状況は`ollama ps`のPROCESSOR列で確認できます。iGPUはCPUとシステムRAMを共有するため、主な速度の制約であるメモリ帯域幅は増えません。Intel Iris Xe iGPU搭載のRAM 8GBシステムでは、iGPUが使われる場合のQwen3 4Bは推定12〜20トークン/秒です。`OLLAMA_VULKAN=0`でテストして、CPU専用と比較してください。
低スペックPC向け最速のローカルLLMは何ですか?
Qwen3 1.7B(Q4_K_M)は本ガイドのティア別推奨モデルの中で最速です(Qwen3 0.6Bのようなさらに小さいモデルはより高速ですが、品質は大きく下がります)— 最新のi5/Ryzen 5、RAM 4 GB、GPUなしで推定25〜40トークン/秒。同程度の速度でより高い品質が欲しい場合は、Phi-4-mini(3.8B)がRAM 8 GBで15〜25トークン/秒、コーディングと推論をより優れて処理します。
4GBのRAMでローカルLLMを実行できますか?
はい — Qwen3 1.7B(Q4_K_M)はRAM 4 GB・CPU専用向けの推奨モデルで、最新のi5/Ryzen 5で25〜40トークン/秒に到達します。本ガイドのティア別推奨モデルの中で最速であり、OS用の余裕を残して収まります。
速度にGPUは必要ですか?
いいえ — 本ガイドのすべてのモデルはCPU専用で動作します。Intel Iris iGPUはわずかな速度向上をもたらす場合があります(Qwen3 4B:iGPUが使われる場合は推定12〜20トークン/秒)が、あくまでオプションで、ドライバの対応状況に左右されます。中古のRTX 4060 8GBなどの専用GPUは、同じモデルでCPU専用の通常5〜10倍高速ですが、これは別のアップグレード経路であり、必須ではありません。
Intel Iris iGPUはローカルLLMに十分ですか?
役立つ場合はありますが、保証はされません。RAM 8 GBとIntel Iris Xe iGPUの場合、Ollamaが実際にiGPUを使うなら、Qwen3 4Bは推定12〜20トークン/秒です。RAM 16 GBでは、Llama 3.2 3Bが推定20〜35トークン/秒です。iGPUはCPUとシステムRAMを共有するため、効果は通常わずかです。同じプロンプトをiGPUありとなしで実行し、速いほうの設定を採用してください。
低スペックハードウェアではQ2とQ4のどちらの量子化を使うべきですか?
まずQ4_K_Mから始めてください — 本ガイドのすべてのモデル階層(1.7B〜8B)に収まり、品質低下は小さく抑えられます。Q4_K_Mでメモリ不足エラーが発生する場合のみQ3またはQ2に下げてください。Q2のファイルは小さいぶん高速ですが、品質低下は推論やコーディングタスクで顕著です。
WindowsでRAMの空き容量を確認する方法は?
タスクマネージャー → パフォーマンス → メモリを開きます。表示される合計がシステムRAMです — 上記のハードウェア判定テーブル(4GB、8GB、16GBの各階層)と比較して正しいモデルを選んでください。
Ollamaは統合GPUを自動的に使用しますか?
対応するバックエンドがある場合のみです。Ollamaのドキュメントによると、WindowsとLinuxでのVulkan GPUサポートはバックエンドがインストールされていればデフォルトで有効で、AMD Ryzen AIのiGPUはROCmの項目に記載されています。Intel統合GPUはサポート表に記載されていません。モデルをロードした後に`ollama ps`で確認すると、PROCESSOR列に100% CPU、100% GPU、またはその分割が表示されます。`OLLAMA_VULKAN=0`を設定するとVulkan GPUをオフにできます。
低スペックPCでのChatGPTの最良の無料代替は何ですか?
RAM 8 GB、CPU専用のOllamaでPhi-4-mini(3.8B、Q4_K_M)を使うと15〜25トークン/秒 — チャット、要約、コーディング支援に十分です。品質はフロンティアクラウドモデルより劣りますが、日常的なタスクには十分です。完全無料でオフライン動作、APIキー不要です。
ローカルLLMで専用GPUはCPUよりどれくらい速いですか?
同じモデルで通常5〜10倍速いです。中古のRTX 4060 8GB(価格は変動)は、本ガイドで扱うCPU専用構成を通常上回ります。Intel Iris iGPUは、よくてもその中間です — 例えばQwen3 4Bは、iGPUが使われる場合は推定12〜20トークン/秒で、最も近いCPU専用の比較階層では推定8〜15トークン/秒です。
ローカルAIモデルとローカルLLMは同じものですか?
本ガイドでは同じ意味で使っています。「ローカルAIモデル」は、業界がローカルLLM(大規模言語モデル)と呼ぶもの — 一度ダウンロードして自分のマシン上でオフラインで実行するテキスト生成の重み — を指す日常的な言い方です。この区別が重要になるのは、AIモデルがテキストベースでない場合のみです。Stable Diffusionのような画像生成モデルやWhisperのような音声モデルもローカルで動作しますが、ハードウェア要件が異なり、本ガイドのトークン/秒の数値はいずれも当てはまりません。
実用的な文章を書ける最も軽量なローカルLLMは何ですか?
Q4_K_MのQwen3 1.7Bが、本ガイドで使う価値のある最軽量モデルです — Ollamaではディスク上で1.4GB、4GBのRAMで動作し、CPU専用で推定25〜40トークン/秒。さらに小さい選択肢(TinyLlama 1.1B、Qwen3 0.6B)も存在し速度はより速いですが、出力品質が大きく落ちるため、文章作成アシスタントというよりオートコンプリートとして扱う方が適切です。おおよそ10億パラメータを下回ると、軽量モデルは長文で安定した一貫性のあるテキストを生成できません。
Gemma 4 E2BはローエンドPCでQwen3 1.7Bより速いですか?
RAM 4 GBのマシンではおそらく速くありません。Gemma 4 E2B(Google、2026年4月リリース)の実効パラメータは約23億ですが、埋め込みテーブルのためOllamaのダウンロードは4.6 GBから始まり、帯域幅が制限要因のCPUではファイルが大きいほど1秒あたりのトークン数が減ります。RAM 8 GBまたは16 GBのシステムのほうが適しています。CPU専用モデルガイドでは、デュアルチャネルRAMで推定8~14トークン/秒としています。最も低消費電力のハードウェアでは、引き続きQwen3 1.7B(1.4 GB)が本ガイドの速度重視の選択肢です。RAM 8 GB以上であれば、比較のために`ollama run gemma4:e2b`を試してください。
ローカルLLMが低スペックPCでとても遅いのはなぜですか?
よくある原因はCPUの速度ではなくメモリ帯域幅です。トークンを1つ生成するたびにモデルファイル全体をRAMから読み出すため、速度はメモリ帯域幅をファイルサイズで割った値が上限になります。次の4点を確認してください。RAMが1枚だけ(1チャネルだと上限が半分になります)、空きRAMに対してモデルファイルが大きすぎる(スワップが発生すると生成が何倍も遅くなります)、コンテキストウィンドウが大きい(`OLLAMA_CONTEXT_LENGTH=2048`を設定)、モデルがCPUとGPUのどちらで動いているか(`ollama ps`)。そのうえで、Qwen3 1.7BやPhi-4-miniのQ4_K_Mなど、より小さいモデルに切り替えてください。
Intel N100のミニPCはローカルLLMでどのくらい速いですか?
N100のメモリチャネルは1つです(Intelの仕様ではDDR4-3200、DDR5-4800、LPDDR5-4800)。1.4 GBのQwen3 1.7B Q4_K_Mファイルの帯域幅の上限は、DDR4-3200で約18トークン/秒、DDR5-4800で約27トークン/秒で、実際の速度はこれより低くなります。Phi-4-mini(2.5 GB)の上限は、DDR4で約10トークン/秒、DDR5で約15トークン/秒です。N100ではQwen3 1.7B以下を使ってください。
RAM 2 GBのノートPCでローカルRAGは動かせますか?
はい、小規模な文書セットで、RAMが約2 GB空いている場合は可能です。チャットモデルにQwen3 0.6B(523 MB)、埋め込みにnomic-embed-text(274 MB、2Kコンテキスト)を使い、チャンクは数百トークンに抑え、上位2〜3チャンクだけをモデルに渡し、`OLLAMA_CONTEXT_LENGTH=2048`を設定します。深い推論ではなく文書から引き出した単純な回答を想定し、重要な回答は元の文章と照合してください。
低スペックPCではQwen3の代わりにQwen3.5を使うべきですか?
最速の応答が目的なら、当面はQwen3 1.7Bのままにしてください。OllamaではQwen3.5 0.8Bが1.2 GB、2Bが2.7 GB、4Bが3.3 GBで、Qwen3 1.7Bは1.4 GB、Qwen3 4Bは2.5 GBです。帯域幅が制限要因のCPUではファイルが大きいほど1秒あたりのトークン数が減るため、Qwen3 1.7Bより速いと見込まれるのはQwen3.5 0.8Bだけで、品質は下がります。速度より新しい学習を重視するなら、Qwen3.5 2Bと4Bは試す価値があります。PromptQuorumは、このガイドのハードウェアでQwen3.5の速度を計測していません。
CPU専用で実行できる最大のモデルは何ですか?
上限は、ファイルとコンテキストに使える空きRAMで決まります。OllamaではQwen3 8Bが約5.2 GB、Qwen3 14Bが9.3 GB、Qwen3 32Bが20 GBと記載されており、Q4では10億パラメータあたり約0.65 GBが目安です。RAM 32 GBのPCならQwen3 32Bを保持できますが、デュアルチャネルDDR5-5600での帯域幅の上限は約4.5トークン/秒(89.6 GB/s ÷ 20 GB)で、バッチ処理向けのツールになります。Qwen3 30B-A3B(19 GB)のようなMixture-of-Expertsモデルは、トークンごとに数十億のアクティブパラメータだけを読み出すため、ファイルサイズから想像されるより高速に動くはずです。
情報源
- Phi-4 Miniモデルカード — Microsoft Research。開発元が報告したベンチマーク結果。2025年リリース。
- Ollamaライブラリ:Qwen3 — qwen3:0.6b、1.7b、4b、8bのファイルサイズとコンテキスト長(2026-10-23確認)。
- Ollamaライブラリ:Qwen3.5 — qwen3.5:0.8b、2b、4bのファイルサイズ(2026-10-23確認)。
- Ollamaライブラリ:Gemma 4 — gemma4:e2bのダウンロードサイズと128Kコンテキスト(2026-10-23確認)。
- Ollamaライブラリ:Phi-4-mini — 2.5 GB、128Kコンテキスト(2026-10-23確認)。
- Ollamaライブラリ:nomic-embed-text — 274 MBの埋め込みモデル、2Kコンテキストウィンドウ(2026-10-23確認)。
- Ollamaドキュメント:GPUサポート — Vulkan、ROCm、OLLAMA_VULKANを含むGPU選択用の変数。
- Ollamaドキュメント:FAQ — OLLAMA_CONTEXT_LENGTH、OLLAMA_KV_CACHE_TYPE、OLLAMA_FLASH_ATTENTION、OLLAMA_KEEP_ALIVE、`ollama ps`。
- Intel Processor N100の仕様 — メモリチャネルは1つ;DDR4-3200、DDR5-4800、LPDDR5-4800。
- Gemma 4発表の解説記事 — 2026年4月2日リリース、実効パラメータ約23億・総パラメータ約51億(第三者によるまとめ)。
- llama.cppビルドドキュメント — CPUバックエンドとビルドオプション。