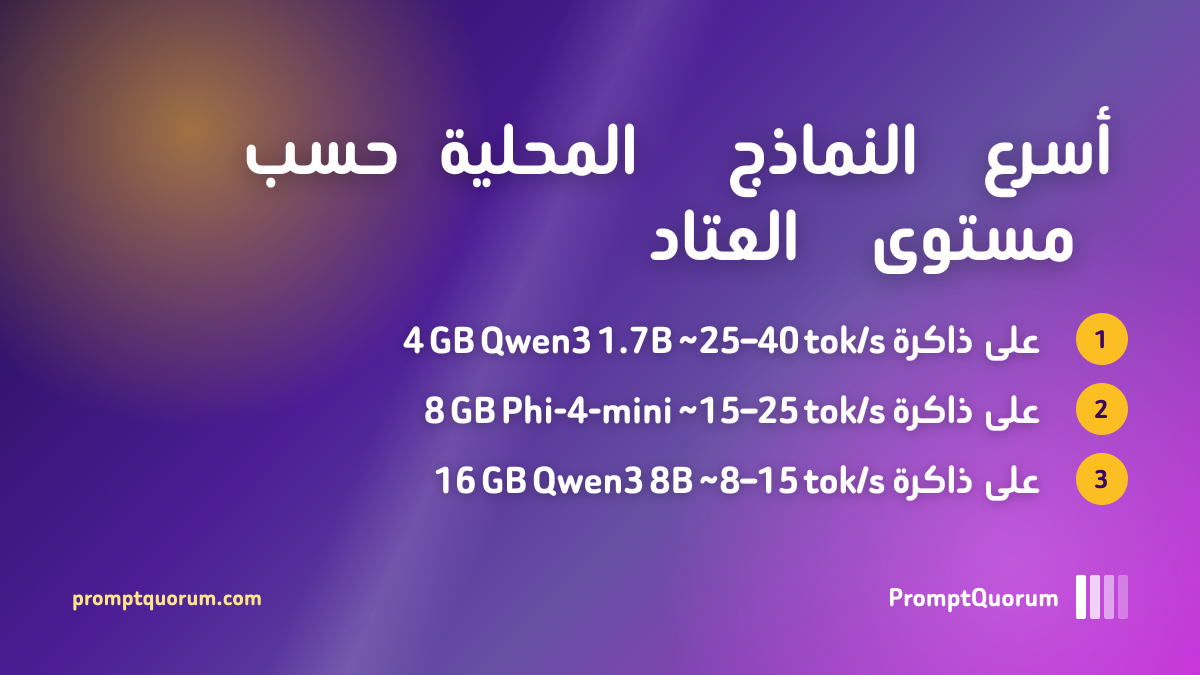
ما النموذج الأسرع لعتادك؟
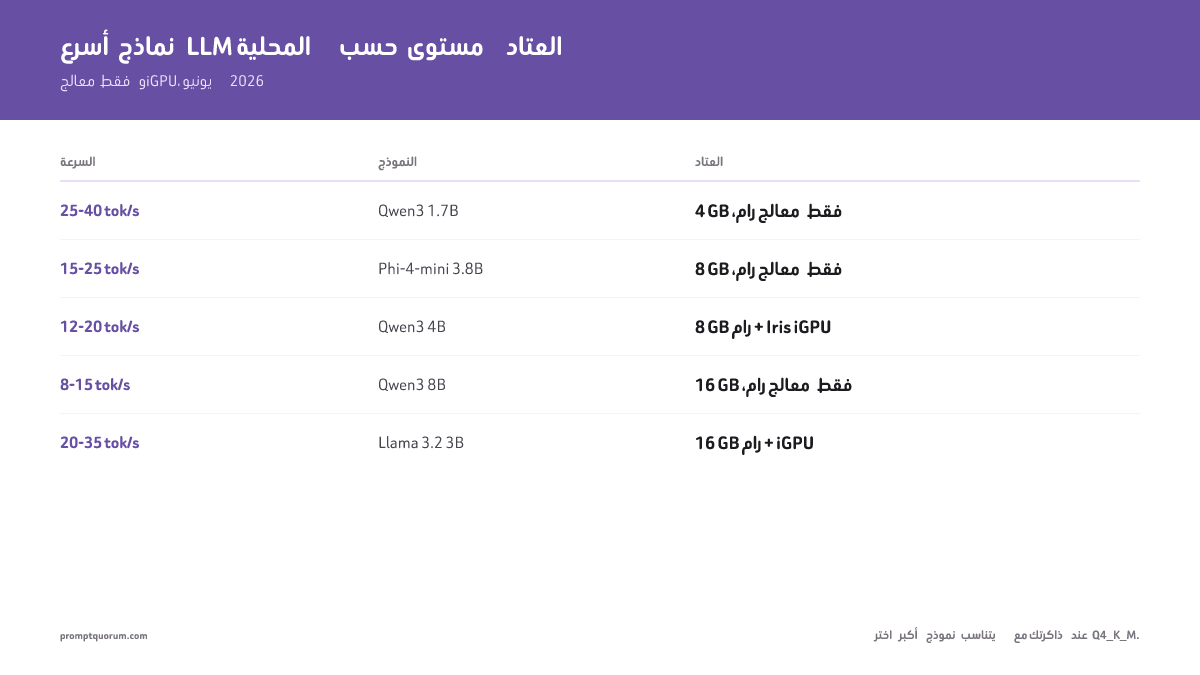
اربط عتادك بالنموذج الصحيح — الاختيار الخاطئ يترك 4–10× من السرعة دون استغلال. جميع المستويات أدناه CPU فقط ما لم يُذكر خلاف ذلك. السرعات تقديرات من PromptQuorum لذاكرة رام ثنائية القناة، وليست قياسات مخبرية؛ الرام أحادية القناة أو حاسوب DDR4 محمول قديم يعطي نتائج أقل.
عتادك | النموذج الموصى به | أمر Ollama | السرعة المتوقَّعة |
|---|---|---|---|
| 4 جيجابايت رام، CPU فقط | Qwen3 1.7B Q4_K_M | ollama run qwen3:1.7b | 25–40 tok/s |
| 8 جيجابايت رام، CPU فقط | Phi-4-mini 3.8B Q4_K_M | ollama run phi4-mini | 15–25 tok/s |
| 8 جيجابايت رام + iGPU من Intel Iris | Qwen3 4B Q4_K_M | ollama run qwen3:4b | 12–20 tok/s |
| 16 جيجابايت رام، CPU فقط | Qwen3 8B Q4_K_M | ollama run qwen3:8b | 8–15 tok/s |
| 16 جيجابايت رام + iGPU | Llama 3.2 3B Q4_K_M | ollama run llama3.2:3b | 20–35 tok/s |
أي نموذج ينبغي أن تستخدم؟
اربط وضعك بالنموذج الصحيح — هذا أهم قرار:
- حاسوب محمول بـ 8 جيجابايت رام (دون GPU منفصلة): Phi-4-mini (3.8B) بصيغة Q4_K_M — 15–25 tok/s، يدعم البرمجة والاستدلال. `ollama run phi4-mini`
- 4 جيجابايت رام، كمبيوتر قديم جداً: Qwen3 1.7B Q4_K_M — 25–40 tok/s، أسرع استجابة بأقل رام. `ollama run qwen3:1.7b`
- 16 جيجابايت رام، دون GPU: Qwen3 8B Q4_K_M — 8–15 tok/s، جودة قوية. `ollama run qwen3:8b`
- 8 جيجابايت رام + iGPU من Intel Iris: Qwen3 4B — تقديري 12–20 tok/s إذا استخدم Ollama وحدة iGPU (شغّل `ollama ps` واقرأ عمود PROCESSOR). `ollama run qwen3:4b`
- تريد سياقاً طويلاً: Qwen3 4B (سياق 256K على Ollama) أو Llama 3.2 3B (128K). يُدرج Qwen3 1.7B وQwen3 8B بسياق 40K.
- جيل أحدث بأصغر الملفات: Qwen3.5 0.8B (1.2 GB على Ollama) أصغر من Qwen3 1.7B (1.4 GB)، فيُتوقع أن يعمل أسرع على نفس CPU بجودة أقل. أما Qwen3.5 2B (2.7 GB) و4B (3.3 GB) فملفاتهما أكبر من Phi-4-mini (2.5 GB) وQwen3 4B (2.5 GB)، فتوقّع أن يكونا أبطأ. `ollama run qwen3.5:0.8b`. لم تقس PromptQuorum سرعة Qwen3.5 على أجهزة هذا الدليل.
- يستحق التجربة أيضاً على 8 جيجابايت رام: Gemma 4 E2B (جوجل، صدر في أبريل 2026). يبلغ عدد معاملاته الفعّالة نحو 2.3B، لكن التنزيل على Ollama يبدأ من 4.6 GB بسبب جداول التضمين فيه، فهو ليس نموذجاً بحجم 1.5–2 GB. `ollama run gemma4:e2b`. راجع دليل النماذج بمعالج فقط للاطلاع على السرعات التقديرية حسب نوع الذاكرة.
- لتوصيات حسب مستوى الرام والتبريد، راجع كيفية تشغيل LLM محلي على حاسوب محمول.
أي LLM محلي ينبغي أن تشغّل على عتادك؟
جميع المستويات أدناه CPU فقط أو iGPU. اختر أكبر نموذج يتناسب مع الرام لديك بصيغة Q4_K_M ويترك هامشاً لنظام التشغيل والسياق. السرعات تقديرية.
Hardware | Model | Quant | Speed | Experience |
|---|---|---|---|---|
| 4 جيجابايت رام، CPU فقط | Qwen3 1.7B | Q4_K_M | 25–40 t/s | سريع، جودة قابلة للاستخدام |
| 8 جيجابايت رام، CPU فقط | Phi-4-mini 3.8B | Q4_K_M | 15–25 t/s | برمجة + استدلال |
| 8 جيجابايت رام + iGPU Iris | Qwen3 4B | Q4_K_M | 12–20 t/s | إذا استُخدمت iGPU |
| 16 جيجابايت رام، CPU فقط | Qwen3 8B | Q4_K_M | 8–15 t/s | جودة قوية |
| 16 جيجابايت رام + iGPU | Llama 3.2 3B | Q4_K_M | 20–35 t/s | إذا استُخدمت iGPU |
GPU مقابل CPU لنماذج LLM المحلية: أيهما أسرع على العتاد منخفض المواصفات؟
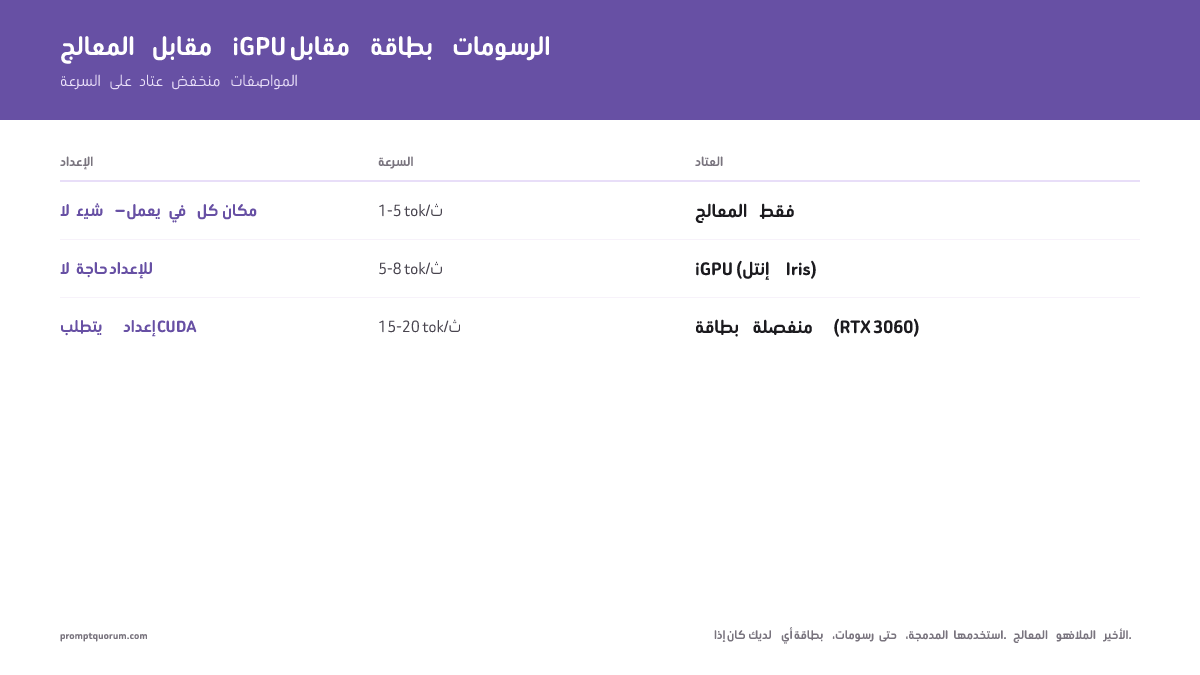
GPU منفصلة: أسرع عادةً بـ 5–10 أضعاف من CPU فقط للنموذج نفسه، لأن VRAM يملك عرض نطاق ذاكرة أكبر بكثير من رام النظام. RTX 4060 8 GB مستعملة (السعر متغيّر) ترقية اقتصادية شائعة. راجع دليل وحدات GPU الاقتصادية للخيارات المجدية.
iGPU (مدمجة): تتشارك رام النظام مع CPU، فيبقى القيد الرئيسي — عرض نطاق الذاكرة — كما هو. والمكسب عادةً متواضع ويتوقف على دعم برنامج التشغيل. يذكر توثيق Ollama أن دعم Vulkan لوحدات GPU على Windows وLinux مفعّل افتراضياً عند تثبيت الواجهة الخلفية، ويدرج وحدات iGPU من AMD Ryzen AI ضمن ROCm؛ ولا يدرج وحدات Intel الرسومية المدمجة في جدول دعم. تحقق بالأمر `ollama ps`: يبيّن عمود PROCESSOR هل يعمل النموذج على CPU أم GPU أم بتوزيع بينهما.
CPU فقط: يعمل على أي كمبيوتر دون إعداد برامج تشغيل. السرعة تساوي تقريباً عرض نطاق الذاكرة ÷ حجم ملف النموذج، ولذلك فإن الرام ثنائية القناة وملف Q4_K_M صغير يهمان أكثر من تردد CPU.
القاعدة: استخدم GPU منفصلة إن كانت لديك. وإلا فشغّل الموجّه نفسه مع iGPU وبدونها (`OLLAMA_VULKAN=0` يوقف وحدات Vulkan GPU) واحتفظ بالأسرع.
لماذا النماذج الأصغر أسرع على أجهزة الكمبيوتر منخفضة المواصفات
يحدّد حجم النموذج السرعة مباشرة. يتناسب نموذج 1B–3B بالكامل مع RAM النظام، مما يتيح لـ CPU أو GPU بث البيانات باستمرار. تتطلب النماذج الأكبر تبادل الذاكرة — نقل البيانات بين RAM والقرص — مما يبطئ التوليد بشكل كبير (الاختناق هو دخل/خرج القرص، لا الحوسبة).
يعكس جدول قرار العتاد أعلاه هذا المبدأ: أصغر الملفات تعطي أعلى سرعة، بينما تكون نماذج 13B+ غير عملية على العتاد منخفض المواصفات لأن التبادل يهيمن.
- نماذج 1B–3B: تتناسب مع 4–8 GB RAM ← توليد أسرع ← جودة مقبولة
- نماذج 7B: ضيقة على أنظمة 8 GB ← أبطأ بسبب ضغط الذاكرة ← جودة عالية
- نماذج 13B+: تتطلب 16+ GB رام أو تبادلاً ضخماً ← بطيئة جداً للاستخدام التفاعلي على الحواسيب منخفضة المواصفات
ما مدى سرعة نماذج LLM المحلية على أجهزة الكمبيوتر منخفضة المواصفات؟
على أنظمة CPU فقط، توقّع هذه النطاقات التقديرية:
- نماذج 3B ← 15–40 رمز/ثانية (وحدات CPU قديمة: 10–15، وأنظمة DDR5 ثنائية القناة الأحدث: 30–40)
- نماذج 7B–8B ← 8–15 رمز/ثانية (بصيغة Q4_K_M على رام ثنائية القناة؛ الرام أحادية القناة أقل)
- قدّر سرعتك بقسمة واحدة. يتطلب توليد كل رمز قراءة النموذج كاملاً من الرام مرة واحدة، لذا لا يمكن أن يتجاوز عدد الرموز في الثانية عرض نطاق الذاكرة ÷ حجم ملف النموذج. عرض النطاق الأقصى = معدل النقل (MT/s) × 8 بايت × عدد القنوات.
- أمثلة محسوبة (سقوف لا تنبؤات): رام DDR4-3200 ثنائية القناة تعطي 3200 × 8 × 2 = 51.2 GB/s؛ وبقسمتها على ملف Phi-4-mini البالغ 2.5 GB نحصل على نحو 20 tok/s كحد أقصى. وDDR5-5600 ثنائية القناة تعطي 89.6 GB/s، أي نحو 36 tok/s كحد أقصى للملف نفسه. وحاسوب محمول بـ DDR4-3200 أحادية القناة يعطي 25.6 GB/s، أي نحو 10 tok/s كحد أقصى. السرعة الفعلية أقل من السقف.
- أجهزة Intel N100 المصغّرة لها قناة ذاكرة واحدة (مواصفات Intel: DDR4-3200 أو DDR5-4800 أو LPDDR5-4800). مع DDR4-3200 يبلغ السقف لملف Qwen3 1.7B البالغ 1.4 GB نحو 18 tok/s؛ ومع DDR5-4800 نحو 27 tok/s. توقّع أن يقع N100 دون النطاقات ثنائية القناة في هذا الدليل.
- هذا أبطأ من روبوتات الدردشة السحابية لكنه كافٍ للاستخدام التفاعلي. ينتج نموذج 3B بسرعة 25 tok/s رداً من 500 رمز في 20 ثانية — مقبول للمهام غير العاجلة كمراجعة الكود والتلخيصات والكتابة الإبداعية.
كيف يؤثر التكميم على السرعة على أجهزة الكمبيوتر منخفضة المواصفات؟
Q4 (4 بت): الخيار القياسي — نحو ربع حجم ملف 16 بت مع فقدان جودة صغير في معظم المهام. لتفاصيل جميع مستويات التكميم وكيف تعمل، راجع الدليل الكامل.
Q3 (3 بت): ملف أصغر وفقدان جودة أكبر من Q4. مقبول للدردشة عندما لا يتسع Q4 في الرام.
Q2 (2 بت): أصغر ملف وأكبر فقدان للجودة. محفوف بالمخاطر؛ استخدمه فقط إذا نفدت الذاكرة مع Q4 وQ3.
تأثير السرعة: لأن فك الترميز على CPU محكوم بعرض نطاق الذاكرة، فإن الملف الأصغر يولّد أسرع بنسبة تقارب نسبة الحجم. ملفات Q3 وQ2 أسرع من Q4، لكن هبوط الجودة لا يستحق ذلك عادةً مع نماذج بهذا الصغر.
الاستراتيجية: اختر حجم النموذج أولاً، ثم استخدم Q4_K_M. النموذج الصغير بصيغة Q4_K_M يتفوق عادةً على نموذج أكبر مضغوط إلى Q2، الذي يفقد الدقة ويحتاج ذاكرة أكثر مع ذلك.
تضحّي النماذج الأسرع بالجودة مقابل السرعة — لكن ضبط temperature وtop-p يستعيد جزءاً كبيراً من تلك الجودة. ينتج temperature منخفض (0.1–0.3) في النماذج السريعة نتائج أكثر اتساقاً من الإعداد الافتراضي. راجع شرح temperature وtop-p للإعدادات الدقيقة.

كيف تسرّع الاستدلال على CPU فقط؟
- املأ قناتي الذاكرة: شريحتا رام متطابقتان تضاعفان عرض نطاق الذاكرة الأقصى مقارنةً بشريحة واحدة، وهذا أكبر تسريع منفرد على كمبيوتر CPU فقط. الحواسيب المحمولة والأجهزة المصغّرة بشريحة واحدة تعمل عند نصف السقف.
- قلّص نافذة السياق: تكبر ذاكرة KV المؤقتة مع طول السياق. اضبط `OLLAMA_CONTEXT_LENGTH=2048` (القيمة الافتراضية في Ollama هي 4096)، أو `/set parameter num_ctx 2048` داخل `ollama run`.
- كمّم ذاكرة KV المؤقتة: تقلّص `OLLAMA_FLASH_ATTENTION=1` مع `OLLAMA_KV_CACHE_TYPE=q8_0` ذاكرة KV إلى نحو النصف مقارنةً بالقيمة الافتراضية f16، وهذا يفيد أكثر على أجهزة 4 جيجابايت و8 جيجابايت.
- أبقِ النموذج محمّلاً: يفرّغ Ollama النموذج بعد 5 دقائق افتراضياً. `OLLAMA_KEEP_ALIVE=30m` يتجنّب إعادة تحميل الملف في كل جلسة.
- أغلق التطبيقات المستهلكة للذاكرة: المتصفحات ذات التبويبات الكثيرة تدفع النموذج إلى ملف التبديل (swap)، مما يبطئ التوليد عدة أضعاف.
- اختبر iGPU: شغّل `ollama ps` أثناء تحميل نموذج. إذا أظهر PROCESSOR نسبة 100% CPU، فقارن مع تشغيل على GPU؛ وإذا كانت iGPU غير مستقرة، فاضبط `OLLAMA_VULKAN=0`.
هل يمكن تشغيل RAG محلي بذاكرة 2 جيجابايت؟
نعم، لمجموعات المستندات الصغيرة: Qwen3 0.6B (523 MB على Ollama) للإجابات مع نموذج التضمين nomic-embed-text (274 MB) للبحث يحتاجان نحو 0.8 جيجابايت من ملفات النماذج إجمالاً. يتسع هذا عندما تكون 2 جيجابايت من الرام متاحة فعلاً، مثلاً على توزيعة Linux خفيفة أو نتبوك قديم أو كمبيوتر أُغلقت فيه التطبيقات الأخرى. توقّع إجابات بسيطة مستخلصة من مستنداتك، لا استدلالاً عميقاً.
- نموذج الدردشة: `ollama pull qwen3:0.6b` (523 MB، سياق 40K على Ollama). ومع رام متاحة أكثر قليلاً، يكون `qwen3.5:0.8b` (1.2 GB) الخيار الأصغر الأحدث.
- نموذج التضمين: `ollama pull nomic-embed-text` (274 MB، نافذة سياق 2K). قسّم المستندات إلى مقاطع من بضع مئات من الرموز ليتسع كل مقطع في نافذة 2K.
- استرجع مقاطع قليلة: مرّر إلى نموذج الدردشة أفضل 2–3 مقاطع مطابقة فقط. كل مقطع إضافي يطيل السياق ويكبّر ذاكرة KV المؤقتة.
- أبقِ السياق قصيراً: اضبط `OLLAMA_CONTEXT_LENGTH=2048` لتبقى ذاكرة KV المؤقتة صغيرة.
- تحقق من الإجابات: نموذج 0.6B جيد في استخراج معلومة من مقطع مسترجَع وضعيف في الاستدلال متعدد الخطوات، لذا تحقق من الإجابات المهمة بمقارنتها بالمقطع المصدر.
- عندما تضيق 2 جيجابايت: انتقل إلى Qwen3 1.7B (1.4 GB) على 4 جيجابايت رام، أو Phi-4-mini على 8 جيجابايت، مع الإبقاء على نموذج التضمين نفسه.
ما مدى سرعة هذه النماذج؟ سرعات تقديرية
سرعات تقديرية حسب فئة العتاد، وليست قياسات مخبرية. هذه النطاقات تقريبات خاصة بـ PromptQuorum، مستخلصة من سقف عرض نطاق الذاكرة لكل فئة، بإعدادات Ollama الافتراضية وملفات Q4_K_M. اعتبرها سقوفاً لتثبيت سليم؛ أما ناتج الأمر `ollama run <model> --verbose` على جهازك فيعرض عدد الرموز الفعلي في الثانية:
- كمبيوتر Intel N100 مصغّر (رام أحادية القناة، مستوى 4 جيجابايت) + Qwen3 1.7B Q4_K_M: حتى نحو 18 tok/s مع DDR4-3200 ونحو 27 tok/s مع DDR5-4800 (سقوف عرض النطاق). `ollama run qwen3:1.7b`
- i5/Ryzen 5 حديث ثنائي القناة (مستوى 4 جيجابايت) + Qwen3 1.7B Q4_K_M: تقديري 25–40 tok/s. `ollama run qwen3:1.7b`
- حاسوب محمول من فئة Core i5-1235U (8 جيجابايت رام) + Phi-4-mini Q4_K_M: تقديري 15–22 tok/s مع LPDDR5؛ وحواسيب DDR4 المحمولة أقل. `ollama run phi4-mini`
- سطح مكتب من فئة Ryzen 5 5600G (8 جيجابايت رام) + Qwen3 4B Q4_K_M: تقديري 15–20 tok/s (سقف DDR4-3200 ثنائية القناة نحو 20)؛ وتتشارك iGPU عرض نطاق الرام نفسه، فلا تتوقع أكثر.
- حاسوب محمول من فئة Intel Iris Xe (8 جيجابايت رام) + Qwen3 4B Q4_K_M: تقديري 12–18 tok/s. `ollama run qwen3:4b`
- سطح مكتب من فئة Ryzen 7 7700X (16 جيجابايت رام، DDR5 ثنائية القناة) + Qwen3 8B Q4_K_M: تقديري 8–13 tok/s. `ollama run qwen3:8b`
- حاسوب محمول من فئة Iris Xe (16 جيجابايت رام) + Llama 3.2 3B Q4_K_M: تقديري 20–30 tok/s. `ollama run llama3.2:3b`
ما "السريع" فعلاً لنماذج LLM المحلية؟
تُدرَك السرعة بشكل مختلف حسب المهمة — استخدم هذا كمرجع:
إن كان نموذجك يعمل دون 15 tok/s، اخفض حجم النموذج (7B ← 3B) أو اخفض مستوى تكميم (Q5 ← Q4) قبل شراء عتاد جديد.
- دون 10 tok/s ← يبدو معطّلاً. تظهر الكلمات واحدة تلو الأخرى بفواصل ملحوظة. غير قابل للاستخدام للدردشة التفاعلية.
- 15–25 tok/s ← مقبول. سرعة قابلة للقراءة لمعظم المستخدمين. جيد للأسئلة والأجوبة والتلخيصات والمساعدة في الكود.
- 30+ tok/s ← سلس. يبدو كمساعد حقيقي. مريح لجميع المهام التفاعلية.
- 60+ tok/s ← فوري. أسرع من القراءة. مثالي للإكمال التلقائي في الوقت الفعلي والتكرار السريع.

ما يجب تجنّبه على أجهزة الكمبيوتر منخفضة المواصفات
- لا تشغّل نماذج 13B+ — تتجاوز حدود RAM. يحتاج نموذج 13B بصيغة Q4 إلى نحو 8 GB للملف وحده، وهذا يفوق ما يستطيع كمبيوتر بذاكرة 8 جيجابايت استيعابه بعد احتساب نظام التشغيل. التزم بـ 8B أو أقل على 16 جيجابايت، وبـ 4B أو أقل على 8 جيجابايت.
- تجنّب تكميم Q8 — أبطأ بمكسب جودة ضئيل. يضاعف Q8 تقريباً حجم ملف Q4، والملف الأكبر يعني رموزاً أقل في الثانية على CPU محدود بعرض نطاق الذاكرة. على أنظمة 4 GB، Q8 غير عملي؛ على أنظمة 8 GB، يبقى Q4 الأمثل. Q3 هي المفاضلة الوحيدة التي تستحق النظر عندما تنفد الذاكرة مع Q4.
- لا تتوقع أداء إكمال تلقائي في الوقت الفعلي. بسرعة 3 tok/s على CPU، يستغرق توليد 50 رمزاً نحو 17 ثانية. يتطلب الإكمال التلقائي التفاعلي سرعات أعلى بكثير. تخدم نماذج LLM المحلية على وحدات CPU منخفضة المواصفات الدردشة الدفعية والمسودات والمراجعة — لا الإكمال التلقائي الحي أو الكود أثناء الكتابة.
- لا تستخدم الاستدلال على CPU فقط لروبوتات الدردشة الإنتاجية. مقبول للأدوات الداخلية والنماذج الأولية والعمل الدفعي دون اتصال. يخدم CPU منخفض المواصفات مستخدماً واحداً في كل مرة وبسرعة منخفضة، بينما تتسع واجهة API مستضافة لعدد كبير من المستخدمين. استخدم الاستدلال المحلي للسيناريوهات الحرجة للخصوصية أو دون اتصال، لا الحرجة للسرعة.
الأخطاء الشائعة
- خطأ: تشغيل شريحة رام واحدة. المشكلة: قناة ذاكرة واحدة تُنصّف عرض النطاق الأقصى، فيولّد النموذج نفسه بنحو نصف السرعة. الحل: ركّب شريحتين متطابقتين (أو اشترِ كمبيوتراً مصغّراً ثنائي القناة) قبل شراء CPU أسرع.
- خطأ: الحكم على السرعة من طراز CPU وحده. المشكلة: قد يكون CPU أحدث مع DDR4 أحادية القناة أبطأ من CPU أقدم مع DDR5 ثنائية القناة، لأن توليد الرموز محكوم بعرض نطاق الذاكرة. الحل: قارن سرعة الرام وعدد القنوات، ثم اقرأ الرقم الفعلي من `ollama run <model> --verbose`.
- خطأ: التكميم إلى Q2 لإجبار 7B في 4 GB. المشكلة: كثيراً ما يسبّب تكميم Q2 تعليقاً بسبب نفاد الذاكرة بسبب حمل ذاكرة KV المؤقتة أثناء الاستدلال، كما تنخفض جودة المخرجات بشكل حاد. الحل: استخدم نموذج 3B بصيغة Q4.
- خطأ: ترك نافذة السياق كبيرة. المشكلة: السياق الطويل يكبّر ذاكرة KV المؤقتة ويدفع الجهاز الصغير إلى ملف التبديل (swap). الحل: اضبط `OLLAMA_CONTEXT_LENGTH=2048` ما لم تحتج إلى مستندات طويلة.
- خطأ: استخدام slug خاطئ في Ollama لنموذجك. المشكلة: `ollama run phi` يحمّل Phi-2، لا Phi-4-mini. الحل: استخدم `ollama run phi4-mini` لنموذج Phi mini الحالي. راجع دائماً ollama.com/library للوسوم الدقيقة للنماذج.
نماذج LLM المحلية على أجهزة الكمبيوتر منخفضة المواصفات: السياق الإقليمي
الاتحاد الأوروبي / GDPR: محلياً على أجهزة منخفضة التكلفة: عند التشغيل دون اتصال بالإنترنت لا تغادر بيانات الاستنتاج الجهاز — وهذه طريقة تقنية بسيطة لكثير من الشركات الصغيرة والمتوسطة والعاملين لحسابهم الخاص لتجنب مخاطر النقل وفق المادة 44 من اللائحة العامة لحماية البيانات. يتوقف انطباق قانون الذكاء الاصطناعي للاتحاد الأوروبي أو غيره من الالتزامات على استخدامك على من ينشر النظام ولأي غرض؛ وهذا الدليل ليس استشارة قانونية. وللشركات الألمانية الصغيرة والمتوسطة التي تدرس نماذج LLM المحلية لمهام العمل الداخلية، فإن إبقاء المستندات على الجهاز يتجنّب إرسالها إلى معالِج بيانات تابع لطرف ثالث، غير أن الامتثال الشامل لحماية البيانات يعتمد على التشغيل الكامل، وليس على بنية الاستنتاج وحدها.
اليابان: تؤكد إرشادات METI للذكاء الاصطناعي في قطاع الأعمال في اليابان على التعامل المسؤول مع البيانات. يُبقي الاستدلال على CPU لعتاد منخفض المواصفات، رغم بطئه، الموجّهات على الجهاز — فبعد تنزيل النموذج لا يحتاج الاستدلال نفسه إلى استدعاءات API. وبالنسبة للمهام باللغة اليابانية على Qwen3 بسرعات CPU ضمن النطاقات المذكورة أعلاه، فإن بضع ثوانٍ لكل جملة مقبولة لتلخيص المستندات غير العاجل.
الصين: يُعدّ الاستدلال المحلي لنموذج Qwen3 وللنسخ المقطّرة من DeepSeek-R1 على العتاد الاستهلاكي خياراً للمستخدمين في الصين الذين لا يستطيعون الوصول إلى واجهات API السحابية للنماذج غير الصينية. تعمل Qwen3 0.6B و1.7B و4B على عتاد CPU فقط، موفّراً بديلاً عملياً لواجهات API السحابية للمستخدمين ذوي العتاد المحدود.
الأسئلة الشائعة حول كيفية تشغيل نماذج LLM المحلية على أجهزة الكمبيوتر منخفضة المواصفات
ما الذي يُعَد كمبيوتراً منخفض المواصفات لتشغيل نماذج LLM المحلية؟
الكمبيوتر منخفض المواصفات لنماذج LLM المحلية هو أي جهاز CPU فقط (دون GPU منفصلة) بذاكرة نظام من 4 إلى 16 جيجابايت. يشمل معظم الحواسيب المحمولة بمعالجات رسوم مدمجة Intel Iris أو AMD Radeon، وأجهزة سطح المكتب القديمة دون GPU مخصصة، وأجهزة mini PC مثل Intel N100. القيد الرئيسي هو ذاكرة النظام لاستيعاب أوزان النموذج، لا سرعة ساعة CPU.
هل يمكنني تشغيل نموذج من فئة 7B دون أي GPU على الإطلاق؟
نعم — يعمل Qwen3 8B بصيغة Q4_K_M بسرعة تقديرية 8–15 tok/s مع 16 جيجابايت رام، CPU فقط (تقدير لسطح مكتب ثنائي القناة من فئة Ryzen 7 7700X). إنه أبطأ من الخيارات الأصغر لكنه يقدّم جودة أفضل بشكل ملحوظ. مع 8 جيجابايت رام، التزم بـ Phi-4-mini (3.8B) بدلاً منه — يحتاج نموذج 8B بصيغة Q4_K_M هامشاً لا يضمنه نظام 8 جيجابايت بشكل موثوق دائماً.
هل استدلال CPU قابل للاستخدام لروبوتات الدردشة؟
نعم، للاستخدام التفاعلي إن اخترت الحجم الصحيح للنموذج. Phi-4-mini بسرعة 15–25 tok/s (8 جيجابايت رام) وQwen3 1.7B بسرعة 25–40 tok/s (4 جيجابايت رام) كلاهما سريع بما يكفي للدردشة الفورية. نموذج من فئة 7B على CPU (8–15 tok/s) أنسب للمهام الدفعية — الصياغة والتلخيص والمراجعة دون اتصال — من المحادثة الحية المتبادلة.
هل ينبغي أن أستخدم Phi-4-mini أم Qwen3 1.7B على عتاد CPU فقط؟
استخدم Phi-4-mini (3.8B) إن كان لديك 8 جيجابايت رام — يدعم البرمجة والاستدلال بسرعة 15–25 tok/s. استخدم Qwen3 1.7B إن كان لديك 4 جيجابايت رام فقط أو تريد أسرع استجابة ممكنة (25–40 tok/s) على حساب بعض الجودة في المهام المعقدة.
كيف أتحقق إن كان لدي أي GPU على الإطلاق؟
شغّل `nvidia-smi` في الطرفية لوحدات NVIDIA المنفصلة. إن أعاد "command not found"، تحقق من `lspci` (على Linux) أو مدير الأجهزة (على Windows) بحثاً عن iGPU من نوع Intel Iris Xe أو AMD Radeon — تعتمد قدرة Ollama على استخدامها على دعم برنامج التشغيل والواجهة الخلفية (backend)، لذا تأكد عبر `ollama ps`.
كيف يؤثر التكميم على سرعة الاستدلال؟
يقلّل التكميم أساساً متطلبات عرض نطاق الذاكرة، لا الحوسبة. ملف Q2 (2 بت) أصغر من ملف Q4 (4 بت)، فيقرأ CPU بايتات أقل لكل رمز ويولّد أسرع، بنسبة تقارب نسبة حجم الملف. لكن Q2 يفقد جودة المخرجات أكثر بكثير. القاعدة العملية: استخدم Q4_K_M افتراضياً لكل مستوى في هذا الدليل، اخفض إلى Q3 فقط إن لم يتناسب Q4_K_M مع الرام المتاحة.
هل يمكنني استخدام تكميم دون Q2؟
تقنياً نعم (توجد صيغ IQ1 بدقة 1 بت في llama.cpp)، لكن جودة المخرجات تنهار عند هذا الحجم. غير موصى به لأي حالة استخدام عملية، بما في ذلك مستوى 4 جيجابايت رام في هذا الدليل — اختر نموذجاً أصغر بصيغة Q4_K_M بدلاً من ذلك.
هل الاستدلال الهجين CPU + iGPU مدعوم؟
أحياناً. يستطيع Ollama تقسيم النموذج بين CPU وGPU عندما يجد واجهة GPU خلفية مدعومة، ويعرض الأمر `ollama ps` هذا التقسيم في عمود PROCESSOR. تتشارك iGPU رام النظام مع CPU، لذا لا يزداد عرض نطاق الذاكرة — القيد الرئيسي للسرعة. على نظام 8 جيجابايت رام مع iGPU من Intel Iris Xe، يُقدَّر Qwen3 4B بسرعة 12–20 tok/s إذا استُخدمت iGPU. اختبر بالقيمة `OLLAMA_VULKAN=0` للمقارنة مع CPU فقط.
ما أسرع LLM محلي لكمبيوتر منخفض المواصفات؟
Qwen3 1.7B بصيغة Q4_K_M هو الأسرع بين اختيارات الفئات في هذا الدليل (نماذج أصغر مثل Qwen3 0.6B أسرع منه، لكن بجودة أقل بكثير) — نحو 25–40 tok/s تقديرياً على i5/Ryzen 5 حديث مع 4 جيجابايت رام ودون GPU. لجودة أفضل بسرعة مماثلة، يعمل Phi-4-mini (3.8B) بسرعة 15–25 tok/s مع 8 جيجابايت رام ويدعم البرمجة والاستدلال بشكل أفضل ملحوظاً.
هل يمكنني تشغيل LLM محلي بـ 4 جيجابايت من الرام؟
نعم — Qwen3 1.7B بصيغة Q4_K_M هو الخيار الموصى به لـ 4 جيجابايت رام، CPU فقط، ويبلغ 25–40 tok/s على i5/Ryzen 5 حديث. إنه الأسرع بين اختيارات الفئات في هذا الدليل ويتناسب بهامش لنظام التشغيل.
هل GPU ضرورية لسرعة أعلى؟
لا — تعمل جميع نماذج هذا الدليل على CPU فقط. قد تضيف iGPU من Intel Iris دفعة سرعة متواضعة (Qwen3 4B: تقديري 12–20 tok/s إذا استُخدمت iGPU) لكنها اختيارية وتتوقف على دعم برنامج التشغيل. GPU منفصلة مثل RTX 4060 8 GB مستعملة أسرع عادةً بـ 5–10× من CPU فقط للنموذج نفسه، لكنها مسار ترقية منفصل، لا شرط أساسي.
هل iGPU من Intel Iris كافية لنماذج LLM المحلية؟
قد تفيد، لكن ذلك غير مضمون. مع 8 جيجابايت رام وiGPU من Intel Iris Xe، يُقدَّر Qwen3 4B بسرعة 12–20 tok/s إذا استخدم Ollama وحدة iGPU فعلاً؛ ومع 16 جيجابايت رام يُقدَّر Llama 3.2 3B بسرعة 20–35 tok/s. ولأن iGPU تتشارك رام النظام مع CPU، فإن المكسب متواضع عادةً. شغّل الموجّه نفسه مع iGPU وبدونها واحتفظ بالإعداد الأسرع.
هل ينبغي أن أستخدم تكميم Q2 أم Q4 على العتاد منخفض المواصفات؟
ابدأ بـ Q4_K_M — يتناسب مع كل مستوى نموذج في هذا الدليل (من 1.7B إلى 8B) بفقدان جودة صغير. اخفض إلى Q3 أو Q2 فقط إن سبّب Q4_K_M أخطاء نفاد ذاكرة. ملفات Q2 أسرع لأنها أصغر، لكن فقدان الجودة ملحوظ في مهام الاستدلال والكود.
كيف أتحقق من الرام المتاحة لدي على Windows؟
افتح مدير المهام ← الأداء ← الذاكرة. الإجمالي المعروض هو رام النظام لديك — قارنه بجدول قرار العتاد أعلاه (مستويات 4 أو 8 أو 16 جيجابايت) لاختيار النموذج الصحيح.
هل يستخدم Ollama وحدة GPU المدمجة لدي تلقائياً؟
فقط حيثما توجد واجهة خلفية مدعومة. يذكر توثيق Ollama أن دعم Vulkan لوحدات GPU على Windows وLinux مفعّل افتراضياً عند تثبيت الواجهة الخلفية، ويدرج وحدات iGPU من AMD Ryzen AI ضمن ROCm؛ ولا يدرج وحدات Intel الرسومية المدمجة في جدول دعم. تحقق بـ `ollama ps` بعد تحميل نموذج — يعرض عمود PROCESSOR القيمة 100% CPU أو 100% GPU أو توزيعاً بينهما. اضبط `OLLAMA_VULKAN=0` لإيقاف وحدات Vulkan GPU.
ما أفضل بديل مجاني لـ ChatGPT على كمبيوتر منخفض المواصفات؟
Phi-4-mini (3.8B) بصيغة Q4_K_M على Ollama مع 8 جيجابايت رام، CPU فقط، يعطي 15–25 tok/s — كافٍ للدردشة والتلخيصات والمساعدة في الكود. الجودة أقل من نموذج سحابي متقدم لكنها كافية للمهام اليومية. مجاني تماماً، يعمل دون اتصال، دون حاجة لمفتاح API.
كم أسرع GPU منفصلة من CPU لنماذج LLM المحلية؟
أسرع عادةً بين 5 و10 أضعاف للنموذج نفسه. تتفوق RTX 4060 8 GB مستعملة (السعر متغيّر) عادةً على إعدادات CPU فقط المذكورة في هذا الدليل. تقع iGPU من Intel Iris في مرتبة وسطى في أفضل الأحوال — على سبيل المثال يُقدَّر Qwen3 4B بسرعة 12–20 tok/s إذا استُخدمت iGPU، مقابل تقدير 8–15 tok/s لـ CPU فقط في أقرب مستوى مقارن.
هل نموذج الذكاء الاصطناعي المحلي هو نفسه LLM المحلي؟
بالنسبة لهذا الدليل، نعم. "نموذج الذكاء الاصطناعي المحلي" هو التعبير الشائع لما يسميه المجال LLM محلي (نموذج لغوي كبير) — أوزان مولّدة للنص تُحمّل مرة واحدة وتُشغّل على جهازك الخاص، دون اتصال. لا يهم هذا التمييز إلا عندما يكون نموذج الذكاء الاصطناعي غير نصي: مولدات الصور مثل Stable Diffusion ونماذج الكلام مثل Whisper تعمل محلياً أيضاً، لكن لها ملفات أجهزة مختلفة ولا تنطبق عليها أرقام tok/s في هذا الدليل.
ما هو أخف LLM محلي لا يزال يكتب نصاً قابلاً للاستخدام؟
Qwen3 1.7B بصيغة Q4_K_M هو أخف نموذج في هذا الدليل يستحق الاستخدام — 1.4 جيجابايت على القرص في Ollama، يعمل بـ 4 جيجابايت رام، وبسرعة تقديرية 25–40 tok/s على CPU فقط. توجد خيارات أصغر (TinyLlama 1.1B، Qwen3 0.6B) وهي أسرع، لكن جودة الإخراج تنخفض بشكل حاد يجعل التعامل معها كإكمال تلقائي أفضل من اعتبارها مساعد كتابة. دون نحو 1 مليار معامل، لا ينتج أي نموذج خفيف نصاً طويلاً متماسكاً بشكل موثوق.
هل Gemma 4 E2B أسرع من Qwen3 1.7B على كمبيوتر منخفض الأداء؟
على الأرجح لا على أجهزة 4 جيجابايت. يبلغ عدد المعاملات الفعّالة في Gemma 4 E2B (جوجل، صدر في أبريل 2026) نحو 2.3B، لكن التنزيل على Ollama يبدأ من 4.6 GB بسبب جداول التضمين فيه، وعلى CPU محدود بعرض نطاق الذاكرة يعني الملف الأكبر رموزاً أقل في الثانية. وهو أنسب لأنظمة 8 أو 16 جيجابايت رام. يقدّر دليل النماذج بمعالج فقط سرعته بنحو 8–14 tok/s مع ذاكرة ثنائية القناة. يبقى Qwen3 1.7B (1.4 GB) الخيار الأسرع في هذا الدليل للأجهزة الأضعف؛ جرّب `ollama run gemma4:e2b` للمقارنة على 8 جيجابايت فأكثر.
لماذا يعمل LLM المحلي لدي ببطء شديد على كمبيوتر منخفض المواصفات؟
السبب المعتاد هو عرض نطاق الذاكرة لا سرعة CPU: يتطلب كل رمز قراءة ملف النموذج كاملاً من الرام، فتُحدَّد السرعة بعرض نطاق الذاكرة مقسوماً على حجم الملف. تحقق من أربعة أمور: شريحة رام واحدة (قناة واحدة تُنصّف السقف)، وملف نموذج أكبر من الرام الحرة (التبديل يبطئ التوليد عدة أضعاف)، ونافذة سياق كبيرة (اضبط `OLLAMA_CONTEXT_LENGTH=2048`)، وهل يعمل النموذج على CPU أم GPU (`ollama ps`). ثم انتقل إلى نموذج أصغر مثل Qwen3 1.7B أو Phi-4-mini بصيغة Q4_K_M.
ما سرعة كمبيوتر Intel N100 المصغّر لنماذج LLM المحلية؟
يملك N100 قناة ذاكرة واحدة (DDR4-3200 أو DDR5-4800 أو LPDDR5-4800، وفق Intel). بالنسبة لملف Qwen3 1.7B Q4_K_M البالغ 1.4 GB يبلغ سقف عرض النطاق نحو 18 tok/s مع DDR4-3200 ونحو 27 tok/s مع DDR5-4800، والسرعة الفعلية أقل. أما Phi-4-mini (2.5 GB) فسقفه قرابة 10 tok/s مع DDR4 و15 tok/s مع DDR5. استخدم Qwen3 1.7B أو أصغر على N100.
هل يمكنني تشغيل RAG محلي على حاسوب محمول بذاكرة 2 جيجابايت؟
نعم، لمجموعات المستندات الصغيرة، إذا كانت نحو 2 جيجابايت من الرام متاحة. استخدم Qwen3 0.6B (523 MB) كنموذج دردشة وnomic-embed-text (274 MB، سياق 2K) للتضمين، وأبقِ المقاطع بضع مئات من الرموز، ومرّر أفضل 2–3 مقاطع فقط إلى النموذج، واضبط `OLLAMA_CONTEXT_LENGTH=2048`. توقّع إجابات بسيطة مستخلصة من مستنداتك لا استدلالاً عميقاً، وتحقق من الإجابات المهمة بمقارنتها بالمقطع المصدر.
هل ينبغي أن أستخدم Qwen3.5 بدلاً من Qwen3 على كمبيوتر منخفض المواصفات؟
لأسرع استجابة، ابقَ مع Qwen3 1.7B حالياً. يدرج Ollama حجم Qwen3.5 0.8B بـ 1.2 GB، و2B بـ 2.7 GB، و4B بـ 3.3 GB، مقابل 1.4 GB لـ Qwen3 1.7B و2.5 GB لـ Qwen3 4B. وعلى CPU محدود بعرض نطاق الذاكرة يولّد الملف الأكبر رموزاً أقل في الثانية، لذا يُتوقع أن يكون Qwen3.5 0.8B وحده أسرع من Qwen3 1.7B، بجودة أقل. أما Qwen3.5 2B و4B فيستحقان التجربة إن كنت تقدّم التدريب الأحدث على السرعة. لم تقس PromptQuorum سرعة Qwen3.5 على أجهزة هذا الدليل.
ما أكبر نموذج يمكنني تشغيله على CPU فقط؟
الحد هو الرام الحرة لاستيعاب الملف مع السياق. يدرج Ollama نحو 5.2 GB لـ Qwen3 8B، و9.3 GB لـ Qwen3 14B، و20 GB لـ Qwen3 32B، فالقاعدة التقريبية 0.65 GB لكل مليار معامل بصيغة Q4. يستطيع كمبيوتر بذاكرة 32 جيجابايت استيعاب Qwen3 32B، لكن سقف عرض النطاق على DDR5-5600 ثنائية القناة نحو 4.5 tok/s (89.6 GB/s ÷ 20 GB)، مما يجعله أداة للمهام الدفعية. أما نماذج مزيج الخبراء مثل Qwen3 30B-A3B (19 GB) فتقرأ بضعة مليارات من المعاملات النشطة فقط لكل رمز، فيُتوقع أن تعمل أسرع مما يوحي به حجم ملفها.
المصادر
- بطاقة نموذج Phi-4 Mini — Microsoft Research. نتائج اختبارات أبلغ عنها المطوّر؛ أُطلق في 2025.
- مكتبة Ollama: Qwen3 — أحجام الملفات وأطوال السياق لـ qwen3:0.6b و1.7b و4b و8b (روجع في 2026-10-23).
- مكتبة Ollama: Qwen3.5 — أحجام الملفات لـ qwen3.5:0.8b و2b و4b (روجع في 2026-10-23).
- مكتبة Ollama: Gemma 4 — حجم تنزيل gemma4:e2b وسياق 128K (روجع في 2026-10-23).
- مكتبة Ollama: Phi-4-mini — 2.5 GB، سياق 128K (روجع في 2026-10-23).
- مكتبة Ollama: nomic-embed-text — نموذج تضمين بحجم 274 MB ونافذة سياق 2K (روجع في 2026-10-23).
- توثيق Ollama: دعم GPU — Vulkan وROCm ومتغيرات اختيار GPU ومنها OLLAMA_VULKAN.
- توثيق Ollama: الأسئلة الشائعة — OLLAMA_CONTEXT_LENGTH وOLLAMA_KV_CACHE_TYPE وOLLAMA_FLASH_ATTENTION وOLLAMA_KEEP_ALIVE والأمر `ollama ps`.
- مواصفات معالج Intel N100 — قناة ذاكرة واحدة؛ DDR4-3200 وDDR5-4800 وLPDDR5-4800.
- تغطية إعلان Gemma 4 — تاريخ الإصدار 2 أبريل 2026، نحو 2.3B معاملاً فعّالاً و5.1B إجمالاً (ملخص من طرف ثالث).
- توثيق بناء llama.cpp — واجهات CPU الخلفية وخيارات البناء.