هل تستطيع وحدات CPU تشغيل LLM؟
نعم، تستطيع وحدات CPU الحديثة (مثل Intel Core الجيل العاشر فأحدث، وAMD Ryzen 5000 فأحدث، ومعالجات Apple M-series) تشغيل نماذج 3–8B بسرعة مقدّرة 8–30 رمزًا في الثانية على ذاكرة ثنائية القناة. هذا عادةً أبطأ بمقدار 5–10× أو أكثر من GPU منفصل، لكنه لا يحتاج إلى VRAM. يستطيع حاسوب بذاكرة نظام 8–32 GB تشغيل نماذج كانت ستتطلب لولا ذلك بطاقة رسومات مخصصة.
يقايض الاستدلال على CPU السرعة بسهولة الوصول: لا إعداد لتعريفات GPU ولا حد لـ VRAM، بل ذاكرة النظام فقط. وفي الاستخدامات العرضية (روبوت دردشة لمستخدم واحد، أو معالجة مستندات دون اتصال) يكون وضع CPU فقط عمليًا.
تحدد عرض النطاق الترددي للذاكرة السرعة، لا تردد المعالج: فتوليد كل رمز يقرأ ملف النموذج كاملًا من الذاكرة مرة واحدة، فيكون عدد الرموز في الثانية ≈ عرض النطاق ÷ حجم الملف (وهو حد أقصى؛ السرعة الفعلية أقل). كما يستخدم llama.cpp، الذي يُبنى عليه Ollama، تعليمات المتجهات في CPU مثل AVX2 أو ARM NEON حيث يدعمها المعالج.
تستطيع وحدات CPU الحديثة تشغيل نماذج LLM بحجم 3B–8B بسرعة مقدّرة 8–30 رمزًا في الثانية باستخدام تكميم Q4_K_M وllama.cpp أو Ollama، بحسب سرعة الذاكرة وحجم النموذج.
نعم. يستطيع حاسوب محمول أو مكتبي عادي بذاكرة RAM كافية تشغيل نموذج ذكاء اصطناعي صغير محليًا دون GPU. سيكون أبطأ من GPU، لكنه سريع بما يكفي للمهام التي لا تنتظر فيها الرد لحظيًا.
ما أفضل نماذج LLM على CPU فقط في 2026؟
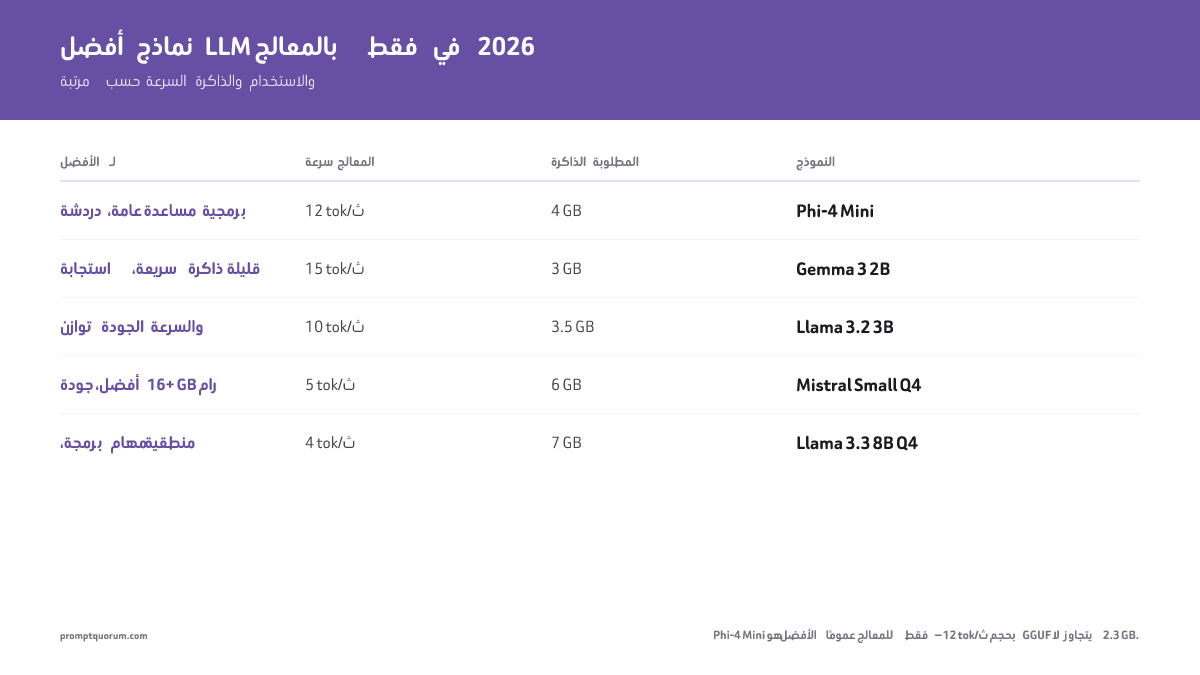
من بين النماذج الخمسة المقارَنة هنا، يُعد Phi-4 Mini (3.8B، Q4_K_M) الخيار العام الأفضل على CPU فقط في 2026: سرعة مقدّرة 15–25 tok/s على ذاكرة ثنائية القناة من ملف حجمه 2.5 GB. يعرض الجدول النماذج الخمسة بحسب حجم الملف والحاجة إلى RAM والسرعة المقدّرة. السرعات تقديرات خاصة بـ PromptQuorum مشتقة من الحد الأقصى لعرض النطاق الترددي للذاكرة (DDR4-3200 ثنائية القناة = 51.2 GB/s، وDDR5-5600 = 89.6 GB/s، مقسومًا على حجم ملف Ollama) لحاسوب مكتبي ثنائي القناة بذاكرة 16 GB؛ وهي ليست قياسات مخبرية. وتُنصّف الذاكرة أحادية القناة النتيجة. تقدير Gemma 4 E2B هو الأقل يقينًا لأن جزءًا من ملفه البالغ 4.6 GB جداول تضمين؛ تحقق من سرعتك الفعلية عبر `ollama run <model> --verbose`.
النموذج | المعاملات | الحجم (Ollama) | أدنى RAM | tok/s (تقدير) | الأفضل لـ |
|---|---|---|---|---|---|
| Phi-4 Mini | 3.8B | 2.5 GB | 3 GB | 15–25 | دردشة عامة، مساعدة برمجية |
| Llama 3.2 3B | 3B | 2.0 GB | 2.5–3 GB | 18–30 | أصغر ملف، أداء متوازن |
| Gemma 4 E2B | 2.3B فعلي / 5.1B إجمالي | 4.6 GB | 5–6 GB | 8–14 | سياق 128K، إدخال صور |
| Qwen3 8B | 8B | 5.2 GB | 6 GB | 8–15 | جودة أعلى، ذاكرة 16 GB |
| DeepSeek-R1 7B | 7B (تقطير Qwen) | 4.7 GB | 6 GB | 8–14 | الاستدلال، الرياضيات |
ما مدى سرعة CPU مقارنة بـ GPU؟
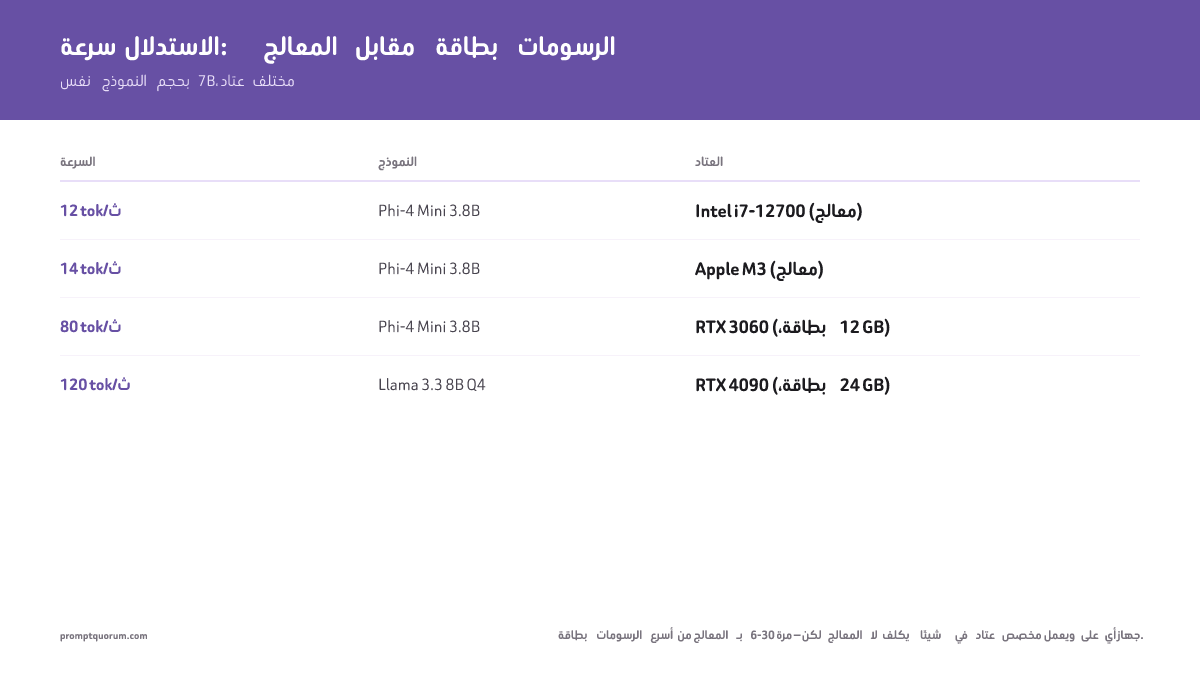
الاستدلال على CPU عادةً أبطأ بمقدار 5–10× أو أكثر من GPU منفصل، لأن GPU يملك عرض نطاق ترددي أكبر بمقدار 7–20×: تقدّم DDR4-3200 ثنائية القناة 51.2 GB/s، وبطاقة RTX 3060 12 GB تقدّم 360 GB/s، وبطاقة RTX 4090 تقدّم 1,008 GB/s. يطبّق الجدول قاعدة عرض النطاق (الحد الأقصى = عرض النطاق ÷ حجم الملف) على ملف Phi-4 Mini البالغ 2.5 GB. الحدود القصوى سقوف عليا؛ أما السرعات المقدّرة فهي تقريبات من PromptQuorum (نحو 75–100% من الحد الأقصى في تثبيت سليم)، وليست قياسات مخبرية. وأرقام عرض النطاق لـ GPU مأخوذة من مواصفات NVIDIA المنشورة. لم يُدرج Apple Silicon لأن Ollama يستخدم GPU افتراضيًا على Mac، فلا تنطبق قاعدة CPU فقط بالطريقة نفسها.
العتاد | عرض النطاق | النموذج | الحد الأقصى tok/s | tok/s (تقدير) |
|---|---|---|---|---|
| حاسوب مكتبي DDR4-3200 ثنائي القناة (CPU) | 51.2 GB/s | Phi-4 Mini 2.5 GB | ~20 | 15–20 |
| حاسوب مكتبي DDR5-5600 ثنائي القناة (CPU) | 89.6 GB/s | Phi-4 Mini 2.5 GB | ~36 | 25–32 |
| حاسوب محمول DDR4-3200 أحادي القناة (CPU) | 25.6 GB/s | Phi-4 Mini 2.5 GB | ~10 | 7–10 |
| RTX 3060 12 GB (GPU) | 360 GB/s | Phi-4 Mini 2.5 GB | ~144 | عادةً 5–10× من CPU |
| RTX 4090 24 GB (GPU) | 1,008 GB/s | Phi-4 Mini 2.5 GB | ~403 | حتى ~20× حد DDR4 |
كم RAM يحتاج كل نموذج على CPU فقط؟
القاعدة العامة: حجم ملف النموذج + نحو 500 MB عبء = الحد الأدنى من RAM، ويزيد ذلك مع السياق الطويل. يحتاج ملف بحجم 2.0 GB إلى نحو 2.5–3 GB من ذاكرة النظام الحرة. أحجام الملفات هي تنزيلات Ollama التي روجعت على ollama.com؛ وأطوال السياق هي القيم القصوى التي يدرجها Ollama، بينما السياق الافتراضي في Ollama هو 4096 رمزًا ما لم تضبط `OLLAMA_CONTEXT_LENGTH`:
النموذج | الحجم (Ollama) | أدنى RAM | مريح | طول السياق |
|---|---|---|---|---|
| Llama 3.2 3B | 2.0 GB | 2.5–3 GB | 6 GB | 128K |
| Phi-4 Mini 3.8B | 2.5 GB | 3 GB | 6 GB | 128K |
| Gemma 4 E2B | 4.6 GB | 5–6 GB | 8 GB | 128K |
| DeepSeek-R1 7B | 4.7 GB | 6 GB | 8 GB | 128K |
| Qwen3 8B | 5.2 GB | 6 GB | 8–16 GB | 40K |
كيف تفعّل الاستدلال على CPU فقط؟
Ollama (الأبسط): شغّل `ollama run phi4-mini`. يستخدم Ollama المعالج عندما لا يجد GPU مدعومة. ولفرض CPU على جهاز يحتوي GPU، اضبط `CUDA_VISIBLE_DEVICES=-1` (لبطاقات NVIDIA) أو `OLLAMA_VULKAN=0` (لوحدات GPU التي تعمل عبر Vulkan، ومنها بعض وحدات GPU المدمجة) قبل تشغيل Ollama، ثم تحقق من عمود PROCESSOR في `ollama ps`. LM Studio: اضبط شريط GPU offload على 0 طبقة عند تحميل النموذج. llama.cpp: استخدم `--n-gpu-layers 0` لتعطيل تفريغ الحمل إلى GPU.
ollama run phi4-mini
# in a second terminal, while the model is loaded:
ollama ps   # PROCESSOR column should read 100% CPU
كيف تزيد سرعة الاستدلال على CPU إلى أقصى حد؟
يحدد عرض النطاق الترددي للذاكرة وحجم الملف سرعة CPU، لذا تعطي الذاكرة ثنائية القناة وملف Q4_K_M أكبر مكسب. نصائح محددة:
- املأ قناتَي الذاكرة — شريحتا RAM متطابقتان تضاعفان ذروة عرض النطاق مقارنة بشريحة واحدة، وهذا أكبر تسريع منفرد على حاسوب CPU فقط.
- استخدم تكميم Q4_K_M — يصغر الملف بنحو 70% عن FP16 مع فقدان طفيف في الجودة، ولأن فك الترميز على CPU محدود بعرض النطاق فإن الملف الأصغر يولّد النص أسرع بنسبة مماثلة تقريبًا.
- قلّص نافذة السياق — السياق الأطول يكبّر KV cache ويبطئ معالجة المُدخل. اضبط `OLLAMA_CONTEXT_LENGTH=2048` (الافتراضي في Ollama هو 4096) أو استخدم `/set parameter num_ctx 2048` داخل `ollama run`.
- كمّم KV cache — يؤدي `OLLAMA_FLASH_ATTENTION=1` مع `OLLAMA_KV_CACHE_TYPE=q8_0` إلى تنصيف ذاكرة KV cache تقريبًا مقارنة بالافتراضي f16، وهذا يفيد أكثر في الأجهزة ذات 8 GB.
- أبقِ النموذج محمّلًا — يُفرغ Ollama النموذج بعد 5 دقائق افتراضيًا. يجنّبك `OLLAMA_KEEP_ALIVE=30m` إعادة تحميل الملف في كل جلسة.
- تحقق من عدد الخيوط — يختار Ollama الخيوط تلقائيًا؛ وفي llama.cpp اضبط `-t` على عدد أنويتك الفعلية. أغلق التطبيقات المستهلكة للذاكرة حتى لا يلجأ النموذج إلى التبديل (swap).
متى تستخدم CPU بدل GPU؟
حالة الاستخدام | CPU | GPU |
|---|---|---|
| دردشة فورية (زمن استجابة أقل من ثانية) | ⚠️ مقبول عند 15+ tok/s (تقدير)؛ أبطأ بقناة واحدة | ✅ عادةً أسرع بمقدار 5–10× |
| معالجة دفعية (مستندات، سجلات) | ✅ جيد (السرعة أقل أهمية) | ⚠️ مبالغ فيه |
| واجهة API إنتاجية (ميزانية محدودة) | ✅ يستخدم العتاد الموجود | ⚠️ تكلفة وطاقة إضافية لـ GPU |
| جهاز طرفي (Raspberry Pi) | ✅ غالبًا الخيار الوحيد | ❌ خيارات GPU محدودة |
| التطوير والتجارب المحلية | ✅ طاقة أقل، وأهدأ | ⚠️ مبالغ فيه |
| ضبط LLM دقيقًا (fine-tuning) | ❌ غير عملي (أبطأ بكثير) | ✅ أسرع بكثير |
الأسئلة الشائعة حول LLM على CPU فقط
ما مدى سرعة الاستدلال على CPU فقط مقارنة بـ GPU؟
بالنسبة إلى Phi-4 Mini (ملف 2.5 GB)، يبلغ الحد الأقصى على CPU نحو 20 tok/s على DDR4-3200 ثنائية القناة (51.2 GB/s) ونحو 36 tok/s على DDR5-5600 ثنائية القناة (89.6 GB/s)؛ وتقدير PromptQuorum للسرعة الفعلية هو 15–25 tok/s. يملك GPU المنفصل عرض نطاق ترددي أكبر بكثير (RTX 3060: 360 GB/s، وRTX 4090: 1,008 GB/s)، فهو عادةً أسرع بمقدار 5–10× أو أكثر. هذه تقديرات وليست قياسات مخبرية.
ما أصغر نموذج ما زال ينتج مخرجات متماسكة على CPU؟
تنخفض الجودة بسرعة دون نحو 2B معامل. يُعد Llama 3.2 3B (ملف 2.0 GB) وPhi-4 Mini (3.8B، 2.5 GB) أصغر خيارات هذا الدليل، ويقدّمان دردشة صالحة للاستخدام على ذاكرة 8 GB. وللاطلاع على ملفات أصغر، راجع دليل أسرع نماذج LLM المحلية للأجهزة منخفضة المواصفات.
هل يمكنني تشغيل نموذج 13B على CPU؟
نعم، لكنه بطيء. نموذج 13B بصيغة Q4_K_M ملف بحجم نحو 8 GB ويحتاج إلى 12 GB أو أكثر من ذاكرة النظام. يبلغ الحد الأقصى لعرض النطاق نحو 6 tok/s على DDR4-3200 ثنائية القناة (51.2 ÷ 8) ونحو 11 tok/s على DDR5-5600، والسرعة الفعلية أقل. يناسب ذلك المعالجة الدفعية لا الدردشة المباشرة.
هل يستخدم الاستدلال على CPU وحدة GPU إطلاقًا؟
ليس إذا عطّلتها. عند استخدام `CUDA_VISIBLE_DEVICES=-1` (لبطاقات NVIDIA) أو `OLLAMA_VULKAN=0` (لوحدات GPU عبر Vulkan) أو `--n-gpu-layers 0` في llama.cpp، يجري الاستدلال على CPU وذاكرة النظام فقط. تحقق من عمود PROCESSOR في `ollama ps` للتأكد.
هل الاستدلال على CPU فقط مستقر؟
يتجنب أنماط الفشل الخاصة بـ GPU مثل أعطال التعريفات وأخطاء نفاد ذاكرة GPU. الخطر المتبقي الرئيسي هو نفاد ذاكرة النظام، فيدفع ذلك النموذج إلى التبديل (swap) ويبطئ التوليد كثيرًا؛ ويمكنك التحكم في ذلك باختيار النموذج وطول السياق.
هل أحتاج إلى ضبط إعدادات لمعالجات Apple Silicon؟
عادةً لا. يستخدم Ollama معالج الرسومات في Apple عبر Metal والذاكرة الموحدة للشريحة افتراضيًا، فجهاز Mac ليس حالة CPU فقط. يختلف عرض النطاق الترددي للذاكرة بحسب الشريحة، فتنطبق القاعدة نفسها: عدد الرموز في الثانية ≈ عرض النطاق ÷ حجم ملف النموذج.
كم VRAM يحتاج نموذج 7B في وضع CPU فقط؟
لا VRAM مخصصة إطلاقًا. يحتاج نموذج 7B بصيغة Q4_K_M (ملف deepseek-r1:7b في Ollama بحجم 4.7 GB) إلى نحو 6 GB من ذاكرة النظام ليعمل براحة. هذه هي الميزة الجوهرية للاستدلال على CPU فقط: لا حاجة إلى GPU أو VRAM.
هل يمكنني إجراء fine-tuning لـ LLM على CPU؟
من الناحية التقنية نعم، لكنه غير عملي: التدريب على CPU أبطأ بكثير منه على GPU. استخدم وضع CPU فقط للاستدلال، وانتقل إلى GPU لأي مهمة fine-tuning أو تدريب.
هل يمكنني تشغيل عدة نماذج في وقت واحد على CPU؟
ممكن تقنيًا إذا سمحت الذاكرة، لكنه غير عملي. تتنافس النماذج المحمّلة معًا على عرض النطاق الترددي نفسه للذاكرة، فيولّد كل منها أبطأ. شغّل نموذجًا واحدًا في كل مرة لأفضل سرعة، وراجع `OLLAMA_NUM_PARALLEL` و`OLLAMA_KEEP_ALIVE` في الأسئلة الشائعة لـ Ollama إذا كنت تخدم عدة طلبات.
ما المخاطر الأمنية للاستدلال على CPU فقط؟
التشغيل المحلي يعني أن المُدخلات لا يلزم أن تغادر جهازك، وهذا يزيل خطر النقل في واجهات API السحابية. المخاطر المتبقية هي مخاطر أي برنامج محلي: أبقِ نظام التشغيل محدّثًا وأمّن الجهاز ماديًا، لأن البيانات الحساسة قد تبقى غير مشفّرة على القرص.
هل يوجد فرق في السرعة بين Ollama وllama.cpp للاستدلال على CPU؟
لم تقِس PromptQuorum ذلك. يُبنى Ollama على llama.cpp، فكلاهما يعتمد على النوع نفسه من تحسينات CPU، وأي فرق يأتي أساسًا من إدارة الخيوط والإعدادات الافتراضية. ابدأ بإعدادات Ollama الافتراضية، واستخدم llama.cpp إذا احتجت إلى أعلام أدق مثل `-t`. قارن بينهما على جهازك عبر `ollama run <model> --verbose`.
هل الاستدلال على CPU فقط عملي على حاسوب محمول قديم بذاكرة 8–10 GB؟
نعم، مع نموذج صغير. يتسع Llama 3.2 3B (2.0 GB) أو Phi-4 Mini (2.5 GB) ضمن 8–10 GB من الذاكرة. على حاسوب محمول بذاكرة DDR4-3200 أحادية القناة يبلغ الحد الأقصى نحو 10 tok/s لـ Phi-4 Mini، فتوقّع سرعة مقدّرة 5–10 tok/s: مناسبة لروبوت دردشة خفيف أو عمل دفعي، وبطيئة للدردشة السريعة المتبادلة.
هل تستطيع وحدات CPU تشغيل LLM؟
نعم. تستطيع وحدات CPU الحديثة (مثل Intel Core الجيل العاشر فأحدث، وAMD Ryzen 5000 فأحدث) تشغيل نماذج 3–8B بسرعة مقدّرة 8–30 tok/s على ذاكرة ثنائية القناة، بحسب حجم النموذج. هذا عادةً أبطأ بمقدار 5–10× أو أكثر من GPU منفصل، لكنه لا يتطلب VRAM مخصصة.
ما أفضل LLM على CPU فقط؟
من بين النماذج المقارَنة هنا، يُعد Phi-4 Mini (3.8B، ملف 2.5 GB) الخيار العام الأفضل بسرعة مقدّرة 15–25 tok/s. وللملف الأصغر: Llama 3.2 3B (2.0 GB، سرعة مقدّرة 18–30 tok/s). وللجودة على ذاكرة 16 GB: Qwen3 8B (5.2 GB، سرعة مقدّرة 8–15 tok/s). أما Gemma 4 E2B فتنزيله 4.6 GB، فليس خيار السرعة.
كم RAM أحتاج للاستدلال على CPU فقط؟
استخدم القاعدة: حجم ملف النموذج + نحو 500 MB عبء، ويزيد ذلك مع السياق الطويل. يحتاج Phi-4 Mini (2.5 GB) إلى نحو 3 GB، وLlama 3.2 3B (2.0 GB) إلى نحو 2.5–3 GB، وGemma 4 E2B (4.6 GB) إلى نحو 5–6 GB، وQwen3 8B (5.2 GB) إلى نحو 6 GB.
كيف أفعّل وضع CPU فقط؟
في Ollama شغّل `ollama run phi4-mini`؛ فهو يستخدم المعالج عندما لا يجد GPU مدعومة. ولفرض CPU على جهاز يحتوي GPU، اضبط `CUDA_VISIBLE_DEVICES=-1` أو `OLLAMA_VULKAN=0`. وفي llama.cpp استخدم `--n-gpu-layers 0`. وفي LM Studio اضبط GPU offload على 0 طبقة. وتأكد عبر `ollama ps`.
هل الاستدلال على CPU عملي للإنتاج؟
نعم، إذا لم تكن بحاجة إلى زمن استجابة فوري. تعمل المعالجة الدفعية وواجهات API غير المتزامنة وسير العمل دون اتصال على CPU. يخدم CPU مستخدمًا واحدًا بسرعة منخفضة، لذا استخدم GPU للدردشة التفاعلية بزمن استجابة أقل من ثانية أو لعدد كبير من المستخدمين المتزامنين.
أي نماذج CPU فقط تتعامل مع السياق الطويل بأفضل شكل؟
في Ollama، يدرج كل من Gemma 4 E2B وPhi-4 Mini وLlama 3.2 3B وDeepSeek-R1 7B نافذة سياق 128K، ويدرج Qwen3 8B نافذة 40K. السياق الافتراضي في Ollama هو 4096 رمزًا فقط ما لم تضبط `OLLAMA_CONTEXT_LENGTH`. والسياق الطويل ليس مجانيًا على CPU: فمعالجة المُدخل تزداد مع عدد الرموز التي تحمّلها، ويكبر KV cache، فقد تستغرق نافذة طويلة جدًا دقائق لتمتلئ قبل ظهور أول رمز. وإذا لم تكن بحاجة إلى النافذة كاملة، فحدّدها عبر `OLLAMA_CONTEXT_LENGTH` لتعود الإجابات أسرع بوضوح.
الخطوات التالية
- أسرع نماذج LLM المحلية للأجهزة منخفضة المواصفات — جهاز قديم أو منخفض المواصفات؟ سرعات مقدّرة بحسب فئة RAM →
- شرح تكميم LLM — لماذا يهم Q4_K_M لسرعة الاستدلال على CPU →
- أفضل نماذج LLM المحلية للبرمجة — نماذج برمجة خفيفة يمكن تشغيلها على CPU →
لماذا تهم نماذج LLM على CPU فقط في النشر الحساس للخصوصية
الاتحاد الأوروبي / GDPR: عندما يعمل النموذج دون اتصال على CPU الخاص بك، لا يلزم أن تغادر المُدخلات والمستندات الجهاز، وهو لدى كثير من الفرق الصغيرة طريقة مباشرة تقنيًا لتجنب أسئلة النقل إلى دول ثالثة بموجب المادة 44 من GDPR. ويعتمد انطباق GDPR أو قانون الذكاء الاصطناعي الأوروبي أو غيرهما على من ينشر النظام ولأي غرض؛ وهذا الدليل ليس استشارة قانونية، والامتثال الشامل يعتمد على إعدادك الكامل لا على بنية الاستدلال وحدها.
البيئات دون اتصال أو ضعيفة الاتصال: تعمل نماذج CPU دون اتصال موثوق بالإنترنت. فملف نموذج مثل Phi-4 Mini تنزّله مرة واحدة يمكن تشغيله دون وصول إضافي إلى الشبكة، وهذا يفيد في المناطق ذات الاتصال غير المستقر أو النطاق الترددي المحدود الكمية.
ما أخطاء الاستدلال على CPU الشائعة؟
- تشغيل FP16 بدل Q4_K_M. ملف Phi-4 Mini بصيغة FP16 نحو 7.6 GB مقابل 2.5 GB بصيغة Q4_K_M، فينخفض الحد الأقصى لعرض النطاق من نحو 20 إلى نحو 7 tok/s على DDR4-3200 ثنائية القناة. استخدم نماذج GGUF المكمَّمة للاستدلال على CPU.
- نسيان فرض CPU فقط في llama.cpp. من دون أعلام صريحة، قد يفرّغ إصدار يدعم GPU بعض الطبقات إليها. اضبط `--n-gpu-layers 0` لوضع CPU الخالص.
- استخدام شريحة RAM واحدة. تُنصّف القناة الواحدة ذروة عرض النطاق، فيولّد النموذج نفسه بنحو نصف السرعة. ركّب شريحتين متطابقتين قبل التفكير في شراء CPU أسرع.
- اختيار نموذج أكبر من اللازم. Phi-4 Mini (2.5 GB، حد أقصى نحو 20 tok/s على DDR4-3200 ثنائية القناة) أكثر راحة بكثير للاستخدام التفاعلي من DeepSeek-R1 7B (4.7 GB، حد أقصى نحو 11 tok/s). اختر حجم النموذج بما يناسب عرض نطاق الذاكرة، لا بحسب RAM الحرة فقط.
- استخدام وسم Ollama الخاطئ. الأمر `ollama run phi` يحمّل Phi-2 لا Phi-4 Mini. استخدم `ollama run phi4-mini`، وراجع ollama.com/library لمعرفة وسوم النماذج الدقيقة.
المصادر
- llama.cpp على GitHub — الاستدلال على CPU وخيارات الخيوط وتفريغ الحمل إلى GPU
- الأسئلة الشائعة لـ Ollama — طول السياق ونوع KV cache وkeep-alive وتقسيم CPU/GPU في ollama ps
- توثيق GPU في Ollama — فرض CPU فقط وOLLAMA_VULKAN ووحدات GPU المدعومة
- مكتبة Ollama: phi4-mini — 2.5 GB، سياق 128K
- مكتبة Ollama: llama3.2 — ملف 3B بحجم 2.0 GB، سياق 128K
- مكتبة Ollama: gemma4 — تنزيل e2b بحجم 4.6–7.5 GB، سياق 128K، 2.3B معاملًا فعليًا / 5.1B إجمالًا
- مكتبة Ollama: qwen3 — ملف 8B بحجم 5.2 GB، سياق 40K
- مكتبة Ollama: deepseek-r1 — ملف 7B بحجم 4.7 GB، مقطَّر من Qwen2.5
- بطاقة نموذج Microsoft Phi-4-mini-instruct — Hugging Face
- مواصفات NVIDIA GeForce RTX 3060 — عرض النطاق الترددي للذاكرة
- مواصفات NVIDIA GeForce RTX 4090 — عرض النطاق الترددي للذاكرة
- ملخص Gemma 4 E2B — llm-stats (جهة خارجية)