CPU로 LLM을 실행할 수 있습니까?
예, 최신 CPU(예: Intel Core 10세대 이상, AMD Ryzen 5000 이상, Apple M 시리즈)는 듀얼 채널 RAM에서 3~8B 모델을 추정 초당 8–30 토큰으로 실행할 수 있습니다. 외장 GPU보다 보통 5–10배 이상 느리지만 VRAM은 필요하지 않습니다. 시스템 RAM 8~32 GB를 갖춘 PC라면 원래 전용 그래픽카드가 필요한 모델도 실행할 수 있습니다.
CPU 추론은 속도를 내주고 접근성을 얻는 방식입니다. GPU 드라이버 설정이 없고 VRAM 한도도 없으며 시스템 RAM만 있으면 됩니다. 사용자 한 명을 위한 챗봇, 오프라인 문서 처리 같은 일상적인 용도에서는 CPU 전용도 실용적입니다.
속도를 정하는 것은 클럭 속도가 아니라 메모리 대역폭입니다. 토큰을 하나 생성할 때마다 모델 파일 전체를 RAM에서 한 번 읽으므로 초당 토큰 수 ≈ 메모리 대역폭 ÷ 파일 크기입니다(상한이며 실제 속도는 더 낮습니다). Ollama의 기반인 llama.cpp는 프로세서가 지원하는 경우 AVX2나 ARM NEON 같은 CPU 벡터 명령어도 활용합니다.
최신 CPU는 Q4_K_M 양자화와 llama.cpp 또는 Ollama를 사용해 3B~8B LLM을 RAM 속도와 모델 크기에 따라 추정 초당 8–30 토큰으로 실행할 수 있습니다.
예. RAM이 충분한 일반 노트북이나 데스크톱이라면 GPU 없이도 작은 AI 모델을 로컬에서 실행할 수 있습니다. GPU보다는 느리지만, 실시간으로 기다리지 않아도 되는 작업에는 충분히 빠릅니다.
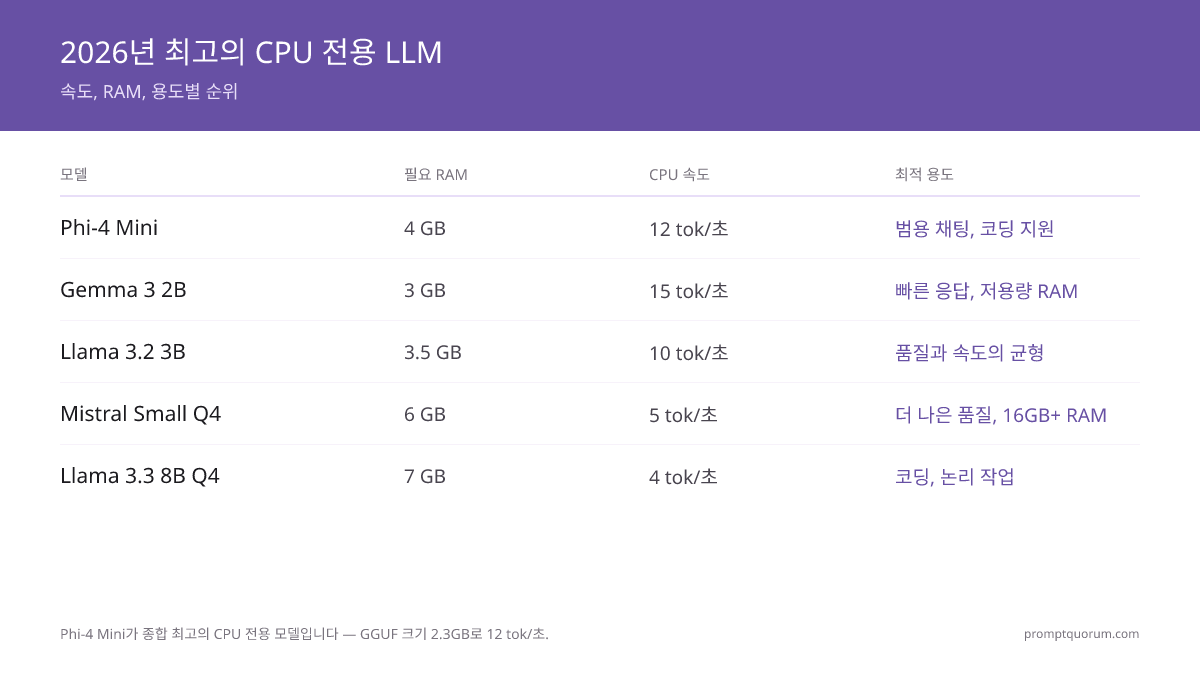
2026년 최고의 CPU 전용 LLM은 무엇입니까?
여기서 비교한 5개 모델 중 Phi-4 Mini(3.8B, Q4_K_M)가 2026년 기준 가장 균형 잡힌 CPU 전용 선택입니다. 2.5 GB 파일로 듀얼 채널 RAM에서 추정 15–25 tok/s를 냅니다. 표는 5개 모델을 파일 크기, 필요 RAM, 추정 속도로 정리한 것입니다. 속도는 메모리 대역폭 상한(듀얼 채널 DDR4-3200 = 51.2 GB/s, DDR5-5600 = 89.6 GB/s를 Ollama 파일 크기로 나눈 값)에서 도출한 PromptQuorum 자체 추정치이며, 16 GB 듀얼 채널 데스크톱 기준입니다. 실험실 측정값이 아닙니다. 단일 채널 RAM은 결과를 절반으로 줄입니다. Gemma 4 E2B는 4.6 GB 파일 중 일부가 임베딩 테이블이라 추정의 불확실성이 가장 큽니다. 직접 속도를 확인하려면 `ollama run <model> --verbose`를 사용하십시오.
모델 | 파라미터 | 파일(Ollama) | 최소 RAM | 추정 tok/s | 최적 용도 |
|---|---|---|---|---|---|
| Phi-4 Mini | 3.8B | 2.5 GB | 3 GB | 15–25 | 일반 채팅, 코드 지원 |
| Llama 3.2 3B | 3B | 2.0 GB | 2.5–3 GB | 18–30 | 가장 작은 파일, 균형형 |
| Gemma 4 E2B | 유효 2.3B / 전체 5.1B | 4.6 GB | 5–6 GB | 8–14 | 128K 컨텍스트, 이미지 입력 |
| Qwen3 8B | 8B | 5.2 GB | 6 GB | 8–15 | 더 높은 품질, 16 GB RAM |
| DeepSeek-R1 7B | 7B (Qwen 증류) | 4.7 GB | 6 GB | 8–14 | 추론, 수학 |
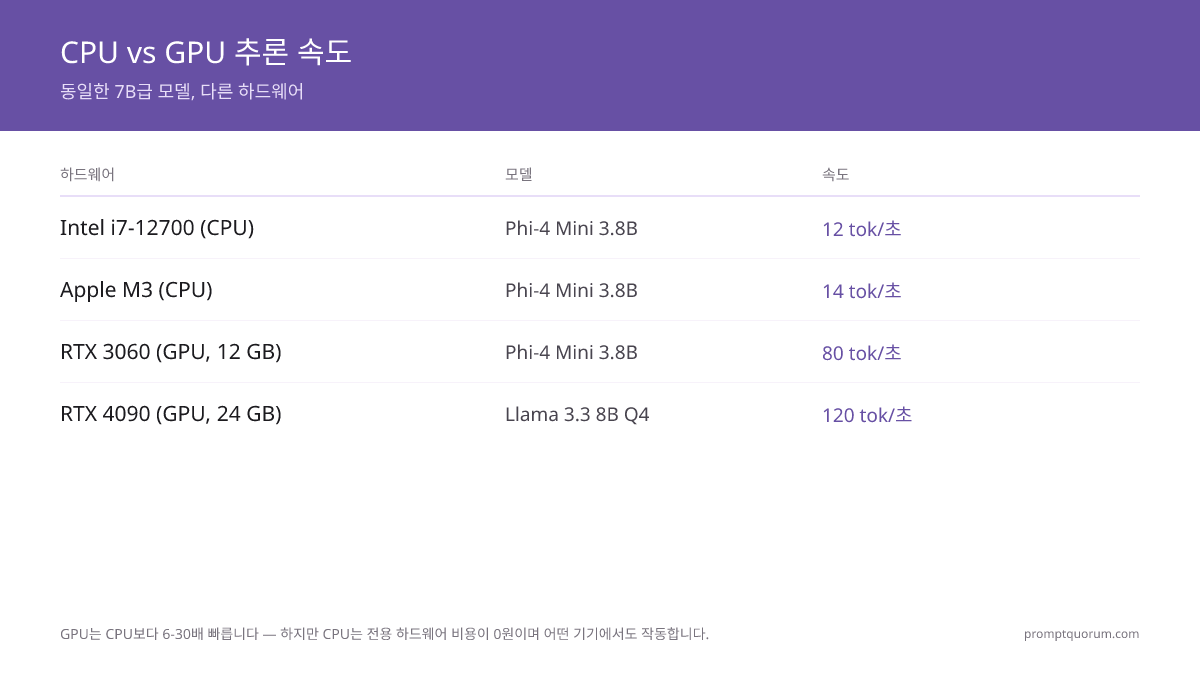
CPU와 GPU 추론의 속도는 얼마나 차이 납니까?
CPU 추론은 GPU의 메모리 대역폭이 7–20배 높기 때문에 외장 GPU보다 보통 5–10배 이상 느립니다. 듀얼 채널 DDR4-3200은 51.2 GB/s, RTX 3060 12 GB는 360 GB/s, RTX 4090은 1,008 GB/s입니다. 표는 대역폭 규칙(상한 = 대역폭 ÷ 파일 크기)을 2.5 GB Phi-4 Mini 파일에 적용한 것입니다. 상한은 이론적인 최댓값이며, 추정 속도는 정상 설치에서 상한의 대략 75–100%로 본 PromptQuorum의 근사치로 실험실 측정값이 아닙니다. GPU 대역폭 수치는 NVIDIA의 공개 사양에서 가져왔습니다. Mac에서는 Ollama가 기본적으로 GPU를 사용하므로 CPU 전용 규칙이 같은 방식으로 적용되지 않아 Apple Silicon은 표에 넣지 않았습니다.
하드웨어 | 대역폭 | 모델 | 상한 tok/s | 추정 tok/s |
|---|---|---|---|---|
| 듀얼 채널 DDR4-3200 데스크톱 (CPU) | 51.2 GB/s | Phi-4 Mini 2.5 GB | ~20 | 15–20 |
| 듀얼 채널 DDR5-5600 데스크톱 (CPU) | 89.6 GB/s | Phi-4 Mini 2.5 GB | ~36 | 25–32 |
| 단일 채널 DDR4-3200 노트북 (CPU) | 25.6 GB/s | Phi-4 Mini 2.5 GB | ~10 | 7–10 |
| RTX 3060 12 GB (GPU) | 360 GB/s | Phi-4 Mini 2.5 GB | ~144 | 보통 CPU의 5–10배 |
| RTX 4090 24 GB (GPU) | 1,008 GB/s | Phi-4 Mini 2.5 GB | ~403 | DDR4 상한의 최대 ~20배 |
각 CPU 전용 모델에는 RAM이 얼마나 필요합니까?
경험칙: 모델 파일 크기 + 약 500 MB 오버헤드 = 최소 RAM이며, 컨텍스트가 길면 더 필요합니다. 2.0 GB 파일에는 여유 시스템 RAM이 대략 2.5–3 GB 필요합니다. 파일 크기는 ollama.com에서 확인한 Ollama 다운로드 기준이고, 컨텍스트 길이는 Ollama가 표시하는 최댓값입니다. Ollama의 기본 컨텍스트는 `OLLAMA_CONTEXT_LENGTH`를 설정하지 않으면 4096 토큰입니다.
모델 | 파일(Ollama) | 최소 RAM | 여유 있는 RAM | 컨텍스트 길이 |
|---|---|---|---|---|
| Llama 3.2 3B | 2.0 GB | 2.5–3 GB | 6 GB | 128K |
| Phi-4 Mini 3.8B | 2.5 GB | 3 GB | 6 GB | 128K |
| Gemma 4 E2B | 4.6 GB | 5–6 GB | 8 GB | 128K |
| DeepSeek-R1 7B | 4.7 GB | 6 GB | 8 GB | 128K |
| Qwen3 8B | 5.2 GB | 6 GB | 8–16 GB | 40K |
CPU 전용 추론은 어떻게 활성화합니까?
Ollama(가장 간단): `ollama run phi4-mini`를 실행하십시오. Ollama는 지원되는 GPU를 찾지 못하면 CPU를 사용합니다. GPU가 있는 머신에서 CPU를 강제하려면 Ollama를 시작하기 전에 `CUDA_VISIBLE_DEVICES=-1`(NVIDIA) 또는 `OLLAMA_VULKAN=0`(일부 내장 GPU를 포함한 Vulkan GPU)을 설정한 다음 `ollama ps`의 PROCESSOR 열을 확인하십시오. LM Studio: 모델을 불러올 때 GPU 오프로드 슬라이더를 0 레이어로 설정합니다. llama.cpp: `--n-gpu-layers 0`을 사용해 GPU 오프로딩을 비활성화합니다.
ollama run phi4-mini
# in a second terminal, while the model is loaded:
ollama ps   # PROCESSOR column should read 100% CPU
CPU 추론 속도를 최대로 높이려면 어떻게 합니까?
CPU 속도는 메모리 대역폭과 파일 크기가 정하므로, 듀얼 채널 RAM과 Q4_K_M 파일이 가장 큰 효과를 냅니다. 구체적인 팁은 다음과 같습니다.
- 두 메모리 채널 모두 채우기 — 같은 규격의 RAM 모듈 2개는 1개보다 최대 메모리 대역폭이 2배이며, CPU 전용 PC에서 가장 큰 단일 속도 향상 방법입니다.
- Q4_K_M 양자화 사용 — 파일이 FP16보다 약 70% 작고 품질 손실은 작습니다. CPU 디코딩은 대역폭에 제한되므로 파일이 작을수록 거의 같은 비율로 더 빠르게 생성합니다.
- 컨텍스트 윈도우 줄이기 — 컨텍스트가 길수록 KV 캐시가 커지고 프롬프트 처리가 느려집니다. `OLLAMA_CONTEXT_LENGTH=2048`(Ollama 기본값은 4096)을 설정하거나 `ollama run` 안에서 `/set parameter num_ctx 2048`을 사용하십시오.
- KV 캐시 양자화 — `OLLAMA_FLASH_ATTENTION=1`과 `OLLAMA_KV_CACHE_TYPE=q8_0`을 함께 쓰면 기본값인 f16에 비해 KV 캐시 메모리가 대략 절반으로 줄어, 8 GB 머신에서 가장 도움이 됩니다.
- 모델을 메모리에 유지하기 — Ollama는 기본적으로 5분 후 모델을 언로드합니다. `OLLAMA_KEEP_ALIVE=30m`을 설정하면 세션마다 파일을 다시 불러오지 않아도 됩니다.
- 스레드 수 확인 — Ollama는 스레드를 자동으로 선택합니다. llama.cpp에서는 `-t`를 물리 코어 수로 설정하십시오. 모델이 스왑되지 않도록 메모리를 많이 쓰는 앱은 닫으십시오.
GPU 대신 CPU를 사용해야 하는 경우는 언제입니까?
사용 사례 | CPU | GPU |
|---|---|---|
| 실시간 채팅(1초 미만 지연) | ⚠️ 15+ tok/s(추정)면 사용 가능, 단일 채널은 더 느림 | ✅ 보통 5–10배 빠름 |
| 배치 처리(문서, 로그) | ✅ 적합(속도는 덜 중요) | ⚠️ 과한 사양 |
| 프로덕션 API(비용 제약) | ✅ 기존 하드웨어 활용 | ⚠️ GPU 비용과 전력 추가 |
| 엣지 디바이스(Raspberry Pi) | ✅ 유일한 선택인 경우가 많음 | ❌ GPU 선택지 제한적 |
| 개발 / 로컬 작업 | ✅ 저전력, 조용함 | ⚠️ 과한 사양 |
| LLM 파인튜닝 | ❌ 비현실적(훨씬 느림) | ✅ 훨씬 빠름 |
CPU 전용 LLM에 관한 자주 묻는 질문
CPU 전용 추론은 GPU에 비해 얼마나 빠릅니까?
Phi-4 Mini(파일 2.5 GB)의 CPU 상한은 듀얼 채널 DDR4-3200(51.2 GB/s)에서 약 20 tok/s, 듀얼 채널 DDR5-5600(89.6 GB/s)에서 약 36 tok/s이며, PromptQuorum의 추정치는 실제로 15–25 tok/s입니다. 외장 GPU는 메모리 대역폭이 훨씬 높아(RTX 3060: 360 GB/s, RTX 4090: 1,008 GB/s) 보통 5–10배 이상 빠릅니다. 이 수치는 추정치이며 실험실 측정값이 아닙니다.
CPU에서 일관된 출력을 생성하는 가장 작은 모델은 무엇입니까?
대략 2B 파라미터 아래에서는 품질이 급격히 떨어집니다. Llama 3.2 3B(파일 2.0 GB)와 Phi-4 Mini(3.8B, 2.5 GB)가 이 가이드에서 가장 작은 선택이며 8 GB RAM에서 쓸 만한 채팅을 제공합니다. 더 작은 파일이 필요하면 저사양 PC용 가장 빠른 로컬 LLM 가이드를 참고하십시오.
CPU에서 13B 모델을 실행할 수 있습니까?
예, 하지만 느립니다. Q4_K_M의 13B 모델은 파일이 대략 8 GB이고 시스템 RAM이 12 GB 이상 필요합니다. 대역폭 상한은 듀얼 채널 DDR4-3200에서 약 6 tok/s(51.2 ÷ 8), DDR5-5600에서 약 11 tok/s이며 실제 속도는 더 낮습니다. 실시간 채팅보다는 배치 처리에 적합합니다.
CPU 추론 시 GPU를 전혀 사용하지 않습니까?
강제로 끄면 사용하지 않습니다. `CUDA_VISIBLE_DEVICES=-1`(NVIDIA), `OLLAMA_VULKAN=0`(Vulkan GPU) 또는 llama.cpp의 `--n-gpu-layers 0`을 쓰면 추론이 CPU와 시스템 RAM에서만 실행됩니다. `ollama ps`의 PROCESSOR 열로 확인하십시오.
CPU 전용 추론은 안정적입니까?
드라이버 충돌이나 GPU 메모리 부족 오류 같은 GPU 고유의 문제를 피할 수 있습니다. 남는 주요 위험은 시스템 RAM 부족으로, 모델이 스왑으로 밀려 생성 속도가 크게 떨어집니다. 모델 선택과 컨텍스트 길이로 이를 제어할 수 있습니다.
Apple Silicon CPU를 위해 설정을 조정해야 합니까?
보통은 필요 없습니다. Ollama는 기본적으로 Metal을 통해 Apple GPU와 칩의 통합 메모리를 사용하므로 Mac은 CPU 전용 사례가 아닙니다. 메모리 대역폭은 칩마다 다르지만 같은 규칙이 적용됩니다. 초당 토큰 수 ≈ 메모리 대역폭 ÷ 모델 파일 크기입니다.
CPU 전용 모드에서 7B 모델은 VRAM이 얼마나 필요합니까?
전용 VRAM은 전혀 필요하지 않습니다. Q4_K_M의 7B 모델(Ollama deepseek-r1:7b 파일은 4.7 GB)은 편하게 실행하려면 시스템 RAM이 대략 6 GB 필요합니다. 이것이 CPU 전용 추론의 핵심 장점으로, GPU도 VRAM도 필요하지 않습니다.
CPU에서 LLM을 파인튜닝할 수 있습니까?
기술적으로는 가능하지만 비현실적입니다. 학습은 CPU에서 GPU보다 훨씬 느립니다. CPU 전용 모드는 추론에 쓰고, 파인튜닝이나 학습 작업에는 GPU로 전환하십시오.
CPU에서 여러 모델을 동시에 실행할 수 있습니까?
RAM이 허용하면 기술적으로 가능하지만 실용적이지 않습니다. 함께 불러온 모델은 같은 메모리 대역폭을 두고 경쟁하므로 각각 더 느리게 생성합니다. 최고 속도를 위해 한 번에 하나의 모델만 실행하십시오. 여러 요청을 처리한다면 Ollama FAQ의 `OLLAMA_NUM_PARALLEL`과 `OLLAMA_KEEP_ALIVE`를 참고하십시오.
CPU 전용 추론의 보안 위험은 무엇입니까?
로컬에서 실행하면 프롬프트가 기기를 떠날 필요가 없으므로 클라우드 API의 전송 위험이 사라집니다. 남는 위험은 모든 로컬 소프트웨어와 같습니다. 민감한 데이터가 암호화되지 않은 채 디스크에 남아 있을 수 있으므로 운영체제를 최신 상태로 유지하고 기기를 물리적으로 보호하십시오.
CPU 추론에서 Ollama와 llama.cpp 사이에 속도 차이가 있습니까?
PromptQuorum은 두 도구의 속도 차이를 따로 확인한 수치가 없습니다. Ollama는 llama.cpp를 기반으로 하므로 둘 다 같은 종류의 CPU 최적화를 사용하며, 차이가 있다면 주로 스레드 처리와 기본 설정에서 비롯됩니다. Ollama의 기본 설정으로 시작하고, `-t` 같은 세부 플래그가 필요하면 llama.cpp를 사용하십시오. 두 도구는 `ollama run <model> --verbose`로 직접 비교해 보십시오.
RAM이 8~10 GB인 오래된 노트북에서도 CPU 전용 추론이 실용적입니까?
예, 작은 모델이라면 가능합니다. Llama 3.2 3B(2.0 GB) 또는 Phi-4 Mini(2.5 GB)는 8~10 GB RAM 안에 들어갑니다. 단일 채널 DDR4-3200 노트북에서 Phi-4 Mini의 상한은 약 10 tok/s이므로 추정 5–10 tok/s를 예상하십시오. 가벼운 챗봇이나 배치 작업에는 괜찮지만 빠르게 주고받는 채팅에는 느립니다.
CPU로 LLM을 실행할 수 있습니까?
예. 최신 CPU(예: Intel Core 10세대 이상, AMD Ryzen 5000 이상)는 모델 크기에 따라 듀얼 채널 RAM에서 3~8B 모델을 추정 8–30 tok/s로 실행할 수 있습니다. 외장 GPU보다 보통 5–10배 이상 느리지만 전용 VRAM은 필요하지 않습니다.
최고의 CPU 전용 LLM은 무엇입니까?
여기서 비교한 모델 중 Phi-4 Mini(3.8B, 파일 2.5 GB)가 추정 15–25 tok/s로 가장 균형 잡힌 선택입니다. 가장 작은 파일은 Llama 3.2 3B(2.0 GB, 추정 18–30 tok/s)입니다. 16 GB RAM에서의 품질은 Qwen3 8B(5.2 GB, 추정 8–15 tok/s)입니다. Gemma 4 E2B는 다운로드가 4.6 GB이므로 속도 중심 선택은 아닙니다.
CPU 전용 추론에는 RAM이 얼마나 필요합니까?
모델 파일 크기 + 약 500 MB 오버헤드를 기준으로 하고, 컨텍스트가 길면 더 필요합니다. Phi-4 Mini(2.5 GB)는 약 3 GB, Llama 3.2 3B(2.0 GB)는 약 2.5–3 GB, Gemma 4 E2B(4.6 GB)는 약 5–6 GB, Qwen3 8B(5.2 GB)는 약 6 GB가 필요합니다.
CPU 전용 모드를 어떻게 활성화합니까?
Ollama에서는 `ollama run phi4-mini`를 실행하면 지원되는 GPU가 없을 때 CPU를 사용합니다. GPU가 있는 머신에서 CPU를 강제하려면 `CUDA_VISIBLE_DEVICES=-1` 또는 `OLLAMA_VULKAN=0`을 설정하십시오. llama.cpp에서는 `--n-gpu-layers 0`을 사용하고, LM Studio에서는 GPU 오프로드를 0 레이어로 설정합니다. `ollama ps`로 확인하십시오.
CPU 추론은 프로덕션 환경에서 실용적입니까?
실시간 지연이 필요하지 않다면 예. 배치 처리, 비동기 API, 오프라인 워크플로는 CPU에서 작동합니다. CPU는 낮은 속도로 한 명의 사용자를 처리하므로, 1초 미만 지연의 대화형 채팅이나 동시 사용자가 많은 경우에는 GPU를 사용하십시오.
긴 컨텍스트를 가장 잘 처리하는 CPU 전용 모델은 무엇입니까?
Ollama에서 Gemma 4 E2B, Phi-4 Mini, Llama 3.2 3B, DeepSeek-R1 7B는 128K 컨텍스트 윈도우를, Qwen3 8B는 40K를 표시합니다. Ollama의 기본 컨텍스트는 `OLLAMA_CONTEXT_LENGTH`를 설정하지 않으면 4096 토큰뿐입니다. 긴 컨텍스트는 CPU에서 공짜가 아닙니다. 프롬프트 처리 시간은 불러오는 토큰 수에 비례해 늘어나고 KV 캐시도 커지므로, 매우 긴 윈도우는 첫 토큰이 나오기까지 몇 분이 걸릴 수 있습니다. 윈도우 전체가 필요하지 않다면 `OLLAMA_CONTEXT_LENGTH`로 제한하십시오. 답변이 눈에 띄게 빨리 돌아옵니다.
다음 단계
- 저사양 PC용 가장 빠른 로컬 LLM — 오래되었거나 저사양인 PC? RAM 등급별 추정 속도 →
- LLM 양자화 설명 — CPU 추론 속도에 Q4_K_M이 중요한 이유 →
- 코딩용 최고의 로컬 LLM — CPU에서 실행할 수 있는 경량 코딩 모델 →
개인정보에 민감한 환경에서 CPU 전용 LLM이 중요한 이유
EU / GDPR: 모델이 자체 CPU에서 오프라인으로 실행되면 프롬프트와 문서가 기기를 떠날 필요가 없으며, 많은 소규모 팀에게 이는 GDPR 제44조에 따른 제3국 이전 문제를 기술적으로 간단하게 피하는 방법입니다. GDPR, EU AI Act 또는 다른 의무가 적용되는지는 시스템을 누가 어떤 목적으로 배포하는지에 달려 있습니다. 이 가이드는 법률 자문이 아니며, 전체 규정 준수 여부는 추론 아키텍처만이 아니라 전체 구성에 달려 있습니다.
오프라인 및 연결이 불안정한 환경: CPU 모델은 안정적인 인터넷 연결 없이도 작동합니다. Phi-4 Mini 같은 모델 파일을 한 번 내려받으면 추가 네트워크 접속 없이 실행할 수 있어, 연결이 불안정하거나 대역폭에 제한이 있는 지역에 도움이 됩니다.
CPU 추론에서 흔히 하는 실수는 무엇입니까?
- Q4_K_M 대신 FP16 실행. FP16 Phi-4 Mini 파일은 약 7.6 GB로, Q4_K_M의 2.5 GB에 비해 듀얼 채널 DDR4-3200에서 대역폭 상한이 약 20 tok/s에서 약 7 tok/s로 떨어집니다. CPU 추론에는 양자화된 GGUF 모델을 사용하십시오.
- llama.cpp에서 CPU 전용 강제를 잊음. 명시적인 플래그가 없으면 GPU 빌드가 레이어를 오프로드할 수 있습니다. 순수 CPU 모드에는 `--n-gpu-layers 0`을 설정하십시오.
- RAM 모듈 1개 사용. 메모리 채널이 하나면 최대 대역폭이 절반이 되어 같은 모델이 대략 절반의 속도로 생성합니다. 더 빠른 CPU를 사기 전에 같은 규격의 모듈 2개를 설치하십시오.
- 너무 큰 모델 선택. Phi-4 Mini(2.5 GB, 듀얼 채널 DDR4-3200에서 상한 약 20 tok/s)는 DeepSeek-R1 7B(4.7 GB, 상한 약 11 tok/s)보다 대화형 사용에 훨씬 쾌적합니다. 모델 크기는 남은 RAM만이 아니라 메모리 대역폭에 맞추십시오.
- 잘못된 Ollama 태그 사용. `ollama run phi`는 Phi-4 Mini가 아니라 Phi-2를 불러옵니다. `ollama run phi4-mini`를 사용하고, 정확한 모델 태그는 ollama.com/library에서 확인하십시오.
출처
- GitHub의 llama.cpp — CPU 추론, 스레드 및 GPU 오프로드 옵션
- Ollama FAQ — 컨텍스트 길이, KV 캐시 유형, keep-alive, ollama ps의 CPU/GPU 분할
- Ollama GPU 문서 — CPU 전용 강제, OLLAMA_VULKAN, 지원 GPU
- Ollama 라이브러리: phi4-mini — 2.5 GB, 128K 컨텍스트
- Ollama 라이브러리: llama3.2 — 3B 파일 2.0 GB, 128K 컨텍스트
- Ollama 라이브러리: gemma4 — e2b 다운로드 4.6–7.5 GB, 128K 컨텍스트, 유효 2.3B / 전체 5.1B 파라미터
- Ollama 라이브러리: qwen3 — 8B 파일 5.2 GB, 40K 컨텍스트
- Ollama 라이브러리: deepseek-r1 — 7B 파일 4.7 GB, Qwen2.5에서 증류
- Microsoft Phi-4-mini-instruct 모델 카드 — Hugging Face
- NVIDIA GeForce RTX 3060 사양 — 메모리 대역폭
- NVIDIA GeForce RTX 4090 사양 — 메모리 대역폭
- Gemma 4 E2B 요약 — llm-stats (서드파티)