핵심 요약 — 코딩용 로컬 LLM 한눈에 보기
- 종합 최고: Qwen3.8 27B(Alibaba) — 밀집 27B, Apache 2.0, Ollama 18GB, 256K 컨텍스트, SWE-bench Pro 61.7, LiveCodeBench v6 90.3(Qwen 발표).
- 이전 Qwen 세대: Qwen 3.6 27B — SWE-bench Verified 77.2%, SWE-bench Pro 53.5(Qwen 발표). 여전히 든든한 대안이지만 Qwen3.8 27B로 대체되었습니다.
- 24B급 에이전트 코딩 최고: Devstral Small 2(Mistral AI, 프랑스) — 15GB, SWE-bench Verified 65.8%, Apache 2.0, 도구 호출과 다중 파일 편집. Ollama 0.13.3 이상 필요.
- 장시간 에이전트 세션 최고: Laguna XS 2.1(Poolside) — 총 33B/활성 3B MoE, 20GB, 256K 컨텍스트, SWE-bench Verified 70.9%, SWE-bench Multilingual 63.1%, OpenMDW-1.1 라이선스.
- 64GB 기기용 대형 MoE: Qwen3-Coder-Next — 총 80B/활성 3B, 52GB(Q4), 256K 컨텍스트.
- IDE 자동 완성 최고: Codestral 22B(Mistral) — FIM 최적화, Continue.dev 연동, 13GB, 32K 컨텍스트.
- 8GB RAM 최고: Qwen3 8B — VRAM 5GB 사용, 품질과 속도의 균형이 가장 좋음.
- 프런티어급 오픈 웨이트: Kimi K2.6과 Kimi K2.7 Code(Moonshot AI) — 총 1T/활성 32B MoE, 256K 컨텍스트. Ollama는 `:cloud` 태그만 제공하며, 로컬 GGUF 빌드는 양자화에 따라 약 310~470GB가 필요합니다.
- 벤치마크 전환: 실용적인 코딩의 주요 지표는 SWE-bench Pro와 Verified(실제 GitHub 이슈)입니다. HumanEval(단일 Python 함수)은 소형 모델 비교에 여전히 유용합니다.
- 권장 환경: 24GB GPU 또는 32GB 통합 메모리(Qwen3.8 27B를 여유 있게 실행). Devstral Small 2는 16GB로 충분합니다.
🏆 코딩용 최고의 로컬 LLM(빠른 추천)
- 종합 최고: Qwen3.8 27B — 밀집 27B, 18GB, 256K 컨텍스트, SWE-bench Pro 61.7(Qwen 발표). `ollama run qwen3.8`
- 24B급 에이전트 코딩 최고: Devstral Small 2 — 다중 파일 편집, 도구 호출, 15GB. `ollama run devstral-small-2`
- 장시간 에이전트 세션 최고: Laguna XS 2.1 — 33B/활성 3B MoE, 20GB, 256K 컨텍스트. `ollama run laguna-xs-2.1`
- 대형 MoE(64GB 기기): Qwen3-Coder-Next — 80B/활성 3B, 52GB. `ollama run qwen3-coder-next`
- 24GB에서 저장소 인식 완성 최고: Qwen3-Coder 30B — 30B/활성 3.3B MoE, 19GB, 256K 컨텍스트. `ollama run qwen3-coder:30b`
- IDE 자동 완성 최고: Codestral 22B — Continue.dev용 FIM 최적화, 13GB. `ollama run codestral:22b`
- 8GB RAM 최고: Qwen3 8B — VRAM 5GB. `ollama run qwen3:8b`
- 👉 잘 모르겠다면: 8~16GB 노트북은 Qwen3 8B, GPU 또는 통합 메모리가 24GB 이상이면 Qwen3.8 27B.
- 👉 16GB라면: 에이전트 코딩에는 Devstral Small 2가 가장 적합합니다. Qwen3.8 27B(18GB)에는 24GB 카드 또는 32GB Mac이 필요합니다.
- 👉 장시간 에이전트 세션이 필요하다면: Laguna XS 2.1 또는 Devstral Small 2를 사용해 보세요.
- 👉 IDE 완성이 필요하다면: Continue.dev와 함께 Codestral 22B를 사용하세요.
🛠️실전 팁: 먼저 하드웨어에 맞게 모델 크기를 고르세요. 8GB면 Qwen3 8B, 16GB면 Devstral Small 2, GPU 또는 통합 메모리가 24GB면 Qwen3.8 27B입니다. Kimi K2.6과 K2.7 Code는 현실적인 로컬 선택지가 아닙니다. Ollama에서는 클라우드 태그로만 제공되며 로컬 빌드는 300GB 이상이 필요합니다.
한 문장 요약
2026년 코딩용 최고의 로컬 LLM은 Qwen3.8 27B(18GB, Qwen 발표 SWE-bench Pro 61.7)이며, 16GB 에이전트 코딩에는 Devstral Small 2, 장시간 세션에는 Laguna XS 2.1, IDE 자동 완성에는 Codestral 22B, 8GB RAM에는 Qwen3 8B가 적합합니다.
쉬운 말로
코딩 모델을 로컬에서 실행한다는 것은 노트북에 AI 코딩 어시스턴트를 설치하는 것과 같습니다. 코드가 비공개로 유지되고 오프라인에서도 작동하지만, GitHub Copilot과 같은 클라우드 API보다 느립니다.
코딩에 좋은 로컬 LLM의 조건은?
2026년에는 SWE-bench Pro와 SWE-bench Verified가 실용적인 코딩 벤치마크로서 HumanEval을 크게 대체했습니다. 단일 함수 생성이 아니라 실제 GitHub 이슈 해결 — 여러 파일 수정, 코드베이스 이해, 테스트 작성 — 을 측정합니다. Qwen은 Qwen3.8 27B의 SWE-bench Pro를 61.7, 이전 세대 Qwen 3.6 27B의 SWE-bench Verified를 77.2%로 발표했습니다.
코드 특화 모델은 대규모 코드 말뭉치(GitHub, Stack Overflow, 문서)로 미세 조정되며, 흔히 fill-in-the-middle(FIM) 학습을 포함합니다. 커서 앞뒤 문맥으로 코드를 완성하는 능력으로, IDE 자동 완성에 필수입니다.
Llama 3.1 8B 같은 범용 모델은 HumanEval 72%로 충분히 경쟁력이 있습니다. 그러나 같은 크기의 코드 전용 모델은 학습 데이터와 미세 조정이 일반 언어 작업보다 코드 생성 정확도를 우선하기 때문에 5~15% 더 높은 점수를 냅니다.
📌참고: 개발사가 발표하는 SWE-bench 점수는 에이전트 하네스, 작업 집합, 설정이 서로 다릅니다(Qwen의 SWE-bench Pro 61.7은 Claude Code 하네스와 수정된 작업을 사용). 따라서 발표된 두 수치는 직접 비교가 아닌 참고용입니다. HumanEval은 단일 함수 비교에 여전히 유용하지만, SWE-bench가 실제 개발 워크플로 성능을 더 잘 예측합니다.
#1 Qwen3.8 27B — 종합 최고의 로컬 코딩 LLM
Qwen3.8 27B(Alibaba, 2026년 8월 출시)는 24GB GPU 또는 32GB Mac에서 최고의 로컬 코딩 LLM입니다. Apache 2.0 라이선스의 밀집 27B 모델(토큰마다 모든 파라미터 활성)입니다. Qwen은 SWE-bench Pro 61.7, Terminal Bench 2.1 73.0, LiveCodeBench v6 90.3을 발표했습니다. Ollama 다운로드는 18GB이며 컨텍스트 창은 256K입니다.
`ollama run qwen3.8`. 텍스트와 이미지를 입력받고 도구 호출과 사고 모드를 지원하며, 다중 파일 분석, 디버깅, 리팩터링에 적합합니다. Qwen은 이전 세대 Qwen 3.6 27B에 대해 SWE-bench Pro 53.5(SWE-bench Verified 77.2%)를 발표했으며, `ollama run qwen3.6:27b`도 유효한 대안입니다.
항목 | 값 |
|---|---|
| SWE-bench Pro | 61.7(Qwen 발표) |
| LiveCodeBench v6 | 90.3(Qwen 발표) |
| 아키텍처 | 밀집(27B 모두 활성) |
| Ollama 크기(Q4_K_M) | 18GB |
| 컨텍스트 창 | 256K 토큰 |
| 라이선스 | Apache 2.0 |
| Ollama 명령 | ollama run qwen3.8 |
🔍인사이트: Qwen은 SWE-bench Pro를 Claude Code 하네스와 문제 있는 작업을 수정한 정제 작업 집합으로 실행합니다. 따라서 61.7은 다른 개발사가 발표한 점수와 직접 비교할 수 없습니다. 개발사가 발표한 강력한 신호일 뿐, 직접 대결 테스트가 아닙니다.
#2 Devstral Small 2 — 24B급 에이전트 코딩 최고
Devstral Small 2(Mistral AI)는 에이전트 코딩 워크플로를 위해 만들어졌습니다. 다중 파일 편집, 도구 호출을 동반한 코드 생성, 디버깅 루프를 지원합니다. 24B 파라미터, Ollama 15GB, SWE-bench Verified 65.8%(Mistral 발표), Apache 2.0. `ollama run devstral-small-2`(Ollama 0.13.3 이상 필요).
16GB 기기에서 aider, Claude Code 방식 워크플로, 다단계 코드 수정을 쓰는 개발자에게 최적입니다. 오류 피드백을 읽고 여러 파일을 편집하며 이미지 입력도 지원합니다.
항목 | 값 |
|---|---|
| SWE-bench Verified | 65.8%(Mistral 발표) |
| 최적 용도 | 에이전트 워크플로, 다중 파일 편집 |
| Ollama 크기 | 15GB |
| 컨텍스트 창 | 384K 토큰(Ollama) |
| 라이선스 | Apache 2.0 |
| Ollama 명령 | ollama run devstral-small-2 |
💡팁: 에이전트 코딩 = 추론 → 코드 작성 → 실행 → 오류 관찰 → 수정 → 반복. Devstral Small 2는 15GB로 이 루프를 처리하므로, Qwen3.8 27B(18GB)가 들어가지 않는 16GB 기기의 현실적인 에이전트 선택지입니다.
#3 Laguna XS 2.1과 Qwen3-Coder-Next — 장시간 에이전트 코딩
Laguna XS 2.1(Poolside, 2026년 7월 2일)은 장시간 에이전트 코딩을 겨냥합니다. 총 33B/활성 3B MoE, 256K 컨텍스트, OpenMDW-1.1 라이선스, SWE-bench Verified 70.9%, SWE-bench Multilingual 63.1%. Ollama 기본 태그는 20GB(Q4_K_M)입니다. `ollama run laguna-xs-2.1`.
Qwen3-Coder-Next(Alibaba, 2026년 2월)는 64GB 기기용 더 큰 MoE 옵션입니다. 총 80B/활성 3B, Q4_K_M 52GB, 256K 컨텍스트. `ollama run qwen3-coder-next`. 24GB에서 더 작은 저장소 인식 코딩 모델이 필요하다면 `ollama run qwen3-coder:30b`(총 30B/활성 3.3B, 19GB, Apache 2.0)가 자리 잡은 대안입니다.
수 시간짜리 에이전트 세션에서 가장 큰 컨텍스트 창이 필요하면 Laguna XS 2.1을, 더 작은 크기의 EU 출신 Apache 2.0 모델을 원하면 Devstral Small 2를 선택하세요.
항목 | 값 |
|---|---|
| Laguna XS 2.1 크기 | 20GB(총 33B / 활성 3B) |
| Laguna XS 2.1 SWE-bench | 70.9% Verified / 63.1% Multilingual |
| Qwen3-Coder-Next 크기 | 52GB(총 80B / 활성 3B) |
| 컨텍스트 창 | 256K 토큰(둘 다) |
| Ollama 명령 | laguna-xs-2.1 / qwen3-coder-next |
🔍인사이트: MoE 모델은 모든 파라미터를 메모리에 올리지만 토큰마다 수십억 개만 계산합니다. 크기에 비해 빠르게 생성하지만 전체 가중치만큼의 RAM은 필요합니다(Laguna XS 2.1은 20GB, Qwen3-Coder-Next는 52GB).
#4 Codestral 22B — IDE 자동 완성 최고
Codestral 22B(Mistral AI)는 IDE 자동 완성 전용 FIM 모델로 여전히 유효합니다. VS Code와 Cursor에서 Continue.dev와 함께 fill-in-the-middle 완성을 하도록 만들어졌습니다. 이 페이지에서 가장 오래된 모델(Ollama 빌드는 약 2년 전)이지만 FIM에 가장 특화된 선택지입니다.
`ollama run codestral:22b`. 커서 앞뒤에 문맥이 있는 IDE식 완성을 위해 학습되었습니다. Python, JavaScript, TypeScript, Go, Rust에 강합니다. Ollama 빌드의 컨텍스트 창은 32K입니다.
저장소 인식 완성에는 `ollama run qwen3-coder:30b`가 가장 강력한 오픈 웨이트 대안입니다(Apache 2.0, 19GB). 16GB에서 추론이 가능한 소형 코딩 모델로는 `ollama run gpt-oss:20b`(OpenAI 오픈 웨이트, 총 21B/활성 3.6B MoE, 추론 강도 조절 가능)도 든든한 선택입니다.
항목 | 값 |
|---|---|
| 최적 용도 | FIM(IDE 자동 완성) |
| Ollama 크기 | 13GB |
| 컨텍스트 창 | 32K 토큰 |
| FIM 지원 | 예(주요 용도) |
| IDE 연동 | Continue.dev, Cursor |
| Ollama 명령 | ollama run codestral:22b |
🔍인사이트: Mistral AI의 Codestral 22B는 FIM(fill-in-the-middle) 완성을 위해 특별히 만들어졌습니다. Continue.dev와 결합하면 GitHub Copilot 자동 완성의 로컬 대안이 됩니다.
#5 Qwen3 8B — 8GB RAM용 최고의 코딩 모델
Qwen3 8B는 8GB 구간의 코딩 추천 모델입니다. 코딩 성능이 좋고 다국어를 지원하며 VRAM은 5GB만 사용합니다. Qwen3.8은 현재 Ollama에서 27B로만 제공되므로, Qwen3 8B가 현행 Qwen 중 가장 작은 선택지입니다. 다른 코딩 모델의 VRAM 요구 사항은 VRAM 요구 사항 가이드 →를 참고하세요. `ollama run qwen3:8b`.
🔍인사이트: Qwen3 8B는 8GB 기기의 권장 출발점입니다. 다국어 지원이 강하고 추론이 빠르며 실제 작업에서 코드 품질도 좋습니다.
Kimi K2.6과 K2.7 Code가 현실적인 로컬 선택지가 아닌 이유
Kimi K2.6과 Kimi K2.7 Code(Moonshot AI)는 이 목록에서 가장 큰 오픈 웨이트 코딩 모델이지만 일반 소비자 하드웨어용이 아닙니다. 둘 다 1T 파라미터, 활성 32B의 MoE이며 컨텍스트 창은 256K입니다. Moonshot AI는 Kimi K2.6의 SWE-bench Pro를 58.6으로 발표했고, Kimi K2.7 Code는 K2.6을 바탕으로 장시간 코딩 세션에 맞춰졌습니다.
Ollama에서는 둘 다 클라우드 태그(`kimi-k2.6:cloud`, `kimi-k2.7-code:cloud`)로만 나와 있으며, 프롬프트가 Ollama의 호스팅 서비스로 전송됩니다. 로컬 실행에는 커뮤니티 GGUF 빌드가 필요합니다. Unsloth는 K2.7 Code가 1비트에서 약 310GB, 2비트에서 325~350GB라고 밝혔으므로, 노트북이 아니라 워크스테이션이나 서버급 하드웨어용입니다.
⚠️경고: `:cloud` 태그는 로컬 추론이 아닙니다. 로컬 모델을 쓰는 이유가 프라이버시라면 Qwen3.8 27B, Devstral Small 2, Laguna XS 2.1을 대신 사용하세요.
코딩 모델은 어떻게 비교될까? SWE-bench + HumanEval
모델 | HumanEval | SWE-bench | RAM | FIM |
|---|---|---|---|---|
| Qwen3.8 27B | — | 61.7(Pro) | 18GB | — |
| Qwen 3.6 27B | — | 77.2%(Verified) / 53.5(Pro) | 약 22GB | — |
| Devstral Small 2 | — | 65.8%(Verified) | 15GB | — |
| Laguna XS 2.1(MoE) | — | 70.9%(Verified) | 20GB(활성 3B) | — |
| Qwen3-Coder-Next(MoE) | — | 하네스에 따라 다름 | 52GB(활성 3B) | — |
| Kimi K2.6(MoE) | — | 58.6(Pro) | 300GB 이상(Ollama는 클라우드) | — |
| Codestral 22B | — | — | 13GB | 예(주요) |
| Qwen2.5-Coder 32B | — | — | 20GB | 예 |
| Qwen3 8B | — | — | 5GB | 예 |
| DeepSeek-R1 14B | — | — | 10GB | 아니요 |
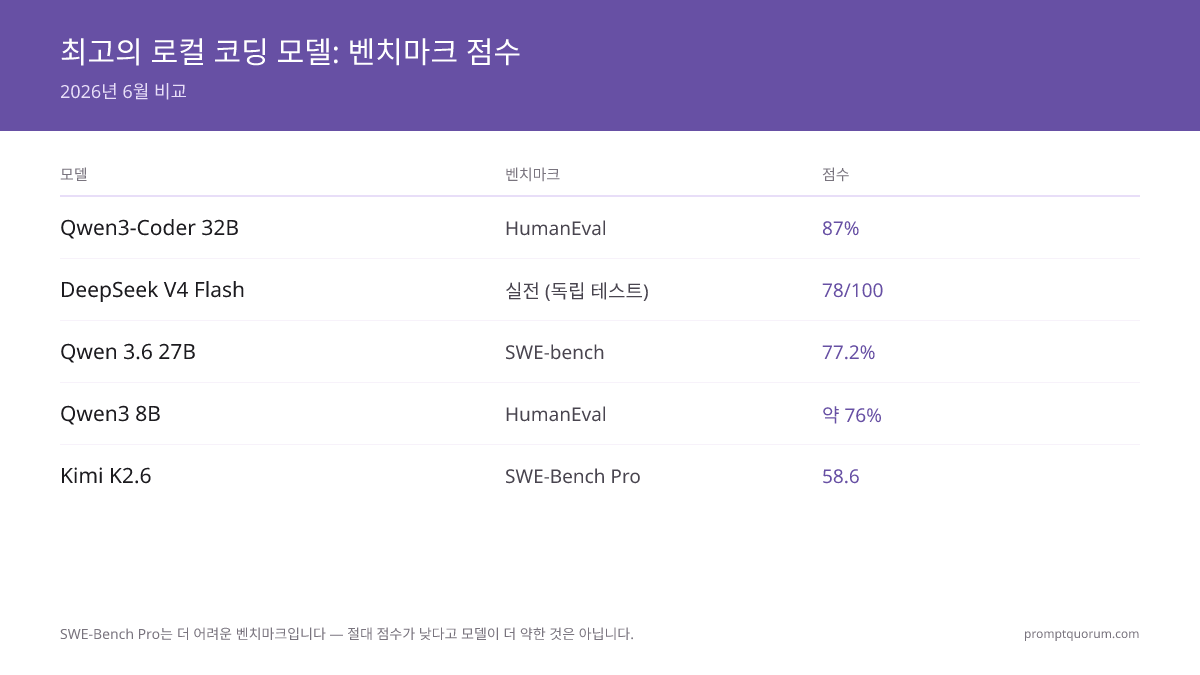
📌참고: HumanEval은 단일 Python 함수 생성을 측정합니다. SWE-bench는 여러 파일에 걸친 실제 코드 변경을 측정합니다. "Pro"와 "Verified"는 SWE-bench의 서로 다른 변형이라 호환되지 않습니다. Verified 77.2%와 Pro 61.7은 직접 비교할 수 없습니다. 모든 점수는 개발사가 발표한 값입니다. 이전 모델(Qwen2.5-Coder 32B, Qwen3 8B)의 HumanEval 수치는 이 페이지의 이전 버전에서 가져온 것으로 다시 검증하지 않았습니다.
어떤 모델이 어떤 코딩 작업에 맞을까?
- 1Python 함수 디버깅과 다중 파일 리팩터링 -- Qwen3.8 27B가 1순위입니다. 밀집 모델은 토큰마다 27B 파라미터를 모두 활성화하므로 다중 파일 추론에 적합합니다. 16GB뿐이라면 Devstral Small 2가 더 가벼운 대안입니다. 선택: Qwen3.8 27B.
- 2에이전트 루프(계획 → 편집 → 테스트 실행 → 수정) -- Devstral Small 2와 Laguna XS 2.1은 도구 호출과 장시간 세션을 위해 만들어졌습니다. Laguna XS 2.1은 256K 컨텍스트를, Devstral Small 2는 더 적은 메모리를 사용합니다. 선택: 장시간 세션은 Laguna XS 2.1, 16GB 기기는 Devstral Small 2.
- 3FIM / IDE 자동 완성(VS Code) -- fill-in-the-middle에는 그에 맞게 학습된 모델이 필요합니다. Codestral 22B와 Qwen3 8B는 Continue.dev를 통해 동작하며, Kimi, Laguna, Devstral은 FIM이 주력이 아닙니다. 선택: Codestral 22B.
- 48GB 노트북에서의 빠른 스크립트 -- Qwen3 8B는 일상적인 스크립트, SQL, 보일러플레이트를 낮은 지연 시간으로 처리합니다. 큰 타입 시스템이나 다중 파일 변경에서는 결과가 약해집니다. 선택: Qwen3 8B.
🔍인사이트: SWE-bench류 작업(다중 파일 디버깅과 리팩터링)에서는 큰 모델이 8B 모델보다 높은 점수를 내지만, 일상적인 스크립팅에서는 차이가 줄어듭니다. 먼저 작업에 맞춰 모델을 고르고, 그다음 메모리 예산에 맞추세요.
속도와 출력 품질의 균형이 가장 좋은 코딩 모델은?
작업 | Qwen3.8 27B | Devstral Small 2 | Qwen3 8B | Codestral 22B |
|---|---|---|---|---|
| 다중 파일 리팩터링·디버깅 | 1순위(밀집, 18GB) | 좋음(15GB) | 큰 변경에는 한계 | 주력 아님 |
| 도구를 쓰는 에이전트 루프 | 강함(도구, 사고) | 이를 위해 설계됨 | 기본 수준 | 주력 아님 |
| 보일러플레이트, REST API, 테스트 | 강함, 더 느림 | 강함 | 빠름, 검증 확인 필요 | 빠름, 범용적 |
| FIM 완성(커서가 줄 중간) | 주력 아님 | 주력 아님 | 지원 | 최적(FIM) |
💡팁: 핵심: 18GB와 15GB 모델은 8B 모델보다 토큰당 느리지만 추론이 중요한 작업에서는 더 정확합니다. IDE 자동 완성에는 FIM 최적화 모델(Codestral 22B, Qwen3 8B)만 사용하세요. 처리량은 GPU, 양자화, 컨텍스트 길이에 따라 달라지므로 직접 측정해 보세요.
🛠️실전 팁: 실용 권장 사항: 작업 유형에 따라 고르세요. 일괄 코드 생성이나 리팩터링 검토에는 Qwen3.8 27B, 16GB에서의 에이전트 루프에는 Devstral Small 2, 지연 시간이 가장 중요한 실시간 IDE 자동 완성에는 Codestral 22B 또는 Qwen3 8B를 쓰세요.
어떤 로컬 코딩 LLM을 사용해야 할까?
어떤 모델을 고르는지도 중요하지만, 코드 품질에는 프롬프트 작성 방식이 더 중요합니다. 언어, 제약 조건, 테스트 케이스, 출력 형식을 명시하는 구조화된 프롬프트 기법은 코드 생성 정확도를 크게 높입니다. 프롬프트 엔지니어링 가이드는 기초, 프레임워크, 평가 방법에 걸친 80가지 기법을 다룹니다.
이 모델들을 중심으로 한 전체 IDE 워크플로는 GitHub Copilot을 로컬 LLM으로 대체하기를 참고하세요. 오픈소스 스택(Continue.dev + Ollama + Qwen3-Coder)이 위 추천과 잘 맞습니다.
- 8GB RAM, 코딩 중심: `ollama run qwen3:8b` -- VRAM 5GB, 이 구간 최고의 모델.
- 16GB RAM: `ollama run devstral-small-2` -- 24B급 에이전트 코딩(다중 파일 편집, 디버깅 루프)에 최적, 15GB.
- 24GB GPU 또는 32GB Mac(최고 품질): `ollama run qwen3.8` -- Qwen3.8 27B, 18GB, SWE-bench Pro 61.7(Qwen 발표).
- 장시간 에이전트 세션: `ollama run laguna-xs-2.1` -- 20GB, 256K 컨텍스트, SWE-bench Verified 70.9%.
- 64GB 기기: `ollama run qwen3-coder-next` -- 활성 3B의 80B MoE, 52GB.
- VS Code의 IDE 자동 완성: Continue.dev를 통한 `ollama run codestral:22b` -- FIM 최적화, 최고의 로컬 Copilot 대안.
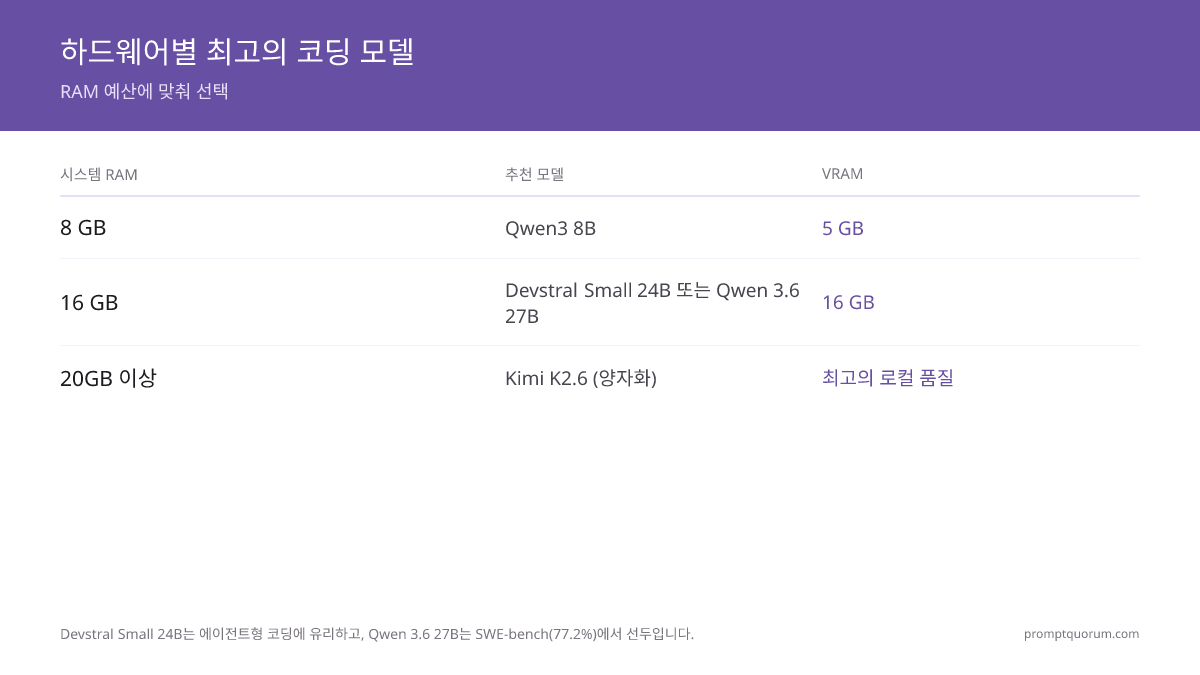
🛠️실전 팁: 먼저 하드웨어에 맞게 모델 크기를 고른 뒤 용도에 맞게 최적화하세요. 8GB라면 Qwen3 8B가 최선이고, 16GB라면 Devstral Small 2, 24GB 이상이라면 Qwen3.8 27B를 쓰세요. 버거워하는 완벽한 모델보다 잘 돌아가는 모델이 낫습니다.
8 GB VRAM 최고 코딩 LLM (RTX 3060 12GB / RTX 3070 8GB / RX 6800 16GB)
8 GB RAM 환경에서는 Qwen3 8B가 코딩에 최적입니다. VRAM을 5 GB만 사용하여 IDE, 브라우저, 기타 애플리케이션을 위한 3 GB가 남습니다. Qwen3 8B는 Continue.dev를 통한 VS Code 자동 완성을 위한 FIM(fill-in-the-middle)을 지원합니다.
- Qwen3 8B (권장) — VRAM 5 GB, 20–35 tok/sec, FIM 지원. `ollama run qwen3:8b`
- Phi-4 Mini 3.8B — MMLU 68% (추론), VRAM 2.5 GB, 경량 추론에 최적. `ollama run phi4-mini`
- Llama 3.2 3B — 40–60 tok/sec, VRAM 2.5 GB, 매우 제한된 환경의 대안. `ollama run llama3.2:3b`
16GB VRAM용 최고의 코딩 LLM(RTX 4070 Ti 16GB / RTX 5070 Ti 16GB / 24GB 카드)
16GB에서는 에이전트 코딩에 Devstral Small 2(15GB)가 가장 적합합니다. Qwen3.8 27B(다운로드 18GB)에는 24GB GPU 또는 32GB 통합 메모리 Mac이 필요하며, 그만한 여유가 있다면 최선의 선택입니다.
- Devstral Small 2 — 에이전트 코딩, 도구 호출, 다중 파일 편집에 최적, 15GB. `ollama run devstral-small-2`
- Qwen3.8 27B — 종합 최고, 밀집 27B, 18GB, 256K 컨텍스트, 24GB 카드에 들어감. `ollama run qwen3.8`
- Qwen3-Coder 30B — 30B/활성 3.3B MoE, 19GB, 24GB 카드에서 저장소 인식 완성. `ollama run qwen3-coder:30b`
6 GB VRAM 최고 코딩 LLM (보급형 GPU / 내장 그래픽)
4–6 GB VRAM 환경(보급형 GPU, 구형 노트북, Intel iGPU)에서는 Phi-4 Mini 3.8B가 최선입니다. MMLU 추론 성능 68%를 달성하면서 VRAM을 2.5 GB만 사용하여 시스템을 위한 ~3.5 GB가 남습니다.
- Phi-4 Mini 3.8B (권장) — MMLU 추론 68%, VRAM 2.5 GB, 논리 및 디버깅에 탁월. `ollama run phi4-mini`
- Qwen3 4B — 소형 변형, VRAM 4 GB, 보급형 하드웨어에서 균형 잡힌 품질-속도. `ollama run qwen3:4b`
🧭 누가 무엇을 써야 할까: 사용자 유형별 추천
- 입문자(로컬 LLM 경험 없음): LM Studio + Qwen3 8B -- GUI라 터미널이 필요 없고, 코드 완성용 FIM 포함, VRAM 5GB.
- 노트북 개발자(8~16GB RAM, 일상 코딩): Ollama + Qwen3 8B(8GB 기기) 또는 Devstral Small 2(16GB 기기) -- 품질과 성능이 균형 잡혀 몇 시간이고 쾌적하게 동작.
- 고급 개발자(디버깅, 리팩터링, 복잡한 추론, 24GB 이상): Ollama + Qwen3.8 27B(밀집 모델, 18GB) -- 다중 파일 컨텍스트와 알고리즘 설계를 처리.
- 장시간 에이전트 세션(계획 → 코딩 → 테스트 → 반복): Ollama + Laguna XS 2.1(256K 컨텍스트, SWE-bench Verified 70.9%) 또는 Devstral Small 2 -- 도구 호출과 다단계 실행용.
- IDE 중심 워크플로(VS Code, Cursor, JetBrains): Continue.dev + Codestral 22B -- 커서 위치 완성에 맞춘 FIM 최적화, 최고의 로컬 Copilot 대안.
- 프라이버시가 중요한 환경(GDPR, HIPAA, 자체 코드): 위의 로컬 모델 중 하나를 Ollama로 실행(`:cloud` 태그는 제외) -- 추론에 외부 API 호출이 없으므로, 에디터 플러그인 등 다른 도구도 네트워크를 사용하지 않는 한 코드가 기기를 떠나지 않습니다.
⚠️경고: ❌ 피할 것: GPU 또는 통합 메모리가 약 24GB 미만인 기기에서 Qwen3.8 27B(18GB)를 실행하는 것. 모델이 시스템 RAM으로 넘치면 속도가 크게 떨어집니다. 작은 기기에서는 Qwen3 8B 또는 Devstral Small 2를 사용하세요.
⚠️경고: ❌ 피할 것: IDE 자동 완성이 필요한데 범용 모델(Llama 3.1 8B)을 쓰는 것. 에디터 내 완성에는 FIM을 지원하는 코드 전용 모델(Codestral 22B, Qwen3 8B)만 쓸 수 있습니다.
🔍인사이트: 입문 → 중급 → 고급은 하드웨어 요구 사항이 올라가는 과정이기도 합니다. Qwen3 8B(8GB)로 시작해, 도구와 워크플로를 늘리면 Devstral Small 2(16GB)로, 최고의 추론 품질이 필요해지면 Qwen3.8 27B(24GB 이상)로 올라가세요.
❌ 코딩에 로컬 LLM을 사용하지 말아야 할 때
- 최신 프레임워크 지식이 필요할 때(2025+ API): 로컬 모델은 고정된 학습 시점까지의 데이터로 학습되어 이후에 공개된 API를 모릅니다. 최신 프레임워크 버전에는 최신 문서를 프롬프트에 포함하거나 GPT-5.6, Claude Sonnet 5 같은 최상위 클라우드 모델을 사용하세요.
- 대형 코드베이스 (100k+ 토큰)에서 멀티파일 추론이 필요할 때: 로컬 모델은 매우 긴 컨텍스트에서 성능이 저하됩니다. 지연 시간이 허용 불가능해집니다. 클라우드 모델 (GPT-5.6, Claude)은 100k+ 토큰 컨텍스트를 기본적으로 처리합니다. 전체 서비스의 아키텍처 리팩토링에는 클라우드 모델을 사용하십시오.
- 지연 시간이 300ms 미만이어야 하는 경우 (실시간 대화형 코딩): 로컬 모델은 CPU에서 15–25 토큰/초로 실행되어(일반 노트북 기준) 응답당 5–10초의 지연이 발생합니다. GitHub Copilot과 Claude는 IDE에서 1초 이내에 제안을 완성합니다. 키스트로크 수준의 자동 완성에는 로컬 모델이 너무 느립니다.
- 최고의 디버깅 정확도가 필요할 때: 복잡한 디버깅 작업(여러 호출 스택 추적, 미묘한 타입 오류 식별)에서는 GPT-5.6, Claude Sonnet 5 같은 최상위 클라우드 모델이 실제 코드 이슈에서 대체로 앞섭니다. 로컬 모델은 생성에 강하고, 최상위 모델은 진단에 더 강한 경향이 있습니다.
- 생성된 코드의 환각을 허용할 수 없을 때: 소형 로컬 모델은 복잡한 작업에서 문법상 올바르지만 논리적으로 틀린 코드를 만들 수 있고, 더 큰 클라우드 모델이 대체로 더 신뢰할 만합니다. 결제 시스템, 보안 같은 핵심 코드는 생성된 모든 코드를 사람이 검토해야 합니다.
🔍인사이트: 👉 로컬 LLM의 강점: 개인정보 보호 + 오프라인 작업 + 비용 절감 — 최고 성능을 위한 것이 아닙니다. 이 세 가지 요소보다 최대 정확도가 더 중요하다면 클라우드 API를 사용하십시오.
📊 코딩용 로컬 LLM 비교(의사결정 매트릭스)
어떤 코딩 모델을 고를지 고민되나요? PromptQuorum은 하나의 프롬프트를 여러 모델(Qwen3.8, Devstral, GPT-5.6, Claude)에 동시에 보내고, 내 코드에 대한 출력, 실제 응답 시간, 정확도를 나란히 보여줍니다. PromptQuorum 무료 체험 — 5분, 가입 불필요.
모델 | 최적 용도 | VRAM | 속도 | 강점 | 선택 시점 |
|---|---|---|---|---|---|
| Qwen3.8 27B | 종합 최고, 다중 파일 추론 | 약 18GB | GPU에 따라 다름 | SWE-bench Pro 61.7(Qwen 발표), 밀집 27B, 256K 컨텍스트, Apache 2.0 | 24GB GPU 또는 32GB Mac에서 최고의 로컬 품질을 원할 때 |
| Devstral Small 2 | 24B급 에이전트 코딩 | 약 15GB | GPU에 따라 다름 | SWE-bench Verified 65.8%(Mistral 발표), 도구 호출, 다중 파일, Apache 2.0 | 16GB에서 aider나 Claude Code식 에이전트를 쓸 때 |
| Laguna XS 2.1 | 장시간 에이전트 코딩 | 약 20GB(활성 3B) | GPU에 따라 다름 | SWE-bench Verified 70.9%, 256K 컨텍스트, 33B/활성 3B MoE, OpenMDW-1.1 | 수 시간 에이전트 세션에 256K 컨텍스트가 필요할 때 |
| Qwen3-Coder-Next | 64GB 기기용 대형 MoE | 약 52GB(활성 3B) | GPU에 따라 다름 | 총 80B/활성 3B MoE, 256K 컨텍스트 | 64GB 통합 메모리로 더 큰 코딩 모델을 원할 때 |
| Codestral 22B | IDE 자동 완성(VS Code, Cursor) | 약 13GB | GPU에 따라 다름 | FIM 최적화, 최고의 로컬 Copilot 대안, Continue.dev 기본 지원 | Continue.dev로 키 입력마다 완성을 원할 때 |
| Qwen3 8B | 노트북 코딩, 8GB RAM에 최적 | 약 5GB | 여기서 가장 빠름 | 향상된 코딩 성능, FIM 지원, 다국어 | 8GB RAM에서 이 구간 최고의 로컬 코딩 모델을 원할 때 |
| Kimi K2.6 / K2.7 Code | 프런티어급 오픈 웨이트 | 300GB 이상(Ollama는 클라우드 태그) | 서버급 | 총 1T/활성 32B MoE, 256K 컨텍스트 | 워크스테이션/서버 하드웨어가 있거나 클라우드 태그를 수용할 때 |
| GPT-5.6(클라우드) | 최신 API, 복잡한 추론, 최고 성능 | 해당 없음(클라우드) | 1초 미만 | 최고 정확도, 최신 지식, 다중 파일 추론 | 최고 성능, 실시간 지연, 최신 프레임워크 지식이 필요할 때 |
| Claude Sonnet 5(클라우드) | 코드 리뷰, 설계 결정, 디버깅 | 해당 없음(클라우드) | 1초 미만 | 코드 이해, 디버깅, 다중 파일 문맥에 강함 | 비용이나 프라이버시보다 디버깅 정확도와 리뷰를 우선할 때 |
지역별 요구사항이 코딩 모델 선택에 어떤 영향을 미칩니까?
EU / GDPR
독점 코드베이스를 다루는 EU 소프트웨어 개발 팀의 경우, 로컬 코드 생성을 사용하면 소스 코드가 조직의 인프라 밖으로 나가지 않습니다. GDPR 제32조는 적절한 기술적 보안 조치를 요구합니다 — 소스 코드를 클라우드 AI API에 전송하면 제28조에 따른 추가적인 데이터 처리자 관계가 형성됩니다. 로컬 추론은 이를 제거합니다.
Qwen3.8 27B(Alibaba, Apache 2.0)와 DeepSeek-Coder V2(DeepSeek, MIT)는 모두 완전히 온프레미스로 실행됩니다. EU 출신 모델을 선호하는 조직에는 Mistral의 코드 모델(Mistral Small 3.1, Codestral, Devstral Small 2)이 있으며 Mistral AI(프랑스)가 만들었습니다. Devstral Small 2는 Apache 2.0이고 Codestral은 라이선스 조건이 달라 확인이 필요합니다. Laguna XS 2.1은 OpenMDW-1.1(허용적, 상업적 사용 가능, OSI 미승인)을 사용하므로 상업 배포 전에 반드시 라이선스 조건을 확인하세요. EU AI 법은 중요 인프라를 위한 AI 지원 코드 생성을 고위험으로 분류할 수 있으며, 온프레미스 추론은 파이프라인을 기존 보안 경계 안에 유지합니다.
일본 (METI)
METI 사이버보안 지침은 소프트웨어 개발에서의 AI 도구 사용을 점점 더 다루고 있습니다. Qwen3-Coder는 일본어 코드 주석과 변수 명명 규칙을 기본적으로 처리합니다 — 일본어 인라인 문서가 있는 일본 개발 코드베이스에 유용합니다. 규정 준수 기록을 위해 Ollama 태그(예: qwen2.5-coder:32b)는 METI AI 거버넌스 문서에 필요한 정확한 버전 식별자를 제공합니다.
중국
중국 데이터보안법(数据安全法)에 따라 핵심 정보 인프라의 소스 코드는 외국 클라우드 서비스에서 처리할 수 없습니다. Qwen3.8 27B와 Qwen3-Coder(Alibaba, Apache 2.0)는 중국 기업 코딩 워크플로의 자연스러운 선택입니다 -- 중국 개발사, Apache 2.0 라이선스, Ollama를 통한 완전한 로컬 배포. Kimi K2.6(Moonshot AI)도 중국 출신이지만 로컬 실행에는 서버급 하드웨어가 필요합니다. 이는 법률 자문이 아니므로 해당 사례에 적용되는 요건을 확인하세요.
로컬 코딩 모델의 흔한 실수는 무엇입니까?
- 모델 선택 시 HumanEval만을 유일한 벤치마크로 사용하는 것: HumanEval은 단일 함수 Python 생성을 테스트합니다. 실제 개발에서는 멀티파일 추론, 테스트 생성, 코드베이스 이해가 필요합니다. SWE-bench가 실제 코딩 성능을 더 잘 예측합니다. SWE-bench 점수가 좋은 모델이 HumanEval 점수는 높지만 SWE-bench 결과가 없는 모델보다 실용적 워크플로에서 더 나은 선택입니다.
- 총 파라미터 수가 너무 커 보인다고 MoE 모델을 무시하는 것: Kimi K2.6는 총 1T 파라미터를 갖지만 토큰당 32B만 활성화됩니다. MoE 모델은 총 파라미터 수가 시사하는 것보다 빠르고 VRAM을 적게 사용합니다. 1T MoE 모델은 밀집형 70B 모델이 필요로 하는 하드웨어에서 실행될 수 있습니다.
- 코드 특화 모델 대신 범용 모델을 사용하는 것: Qwen3 8B (코딩 특화)는 유사한 HumanEval 점수에도 불구하고 실제 작업에서 Llama 3.1 8B 일반 (범용)보다 성능이 뛰어납니다. IDE 자동 완성에는 항상 FIM 지원이 있는 코드 특화 모델을 사용하십시오.
- 멀티파일 리뷰 시 컨텍스트 길이를 설정하지 않는 것: Ollama의 기본값은 2048 토큰입니다. 대부분의 코드 파일은 1,000–3,000 토큰입니다. 전체 파일이나 여러 함수가 포함된 코딩 작업에는 Modelfile에서 `PARAMETER num_ctx 32768`을 설정하십시오.
- RAM을 절약하기 위해 코딩 모델에 Q3_K_S를 사용하는 것: Q4_K_M 미만의 양자화는 코드 생성 정확도를 눈에 띄게 저하시킵니다 — 논리적 오류와 구문 실수가 증가합니다. 코딩 작업에는 최소 Q4_K_M을 사용하십시오. RAM이 부족하다면 Q3_K_S의 대형 모델보다 Q4_K_M의 소형 모델을 선택하십시오.
- 프롬프트 엔지니어링이 모델에 관계없이 출력 품질을 결정합니다: 언어, 제약 조건, 테스트 케이스, 오류 처리를 프롬프트에 명확히 지정하면 환각된 코드가 크게 줄어듭니다. 실제 검증된 패턴에 대해서는 AI로 더 나은 코드 작성하기를 참조하십시오.
⚠️경고: 코딩 모델에 Q4_K_M 미만의 양자화를 절대 사용하지 마십시오. Q3_K_S는 RAM을 절약하지만 구문 오류와 논리적 버그를 발생시킵니다. 이것은 코드 생성에 가치 있는 트레이드오프가 아닙니다 — Q4_K_M을 사용하거나 전체 정밀도의 소형 모델을 선택하십시오.
자주 묻는 질문
코딩용 최고의 로컬 LLM은 무엇인가요?
Qwen3.8 27B(Alibaba, Apache 2.0) — 밀집 27B, 18GB, 256K 컨텍스트, Qwen 발표 SWE-bench Pro 61.7. `ollama run qwen3.8`. 16GB 에이전트 코딩은 Devstral Small 2, 장시간 세션은 Laguna XS 2.1, IDE 자동 완성은 Codestral 22B, 8GB 기기는 Qwen3 8B입니다.
코딩에 가장 좋은 Qwen 모델은 무엇인가요?
24GB GPU 또는 32GB Mac에서는 Qwen3.8 27B가 코딩에 가장 좋은 범용 Qwen 모델입니다(18GB, Qwen 발표 SWE-bench Pro 61.7). Qwen3-Coder-Next(총 80B/활성 3B, 52GB)는 64GB 기기에, Qwen3-Coder 30B(19GB)는 저장소 인식 완성에, Qwen3 8B(5GB)는 8GB RAM에 적합합니다.
Qwen이 코딩용 최고의 로컬 LLM인가요?
대부분의 소비자 하드웨어에서 Qwen3.8 27B는 로컬에서 실행되는 모델 중 현재 발표된 코딩 점수가 가장 높지만, 모든 작업에서 이기는 단일 모델은 없습니다. Devstral Small 2는 16GB에 들어가며 에이전트 루프용이고, Laguna XS 2.1은 장시간 세션용이며, Codestral 22B는 IDE 자동 완성에 더 특화되어 있습니다. 점수는 개발사 발표 값이며 하네스가 다르므로 직접 코드로 테스트해 보세요.
Kimi K2.6이나 Kimi K2.7 Code를 로컬에서 실행할 수 있나요?
서버급 하드웨어에서만 가능합니다. 둘 다 1T 파라미터(활성 32B)의 MoE 모델입니다. Ollama는 클라우드 태그(`kimi-k2.6:cloud`, `kimi-k2.7-code:cloud`)로만 나열하며, 이는 로컬 추론이 아닙니다. K2.7 Code의 커뮤니티 GGUF 빌드는 약 310GB(1비트)에서 350GB(2비트)가 필요합니다. 소비자 하드웨어에서 로컬로 코딩하려면 Qwen3.8 27B, Devstral Small 2, Laguna XS 2.1을 사용하세요.
Devstral Small 2와 Laguna XS 2.1은 무엇인가요?
둘 다 에이전트 코딩 모델입니다. Devstral Small 2(Mistral AI, Apache 2.0)는 15GB의 24B 모델로 Mistral 발표 SWE-bench Verified 65.8% -- `ollama run devstral-small-2`. Laguna XS 2.1(Poolside, 2026년 7월 2일)은 20GB의 총 33B/활성 3B MoE 모델이며 256K 컨텍스트 창을 갖고, OpenMDW-1.1 라이선스에서 SWE-bench Verified 70.9%, SWE-bench Multilingual 63.1%를 기록합니다 -- `ollama run laguna-xs-2.1`.
HumanEval이란 무엇이고 왜 중요한가요?
HumanEval은 164개의 Python 프로그래밍 문제로 이루어진 벤치마크입니다. 모델은 각 문제에 맞는 함수 본문을 생성해야 하며, pass@1(첫 시도에서 해결한 비율)이 표준 지표입니다. 소형 코딩 모델 비교에는 여전히 쓰이지만, 실제 프로젝트가 아니라 단일 함수를 측정합니다.
fill-in-the-middle(FIM)이란 무엇이고 어떤 모델이 지원하나요?
FIM은 커서 앞뒤의 코드를 바탕으로 코드를 완성하는 능력으로, IDE 자동 완성의 방식입니다. Codestral 22B, Qwen3-Coder, DeepSeek-Coder, Starcoder2가 FIM을 지원하며 범용 Llama 3.1 8B는 지원하지 않습니다. IDE 연동에는 FIM을 지원하는 모델을 쓰세요.
로컬 코딩 모델이 GitHub Copilot을 대체할 수 있나요?
Continue.dev와 함께 쓰는 Codestral 22B는 대부분의 자동 완성 작업을 충당할 수 있습니다. 복잡한 다중 파일 추론에서는 가장 어려운 작업에서 여전히 클라우드 모델이 우위인 경향이 있습니다. 트레이드오프: 로컬 모델은 더 느리지만 완전히 비공개이며 내 하드웨어에서 실행됩니다.
로컬 코딩 LLM에는 RAM이 얼마나 필요한가요?
최소 4GB(아주 작은 3B 모델), 실용적으로는 8GB 이상입니다. 16GB에서는 Devstral Small 2(15GB)가 실행됩니다. 24GB GPU 메모리 또는 32GB Mac에서는 Qwen3.8 27B(18GB)가 여유 있게 실행됩니다. 경험칙: Q4_K_M 가중치는 10억 파라미터당 약 0.6GB이며, 여기에 컨텍스트 창용 메모리가 더해집니다.
500줄짜리 Python 파일은 컨텍스트를 얼마나 사용하나요?
500줄짜리 Python 파일은 약 2,000~3,000 토큰입니다. Ollama의 런타임 기본 컨텍스트(VRAM에 따라 조정됨)는 부족할 수 있습니다. 단일 파일 코드 리뷰에는 최소 `PARAMETER num_ctx 16384`를, 다중 파일 분석에는 32768 또는 65536을 설정하세요.
로컬 코딩 모델은 개발에 충분히 빠른가요?
반복적인 워크플로에는 충분합니다. 속도는 GPU, 양자화, 컨텍스트 길이에 따라 달라집니다. Qwen3 8B 같은 소형 모델은 노트북에서도 빠르게 응답하고, 큰 모델은 토큰당 더 느립니다. 요청하고 검토하는 방식이라면 응답당 몇 초 대기는 괜찮지만, 키 입력마다 완성하는 자동 완성에는 소형 FIM 모델을 써야 합니다.
로컬 LLM이 코딩에서 GPT-5.6을 대체할 수 있나요?
완전히는 아닙니다. 로컬 모델(Qwen3.8 27B, Devstral Small 2)은 최신 프레임워크 지식(학습 시점 이후 API), 매우 긴 다중 파일 추론(100k+ 토큰), 디버깅 정확도에서 최상위 클라우드 모델에 뒤처집니다. 일상적인 다중 파일 작업에서는 격차를 좁혔고 코드를 비공개로 유지할 수 있습니다.
Qwen3-Coder는 어떤 언어를 가장 잘 지원하나요?
Python이 주된 학습 언어입니다. JavaScript, TypeScript, Java, C++, Go, Rust, SQL도 잘 지원하며 PHP, Ruby, Swift, Kotlin도 처리합니다. Python이 아닌 언어는 HumanEval 점수가 더 낮지만 여전히 경쟁력이 있습니다.
DeepSeek-Coder를 자체 코드에 써도 안전한가요?
Ollama로 로컬 실행하면 DeepSeek-Coder는 외부 연결을 만들지 않으며 코드는 내 하드웨어에 남습니다. DeepSeek의 데이터 우려는 클라우드 API(api.deepseek.com)에 해당하며 로컬 Ollama 추론에는 해당하지 않습니다. 로컬 추론은 코드를 DeepSeek 서버로 보내지 않습니다.
로컬 코딩 모델로 SQL을 생성할 수 있나요?
네 -- Qwen3.8 27B와 Devstral Small 2는 SQL 생성을 처리합니다. 프롬프트 컨텍스트에 테이블 스키마를 제공하세요. 조인이 많은 복잡한 쿼리는 32K 컨텍스트로 전체 스키마를 포함합니다. 시스템 프롬프트는 "당신은 SQL 전문가입니다. 유효한 SQL만 생성하세요."처럼 설정하세요.
SWE-bench란 무엇이고 왜 HumanEval을 대체하나요?
SWE-bench는 모델이 실제 GitHub 이슈를 해결하는 능력 — 코드베이스 읽기, 여러 파일 수정, 테스트 작성 — 을 평가합니다. 단일 Python 함수를 평가하는 HumanEval과 달리, SWE-bench는 실제 개발 워크플로에서의 성능을 예측합니다. SWE-bench Verified와 SWE-bench Pro는 서로 다른 변형이라 점수가 호환되지 않습니다. 2026년에는 실제 사용을 위한 코딩 모델 평가의 주요 벤치마크입니다.
로컬 코딩 모델을 VS Code에 연결하려면 어떻게 하나요?
VS Code 마켓플레이스에서 Continue.dev 확장을 설치하세요. Continue 설정에서 제공자로 Ollama를 선택하고 모델(예: `qwen3:8b`, `qwen3.8`, `codestral:22b`)을 지정합니다. 확장은 localhost:11434의 Ollama에 자동으로 연결됩니다. Cmd+I(macOS) 또는 Ctrl+I(Windows)로 인라인 코드 생성을 실행하세요.
출처
- Qwen 팀 (2026). "Qwen3.8-27B" 모델 카드. huggingface.co -- Apache 2.0, 256K 컨텍스트, SWE-bench Pro 61.7, LiveCodeBench v6 90.3, Terminal Bench 2.1 73.0.
- Ollama (2026). "qwen3.8" 라이브러리 페이지. ollama.com -- 18GB(Q4_K_M) 태그, 256K 컨텍스트.
- Mistral AI (2026). Ollama의 "devstral-small-2". ollama.com -- 15GB, SWE-bench Verified 65.8%, Ollama 0.13.3 이상 필요.
- Poolside (2026). "Introducing Laguna XS 2.1". poolside.ai -- 에이전트 코딩 모델, 33B/활성 3B MoE, SWE-bench Verified 70.9%, OpenMDW-1.1 라이선스.
- Ollama (2026). "laguna-xs-2.1" 라이브러리 페이지. ollama.com -- 기본 태그 20GB, 256K 컨텍스트.
- Ollama (2026). "qwen3-coder-next" 라이브러리 페이지. ollama.com -- 총 80B/활성 3B, 52GB Q4_K_M.
- Ollama (2026). "kimi-k2.6" 라이브러리 페이지. ollama.com -- `:cloud` 태그만 나열됨.
- Unsloth (2026). "Kimi K2.7 Code" 로컬 실행 가이드. unsloth.ai -- 1T/활성 32B MoE, 양자화 시 메모리 요구량 310~470GB.
- Ollama (2026). "codestral" 라이브러리 페이지. ollama.com -- 22B, 13GB, 32K 컨텍스트.
- Qwen 팀 (2026). "Qwen3-Coder-Next Technical Report". arxiv.org -- Qwen3-Coder-Next의 아키텍처와 에이전트 코딩 결과.
- DeepSeek AI (2024). "DeepSeek-Coder-V2 Technical Report". arxiv.org/abs/2406.11931 -- DeepSeek-Coder V2 Lite의 MoE 아키텍처와 코딩 벤치마크 결과.