Key Takeaways
- 양자화는 16비트 모델 가중치를 4비트 또는 8비트로 변환하여 RAM을 50–75% 절약합니다.
- Q4_K_M은 표준 권장 수준으로, 소비자용 하드웨어에서 품질과 RAM의 최적 균형을 제공합니다.
- FP16 기준 7B 모델 = 약 14 GB RAM. Q4_K_M = 약 4.5 GB. Q8_0 = 약 7 GB.
- Q4_K_M의 품질 손실은 FP16 대비 MMLU 벤치마크에서 1–3%로, 대부분의 실용적인 작업에서 체감하기 어렵습니다.
- GGUF는 llama.cpp, Ollama, LM Studio를 위한 양자화 모델 파일 형식입니다.
Q4_K_M은 로컬 LLM의 표준 양자화입니다. 7B 모델이 FP16의 약 14 GB 대신 약 4.5 GB를 차지하며, MMLU 기준 품질 손실은 1~3%입니다.
양자화는 모델 안의 숫자를 더 거칠게 저장해 크기를 줄이는 방식입니다. Q4_K_M은 거의 모든 사용자가 선택하면 되는 수준으로, 일반적인 하드웨어에 들어가고 일상적인 사용에서는 품질 차이를 거의 느끼기 어렵습니다. VRAM에 여유가 있다면 Q5_K_M이나 Q8_0을 고려할 수 있습니다.
LLM 양자화란 무엇이며 왜 중요합니까?
양자화는 16비트 모델 가중치(FP16)를 4비트 또는 8비트 정수로 변환하여 RAM을 50–75% 줄이며, Q4_K_M 기준 품질 손실은 1–3%에 불과합니다. 대형 언어 모델은 학습된 지식을 수십억 개의 수치 가중치로 저장합니다. 기본적으로 이 가중치는 16비트 부동소수점(FP16), 즉 가중치당 2바이트로 저장됩니다. 7B 모델은 70억 개의 가중치를 가지므로 FP16 파일 크기는 약 14 GB입니다.
양자화는 이 16비트 부동소수점을 낮은 정밀도의 정수로 대체합니다. 4비트 양자화에서는 가중치 하나에 2바이트 대신 0.5바이트를 사용하여 메모리를 가중치 단독 기준 약 3.5 GB로 줄입니다. 메타데이터 오버헤드를 포함하면 Q4_K_M으로 양자화된 7B 모델은 약 4.5 GB입니다.
이것이 로컬 추론에서 중요한 이유는 소비자용 하드웨어의 RAM이 제한되어 있기 때문입니다. 양자화 없이는 7B 모델을 실행하는 데 16 GB RAM이 필요합니다. Q4_K_M 양자화를 적용하면 동일한 모델을 6 GB RAM으로 실행할 수 있어 대부분의 최신 노트북에서도 사용 가능합니다.
Q4_K_M 양자화란 무엇입니까?
Q4_K_M은 llama.cpp와 Ollama에서 사용되는 4비트 GGUF 양자화 형식입니다. "K"는 K-퀀트(혼합 정밀도)를 사용함을 의미하며, "M"은 미디엄(medium), 즉 모델 크기·속도·품질 손실 간의 균형을 나타냅니다. Q4_K_M은 대부분의 가중치를 4비트로 저장하지만, 가장 민감한 레이어에는 6비트를 사용하여 순수 4비트 Q4_0보다 우수한 품질 대비 크기 비율을 제공합니다.
- Q4_K_M은 7B 모델 기준 약 4.5 GB RAM을 사용하며, FP16 대비 70% 적고 품질 손실은 1–3%에 불과합니다
- K-퀀트는 민감도에 따라 서로 다른 가중치 그룹에 다른 정밀도를 적용합니다(중요한 가중치에 더 많은 비트 할당)
- "M" 변형이 표준 권장 버전입니다(더 가벼운 "S"와 더 무거운 "L" 변형도 존재함)
- Q4_K_M은 6–16 GB VRAM을 가진 소비자용 하드웨어의 기본 선택입니다
- Ollama(`ollama run model:q4_k_m`), LM Studio, llama.cpp에서 모두 지원됩니다
Q4_K_M, Q5_K_M, Q8_0 및 기타 수준의 차이는 무엇입니까?
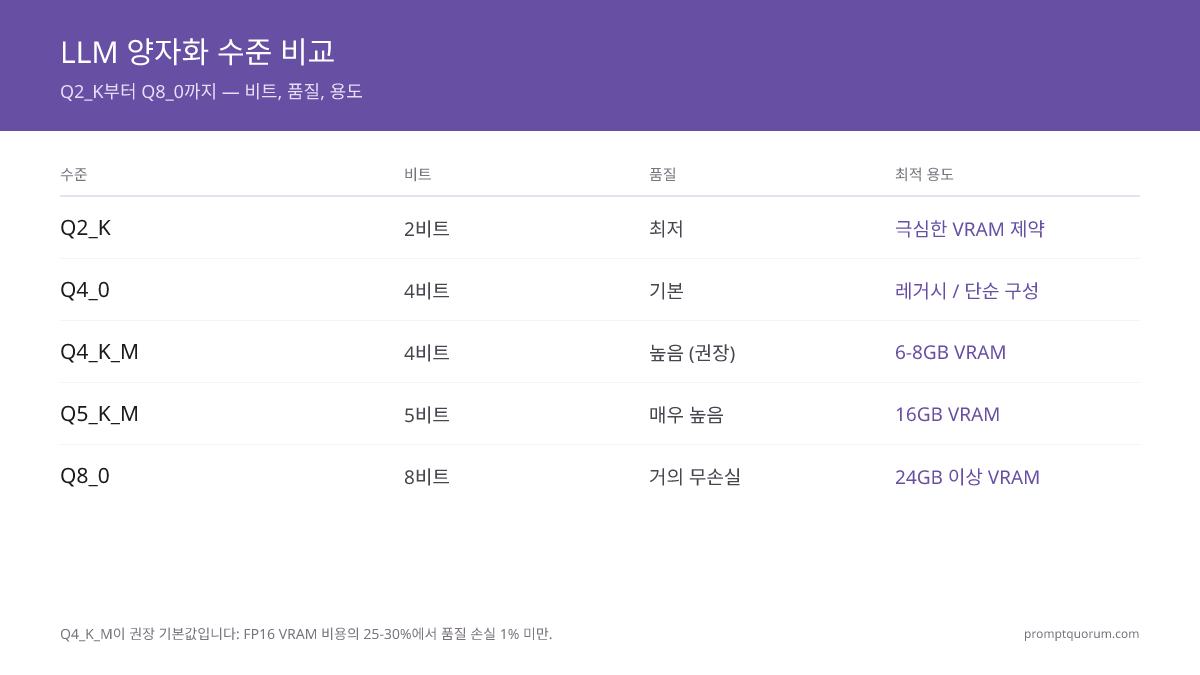
4비트 Q4_K_M은 표준 권장 사항으로, 7B 모델 기준 약 4.5 GB RAM과 FP16 대비 1–3% 품질 손실을 제공합니다. 양자화 이름은 Q{비트수}_{변형} 패턴을 따릅니다. 비트 수는 가중치 정밀도이고, 변형은 양자화 적용 방식에 영향을 줍니다.
수준 | 비트 | RAM (7B) | 품질 손실 | 사용 시기 |
|---|---|---|---|---|
| Q2_K | 2 | ~2.7 GB | 높음 | RAM < 4 GB, 품질 저하 허용 시 |
| Q3_K_S | 3 | ~3.3 GB | 보통 | RAM 4–5 GB |
| Q4_K_M | 4 | ~4.5 GB | 낮음 (1–3%) | 대부분의 사용자에게 기본값 |
| Q5_K_M | 5 | ~5.7 GB | 최소 (<1%) | RAM 16 GB, 더 나은 품질 원할 때 |
| Q6_K | 6 | ~6.6 GB | 거의 무손실 | RAM 16 GB, 코딩·수학 작업 |
| Q8_0 | 8 | ~7.7 GB | 무시 가능 | RAM 16+ GB, 최고 품질 |
인터랙티브 VRAM 계산기
이 계산기를 사용하면 모델, 양자화, 컨텍스트, 배치 크기의 모든 조합에 대해 정확한 VRAM 요구량을 계산할 수 있습니다. 구성을 선택하면 어떤 GPU에 적합한지 확인할 수 있습니다.
Popular Models
Base Model
6.50 GB
Context OH
1.50 GB
Batch OH
0.00 GB
System OH
1.00 GB
Total Minimum
9.00 GB
Recommended (with 25% safety margin)
11.25 GB
👉 Look for a GPU with at least 11.25 GB VRAM
Compatible GPUs
RTX 3060 (12 GB)
0.8 GB headroom
RTX 4070 (12 GB)
0.8 GB headroom
RTX 4070 Ti (12 GB)
0.8 GB headroom
RTX 4080 (16 GB)
4.8 GB headroom
RTX 4090 (24 GB)
12.8 GB headroom
Mac mini M5 (16 GB) (16 GB)
4.8 GB headroom
Mac mini M4 (16 GB) (16 GB)
4.8 GB headroom
MacBook Pro (24 GB) (24 GB)
12.8 GB headroom
M3 Max (36 GB) (36 GB)
24.8 GB headroom
💡 Pro Tips:
- Always use the "with safety margin" figure when buying a GPU
- Q4 gives 90-95% quality with 25% size reduction. Q5 is better if you have room
- Context overhead grows with conversation length. Budget 1-3 GB for typical usage
- Batch size matters for multi-user APIs. Single-user chat can ignore batch overhead
📋 Share this configuration:
Q8_0 양자화란 무엇입니까?
Q8_0은 사실상 무손실에 가까운 8비트 GGUF 양자화 형식입니다 — FP16 대비 품질 저하가 0.5% 미만이며, 파일 크기는 대략 절반입니다. 각 가중치는 8비트와 블록당 작은 스케일 값으로 저장되므로, 7B 모델은 FP16의 약 14 GB 대신 약 7.7 GB가 됩니다. K-퀀트(Q4_K_M, Q5_K_M)와 달리 Q8_0은 모든 가중치에 균일한 8비트 정밀도를 사용합니다 — 8비트만으로 이미 거의 모든 정보가 보존되므로 혼합 정밀도의 "K" 변형이 존재하지 않습니다.
- Q8_0은 7B 모델 기준 약 7.7 GB RAM을 사용하며, FP16 대비 약 45% 적고 품질 손실은 무시할 수 있는 수준입니다
- 16+ GB VRAM을 보유하고 최고의 충실도(코딩, 수학, 에이전트)를 원할 때 최선의 선택입니다
- 일반 채팅에서는 Q6_K 대비 측정 가능한 이점이 거의 없지만, 품질이 가장 중요할 때 가장 안전한 선택입니다
- `ollama run model:q8_0`으로 실행하거나 LM Studio에서 Q8_0 GGUF를 선택하십시오
Q4_0 vs Q4_K_M: 어떤 4비트 형식이 더 나은가?
Q4_0 대신 Q4_K_M을 선택하십시오. 둘 다 가중치당 평균 4비트를 사용하지만, Q4_K_M은 가장 민감한 레이어를 6비트로 저장하는 K-퀀트로, 7B 모델 기준 동일한 약 4.5 GB 용량에서 5–8%의 품질을 회복합니다. Q4_0은 초기 llama.cpp의 원래 균일 4비트 형식이며, 오늘날에는 레거시 호환성을 위해서만 존재합니다. Q4_K_M을 사용할 수 있다면 Q4_0을 선택할 크기나 속도상의 이유는 없습니다.
형식 | 방식 | RAM (7B) | 품질 | 선택 시기 |
|---|---|---|---|---|
| Q4_0 | 균일 4비트 (레거시) | ~4.0 GB | Q4_K_M보다 약 5–8% 낮음 | Q4_K_M을 사용할 수 없을 때만 |
| Q4_K_M | K-퀀트, 4/6비트 혼합 | ~4.5 GB | FP16 대비 1–3% 손실 | 거의 모든 사용자에게 기본값 |
Q4_K_M vs Q4_K_XL: 표준 K-quant와 Dynamic Upcast
Q4_K_M은 llama.cpp의 표준 4비트 K-quant입니다. Q4_K_XL은 표준 형식이 아니라 Unsloth의 "Dynamic" GGUF 변형으로, 4비트 기반을 유지하면서 가장 민감한 레이어(임베딩, 어텐션, 출력)만 더 높은 정밀도로 올립니다. 파일 크기와 품질은 Q4_K_M과 Q5_K_M 사이에 위치합니다. Q8_K_XL이 Q8_0에 대해 적용하는 것과 같은 원리를 4비트 기반에 적용한 것입니다.
Q4_K_XL의 정확한 파일 크기는 모델마다, 그리고 Unsloth가 몇 개 레이어를 올렸는지에 따라 달라집니다. 고정된 수치를 가정하지 말고 LM Studio나 Hugging Face에 표시된 크기를 내려받기 전에 확인하세요. 실용적인 기준은 이렇습니다. Q5_K_M이 VRAM에 들어가면 Q5_K_M을 고르십시오. 표준 형식이라 도구 지원이 넓습니다. Q4_K_XL은 Q4_K_M은 들어가지만 Q5_K_M이 아슬아슬하게 들어가지 않을 때의 중간 단계입니다.
형식 | 종류 | 정밀도 | 품질 | 선택 기준 |
|---|---|---|---|---|
| Q4_K_M | llama.cpp 표준 | 4/6비트 혼합 | 1~3% 손실 | 대부분의 사용자에게 기본 |
| Q4_K_XL | Unsloth Dynamic | 4비트 + 민감 레이어 상향 | Q4_K_M과 Q5_K_M 사이 | Q5_K_M이 아슬아슬하게 안 들어갈 때 |
| Q5_K_M | llama.cpp 표준 | 5/6비트 혼합 | 1% 미만 손실 | VRAM 여유, 표준 도구 사용 |
Q4_K_M vs Q4_K_S: 중간형 vs 소형 K-퀀트
Q4_K_M과 Q4_K_S는 둘 다 4비트 K-퀀트이며, 차이는 몇 개의 레이어가 더 높은 정밀도를 유지하는지에 있습니다. Q4_K_M(Medium)은 더 많은 민감한 레이어를 6비트로 유지하는 반면, Q4_K_S(Small)는 더 많은 가중치를 4비트로 밀어넣어 7B 모델 기준 약 0.3–0.4 GB를 절약합니다. llama.cpp에서 측정한 결과, Q4_K_S는 7B에서 약 +0.11의 퍼플렉시티를 추가하는 반면 Q4_K_M은 +0.05입니다 — 약 3–5% 더 많은 품질 손실입니다. 그 몇백 메가바이트가 모델이 VRAM에 들어가는지 여부를 결정할 때만 Q4_K_S를 선택하십시오.
형식 | 변형 | RAM (7B) | 품질 손실 | 선택 시기 |
|---|---|---|---|---|
| Q4_K_S | Small | ~4.1 GB | ~4–6% (작지만 실재함) | VRAM에 맞추려면 ~0.4 GB가 필요할 때 |
| Q4_K_M | Medium | ~4.5 GB | 1–3% (균형) | 기본값 — 약 0.4 GB 더 사용해 더 나은 품질 |
Q8_0 vs Q4_K_M: 8비트가 두 배의 VRAM만큼 가치가 있는가?
대부분의 채팅 및 작문 작업에는 Q4_K_M이 더 나은 절충안입니다 — 7B 모델 기준 약 4.5 GB를 사용하는 반면 Q8_0은 약 7.7 GB를 사용하며, 품질 손실 차이는 1–3%에 불과합니다. 작은 오류가 누적되는 코딩, 수학, 에이전트형 도구 사용에서 최고의 충실도가 필요할 때는 Q8_0(16+ GB VRAM 필요)을 선택하십시오. Q8_0은 FP16 대비 0.5% 미만의 손실이 있고, Q4_K_M은 1–3% 손실이 있습니다. 이 차이는 일상적인 사용에서는 체감하기 어렵지만 정밀한 수치 추론에서는 중요할 수 있습니다.
형식 | 비트 | RAM (7B) | 품질 손실 | 최적 용도 |
|---|---|---|---|---|
| Q4_K_M | ~4 | ~4.5 GB | 1–3% | 6–16 GB VRAM, 일반 용도 |
| Q8_0 | 8 | ~7.7 GB | <0.5% | 16+ GB VRAM, 코딩/수학/에이전트 |
Q8_0 vs Q8_K_XL: 표준 8비트 vs 동적 업캐스트
Q8_0은 llama.cpp의 표준 8비트 퀀트입니다 — 모든 가중치가 8비트이며, 7B 모델 기준 약 7.7 GB, FP16 대비 손실은 0.5% 미만입니다. Q8_K_XL은 표준 llama.cpp 유형이 아닙니다: Unsloth의 "Dynamic" GGUF 변형으로, 8비트 기반을 유지하면서 가장 민감한 레이어(임베딩, 어텐션, 출력)를 16비트(BF16/F16)로 업캐스트하여 파일 크기를 약간 늘리는 대신 품질을 완전한 FP16에 더 가깝게 만듭니다. Q8_K_XL은 정밀도의 마지막 몇 분의 1 퍼센트를 원하고 여유 VRAM이 있는 사용자를 대상으로 합니다.
Q8_K_XL의 정확한 파일 크기는 모델과 Unsloth가 업캐스트하는 레이어 수에 따라 달라지므로, 다운로드 전에 사용 중인 도구(LM Studio 또는 Hugging Face)에 표시된 크기를 확인하십시오. 7B–8B 모델의 경우 Q8_0보다 약간 큰 것을 예상하십시오. 매우 큰 모델에서는 그 차이가 더 커집니다. Q8_0이 대부분의 사용자에게 이미 사실상 무손실이므로, Q8_K_XL은 특별히 최고의 충실도가 필요하고 추가 VRAM이 여유로울 때만 가치가 있습니다.
형식 | 유형 | 정밀도 | 품질 | 선택 시기 |
|---|---|---|---|---|
| Q8_0 | 표준 llama.cpp | 균일 8비트 | FP16 대비 <0.5% 손실 | 최고 품질, 표준 도구 |
| Q8_K_XL | Unsloth Dynamic GGUF | 8비트 + 주요 레이어 16비트 업캐스트 | 거의 무손실 (가장 큰 8비트 옵션) | 마지막 0.5% 충실도가 필요하고 여유 VRAM이 있을 때 |
GGUF 형식이란 무엇이며 양자화와 어떤 관계가 있습니까?
GGUF(GPT-Generated Unified Format)는 양자화된 LLM 가중치를 위한 단일 파일 표준으로, 모델 가중치·메타데이터·토크나이저를 포함하며 Ollama, LM Studio, llama.cpp에서 사용됩니다. llama.cpp 프로젝트에서 만들었으며 구형 GGML 형식을 대체합니다.
GGUF 파일에는 양자화된 모델 가중치, 모든 모델 메타데이터(아키텍처, 토크나이저, 컨텍스트 길이), 형식 버전 번호가 포함됩니다. 이 자급자족 설계 덕분에 단일 `.gguf` 파일만으로 모델을 실행할 수 있습니다. 별도의 토크나이저 파일이나 설정 JSON이 필요하지 않습니다.
2026년 8월 기준, GGUF는 Ollama, LM Studio, Jan AI, GPT4All의 표준 형식입니다. `ollama pull llama3.1:8b`를 실행하면 Ollama가 내부적으로 GGUF 파일을 다운로드합니다. LM Studio에서 표시되는 모델 파일 크기는 GGUF 파일 크기입니다.
양자화 수준은 파일명에 포함됩니다: `Meta-Llama-3.1-8B-Instruct-Q4_K_M.gguf`는 Llama 3.1 8B의 Q4_K_M 양자화 GGUF 파일입니다.

양자화는 다양한 모델 크기에서 RAM을 얼마나 절약합니까?
모델 크기 | FP16 | Q8_0 | Q4_K_M | Q3_K_S |
|---|---|---|---|---|
| 3B | ~6 GB | ~3.8 GB | ~2 GB | ~1.6 GB |
| 7B | ~14 GB | ~7.7 GB | ~4.5 GB | ~3.3 GB |
| 13B | ~26 GB | ~14 GB | ~8.5 GB | ~6 GB |
| 34B | ~68 GB | ~36 GB | ~22 GB | ~16 GB |
| 70B | ~140 GB | ~70 GB | ~40 GB | ~30 GB |

양자화로 실제로 품질이 얼마나 저하됩니까?
Q4_K_M은 FP16 대비 MMLU 벤치마크에서 1–3% 손실이 발생하며 대부분의 실용적 작업에서 차이를 체감하기 어렵습니다. Q3_K_S는 5–10% 손실로 수학 및 추론 작업에서 차이가 눈에 띕니다. 양자화로 인한 품질 손실은 전체 정밀도와 양자화 버전의 벤치마크 점수를 비교하여 측정합니다. 2026년 8월 기준 검증된 결과는 다음과 같습니다.
양자화는 메모리 사용량을 줄이지만 출력 품질이 저하될 수 있습니다. 잘 설계된 프롬프트로 보완이 가능합니다: 퓨샷 예시 및 명시적 출력 제약 조건 같은 기법은 양자화된 모델의 정확도 유지에 도움이 됩니다. 모든 양자화 수준에서 효과적인 방법은 프롬프트 엔지니어링 기법을 참고하십시오.
- Q4_K_M vs FP16: MMLU에서 1–3% 저하. FP16에서 73%를 기록한 7B 모델은 Q4_K_M에서 71–72%를 기록합니다. 실용적 작업에서는 이 차이를 체감하기 어렵습니다.
- Q3_K_S vs FP16: 5–10% 저하. 복잡한 추론 및 수학 작업에서 차이가 눈에 띕니다. FP16에서는 수학 문제를 정확히 푸는 모델이 Q3_K_S에서는 실패할 수 있습니다.
- Q2_K vs FP16: 15–25% 저하. 모든 작업 유형에서 품질 손실이 두드러집니다. RAM 제약이 절대적일 때만 사용하십시오.
- Q8_0 vs FP16: 0.5% 미만 저하 — 모든 실용적 목적에서 사실상 동일합니다.
- K_M 변형(K-퀀트 미디엄)은 혼합 정밀도 방식을 사용하여 동일한 비트 수에서 구형 Q4_0 양자화보다 품질을 더 잘 보존합니다. 두 가지가 모두 제공될 때는 항상 Q4_0 대신 Q4_K_M을 선택하십시오.
어떤 양자화를 사용해야 합니까? (빠른 결정 트리)
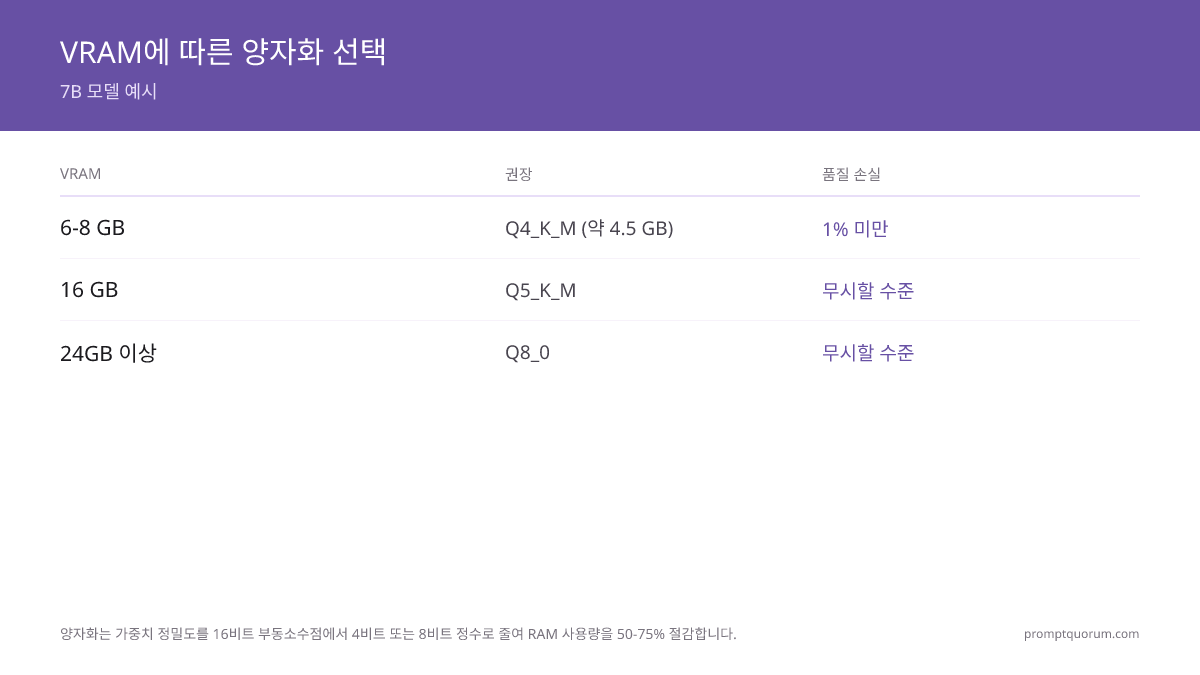
모델 크기만이 아닌 사용 가능한 VRAM을 기준으로 선택하십시오. 아래 표는 하드웨어 제약에 따라 선택할 양자화를 보여줍니다.
- RAM 6 GB (가장 일반적인 노트북/데스크톱): Q4_K_M을 사용하십시오. Q4_K_M으로 양자화된 7B 모델은 약 4.5 GB로, OS와 브라우저용 1.5 GB가 남습니다.
- 코딩 또는 수학 작업의 경우: Q4_K_M 예산이 있더라도 Q5_K_M 이상을 사용하십시오. 양자화 효과(1–3% 손실)는 정밀한 수치 추론에서 가장 두드러집니다. Q5_K_M Qwen3-Coder와 인터넷 차단 운용을 결합한 완전한 에어갭 코딩 설정은 인터넷 없는 로컬 코딩 LLM을 참고하십시오.
- 양자화 + 온도(temperature) 트레이드오프: 온도 0.3의 Q4_K_M 모델은 온도 1.0의 전체 정밀도(FP16) 모델보다 더 결정론적인 출력을 생성합니다. 독립적인 조정을 위해서는 온도와 top-p: AI 창의성 제어를 참고하십시오.
- 스마트 홈 및 엣지 디바이스: Q4_K_M (4–8 GB VRAM)은 미니 PC에서 상시 가동되는 홈 자동화 AI의 최적 선택입니다. 스마트 홈 최고의 로컬 LLM 모델 →을 참고하십시오.
VRAM 용량 | 최적 양자화 | 모델 크기 | 품질 |
|---|---|---|---|
| 4–6 GB | Q3_K_S 또는 Q4_K_M | 3B, 7B (Q4) | 7B (Q3) | Q3 기준 5–10% 손실 | Q4 기준 1–3% |
| 6–8 GB | Q4_K_M (권장) | 7B 네이티브 | 1–3% 손실 (체감 불가) |
| 12–16 GB | Q5_K_M | 7B, 13B 네이티브 | <1% 손실 (최소) |
| 24 GB (RTX 4090) | Q5_K_M 또는 Q6_K | 13B, 32B 네이티브 | Q4 + 오프로드로 70B | 무시 가능 <0.5% |
| 32 GB (RTX 5090) | Q5_K_M, Q6_K 또는 Q8_0 | 70B @ Q4 (35 GB), Q5 (43 GB) | 0–2% 손실 |
| 48+ GB (2× RTX 4090) | Q5_K_M 또는 Q8_0 | 레이어 분할로 70B 네이티브 | 무시 가능 <0.5% |
LM Studio: UI에서 양자화를 선택하는 방법
LM Studio(데스크톱 앱)는 각 모델 다운로드에 대해 사용 가능한 양자화 변형을 표시합니다. 모델을 검색하면 Q2_K, Q3_K_S, Q4_K_M, Q5_K_M, Q6_K, Q8_0 등 여러 GGUF 옵션을 볼 수 있습니다.
1단계: LM Studio 열기 → "Local Models" 탭으로 이동. 모델 검색 (예: "Llama 3.1 8B"). 2단계: 각 모델에 사용 가능한 양자화가 표시됩니다. 파일 크기를 확인하여 VRAM 사용량을 추정하십시오. 7B 모델의 Q4_K_M은 보통 약 4.5 GB로 표시됩니다. 3단계: 선택한 양자화 옆의 다운로드 아이콘을 클릭하십시오.
LM Studio 기본 권장 사항:
- GPU VRAM 6–8 GB (RTX 4060, RTX 3060 Ti, RTX 4060 Ti): Q4_K_M 변형을 다운로드하십시오 (허용 가능한 품질의 가장 작은 파일).
- GPU VRAM 12–16 GB (RTX 4070, RTX 4080): Q5_K_M 또는 Q6_K를 다운로드하십시오 (더 나은 품질, VRAM 내 충분히 실행 가능).
- GPU VRAM 24+ GB (RTX 4090, RTX 5090): Q8_0 또는 FP16을 다운로드하십시오 (최고 품질, 속도 페널티 최소).
LM Studio의 "GPU offload" 기능: 채팅 인터페이스에서 "Use GPU" 토글을 확인하십시오. LM Studio는 VRAM이 허용하는 한 최대한 많은 모델 레이어를 GPU로 이동하고, 나머지는 CPU RAM으로 오프로드합니다. 시스템 RAM이 충분하다면 GPU VRAM보다 약간 큰 모델도 실행할 수 있습니다 (예: 64+ GB 시스템 RAM이 있는 RTX 4090에서 Llama 3.3 70B Q4_K_M).
오프로딩: CPU RAM 활용
VRAM이 가득 찼을 때 모델은 레이어를 시스템 RAM으로 오프로드(이동)할 수 있습니다. 오프로딩은 속도를 희생하고 용량을 확보합니다.
시나리오: RTX 4090 (24 GB)에서 70B Q4 모델 실행. 모델에 35 GB가 필요한 경우, 오프로딩을 사용하면 약 5–10 토큰/초로 실행 가능합니다 (80%를 RAM으로 이동).
오프로딩은 최후의 수단입니다 — 추론을 실용적이지 않게 만듭니다. 오프라인 배치 처리나 실험 목적으로만 사용하십시오.
# Ollama: 오프로딩 활성화
export OLLAMA_NUM_GPU=0  # GPU 비활성화 (CPU 강제)
ollama run llama3.3:70b

# vLLM: CPU 오프로드 활성화 (부분)
vllm serve meta-llama/Llama-3.3-70B-Instruct \
  --gpu-memory-utilization 0.7 \
  --cpu-offload-gb 10  # RAM으로 10GB 오프로드
레이어 분할: 멀티 GPU에 분산
현대 추론 엔진(vLLM, llama.cpp)은 모델을 여러 GPU에 자동으로 분할할 수 있습니다. 고급 설정에 대해서는 멀티 GPU 로컬 LLM을 참고하십시오.
예시: 2× RTX 4090으로 70B 모델 실행:
- 분할 없이: 불가능 (단일 GPU에 40+ GB VRAM 필요).
- 분할 시: 각 GPU에 절반의 모델 가중치 할당. 추론 속도: 약 100 토큰/초 (통신 오버헤드 최소).
레이어 분할은 프로덕션 배포에 실용적이며 사용자에게 투명하게 작동합니다.
# vLLM: 자동 텐서 병렬 처리
vllm serve meta-llama/Llama-3.3-70B-Instruct \
  --tensor-parallel-size 2  # 2개의 GPU에 분산

# llama.cpp: 멀티 GPU 지원
ollama run llama3.3:70b  # GPU를 자동 감지하여 분할
KV 캐시 양자화: 컨텍스트 메모리 오버헤드 절감
KV 캐시 양자화는 추론 중 어텐션 키-값 쌍을 저장하는 데 필요한 메모리를 줄이며, 특히 긴 컨텍스트(32K+ 토큰) 처리 시 중요합니다. 모델 가중치 양자화(Q4_K_M)가 가장 일반적이지만, KV 캐시 양자화는 다른 메모리 병목 지점을 처리합니다.
추론 중 모델은 컨텍스트의 각 토큰에 대한 실행 키-값(KV) 쌍을 유지합니다. 32K 토큰 컨텍스트를 처리하는 7B 모델의 경우, KV 캐시만으로 정밀도에 따라 8–16 GB의 VRAM을 소비할 수 있습니다. 표준 KV 캐시는 FP16(값당 2바이트)를 사용하며, KV 캐시를 FP8 또는 Q8로 양자화하면 50% 절약됩니다.
KV 캐시 양자화 활성화 방법:
- Ollama: 호환 모델에서 자동 적용되며 별도 설정이 필요하지 않습니다.
- LM Studio: 설정에서 "KV cache quantization" 토글을 확인하십시오(버전에 따라 제공 여부 다름).
- llama.cpp: 서버 시작 시 `--cache-type-k q8_0 --cache-type-v q8_0`(짧은 형태는 `-ctk q8_0 -ctv q8_0`)을 지정합니다. `q8_0` 대신 `q4_0`을 쓰면 KV 캐시가 한 번 더 절반으로 줄어듭니다.
트레이드오프: KV 캐시 양자화는 품질에 미치는 영향이 최소화됩니다(공격적인 양자화에서도 1% 미만 저하). 어텐션 패턴은 모델 가중치보다 낮은 정밀도에 더 강건하기 때문입니다. 제한된 하드웨어에서 16K+ 컨텍스트를 처리하는 모델에 권장됩니다.
하이브리드 방식: 기법 결합
세 가지 기법을 모두 결합하면 최상의 결과를 얻을 수 있습니다. 구체적인 하드웨어 계획을 위해서는 VRAM 요구 사항 가이드를 참고하십시오.
시나리오 1: 단일 RTX 4090 (24 GB)에서 70B 실행
- Q4로 양자화 (35 GB → 18 GB)
- 나머지 6 GB 오프로딩 (시스템 RAM으로)
- 결과: 약 8–10 토큰/초 (느리지만 작동함)
시나리오 2: 2× RTX 4090에서 70B 실행
- Q5로 양자화 (43.75 GB)
- 2개의 GPU에 레이어 분할 (각 22 GB)
- 결과: 약 100 토큰/초 (실용적)
성능 트레이드오프는 무엇입니까?
각 기법은 VRAM 절감을 속도 페널티와 교환합니다. 양자화는 영향이 최소적이며, 오프로딩은 5–10배 속도 저하를 초래하고, 레이어 분할은 약 5% 오버헤드를 추가합니다.
기법 | 절감된 VRAM | 속도 영향 | 품질 영향 |
|---|---|---|---|
| 양자화 (Q4) | 50% | 없음 (±5%) | 미미 |
| 오프로딩 (CPU RAM) | 60–80% | 5–10배 느림 | 없음 |
| 레이어 분할 (GPU 2개) | 해당 없음 (더 큰 모델 가능) | 5–10% 느림 | 없음 |
| 양자화 + 오프로딩 | 75–90% | 3–5배 느림 | 미미 |
Mac Studio M5 Ultra: 오프로딩 없이 70B 네이티브 실행
M5 Ultra 탑재 Mac Studio($5,499부터, 96 GB 통합 메모리 기본 탑재, 최대 512 GB)는 Llama 3.3 70B를 Q4로 네이티브 실행할 수 있습니다 — 오프로딩도 레이어 분할도 필요하지 않습니다.
애플은 2026년 8월 25일 두 가지 칩으로 Mac Studio 라인업을 새로 선보였습니다: M5 Max($2,499부터, 최대 128 GB 통합 메모리, 애플이 공개한 사양 기준 최대 614 GB/s 대역폭)와 M5 Ultra($5,499부터 96 GB, 최대 512 GB, 애플이 공개한 사양 기준 최대 1.2 TB/s 대역폭)입니다. 두 칩 모두 이전 M2 Ultra 세대(최대 192 GB, 약 800 GB/s)를 대체합니다. DDR5 시스템 RAM 오프로딩은 여전히 약 90 GB/s로 제한됩니다 — 이 대역폭 격차가 70B급 모델에서 통합 메모리가 오프로딩보다 우수한 이유입니다.
M5 Max와 M5 Ultra에 대한 독립적인 처리량 벤치마크는 아직 존재하지 않습니다. 표준 구성은 2026년 9월 22일 출시되며, M5 Ultra의 512 GB 구성은 2026년 10월 말 출시됩니다. PromptQuorum은 이 하드웨어를 테스트하지 않았습니다 — 따라서 독립적인 측정값이 나올 때까지 신규 칩의 초당 토큰 수치는 표기하지 않습니다.
구성 | 모델 | 속도 | 복잡도 |
|---|---|---|---|
| 1× RTX 4090 + 오프로딩 | Llama 3.3 70B Q4 | 5–10 토큰/초 | 보통 |
| 2× RTX 4090 레이어 분할 | Llama 3.3 70B Q5 | ~100 토큰/초 | 높음 |
| 1× RTX 5090 (32 GB) | Llama 3.3 70B Q4 | 10–12 토큰/초 | 낮음 |
| Mac Studio M5 Ultra (96 GB~) | Llama 3.3 70B Q4 | 아직 미측정 | 낮음 (플러그 앤 플레이) |
LLM 양자화: 지역별 맥락
- EU (GDPR, 제44조) — 국경 간 AI 데이터 전송에는 적정성 결정 또는 표준 계약 조항이 필요합니다. Q4_K_M 양자화를 통해 7B 모델을 8 GB 엣지 디바이스에서 실행하면 제3자 클라우드 API 호출을 완전히 없앨 수 있습니다. 독일 BfDI와 프랑스 CNIL 모두 GDPR 제22조의 고위험 AI 처리에 로컬 추론을 권장합니다. 이러한 이유로 양자화된 Mistral 및 Llama 모델은 EU 기업 배포에서 지배적인 선택입니다.
- 일본 (METI AI 거버넌스 가이드라인 2024) — 일본 경제산업성은 기업 배포에 AI 거버넌스 문서를 요구합니다. 국내 인프라의 양자화된 모델은 METI의 "제어 가능성" 요건을 충족합니다 — 모델 가중치가 온프레미스에 유지됩니다. Q4_K_M 양자화를 통해 GPU 클러스터 없이 16–32 GB 기업 서버에서 13B–32B 모델이 실용적으로 작동합니다. Qwen3와 Llama 3는 일본 기업 환경에서 가장 많이 배포되는 모델 계열입니다.
- 중국 (CAC 생성형 AI 규정 2023) — 중국 사이버공간 관리국은 공개 배포 AI에 대한 보안 평가와 사용자 데이터 현지화를 요구합니다. 양자화된 중국어 네이티브 모델(Qwen3, Baichuan2, Yi)은 국내 하드웨어에서 완전히 실행되어 CAC 현지화 요건을 충족합니다. Q4_K_M 및 Q5_K_M 양자화는 FP16 대비 하드웨어 비용을 60–70% 절감하여 중견 기업의 온프레미스 CAC 준수를 경제적으로 실현 가능하게 합니다.
LLM 양자화에서 흔히 발생하는 실수는 무엇입니까?
- Q4_K_M 대신 Q4_0 다운로드 — Q4_0은 K-퀀트 개선이 없는 구형 양자화 방법입니다. Q4_K_M은 동일한 RAM 사용량에서 5–8% 더 나은 품질을 제공합니다. 두 가지가 모두 제공될 때는 항상 Q4_K_M을 선택하십시오.
- 양자화 번호가 높을수록 항상 품질이 낮다는 오해 — Q 번호가 높을수록 비트가 많고 품질이 더 좋습니다. Q8_0이 Q4_K_M보다 좋습니다. Q5_K_M이 Q4_K_M보다 좋습니다. Q4_K_M으로 양자화된 70B 모델은 대부분의 작업에서 Q8_0 7B 모델을 능가합니다.
- 모델 로드 전 RAM 여유 공간 미확인 — 모델 크기가 유일한 RAM 소비원이 아닙니다. OS, 브라우저 및 기타 애플리케이션도 RAM을 사용합니다. 8 GB 머신에서 4.5 GB Q4_K_M 7B 모델은 나머지 모든 작업에 3.5 GB만 남깁니다. 원칙: 모델 파일 크기 + 2 GB OS 오버헤드 + 1 GB 여유 공간 = 최소 필요 RAM.
다음 단계
- 필요한 VRAM은 얼마나? — 양자화 지식을 VRAM 예산에 적용하기 →
- CPU 전용 최고 LLM — CPU 추론용 최고 양자화 모델 →
- Ollama 최고 오픈소스 모델 — 양자화 수준을 이해했으니, 이제 모델을 선택하세요 →
LLM 양자화에 관한 자주 묻는 질문
Q4_K_XL은 무엇이고 Q4_K_M보다 나을까요?
Q4_K_XL은 llama.cpp의 표준 형식이 아니라 Unsloth의 Dynamic GGUF 변형입니다. Q4_K_M과 같은 4비트 기반을 유지하면서 가장 민감한 레이어를 더 높은 정밀도로 저장하므로, 파일 크기와 품질이 Q4_K_M과 Q5_K_M 사이에 놓입니다. Q5_K_M이 VRAM에 아슬아슬하게 들어가지 않을 때 주로 의미가 있습니다. Q5_K_M이 들어간다면 표준 형식이고 도구 지원이 넓은 Q5_K_M을 선택하세요.
Q5_K_M과 Q5_K_XL은 무엇이 다른가요?
Q4, Q8과 같은 원리입니다. Q5_K_M은 llama.cpp의 표준 K-quant이고, Q5_K_XL은 민감한 레이어를 더 높은 해상도로 담아 파일이 조금 커지는 Unsloth의 Dynamic 변형입니다. Q5_K_M은 이미 품질 손실이 1% 미만이므로 실질적인 이득은 크지 않습니다. XL 변형을 고르기 전에 도구에서 실제 파일 크기를 확인하세요.
FP8과 Q8_0 중 무엇을 써야 하나요?
llama.cpp, Ollama, LM Studio로 로컬 실행할 때 관련 있는 형식은 Q8_0입니다. FP8은 주로 최신 NVIDIA 하드웨어의 서버 추론에서 의미가 있는 자료형이며 GGUF 생태계에서 흔한 다운로드 선택지는 아닙니다. Q8_0은 이미 FP16 대비 품질 손실이 0.5% 미만이므로, 실제 선택은 Q8_0과 더 작은 K-quant 사이에서 이루어집니다.
Q4_0과 Q4_1은 아직 의미가 있나요?
없습니다. 둘 다 K-quant 개선이 들어가기 전의 오래된 형식입니다. Q4_0은 모든 가중치를 4비트로 균일하게 양자화하고, Q4_1은 오프셋을 더했지만 마찬가지로 대체되었습니다. Q4_K_M은 사실상 같은 메모리 사용량으로 눈에 띄게 나은 품질을 냅니다. 저장소에서 둘 다 보인다면 Q4_K_M을 고르십시오. Q4_0과 Q4_1은 이제 오래된 모델 업로드에서만 보입니다.
Ollama는 자동으로 최적의 양자화를 사용합니까?
그렇습니다 — `ollama pull llama3.1:8b`를 실행하면 Ollama는 기본적으로 Q4_K_M 변형을 다운로드합니다. 특정 양자화를 가져오려면 태그를 추가하십시오: `ollama pull llama3.1:8b-instruct-q5_K_M`. 각 모델의 사용 가능한 양자화 태그는 ollama.com/library의 모델 페이지에 나열되어 있습니다.
미리 양자화된 버전을 다운로드하는 대신 직접 모델을 양자화할 수 있습니까?
그렇습니다 — llama.cpp에는 GGUF 파일을 지원하는 모든 양자화 수준으로 변환하는 `quantize` 바이너리가 포함되어 있습니다. 프로세스는 모델 크기에 따라 5–30분이 소요됩니다. 결과는 동등하므로 대부분의 사용자는 직접 양자화하는 것보다 Hugging Face에서 미리 양자화된 GGUF 파일을 다운로드하는 것을 권장합니다.
양자화가 모델의 컨텍스트 창에 영향을 줍니까?
아닙니다 — 양자화는 모델 가중치 정밀도에만 영향을 미치며 컨텍스트 길이에는 영향을 주지 않습니다. Llama 3.1 8B 모델은 Q4_K_M으로 양자화되든 FP16으로 실행되든 128K 토큰을 지원합니다. 그러나 양자화에 관계없이 긴 컨텍스트를 처리하려면 더 많은 RAM이 필요합니다 — Q4_K_M 7B 모델로 64K 토큰 컨텍스트를 처리하면 10+ GB RAM이 필요할 수 있습니다.
GGUF와 GPTQ 양자화의 차이점은 무엇입니까?
GGUF(llama.cpp 형식)와 GPTQ는 두 가지 다른 양자화 방식입니다. GGUF는 K-퀀트를 사용하며 CPU와 GPU에서 모두 실행됩니다. GPTQ는 GPU 전용이며 PyTorch가 필요합니다. Ollama, LM Studio, Jan AI를 이용한 로컬 추론에는 GGUF가 올바른 형식입니다. GPTQ는 AutoGPTQ 및 vLLM 같은 GPU 중심 추론 프레임워크에서 사용됩니다.
Q4_K_M과 Q4_0의 차이점은 무엇입니까?
Q4_K_M과 Q4_0은 둘 다 4비트 양자화이지만 서로 다른 알고리즘을 사용합니다. Q4_0은 초기 llama.cpp의 원래 균일 4비트 형식입니다. Q4_K_M은 2023년에 도입된 K-퀀트로, 가중치를 블록으로 그룹화하고 각 블록 내에서 혼합 정밀도를 적용하여 동일한 RAM 사용량으로 5-8%의 품질을 회복합니다. Hugging Face에서 두 가지를 모두 볼 경우 항상 Q4_K_M을 선택하십시오. Q4_0은 레거시 호환성을 위해서만 존재합니다.
Hugging Face의 다른 제공자가 만든 Q4_K_M 모델 간에 품질 차이가 있습니까?
양자화 알고리즘은 llama.cpp에서 표준화되어 있으므로, 동일한 기본 모델의 Q4_K_M 양자화는 GGUF 파일을 누가 만들었는지에 관계없이 거의 동일합니다. 그러나 일부 제공자는 imatrix 양자화를 적용하여 동일한 비트 수에서 품질을 향상시킵니다. "imat" 또는 "importance matrix"로 설명된 파일은 일반적으로 동일한 비트 수에서 더 높은 품질을 제공합니다.
이매트릭스(imatrix) 양자화란 무엇입니까?
imatrix(중요도 행렬) 양자화는 교정 데이터를 사용하여 모델 출력에 미치는 중요도에 따라 가중치에 서로 다른 정밀도 수준을 할당합니다. 예측에 가장 큰 영향을 미치는 가중치는 더 많은 비트로 양자화되고, 덜 중요한 가중치는 더 적은 비트를 사용합니다. 결과: 균일 양자화 대비 동일한 비트 수에서 더 나은 품질. Qwen3 imatrix 양자화는 표준 Q4_K_M 대비 2–4% 더 좋습니다.
Q4_K_M과 Q4_K_S의 차이점은 무엇입니까?
두 가지 모두 4비트 양자화이지만, K_M(미디엄)과 K_S(스몰)는 양자화 블록당 메모리 할당이 다릅니다. Q4_K_M은 더 나은 품질 복원을 위해 더 많은 메타데이터를 사용합니다 — 7B 모델 기준 일반적으로 4.5–5 GB. Q4_K_S는 K_M 대비 300–400 MB를 절약하지만 3–5% 품질 손실이 있습니다. RAM이 4 GB 미만으로 극도로 제한된 경우를 제외하고는 Q4_K_M을 사용하십시오.
Q8_0과 Q8_K_XL의 차이점은 무엇입니까?
Q8_0은 llama.cpp의 표준 8비트 양자화입니다 — 모든 가중치가 8비트이며, 7B 모델 기준 약 7.7 GB, FP16 대비 손실은 0.5% 미만입니다. Q8_K_XL은 표준 llama.cpp 유형이 아니라 Unsloth의 "Dynamic" GGUF 변형으로, 8비트 기반을 유지하면서 가장 민감한 레이어(임베딩, 어텐션, 출력)를 16비트로 업캐스트하여 품질을 완전한 FP16에 더 가깝게 만듭니다. Q8_0이 대부분의 사용자에게 이미 사실상 무손실이므로, Q8_K_XL은 마지막 몇 분의 1 퍼센트의 정밀도가 필요하고 여유 VRAM이 있을 때만 도움이 됩니다. 파일 크기는 모델마다 다르므로 다운로드 전에 LM Studio나 Hugging Face에서 크기를 확인하십시오.
양자화 수준 간 전환 시 모델을 다시 다운로드해야 합니까?
그렇습니다 — 양자화 수준 전환에는 다른 GGUF 파일을 다운로드하거나 직접 기본 모델을 재양자화해야 합니다. Q4_K_M으로 양자화된 모델은 원본 FP16 모델 없이는 Q5_K_M으로 다시 변환할 수 없습니다. 대부분의 사용자는 원하는 양자화 수준의 미리 양자화된 GGUF 파일을 Hugging Face에서 다운로드합니다.
양자화는 추론 속도에 어떤 영향을 줍니까?
양자화는 일반적으로 추론 속도를 10–40% 향상시킵니다. 4비트 가중치를 로드하고 처리하는 것이 16비트 부동소수점보다 빠르기 때문입니다. Q4_K_M 7B 모델은 소비자용 CPU에서 약 8–12 토큰/초로 실행되며, 동일한 모델이 FP16에서는 약 1–2 토큰/초로 실행됩니다. GPU는 이미 부동소수점 연산에 최적화되어 있기 때문에 GPU에서의 양자화 성능 향상은 작습니다(5–15% 빠름).
Ollama는 기본적으로 어떤 양자화 수준을 사용합니까?
Ollama는 라이브러리의 모든 모델에 대해 Q4_K_M을 기본값으로 사용합니다. `ollama pull llama3.1:8b`를 실행하면 Q4_K_M 변형을 다운로드합니다. 이 기본값은 대부분의 사용자에게 품질과 RAM 요구 사항의 균형을 잘 맞춥니다. 다른 양자화를 가져오려면 태그를 추가하십시오: `ollama pull llama3.1:8b:q5_k_m` 또는 `ollama pull llama3.1:8b:q8_0`.
단일 RTX 4090에서 Llama 3.3 70B를 실행할 수 있습니까?
그렇습니다, 하지만 느립니다. Q4로 양자화(35 GB)하고 11 GB를 시스템 RAM으로 오프로드합니다. 5–10 토큰/초를 예상하십시오 — 실시간 채팅에는 너무 느리지만 배치 처리에는 적합합니다. 실용적인 70B 추론을 위해서는: 레이어 분할로 2× RTX 4090(~100 토큰/초) 또는 통합 메모리에 모델을 네이티브로 담을 수 있는 M5 Ultra 탑재 Mac Studio를 사용하십시오(독립적인 토큰/초 벤치마크는 아직 없습니다 — 해당 칩은 2026년 9월 22일 출시됩니다).
양자화와 오프로딩의 차이점은 무엇입니까?
양자화는 모델 가중치 정밀도를 영구적으로 줄입니다(FP16 → Q4). 모델 파일이 작아집니다. 오프로딩은 런타임에 모델 레이어를 VRAM에서 시스템 RAM으로 이동합니다. 양자화는 품질에 미치는 영향이 최소화되고(±5%), 오프로딩은 5–10배 속도 저하를 초래합니다. 양자화를 먼저 사용하고, 오프로딩은 최후의 수단으로 사용하십시오.
Mac Studio M5 Ultra는 70B 모델에 양자화가 필요합니까?
경미한 양자화만 필요합니다. M5 Ultra 탑재 Mac Studio는 최소 96 GB 통합 메모리(최대 512 GB)를 제공하며, Llama 3.3 70B를 Q4(35 GB)로 네이티브 실행할 수 있습니다 — 오프로딩이나 레이어 분할 없이도 가능합니다. Q5에서도 70B가 맞습니다(44 GB). FP16 70B(140 GB)도 맞지만 더 느리게 실행됩니다. Q4는 Mac Studio 70B 워크플로의 최적 선택입니다.
내 하드웨어에 가장 적합한 기법 조합은 무엇입니까?
단일 RTX 4090 (24 GB): Q4 + 오프로딩으로 70B (느림). Q5 네이티브로 32B (빠름). 2× RTX 4090 (48 GB): Q5 + 레이어 분할로 70B (100 토큰/초). RTX 5090 (32 GB): Q4 네이티브로 70B (10–12 토큰/초). Mac Studio M5 Ultra (96–512 GB): 오프로딩 없이 Q4 네이티브로 70B 실행 — 독립적인 토큰/초 벤치마크는 칩 출시일인 2026년 9월 22일 이후를 기다려야 합니다.
모델을 다시 다운로드하지 않고 양자화 수준을 전환할 수 있습니까?
아닙니다 — 양자화 수준 전환에는 다른 GGUF 파일을 다운로드하거나 직접 기본 모델을 재양자화해야 합니다. Q4_K_M으로 양자화된 모델은 원본 FP16 모델 없이는 Q5_K_M으로 다시 변환할 수 없습니다.
출처
- llama.cpp 양자화 문서
- K-퀀트 기술 논의 — 최초 K-퀀트 PR
- GGUF 형식 명세
- Open LLM 리더보드 — 양자화 벤치마크
업데이트 로그
- 2026-08-26: 반기 업데이트. 영어 버전과의 구조적 일관성을 위해 누락되었던 5개 비교 섹션(Q8_0이란?, Q4_0 vs Q4_K_M, Q4_K_M vs Q4_K_S, Q8_0 vs Q4_K_M, Q8_0 vs Q8_K_XL)과 schema/faqSchema/gammaEmbedUrl 블록 전체를 추가. 내부 링크 13개에 누락된 `/ko/` 접두사를 추가. 모든 표의 영어 열 머리글(Level, Bits, Model Size 등)을 한국어로 번역. "2026년 4월 기준"을 2026년 8월로 갱신.
- 2026-05-17: 결정 중심 의도를 반영하도록 제목 업데이트; 내용 변경 없음.