홈 제어에 중요한 것
좋은 홈 제어 모델을 결정하는 세 가지: 지연 시간, 신뢰할 수 있는 함수 호출, 하드웨어에 맞는 크기입니다. 벤치마크 리더보드는 반응성보다 훨씬 덜 중요합니다.
- 지연 시간: 음성 명령이 거의 즉각적으로 느껴져야 합니다. 고성능 하드웨어의 소형 모델이 더 빠르게 응답합니다.
- 함수 호출: 모델이 구조화된 장치 동작을 안정적으로 출력해야 합니다. 이것이 결정적인 능력입니다.
- 적합성: 모델이 Home Assistant를 호스팅하는 기기에서 편안하게 실행되어야 합니다. 로컬 스마트 홈을 위한 최고의 하드웨어를 참조하십시오.
단축 목록
2026년 Home Assistant 툴 호출에서 가장 많이 언급되는 것은 Qwen3.5와 Qwen3이며, Gemma 4가 가장 새로운 계열입니다. 가벼운 하드웨어에는 4B 모델을, GPU나 NPU가 있으면 8B~9B 모델을 사용하십시오. Qwen3.5와 Gemma 4는 Ollama 페이지에 네이티브 툴 지원이 표기되어 있지만 커뮤니티의 Assist 결과는 아직 엇갈리므로 직접 쓰는 명령으로 테스트하십시오.
- Qwen3.5 4B (Alibaba): 툴과 thinking을 지원하는 현세대 4B 모델. 커뮤니티 가이드는 8 GB GPU에서 안정적인 툴 호출을 보고합니다 —
qwen3.5:4b. - Qwen3.5 9B (Alibaba): 기본
qwen3.5태그로, 다중 기기 명령에 강하다고 보고됩니다. 다만 Qwen3 8B보다 뚜렷이 낫지는 않다는 테스터도 있습니다 —qwen3.5:9b. - Gemma 4 E4B (Google): 유효 파라미터 4.5B에 네이티브 함수 호출과 설정 가능한 thinking을 지원합니다. 커뮤니티 보고에서는 빠르지만 능력은 다소 떨어진다고 평가합니다 —
gemma4:e4b. - Gemma 4 26B-A4B (Google): 활성 파라미터 3.8B의 전문가 혼합 모델로 다운로드 16~19 GB, 24 GB급 메모리 호스트용 —
gemma4:26b. - Gemma 3 4B (Google): 광범위한 다국어 지원(140개 이상 언어)을 갖춘 40억 매개변수 모델로 강력한 저전력 선택입니다 — Ollama 태그
gemma3:4b. - Qwen3 4B (Alibaba): 신뢰할 수 있는 툴 사용과 우수한 다국어 지원을 갖춘 빠른 4B 모델로 CPU 또는 내장 GPU에서 낮은 지연 시간 —
qwen3:4b. - Phi-4-mini (Microsoft): 명령 이행에서 크기 이상의 성능을 발휘하는 컴팩트한 3.8B 모델 —
phi4-mini. - Llama 3.2 3B (Meta): 우수한 함수 호출로 평범한 하드웨어에서 실행되는 광범위하게 지원되는 3B 기준 모델 —
llama3.2:3b. - Qwen3 8B (Alibaba): GPU 또는 NPU에서 최고의 품질, Home Assistant 툴 호출의 선호 모델 —
qwen3:8b.
비교
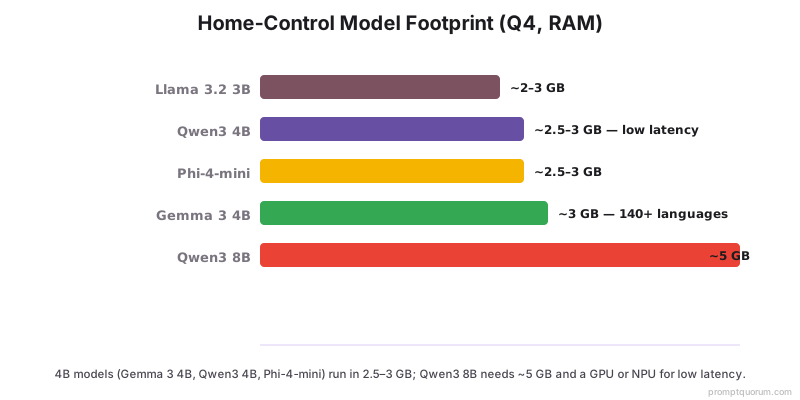
하드웨어와 언어로 선택하십시오: CPU 전용 또는 Pi급 하드웨어에는 소형 모델, GPU 탑재 미니 PC에는 8B. 아래 크기는 일반적인 4비트 양자화에서 근사치입니다. Ollama 태그가 다운로드할 정확한 모델입니다.
- 풋프린트는 근사치이며 양자화에 따라 달라집니다. VRAM 및 양자화 심도는 local-llms 클러스터로 연결하십시오.
- Qwen3.5와 Gemma 4의 크기는 Ollama 페이지에 표기된 다운로드 크기입니다. Gemma 4 E4B는 표기된 8B에 임베딩이 포함되어 있어 유효 4.5B로 짐작하는 것보다 큽니다.
모델 | 매개변수 | 근사 풋프린트 (Q4) | Ollama 태그 | 최적 용도 |
|---|---|---|---|---|
| Gemma 3 4B | 4B | ~3 GB | gemma3:4b | 저전력 호스트, 140개 이상 언어 |
| Qwen3 4B | 4B | ~2.5–3 GB | qwen3:4b | 낮은 지연 시간, 다국어, 툴 |
| Phi-4-mini | 3.8B | ~2.5–3 GB | phi4-mini | 강력한 명령 이행 |
| Llama 3.2 3B | 3B | ~2–3 GB | llama3.2:3b | 광범위하게 지원되는 기준 모델 |
| Qwen3 8B | 8B | ~5 GB | qwen3:8b | GPU/NPU에서 최고 품질; HA 선호 모델 |
| Qwen3.5 4B | 4B | ~3.3 GB | qwen3.5:4b | 현세대 소형, 툴 지원 |
| Qwen3.5 9B | 9B | ~6.6 GB | qwen3.5:9b | 다중 기기, GPU용 |
| Gemma 4 E4B | 4.5B (eff.) | ~6.6–9.5 GB | gemma4:e4b | 빠름, 툴 호출 확인 필요 |
| Gemma 4 26B-A4B | 26B (3.8B active) | ~16–19 GB | gemma4:26b | 24 GB급 메모리 호스트 |
하드웨어 예산별 선택
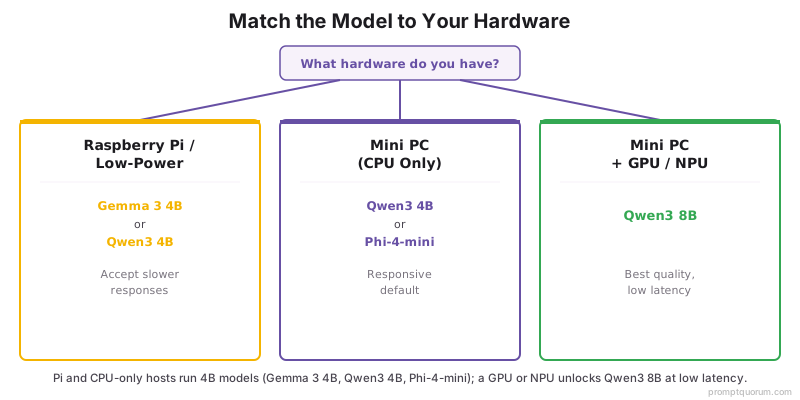
Pi 또는 CPU 전용 미니 PC에는 4B 모델, GPU 또는 NPU가 있을 때는 8B 모델을 선택하십시오. 이렇게 하면 모든 계층에서 응답이 빠릅니다.
- Raspberry Pi / 저전력: 더 느린 응답을 감수하고 Gemma 3 4B 또는 Qwen3 4B.
- 미니 PC(CPU 전용): 응답성 좋은 기본값으로 Qwen3.5 4B, Qwen3 4B 또는 Phi-4-mini.
- GPU/NPU 탑재 미니 PC: 허용 가능한 지연 시간에서 최고 품질을 위해 Qwen3.5 9B 또는 Qwen3 8B, 24 GB급 메모리가 있다면 Gemma 4 26B-A4B — Home Assistant + 로컬 AI를 위한 최고의 미니 PC 참조.
Home-LLM과 파인튜닝된 홈 모델
Home-LLM은 기기 제어용으로 파인튜닝된 소형 모델과 함께 쓰는 Home Assistant용 커뮤니티 커스텀 통합으로, 공식 Ollama 통합으로 범용 모델을 불러오는 방식과는 다른 경로입니다. 저장소는 Home-Llama-3.2-3B(3B)와 Home-FunctionGemma-270m(270M)을 권장하며 llama.cpp, Ollama, OpenAI 호환 백엔드를 지원합니다.
- 하드웨어가 매우 제한적일 때 선택하십시오. 기기 제어용 270M~3B 모델은 범용 8B 모델보다 메모리가 훨씬 적게 듭니다.
- 대화, 요약, 유연한 표현도 원한다면 범용 4B~9B 모델을 선택하십시오. 파인튜닝된 홈 모델은 범위가 좁습니다.
- 설치 전에 프로젝트 저장소에서 최신 릴리스와 필요한 Home Assistant 버전을 확인하십시오. 프로젝트는 버전 간 호환성이 깨지는 변경을 문서화합니다.
벤치마크와 테스트
로컬 모델에 대한 Home Assistant 공식 리더보드는 없으며, 공개된 수치는 검증된 순위가 아닌 커뮤니티 테스트입니다. 한 커뮤니티 구축 로그는 다중 기기 명령, 문맥 단서, 잘못 들은 명령으로 여러 로컬 모델을 테스트했고 모델과 thinking 설정에 따라 결과가 크게 달랐다고 보고했습니다.
- 다중 기기 명령("주방과 복도 불 꺼 줘"), 문맥 단서("좀 더 따뜻하게"), 잘못 들었거나 불완전한 명령을 테스트하십시오.
- thinking을 켠 경우와 끈 경우를 비교하십시오. thinking은 보통 지연을 늘려 음성 제어에 불리합니다.
- 사양표의 초당 토큰 수가 아니라 직접 쓰는 호스트에서 첫 응답까지의 시간을 측정하십시오.
- HomeSec-Bench 점수를 Home Assistant 결과로 해석하지 마십시오. 보안 카메라 어시스턴트 작업을 측정하며 Assist 기기 제어가 아닙니다.
선택 방법
4B 모델로 시작하여 지연 시간과 신뢰할 수 있는 장치 동작을 확인하고, 품질이 부족한 경우에만 8B로 전환하십시오. 결정하기 전에 실제 명령으로 테스트하십시오.
- Ollama 통합을 통해 설치하고 일반적인 명령을 테스트하십시오.
- 응답이 느리면 크기를 줄이거나 GPU/NPU를 추가하십시오.
- 동작이 불안정하면 함수 호출로 알려진 모델을 선호하십시오.
- 깊은 모델 순위와 메커니즘은 최고의 로컬 LLM 2026(크로스 클러스터)를 참조하십시오. 이 가이드는 홈 제어 특화입니다.
자주 묻는 질문
홈 제어에 사용 가능한 가장 소형 모델은 무엇입니까?
Llama 3.2 3B 같은 3B 모델은 저전력 하드웨어에서 신뢰할 수 있는 장치 제어를 위한 실용적인 최저선입니다. 일부 이해력을 속도와 교환합니다. 하드웨어가 허용한다면 Gemma 3 4B나 Qwen3 4B 같은 4B 모델이 더 나은 균형입니다.
홈 제어 모델에 GPU가 필요합니까?
CPU 또는 내장 GPU에서 실행되는 4B 모델에는 필요하지 않습니다. GPU 또는 NPU는 주로 더 나은 이해를 위해 낮은 지연 시간으로 Qwen3 8B 같은 8B 모델을 실행할 수 있게 합니다. 하드웨어에 맞는 모델을 선택하십시오.
어떤 모델이 함수 호출을 지원합니까?
Qwen3, Gemma 3, Phi-4-mini를 포함한 현대 소형 모델은 신뢰할 수 있는 장치 동작을 출력할 수 있는 능력인 Home Assistant 툴/함수 호출 지원이 검증되어 있습니다. 홈 제어에는 이를 지원하는 것으로 문서화된 모델을 선호하십시오.
Raspberry Pi에 가장 적합한 모델은 무엇입니까?
Gemma 3 4B나 Qwen3 4B 같은 4B 모델이 Raspberry Pi의 실용적인 상한선이며 응답이 미니 PC보다 느립니다. 빠른 어시스턴트를 원한다면 GPU/NPU로 Qwen3 8B를 실행하는 미니 PC가 더 나은 호스트입니다.
Home Assistant 음성 제어에 가장 좋은 LLM은 무엇입니까?
툴 호출을 지원하고 지연이 낮은 소형 모델입니다. 가벼운 하드웨어에는 Qwen3.5 4B 또는 Qwen3 4B, GPU가 있으면 Qwen3.5 9B 또는 Qwen3 8B를 쓰십시오. 음성에서는 thinking이 지연을 늘리므로 thinking 없는 모드를 권장합니다. 공식 벤치마크는 없으므로 직접 쓰는 명령으로 테스트하십시오.
Home Assistant에 가장 좋은 4B LLM은 무엇입니까?
Qwen3.5 4B와 Qwen3 4B가 툴 호출에서 가장 많이 언급되는 4B 선택입니다. Gemma 3 4B와 Gemma 4 E4B는 대안이며, 커뮤니티 보고는 Gemma 4 E4B를 빠르지만 툴 호출 능력은 다소 떨어진다고 평가합니다. 직접 쓰는 명령으로 테스트하십시오.
Home-LLM이란 무엇입니까?
Home-LLM은 Home-Llama-3.2-3B, Home-FunctionGemma-270m처럼 기기 제어용으로 파인튜닝된 소형 모델과 함께 쓰는 Home Assistant용 커뮤니티 커스텀 통합입니다. llama.cpp, Ollama, OpenAI 호환 백엔드를 지원합니다. 현재 버전 요구 사항은 저장소에서 확인하십시오.
Home Assistant용 LLM 벤치마크가 있습니까?
로컬 모델에 대한 Home Assistant 공식 리더보드는 없습니다. 입수 가능한 수치는 커뮤니티 테스트이며 모델, 양자화, thinking 설정에 따라 달라집니다. 다중 기기, 문맥, 잘못 들은 명령으로 직접 테스트하십시오.