로컬 LLM 순위·추천 2026: 모델 성능 비교, Ollama, LM Studio 및 하드웨어 가이드
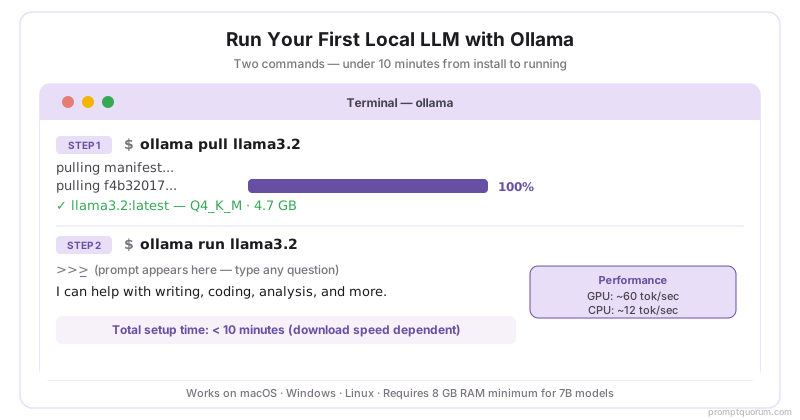
로컬 LLM은 인터넷 연결, API 요금, 데이터 전송 없이 전적으로 자신의 컴퓨터에서 실행되는 대규모 언어 모델입니다. 로컬 AI와 로컬 LLM은 같은 것을 가리킵니다. 처음이라면 Ollama를 설치하고 8GB RAM으로 Llama 3.2 3B 또는 Qwen3.5 4B를 10분 이내에 실행할 수 있습니다. 아래 가이드는 VRAM 등급별 순위와 추천으로, 모델 종류와 성능을 가성비까지 비교합니다.
여기서 시작
독자가 가장 먼저 묻는 질문과, 먼저 열어 볼 가이드입니다. 맞는 것을 고르세요.
주제별 탐색
15개 주제, 가이드 173개. 클릭하면 그 자리에서 주제가 열립니다.
시작하기 12 가이드
10분 이내에 제로에서 실행까지. OS별 설치 가이드, 첫 모델 실행 안내, 초보자를 위한 개인 정보 보호 우선 설정 체크리스트. Ollama는 macOS, Windows, Linux에서 단 하나의 명령으로 설치됩니다. 8 GB RAM의 경우 `ollama pull llama3.2:3b`로 Llama 3.2 3B(Q4, ~2 GB)를 시작하세요.
하드웨어 및 성능 11 가이드
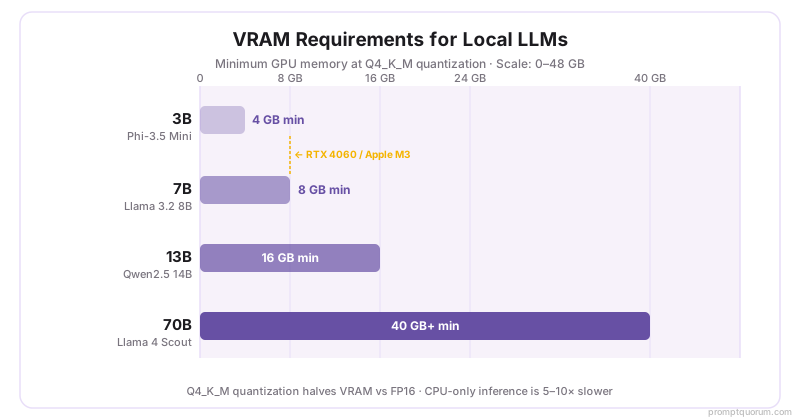
VRAM은 로컬 LLM의 가장 큰 제약입니다. Q4_K_M의 7B 모델에는 약 4~5 GB, 70B 모델에는 약 42 GB가 필요합니다. 가이드는 GPU 선택(RTX 4070 Ti부터 RTX 5090까지), Apple Silicon, 예산형 구성, 모든 모델의 VRAM 계산을 다룹니다.
GPU 구매 가이드 9 가이드
예산과 용도에 따른 GPU 선택, 토큰당 비용, 전력 효율, 열 설계, 중고 시장 비교, 보증 관련 득실. RTX 4090 같은 24 GB 카드는 27B급 모델에 적합하고, 70B 모델에는 약 48 GB가 필요합니다. 2026년 메모리 부족으로 가격이 변동했으므로 각 가이드에서 최신 수치를 안내합니다.
미니 PC와 AI 컴퓨터 12 가이드
로컬 AI용 소형 기기: 미니 PC, AMD Strix Halo와 NVIDIA DGX Spark 워크스테이션, Mac mini, 완제품 AI 박스를 메모리·속도·가격으로 비교합니다.
PC 구성 및 노트북 11 가이드
본격적인 로컬 추론을 위한 여러 가격대의 완성 시스템 구성, 노트북, 워크스테이션, 스토리지, 운영체제 선택.
Apple 실리콘 11 가이드
M 시리즈 Apple 실리콘 전용 Mac 가이드 — 통합 메모리 용량 산정, MLX 대 Ollama·llama.cpp 벤치마크 비교, Metal 기반 Whisper 음성 인식, 로컬 추론을 위한 Mac mini/MacBook 구성을 다룹니다. Apple 실리콘은 CPU와 GPU가 통합 메모리를 공유하므로, 32GB RAM을 갖춘 M 시리즈 Mac은 별도 GPU 없이도 300억 파라미터급 모델을 실행할 수 있습니다. MLX는 Apple 자체 추론 프레임워크로, 동일 칩에서 llama.cpp보다 대체로 더 빠릅니다.
모바일 및 온디바이스 AI 12 가이드
iPhone, iPad, Android, 태블릿에서 쓰는 로컬 LLM: 오프라인으로 실행되는 앱과 소형 모델, 스마트폰 칩의 성능, 온디바이스 AI와 PC에서 모델을 돌리는 방식의 차이.
클라우드 GPU와 대여 4 가이드
클라우드 GPU 대여가 하드웨어 구매보다 유리한 경우: 제공업체 비교, EU 데이터 보호 관점, 중국 클라우드 옵션, 기업의 온프레미스 대 대여 손익분기점.
사용 사례별 모델 20 가이드
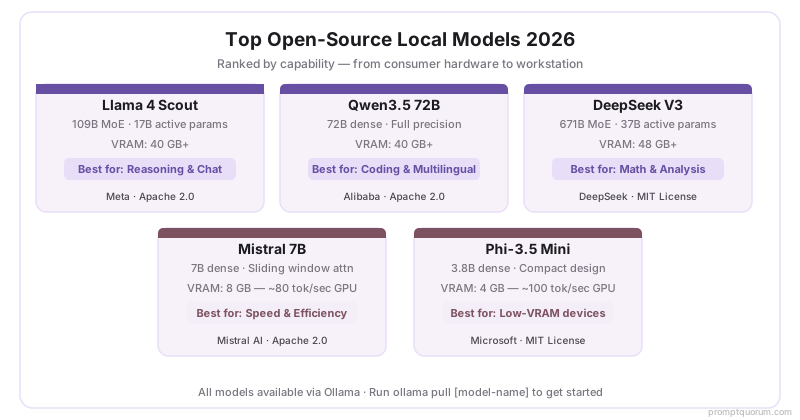
모델 순위, 벤치마크 비교, 메모리 구간별 추천. 현재 추천: 24 GB 카드에는 Qwen3.8-27B, 12 GB에는 Gemma 4 12B, 16 GB에는 gpt-oss-20b, 8 GB 기기에는 Qwen3 8B 또는 Qwen3.5 4B, CPU 전용에는 Phi-4 Mini입니다. 벤치마크 점수는 직접 측정했다고 표시한 경우를 제외하고 제조사가 발표한 값입니다.
도구 및 인터페이스 25 가이드
Ollama와 LM Studio는 macOS, Windows, Linux에서 다양한 오픈 모델을 실행합니다. Ollama는 CLI 중심이며 REST API를 제공하고, LM Studio는 모델 브라우저가 내장된 그래픽 인터페이스를 제공합니다. 가이드는 두 도구와 함께 vLLM, llama.cpp, Open WebUI, IDE 연동을 다룹니다.
개발자 및 MLOps 도구 10 가이드
운영 환경에서 로컬 모델을 둘러싼 스택: 코딩 어시스턴트, API 게이트웨이, 벡터 데이터베이스, 파인튜닝 및 에이전트 프레임워크, 평가, 관측성, AI 코드 리뷰.
고급 기법 13 가이드
파인튜닝, RAG 파이프라인, 양자화 심화 분석, 증류, 모델 병합, 프로덕션 사용을 위한 프롬프트 최적화. LoRA와 QLoRA는 전체 파인튜닝에 비해 필요한 메모리를 크게 줄입니다. 로컬 RAG 워크플로우는 검색 품질을 유지하면서 민감한 데이터를 온프레미스에 보관합니다.
엔터프라이즈 15 가이드
멀티 GPU 구성, 추론 최적화, 모델 서빙 프레임워크(vLLM, TensorRT-LLM), 모니터링과 관측성, 비용 감사, 규제 준수. 로컬 실행은 데이터를 제3자 API로 보내지 않아도 되고 사용량에 따라 SaaS보다 라이선스 비용을 줄일 수 있지만, 규정 준수 여부는 전체 구성에 달려 있습니다.
개인 정보 보호 및 비즈니스 4 가이드
개인정보 보호와 규정 준수 작업을 위한 온프레미스 도입(GDPR, HIPAA, APPI, CAC). 망 분리 구성과 접근 로깅. 로컬 LLM은 API 공급업체 종속을 피하고, 규정 준수 감사 범위를 줄일 수 있으며, 자체 데이터를 제3자 서버 밖에 둘 수 있습니다. 다만 규정 준수 자체는 전체 구성에 달려 있습니다.
비용 및 비교 5 가이드
손익분기 분석: 로컬, 클라우드, 구독 모델 비교. SaaS의 숨은 비용: 초과 요금, 기업용 좌석, 감사 로그. 로컬 하드웨어가 비용을 회수하는지는 주로 월간 사용 시간에 달려 있으며, 계산기에서 직접 수치를 입력할 수 있습니다.
실용적인 답
간단한 메모리 공식으로 계산한 네 가지 실용적인 답입니다(실측이 아닌 추정치). 전체 표는 페이지 하단에 있습니다.
요약: 7B 모델은 8 GB RAM으로 실행할 수 있고, 모든 데이터는 내 기기에 남으며, 하드웨어를 갖춘 뒤에는 API 비용이 들지 않습니다.
최근 업데이트
가장 최근에 변경된 여섯 페이지.
프레젠테이션으로 보는 개요
아래 슬라이드는 하드웨어 요구 사항(7B 모델은 8 GB VRAM, 70B 모델은 약 42 GB), 2026년 최고의 오픈소스 모델, 5분 만에 끝내는 Ollama 설정, Q4_K_M 양자화, 지역별 규정 준수(GDPR, APPI), 핵심 요점을 다룹니다. PDF를 로컬 LLM 빠른 참조 카드로 내려받으세요.
자주 묻는 질문
로컬 LLM이란 무엇입니까?
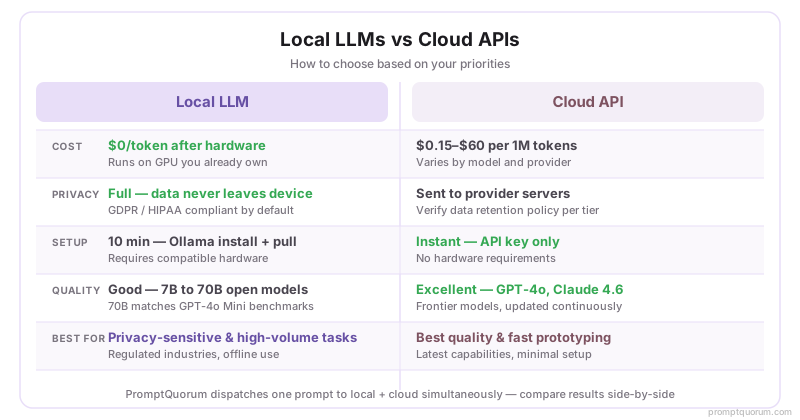
클라우드 API 대신 자신의 하드웨어에서 실행되는 대규모 언어 모델입니다(예: Qwen3.8, Gemma 4, gpt-oss, DeepSeek). 프롬프트와 파일이 사용자의 기기에 남고, 오프라인에서 동작하며, 사용 제한이 없고, 하드웨어 구입 후에는 토큰당 비용이 들지 않습니다.
로컬 LLM에는 VRAM이 얼마나 필요합니까?
8 GB VRAM으로 Q4 양자화의 7~8B 모델(가중치 약 5 GB)을 실행할 수 있습니다. 16 GB면 13~14B 모델을 여유 있게 처리합니다. 70B 모델은 Q4 가중치만 약 42 GB가 필요하므로 48 GB 구성(예: RTX 4090 두 장)이 현실적인 최소 사양입니다. Apple Silicon의 통합 메모리는 VRAM으로 계산됩니다.
Ollama와 LM Studio의 차이는 무엇입니까?
Ollama는 간단한 터미널 명령으로 모델을 실행하는 CLI 도구이며 `localhost:11434`에서 OpenAI 호환 API를 제공합니다. LM Studio는 데스크톱 GUI, 모델 브라우저, 내장 채팅 인터페이스를 제공합니다. 둘 다 같은 모델을 지원합니다.
로컬 LLM이 GPT나 Claude 같은 클라우드 모델에 필적할 수 있습니까?
Qwen3.8-27B나 Gemma 4 같은 오픈 웨이트 모델은 24 GB GPU 한 장으로 일상적인 코딩, 글쓰기, 요약을 처리합니다. 복잡한 다단계 추론에서는 최상위 클라우드 모델이 여전히 앞섭니다. 제조사가 발표하는 벤치마크 수치는 테스트마다 다르므로, 선택하기 전에 직접 프롬프트로 시험해 보시기 바랍니다.
로컬 모델을 파인튜닝하려면 어떻게 합니까?
파인튜닝에는 500개 이상의 레이블이 지정된 학습 예제, QLoRA 프레임워크(4비트 양자화로 VRAM 요구량을 줄임), 24 GB 이상의 VRAM(또는 클라우드 GPU 대여), 그리고 7B 모델 기준 1~4시간의 학습 시간이 필요합니다.
2026년에 로컬 LLM을 실행하기 위한 최소 하드웨어는 무엇입니까?
최소: 8 GB RAM과 최신 CPU(3B~7B 모델을 약 2~5 tokens/sec로 실행). 권장: 8 GB 이상의 VRAM을 갖춘 GPU(RTX 3060 이상)로 7~8B 모델에서 약 15~40 tokens/sec.
로컬 LLM은 무료로 사용할 수 있습니까?
대부분 무료입니다. Ollama는 오픈소스이고, LM Studio는 무료로 사용할 수 있지만 소스가 공개되어 있지 않습니다. Qwen, Gemma, gpt-oss, Mistral, DeepSeek 같은 대부분의 오픈 웨이트 모델은 무료로 내려받을 수 있지만 라이선스가 서로 다르고 Llama는 커뮤니티 라이선스를 사용하므로, 상업적으로 사용하기 전에 조건을 확인하시기 바랍니다. 주된 비용은 하드웨어입니다.
2026년 코딩에 가장 좋은 로컬 LLM은 무엇입니까?
24 GB GPU에는 Qwen3.8 27B가 1순위입니다(18 GB, 256K 컨텍스트). Devstral Small 2(24B, 15 GB)는 16 GB 기기에, Qwen3 8B는 8 GB 기기에 적합합니다. IDE 자동 완성에는 Codestral 22B가 여전히 흔한 선택이며, CPU만 사용한다면 Phi-4 Mini가 실용적입니다. 벤치마크 점수는 제조사가 발표한 값이며, 자세한 내용은 코딩 가이드를 참고하시기 바랍니다.
GPU 없이 로컬 LLM을 실행할 수 있습니까?
가능합니다. 최신 CPU라면 Ollama(CPU 모드)나 LM Studio로 Q4 양자화의 3B~7B 모델을 실행할 수 있습니다. 속도는 노트북 CPU에서 7B 모델이 약 2~8 tokens/sec, 3~4B 모델은 그보다 빠르며, RTX 4060에서는 20~50 tokens/sec입니다. 7B Q4에는 약 5 GB의 RAM(VRAM이 아님)이 필요합니다. CPU만 사용하는 구성에서는 Phi-4 Mini(3.8B)와 Llama 3.2 3B가 품질 대비 속도가 가장 좋습니다.
새 버전이 나오면 로컬 LLM 모델을 어떻게 업데이트합니까?
Ollama: `ollama pull <model-name>`을 다시 실행합니다 — 변경된 레이어만 내려받습니다. LM Studio: 모델 브라우저를 열어 업데이트된 버전을 찾아 내려받습니다. 이전 GGUF 파일은 자동으로 삭제되지 않으므로 ~/.ollama/models(Ollama) 또는 ~/Library/Application Support/LM Studio/models(macOS)에서 직접 삭제해 디스크 공간을 확보하세요. 새 모델은 보통 공식 출시 후 며칠 안에 Ollama 라이브러리에 올라옵니다.
2026년 최고의 Ollama 모델은 무엇입니까?
Ollama 라이브러리의 추천: Qwen3.8-27B(24 GB 카드에 권장, `ollama pull qwen3.8:27b`, 18 GB), gpt-oss:20b(소형 모델, 16 GB급), Gemma 4(비전 및 도구 호출, E2B부터 31B까지, `ollama pull gemma4:12b`는 약 8 GB), 8 GB 기기용 Qwen3 8B(`ollama pull qwen3:8b`, 약 5 GB), 단계별 추론용 DeepSeek-R1 증류 모델. 내려받은 뒤 `ollama run <name>`으로 어떤 모델이든 실행할 수 있습니다.
RTX 3060 12 GB에는 어떤 로컬 LLM이 가장 적합합니까?
RTX 3060 12 GB는 로컬 LLM에 적합한 GPU입니다. 추천 모델: Qwen3 14B(약 9 GB, 9~12 tokens/sec), Gemma 4 12B(약 8 GB, 11~14 tokens/sec), Qwen3 8B(16~20 tokens/sec), DeepSeek-R1 7B(10~12 tokens/sec). Llama 4 Scout는 약 67 GB가 필요해 들어가지 않습니다. 12 GB VRAM은 RTX 3060 Ti(8 GB)보다 넉넉해 13~14B급 모델을 온전한 품질로 사용할 수 있습니다.
Ollama vs LM Studio vs Jan.ai: 무엇을 사용해야 합니까?
CLI와 localhost:11434의 OpenAI 호환 API가 필요한 개발자에게는 Ollama, 데스크톱 GUI와 모델 브라우저가 필요한 입문자에게는 LM Studio, 개인정보 보호 중심의 채팅 앱과 내장 모델 스토어가 필요하면 Jan.ai가 적합합니다. 세 가지 모두 같은 GGUF 모델을 지원합니다. 설정 시간: Ollama 2분, LM Studio 5분, Jan.ai 5분.
2026년 로컬 LLM에 적합한 가성비 GPU는 무엇입니까?
당사의 가성비 GPU 가이드에 따르면, 중고 RTX 3060 12 GB(약 $270~300, 미국 가격)가 살 만한 가장 저렴한 카드이며 Qwen3 14B를 9~12 tokens/sec, Qwen3 8B를 16~20 tokens/sec로 실행합니다. 새 제품으로는 RTX 5060 Ti 16 GB(약 $570~600)와 Intel Arc B580 12 GB(약 $250~290)가 있습니다. 2026년에는 메모리 부족으로 가격이 올랐으므로 최신 수치는 가이드를 확인하세요. 최소 권장 사양: 실용적인 7B 추론에는 8 GB VRAM.
로컬 LLM이 ChatGPT보다 낫습니까?
개인정보 보호와 비용 면에서는 그렇습니다. 가장 어려운 작업의 출력 품질에서는 대체로 그렇지 않습니다. 최상위 클라우드 모델은 복잡한 추론에서 로컬로 실행할 수 있는 모델보다 여전히 앞섭니다. 일상적인 작업에는 24 GB GPU의 27B급 로컬 모델이 질의당 비용 없이 쓸 수 있는 유력한 대안입니다.
로컬 LLM을 실행하려면 RAM이 얼마나 필요합니까?
최소: Q4 양자화의 7B 모델에 8 GB RAM. 권장: 13B 모델에 16 GB, 70B 모델에 약 48 GB(Q4 가중치 약 42 GB에 여유분 추가). Apple Silicon의 통합 메모리는 전부 계산됩니다 — 18 GB의 M3 Mac은 13B 모델을 잘 실행합니다. GPU 추론에서는 VRAM이 RAM과 같은 역할을 합니다.
로컬 LLM은 어떻게 실행합니까?
Ollama(ollama.com)를 설치한 뒤 명령 하나를 실행합니다: `ollama run llama3.1:8b`. 모델이 자동으로 내려받아지며 5분 이내에 대화를 시작할 수 있습니다. API 키도, 계정도 필요 없고 처음 내려받은 뒤에는 인터넷 연결도 필요하지 않습니다.
2026년 최고의 무료 로컬 LLM은 무엇입니까?
24 GB GPU에는 Qwen3.8-27B(18 GB, `ollama pull qwen3.8:27b`). 16 GB에는 gpt-oss:20b 또는 Gemma 4 12B. 8 GB에는 Qwen3 8B. CPU만 사용하는 구성에는 Phi-4 Mini. 모두 오픈 웨이트이며 `ollama pull`로 무료로 내려받을 수 있습니다. 상업적으로 사용하기 전에 각 라이선스를 확인하시기 바랍니다.
로컬 LLM은 개인정보가 보호됩니까?
추론에 관해서는 그렇습니다. Ollama나 LM Studio로 실행하면 프롬프트, 문서, 응답이 사용자의 기기에서 처리되며 모델 제공업체의 서버로 전송되지 않습니다. 업데이트 확인과 선택적 텔레메트리는 별개이므로 각 앱의 설정을 확인하세요. 로컬 처리는 기밀 정보와 개인정보에 적합하고 GDPR 대응을 쉽게 하지만, 법적 준수 여부는 전체 구성에 달려 있습니다.
핵심 요점
- 8 GB RAM으로 7B 모델을 로컬에서 실행할 수 있습니다(Ollama 또는 LM Studio, 10분 이내 설정)
- 48 GB VRAM으로 70B 모델을 Q4로 실행(가중치 약 42 GB). Llama 4 Scout(109B MoE)는 약 67 GB가 필요합니다
- Q4 양자화는 메모리 사용량을 FP16의 약 4분의 1로 줄이며 품질 저하는 작습니다 — 7B 모델이 4–5 GB VRAM에 들어갑니다
- Qwen3.8, Gemma 4, gpt-oss 같은 오픈 웨이트 모델은 일상적인 코딩과 글쓰기 작업 대부분을 처리합니다. 가장 어려운 다단계 작업에서는 최상위 클라우드 모델이 여전히 앞섭니다
- 하드웨어 구입 후 API 비용 제로 — 사용 제한 없음, 공급업체 종속 없음
- 프롬프트와 파일은 기기에 남고 클라우드 저장소를 쓰지 않습니다 — 각 앱의 텔레메트리 설정을 확인하세요. 로컬 처리는 GDPR 대응을 쉽게 하지만 이를 대체하지는 않습니다
- LoRA 파인튜닝에는 500개 이상의 레이블이 지정된 예제와 24 GB+ VRAM이 필요합니다(또는 학습용 클라우드 GPU)
- Qwen 로컬 배포 가이드 2026 — Qwen 3.6 27B와 Qwen3 8B용 단일 명령 Ollama 설정(Coder·VL 등급 포함)
- LLM 추론을 위한 $500 미만 최고의 GPU — Intel Arc B580 12 GB가 선두, 중고 RTX 3060 12 GB가 CUDA 쪽 차선책
- DeepSeek vs Qwen: 로컬 비교 2026 — 벤치마크 직접 비교
- Alibaba Cloud vs Tencent Cloud GPU 2026 — 중국 시장을 위한 GPU 클라우드
- 로컬 LLM 비용 계산기: 구축 vs 임대 2026 — 3년 ROI 계산기
최근 추가된 모델
| 모델 | Pull 명령어 | 다운로드 크기 | 비고 |
|---|---|---|---|
| Qwen3.8-27B | ollama pull qwen3.8:27b | 18 GB | Alibaba. 256K 컨텍스트, 텍스트·이미지 입력 지원. 24 GB 카드에 권장하는 선택 |
| Gemma 4 12B | ollama pull gemma4:12b | 8 GB | Google. 256K 컨텍스트, 비전 및 도구 호출 지원. 12 GB GPU에 들어갑니다 |
| gpt-oss 20B | ollama pull gpt-oss:20b | 14 GB | OpenAI. 128K 컨텍스트, 오픈 웨이트. 16 GB GPU에 들어갑니다 |
| Qwen3.5 4B | ollama pull qwen3.5:4b | 4 GB | Alibaba. 텍스트·이미지 입력 지원. 8 GB 기기에 권장하는 소형 모델 |
VRAM 등급별 최고의 로컬 LLM
GPU의 VRAM 용량을 이미 알고 계신가요? 아래에서 등급을 찾아 가장 적합한 모델을 확인하세요 — 전체 공식과 양자화 계산, MoE 모델의 예외 사항은 전체 VRAM 가이드를 참고하세요.
| VRAM | 최적 모델 (Q4) | 예시 GPU |
|---|---|---|
| 4 GB | Llama 3.2 3B 또는 Phi-4 Mini (~2–2.5 GB) | RTX 3050 4GB, GTX 1650 |
| 8 GB | Llama 3.1 8B 또는 Qwen3 8B (~4-5 GB) | RTX 4060 Ti 8GB, RTX 3070 |
| 12 GB | Qwen3 14B (~8.4 GB), 또는 고품질을 원하면 7-8B를 Q5/Q8로 | RTX 3060 12GB, RTX 4070 |
| 16 GB | Qwen3 14B를 Q5/Q8로, 또는 22B급 (~13 GB) | RTX 4060 Ti 16GB, RTX 4080 |
| 24 GB | Qwen3.8-27B (~18 GB, 24 GB 카드의 1순위) | RTX 4090, RTX 3090 |
| 32 GB | 22-32B를 완전한 정밀도로, 또는 듀얼 GPU 70B 구성의 카드 한 장으로 | RTX 5090 |
| 48 GB | 70B 모델을 Q4로 (~42 GB), Q5(~50 GB)는 들어가지 않음 | 2x RTX 4090, RTX 6000 Ada |
로컬에서 실행할 수 있는 가장 큰 LLM
한계를 정하는 것은 소프트웨어가 아니라 메모리입니다. Q4에서는 파라미터 10억 개당 약 0.6GB에 1–2GB 여유분이 필요합니다. 24GB 카드 한 장이면 27B급, 48GB라면 70B 모델을 실행할 수 있습니다.
| 모델 | 양자화 | 가중치 크기 | 적합한 환경 |
|---|---|---|---|
| Qwen3.8-27B | Q4 | 약 18 GB | VRAM 24 GB |
| 70B (Llama 3.3, Qwen) | Q4 | 약 42 GB | VRAM 48 GB |
| 70B | Q5 | 약 50 GB | 48 GB 카드 한 장으로는 부족 |
| 70B | Q8 | 약 74 GB | 멀티 GPU 구성 |
VRAM이 부족하다면 24GB VRAM으로 70B 모델 실행하기와 VRAM 전체 가이드를 참고하세요.
16GB VRAM·RAM에 가장 좋은 양자화
양자화된 크기는 대략 Q4에서 파라미터 수 × 0.6GB, Q5에서 × 0.7, Q8에서 × 1.05이며, 컨텍스트용으로 1–2GB를 더합니다. VRAM 16GB에서는 12–14B 모델에 Q5가 무난한 기본값이고, 22B 모델은 Q4에서만 들어갑니다. GPU 없이 RAM 16GB만 있다면 예산을 절반으로 보세요. Q4의 12B 모델(약 7.2GB)이 여유 있는 선택입니다.
| 모델 크기 | Q4 | Q5 | Q8 | VRAM 16GB 적합 여부 |
|---|---|---|---|---|
| 8B | ~4.8 GB | ~5.6 GB | ~8.4 GB | Q4, Q5, Q8 |
| 12B | ~7.2 GB | ~8.4 GB | ~12.6 GB | Q4, Q5, Q8 |
| 14B | ~8.4 GB | ~9.8 GB | ~14.7 GB | Q4, Q5 |
| 22B | ~13.2 GB | ~15.4 GB | ~23.1 GB | Q4만 가능 |
비트 수준별 품질 차이는 LLM 양자화 설명을 참고하세요.
LM Studio에서 쓰는 중급 PC용 추천 모델
중급 PC란 RTX 3060 12GB나 RTX 4060 Ti 16GB처럼 VRAM이 12–16GB인 환경입니다. LM Studio에서 모델을 검색한 뒤, 파일 크기에 1–2GB를 더해도 VRAM에 들어가면 Q4를 고르고, 여유가 있으면 Q5로 올리세요.
| VRAM | 써볼 모델 | 대략적인 크기 |
|---|---|---|
| 12 GB | Qwen3 14B(Q4) 또는 12B급 모델 | 약 8.4 GB (12B: 약 7.2 GB) |
| 16 GB | Qwen3 14B(Q5) | 약 9.8 GB |
| 16 GB | 22B급 모델(Q4) | 약 13.2 GB |
설치는 LM Studio 설치 방법, 어떤 앱을 쓸지 고민이라면 Ollama vs LM Studio를 읽어보세요.
RAM이 적은 노트북에서 로컬 RAG 쓰기
RAG에는 작은 모델 두 개가 필요합니다. 임베딩 모델(nomic-embed-text, 1.37억 파라미터)과 채팅 모델입니다. GPU 없이 CPU만 쓰면 채팅 모델은 GPU에서의 Q4 크기의 약 두 배를 차지해, 1B 모델은 약 1.2GB, 3B 모델은 약 3.6GB입니다. RAM 2GB 노트북은 최저선으로 운영체제와 인덱스를 위한 여유가 거의 없고, 현실적인 시작점은 8GB입니다.
| 시스템 RAM | 채팅 모델(Q4) | 예상 메모리(CPU만 사용) |
|---|---|---|
| 2 GB | Llama 3.2 1B + nomic-embed-text | 채팅 모델만 약 1.2 GB, 매우 빠듯함 |
| 8 GB | Llama 3.2 3B + nomic-embed-text | 약 3.6 GB |
| 16 GB | 7–8B 모델 | 약 8.4–9.6 GB |
수치는 VRAM 공식으로 추정한 값이며 벤치마크가 아닙니다. 전체 구성은 로컬 RAG 가이드와 최고의 로컬 RAG 도구를 참고하세요.
Ollama vs LM Studio vs Jan.ai: 무엇을 사용해야 하나요?
| 기능 | Ollama | LM Studio | Jan.ai |
|---|---|---|---|
| 인터페이스 | 터미널 (CLI) | 데스크탑 GUI | 데스크탑 GUI + 채팅 |
| API 엔드포인트 | localhost:11434 | localhost:1234 | localhost:1337 |
| 모델 브라우저 | CLI 전용 | 내장 | 내장 |
| 최적 용도 | 개발자, 자동화 | 초보자, GUI 사용자 | 개인 정보 보호 우선 채팅 |
| 설정 시간 | 2분 | 5분 | 5분 |
규정 준수 및 지역별 맥락
EU / GDPR
로컬 LLM은 데이터를 온프레미스에서 처리합니다. 전체 디스크 암호화와 접근 로깅을 함께 사용하면 로컬 추론으로 개인 데이터를 자체 시스템 안에 둘 수 있습니다. 제3자가 데이터에 접근할 수 없다면 추론 단계에서는 GDPR 제28조에 따른 처리자 계약이 필요하지 않습니다. 다만 적법 근거, 보안, 처리 활동 기록 같은 다른 의무는 그대로 적용됩니다. Ollama는 기본적으로 `localhost`에 바인딩되어 외부에 노출되지 않습니다.
일본 / APPI
일본의 개인정보보호법(APPI)은 개인정보의 국외 이전을 제한합니다. 모델을 로컬에서 실행하면 추론 단계에서 국외 이전이 발생하지 않습니다. 경제산업성(METI)의 2024년 AI 거버넌스 지침은 프라이버시를 보호하는 AI를 장려하며, 로컬 배포는 이 방향과 부합합니다.
중국 / CAC
중국 국가인터넷정보판공실(CAC)의 「생성형 인공지능 서비스 관리 임시 방법」(2023)은 대중을 대상으로 생성형 AI 서비스를 제공하는 사업자에게 등록을 요구합니다. 자체 시설에서 내부 용도로만 실행하는 모델은 일반적으로 대중 대상 서비스에 해당하지 않지만, 규정의 적용은 사용 사례에 따라 다르므로 의존하기 전에 법률 전문가와 상의하시기 바랍니다.
결과 개선하기
로컬 모델을 실행하고 계신가요? 출력 품질은 프롬프트 작성 방법에 따라 달라집니다. 모든 로컬 LLM에서 더 나은 답변을 얻기 위한 체계적인 기법을 배워 보세요.
길게 읽지 않아도 되는 빠른 답변
VRAM이 얼마나 필요한지, 어떤 양자화를 선택해야 하는지, Ollama와 LM Studio 중 무엇이 나은지 등 구체적인 질문이 있으신가요? Prompt Bites는 이런 질문 100개 이상에 각각 1분 이내로 답합니다.
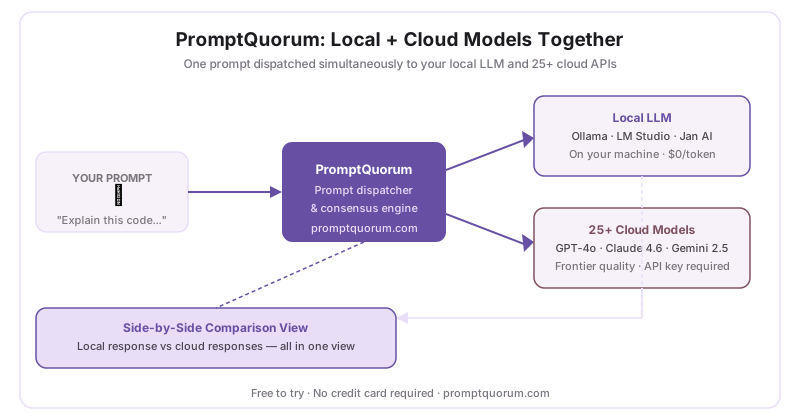
PromptQuorum은 귀하의 로컬 LLM(Ollama, LM Studio, Jan AI)에 연결하여 프롬프트를 25개 이상의 클라우드 모델에 동시에 전송합니다. 로컬과 클라우드 결과를 한 화면에서 비교하세요.
PromptQuorum 무료로 사용해 보기 →