Key Takeaways
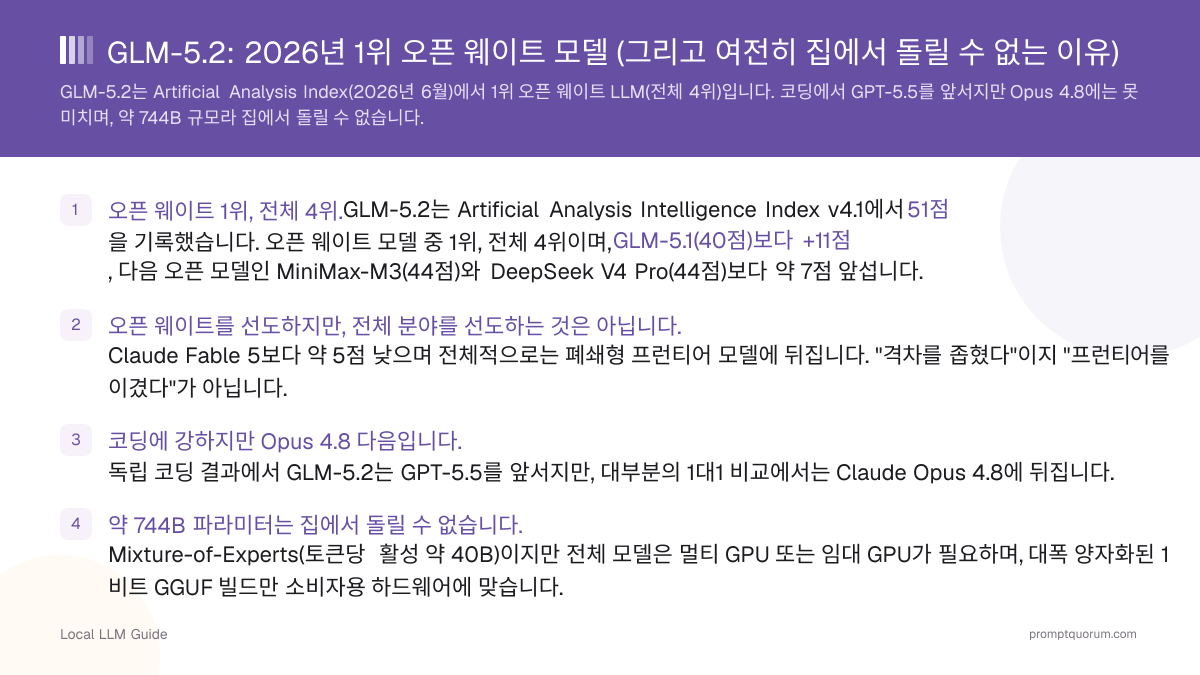
- 오픈 웨이트 2위, 출시 당시에는 1위. GLM-5.2는 2026년 6월 출시 당시 Artificial Analysis Intelligence Index v4.1에서 51점을 기록해 오픈 웨이트 모델 중 1위였습니다. 2026년 8월 기준으로는 Moonshot AI의 Kimi K3(57점, 2026년 7월 27일 출시)가 오픈 웨이트 1위이며, GLM-5.2(업데이트된 v4.1.1 지표로 현재 약 52.6점)는 2위로, MiniMax-M3와 DeepSeek V4 Pro(각 44점)는 여전히 앞섭니다.
- Z.ai는 이미 후속 모델 GLM-5.3을 출시했습니다. 2026년 8월 14일 출시된 GLM-5.3은 GLM-5.2와 동일한 기반 모델에 더 강력한 사후 학습을 적용해 코딩 점수가 크게 향상되었습니다(Terminal-Bench 3.0이 4.6에서 28.3으로 상승). 현재는 Z.ai API와 Coding Plan을 통해서만 이용 가능하며, 이번 업데이트 시점까지 공개 웨이트는 출시되지 않았습니다.
- 코딩은 강력하지만 폐쇄형 프런티어와의 격차는 더 벌어졌습니다. GLM-5.2는 독립 코딩 벤치마크에서 여전히 GPT-5.5를 앞서지만, Anthropic과 OpenAI는 그 이후 더 새로운 폐쇄형 모델(Claude Opus 5, GPT-5.6 Sol)을 출시했으며, 1대1 코딩 비교에서 2026년 6월 당시의 이전 모델보다 더 큰 격차로 GLM-5.2를 앞섭니다.
- 약 744B 파라미터는 여전히 집에서 돌릴 수 없습니다. Mixture-of-Experts(토큰당 활성 약 40B)이지만 전체 모델은 멀티 GPU 또는 임대 GPU가 필요합니다. Z.ai의 더 작은 GLM-5.3-Flash(총 320B / 활성 18B, 2026년 8월 26일 출시, MIT 라이선스)는 자체 호스팅이 더 쉽지만, 강한 양자화 없이는 여전히 단일 소비자용 GPU와는 거리가 멉니다.
- 자체 호스팅 웨이트는 데이터를 지키지만, Z.ai API는 반드시 그렇지 않습니다. MIT 라이선스 웨이트는 사용자 경계 내에서 실행되지만, 퍼스트파티 Z.ai API는 중국 데이터 거주성 고려사항이 따릅니다.
- Z.ai 자체 벤치마크는 회사 보고치로 다루세요. 재현성에 이견이 있으므로 독립 평가인 Artificial Analysis 수치를 우선하세요.
GLM-5.2란?
GLM-5.2는 2026년 6월 13일 Z.ai(구 Zhipu AI)가 MIT 라이선스로 지역 사용 제한 없이 공개한 오픈 웨이트 대규모 언어 모델입니다. 2026년 6월 16일부터 공개적으로 벤치마크되었습니다.
- 총 약 744B 파라미터(출처에 따라 743B~753B)로, 토큰당 활성 파라미터 약 40B의 Mixture-of-Experts 아키텍처를 사용합니다.
- 1M 토큰 컨텍스트 윈도우와 최대 131,072 토큰 출력.
- 작업당 평균 약 43,000 출력 토큰 — GLM-5.1의 약 26,000보다 늘어났으며, 이는 로컬 추론 시간과 비용을 높입니다.
- MIT 라이선스: 지역 제한 없이 무료로 다운로드, 자체 호스팅, 수정이 가능합니다.
- Z.ai는 이후 두 가지 후속 모델을 출시했습니다: GLM-5.3(2026년 8월 14일, 동일한 기반 모델, 더 강력한 사후 학습, 현재는 API/Coding Plan에서만 이용 가능)과 GLM-5.3-Flash(2026년 8월 26일, 총 320B / 활성 약 18B의 MIT 라이선스 소형 모델). GLM-5.2와의 비교는 아래 섹션을 참고하세요.
GLM-5.2는 얼마나 좋은가? 독립 벤치마크부터
GLM-5.2는 2026년 6월 출시 당시 Artificial Analysis Intelligence Index에서 가장 높은 점수를 받은 오픈 웨이트 모델이었습니다(51점, 전체 4위). 2026년 8월 기준으로는 Moonshot AI의 Kimi K3가 오픈 웨이트 1위이며, GLM-5.2는 현재 2위입니다(Artificial Analysis, 2026년 7~8월).
모델 | Index v4.1.1 | 등급 |
|---|---|---|
| Claude Fable 5 | ~62 | 폐쇄형 프런티어 |
| Kimi K3 (Moonshot AI) | 57 | 오픈 웨이트 1위 |
| GLM-5.2 | ~52.6 | 오픈 웨이트 2위 (2026년 6월 출시 당시 1위) |
| MiniMax-M3 | 44 | 오픈 웨이트 |
| DeepSeek V4 Pro | 44 | 오픈 웨이트 |
출시 당시(2026년 6월) 독립 코딩 결과: Terminal-Bench 2.1 — GLM-5.2는 81.0점, Claude Opus 4.8은 85.0점이었습니다. SWE-bench Pro — GLM-5.2는 62.1점(Z.ai 보고치)으로 GPT-5.5의 58.6점을 앞섰으며, 독립 보도도 그 순서를 뒷받침했습니다. Claude Opus 4.8과 GPT-5.5는 이후 각각 Claude Opus 5와 GPT-5.6 Sol로 대체되었고, GLM-5.2는 이전 모델 대비보다 더 큰 격차로 이 새로운 폐쇄형 모델들에 뒤집니다. 한편 Moonshot AI의 Kimi K3(총 2.8T 파라미터, 활성 약 104B, 2026년 7월 27일 출시, MIT 기반 수정 라이선스인 Kimi K3 License 적용)는 현재 Intelligence Index와 FrontierSWE(81.2점), Terminal-Bench 2.0(88.3점) 등의 코딩 벤치마크에서 GLM-5.2를 앞섭니다. 2026년 8월 기준 종합 평가: GLM-5.2는 오픈 웨이트 중 여전히 최상위권 코딩 모델이지만, 더 이상 가장 강력한 오픈 웨이트 선택지는 아닙니다 — 그 자리는 현재 Kimi K3의 것입니다 — 그리고 폐쇄형 프런티어와의 격차는 출시 이후 더 벌어졌습니다(Artificial Analysis; VentureBeat; TechTimes, 2026년 7~8월).

Z.ai 자체 수치 vs 독립 결과: 신중하게 읽기
여러 대표 수치는 Z.ai 자체 평가에서 나온 것이므로 독립 검증된 값이 아닌 회사 보고치로 읽어야 합니다.
- 회사 보고 코딩 수치 — 예를 들어 MCP-Atlas 77.0(Z.ai 보고치), GPT-5.5 75.3, Opus 4.8 77.8 — 는 Z.ai 자체가 측정한 것이므로 독립 재현 전까지 주장으로 다루어야 합니다.
- Artificial Analysis 분석은 Z.ai의 내부 평가가 공개 벤치마크보다 낮게 보고되었다고 지적하며, 재현성에 이견이 있습니다.
- 재현성은 미해결 문제입니다. 적어도 한 저명한 논평가는 이 모델을 "bench-maxxed"라고 평했으며, GLM-5.1은 GLM-5.2가 지금 잘 해내는 어떤 벤치마크에서 0%를 기록했다고 보고됩니다. 현재 "오픈 웨이트 2위" 순위를 뒷받침하는 것은 Z.ai 자체 평가가 아니라 독립 평가인 Artificial Analysis Index입니다.
- GLM-5.3(2026년 8월)은 사후 학습만으로 큰 향상을 보고합니다. GLM-5.2와 동일한 기반 모델을 재학습 없이 사용했으며, 예를 들어 Terminal-Bench 3.0이 4.6에서 28.3으로 상승했습니다. 독립 평가로 확인되기 전까지는 이러한 향상도 회사 보고치와 같은 수준의 신중함으로 다루세요.
GLM-5.2를 집에서 돌릴 수 있나요? 약 744B 현실 점검
아니요 — 전체 모델은 안 됩니다. "오픈 웨이트"와 "자체 호스팅 가능"이 "일반 가정용 PC에서 돌아간다"는 뜻은 아닙니다.
- 전체 GLM-5.2는 상당한 인프라가 필요합니다. 멀티 GPU 서버 또는 임대 클라우드 GPU.
- 소비자용 하드웨어에서는 대폭 양자화된 1비트 GGUF 빌드만 실행 가능하며, 품질과 속도의 트레이드오프가 따릅니다.
- 작업당 약 43,000 토큰의 높은 출력량은 로컬 시간과 비용을 더욱 높입니다.
- Z.ai의 더 작은 GLM-5.3-Flash(총 320B / 활성 약 18B, MIT 라이선스, 2026년 8월 26일 출시)는 전체 GLM-5.2보다 자체 호스팅이 쉽지만, 강한 양자화 없이는 여전히 단일 소비자용 GPU와는 거리가 멉니다.
- 대형 로컬 모델의 하드웨어 현실은 소비자용 하드웨어에서 70B 모델 돌리기, 로컬 LLM용 중고 GPU, 로컬 LLM 하드웨어 가이드 2026, 로컬 LLM용 Apple Silicon M5를 참고하세요.

자체 호스팅 웨이트 vs Z.ai API: 데이터는 어디로 가는가
라이선스와 API는 서로 다른 데이터 거버넌스 이야기입니다. 자체 호스팅 MIT 웨이트는 데이터를 사용자 경계 안에 두지만, 퍼스트파티 Z.ai API는 그렇지 않습니다.
- 자체 호스팅(MIT 웨이트): 데이터가 로컬에 남고 사용자 소유입니다 — 제3자 전송 없음.
- Z.ai 퍼스트파티 API: 독립 보도는 API 경로에 대해 중국 데이터 거주성 고려사항("중국 데이터 리스크")을 명시적으로 지적합니다(TechTimes, 2026년 6월 17일).
- 의사결정 기준: 데이터 민감도가 중요하다면 웨이트를 자체 호스팅하세요. 호스티드 API를 사용한다면 해당 관할권의 적용을 받는 제3자 클라우드 엔드포인트처럼 다루세요.
GLM-5.2 가격과 비용
호스티드 API를 통하면 GLM-5.2는 폐쇄형 프런티어 모델의 약 1/6 비용으로 실행됩니다(VentureBeat, 2026년 6월). 보고된 가격은 입력 100만 토큰당 약 $1.4, 출력 100만 토큰당 약 $4.4입니다(2026년 6월 기준). 실제 워크로드 비용을 추산할 때는 작업당 높은 출력량(약 43,000 토큰)을 고려하세요.
GLM-5.2를 써야 할까요?
GLM-5.2 의사결정 가이드
다음의 경우 로컬 LLM을 사용하십시오:
- •검증된 실적을 갖춘, 독립적으로 확인된 오픈 웨이트 2위의 성숙한 모델을 원함
- •자체 경계 안에서 자체 호스팅과 데이터 통제가 필요함
- •장기 호흡의 코딩 작업을 수행함
- •약 1/6 비용으로 프런티어에 근접한 품질을 원함
다음의 경우 클라우드 모델을 사용하십시오:
- •1대1 코딩이나 추론에서 최고 점수가 필요함 — Claude Opus 5나 GPT-5.6 Sol 같은 현재 폐쇄형 모델을 확인하세요
- •절대적으로 가장 강력한 오픈 웨이트 모델을 원하며 대신 Kimi K3 평가도 고려함
- •멀티 GPU 또는 임대 GPU 인프라를 마련할 수 없음
빠른 결정:
- →오늘날에도 강력한 오픈 웨이트 선택지이지만, 더 이상 최고는 아닙니다 — 현재 Kimi K3가 오픈 웨이트 1위이며, Z.ai 자체의 GLM-5.3도 웨이트 공개 시 GLM-5.2를 대체할 수 있습니다. 도입을 확정하기 전에 이견이 있는 벤치마크를 자신의 작업으로 검증하세요.
GLM-5.2: 지역별 고려사항
한국 / PIPA: MIT 라이선스로 GLM-5.2를 자체 호스팅하면 모든 추론 데이터가 자체 인프라 안에 남아, 개인정보 보호법(PIPA)에서 기대하는 데이터 거주성을 충족하는 데 도움이 됩니다. 추론이 로컬에서 실행될 때 모델 간 컴플라이언스 차이는 데이터 처리 방식이 아니라 공급업체 문서에 있습니다. 운영 배포 시에는 모델 버전(GLM-5.2), 라이선스(MIT), 자체 호스팅 웨이트인지 Z.ai API인지를 문서화하고, 필요 시 개인정보보호위원회(PIPC) 지침을 참고하세요.
EU / GDPR: MIT 라이선스로 GLM-5.2를 자체 호스팅하면 모든 추론 데이터가 자체 인프라 안에 남아 GDPR의 데이터 거주성 기대를 충족합니다. 추론이 로컬에서 실행될 때 모델 간 컴플라이언스 차이는 데이터 처리 방식이 아니라 공급업체 문서에 있습니다.
중국 / 데이터 경로: GLM-5.2는 중국 연구소가 만든 모델입니다. 핵심 컴플라이언스 지렛대는 모델이 아니라 배포 경로입니다. 자체 호스팅 MIT 웨이트는 데이터를 사용자 경계 안에 두지만, 퍼스트파티 Z.ai API는 본국 관할권의 적용을 받습니다. 데이터 거주성 요건에 맞는 경로를 선택하세요.
GLM-5.2 평가 시 흔한 실수
- "오픈 웨이트"가 "집에서 돌아간다"는 뜻이라고 가정하기. 약 744B 규모는 멀티 GPU 또는 임대 인프라가 필요하며, 1비트 GGUF 빌드만 소비자용 하드웨어에 맞습니다.
- Z.ai 퍼스트파티 벤치마크를 검증된 것으로 취급하기. 독립 평가인 Artificial Analysis Index를 우선하고, 회사가 측정한 코딩 수치는 주장으로 다루세요.
- 데이터 거버넌스에서 MIT 웨이트와 호스티드 API를 혼동하기. 자체 호스팅은 데이터를 로컬에 두지만, API는 본국 관할권의 적용을 받습니다.
- GLM-5.2가 여전히 "오픈 웨이트 1위"라고 가정하기. 2026년 7월 Moonshot AI의 Kimi K3가 그 자리를 차지했으며, GLM-5.2는 현재 2위입니다. 또한 Z.ai 자체의 GLM-5.3(2026년 8월)이 이미 GLM-5.2의 일부 코딩 수치를 앞섰지만, 공개 웨이트는 아직 출시되지 않았습니다.
- 추론 시간과 비용을 잡을 때 작업당 약 43,000 토큰 출력량을 무시하기.
자주 묻는 질문
GLM-5.2가 여전히 현재 최고의 오픈 웨이트 모델인가요?
아닙니다 — 2026년 8월 기준, Moonshot AI의 Kimi K3(2026년 7월 27일 출시)가 Artificial Analysis Intelligence Index에서 57점으로 1위이며, GLM-5.2의 약 52.6점보다 앞섭니다. GLM-5.2는 2026년 6월 출시 당시 오픈 웨이트 1위(51점)였지만, 현재는 2위로, MiniMax-M3와 DeepSeek V4 Pro(둘 다 44점)는 여전히 앞섭니다.
일반 PC나 Mac에서 GLM-5.2를 돌릴 수 있나요?
전체 모델은 안 됩니다. 약 744B 파라미터라 멀티 GPU 서버나 임대 클라우드 GPU가 필요합니다. 소비자용 하드웨어에서는 품질과 속도를 희생하는 대폭 양자화된 1비트 GGUF 빌드로 제한됩니다. Z.ai의 더 작은 GLM-5.3-Flash(320B / 활성 약 18B, MIT)는 자체 호스팅이 조금 더 쉽지만 소비자용 노트북 수준은 아닙니다. 대형 로컬 모델이 실제로 무엇을 요구하는지는 하드웨어 가이드를 참고하세요.
GLM-5.2가 GPT-5.5, Claude Opus 4.8, 그리고 그 후속 모델을 이기나요?
출시 당시 독립 결과는 코딩에서 GLM-5.2를 GPT-5.5보다 앞에 두었지만, Claude Opus 4.8과 비교하면 대부분의 1대1 비교에서 뒤졌습니다 — 예를 들어 Terminal-Bench 2.1(81.0 vs 85.0). 두 모델 모두 이후 GPT-5.6 Sol과 Claude Opus 5로 대체되었으며, GLM-5.2는 이전 모델 대비보다 더 큰 격차로 이들에 뒤집니다. 2026년 8월 기준 정확한 요약은 "출시 당시보다 폐쇄형 프런티어와의 격차가 벌어진, 강력한 오픈 웨이트 2위 모델"입니다.
GLM-5.2가 GLM-5.3이나 Kimi K3로 대체되었나요?
GLM-5.2는 대체되지는 않았지만 두 가지 측면에서 추월당했습니다. Z.ai는 2026년 8월 14일 GLM-5.3을 출시했습니다 — 동일한 기반 모델에 더 강력한 사후 학습을 적용해 코딩 결과가 크게 향상되었지만, 이번 업데이트 시점까지 공개 웨이트는 출시되지 않았으며 Z.ai API와 Coding Plan을 통해서만 이용 가능합니다. 한편 Moonshot AI의 Kimi K3(2026년 7월 27일)는 GLM-5.2로부터 최강 오픈 웨이트 모델 전체 1위 자리를 가져갔습니다. GLM-5.2는 여전히 완전히 자체 호스팅 가능하며 독립적으로 검증된 오픈 웨이트 2위 선택지입니다.
GLM-5.2는 정말 무료인가요? 라이선스는 무엇인가요?
GLM-5.2는 지역 사용 제한이 없는 MIT 라이선스로 공개되어 무료로 다운로드, 자체 호스팅, 수정할 수 있습니다. 전체 모델을 돌리려면 여전히 실제 인프라 비용(멀티 GPU 또는 임대 GPU)이 들고, 호스티드 Z.ai API는 유료 서비스입니다.
GLM-5.2에서 제 데이터는 안전한가요?
배포 경로에 따라 다릅니다. 자체 호스팅 MIT 웨이트는 모든 데이터를 자체 경계 안에 둡니다. 퍼스트파티 Z.ai API는 독립 보도가 지적한 중국 데이터 거주성 고려사항이 따르므로, 해당 관할권의 적용을 받는 제3자 클라우드 엔드포인트처럼 다루세요.
GLM-5.2의 벤치마크 수치를 신뢰할 수 있나요?
독립 평가인 Artificial Analysis Index는 2026년 8월 기준 GLM-5.2의 "오픈 웨이트 2위" 순위를 뒷받침합니다(GLM-5.3이 보고한 향상 수치도 마찬가지입니다). Z.ai 자체 코딩 수치는 회사 보고치이며 재현성에 이견이 있습니다. 독립 수치를 우선하고 퍼스트파티 수치는 주장으로 다루세요.
GLM-5.2를 API로 돌리는 비용은 얼마인가요?
폐쇄형 프런티어 모델의 약 1/6 비용입니다. 보고된 가격은 입력 100만 토큰당 약 $1.4, 출력 100만 토큰당 약 $4.4입니다(2026년 6월, 이번 업데이트 시점까지 변동 없음). GLM-5.2는 작업당 평균 약 43,000 출력 토큰을 사용하므로, 토큰당 요율만이 아니라 자신의 워크로드로 실제 비용을 추산하세요.
GLM-5.2를 제대로 자체 호스팅하려면 어떤 하드웨어가 필요한가요?
전체 모델에는 멀티 GPU 서버 또는 임대 클라우드 GPU가 필요합니다. 소비자용 하드웨어는 대폭 양자화된 1비트 GGUF 빌드만 돌릴 수 있습니다. 환경 규모를 가늠하려면 로컬 LLM 하드웨어 가이드 2026, 로컬 LLM용 중고 GPU, 소비자용 하드웨어에서 70B 모델 돌리기를 참고하세요.
출처
- Artificial Analysis. (2026). "GLM-5.2 is the new leading open-weights model on the Artificial Analysis Intelligence Index." artificialanalysis.ai/articles/glm-5-2-is-the-new-leading-open-weights-model-on-the-artificial-analysis-intelligence-index — 출시 당시 독립 Intelligence Index 순위(51점, 오픈 1위 / 전체 4위, 2026년 6월).
- TechTimes. (2026, June 17). "GLM-5.2 open weights live, tops coding benchmark; API use carries China data risk." www.techtimes.com/articles/318543/20260617/glm-52-open-weights-live-top-coding-benchmark-api-use-carries-china-data-risk.htm — Z.ai API 경로의 데이터 거주성 고려사항.
- VentureBeat. (2026). "Z.ai's open-weights GLM-5.2 beats GPT-5.5 on multiple long-horizon coding benchmarks for 1/6th the cost." venturebeat.com/technology/z-ais-open-weights-glm-5-2-beats-gpt-5-5-on-multiple-long-horizon-coding-benchmarks-for-1-6th-the-cost — 독립 코딩 비교 및 비용 분석.
- LetsDataScience. (2026). "GLM-5.2 open weights beats GPT-5.5 coding." letsdatascience.com/blog/glm-5-2-open-weights-beats-gpt-5-5-coding — 코딩 결과에 대한 독립 보도.
- TechTimes. (2026, July 24). "Kimi K3 Open Weights Drop July 27: Near-Frontier Coding, Undisclosed Hallucination Risk." www.techtimes.com/articles/321499/20260724/kimi-k3-open-weights-drop-july-27-near-frontier-coding-undisclosed-hallucination-risk.htm — GLM-5.2로부터 오픈 웨이트 1위 자리를 가져간 Kimi K3 출시.
- VentureBeat. (2026, August 14). "GLM-5.3 is here with advanced cyber capabilities — and reportedly already found a 'serious vulnerability' in Cursor." venturebeat.com/technology/glm-5-3-is-here-with-advanced-cyber-capabilities-and-reportedly-already-found-a-serious-vulnerability-in-cursor — GLM-5.2와 동일한 기반 모델을 사용한 GLM-5.3 출시(출시 당시 API 전용).
- MarkTechPost. (2026, August 26). "Z.ai Releases GLM-5.3-Flash: A 320B-A18B Natively Multimodal MoE With a 1M-Token Context." www.marktechpost.com/2026/08/26/z-ai-releases-glm-5-3-flash-a-320b-a18b-natively-multimodal-moe-with-a-1m-token-context/ — GLM-5.3-Flash 사양 및 MIT 라이선스 즉시 출시.