Key Takeaways
- Nº2 open-weights, fue nº1 al lanzarse. GLM-5.2 puntuó 51 en el Artificial Analysis Intelligence Index v4.1 al lanzarse en junio de 2026: el mejor modelo open-weights en ese momento. Desde agosto de 2026, Kimi K3 de Moonshot AI (57, lanzado el 27 de julio de 2026) ocupa el nº1 entre los open-weights; GLM-5.2 (ahora ~52,6 en el índice v4.1.1 actualizado) es el nº2, aún por delante de MiniMax-M3 y DeepSeek V4 Pro (44 cada uno).
- Z.ai ya lanzó una continuación, GLM-5.3. Lanzado el 14 de agosto de 2026 sobre el mismo modelo base que GLM-5.2 con un post-entrenamiento más intenso, GLM-5.3 obtiene resultados de programación notablemente mejores (Terminal-Bench 3.0 subió de 4.6 a 28.3). Solo está disponible vía la API y el Coding Plan de Z.ai; los pesos públicos no se habían publicado al momento de esta actualización.
- Fuerte en programación, ahora más lejos de la frontera cerrada. GLM-5.2 sigue por delante de GPT-5.5 en benchmarks de programación independientes, pero Anthropic y OpenAI han lanzado modelos cerrados más nuevos desde entonces —Claude Opus 5 y GPT-5.6 Sol— que superan a GLM-5.2 en comparativas directas de programación por un margen mayor que sus predecesores de junio de 2026.
- ~744B parámetros sigue sin ser ejecutable en casa. Es Mixture-of-Experts (~40B activos por token); el modelo completo necesita multi-GPU o una GPU alquilada. El GLM-5.3-Flash, más pequeño, de Z.ai (320B totales / 18B activos, lanzado el 26 de agosto de 2026, licencia MIT) es más viable para self-hosting, aunque sigue lejos de una sola GPU de consumo sin cuantización agresiva.
- Los pesos self-hosted protegen tus datos; la API de Z.ai no necesariamente. Los pesos con licencia MIT se ejecutan dentro de tu perímetro; la API de Z.ai de primera parte conlleva consideraciones de residencia de datos en China.
- Trata los propios benchmarks de Z.ai como reportados por la empresa. La reproducibilidad está en disputa: guíate por las cifras independientes de Artificial Analysis.
¿Qué es GLM-5.2?
GLM-5.2 es un modelo de lenguaje open-weights lanzado el 13 de junio de 2026 por Z.ai (antes Zhipu AI), bajo la licencia MIT sin límites regionales de uso. Se sometió a benchmarks públicos desde el 16 de junio de 2026.
- ~744B parámetros totales (las fuentes citan entre 743B y 753B), usando una arquitectura Mixture-of-Experts con ~40B parámetros activos por token.
- Ventana de contexto de 1M tokens con una salida máxima de 131,072 tokens.
- ~43,000 tokens de salida por tarea de media, frente a los ~26,000 de GLM-5.1, lo que aumenta el tiempo y el coste de la inferencia local.
- Licencia MIT: gratis para descargar, hacer self-hosting y modificar, sin restricciones regionales.
- Z.ai ha lanzado desde entonces dos continuaciones: GLM-5.3 (14 de agosto de 2026, mismo modelo base, post-entrenamiento más intenso, disponible por ahora solo vía API/Coding Plan) y GLM-5.3-Flash (26 de agosto de 2026, un modelo más pequeño con licencia MIT de 320B totales / ~18B activos). Consulta las secciones siguientes para ver cómo se comparan con GLM-5.2.
¿Qué tan bueno es GLM-5.2? Primero los benchmarks independientes
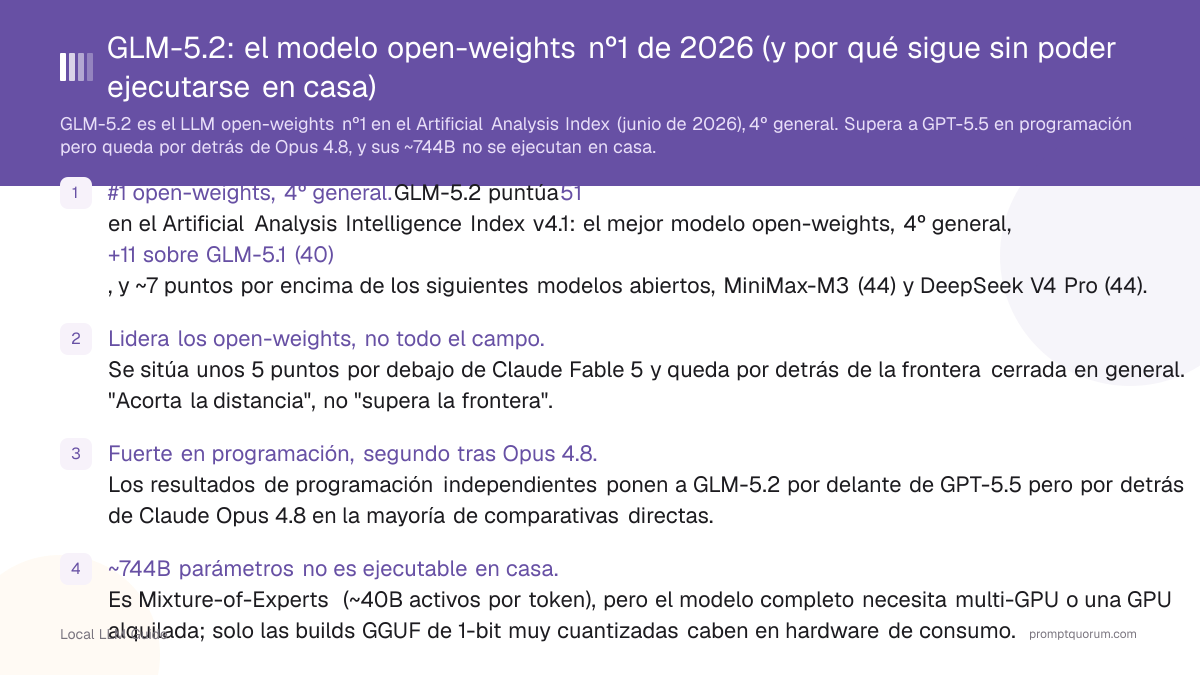
GLM-5.2 fue el modelo open-weights con la puntuación más alta en el Artificial Analysis Intelligence Index al lanzarse en junio de 2026 (51 puntos, 4º general). Desde agosto de 2026, Kimi K3 de Moonshot AI ocupa el nº1 entre los open-weights; GLM-5.2 es ahora el nº2 (Artificial Analysis, julio–agosto de 2026).
Modelo | Index v4.1.1 | Categoría |
|---|---|---|
| Claude Fable 5 | ~62 | Frontera cerrada |
| Kimi K3 (Moonshot AI) | 57 | #1 open-weights |
| GLM-5.2 | ~52.6 | #2 open-weights (fue #1 al lanzarse en junio de 2026) |
| MiniMax-M3 | 44 | Open-weights |
| DeepSeek V4 Pro | 44 | Open-weights |
Resultados de programación independientes al lanzarse (junio de 2026): Terminal-Bench 2.1 — GLM-5.2 puntuó 81.0 frente a Claude Opus 4.8 con 85.0. SWE-bench Pro — GLM-5.2 con 62.1 (valor reportado por Z.ai) se situó por delante del 58.6 de GPT-5.5; la cobertura independiente corroboró ese orden. Tanto Claude Opus 4.8 como GPT-5.5 han sido sustituidos desde entonces por Claude Opus 5 y GPT-5.6 Sol, y GLM-5.2 queda por detrás de ambos modelos cerrados más nuevos por un margen mayor del que quedaba frente a sus predecesores. Por separado, Kimi K3 de Moonshot AI (2.8T de parámetros totales, ~104B activos, lanzado el 27 de julio de 2026 bajo la licencia modificada de tipo MIT Kimi K3 License) ahora supera a GLM-5.2 en el Intelligence Index y en benchmarks de programación como FrontierSWE (81.2) y Terminal-Bench 2.0 (88.3). Veredicto a agosto de 2026: GLM-5.2 sigue siendo un modelo de programación de primer nivel entre los open-weights, pero ya no es la opción open-weights más fuerte disponible —ese lugar es ahora de Kimi K3— y la distancia con la frontera cerrada se ha ampliado desde su lanzamiento (Artificial Analysis; VentureBeat; TechTimes, julio–agosto de 2026).

Las cifras de la propia Z.ai frente a los resultados independientes: léelas con cuidado
Varias cifras destacadas provienen de las propias evaluaciones de Z.ai y deben leerse como reportadas por la empresa, no verificadas de forma independiente.
- Las cifras de programación reportadas por la empresa —por ejemplo MCP-Atlas 77.0 (reportado por Z.ai), frente a GPT-5.5 con 75.3 y Opus 4.8 con 77.8— las ejecuta la propia Z.ai y deben tratarse como afirmaciones a la espera de una réplica independiente.
- El análisis de Artificial Analysis señala que las evaluaciones internas de Z.ai se reportaron más débiles que sus benchmarks publicados, y la reproducibilidad está en disputa.
- La reproducibilidad es una incógnita. Al menos un comentarista destacado describe el modelo como "bench-maxxed", y GLM-5.1 supuestamente puntuó un 0% en al menos un benchmark en el que GLM-5.2 ahora rinde bien. El Artificial Analysis Index independiente —no la propia suite de Z.ai— es lo que actualmente respalda la clasificación de nº2 open-weights.
- GLM-5.3 (agosto de 2026) reporta grandes saltos solo por post-entrenamiento sobre el mismo modelo base que GLM-5.2 —por ejemplo, Terminal-Bench 3.0 subió de 4.6 a 28.3— sin reentrenamiento. Trata estos avances con la misma cautela por ser reportados por la empresa, hasta que evaluaciones independientes los confirmen.
¿Puedes ejecutar GLM-5.2 en casa? La realidad de los ~744B
No, no el modelo completo. "Open weights" y "self-hostable" no significan "se ejecuta en un PC doméstico típico".
- El GLM-5.2 completo necesita infraestructura seria: servidores multi-GPU o una GPU en la nube alquilada.
- En hardware de consumo, solo son viables las builds GGUF de 1-bit muy cuantizadas, con concesiones en calidad y velocidad.
- La alta salida de ~43,000 tokens por tarea aumenta aún más el tiempo y el coste locales.
- El GLM-5.3-Flash, más pequeño, de Z.ai (320B totales / ~18B activos, licencia MIT, lanzado el 26 de agosto de 2026) es más viable para self-hosting que GLM-5.2 completo, aunque sigue lejos de una sola GPU de consumo sin cuantización agresiva.
- Para la realidad de hardware de los modelos locales grandes, consulta Ejecutar modelos de 70B en hardware de consumo, GPUs usadas para LLMs locales, la Guía de hardware para LLMs locales 2026 y Apple Silicon M5 para LLMs locales.

Pesos self-hosted frente a la API de Z.ai: a dónde van tus datos
La licencia y la API son dos historias distintas de gobernanza de datos. Los pesos MIT self-hosted mantienen tus datos dentro de tu perímetro; la API de Z.ai de primera parte no.
- Self-hosted (pesos MIT): los datos permanecen locales y tuyos, sin transmisión a terceros.
- API de primera parte de Z.ai: la cobertura independiente señala explícitamente consideraciones de residencia de datos en China ("China data risk") en la ruta de la API (TechTimes, 17 de junio de 2026).
- Marco de decisión: si la sensibilidad de los datos importa, haz self-hosting de los pesos; si usas la API alojada, trátala como tratarías cualquier endpoint en la nube de terceros sujeto a su jurisdicción.
Precio y coste de GLM-5.2
Vía la API alojada, GLM-5.2 cuesta aproximadamente un sexto del coste de los modelos de frontera cerrada (VentureBeat, junio de 2026). El precio reportado es de aproximadamente $1.4 por 1M de tokens de entrada y $4.4 por 1M de tokens de salida (a junio de 2026). Ten en cuenta la alta salida por tarea (~43,000 tokens) al estimar el coste real de la carga de trabajo.
¿Deberías usar GLM-5.2?
Guía de decisión de GLM-5.2
Usa un LLM local si:
- •Quieres un modelo open-weights maduro y verificado de forma independiente en el puesto nº2, con trayectoria comprobada
- •Necesitas self-hosting y control de datos dentro de tu propio perímetro
- •Ejecutas tareas de programación de horizonte largo
- •Quieres calidad cercana a la frontera a aproximadamente un sexto del coste
Usa un modelo en la nube si:
- •Necesitas la puntuación máxima en comparativas directas de programación o razonamiento: revisa modelos cerrados actuales como Claude Opus 5 o GPT-5.6 Sol
- •Quieres el modelo open-weights absolutamente más fuerte y estás dispuesto a evaluar Kimi K3 en su lugar
- •No puedes aprovisionar infraestructura multi-GPU o de GPU alquilada
Decisión rápida:
- →Una opción open-weights sólida hoy, pero ya no la mejor: Kimi K3 lidera ahora los open-weights, y el propio GLM-5.3 de Z.ai podría suceder a GLM-5.2 en cuanto publique sus pesos. Verifica los benchmarks en disputa con tus propias tareas antes de comprometerte.
GLM-5.2: contexto regional
UE / GDPR: Hacer self-hosting de GLM-5.2 bajo la licencia MIT mantiene todos los datos de inferencia dentro de tu propia infraestructura, lo que satisface las expectativas de residencia de datos bajo el GDPR. La diferencia de cumplimiento entre modelos está en la documentación del proveedor, no en el tratamiento de datos, cuando la inferencia se ejecuta localmente.
Japón (METI): Para despliegues de producción, documenta la versión del modelo (GLM-5.2), la licencia (MIT), y si la inferencia se ejecuta sobre pesos self-hosted o la API de Z.ai, en línea con las directrices de gobernanza de IA del METI.
China / ruta de datos: GLM-5.2 está construido por un laboratorio chino. La palanca de cumplimiento clave es la ruta de despliegue, no el modelo: los pesos MIT self-hosted mantienen los datos en tu perímetro, mientras que la API de primera parte de Z.ai está sujeta a su jurisdicción de origen. Elige la ruta que se ajuste a tus requisitos de residencia de datos.
Errores comunes al evaluar GLM-5.2
- Asumir que "open weights" significa "se ejecuta en casa". El tamaño de ~744B requiere infraestructura multi-GPU o alquilada; solo las builds GGUF de 1-bit caben en hardware de consumo.
- Tratar los benchmarks de primera parte de Z.ai como verificados. Guíate por el Artificial Analysis Index independiente; trata las cifras de programación de la empresa como afirmaciones.
- Confundir los pesos MIT con la API alojada para la gobernanza de datos. El self-hosting mantiene los datos locales; la API está sujeta a su jurisdicción de origen.
- Asumir que GLM-5.2 sigue siendo el #1 open weights. Kimi K3 de Moonshot AI tomó ese puesto en julio de 2026; GLM-5.2 es ahora el #2, y el propio GLM-5.3 de Z.ai (agosto de 2026) ya mejora algunos resultados de programación de GLM-5.2, aunque sus pesos públicos todavía no se han publicado.
- Ignorar la salida de ~43,000 tokens por tarea al presupuestar el tiempo y el coste de la inferencia.
Preguntas frecuentes
¿Sigue siendo GLM-5.2 el mejor modelo open-weights ahora mismo?
No: a agosto de 2026, Kimi K3 de Moonshot AI (lanzado el 27 de julio de 2026) ocupa el primer puesto en el Artificial Analysis Intelligence Index con 57 puntos, por delante de los ~52.6 de GLM-5.2. GLM-5.2 fue el nº1 open-weights al lanzarse en junio de 2026 (51 puntos), pero ahora es el nº2, aún por delante de MiniMax-M3 y DeepSeek V4 Pro (ambos 44).
¿Puedo ejecutar GLM-5.2 en un PC o Mac normal?
No el modelo completo. Con ~744B parámetros necesita servidores multi-GPU o una GPU en la nube alquilada. En hardware de consumo estás limitado a builds GGUF de 1-bit muy cuantizadas, que sacrifican calidad y velocidad. El GLM-5.3-Flash, más pequeño, de Z.ai (320B totales / ~18B activos, licencia MIT) es algo más viable para self-hosting, pero sigue sin ser territorio de portátil de consumo. Consulta nuestras guías de hardware para saber qué requieren realmente los modelos locales grandes.
¿GLM-5.2 supera a GPT-5.5, Claude Opus 4.8 y a sus sucesores?
Al lanzarse, los resultados independientes situaron a GLM-5.2 por delante de GPT-5.5 en programación mientras quedaba por detrás de Claude Opus 4.8 en la mayoría de comparativas directas: por ejemplo Terminal-Bench 2.1 (81.0 frente a 85.0). Ambos han sido sustituidos desde entonces por GPT-5.6 Sol y Claude Opus 5, y GLM-5.2 queda por detrás de estos modelos cerrados más nuevos por un margen mayor del que quedaba frente a sus predecesores. El resumen preciso a agosto de 2026 es "un sólido modelo open-weights nº2, más lejos de la frontera cerrada que al lanzarse".
¿Ha sido sustituido GLM-5.2 por GLM-5.3 o Kimi K3?
GLM-5.2 no ha sido sustituido, pero sí superado en dos frentes. Z.ai lanzó GLM-5.3 el 14 de agosto de 2026 —mismo modelo base con post-entrenamiento más intenso y resultados de programación notablemente mejores—, pero sus pesos públicos aún no se habían publicado al momento de esta actualización; solo está disponible vía la API y el Coding Plan de Z.ai. Por separado, Kimi K3 de Moonshot AI (27 de julio de 2026) le quitó a GLM-5.2 el puesto de mejor modelo open-weights en general. GLM-5.2 sigue siendo una opción totalmente viable para self-hosting, verificada de forma independiente, en el puesto nº2 open-weights.
¿GLM-5.2 es realmente gratis? ¿Cuál es la licencia?
GLM-5.2 se lanza bajo la licencia MIT sin límites regionales de uso, así que puedes descargarlo, hacerle self-hosting y modificarlo gratis. Ejecutar el modelo completo aún cuesta infraestructura real (multi-GPU o GPU alquilada), y la API alojada de Z.ai es un servicio de pago.
¿Están seguros mis datos con GLM-5.2?
Depende de la ruta de despliegue. Los pesos MIT self-hosted mantienen todos los datos dentro de tu propio perímetro. La API de primera parte de Z.ai conlleva consideraciones de residencia de datos en China señaladas por la cobertura independiente, así que trátala como tratarías cualquier endpoint en la nube de terceros sujeto a su jurisdicción.
¿Son fiables las cifras de benchmark de GLM-5.2?
El Artificial Analysis Index independiente corrobora la clasificación de nº2 open-weights de GLM-5.2 a agosto de 2026. Las propias cifras de programación de Z.ai son reportadas por la empresa, y la reproducibilidad está en disputa —esto también aplica a los avances reportados de GLM-5.3. Guíate por las cifras independientes y trata las cifras de primera parte como afirmaciones.
¿Cuánto cuesta ejecutar GLM-5.2 vía API?
Aproximadamente un sexto del coste de los modelos de frontera cerrada. El precio reportado es de aproximadamente $1.4 por 1M de tokens de entrada y $4.4 por 1M de tokens de salida (junio de 2026, sin cambios a fecha de esta actualización). Como GLM-5.2 promedia ~43,000 tokens de salida por tarea, estima el coste real sobre tu propia carga de trabajo en lugar de basarte solo en las tarifas por token.
¿Qué hardware necesito para hacer self-hosting de GLM-5.2 correctamente?
Para el modelo completo, servidores multi-GPU o una GPU en la nube alquilada. El hardware de consumo solo puede ejecutar builds GGUF de 1-bit muy cuantizadas. Consulta la Guía de hardware para LLMs locales 2026, GPUs usadas para LLMs locales y Ejecutar modelos de 70B en hardware de consumo para dimensionar tu configuración.
Fuentes
- Artificial Analysis. (2026). "GLM-5.2 is the new leading open-weights model on the Artificial Analysis Intelligence Index." artificialanalysis.ai/articles/glm-5-2-is-the-new-leading-open-weights-model-on-the-artificial-analysis-intelligence-index — Clasificación independiente del Intelligence Index al lanzarse (51, #1 abierto / 4º general, junio de 2026).
- TechTimes. (2026, 17 de junio). "GLM-5.2 open weights live, tops coding benchmark; API use carries China data risk." www.techtimes.com/articles/318543/20260617/glm-52-open-weights-live-top-coding-benchmark-api-use-carries-china-data-risk.htm — Consideraciones de residencia de datos en la ruta de la API de Z.ai.
- VentureBeat. (2026). "Z.ai's open-weights GLM-5.2 beats GPT-5.5 on multiple long-horizon coding benchmarks for 1/6th the cost." venturebeat.com/technology/z-ais-open-weights-glm-5-2-beats-gpt-5-5-on-multiple-long-horizon-coding-benchmarks-for-1-6th-the-cost — Comparativa de programación independiente y marco de costes.
- LetsDataScience. (2026). "GLM-5.2 open weights beats GPT-5.5 coding." letsdatascience.com/blog/glm-5-2-open-weights-beats-gpt-5-5-coding — Cobertura independiente de los resultados de programación.
- TechTimes. (2026, 24 de julio). "Kimi K3 Open Weights Drop July 27: Near-Frontier Coding, Undisclosed Hallucination Risk." www.techtimes.com/articles/321499/20260724/kimi-k3-open-weights-drop-july-27-near-frontier-coding-undisclosed-hallucination-risk.htm — Lanzamiento de Kimi K3, que le quitó a GLM-5.2 el puesto #1 open-weights.
- VentureBeat. (2026, 14 de agosto). "GLM-5.3 is here with advanced cyber capabilities — and reportedly already found a 'serious vulnerability' in Cursor." venturebeat.com/technology/glm-5-3-is-here-with-advanced-cyber-capabilities-and-reportedly-already-found-a-serious-vulnerability-in-cursor — Lanzamiento de GLM-5.3, mismo modelo base que GLM-5.2, solo vía API al lanzarse.
- MarkTechPost. (2026, 26 de agosto). "Z.ai Releases GLM-5.3-Flash: A 320B-A18B Natively Multimodal MoE With a 1M-Token Context." www.marktechpost.com/2026/08/26/z-ai-releases-glm-5-3-flash-a-320b-a18b-natively-multimodal-moe-with-a-1m-token-context/ — Especificaciones de GLM-5.3-Flash y su lanzamiento inmediato con licencia MIT.