Key Takeaways
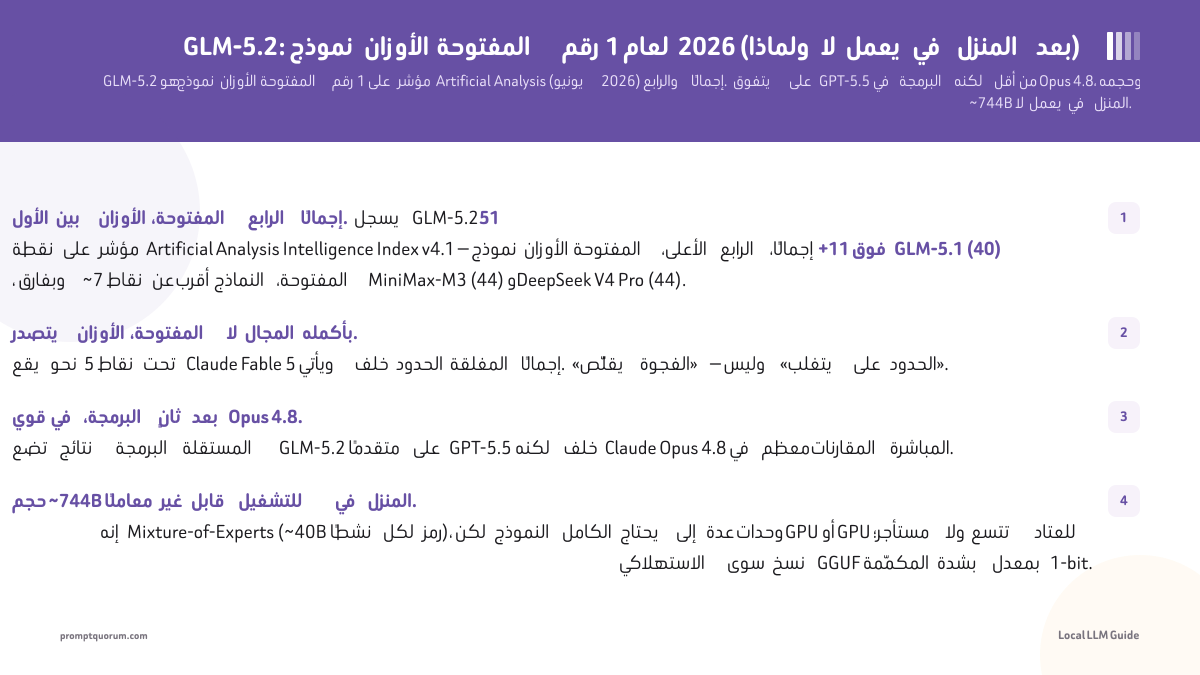
- المركز الثاني بين الأوزان المفتوحة، كان الأول عند الإطلاق. سجّل GLM-5.2 51 نقطة على مؤشر Artificial Analysis Intelligence Index v4.1 عند إطلاقه في يونيو 2026 — نموذج الأوزان المفتوحة الأعلى وقتها. اعتبارًا من أغسطس 2026، أصبح Kimi K3 من Moonshot AI (57 نقطة، أُطلق في 27 يوليو 2026) في المركز الأول بين الأوزان المفتوحة؛ ويأتي GLM-5.2 (الآن ~52.6 على مؤشر v4.1.1 المحدَّث) في المركز الثاني، متقدمًا على MiniMax-M3 وDeepSeek V4 Pro (44 لكل منهما).
- أصدرت Z.ai بالفعل نسخة تالية، GLM-5.3. أُطلق في 14 أغسطس 2026 على نفس النموذج الأساسي لـ GLM-5.2 مع تدريب لاحق أعمق، ويحقق GLM-5.3 نتائج برمجة أفضل بشكل ملحوظ (ارتفع Terminal-Bench 3.0 من 4.6 إلى 28.3). متاح فقط عبر واجهة API الخاصة بـ Z.ai وخطة البرمجة؛ لم تُصدر الأوزان العامة بعد وقت هذا التحديث.
- قوي في البرمجة، لكنه أبعد الآن عن الحدود المغلقة. لا يزال GLM-5.2 متقدمًا على GPT-5.5 في اختبارات البرمجة المستقلة، لكن Anthropic وOpenAI أطلقتا نماذج مغلقة أحدث منذ ذلك الحين — Claude Opus 5 وGPT-5.6 Sol — تتقدم على GLM-5.2 في المقارنات المباشرة للبرمجة بفارق أكبر مما كان عليه مع النموذجين السابقين في يونيو 2026.
- حجم ~744B معاملًا لا يزال غير قابل للتشغيل في المنزل. إنه Mixture-of-Experts (~40B نشطًا لكل رمز)؛ يحتاج النموذج الكامل إلى عدة وحدات GPU أو GPU مستأجر. نموذج Z.ai الأصغر GLM-5.3-Flash (320B إجماليًا / 18B نشطًا، أُطلق في 26 أغسطس 2026، بترخيص MIT) أكثر قابلية للاستضافة الذاتية، رغم أنه لا يزال بعيدًا عن GPU استهلاكي واحد دون تكميم شديد.
- الأوزان المستضافة ذاتيًا تحافظ على بياناتك؛ واجهة Z.ai API ليست كذلك بالضرورة. تعمل الأوزان المرخّصة بـ MIT داخل حدودك؛ أما واجهة Z.ai API من الطرف الأول فتحمل اعتبارات إقامة البيانات في الصين.
- تعامل مع اختبارات Z.ai الخاصة على أنها مُبلَّغ عنها من الشركة. قابلية إعادة الإنتاج محل خلاف — اعتمد أولًا على أرقام Artificial Analysis المستقلة.
ما هو GLM-5.2؟
GLM-5.2 هو نموذج لغة كبير ذو أوزان مفتوحة أطلقته Z.ai (المعروفة سابقًا باسم Zhipu AI) في 13 يونيو 2026، بموجب ترخيص MIT دون قيود استخدام إقليمية. خضع للاختبار العلني اعتبارًا من 16 يونيو 2026.
- ~744B معاملًا إجماليًا (تشير المصادر إلى 743B–753B)، باستخدام بنية Mixture-of-Experts مع ~40B معاملًا نشطًا لكل رمز.
- نافذة سياق بحجم 1M رمز مع حد أقصى للإخراج يبلغ 131,072 رمزًا.
- ~43,000 رمز إخراج لكل مهمة في المتوسط — ارتفاعًا من ~26,000 في GLM-5.1 — ما يرفع زمن الاستدلال المحلي والتكلفة.
- ترخيص MIT: مجاني للتنزيل والاستضافة الذاتية والتعديل، دون قيود إقليمية.
- أصدرت Z.ai نموذجين تاليين منذ ذلك الحين: GLM-5.3 (14 أغسطس 2026، نفس النموذج الأساسي، تدريب لاحق أعمق، متاح حاليًا فقط عبر API/خطة البرمجة) وGLM-5.3-Flash (26 أغسطس 2026، نموذج أصغر بترخيص MIT بحجم 320B إجمالي / ~18B نشط). راجع الأقسام أدناه لمعرفة كيفية مقارنتهما بـ GLM-5.2.
ما مدى جودة GLM-5.2؟ الاختبارات المستقلة أولًا
كان GLM-5.2 أعلى نموذج أوزان مفتوحة تسجيلًا على مؤشر Artificial Analysis Intelligence Index عند إطلاقه في يونيو 2026 (51 نقطة، الرابع إجمالًا). اعتبارًا من أغسطس 2026، انتزع Kimi K3 من Moonshot AI المركز الأول بين الأوزان المفتوحة؛ ويأتي GLM-5.2 الآن في المركز الثاني (Artificial Analysis، يوليو–أغسطس 2026).
النموذج | Index v4.1.1 | الفئة |
|---|---|---|
| Claude Fable 5 | ~62 | حدود مغلقة |
| Kimi K3 (Moonshot AI) | 57 | الأول بين الأوزان المفتوحة |
| GLM-5.2 | ~52.6 | الثاني بين الأوزان المفتوحة (كان الأول عند إطلاقه في يونيو 2026) |
| MiniMax-M3 | 44 | أوزان مفتوحة |
| DeepSeek V4 Pro | 44 | أوزان مفتوحة |
نتائج البرمجة المستقلة عند الإطلاق (يونيو 2026): Terminal-Bench 2.1 — سجل GLM-5.2 81.0 مقابل 85.0 لـ Claude Opus 4.8. SWE-bench Pro — جاء GLM-5.2 بـ 62.1 (قيمة مُبلَّغ عنها من Z.ai) متقدمًا على 58.6 لـ GPT-5.5. تم استبدال كل من Claude Opus 4.8 وGPT-5.5 منذ ذلك الحين بـ Claude Opus 5 وGPT-5.6 Sol، ويتأخر GLM-5.2 عن كلا النموذجين المغلقين الأحدث بفارق أكبر مما كان عليه مع سابقيهما. بشكل منفصل، أصبح Kimi K3 من Moonshot AI (2.8T معامل إجمالي، ~104B نشط، أُطلق في 27 يوليو 2026 بموجب ترخيص Kimi K3 المعدَّل من MIT) متقدمًا على GLM-5.2 على مؤشر Intelligence Index وفي اختبارات برمجة مثل FrontierSWE (81.2) وTerminal-Bench 2.0 (88.3). الحكم الإجمالي اعتبارًا من أغسطس 2026: يبقى GLM-5.2 نموذج برمجة من الطراز الأول بين الأوزان المفتوحة، لكنه لم يعد الخيار الأقوى بينها — فهذا الآن من نصيب Kimi K3 — وقد اتسعت الفجوة مع الحدود المغلقة منذ الإطلاق (Artificial Analysis؛ VentureBeat؛ TechTimes، يوليو–أغسطس 2026).

أرقام Z.ai الخاصة مقابل النتائج المستقلة: اقرأها بحذر
تأتي عدة أرقام رئيسية من تقييمات Z.ai الخاصة وينبغي قراءتها على أنها مُبلَّغ عنها من الشركة، وليست متحقَّقًا منها بشكل مستقل.
- أرقام البرمجة المُبلَّغ عنها من الشركة — على سبيل المثال MCP-Atlas 77.0 (مُبلَّغ عنه من Z.ai)، مقابل 75.3 لـ GPT-5.5 و77.8 لـ Opus 4.8 — تُجريها Z.ai نفسها وينبغي التعامل معها كادعاءات بانتظار التكرار المستقل.
- يشير تقرير Artificial Analysis إلى أن التقييمات الداخلية لـ Z.ai أُبلغ عنها أضعف من اختباراتها المنشورة، وقابلية إعادة الإنتاج محل خلاف.
- قابلية إعادة الإنتاج سؤال مفتوح. يصف معلق بارز واحد على الأقل النموذج بأنه «مُحسَّن للاختبارات» (bench-maxxed)، ويُقال إن GLM-5.1 سجّل 0% في اختبار واحد على الأقل يحقق فيه GLM-5.2 أداءً جيدًا الآن. مؤشر Artificial Analysis المستقل — وليس مجموعة Z.ai الخاصة — هو ما يدعم حاليًا ترتيب المركز الثاني بين الأوزان المفتوحة.
- يُبلغ GLM-5.3 (أغسطس 2026) عن قفزات كبيرة من التدريب اللاحق وحده على نفس النموذج الأساسي لـ GLM-5.2 — مثل ارتفاع Terminal-Bench 3.0 من 4.6 إلى 28.3 — دون إعادة تدريب. تعامل مع هذه المكاسب بنفس الحذر المُبلَّغ عنه من الشركة إلى أن تؤكدها تقييمات مستقلة.
هل يمكنك تشغيل GLM-5.2 في المنزل؟ مراجعة واقعية لحجم ~744B
لا — ليس النموذج الكامل. «الأوزان المفتوحة» و«القابل للاستضافة الذاتية» لا يعنيان «يعمل على حاسوب منزلي عادي».
- يحتاج GLM-5.2 الكامل إلى بنية تحتية قوية: خوادم متعددة وحدات GPU أو GPU سحابي مستأجر.
- على العتاد الاستهلاكي، تكون نسخ GGUF المكمّمة بشدة بمعدل 1-bit فقط هي الممكنة عمليًا، مع مقايضات في الجودة والسرعة.
- يرفع الإخراج المرتفع البالغ ~43,000 رمز لكل مهمة الزمن والتكلفة المحليين أكثر.
- نموذج Z.ai الأصغر GLM-5.3-Flash (320B إجماليًا / ~18B نشطًا، بترخيص MIT، أُطلق في 26 أغسطس 2026) أكثر قابلية للاستضافة الذاتية من GLM-5.2 الكامل، رغم أنه لا يزال بعيدًا عن GPU استهلاكي واحد دون تكميم شديد.
- للاطلاع على واقع العتاد للنماذج المحلية الكبيرة، راجع تشغيل نماذج 70B على العتاد الاستهلاكي، ووحدات GPU المستعملة للنماذج المحلية، ودليل عتاد النماذج المحلية 2026، وApple Silicon M5 للنماذج المحلية.

الأوزان المستضافة ذاتيًا مقابل واجهة Z.ai API: إلى أين تذهب بياناتك
الترخيص وواجهة API قصتان مختلفتان لحوكمة البيانات. تحافظ أوزان MIT المستضافة ذاتيًا على بياناتك داخل حدودك؛ أما واجهة Z.ai API من الطرف الأول فلا تفعل.
- الاستضافة الذاتية (أوزان MIT): تبقى البيانات محلية وملكًا لك — دون نقل إلى طرف ثالث.
- واجهة Z.ai API من الطرف الأول: تشير التغطية المستقلة صراحةً إلى اعتبارات إقامة البيانات في الصين («مخاطر بيانات الصين») على مسار واجهة API (TechTimes، 17 يونيو 2026).
- إطار القرار: إذا كانت حساسية البيانات مهمة، فاستضِف الأوزان ذاتيًا؛ وإذا استخدمت واجهة API المستضافة، فعامِلها كما تعامل أي نقطة نهاية سحابية من طرف ثالث خاضعة لولايتها القضائية.
تسعير GLM-5.2 وتكلفته
عبر واجهة API المستضافة، يعمل GLM-5.2 بتكلفة تقارب سُدس تكلفة النماذج المغلقة المتقدمة (VentureBeat، يونيو 2026). التسعير المُبلَّغ عنه يقارب $1.4 لكل 1M رمز إدخال و$4.4 لكل 1M رمز إخراج (اعتبارًا من يونيو 2026). ضع في الحسبان الإخراج المرتفع لكل مهمة (~43,000 رمز) عند تقدير التكلفة الفعلية لعبء العمل.
هل يجب أن تستخدم GLM-5.2؟
دليل قرار GLM-5.2
استخدم LLM محليًا إذا:
- •تريد نموذجًا ناضجًا ومُتحقَّقًا منه بشكل مستقل في المركز الثاني بين الأوزان المفتوحة مع سجل حافل
- •تحتاج إلى استضافة ذاتية وتحكم في البيانات داخل حدودك الخاصة
- •تشغّل مهام برمجة طويلة الأمد
- •تريد جودة قريبة من الحدود المتقدمة بتكلفة تقارب السُدس
استخدم نموذجًا سحابيًا إذا:
- •تحتاج إلى أعلى نتيجة في البرمجة أو الاستدلال — تحقق من النماذج المغلقة الحالية مثل Claude Opus 5 أو GPT-5.6 Sol
- •تريد أقوى نموذج أوزان مفتوحة بشكل مطلق وترغب في تقييم Kimi K3 بدلًا من ذلك
- •لا تستطيع توفير بنية تحتية متعددة وحدات GPU أو GPU مستأجر
قرار سريع:
- →خيار أوزان مفتوحة قوي اليوم، لكنه لم يعد الأول — يتصدر Kimi K3 الآن الأوزان المفتوحة، وقد يتفوق نموذج Z.ai الخاص GLM-5.3 على GLM-5.2 بمجرد صدور أوزانه. تحقق من الاختبارات المتنازع عليها مقابل مهامك الخاصة قبل الالتزام.
GLM-5.2: السياق الإقليمي
الخليج / سيادة البيانات: تحافظ الاستضافة الذاتية لـ GLM-5.2 بموجب ترخيص MIT على جميع بيانات الاستدلال داخل بنيتك التحتية الخاصة، ما يبقي البيانات داخل الحدود الوطنية ويتوافق مع متطلبات حماية البيانات الإقليمية مثل نظام حماية البيانات الشخصية (PDPL) في السعودية وقانون حماية البيانات في الإمارات. الفرق في الامتثال بين النماذج يكمن في وثائق المورّد، لا في معالجة البيانات، عندما يجري الاستدلال محليًا.
التوجه نحو الذكاء الاصطناعي السيادي: يدفع الدفع الإقليمي نحو الذكاء الاصطناعي السيادي والعربي أولًا (مثل Jais وALLaM وFalcon) المؤسسات إلى تفضيل الاستضافة الذاتية. يدعم تشغيل الأوزان المرخّصة بـ MIT محليًا هذا الهدف عبر إبقاء البيانات داخل الحدود الوطنية أو الإقليمية.
الصين / مسار البيانات: GLM-5.2 من بناء مختبر صيني. الرافعة الرئيسية للامتثال هي مسار النشر، وليس النموذج: تبقي أوزان MIT المستضافة ذاتيًا البيانات داخل حدودك، بينما تخضع واجهة Z.ai API من الطرف الأول لولايتها القضائية الأم. اختر المسار الذي يطابق متطلبات إقامة البيانات لديك.
أخطاء شائعة عند تقييم GLM-5.2
- افتراض أن «الأوزان المفتوحة» تعني «يعمل في المنزل». يتطلب حجم ~744B بنية تحتية متعددة وحدات GPU أو مستأجرة؛ ولا تتسع للعتاد الاستهلاكي سوى نسخ GGUF بمعدل 1-bit.
- التعامل مع اختبارات Z.ai من الطرف الأول على أنها متحقَّق منها. اعتمد أولًا على مؤشر Artificial Analysis المستقل؛ وعامِل أرقام البرمجة التي تجريها الشركة كادعاءات.
- الخلط بين أوزان MIT وواجهة API المستضافة في حوكمة البيانات. تبقي الاستضافة الذاتية البيانات محلية؛ بينما تخضع واجهة API لولايتها القضائية الأم.
- افتراض أن GLM-5.2 لا يزال الأول بين الأوزان المفتوحة. انتزع Kimi K3 من Moonshot AI هذا المركز في يوليو 2026؛ أصبح GLM-5.2 الآن في المركز الثاني، وقد حسّن نموذج Z.ai الخاص GLM-5.3 (أغسطس 2026) بالفعل بعض نتائج البرمجة مقارنة بـ GLM-5.2، رغم أن أوزانه العامة لم تصدر بعد.
- تجاهل الإخراج البالغ ~43,000 رمز لكل مهمة عند وضع ميزانية زمن الاستدلال والتكلفة.
الأسئلة الشائعة
هل لا يزال GLM-5.2 أفضل نموذج أوزان مفتوحة حاليًا؟
لا — اعتبارًا من أغسطس 2026، يحتل Kimi K3 من Moonshot AI (الذي أُطلق في 27 يوليو 2026) المركز الأول على مؤشر Artificial Analysis Intelligence Index بـ 57 نقطة، متقدمًا على ~52.6 لـ GLM-5.2. كان GLM-5.2 الأول بين الأوزان المفتوحة عند إطلاقه في يونيو 2026 (51 نقطة) لكنه الآن في المركز الثاني، لا يزال متقدمًا على MiniMax-M3 وDeepSeek V4 Pro (كلاهما 44).
هل يمكنني تشغيل GLM-5.2 على حاسوب عادي أو Mac؟
ليس النموذج الكامل. بحجم ~744B معاملًا يحتاج إلى خوادم متعددة وحدات GPU أو GPU سحابي مستأجر. على العتاد الاستهلاكي تقتصر على نسخ GGUF المكمّمة بشدة بمعدل 1-bit، التي تضحّي بالجودة والسرعة. نموذج Z.ai الأصغر GLM-5.3-Flash (320B إجماليًا / ~18B نشطًا، بترخيص MIT) أكثر قابلية للاستضافة الذاتية إلى حد ما لكنه لا يزال بعيدًا عن حاسوب محمول استهلاكي. راجع أدلة العتاد لدينا لمعرفة ما تتطلبه النماذج المحلية الكبيرة فعليًا.
هل يتغلب GLM-5.2 على GPT-5.5 وClaude Opus 4.8 وخليفتيهما؟
عند الإطلاق، وضعت النتائج المستقلة GLM-5.2 متقدمًا على GPT-5.5 في البرمجة بينما تأخر عن Claude Opus 4.8 في معظم المقارنات المباشرة — مثل Terminal-Bench 2.1 (81.0 مقابل 85.0). تم استبدال كلا النموذجين منذ ذلك الحين بـ GPT-5.6 Sol وClaude Opus 5، ويتأخر GLM-5.2 عن هذين النموذجين المغلقين الأحدث بفارق أكبر مما كان عليه مع سابقيهما. الخلاصة الدقيقة اعتبارًا من أغسطس 2026 هي «نموذج قوي في المركز الثاني بين الأوزان المفتوحة، أبعد عن الحدود المغلقة مما كان عليه عند الإطلاق».
هل تم استبدال GLM-5.2 بـ GLM-5.3 أو Kimi K3؟
لم يُستبدل GLM-5.2، لكنه تجاوزَته نماذج أخرى على جبهتين. أطلقت Z.ai نموذج GLM-5.3 في 14 أغسطس 2026 — نفس النموذج الأساسي مع تدريب لاحق أعمق ونتائج برمجة أفضل بشكل ملحوظ — لكن أوزانه العامة لم تصدر بعد وقت هذا التحديث؛ وهو متاح فقط عبر واجهة API الخاصة بـ Z.ai وخطة البرمجة. بشكل منفصل، انتزع Kimi K3 من Moonshot AI (27 يوليو 2026) من GLM-5.2 مركزه كأفضل نموذج أوزان مفتوحة إجمالًا. يبقى GLM-5.2 خيارًا قابلًا للاستضافة الذاتية بالكامل ومُتحقَّقًا منه بشكل مستقل في المركز الثاني بين الأوزان المفتوحة.
هل GLM-5.2 مجاني حقًا؟ وما هو الترخيص؟
يصدر GLM-5.2 بموجب ترخيص MIT دون قيود استخدام إقليمية، لذا يمكنك تنزيله واستضافته ذاتيًا وتعديله مجانًا. لا يزال تشغيل النموذج الكامل يكلّف بنية تحتية حقيقية (وحدات GPU متعددة أو GPU مستأجر)، وواجهة Z.ai API المستضافة خدمة مدفوعة.
هل بياناتي آمنة مع GLM-5.2؟
يعتمد ذلك على مسار النشر. تحافظ أوزان MIT المستضافة ذاتيًا على جميع البيانات داخل حدودك الخاصة. أما واجهة Z.ai API من الطرف الأول فتحمل اعتبارات إقامة البيانات في الصين التي أشارت إليها التغطية المستقلة، لذا عامِلها كما تعامل أي نقطة نهاية سحابية من طرف ثالث خاضعة لولايتها القضائية.
هل أرقام اختبارات GLM-5.2 جديرة بالثقة؟
يؤكد مؤشر Artificial Analysis المستقل ترتيب GLM-5.2 في المركز الثاني بين الأوزان المفتوحة اعتبارًا من أغسطس 2026. أما أرقام البرمجة الخاصة بـ Z.ai فهي مُبلَّغ عنها من الشركة، وقابلية إعادة الإنتاج محل خلاف — ينطبق هذا أيضًا على مكاسب GLM-5.3 المُبلَّغ عنها. اعتمد أولًا على الأرقام المستقلة وعامِل أرقام الطرف الأول كادعاءات.
كم تبلغ تكلفة تشغيل GLM-5.2 عبر واجهة API؟
نحو سُدس تكلفة النماذج المغلقة المتقدمة. التسعير المُبلَّغ عنه يقارب $1.4 لكل 1M رمز إدخال و$4.4 لكل 1M رمز إخراج (يونيو 2026، دون تغيير حتى هذا التحديث). وبما أن GLM-5.2 يخرج في المتوسط ~43,000 رمز لكل مهمة، قدّر التكلفة الفعلية على عبء عملك الخاص بدلًا من الاعتماد على أسعار الرمز وحدها.
ما العتاد الذي أحتاجه لاستضافة GLM-5.2 ذاتيًا بشكل صحيح؟
للنموذج الكامل، خوادم متعددة وحدات GPU أو GPU سحابي مستأجر. يستطيع العتاد الاستهلاكي تشغيل نسخ GGUF المكمّمة بشدة بمعدل 1-bit فقط. راجع دليل عتاد النماذج المحلية 2026، ووحدات GPU المستعملة للنماذج المحلية، وتشغيل نماذج 70B على العتاد الاستهلاكي لتحديد حجم إعدادك.
المصادر
- Artificial Analysis. (2026). "GLM-5.2 is the new leading open-weights model on the Artificial Analysis Intelligence Index." artificialanalysis.ai/articles/glm-5-2-is-the-new-leading-open-weights-model-on-the-artificial-analysis-intelligence-index — ترتيب Intelligence Index المستقل عند الإطلاق (51، الأول بين المفتوحة / الرابع إجمالًا، يونيو 2026).
- TechTimes. (2026, June 17). "GLM-5.2 open weights live, tops coding benchmark; API use carries China data risk." www.techtimes.com/articles/318543/20260617/glm-52-open-weights-live-top-coding-benchmark-api-use-carries-china-data-risk.htm — اعتبارات إقامة البيانات على مسار Z.ai API.
- VentureBeat. (2026). "Z.ai's open-weights GLM-5.2 beats GPT-5.5 on multiple long-horizon coding benchmarks for 1/6th the cost." venturebeat.com/technology/z-ais-open-weights-glm-5-2-beats-gpt-5-5-on-multiple-long-horizon-coding-benchmarks-for-1-6th-the-cost — مقارنة برمجة مستقلة وإطار للتكلفة.
- LetsDataScience. (2026). "GLM-5.2 open weights beats GPT-5.5 coding." letsdatascience.com/blog/glm-5-2-open-weights-beats-gpt-5-5-coding — تغطية مستقلة لنتائج البرمجة.
- TechTimes. (2026, July 24). "Kimi K3 Open Weights Drop July 27: Near-Frontier Coding, Undisclosed Hallucination Risk." www.techtimes.com/articles/321499/20260724/kimi-k3-open-weights-drop-july-27-near-frontier-coding-undisclosed-hallucination-risk.htm — إطلاق Kimi K3 وانتزاعه المركز الأول بين الأوزان المفتوحة من GLM-5.2.
- VentureBeat. (2026, August 14). "GLM-5.3 is here with advanced cyber capabilities — and reportedly already found a 'serious vulnerability' in Cursor." venturebeat.com/technology/glm-5-3-is-here-with-advanced-cyber-capabilities-and-reportedly-already-found-a-serious-vulnerability-in-cursor — إطلاق GLM-5.3، نفس النموذج الأساسي لـ GLM-5.2، متاح فقط عبر API عند الإطلاق.
- MarkTechPost. (2026, August 26). "Z.ai Releases GLM-5.3-Flash: A 320B-A18B Natively Multimodal MoE With a 1M-Token Context." www.marktechpost.com/2026/08/26/z-ai-releases-glm-5-3-flash-a-320b-a18b-natively-multimodal-moe-with-a-1m-token-context/ — مواصفات GLM-5.3-Flash وإصداره الفوري بترخيص MIT.