Key Takeaways
- ✅ عرض النطاق لكل شريحة: M5 بسرعة 153.6 GB/s · M5 Pro بسرعة 307 GB/s · M5 Max بسرعة 460 GB/s (32 نواة رسوميات) أو 614 GB/s (40 نواة) · M5 Ultra حتى 1.2 TB/s. سرعة التوليد تساوي تقريبًا عرض النطاق ÷ حجم النموذج × 60–80% — راجع أقسام عرض النطاق أدناه.
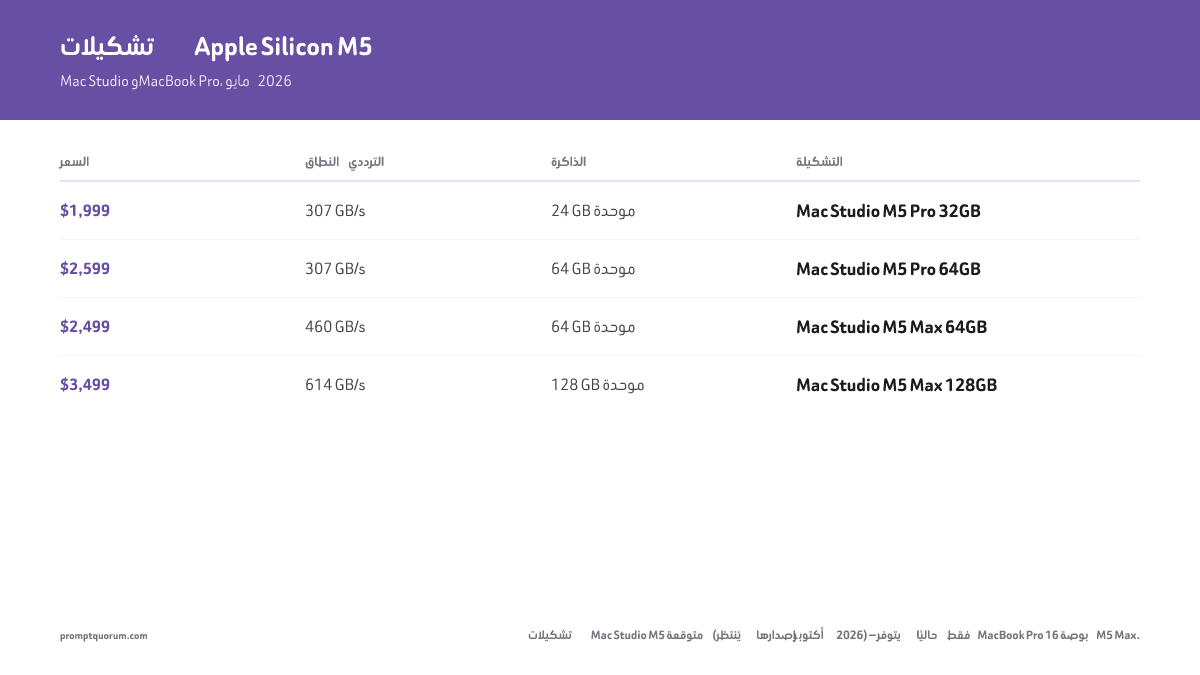
- ✅ يُشحن منذ 22 سبتمبر 2026: Mac mini M5 Pro بدءًا من 1,699 دولار (حتى 64 GB، 307 GB/s) — أرخص جهاز Mac بمعالج M5 Pro على الإطلاق، وأرخص من MacBook Pro.
- ✅ يُشحن Mac Studio M5 Max بدءًا من 2,499 دولار (حتى 128 GB، 614 GB/s) وMac Studio M5 Ultra بدءًا من 5,499 دولار (حتى 512 GB، حتى 1.2 TB/s). تصل تهيئة M5 Ultra بسعة 512 GB في أواخر أكتوبر 2026 ويُتوقع أن يتجاوز سعرها 10,000 دولار بكثير.
- لم يعد Mac Studio يقدّم فئة M5 Pro — بل يبدأ من M5 Max. أصبح Mac mini نقطة الدخول إلى شريحة M5 Pro.
- يتشارك MacBook Pro مقاس 16 بوصة M5 Max (متاح منذ مارس 2026) عرض نطاق الذاكرة نفسه مع Mac Studio M5 Max عند كل فئة رسوميات: 460 GB/s (32 نواة) و614 GB/s (40 نواة) — دون خسارة في عرض النطاق بسبب الشكل.
- جميع تهيئات M5 Pro/Max: عرض نطاق 307–614 GB/s (بطاقة RTX 4090 بسرعة 1,008 GB/s لكن بسعة VRAM لا تتجاوز 24 GB). ويصل M5 Ultra إلى 1.2 TB/s.
- تشغيل هادئ: تصبح مراوح MacBook Pro مسموعة أثناء الاستدلال المستمر؛ أما مراوح Mac Studio وMac mini فنادرًا ما تعمل بقوة تحت أحمال LLM المحلية المعتادة.
- يُعد MLX عادةً أسرع بيئة تشغيل على Apple Silicon. أضافت Ollama واجهة MLX في مارس 2026 (معاينة، Ollama 0.19، لنماذج مختارة في البداية على أجهزة Mac بأكثر من 32 GB)؛ وتعمل بقية النماذج عبر واجهة Metal في llama.cpp.
- الذاكرة الموحدة: من 24 GB (Mac mini M5 Pro الأساسي) إلى 512 GB (Mac Studio M5 Ultra) متاحة لأي نموذج. لا سقف VRAM منفصل كما في بطاقات الرسوميات المنفصلة.
يقدّم M5 Pro سرعة 307 GB/s ويقدّم M5 Max من 460 إلى 614 GB/s ويصل M5 Ultra إلى 1.2 TB/s من عرض نطاق الذاكرة، وهذا الرقم — لا عدد الأنوية — هو ما يحدد عدد الرموز في الثانية التي يولّدها Mac؛ يبدأ Mac mini M5 Pro من 1,699 دولار وMac Studio M5 Max من 2,499 دولار وMac Studio M5 Ultra من 5,499 دولار.
تستخدم أجهزة Mac بشريحة Apple Silicon ذاكرة موحدة: يتشارك المعالج ووحدة الرسوميات ومحرك الذكاء الاصطناعي المجمّع نفسه من الذاكرة السريعة. لذا يستطيع M5 Max بسعة 128 GB تحميل نموذج 70B كاملًا لا تتسع له أي بطاقة NVIDIA استهلاكية واحدة (24–32 GB من VRAM)، ويذهب خيار 512 GB في M5 Ultra أبعد من ذلك.
🔄 تحديث 11 أكتوبر 2026: مضى موعد الشحن 22 سبتمبر 2026، لذا أصبحت أجهزة Mac mini M5 Pro وMac Studio M5 Max وMac Studio M5 Ultra (96–256 GB) متاحة؛ ولا تزال تهيئة M5 Ultra بسعة 512 GB وحدها قيد الانتظار (أواخر أكتوبر 2026). يضيف هذا التحديث أقسامًا عن عرض نطاق الذاكرة، ويستبدل نطاقات الرموز في الثانية التي تجاوزت سقف عرض النطاق لكل شريحة، ويضيف أولى القياسات المستقلة لـ M5 Ultra من مراجعة MacStories. تبقى أرقام الرموز/ثانية لـ Mac mini M5 Pro وMac Studio M5 Max تقديرات مشتقة من عرض النطاق ونتائج MacBook Pro، وليست قياسات على هذه الأجهزة.
لماذا يهم Apple Silicon M5 للـ LLM المحلي
يمثل Apple Silicon بنية مختلفة جذريًا لأحمال الذكاء الاصطناعي. إليك سبب أهميته لمستخدمي LLM المحلي.
- بنية الذاكرة الموحدة: يتشارك M5 Pro وM5 Max مجمّع ذاكرة سريعًا واحدًا (من 24 إلى 128 GB) يصل إليه المعالج ووحدة الرسوميات وNeural Engine في آن واحد. لا اختناق بين VRAM وRAM. تبقى النماذج في الذاكرة السريعة وتظل الاستجابة سريعة.
- عرض نطاق الذاكرة هو الاختناق الحقيقي: توليد LLM محدود بالذاكرة لا بالحوسبة — كل رمز يُولَّد يقرأ أوزان النموذج مرة واحدة. يتخلف M5 Max بسرعة 460–614 GB/s عن 1,008 GB/s لبطاقة RTX 4090 في النماذج الصغيرة، لكنه يستوعب حتى 128 GB مقابل 24 GB، فيشغّل نماذج لا تتسع لها 4090. ويتجاوز M5 Ultra بسرعة تصل إلى 1.2 TB/s بطاقة 4090 ويستوعب حتى 512 GB.
- «VRAM» في Mac هي الذاكرة الموحدة: لا يوجد مجمّع VRAM منفصل. تستخدم وحدة الرسوميات الذاكرة نفسها التي يستخدمها macOS، وبشكل افتراضي يسمح macOS لها بتثبيت ما يقارب ثلثي إلى ثلاثة أرباع الذاكرة الكلية (تختلف النسبة بحسب حجم الذاكرة). في جهاز Mac بسعة 64 GB خطّط لنحو 48 GB للنموذج والسياق؛ ويمكن رفع الحد بالأمر `sudo sysctl iogpu.wired_limit_mb=<MB>` (يُعاد ضبطه عند إعادة التشغيل).
- بنية Apple Fusion (جديدة في M5): يفصل M5 Pro وM5 Max المعالج ووحدة الرسوميات في قالبين منفصلين بدقة 3 نانومتر داخل حزمة واحدة، ما يتيح التوسع والتحسين الحراري باستقلال ويحسّن كفاءة الطاقة مقارنة بالشرائح الأحادية.
- مسرّع عصبي في كل نواة رسوميات: تتضمن كل نواة رسوميات مسرّعًا عصبيًا مخصصًا لأحمال الذكاء الاصطناعي، يكمّل Neural Engine المشترك. تعالج بيئات التشغيل التي تستخدمها، مثل MLX وواجهة MLX في Ollama، الأوامر النصية أسرع على شرائح عائلة M5.
- القفزة الجيلية مقارنة بـ M4: تدّعي Apple أداءً أعلى بنحو 30% في المعالج متعدد الخيوط مقارنة بـ M4 Pro وM4 Max. أما في توليد LLM فالمهم هو عرض النطاق: M5 Pro بسرعة 307 GB/s مقابل 273 GB/s لـ M4 Pro (+12%)، و614 GB/s مقابل 546 GB/s في أعلى M5 Max وM4 Max (+12%). وتكون المكاسب في معالجة الأوامر النصية أكبر بفضل المسرّعات العصبية في كل نواة.
- Thunderbolt 5 (M5 Pro/Max): يوفر M5 Pro وM5 Max منفذ Thunderbolt 5 بعرض نطاق أساسي 80 Gbps (ضعف Thunderbolt 4)، مفيد للتخزين الخارجي السريع وتعدد الشاشات.
- Wi-Fi 7 وBluetooth 6 عبر شريحة Apple N1: تتضمن أنظمة M5 شريحة الاتصال اللاسلكي الجديدة N1 بدعم Wi-Fi 7 وBluetooth 6.0 بزمن استجابة منخفض، مفيدة مع عملاء الاستدلال عن بعد أو واجهات النماذج السحابية.
- إطار MLX ينضج بسرعة: يدعم إطار MLX من Apple نماذج Llama 3.3 وQwen وMistral وGemma بنوى محسّنة. وتوفر Ollama واجهة MLX لـ Apple Silicon منذ مارس 2026 (معاينة)، مقتصرة في البداية على نماذج مختارة.
- كفاءة الطاقة حقيقية: يُقدَّر استهلاك M5 Max بنحو 65–100 واط أثناء الاستدلال المستمر (تقدير وليس رقمًا من Apple؛ وتحدد Apple لهيكل Mac Studio ما يصل إلى 480 واط كحد أقصى للطاقة المستمرة). شهر من الاستدلال المتواصل (720 ساعة) عند 100 واط يعادل نحو 72 كيلوواط ساعة، أي ما يقارب 8–12 دولارًا من الكهرباء في الولايات المتحدة. وتكلّف RTX 4090 عند 350 واط نحو 40–60 دولارًا في الشهر نفسه.
- تشغيل هادئ: نادرًا ما تصبح مراوح Mac Studio مسموعة تحت أحمال LLM المعتادة؛ ولم تتمكن MacStories من سماع مروحة Mac Studio M5 Ultra في الاستخدام اليومي. أما مراوح MacBook Pro فتصبح مسموعة أثناء الاستدلال المستمر.
جدول مقارنة Apple Silicon M5
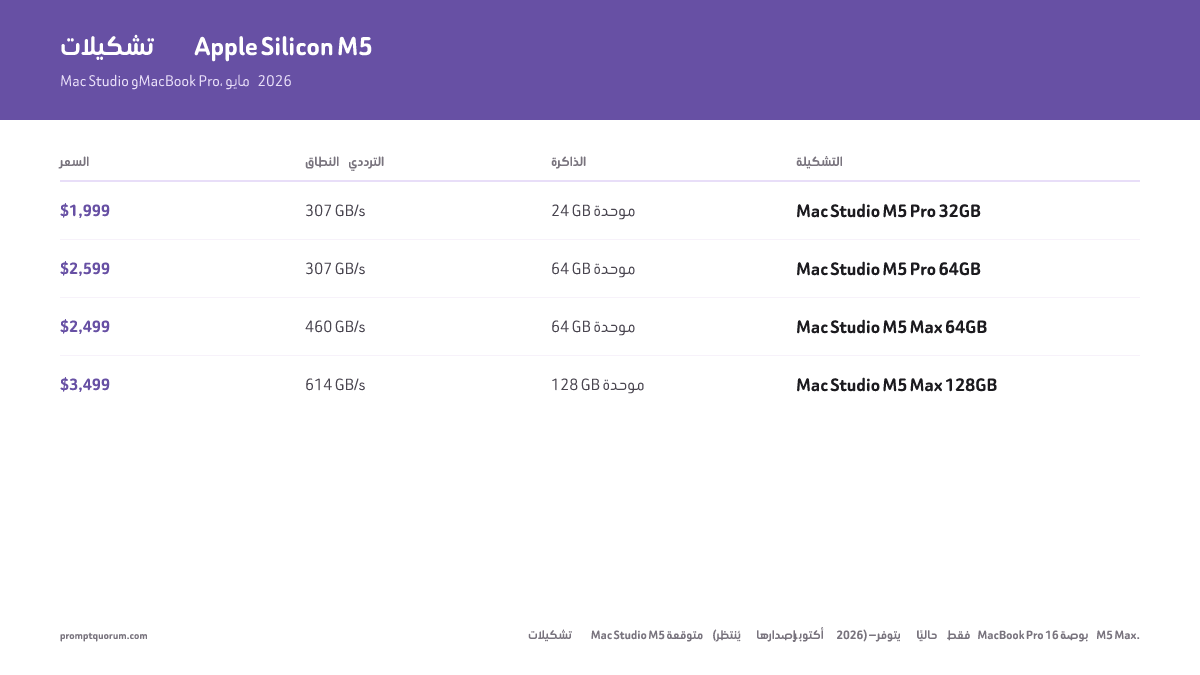
تستخدم التهيئات أدناه أسعار Apple بالتجزئة من إعلان 25 أغسطس 2026. تُشحن أجهزة Mac mini وMac Studio وMacBook Pro منذ 22 سبتمبر 2026، عدا تهيئة Mac Studio M5 Ultra بسعة 512 GB (أواخر أكتوبر 2026، ويُتوقع أن يتجاوز سعرها 10,000 دولار بكثير). الأسعار: أسعار بالدولار الأمريكي من Apple Store. لا تتوفر حتى الآن قياسات مستقلة للرموز/ثانية إلا لـ M5 Ultra — راجع قسم الأداء لمعرفة ما هو مقيس وما هو مقدَّر.
التهيئة | الشريحة | أنوية GPU | الذاكرة | عرض النطاق | السعر | الأنسب لـ |
|---|---|---|---|---|---|---|
| Mac mini M5 Pro 24 GB | M5 Pro | 16 | 24GB موحدة | 307 GB/s | $1,699 | أرخص M5 Pro، نماذج 7B–14B |
| Mac mini M5 Pro 64 GB | M5 Pro | 20 | 64GB موحدة | 307 GB/s | $2,699 | نماذج 30B، أرخص 64 GB |
| Mac Studio M5 Max 36 GB | M5 Max | 32 | 36GB موحدة | 460 GB/s | $2,499 | دخول مكتبي اقتصادي |
| Mac Studio M5 Max 64 GB | M5 Max | 40 | 64GB موحدة | 614 GB/s | $3,499 | 70B Q4، أفضل قيمة |
| Mac Studio M5 Max 128 GB | M5 Max | 40 | 128GB موحدة | 614 GB/s | $5,099 | 70B Q5، للمستخدمين المتقدمين |
| Mac Studio M5 Ultra 96 GB | M5 Ultra | 64 | 96GB موحدة | حتى 1.2 TB/s | $5,499 | أكبر النماذج المحلية |
| Mac Studio M5 Ultra 512 GB | M5 Ultra | 80 | 512GB موحدة | حتى 1.2 TB/s | +10,000$ (تقديري) | نماذج ضخمة، الشحن أواخر أكتوبر |
| MacBook Pro 16" M5 Max 64 GB | M5 Max | 32 | 64GB موحدة | 460 GB/s | $3,499 | محمول، 70B Q4 |
| MacBook Pro 16" M5 Max 128 GB | M5 Max | 40 | 128GB موحدة | 614 GB/s | $4,499 | محمول، 70B Q5 |
مقارنة عرض نطاق الذاكرة بين M5 وM5 Pro وM5 Max وM5 Ultra
عرض نطاق الذاكرة هو المواصفة التي تحدد سرعة توليد LLM المحلي على Apple Silicon، وهو الرقم الذي يبحث عنه معظم المشترين. يعرض الجدول القيمة الرسمية لكل شريحة؛ ولدى M5 Max مستويان: 460 GB/s مع معالج الرسوميات بـ 32 نواة و614 GB/s مع معالج الـ 40 نواة. الأرقام حدود قصوى نظرية.
عرض نطاق ذاكرة Apple M5 هو 153.6 GB/s (M5) و307 GB/s (M5 Pro) و460 GB/s (M5 Max بمعالج رسوميات 32 نواة) و614 GB/s (M5 Max بـ 40 نواة) وحتى 1.2 TB/s (M5 Ultra).
عرض النطاق هو سرعة قراءة الشريحة للنموذج من الذاكرة. يقرأ توليد رمز واحد (تقريبًا) النموذج كله مرة واحدة، لذا لا يستطيع أي Mac التوليد أسرع من عرض نطاقه مقسومًا على حجم النموذج.
- M5 Pro مقابل M5 Max: يمتلك M5 Max ما يعادل 1.5× (32 نواة، 460 GB/s) أو 2× (40 نواة، 614 GB/s) عرض نطاق M5 Pro، فتوقّع توليدًا أسرع بالنسبة نفسها مع النموذج ذاته.
- M5 Max مقابل M5 Ultra: يصل M5 Ultra شريحتي M5 Max ويضاعف 614 GB/s لـ M5 Max بمعالج الـ 40 نواة إلى نحو 1.2 TB/s — أي أعلى بنسبة 50% من 819 GB/s لـ M3 Ultra من الجيل السابق.
- السعة مقابل عرض النطاق: لا تجعل الذاكرة الأكبر الشريحة أسرع. لدى M5 Max بمعالج الـ 40 نواة عرض النطاق نفسه 614 GB/s مع 64 GB أو 128 GB؛ والذاكرة الإضافية تتيح فقط تحميل نماذج أكبر أو عددًا أكبر منها.
الشريحة | أنوية GPU | أقصى ذاكرة | عرض النطاق | تتوفر في |
|---|---|---|---|---|
| M5 | 8–10 | 32GB | 153.6 GB/s | MacBook Air، MacBook Pro 14 بوصة |
| M5 Pro | 16–20 | 64GB | 307 GB/s | MacBook Pro، Mac mini |
| M5 Max (GPU بـ 32 نواة) | 32 | 36GB+ | 460 GB/s | MacBook Pro، Mac Studio |
| M5 Max (GPU بـ 40 نواة) | 40 | 128GB | 614 GB/s | MacBook Pro، Mac Studio |
| M5 Ultra | 64–80 | 512GB | 1.2 TB/s (1,228.8 GB/s) | Mac Studio |
| M4 Max (مرجع) | 40 | 128GB | 546 GB/s | الجيل السابق |
| RTX 4090 (مرجع) | غير متاح | 24GB VRAM | 1,008 GB/s | بطاقة رسوميات منفصلة |
كيف يتحول عرض النطاق إلى رموز في الثانية
الجدول التالي حساب وليس اختبار أداء: الحد الأعلى للرموز/ثانية = عرض النطاق ÷ حجم ملف النموذج. تأتي السرعة الفعلية أقل بسبب قراءات ذاكرة KV وعبء بيئة التشغيل والحرارة. تقرأ نماذج Mixture-of-Experts خبراءها النشطين فقط لكل رمز، لذا قد تعمل أسرع من نموذج كثيف بالحجم نفسه.
الحد الأعلى لسرعة التوليد هو عرض نطاق الذاكرة مقسومًا على حجم ملف النموذج — مثلًا 614 GB/s ÷ 42.5 GB (Llama 3.3 70B Q4) ≈ 14 رمزًا/ثانية — وتبلغ بيئات التشغيل المحسّنة جيدًا عادةً نحو 60–80% منه.
اختر الشريحة بحسب أكبر نموذج تريد تشغيله ثم راجع جدول الحدود هذا: إذا كان الحد أقل من 10 رموز/ثانية فسيبدو النموذج بطيئًا مهما اشتريت من أنوية رسوميات.
- كيف تقرأ الجدول: القيم حدود نظرية بالرموز/ثانية. اضربها في 0.6–0.8 للحصول على نطاق واقعي — لنموذج Llama 3.3 70B Q4 على M5 Max بسرعة 614 GB/s يعني ذلك نحو 9–12 رمزًا/ثانية.
- تحقق مستقل: قاست MacStories سرعة 48 رمزًا/ثانية في التوليد بنموذج Qwen3.8 27B على Mac Studio M5 Ultra (أمر نصي من 6,091 رمزًا)، مقابل 59 رمزًا/ثانية على RTX 5090 (عرض نطاق 1.79 TB/s). تبعت السرعة الفعلية عرض النطاق لا عدد الأنوية.
- قاعدة التحجيم: يجب أن يتسع ملف النموذج مع ذاكرة KV في نحو ثلثي إلى ثلاثة أرباع الذاكرة الموحدة، لذا يحتاج نموذج 70B Q4 (~42.5 GB) إلى جهاز Mac بسعة 64 GB؛ وتحتاج صيغ Q5 وQ8 إلى 128 GB.
النموذج (Q4_K_M) | حجم الملف | M5 Pro 307 | M5 Max 460 | M5 Max 614 | M5 Ultra 1.2 TB/s |
|---|---|---|---|---|---|
| Llama 3.1 8B | ~4.9GB | ~63 | ~94 | ~125 | ~250 |
| Mistral Small 24B | ~14GB | ~22 | ~33 | ~44 | ~88 |
| Qwen3 32B | ~20GB | ~15 | ~23 | ~31 | ~61 |
| Llama 3.3 70B | ~42.5GB | ~7 | ~11 | ~14 | ~29 |
Mac mini M5 Pro: نقطة دخول اقتصادية جديدة للـ LLM المحلي
وضعت Apple شريحة M5 Pro في Mac mini لأول مرة في 25 أغسطس 2026 — كان M5 Pro متاحًا سابقًا في MacBook Pro فقط. بسعر 1,699–2,699 دولار مع 24–64 GB من الذاكرة الموحدة، يُعد Mac mini M5 Pro أرخص طريقة للوصول إلى سقف 64 GB لـ M5 Pro ويقل سعره عن MacBook Pro M5 Pro. يبدأ Mac Studio الآن من M5 Max. متاح منذ 22 سبتمبر 2026.
- المعالج: M5 Pro بـ 15 أو 18 نواة
- وحدة الرسوميات: M5 Pro GPU بـ 16 أو 20 نواة
- الذاكرة: 24 GB أساسية، قابلة للضبط إلى 48 أو 64 GB من الذاكرة الموحدة LPDDR5X
- عرض نطاق الذاكرة: 307 GB/s (مطابق لـ M5 Pro في MacBook Pro)
- التخزين: SSD بسعة 512 GB–2 TB (قابل للضبط)
- المنافذ: Thunderbolt 5 (جديد في Mac mini)
- الاتصال: Wi-Fi 7 وBluetooth 6
- السعر: 1,699 دولار (معالج 15 نواة/رسوميات 16 نواة، 24 GB)؛ 2,699 دولار (معالج 18 نواة/رسوميات 20 نواة، 64 GB)
- التوفر: يُشحن منذ 22 سبتمبر 2026
Mac Studio M5 Max بسعة 36 GB: التهيئة الأساسية
يبدأ Mac Studio M5 Max الأساسي من 2,499 دولار بمعالج رسوميات 32 نواة وذاكرة موحدة 36 GB؛ وتأتي خيارات الذاكرة الأكبر مع فئة الرسوميات 40 نواة أدناه. يُشحن منذ 22 سبتمبر 2026. لم يعد Mac Studio يقدّم أي فئة M5 Pro — وهذا الآن أرخص Mac Studio.
- المعالج: M5 Max بـ 18 نواة
- وحدة الرسوميات: M5 Max GPU بـ 32 نواة
- الذاكرة: 36 GB من الذاكرة الموحدة LPDDR5X عند هذه الفئة
- عرض نطاق الذاكرة: 460 GB/s (مطابق لـ M5 Max بـ 32 نواة في MacBook Pro)
- التخزين: SSD بسعة 512 GB–8 TB (قابل للضبط)
- المنافذ: Thunderbolt 5
- الطاقة: يُقدَّر بنحو 65–100 واط أثناء الاستدلال المستمر؛ نادرًا ما تدور المراوح
- السعر: 2,499 دولار
- التوفر: يُشحن منذ 22 سبتمبر 2026
Mac Studio M5 Max بسعة 48–128 GB: أفضل قيمة للـ LLM المحلي 70B
يبدأ Mac Studio M5 Max بمعالج رسوميات 40 نواة من 3,099 دولار (48 GB) ويُضبط حتى 128 GB مقابل 5,099 دولار. هذه هي الفئة التي تحقق وصف «أفضل قيمة لـ 70B»: تتوفر 64 GB بسعر 3,499 دولار مع عرض النطاق الكامل 614 GB/s. يُشحن منذ 22 سبتمبر 2026.
- المعالج: M5 Max بـ 18 نواة
- وحدة الرسوميات: M5 Max GPU بـ 40 نواة
- الذاكرة: 48 GB أساسية، قابلة للضبط إلى 64 أو 128 GB من الذاكرة الموحدة LPDDR5X
- عرض نطاق الذاكرة: 614 GB/s (مطابق لـ M5 Max بـ 40 نواة في MacBook Pro)
- التخزين: SSD بسعة 512 GB–8 TB
- المنافذ: Thunderbolt 5
- الطاقة: يُقدَّر بنحو 65–100 واط أثناء الاستدلال المستمر؛ نشاط مراوح معتدل مع الاستخدام المكثف لعدة نماذج
- السعر: 3,099 دولار (48 GB)؛ 3,499 دولار (64 GB)؛ 5,099 دولار (128 GB)
- التوفر: يُشحن منذ 22 سبتمبر 2026
Mac Studio M5 Ultra: فئة الأداء الأقصى الجديدة
Mac Studio M5 Ultra فئة عليا جديدة فوق M5 Max، تبدأ من 5,499 دولار بسعة 96 GB وتتدرج حتى 512 GB. تُشحن تهيئات 96–256 GB منذ 22 سبتمبر 2026؛ وتصل تهيئة 512 GB في أواخر أكتوبر 2026 ويُتوقع أن يتجاوز سعرها 10,000 دولار بكثير. وهي تعادل سقف 512 GB لـ M3 Ultra من الجيل السابق مع عرض نطاق أعلى بنسبة 50%.
- المعالج: M5 Ultra بـ 30 نواة (36 نواة قابل للضبط)
- وحدة الرسوميات: 64 نواة أساسية، 80 نواة قابلة للضبط
- الذاكرة: 96 GB أساسية، قابلة للضبط إلى 256 GB الآن و512 GB في أواخر أكتوبر 2026
- عرض نطاق الذاكرة: حتى 1.2 TB/s (1,228.8 GB/s؛ أعلى بنسبة 50% من 819 GB/s لـ M3 Ultra)
- التخزين: SSD بسعة 1–16 TB
- المنافذ: Thunderbolt 5
- السعر: 5,499 دولار (قاعدة 96 GB: معالج 30 نواة/رسوميات 64 نواة)؛ يُتوقع أن يتجاوز سعر 512 GB مبلغ 10,000 دولار بكثير
- التوفر: يُشحن منذ 22 سبتمبر 2026 (96–256 GB)؛ أواخر أكتوبر 2026 (512 GB)
MacBook Pro 16 بوصة M5 Max: LLM محلي محمول
يستخدم MacBook Pro مقاس 16 بوصة M5 Max (3,499–4,499 دولار) سيليكون M5 Max نفسه الموجود في Mac Studio بهيئة محمولة. يطابق عرض نطاق الذاكرة ما في Mac Studio عند كل فئة رسوميات — 460 GB/s مع معالج الـ 32 نواة و614 GB/s مع الـ 40 نواة. لاحظ أن MacBook Pro بسعة 64 GB يستخدم معالج الـ 32 نواة بينما يستخدم Mac Studio بسعة 64 GB معالج الـ 40 نواة. الخنق الحراري أثناء الاستدلال المستمر هو ثمن قابلية الحمل.
- المعالج: M5 Max بـ 18 نواة (6 فائقة + 12 أداء)
- وحدة الرسوميات: M5 Max GPU بـ 32 أو 40 نواة
- الذاكرة: 64 GB أو 128 GB من الذاكرة الموحدة
- الشاشة: Liquid Retina XDR مقاس 16.2 بوصة، 3456×2234
- عرض نطاق الذاكرة: 460 GB/s (64 GB، 32 نواة) أو 614 GB/s (128 GB، 40 نواة)
- التخزين: SSD بسعة 512 GB–8 TB
- البطارية: تُذكر بساعات تشغيل الفيديو؛ ويستنزفها الاستدلال المستمر أسرع بكثير
- الوزن: 2.14 كجم
- المنافذ: 3× Thunderbolt 5 وHDMI 2.1 وقارئ SD ومنفذ سماعات
- السعر: 3,499 دولار (64 GB، رسوميات 32 نواة) إلى 4,499 دولار (128 GB، رسوميات 40 نواة)
🏆 توصياتنا: أي Mac تشتري للـ LLM المحلي
توصيات واضحة بحسب حالة الاستخدام.
- 🏆 💰 أرخص M5 Pro: Mac mini M5 Pro (1,699 دولار، متاح) • السبب: أول Mac mini بشريحة M5 Pro. أقل من أي طريقة سابقة للحصول على M5 Pro بما فيها MacBook Pro. تكفي 24 GB الأساسية لنماذج 7B–14B؛ وتكفي 64 GB لنماذج 30B. • لمن: مشترو Apple Silicon للمرة الأولى الذين يراعون الميزانية. • اشترِ من Apple Store ←
- 🥇 أفضل قيمة لـ 70B: Mac Studio M5 Max بسعة 64 GB (3,499 دولار، متاح) • السبب: يشغّل Llama 3.3 70B Q4 بسرعة تقديرية 9–12 رمزًا/ثانية مع عرض النطاق الكامل 614 GB/s. يمنع التبريد المكتبي الخنق الحراري. • لمن: مطورون يوحّدون سير عمل 70B دون حاجة إلى قابلية الحمل. • اشترِ من Apple Store ←
- 🔥 أقصى قوة: Mac Studio M5 Ultra بسعة 96 GB (5,499 دولار، متاح) • السبب: الفئة العليا. عرض نطاق يصل إلى 1.2 TB/s — ضعف M5 Max. تصل تهيئة 512 GB في أواخر أكتوبر 2026 لأكبر النماذج المحلية. • الحالة: توفرت أولى القياسات المستقلة (MacStories: 48 رمزًا/ثانية مع Qwen3.8 27B مقابل 59 على RTX 5090). • اشترِ من Apple Store ←
- 💼 أفضل خيار محمول: MacBook Pro 16 بوصة M5 Max (3,499 دولار لسعة 64 GB بسرعة 460 GB/s؛ 4,499 دولار لسعة 128 GB بسرعة 614 GB/s) • السبب: سيليكون M5 Max نفسه الموجود في Mac Studio في حاسوب محمول بشاشة Liquid Retina XDR. اقبل انخفاضًا بنسبة 10–15% في السرعة المستمرة بسبب الخنق الحراري. • البديل: يكلّف Mac Studio M5 Max بسعة 64 GB (3,499 دولار) المبلغ نفسه بعرض نطاق 614 GB/s وتبريد مستمر أفضل إن لم تحتج إلى قابلية الحمل. • اشترِ من Apple Store ←
أداء LLM المحلي: تقديرات مشتقة من عرض النطاق ونتائج مستقلة لـ M5 Ultra
لا تتوفر حتى الآن قياسات مستقلة من جهات خارجية إلا لـ M5 Ultra (MacStories، في نهاية هذا القسم). أما بالنسبة إلى M5 Pro وM5 Max فالنطاقات أدناه تقديرات: يساوي كل منها 60–80% من الحد الأعلى لعرض النطاق (عرض النطاق ÷ حجم ملف النموذج)، وقورن بتقارير المجتمع ونتائج MacBook Pro؛ وهي ليست قياسات مخبرية على هيكل Mac mini أو Mac Studio. تُوسَم النطاقات بعرض النطاق لأن MacBook Pro بسعة 64 GB (460 GB/s) وMac Studio بسعة 64 GB (614 GB/s) يختلفان. توقّع ±10–15% بحسب إصدار macOS وإصدار بيئة التشغيل والتكميم وطول السياق. أرقام RTX 4090 المرجعية تقريبية من المجتمع.
- ## Llama 3.1 8B (Q4_K_M، ~4.9 GB) • M5 Pro (307 GB/s): 38–50 رمزًا/ثانية • M5 Max (460 GB/s): 56–75 رمزًا/ثانية • M5 Max (614 GB/s): 75–100 رمزًا/ثانية • مرجع (RTX 4090): 90–120 رمزًا/ثانية
- ## Mistral Small 24B (Q4_K_M، ~14 GB) • M5 Pro (307 GB/s): 13–17 رمزًا/ثانية • M5 Max (460 GB/s): 19–26 رمزًا/ثانية • M5 Max (614 GB/s): 26–34 رمزًا/ثانية
- ## Qwen3 32B (Q4_K_M، ~20 GB) • M5 Pro (307 GB/s): 9–12 رمزًا/ثانية • M5 Max (460 GB/s): 14–19 رمزًا/ثانية • M5 Max (614 GB/s): 19–25 رمزًا/ثانية
- ## Llama 3.3 70B (Q4_K_M، ~42.5 GB) • M5 Pro بسعة 64 GB (307 GB/s): 4–6 رموز/ثانية • M5 Max (460 GB/s): 6–9 رموز/ثانية • M5 Max (614 GB/s): 9–12 رمزًا/ثانية • M5 Ultra: الحد الأعلى نحو 29 رمزًا/ثانية (لا قياس مستقل لـ 70B بعد) • مرجع (RTX 4090): 6–10 رموز/ثانية مع تفريغ جزئي إلى المعالج
- ## Llama 3.3 70B (Q5_K_M، ~50 GB) • M5 Pro بسعة 64 GB: هامش غير كافٍ • M5 Max بسعة 128 GB (614 GB/s): 7–10 رموز/ثانية • مرجع (RTX 4090): غير ممكن (حد VRAM)
- ## Llama 3.3 70B (Q8_0، ~75 GB) • M5 Max بسعة 128 GB (614 GB/s): 5–7 رموز/ثانية • RTX 4090: غير ممكن (يتطلب تفريغًا على عدة بطاقات)
- ## نتائج مستقلة لـ M5 Ultra (MacStories، جهاز 256 GB، oMLX) • Qwen3.8 27B، أمر نصي من 6,091 رمزًا: M5 Ultra بسرعة 48 رمزًا/ثانية في التوليد و1,701 رمزًا/ثانية في قراءة الأمر و4.0 ثوانٍ حتى أول رمز — مقابل RTX 5090: 59 رمزًا/ثانية و3,031 رمزًا/ثانية و2.0 ثانية • Qwen3.8 27B بسياق طويل (التوليد): 38.9 رمزًا/ثانية عند 64K و32.4 عند 128K و24.3 عند 256K — RTX 5090: 49.6 و40.4 و30.0 • Flash-Next، أمر نصي قصير: 108 رموز/ثانية على M5 Ultra مقابل 70 على M3 Ultra (+54%)
- ## المنهجية تُشتق نطاقات M5 Pro وM5 Max بنسبة 60–80% من عرض النطاق ÷ حجم ملف النموذج، ثم تُقارن بنتائج المجتمع مثل اختبار MLX مقابل GGUF المذكور في صفحة اختبارات M5 Pro مقابل M5 Max. أرقام M5 Ultra هي قياسات MacStories نفسها باستخدام oMLX 0.7.0.dev2 على macOS 27.0؛ وأسماء النماذج منها. تعامل مع أي رقم رموز/ثانية لـ M5 Ultra لنماذج غير مدرجة أعلاه على أنه غير موثّق.
Apple Silicon M5 مقابل محطة عمل PC للـ LLM المحلي
يمثل Apple Silicon وNVIDIA فلسفتين مختلفتين. إليك المقارنة الصريحة.
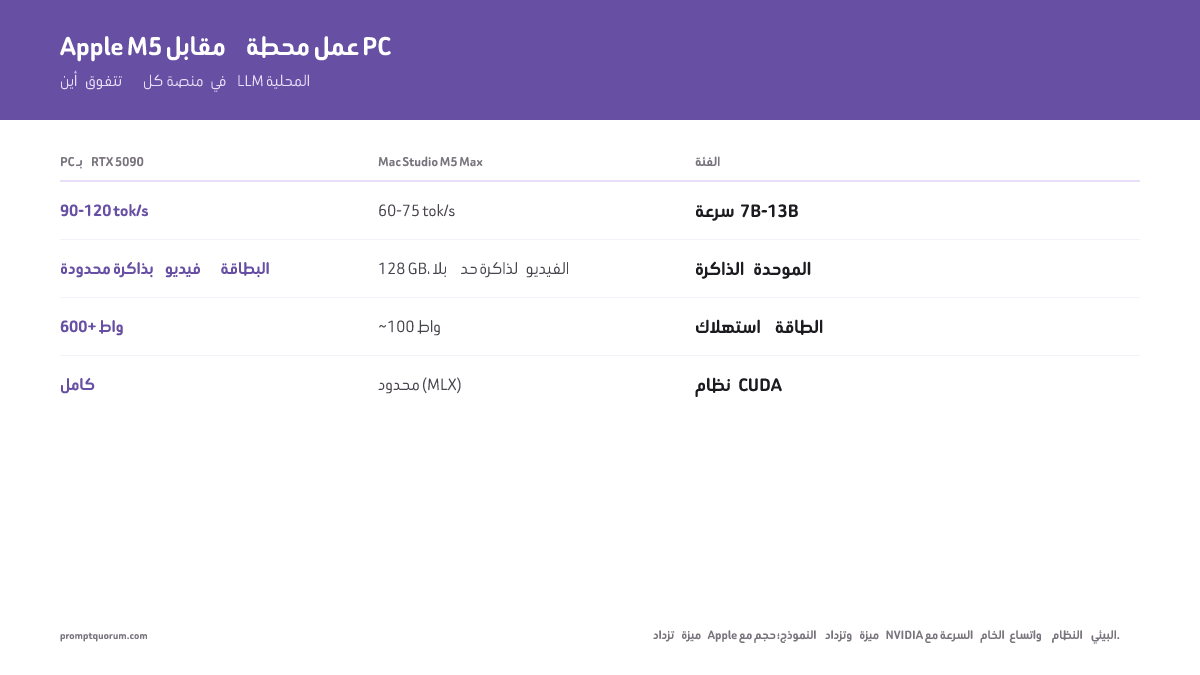
- ## يتفوق Mac Studio M5 Max/Ultra في: • الذاكرة الموحدة: حتى 128 GB (M5 Max) أو 512 GB (M5 Ultra) لأي نموذج، بلا سقف VRAM • كفاءة الطاقة: نحو 100 واط مقابل أكثر من 600 واط لحاسوب مكافئ • التشغيل الهادئ: مراوح نادرًا ما تُسمع تحت الأحمال المعتادة • منظومة macOS: تكامل MLX وMetal وCore ML • التكلفة الإجمالية للملكية: كهرباء أقل على مدى 3 سنوات • النماذج فوق 32 GB: تتوقف RTX 5090 عند 32 GB من VRAM
- ## تتفوق محطة عمل PC (RTX 4090/5090) في: • السرعة الخام للنماذج التي تتسع في VRAM: قاست MacStories بطاقة RTX 5090 بسرعة 59 رمزًا/ثانية مقابل 48 على M5 Ultra مع Qwen3.8 27B، وقراءة أمر نصي أسرع بنحو 1.8× (3,031 مقابل 1,701 رمزًا/ثانية) • اتساع منظومة CUDA: نماذج وأدوات وأكواد بحثية أكثر • الضبط الدقيق: يهيمن PyTorch + CUDA على MLX • مرونة الترقية: استبدال البطاقات وإضافة VRAM • السعر في الفئات الأدنى: بطاقة RTX 4070 Ti الاقتصادية (800–1,200 دولار) تتفوق على M5 Pro في النماذج الصغيرة • الذكاء الاصطناعي خارج LLM: عادةً ما تعمل Stable Diffusion والتدريب والوسائط المتعددة أسرع على NVIDIA
- ## الحكم الصريح للاستدلال المحلي الخالص لنماذج 30B–70B، ينافس Mac Studio M5 Max بسعة 128 GB (5,099 دولار) مباشرةً حواسيب بأكثر من 4,500 دولار، ويرفع Mac Studio M5 Ultra السقف إلى نماذج تحتاج 256 GB أو 512 GB. ميزة الذاكرة الموحدة حقيقية وقابلة للقياس. أما للنماذج التي تتسع في 24–32 GB من VRAM فحاسوب بـ RTX 4090 أو 5090 أسرع من أي Mac. وتتقلص ميزة Apple مع النماذج الأصغر. وللضبط الدقيق والتدريب وStable Diffusion على نطاق واسع أو PyTorch في الإنتاج، يتفوق PC + NVIDIA. يتحسن MLX لكن الفجوات قائمة.
MLX مقابل Ollama مقابل llama.cpp على Apple Silicon
تعمل ثلاثة محركات استدلال رئيسية على M5. أيها يناسبك؟
- ## MLX (أصلي من Apple) • الأداء: عادةً أعلى رموز/ثانية على M5؛ تحسين Metal أصلي ودعم المسرّعات العصبية. • دعم النماذج: متنامٍ (Llama وQwen وMistral وGemma متاحة) • الإعداد: يعتمد على Python ويتطلب إلمامًا بسطر الأوامر • الأنسب لـ: المستخدمين المتقدمين الذين يريدون أقصى أداء • المقايضة: أقل سهولة من Ollama
- ## Ollama (متعدد المنصات) • الأداء: تعمل نماذج GGUF عبر واجهة Metal في llama.cpp؛ وتسرّع واجهة MLX (معاينة منذ Ollama 0.19، مارس 2026) نماذج مختارة، خصوصًا على شرائح M5 • دعم النماذج: أكبر مكتبة نماذج. تُضاف نماذج جديدة أسبوعيًا. • الإعداد: تثبيت بأمر واحد ويعمل مباشرة • الأنسب لـ: المبتدئين ومعظم المطورين. واجهة REST للتكامل. • المقايضة: قد يكون أبطأ من MLX الأصلي حيث تتوفر نسخة MLX من النموذج (يختلف الفارق بحسب النموذج والإصدار)
- ## llama.cpp (متعدد المنصات، أدق تحكم) • الأداء: منافس لـ Ollama عند التحسين (تستخدمه Ollama لنماذج GGUF) • التخصيص: أكبر تحكم في التكميم ومعاملات الاستدلال • الإعداد: يتطلب بناءً وخبرة في سطر الأوامر • الأنسب لـ: الباحثين وسير عمل التكميم المخصص • المقايضة: منحنى تعلّم أشد انحدارًا من Ollama
- ## التوصية بحسب نوع المستخدم • المبتدئون: Ollama (يعمل فورًا، وتوثيق وفير) • المطورون: واجهة REST في Ollama (سهلة الدمج في التطبيقات) • المستخدمون المتقدمون: MLX مباشرةً (أقصى أداء) • الباحثون: llama.cpp (أقصى تخصيص)
البدء السريع على macOS (10 خطوات)
أسرع طريق لتشغيل أول LLM محلي بحجم 70B على Apple Silicon.
- 1اشترِ جهاز Mac
Why it matters: Mac mini M5 Pro للميزانية/الدخول، أو Mac Studio M5 Max أو M5 Ultra لقوة المكتب، أو MacBook Pro 16 بوصة M5 Max لقابلية الحمل. - 2الإعداد الأولي لـ macOS
Why it matters: استخدم مساعد الترحيل (النقل من Mac قديم) أو تثبيتًا جديدًا. أبقِ macOS محدّثًا — تصدر Apple تحسينات أداء Metal في التحديثات الفرعية. - 3ثبّت Homebrew
Why it matters: /bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)" — مدير الحزم لكل ما بعده. - 4ثبّت Ollama
Why it matters: brew install ollama — تثبيت سهل بأمر واحد. - 5شغّل خدمة Ollama
Why it matters: ollama serve (يعمل في المقدمة) أو استخدم Ollama.app من مجلد التطبيقات. - 6نزّل أول نموذج اختبار
Why it matters: ollama pull llama3.1:8b — تحقّق من التثبيت بنموذج صغير (تنزيل نحو 4 GB). - 7اختبر الاستدلال الأساسي
Why it matters: ollama run llama3.1:8b "Explain local LLMs in one sentence" --verbose — يعرض سطر eval rate الرموز/ثانية لديك. - 8نزّل النموذج الكبير المستهدف
Why it matters: ollama pull llama3.1:70b-instruct-q4_K_M (تنزيل نحو 40 GB). يستغرق 20–40 دقيقة على اتصال سريع ويتطلب جهاز Mac بسعة 64 GB أو أكثر. - 9راقب الأداء
Why it matters: يعرض asitop استخدام موارد Apple Silicon. في طرفية ثانية: brew install asitop && asitop. - 10اختياري: ثبّت LM Studio كواجهة رسومية
Why it matters: نزّله من lmstudio.ai. أسهل من سطر الأوامر لغير المطورين؛ ويتضمن محرك MLX لـ Apple Silicon.
كيف تسرّع Ollama على Apple Silicon M5
تستخدم معظم تثبيتات Ollama على Apple Silicon المسار السريع افتراضيًا، لذا تعالج القائمة أدناه ما يبطئ بصمت لا ضبطًا غريبًا.
تأكد عبر `ollama ps` أن النموذج يعمل 100% على وحدة الرسوميات، وحرّر الذاكرة الموحدة، وقلّل طول السياق، واستخدم تكميم Q4، وفعّل flash attention، وأبقِ MacBook Pro موصولًا بالكهرباء ومرفوعًا — فسرعة التوليد محدودة بعرض النطاق، لذا فأكبر مكسب هو اختيار نموذج يناسبه.
Ollama سريعة عادةً افتراضيًا على Mac بشريحة M5 — فمعظم مشكلات السرعة تأتي من شيء يستهلك ذاكرتك الموحدة، أو من نموذج أكبر من عرض نطاقك، أو من حاسوب محمول يسخن، لا من إعداد نسيته.
- طابق النموذج مع عرض نطاقك أولًا. تُحدّ الرموز/ثانية قرب عرض النطاق ÷ حجم ملف النموذج (راجع قسم عرض النطاق أعلاه). نموذج 70B بحجم 42 GB على M5 Pro بسرعة 307 GB/s لن يتجاوز نحو 7 رموز/ثانية مهما ضبطت؛ ونموذج 32B بحجم 20 GB يصل إلى نحو 15. الانتقال إلى نموذج أو تكميم أصغر هو أكبر تسريع متاح.
- تأكد من تفريغ النموذج بالكامل على وحدة الرسوميات وعدم رجوعه إلى المعالج. شغّل `ollama ps` والنموذج محمّل — يجب أن يعرض عمود PROCESSOR القيمة 100% GPU. يعني التقسيم الجزئي مع المعالج عادةً أن النموذج لا يتسع في الذاكرة التي يسمح بها macOS لوحدة الرسوميات، لا أن إعدادًا ناقص.
- حرّر الذاكرة الموحدة قبل جلسة طويلة. تُشارك الذاكرة بين macOS والنموذج — متصفح بعلامات تبويب كثيرة أو Docker Desktop أو Xcode في الخلفية قد يستقطع عدة GB من Ollama. أغلقها قبل تحميل نموذج كبير وتحقق من الذاكرة المتاحة عبر Activity Monitor أو `asitop`. وفي النماذج الكبيرة يمكن رفع حد ذاكرة وحدة الرسوميات بالأمر `sudo sysctl iogpu.wired_limit_mb=<MB>` (يُعاد ضبطه عند إعادة التشغيل).
- قلّل نافذة السياق إن لم تحتجها. اضبط `num_ctx` أصغر في Modelfile أو طلب الواجهة (مثلًا 4096 بدل 32K) للمحادثات القصيرة — فهذا يقلل ضغط ذاكرة KV ويسرّع التوليد.
- فعّل flash attention وذاكرة KV مكمّمة. يقلّل `OLLAMA_FLASH_ATTENTION=1` و`OLLAMA_KV_CACHE_TYPE=q8_0` ذاكرة KV ويسرّعان السياقات الطويلة بخسارة جودة صغيرة.
- طابق التكميم مع احتياجات الجودة الفعلية. Q4_K_M أسرع بوضوح من Q8_0 أو Q5_K_M بخسارة جودة صغيرة ومقبولة عادةً (راجع دليل التكميم). إن كان نموذج أبطأ من اختبارات الأداء أعلاه، جرّب نسخة Q4 قبل أن تلوم العتاد.
- أبقِ MacBook Pro موصولًا ومرفوعًا للاستدلال المستمر. قد يخنق MacBook Pro بنسبة 10–15% بعد 2–3 ساعات من الحمل المتواصل مع تراكم الحرارة في الهيكل الأرق. يؤخّر استخدام حامل يحسّن تدفق الهواء والتشغيل على التيار الكهربائي حدوث الخنق. وللجلسات الأطول من بضع ساعات يحافظ تبريد Mac Studio على الأداء الكامل.
- حدّث macOS وOllama. تصدر Apple تحسينات أداء Metal في التحديثات الفرعية وتصدر Ollama باستمرار واجهات أسرع، بما فيها دعم MLX لمزيد من النماذج. تشغيل إصدار قديم على سيليكون M5 جديد يهدر أداءً.
- تجنب تشغيل عدة نماذج معًا ما لم تحتج إلى ذلك. يحجز كل نموذج محمّل حصته من الذاكرة الموحدة. يتحكم `OLLAMA_MAX_LOADED_MODELS` في عدد النماذج التي تُبقيها Ollama في الذاكرة في وقت واحد.
# Check whether a model is fully offloaded to GPU (PROCESSOR column)
ollama ps

# Measure real speed: the "eval rate" line is generation tokens/sec
ollama run llama3.1:8b --verbose

# Faster long-context inference: flash attention + 8-bit KV cache
OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 ollama serve

# Or limit Ollama to one resident model at a time
OLLAMA_MAX_LOADED_MODELS=1 ollama serve

# Smaller context window in a Modelfile: PARAMETER num_ctx 4096
مصفوفة القرار: أي تهيئة Mac تشتري
استخدم هذه المصفوفة لإيجاد الأنسب لحالة استخدامك. عند تساوي الذاكرة اختر الأعلى عرض نطاق.
- 1. الميزانية أولًا وتقبل نماذج أصغر (7–14B): Mac mini M5 Pro بسعة 24 GB (1,699 دولار) — أرخص M5 Pro على الإطلاق
- 2. تريد نماذج 30B على مكتب اقتصادي: Mac mini M5 Pro بسعة 64 GB (2,699 دولار)
- 3. تريد تشغيل نماذج 70B براحة: Mac Studio M5 Max بسعة 64 GB (3,499 دولار)
- 4. تحتاج 70B Q5 بنوافذ سياق 32K+: Mac Studio M5 Max بسعة 128 GB (5,099 دولار)
- 5. تحتاج 256–512 GB لأكبر النماذج المحلية: Mac Studio M5 Ultra (5,499–10,000+ دولار)
- 6. LLM محلي محمول مع قبول الخنق الحراري: MacBook Pro 16 بوصة M5 Max بسعة 64 GB (3,499 دولار)
- 7. أنت في منظومة macOS أصلًا (Xcode وFinal Cut Pro): أي نسخة من Mac Studio M5
- 8. بحث/ضبط دقيق مع تجارب MLX: Mac Studio M5 Max بسعة 128 GB أو M5 Ultra (هامش الذاكرة)
- 9. تريد أقصى هدوء وتشغيلًا في وضع الخمول: Mac Studio (نادرًا ما تدور المراوح تحت الحمل المعتاد)
- 10. ميزانية 4,000 دولار فأكثر وتريد جهازًا محمولًا: MacBook Pro 16 بوصة M5 Max بسعة 128 GB (4,499 دولار)
- 11. تدرس البدائل: حاسوب RTX 4090 (من 3,000 دولار) أو حاسوب مصغّر AMD Ryzen AI Max+ (1,600–2,000 دولار)
متى لا يناسب Apple Silicon M5 الـ LLM المحلي
Apple Silicon ممتاز لكنه ليس شاملًا. تجنّب Mac للـ LLM المحلي في هذه السيناريوهات.
- تحتاج سير عمل لا يعمل إلا مع CUDA: تعمل معظم عمليات استدلال LLM على Apple Silicon، لكن الضبط الدقيق بـ torch.cuda ونوى CUDA في vLLM وأكواد البحث الخاصة بـ CUDA لا تعمل على MLX. إن كان معظم عملك خاصًا بـ CUDA فاختر بطاقة RTX.
- تعمل كثيرًا مع Stable Diffusion: تعمل نماذج الانتشار عمومًا أبطأ على M5 منها على RTX 4090. إن كان توليد الصور 30% أو أكثر من سير عملك فيتفوق PC + RTX.
- الميزانية هي الأولوية المطلقة: يتفوق حاسوب بـ 1,500 دولار مع RTX 4070 Ti على Mac mini M5 Pro في سرعة النماذج الصغيرة. إن كانت الميزانية وحدها ما يهم فالحاسوب أرخص.
- تحتاج إلى قابلية ترقية محطة العمل: ذاكرة Mac Studio وتخزينه ثابتان عند الشراء. تسمح أجهزة PC بترقيات تدريجية. لملكية 5 سنوات فأكثر قد يكون PC أرخص على المدى الطويل.
- تطلب أرقامًا من ثلاث خانات في الرموز/ثانية مع النماذج الصغيرة: تبلغ RTX 4090 سرعة 90–120 رمزًا/ثانية مع Llama 8B. ويُقدَّر M5 Max بـ 75–100. وللإنتاجية العالية (عدة مستخدمين) لا تزال NVIDIA تتفوق.
- لا تستخدم macOS أصلًا: لا يستحق التحول من Windows/Linux للـ LLM المحلي وحده، ما لم ترغب في macOS لأسباب أخرى.
- تحتاج استدلالًا إنتاجيًا 24/7: Mac Studio ممتاز لكنه مصمم للدفعات. للاستدلال المتواصل باتفاقية مستوى خدمة، محطات NVIDIA المؤسسية خيار أضمن.
الأسئلة الشائعة
ما عرض نطاق ذاكرة M5 Pro وM5 Max وM5 Ultra؟
يبلغ عرض نطاق M5 نحو 153.6 GB/s، وM5 Pro نحو 307 GB/s، وM5 Max نحو 460 GB/s (معالج رسوميات 32 نواة) أو 614 GB/s (40 نواة)، وM5 Ultra حتى 1.2 TB/s (1,228.8 GB/s). في توليد LLM يهم عرض النطاق أكثر من عدد أنوية الرسوميات، لأن كل رمز يقرأ أوزان النموذج من الذاكرة مرة واحدة.
كم VRAM يملك جهاز Mac بشريحة M5؟
لا يملك VRAM منفصلة — لدى جهاز M5 ذاكرة موحدة يتشاركها المعالج ووحدة الرسوميات. افتراضيًا يسمح macOS للرسوميات باستخدام نحو ثلثي إلى ثلاثة أرباع الذاكرة الكلية، فيمنح جهاز 64 GB النموذج نحو 48 GB. يصل M5 Pro إلى 64 GB وM5 Max إلى 128 GB وM5 Ultra إلى 512 GB.
كيف أجعل Ollama تعمل أسرع على MacBook Pro M5؟
اختر نموذجًا يناسب عرض نطاقك، وتأكد عبر `ollama ps` أنه يعمل 100% على وحدة الرسوميات، وأغلق التطبيقات المستهلكة للذاكرة، وقلّل `num_ctx` إن لم تحتج سياقًا طويلًا، واستخدم تكميم Q4_K_M بدل Q5/Q8، وفعّل `OLLAMA_FLASH_ATTENTION=1`، وأبقِ MacBook Pro موصولًا ومرفوعًا للجلسات التي تتجاوز 2–3 ساعات. راجع قسم التسريع أعلاه للقائمة الكاملة.
هل يستطيع Mac Studio M5 Max تشغيل Llama 3.3 70B؟
نعم، بسعة 64 GB أو 128 GB. يحتاج 70B Q4 (~42.5 GB) إلى 64 GB ويعمل بنحو 6–9 رموز/ثانية تقديرًا على الشريحة بسرعة 460 GB/s و9–12 رمزًا/ثانية على الشريحة بسرعة 614 GB/s. أما 70B Q5 (~50 GB) فيحتاج تهيئة 128 GB ويعمل بنحو 7–10 رموز/ثانية تقديرًا.
كيف يقارن M5 Max بـ RTX 4090 للـ LLM المحلي؟
M5 Max أبطأ في النماذج الصغيرة التي تتسع لـ 24 GB (نحو 75–100 مقابل 90–120 رمزًا/ثانية تقديرًا مع Llama 8B). أما نماذج 70B فلا تتسع لها 4090 وتلجأ إلى التفريغ على المعالج بنحو 6–10 رموز/ثانية، بينما يشغّلها M5 Max بسرعة 614 GB/s بنحو 9–12 رمزًا/ثانية تقديرًا وبنحو ثلث استهلاك الطاقة.
هل تكفي 64 GB من الذاكرة أم أحتاج 128 GB؟
لنموذج 70B Q4 واحد: 64 GB كافية. لـ 70B Q5 أو Q8 أو عدة نماذج متزامنة أو سياقات طويلة أو الضبط الدقيق: يُنصح بـ 128 GB. لا تغيّر سعة الذاكرة السرعة — فلدى Mac Studio M5 Max بسعة 64 GB وبسعة 128 GB عرض النطاق نفسه 614 GB/s.
ما الفرق بين M5 Pro وM5 Max للـ LLM؟
لدى M5 Pro معالج رسوميات 16/20 نواة وعرض نطاق 307 GB/s وحتى 64 GB. ولدى M5 Max معالج رسوميات 32/40 نواة وعرض نطاق 460/614 GB/s وحتى 128 GB. ولأن سرعة التوليد تتناسب مع عرض النطاق، فإن M5 Max أسرع بنحو 1.5× (460 GB/s) إلى 2× (614 GB/s) مع النموذج نفسه. ويذهب M5 Ultra (في Mac Studio فقط) أبعد: حتى 80 نواة رسوميات وحتى 1.2 TB/s وحتى 512 GB.
ما سرعة Mac Studio M5 Ultra مع LLM المحلي؟
قاست MacStories سرعة 48 رمزًا/ثانية في التوليد بنموذج Qwen3.8 27B على M5 Ultra بسعة 256 GB (مقابل 59 على RTX 5090) و108 رموز/ثانية مع نموذج Flash-Next أصغر، أي أسرع بنحو 54% من M3 Ultra. الحد الأعلى لعرض النطاق لنموذج 70B Q4 نحو 29 رمزًا/ثانية؛ ولم تُنشر بعد نتيجة مستقلة لنموذج 70B.
هل يخنق MacBook Pro حراريًا أثناء استدلال LLM المستمر؟
نعم، بعد 2–3 ساعات من الاستدلال المتواصل قد يفقد MacBook Pro نحو 10–15% من الأداء (تقدير). ويحافظ Mac Studio على الأداء الكامل على مدار الساعة.
هل أستطيع تشغيل Stable Diffusion على Apple Silicon؟
نعم، يعمل Stable Diffusion XL على M5 بنحو 8–12 ثانية/صورة (أبطأ من RTX 4070 بنحو 3 ثوانٍ). ويدعمه MLX أصليًا.
هل MLX أسرع من Ollama على Mac؟
عادةً، للنماذج التي لها نسخة MLX: يكون MLX عادةً أسرع من نماذج GGUF على llama.cpp، وتُذكر فروق من نحو 10% إلى 2× بحسب النموذج والإصدار. أضافت Ollama واجهة MLX في مارس 2026 تُضيّق الفارق في النماذج المدعومة. اختر بحسب سير عملك لا السرعة الخام.
كم تستهلك Mac Studio M5 Max من الكهرباء في استدلال LLM؟
يُقدَّر نحو 65–100 واط مستمرة لـ M5 Max تحت حمل LLM؛ وتحدد Apple لهيكل Mac Studio ما يصل إلى 480 واط كحد أقصى للطاقة المستمرة، وهو ما لا يبلغه الاستدلال وحده. شهر من الاستدلال 24/7 (720 ساعة) عند 100 واط يعادل نحو 72 كيلوواط ساعة، أي نحو 8–12 دولارًا من الكهرباء في الولايات المتحدة؛ بينما يكلّف نظام RTX 4090 نحو 40–60 دولارًا.
هل لدى Mac mini الآن M5 Pro؟
نعم. يبدأ Mac mini M5 Pro من 1,699 دولار (24 GB وحتى 64 GB) بعرض نطاق 307 GB/s ومنفذ Thunderbolt 5، ويُشحن منذ 22 سبتمبر 2026 — أرخص جهاز Mac بمعالج M5 Pro على الإطلاق.
هل لا يزال Mac Studio يقدّم تهيئة M5 Pro؟
لا. منذ تحديث 25 أغسطس 2026 يبدأ Mac Studio من M5 Max (2,499 دولار). وأصبح Mac mini نقطة الدخول إلى شريحة M5 Pro.
ما هو Mac Studio M5 Ultra وكم ذاكرة يدعم؟
M5 Ultra شريحة فوق M5 Max، حصرية لـ Mac Studio، تبدأ من 5,499 دولار (96 GB). وتتدرج إلى 256 GB الآن و512 GB في أواخر أكتوبر 2026 (يُتوقع أن يتجاوز سعرها 10,000 دولار بكثير)، بعرض نطاق حتى 1.2 TB/s.
هل أستطيع ضبط النماذج بدقة على Apple Silicon؟
نعم، يعمل الضبط الدقيق بـ LoRA جيدًا. الضبط الدقيق لكل الأوزان أبطأ منه على بطاقة رسوميات مكتبية (لا دعم للتدريب الموزّع بعد).
هل Apple Silicon جيد للاستدلال سيئ للتدريب؟
جزئيًا. الاستدلال ممتاز. التدريب/الضبط الدقيق يعمل لكنه أبطأ من NVIDIA. ويتحسن إطار MLX بسرعة.
كيف يساعد Neural Engine في LLM؟
تُحدّ سرعة توليد الرموز بعرض نطاق الذاكرة لا بـ Neural Engine. وفي شرائح عائلة M5 تسرّع المسرّعات العصبية داخل كل نواة رسوميات معالجة الأمر النصي (الزمن حتى أول رمز) في بيئات التشغيل التي تستخدمها، مثل MLX وواجهة MLX في Ollama.
هل أستطيع تشغيل عدة نماذج معًا على M5 Max بسعة 128 GB؟
نعم. تسمح 128 GB بتشغيل نموذجين 32B أو نموذج 70B مع نموذج 14B في الوقت نفسه بسرعة مقبولة.
كم يستغرق إعداد LLM محلي على Mac عادةً؟
من 15 إلى 30 دقيقة من جهاز Mac جديد حتى تشغيل أول نموذج 70B عبر Ollama (بما في ذلك 20–40 دقيقة لتنزيل النموذج على إنترنت سريع).
هل يعمل Apple Silicon مع أحدث النماذج مفتوحة الأوزان؟
تعمل معظم عائلات النماذج مفتوحة الأوزان — Llama وQwen وMistral وGemma وDeepSeek — عبر llama.cpp (GGUF) أو MLX خلال أيام من صدورها. راجع مجتمع MLX على Hugging Face ومكتبة Ollama للقائمة الحالية.
هل أشتري Mac mini M6 أم Mac mini M5 Pro للـ LLM المحلي؟
M6 هو Mac mini للمستوى المبتدئ (899 دولار، 16–32 GB، نحو 153–170 GB/s) ويناسب النماذج الصغيرة. أما M5 Pro (1,699 دولار، حتى 64 GB، 307 GB/s) فلديه نحو ضعف عرض النطاق والذاكرة، فهو خيار الـ LLM المحلي.
هل يستحق Mac Studio المُجدَّد الاعتبار؟
نعم. تبيع Apple أجهزة Mac مُجدَّدة بضمان سنة واحدة، عادةً بخصم عن سعر الجهاز الجديد.
هل الأفضل M5 Max بسعة 64 GB أم 128 GB؟
اشترِ 64 GB لنموذج 70B Q4 واحد ونماذج 32B؛ و128 GB لـ 70B Q5/Q8 أو السياقات الطويلة أو تشغيل عدة نماذج معًا. وانتبه لفئة الرسوميات أيضًا: في MacBook Pro تأتي 64 GB مع الشريحة بسرعة 460 GB/s و128 GB مع الشريحة بسرعة 614 GB/s.