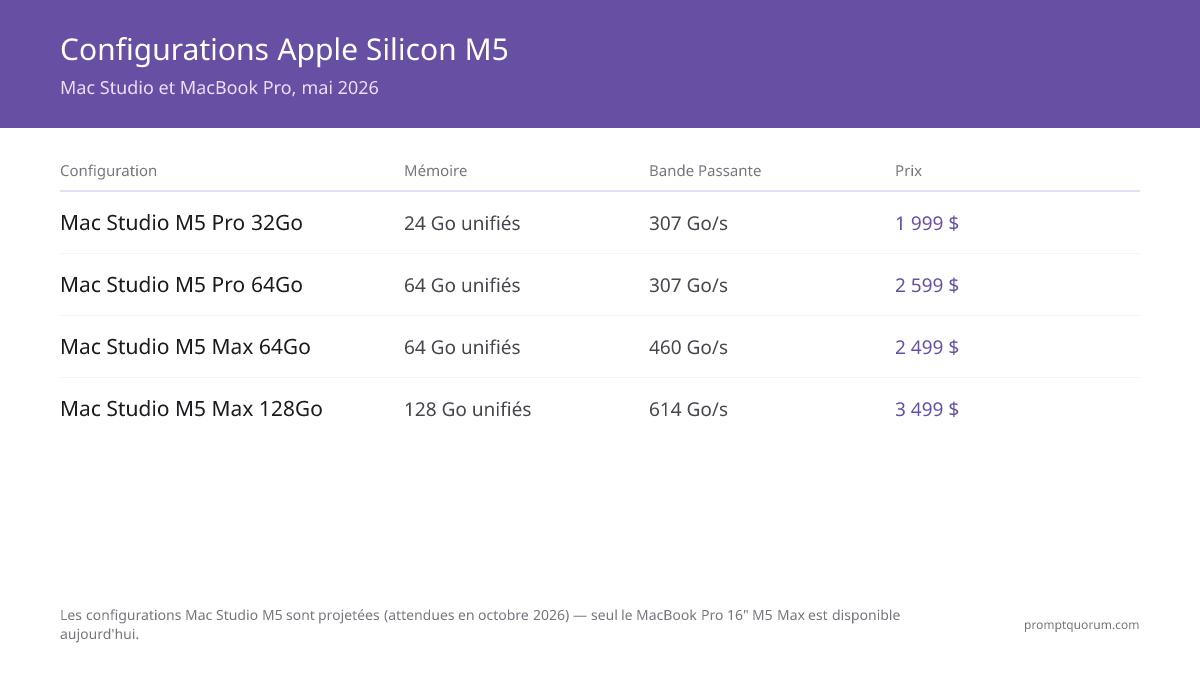
Points clés
- ✅ Bande passante par puce : M5 153,6 Go/s · M5 Pro 307 Go/s · M5 Max 460 Go/s (GPU 32 cœurs) ou 614 Go/s (GPU 40 cœurs) · M5 Ultra jusqu'à 1,2 To/s. La vitesse de génération vaut environ bande passante ÷ taille du modèle × 60–80 % — voir les sections sur la bande passante ci-dessous.
- ✅ LIVRÉ DEPUIS LE 22 SEPTEMBRE 2026 : Mac mini M5 Pro dès 1 699 $ (jusqu'à 64 Go, 307 Go/s) — le Mac M5 Pro le moins cher jamais proposé, moins cher que le MacBook Pro.
- ✅ Le Mac Studio M5 Max dès 2 499 $ (jusqu'à 128 Go, 614 Go/s) et le Mac Studio M5 Ultra dès 5 499 $ (jusqu'à 512 Go, jusqu'à 1,2 To/s) sont livrés. La configuration M5 Ultra de 512 Go arrive fin octobre 2026 et devrait dépasser nettement 10 000 $.
- Le Mac Studio ne propose plus de niveau M5 Pro : il démarre au M5 Max. Le Mac mini est désormais la porte d'entrée vers la puce M5 Pro.
- Le MacBook Pro 16" M5 Max (disponible depuis mars 2026) partage la même bande passante que le Mac Studio M5 Max à niveau de GPU égal : 460 Go/s (GPU 32 cœurs) et 614 Go/s (GPU 40 cœurs), sans pénalité liée au format.
- Toutes les configurations M5 Pro/Max : 307–614 Go/s de bande passante (RTX 4090 à 1 008 Go/s mais limitée à 24 Go de VRAM). Le M5 Ultra atteint jusqu'à 1,2 To/s.
- Fonctionnement silencieux : les ventilateurs du MacBook Pro deviennent audibles en inférence soutenue ; ceux du Mac Studio et du Mac mini s'activent rarement sous charge LLM locale typique.
- MLX est généralement le moteur le plus rapide sur Apple Silicon. Ollama a ajouté un backend MLX en mars 2026 (préversion, Ollama 0.19, d'abord pour certains modèles sur Mac de plus de 32 Go) ; les autres modèles passent toujours par le backend Metal de llama.cpp.
- Mémoire unifiée : de 24 Go (Mac mini M5 Pro, base) à 512 Go (Mac Studio M5 Ultra) disponibles pour n'importe quel modèle. Pas de plafond VRAM distinct comme sur les GPU dédiés.
📍 En une phrase
Le M5 Pro offre 307 Go/s, le M5 Max 460–614 Go/s et le M5 Ultra jusqu'à 1,2 To/s de bande passante mémoire, et c'est ce chiffre — pas le nombre de cœurs — qui fixe le nombre de tokens par seconde d'un Mac ; le Mac mini M5 Pro démarre à 1 699 $, le Mac Studio M5 Max à 2 499 $ et le Mac Studio M5 Ultra à 5 499 $.
💬 En termes simples
Les Mac Apple Silicon utilisent une mémoire unifiée : CPU, GPU et moteur IA partagent le même pool de mémoire rapide. Un M5 Max de 128 Go peut ainsi charger un modèle 70B complet qu'aucun GPU NVIDIA grand public (24–32 Go de VRAM) ne contient, et l'option 512 Go du M5 Ultra va encore plus loin.
🔄 Mise à jour du 11 octobre 2026 : la date de livraison du 22 septembre 2026 est passée, le Mac mini M5 Pro, le Mac Studio M5 Max et le Mac Studio M5 Ultra (96–256 Go) sont donc disponibles ; seule la configuration M5 Ultra de 512 Go reste attendue (fin octobre 2026). Cette mise à jour ajoute des sections sur la bande passante mémoire, remplace les plages de tokens par seconde qui dépassaient le plafond de bande passante de chaque puce et intègre les premières mesures indépendantes du M5 Ultra issues du test de MacStories. Les chiffres de tokens/s du Mac mini M5 Pro et du Mac Studio M5 Max restent des estimations dérivées de la bande passante et des résultats du MacBook Pro, pas des mesures sur ces châssis.
Pourquoi Apple Silicon M5 compte pour le LLM local
Apple Silicon repose sur une architecture radicalement différente pour les charges IA. Voici pourquoi elle compte pour les utilisateurs de LLM locaux.
- Architecture de mémoire unifiée : M5 Pro et M5 Max partagent un unique pool de mémoire rapide (24 à 128 Go) accessible simultanément par le CPU, le GPU et le Neural Engine. Pas de goulot VRAM/RAM. Les modèles restent en mémoire rapide et l'inférence reste réactive.
- La bande passante mémoire est le vrai goulot : la génération d'un LLM est limitée par la mémoire, pas par le calcul : chaque token généré lit une fois les poids du modèle. Avec 460–614 Go/s, le M5 Max reste derrière les 1 008 Go/s de la RTX 4090 sur les petits modèles, mais accueille jusqu'à 128 Go contre 24 Go et exécute donc des modèles qu'une 4090 ne peut pas contenir. Le M5 Ultra dépasse la 4090 avec jusqu'à 1,2 To/s et accueille jusqu'à 512 Go.
- La « VRAM » d'un Mac est la mémoire unifiée : il n'existe pas de pool de VRAM séparé. Le GPU puise dans la même mémoire que macOS ; par défaut, macOS autorise le GPU à réserver environ deux tiers à trois quarts de la RAM totale (la part varie selon la taille de la RAM). Sur un Mac de 64 Go, comptez environ 48 Go pour modèle plus contexte ; la limite peut être relevée avec `sudo sysctl iogpu.wired_limit_mb=<Mo>` (réinitialisée au redémarrage).
- Architecture Apple Fusion (nouveauté M5) : M5 Pro et M5 Max séparent CPU et GPU en deux dies 3 nm distincts dans un même boîtier, ce qui permet un dimensionnement et une optimisation thermique indépendants et améliore l'efficacité énergétique par rapport aux puces monolithiques.
- Neural Accelerator dans chaque cœur GPU : chaque cœur GPU intègre un accélérateur neuronal dédié qui complète le Neural Engine partagé. Les moteurs qui les exploitent, comme MLX et le backend MLX d'Ollama, traitent les prompts plus vite sur les puces M5.
- Gain générationnel par rapport au M4 : Apple annonce jusqu'à 30 % de performances CPU multicœur en plus par rapport aux M4 Pro et M4 Max. Pour la génération de LLM, c'est la bande passante qui compte : M5 Pro 307 Go/s contre 273 Go/s pour le M4 Pro (+12 %), et 614 Go/s contre 546 Go/s pour les M5 Max et M4 Max haut de gamme (+12 %). Le traitement des prompts progresse davantage grâce aux accélérateurs neuronaux par cœur.
- Thunderbolt 5 (M5 Pro/Max) : M5 Pro et M5 Max offrent Thunderbolt 5 avec 80 Gb/s de bande passante de base (le double de Thunderbolt 4), utile pour le stockage externe rapide et plusieurs écrans.
- Wi-Fi 7 et Bluetooth 6 via la puce Apple N1 : les systèmes M5 intègrent la nouvelle puce sans fil N1 (Wi-Fi 7, Bluetooth 6.0) à faible latence, utile avec des clients d'inférence distants ou des API de modèles cloud.
- MLX mûrit vite : le framework MLX d'Apple prend en charge Llama 3.3, Qwen, Mistral et Gemma avec des noyaux optimisés. Ollama propose un backend MLX pour Apple Silicon depuis mars 2026 (préversion), d'abord limité à certains modèles.
- L'efficacité énergétique est réelle : le M5 Max est estimé à environ 65–100 W en inférence soutenue (une estimation, pas un chiffre Apple ; Apple indique jusqu'à 480 W de puissance continue maximale pour le châssis du Mac Studio). Un mois d'inférence continue (720 heures) à 100 W représente environ 72 kWh, soit 8–12 $ d'électricité aux États-Unis. Une RTX 4090 à 350 W coûte environ 40–60 $ le même mois.
- Fonctionnement silencieux : les ventilateurs du Mac Studio deviennent rarement audibles sous charge LLM typique ; MacStories n'a pas pu entendre le ventilateur du Mac Studio M5 Ultra en usage quotidien. Ceux du MacBook Pro deviennent audibles en inférence soutenue.
Tableau comparatif Apple Silicon M5
Les configurations ci-dessous reprennent les prix Apple de l'annonce du 25 août 2026. Mac mini, Mac Studio et MacBook Pro sont livrés depuis le 22 septembre 2026, sauf la configuration Mac Studio M5 Ultra de 512 Go (fin octobre 2026, nettement au-dessus de 10 000 $ attendu). Prix : prix USD de l'Apple Store. Seul le M5 Ultra dispose pour l'instant de mesures indépendantes de tokens/s : voir la section Performances pour ce qui est mesuré et ce qui est estimé.
Configuration | Puce | Cœurs GPU | Mémoire | Bande passante | Prix | Idéal pour |
|---|---|---|---|---|---|---|
| Mac mini M5 Pro 24 Go | M5 Pro | 16 | 24 Go unifiée | 307 Go/s | 1 699 $ | M5 Pro le moins cher, 7B–14B |
| Mac mini M5 Pro 64 Go | M5 Pro | 20 | 64 Go unifiée | 307 Go/s | 2 699 $ | Modèles 30B, 64 Go le moins cher |
| Mac Studio M5 Max 36 Go | M5 Max | 32 | 36 Go unifiée | 460 Go/s | 2 499 $ | Entrée de gamme bureau |
| Mac Studio M5 Max 64 Go | M5 Max | 40 | 64 Go unifiée | 614 Go/s | 3 499 $ | 70B Q4, meilleur rapport |
| Mac Studio M5 Max 128 Go | M5 Max | 40 | 128 Go unifiée | 614 Go/s | 5 099 $ | 70B Q5, utilisateurs avancés |
| Mac Studio M5 Ultra 96 Go | M5 Ultra | 64 | 96 Go unifiée | Jusqu'à 1,2 To/s | 5 499 $ | Les plus gros modèles locaux |
| Mac Studio M5 Ultra 512 Go | M5 Ultra | 80 | 512 Go unifiée | Jusqu'à 1,2 To/s | 10 000+ $ (est.) | Modèles géants, livraison fin oct. |
| MacBook Pro 16" M5 Max 64 Go | M5 Max | 32 | 64 Go unifiée | 460 Go/s | 3 499 $ | Portable, 70B Q4 |
| MacBook Pro 16" M5 Max 128 Go | M5 Max | 40 | 128 Go unifiée | 614 Go/s | 4 499 $ | Portable, 70B Q5 |
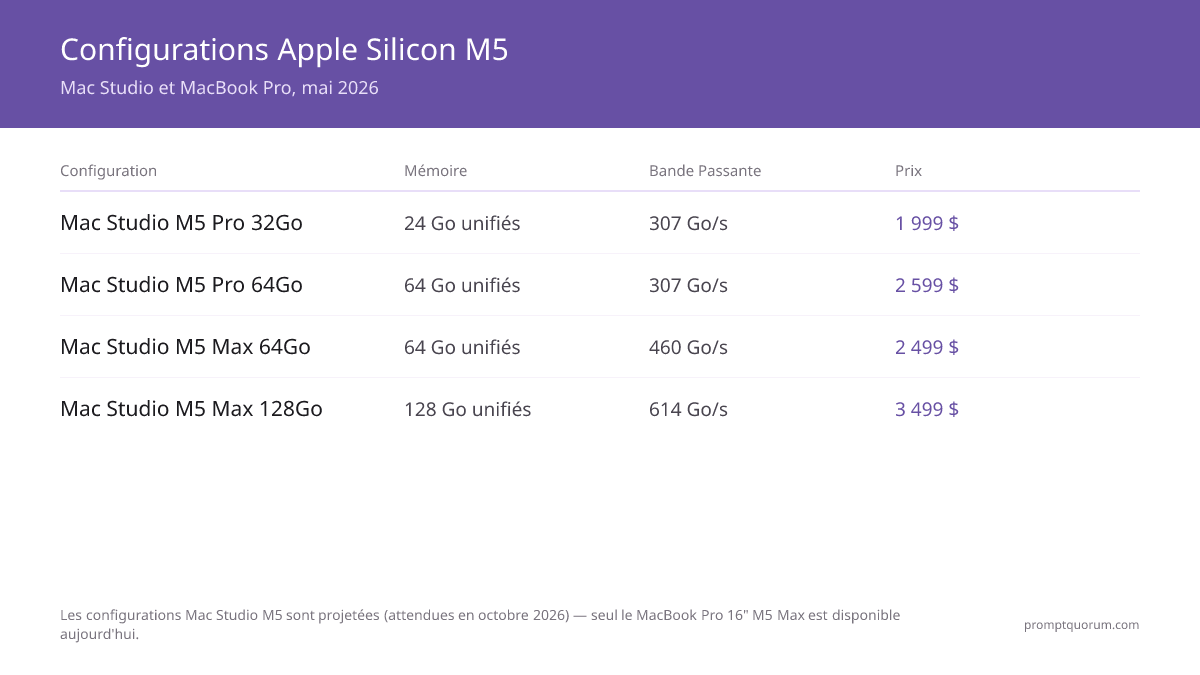
Bande passante mémoire des M5, M5 Pro, M5 Max et M5 Ultra comparée
La bande passante mémoire est la caractéristique qui décide de la vitesse de génération des LLM locaux sur Apple Silicon, et celle que la plupart des acheteurs recherchent. Le tableau donne la valeur officielle de chaque puce ; le M5 Max a deux niveaux : 460 Go/s avec le GPU 32 cœurs et 614 Go/s avec le GPU 40 cœurs. Ce sont des maximums théoriques.
📍 En une phrase
La bande passante mémoire de l'Apple M5 est de 153,6 Go/s (M5), 307 Go/s (M5 Pro), 460 Go/s (M5 Max avec GPU 32 cœurs), 614 Go/s (M5 Max avec GPU 40 cœurs) et jusqu'à 1,2 To/s (M5 Ultra).
💬 En termes simples
La bande passante indique la rapidité avec laquelle la puce lit le modèle en mémoire. Générer un token lit (presque) tout le modèle une fois : un Mac ne peut donc jamais générer plus vite que sa bande passante divisée par la taille du modèle.
- M5 Pro vs M5 Max : le M5 Max offre 1,5× (GPU 32 cœurs, 460 Go/s) ou 2× (GPU 40 cœurs, 614 Go/s) la bande passante du M5 Pro ; attendez-vous à une génération d'autant plus rapide avec le même modèle.
- M5 Max vs M5 Ultra : le M5 Ultra associe deux puces M5 Max et double les 614 Go/s du M5 Max à GPU 40 cœurs jusqu'à environ 1,2 To/s, soit 50 % de plus que les 819 Go/s du M3 Ultra de la génération précédente.
- Capacité vs bande passante : davantage de mémoire ne rend pas une puce plus rapide. Un M5 Max à GPU 40 cœurs offre les mêmes 614 Go/s avec 64 Go ou 128 Go ; la mémoire supplémentaire permet seulement de charger des modèles plus gros ou plus nombreux.
Puce | Cœurs GPU | Mémoire max. | Bande passante | Présent dans |
|---|---|---|---|---|
| M5 | 8–10 | 32 Go | 153,6 Go/s | MacBook Air, MacBook Pro 14" |
| M5 Pro | 16–20 | 64 Go | 307 Go/s | MacBook Pro, Mac mini |
| M5 Max (GPU 32 cœurs) | 32 | 36 Go+ | 460 Go/s | MacBook Pro, Mac Studio |
| M5 Max (GPU 40 cœurs) | 40 | 128 Go | 614 Go/s | MacBook Pro, Mac Studio |
| M5 Ultra | 64–80 | 512 Go | 1,2 To/s (1 228,8 Go/s) | Mac Studio |
| M4 Max (référence) | 40 | 128 Go | 546 Go/s | Génération précédente |
| RTX 4090 (référence) | n/d | 24 Go VRAM | 1,008 Go/s | GPU dédié |
De la bande passante aux tokens par seconde
Le tableau ci-dessous relève de l'arithmétique, pas du benchmark : plafond en tokens/s = bande passante ÷ taille du fichier du modèle. En pratique la génération reste en dessous, à cause des lectures du cache KV, de la surcharge du moteur et de la thermique. Les modèles Mixture-of-Experts ne lisent que leurs experts actifs par token et peuvent donc aller plus vite qu'un modèle dense de même taille de fichier.
📍 En une phrase
La limite supérieure de la vitesse de génération est la bande passante mémoire divisée par la taille du fichier du modèle — par exemple 614 Go/s ÷ 42,5 Go (Llama 3.3 70B Q4) ≈ 14 tokens/s — et les moteurs bien optimisés en atteignent généralement 60–80 %.
💬 En termes simples
Choisissez la puce selon le plus gros modèle que vous voulez exécuter, puis consultez ce tableau de plafonds : si le plafond est inférieur à 10 tokens/s, le modèle paraîtra lent quel que soit le nombre de cœurs GPU achetés.
- Lire le tableau : les valeurs sont des plafonds théoriques en tokens/s. Multipliez par 0,6–0,8 pour une plage réaliste — pour Llama 3.3 70B Q4 sur un M5 Max à 614 Go/s, cela donne environ 9–12 tokens/s.
- Vérification indépendante : MacStories a mesuré 48 tokens/s en génération avec Qwen3.8 27B sur un Mac Studio M5 Ultra (prompt de 6 091 tokens), contre 59 tokens/s sur une RTX 5090 (1,79 To/s de bande passante). La vitesse réelle a suivi la bande passante, pas le nombre de cœurs.
- Règle de dimensionnement : le fichier du modèle plus le cache KV doivent tenir dans environ deux tiers à trois quarts de la mémoire unifiée ; un modèle 70B Q4 (~42,5 Go) demande donc un Mac de 64 Go, et les variantes Q5 et Q8 demandent 128 Go.
Modèle (Q4_K_M) | Taille fichier | M5 Pro 307 | M5 Max 460 | M5 Max 614 | M5 Ultra 1,2 To/s |
|---|---|---|---|---|---|
| Llama 3,1 8B | ~4,9 Go | ~63 | ~94 | ~125 | ~250 |
| Mistral Small 24B | ~14 Go | ~22 | ~33 | ~44 | ~88 |
| Qwen3 32B | ~20 Go | ~15 | ~23 | ~31 | ~61 |
| Llama 3,3 70B | ~42,5 Go | ~7 | ~11 | ~14 | ~29 |
Mac mini M5 Pro : nouvelle entrée économique pour le LLM local
Le 25 août 2026, Apple a placé pour la première fois une puce M5 Pro dans le Mac mini ; auparavant, le M5 Pro n'existait que dans le MacBook Pro. De 1 699 à 2 699 $ pour 24–64 Go de mémoire unifiée, le Mac mini M5 Pro est le moyen le moins cher d'atteindre le plafond de 64 Go du M5 Pro et coûte moins cher que le MacBook Pro M5 Pro. Le Mac Studio démarre désormais au M5 Max. Livré depuis le 22 septembre 2026.
- CPU : M5 Pro 15 ou 18 cœurs
- GPU : GPU M5 Pro 16 ou 20 cœurs
- Mémoire : 24 Go de base, configurable en 48 ou 64 Go de mémoire unifiée LPDDR5X
- Bande passante mémoire : 307 Go/s (identique au M5 Pro du MacBook Pro)
- Stockage : SSD 512 Go–2 To (configurable)
- Ports : Thunderbolt 5 (nouveau sur Mac mini)
- Connectivité : Wi-Fi 7, Bluetooth 6
- Prix : 1 699 $ (CPU 15 cœurs/GPU 16 cœurs, 24 Go) ; 2 699 $ (CPU 18 cœurs/GPU 20 cœurs, 64 Go)
- Disponibilité : livré depuis le 22 septembre 2026
Mac Studio M5 Max 36 Go : configuration de base
Le Mac Studio M5 Max de base démarre à 2 499 $ avec un GPU 32 cœurs et 36 Go de mémoire unifiée ; les options de mémoire supérieures viennent avec le GPU 40 cœurs décrit plus bas. Livré depuis le 22 septembre 2026. Le Mac Studio n'a plus aucun niveau M5 Pro : c'est désormais le Mac Studio le moins cher.
- CPU : M5 Max 18 cœurs
- GPU : GPU M5 Max 32 cœurs
- Mémoire : 36 Go de mémoire unifiée LPDDR5X à ce niveau de GPU
- Bande passante mémoire : 460 Go/s (identique au M5 Max 32 cœurs du MacBook Pro)
- Stockage : SSD 512 Go–8 To (configurable)
- Ports : Thunderbolt 5
- Consommation : estimée à 65–100 W en inférence soutenue ; ventilateurs rarement actifs
- Prix : 2 499 $
- Disponibilité : livré depuis le 22 septembre 2026
Mac Studio M5 Max 48–128 Go : meilleur rapport qualité-prix pour le LLM local 70B
Le Mac Studio M5 Max à GPU 40 cœurs démarre à 3 099 $ (48 Go) et se configure jusqu'à 128 Go pour 5 099 $. C'est le niveau qui tient la promesse « meilleur rapport pour le 70B » : 64 Go coûtent 3 499 $ avec les 614 Go/s complets. Livré depuis le 22 septembre 2026.
- CPU : M5 Max 18 cœurs
- GPU : GPU M5 Max 40 cœurs
- Mémoire : 48 Go de base, configurable en 64 ou 128 Go de mémoire unifiée LPDDR5X
- Bande passante mémoire : 614 Go/s (identique au M5 Max 40 cœurs du MacBook Pro)
- Stockage : SSD 512 Go–8 To
- Ports : Thunderbolt 5
- Consommation : estimée à 65–100 W en inférence soutenue ; activité modérée des ventilateurs en usage multi-modèles intensif
- Prix : 3 099 $ (48 Go) ; 3 499 $ (64 Go) ; 5 099 $ (128 Go)
- Disponibilité : livré depuis le 22 septembre 2026
Mac Studio M5 Ultra : nouveau niveau de performance maximale
Le Mac Studio M5 Ultra est un nouveau niveau haut de gamme au-dessus du M5 Max, dès 5 499 $ pour 96 Go et jusqu'à 512 Go. Les configurations de 96–256 Go sont livrées depuis le 22 septembre 2026 ; celle de 512 Go arrive fin octobre 2026 et devrait dépasser nettement 10 000 $. Elle égale le plafond de 512 Go du M3 Ultra de la génération précédente avec 50 % de bande passante en plus.
- CPU : M5 Ultra 30 cœurs (36 cœurs configurable)
- GPU : 64 cœurs de base, 80 cœurs configurable
- Mémoire : 96 Go de base, configurable en 256 Go dès maintenant, 512 Go fin octobre 2026
- Bande passante mémoire : jusqu'à 1,2 To/s (1 228,8 Go/s ; 50 % de plus que les 819 Go/s du M3 Ultra)
- Stockage : SSD 1–16 To
- Ports : Thunderbolt 5
- Prix : 5 499 $ (base 96 Go : CPU 30 cœurs/GPU 64 cœurs) ; 512 Go attendu nettement au-dessus de 10 000 $
- Disponibilité : livré depuis le 22 septembre 2026 (96–256 Go) ; fin octobre 2026 (512 Go)
MacBook Pro 16" M5 Max : LLM local portable
Le MacBook Pro 16" M5 Max (3 499–4 499 $) utilise le même silicium M5 Max que le Mac Studio dans un format portable. La bande passante mémoire est égale à celle du Mac Studio à chaque niveau de GPU : 460 Go/s avec le GPU 32 cœurs et 614 Go/s avec le GPU 40 cœurs. Notez que le MacBook Pro 64 Go utilise le GPU 32 cœurs, alors que le Mac Studio 64 Go utilise le GPU 40 cœurs. Le bridage thermique en inférence soutenue est le prix de la portabilité.
- CPU : M5 Max 18 cœurs (6 super + 12 performance)
- GPU : GPU M5 Max 32 ou 40 cœurs
- Mémoire : 64 Go ou 128 Go de mémoire unifiée
- Écran : Liquid Retina XDR 16,2 pouces, 3456×2234
- Bande passante mémoire : 460 Go/s (64 Go, GPU 32 cœurs) ou 614 Go/s (128 Go, GPU 40 cœurs)
- Stockage : SSD 512 Go–8 To
- Batterie : annoncée en heures de lecture vidéo ; l'inférence soutenue la vide bien plus vite
- Poids : 2,14 kg
- Ports : 3× Thunderbolt 5, HDMI 2.1, lecteur SD, prise casque
- Prix : 3 499 $ (64 Go, GPU 32 cœurs) à 4 499 $ (128 Go, GPU 40 cœurs)
🏆 Nos sélections : quel Mac acheter pour le LLM local
Des recommandations claires selon l'usage.
- 🏆 💰 M5 PRO LE MOINS CHER : Mac mini M5 Pro (1 699 $, disponible) • Pourquoi : premier Mac mini avec M5 Pro. Moins cher que toute autre façon d'obtenir un M5 Pro, MacBook Pro compris. 24 Go de base pour 7B–14B ; configuré à 64 Go pour 30B. • Pour qui : premiers acheteurs d'Apple Silicon soucieux du budget. • Acheter sur l'Apple Store →
- 🥇 MEILLEUR RAPPORT POUR LE 70B : Mac Studio M5 Max 64 Go (3 499 $, disponible) • Pourquoi : exécute Llama 3.3 70B Q4 à environ 9–12 tokens/s estimés avec les 614 Go/s complets. Le refroidissement de bureau évite le bridage thermique. • Pour qui : développeurs standardisant un flux 70B sans besoin de portabilité. • Acheter sur l'Apple Store →
- 🔥 PUISSANCE MAXIMALE : Mac Studio M5 Ultra 96 Go (5 499 $, disponible) • Pourquoi : niveau haut de gamme. Jusqu'à 1,2 To/s de bande passante, le double du M5 Max. La configuration 512 Go arrive fin octobre 2026 pour les plus gros modèles locaux. • Statut : premières mesures indépendantes disponibles (MacStories : 48 tokens/s avec Qwen3.8 27B contre 59 sur une RTX 5090). • Acheter sur l'Apple Store →
- 💼 MEILLEUR PORTABLE : MacBook Pro 16" M5 Max (3 499 $ en 64 Go à 460 Go/s ; 4 499 $ en 128 Go à 614 Go/s) • Pourquoi : le même silicium M5 Max que le Mac Studio dans un portable à écran Liquid Retina XDR. Acceptez 10–15 % de vitesse soutenue en moins à cause du bridage thermique. • Alternative : le Mac Studio M5 Max 64 Go (3 499 $) coûte autant avec 614 Go/s et un meilleur refroidissement soutenu si la portabilité est inutile. • Acheter sur l'Apple Store →
Performances des LLM locaux : estimations dérivées de la bande passante et résultats indépendants du M5 Ultra
Seul le M5 Ultra dispose pour l'instant de mesures indépendantes de tiers (MacStories, en fin de section). Pour M5 Pro et M5 Max, les plages ci-dessous sont des estimations : chacune vaut 60–80 % du plafond de bande passante (bande passante ÷ taille du fichier du modèle), recoupée avec des retours de la communauté et des résultats du MacBook Pro ; ce ne sont pas des mesures de laboratoire sur les châssis Mac mini ou Mac Studio. Les plages sont étiquetées par bande passante car le MacBook Pro 64 Go (460 Go/s) et le Mac Studio 64 Go (614 Go/s) diffèrent. Prévoyez ±10–15 % selon la version de macOS, du moteur, la quantification et la longueur de contexte. Les valeurs de référence de la RTX 4090 sont des ordres de grandeur issus de la communauté.
- ## Llama 3.1 8B (Q4_K_M, ~4,9 Go) • M5 Pro (307 Go/s) : 38–50 tokens/s • M5 Max (460 Go/s) : 56–75 tokens/s • M5 Max (614 Go/s) : 75–100 tokens/s • Référence (RTX 4090) : 90–120 tokens/s
- ## Mistral Small 24B (Q4_K_M, ~14 Go) • M5 Pro (307 Go/s) : 13–17 tokens/s • M5 Max (460 Go/s) : 19–26 tokens/s • M5 Max (614 Go/s) : 26–34 tokens/s
- ## Qwen3 32B (Q4_K_M, ~20 Go) • M5 Pro (307 Go/s) : 9–12 tokens/s • M5 Max (460 Go/s) : 14–19 tokens/s • M5 Max (614 Go/s) : 19–25 tokens/s
- ## Llama 3.3 70B (Q4_K_M, ~42,5 Go) • M5 Pro 64 Go (307 Go/s) : 4–6 tokens/s • M5 Max (460 Go/s) : 6–9 tokens/s • M5 Max (614 Go/s) : 9–12 tokens/s • M5 Ultra : plafond d'environ 29 tokens/s (pas encore de mesure indépendante en 70B) • Référence (RTX 4090) : 6–10 tokens/s avec délestage partiel sur CPU
- ## Llama 3.3 70B (Q5_K_M, ~50 Go) • M5 Pro 64 Go : marge insuffisante • M5 Max 128 Go (614 Go/s) : 7–10 tokens/s • Référence (RTX 4090) : impossible (limite de VRAM)
- ## Llama 3.3 70B (Q8_0, ~75 Go) • M5 Max 128 Go (614 Go/s) : 5–7 tokens/s • RTX 4090 : impossible (nécessite un délestage multi-GPU)
- ## Résultats indépendants du M5 Ultra (MacStories, unité de 256 Go, oMLX) • Qwen3.8 27B, prompt de 6 091 tokens : M5 Ultra 48 tokens/s en génération, 1 701 tokens/s en lecture de prompt, 4,0 s avant le premier token — RTX 5090 : 59 tokens/s, 3 031 tokens/s, 2,0 s • Qwen3.8 27B en contexte long (génération) : 38,9 tokens/s à 64K, 32,4 à 128K, 24,3 à 256K — RTX 5090 : 49,6, 40,4, 30,0 • Flash-Next, prompt court : 108 tokens/s sur M5 Ultra contre 70 sur un M3 Ultra (+54 %)
- ## Méthodologie Les plages M5 Pro et M5 Max sont dérivées à 60–80 % de bande passante ÷ taille du fichier du modèle, puis comparées à des résultats communautaires comme le test MLX vs GGUF cité sur notre page de benchmarks M5 Pro vs M5 Max. Les chiffres du M5 Ultra sont les mesures propres de MacStories avec oMLX 0.7.0.dev2 sous macOS 27.0 ; les noms de modèles sont les leurs. Considérez tout chiffre de tokens/s du M5 Ultra pour des modèles non listés ci-dessus comme non vérifié.
Apple Silicon M5 vs station de travail PC pour le LLM local
Apple Silicon et NVIDIA sont deux philosophies différentes. Voici la comparaison honnête.
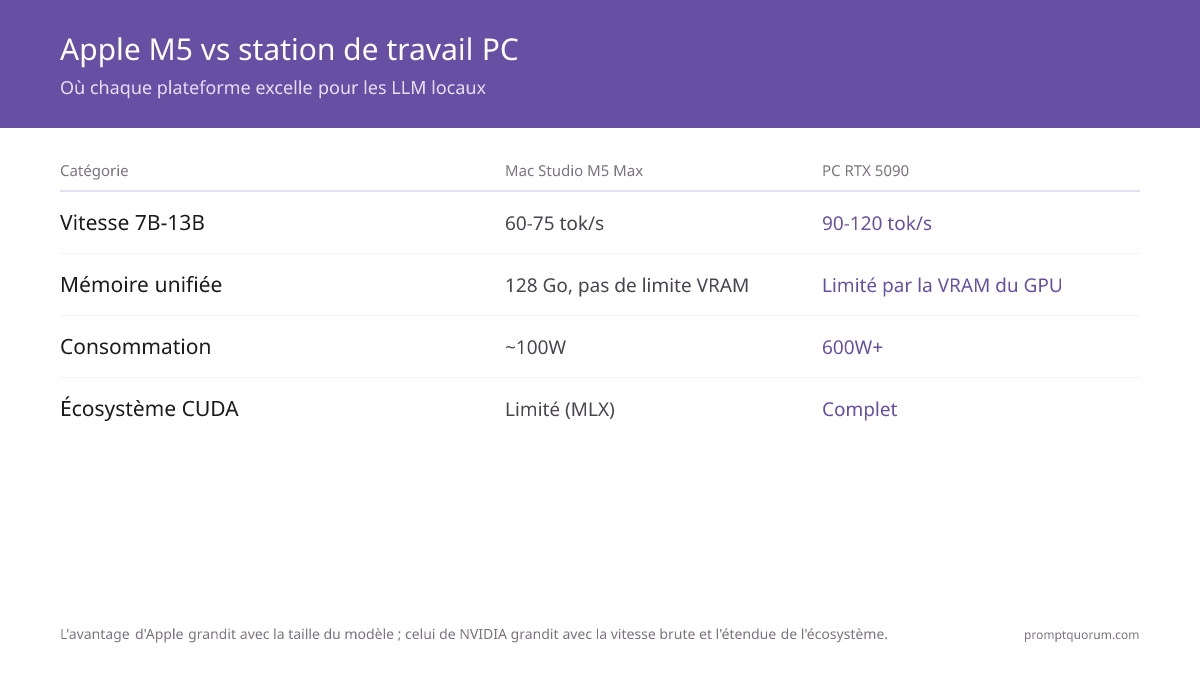
- ## Le Mac Studio M5 Max/Ultra l'emporte pour : • Mémoire unifiée : jusqu'à 128 Go (M5 Max) ou 512 Go (M5 Ultra) pour n'importe quel modèle, sans plafond VRAM • Efficacité énergétique : environ 100 W contre plus de 600 W pour un PC équivalent • Fonctionnement silencieux : ventilateurs rarement audibles sous charge typique • Écosystème macOS : intégration MLX, Metal, Core ML • Coût total de possession : électricité moindre sur 3 ans • Modèles de plus de 32 Go : une RTX 5090 plafonne à 32 Go de VRAM
- ## La station PC (RTX 4090/5090) l'emporte pour : • Vitesse brute sur les modèles tenant en VRAM : MacStories a mesuré une RTX 5090 à 59 tokens/s contre 48 sur M5 Ultra avec Qwen3.8 27B, et une lecture de prompt environ 1,8× plus rapide (3 031 contre 1 701 tokens/s) • Étendue de l'écosystème CUDA : plus de modèles, d'outils et de code de recherche • Fine-tuning : PyTorch + CUDA domine MLX • Évolutivité : changer de GPU, ajouter de la VRAM • Prix aux niveaux bas : une RTX 4070 Ti économique (800–1 200 $) bat le M5 Pro sur les petits modèles • IA hors LLM : Stable Diffusion, entraînement et multimodal sont généralement plus rapides sur NVIDIA
- ## Le verdict honnête Pour l'inférence LLM locale pure sur des modèles 30B–70B, le Mac Studio M5 Max 128 Go (5 099 $) rivalise directement avec des PC à plus de 4 500 $, et le Mac Studio M5 Ultra repousse le plafond vers des modèles qui demandent 256 Go ou 512 Go. L'avantage de la mémoire unifiée est réel et mesurable. Pour les modèles qui tiennent dans 24–32 Go de VRAM, un PC avec RTX 4090 ou 5090 est plus rapide que n'importe quel Mac. L'avantage d'Apple se réduit sur les petits modèles. Pour le fine-tuning, l'entraînement, Stable Diffusion à grande échelle ou PyTorch en production, PC + NVIDIA l'emporte. MLX progresse, mais des écarts subsistent.
MLX vs Ollama vs llama.cpp sur Apple Silicon
Trois principaux moteurs d'inférence fonctionnent sur M5. Lequel vous convient ?
- ## MLX (natif Apple) • Performance : généralement les tokens/s les plus élevés sur M5 ; optimisation Metal native et prise en charge des Neural Accelerators. • Modèles pris en charge : en croissance (Llama, Qwen, Mistral, Gemma disponibles) • Installation : orientée Python, demande de l'aisance en ligne de commande • Idéal pour : utilisateurs avancés cherchant la performance maximale • Compromis : moins convivial qu'Ollama
- ## Ollama (multiplateforme) • Performance : les modèles GGUF passent par le backend Metal de llama.cpp ; un backend MLX (préversion depuis Ollama 0.19, mars 2026) accélère certains modèles, surtout sur les puces M5 • Modèles pris en charge : la plus grande bibliothèque. De nouveaux modèles chaque semaine. • Installation : une seule commande, fonctionne immédiatement • Idéal pour : débutants et la plupart des développeurs. API REST pour l'intégration. • Compromis : peut être plus lent que MLX natif lorsqu'une version MLX du modèle existe (l'écart varie selon modèle et version)
- ## llama.cpp (multiplateforme, contrôle maximal) • Performance : compétitif avec Ollama une fois optimisé (Ollama l'utilise pour les modèles GGUF) • Personnalisation : le plus grand contrôle sur la quantification et les paramètres d'inférence • Installation : demande compilation et expertise en ligne de commande • Idéal pour : chercheurs, workflows de quantification personnalisés • Compromis : courbe d'apprentissage plus raide qu'Ollama
- ## Recommandation par profil • Débutants : Ollama (fonctionne immédiatement, documentation riche) • Développeurs : API REST d'Ollama (facile à intégrer dans des applications) • Utilisateurs avancés : MLX directement (performance maximale) • Chercheurs : llama.cpp (personnalisation maximale)
Guide de démarrage rapide macOS (10 étapes)
Le chemin le plus rapide pour exécuter votre premier LLM local 70B sur Apple Silicon.
- 1Achetez votre Mac
Why it matters: Mac mini M5 Pro pour le budget/l'entrée de gamme, Mac Studio M5 Max ou M5 Ultra pour la puissance de bureau, ou MacBook Pro 16" M5 Max pour la portabilité. - 2Configuration initiale de macOS
Why it matters: Utilisez l'Assistant de migration (transfert depuis un ancien Mac) ou une installation neuve. Gardez macOS à jour : Apple livre des améliorations de performance Metal dans les versions intermédiaires. - 3Installez Homebrew
Why it matters: /bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)" — gestionnaire de paquets pour tout le reste. - 4Installez Ollama
Why it matters: brew install ollama — installation simple en une commande. - 5Démarrez le service Ollama
Why it matters: ollama serve (s'exécute au premier plan) ou utilisez Ollama.app depuis le dossier Applications. - 6Téléchargez un premier modèle de test
Why it matters: ollama pull llama3.1:8b — vérifiez l'installation avec un petit modèle (téléchargement d'environ 4 Go). - 7Testez l'inférence de base
Why it matters: ollama run llama3.1:8b "Explain local LLMs in one sentence" --verbose — la ligne eval rate indique vos tokens/s. - 8Téléchargez le gros modèle visé
Why it matters: ollama pull llama3.1:70b-instruct-q4_K_M (téléchargement d'environ 40 Go). Comptez 20–40 min avec une bonne connexion ; un Mac de 64 Go ou plus est nécessaire. - 9Surveillez les performances
Why it matters: asitop affiche l'utilisation des ressources d'Apple Silicon. Dans un second terminal : brew install asitop && asitop. - 10Optionnel : installez LM Studio pour une interface graphique
Why it matters: Téléchargez-le sur lmstudio.ai. Plus simple que la ligne de commande pour les non-développeurs ; inclut un moteur MLX pour Apple Silicon.
Accélérer Ollama sur Apple Silicon M5
La plupart des installations d'Ollama sur Apple Silicon utilisent déjà la voie rapide par défaut ; la liste ci-dessous vise donc à supprimer ce qui ralentit discrètement, pas à proposer un réglage exotique.
📍 En une phrase
Vérifiez avec `ollama ps` que le modèle tourne à 100 % sur GPU, libérez de la mémoire unifiée, réduisez la longueur de contexte, utilisez une quantification Q4, activez flash attention et gardez le MacBook Pro branché et surélevé : la vitesse de génération est plafonnée par la bande passante, le plus grand gain consiste donc à choisir un modèle adapté.
💬 En termes simples
Ollama est généralement déjà rapide par défaut sur un Mac M5 : la plupart des problèmes de vitesse viennent d'autre chose qui occupe votre mémoire unifiée, d'un modèle trop gros pour votre bande passante ou d'un portable qui surchauffe, pas d'un réglage oublié.
- Adaptez d'abord le modèle à votre bande passante. Les tokens/s sont plafonnés près de bande passante ÷ taille du fichier du modèle (voir la section sur la bande passante plus haut). Un modèle 70B de 42 Go sur un M5 Pro à 307 Go/s ne dépassera pas environ 7 tokens/s quel que soit le réglage ; un modèle 32B de 20 Go atteint environ 15. Passer à un modèle ou une quantification plus petits est le plus gros gain possible.
- Vérifiez que le modèle est entièrement déchargé sur le GPU et ne retombe pas sur le CPU. Lancez `ollama ps` avec un modèle chargé : la colonne PROCESSOR doit afficher 100% GPU. Une répartition partielle avec le CPU signifie généralement que le modèle ne tient pas dans la mémoire que macOS autorise au GPU, pas qu'un réglage manque.
- Libérez la mémoire unifiée avant une longue session. La mémoire est partagée entre macOS et le modèle : un navigateur avec beaucoup d'onglets, Docker Desktop ou Xcode en arrière-plan peuvent retirer plusieurs Go à Ollama. Quittez-les avant de charger un gros modèle et vérifiez la mémoire disponible avec le Moniteur d'activité ou `asitop`. Pour les gros modèles, la limite mémoire du GPU peut être relevée avec `sudo sysctl iogpu.wired_limit_mb=<Mo>` (réinitialisée au redémarrage).
- Réduisez la fenêtre de contexte si vous n'en avez pas besoin. Définissez un `num_ctx` plus petit dans le Modelfile ou la requête API (p. ex. 4096 au lieu de 32K) pour les conversations courtes : cela réduit la pression mémoire du cache KV et accélère la génération.
- Activez flash attention et un cache KV quantifié. `OLLAMA_FLASH_ATTENTION=1` et `OLLAMA_KV_CACHE_TYPE=q8_0` réduisent la mémoire du cache KV et accélèrent les contextes longs pour une petite perte de qualité.
- Adaptez la quantification à vos besoins réels de qualité. Q4_K_M est nettement plus rapide que Q8_0 ou Q5_K_M pour une perte de qualité faible et généralement acceptable (voir le guide sur la quantification). Si un modèle tourne plus lentement que les benchmarks ci-dessus, essayez la variante Q4 avant d'incriminer le matériel.
- Gardez le MacBook Pro branché et surélevé pour une inférence soutenue. Le MacBook Pro peut brider de 10–15 % après 2–3 heures de charge continue, la chaleur s'accumulant dans le châssis plus fin. Un support améliorant la circulation d'air et le branchement secteur retardent le bridage. Pour des sessions de plus de quelques heures, le refroidissement du Mac Studio maintient la performance complète.
- Mettez à jour macOS et Ollama. Apple livre des améliorations Metal dans les versions intermédiaires et Ollama publie régulièrement des backends plus rapides, y compris la prise en charge MLX pour davantage de modèles. Une ancienne version sur du silicium M5 récent laisse de la performance de côté.
- Évitez d'exécuter plusieurs modèles simultanément sans nécessité. Chaque modèle chargé réserve sa part de mémoire unifiée. `OLLAMA_MAX_LOADED_MODELS` contrôle le nombre de modèles qu'Ollama garde résidents à la fois.
# Check whether a model is fully offloaded to GPU (PROCESSOR column)
ollama ps

# Measure real speed: the "eval rate" line is generation tokens/sec
ollama run llama3.1:8b --verbose

# Faster long-context inference: flash attention + 8-bit KV cache
OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 ollama serve

# Or limit Ollama to one resident model at a time
OLLAMA_MAX_LOADED_MODELS=1 ollama serve

# Smaller context window in a Modelfile: PARAMETER num_ctx 4096
Matrice de décision : quelle configuration de Mac acheter
Utilisez cette matrice pour trouver la meilleure correspondance selon votre usage. À mémoire égale, choisissez la bande passante la plus élevée.
- 1. Budget prioritaire, modèles plus petits acceptés (7–14B) : Mac mini M5 Pro 24 Go (1 699 $) — le M5 Pro le moins cher jamais proposé
- 2. Modèles 30B sur un bureau économique : Mac mini M5 Pro 64 Go (2 699 $)
- 3. Exécuter confortablement des modèles 70B : Mac Studio M5 Max 64 Go (3 499 $)
- 4. 70B Q5 avec fenêtres de contexte de 32K+ : Mac Studio M5 Max 128 Go (5 099 $)
- 5. 256–512 Go pour les plus gros modèles locaux : Mac Studio M5 Ultra (5 499–10 000+ $)
- 6. LLM local portable, bridage thermique accepté : MacBook Pro 16" M5 Max 64 Go (3 499 $)
- 7. Déjà dans l'écosystème macOS (Xcode, Final Cut Pro) : n'importe quelle variante de Mac Studio M5
- 8. Recherche/fine-tuning avec expériences MLX : Mac Studio M5 Max 128 Go ou M5 Ultra (marge mémoire)
- 9. Silence maximal et fonctionnement au repos : Mac Studio (ventilateurs rarement actifs en charge normale)
- 10. Budget de 4 000 $+, portabilité souhaitée : MacBook Pro 16" M5 Max 128 Go (4 499 $)
- 11. Alternatives à considérer : PC RTX 4090 (3 000 $+) ou mini PC AMD Ryzen AI Max+ (1 600–2 000 $)
Quand Apple Silicon M5 est un mauvais choix pour le LLM local
Apple Silicon est excellent mais pas universel. Évitez le Mac pour le LLM local dans ces cas.
- Vous avez besoin de flux exclusivement CUDA : l'essentiel de l'inférence LLM fonctionne sur Apple Silicon, mais le fine-tuning avec torch.cuda, les noyaux CUDA de vLLM et le code de recherche CUDA propriétaire ne tournent pas sur MLX. Si l'essentiel de votre travail est spécifique à CUDA, prenez un GPU RTX.
- Vous faites beaucoup de Stable Diffusion : les modèles de diffusion tournent généralement plus lentement sur M5 que sur une RTX 4090. Si la génération d'images pèse 30 % ou plus de votre flux, PC + RTX l'emporte.
- Le budget est la priorité absolue : un PC à 1 500 $ avec RTX 4070 Ti bat le Mac mini M5 Pro en vitesse sur petits modèles. Si seul le budget compte, le PC est moins cher.
- Vous avez besoin d'évolutivité : la RAM et le stockage du Mac Studio sont fixés à l'achat. Les PC permettent des mises à niveau progressives. Sur 5 ans et plus, le PC peut revenir moins cher.
- Vous exigez des tokens/s à trois chiffres sur petits modèles : la RTX 4090 atteint 90–120 tokens/s sur Llama 8B. Le M5 Max est estimé à 75–100. Pour un débit élevé (plusieurs utilisateurs), NVIDIA gagne encore.
- Vous n'utilisez pas déjà macOS : changer d'écosystème depuis Windows/Linux uniquement pour le LLM local ne vaut pas la peine, sauf si vous voulez aussi macOS pour d'autres raisons.
- Vous avez besoin d'inférence de production 24/7 : le Mac Studio est excellent mais conçu pour des pics d'usage. Pour une inférence continue sous SLA, les stations NVIDIA professionnelles sont plus sûres.
Questions fréquentes
Quelle est la bande passante mémoire des M5 Pro, M5 Max et M5 Ultra ?
Le M5 offre 153,6 Go/s, le M5 Pro 307 Go/s, le M5 Max 460 Go/s (GPU 32 cœurs) ou 614 Go/s (GPU 40 cœurs) et le M5 Ultra jusqu'à 1,2 To/s (1 228,8 Go/s). Pour la génération de LLM, la bande passante compte plus que le nombre de cœurs GPU, car chaque token lit une fois les poids du modèle en mémoire.
Combien de VRAM possède un Mac M5 ?
Aucune séparée : un Mac M5 dispose d'une mémoire unifiée partagée par le CPU et le GPU. Par défaut, macOS autorise le GPU à utiliser environ deux tiers à trois quarts de la RAM totale ; un Mac de 64 Go offre donc environ 48 Go à un modèle. Le M5 Pro monte à 64 Go, le M5 Max à 128 Go et le M5 Ultra à 512 Go.
Comment faire tourner Ollama plus vite sur un MacBook Pro M5 ?
Choisissez un modèle adapté à votre bande passante, confirmez avec `ollama ps` qu'il tourne à 100 % sur GPU, fermez les applications gourmandes en mémoire, réduisez `num_ctx` si vous n'avez pas besoin d'un long contexte, utilisez la quantification Q4_K_M plutôt que Q5/Q8, activez `OLLAMA_FLASH_ATTENTION=1` et gardez le MacBook Pro branché et surélevé pour les sessions de plus de 2–3 heures. Voir la section sur l'accélération plus haut pour la liste complète.
Le Mac Studio M5 Max peut-il exécuter Llama 3.3 70B ?
Oui, avec 64 Go ou 128 Go. Le 70B Q4 (~42,5 Go) demande 64 Go et tourne à environ 6–9 tokens/s estimés sur la puce à 460 Go/s et 9–12 tokens/s sur celle à 614 Go/s. Le 70B Q5 (~50 Go) demande la configuration de 128 Go et tourne à environ 7–10 tokens/s estimés.
Comment le M5 Max se compare-t-il à la RTX 4090 pour le LLM local ?
Le M5 Max est plus lent sur les petits modèles tenant dans 24 Go (environ 75–100 contre 90–120 tokens/s estimés avec Llama 8B). Sur les modèles 70B, la 4090 ne peut pas les contenir et passe par un délestage CPU à environ 6–10 tokens/s, tandis qu'un M5 Max à 614 Go/s les exécute à environ 9–12 tokens/s estimés pour un tiers de la consommation.
64 Go de RAM suffisent-ils ou me faut-il 128 Go ?
Pour un seul modèle 70B Q4 : 64 Go suffisent. Pour le 70B Q5 ou Q8, plusieurs modèles simultanés, de longs contextes ou du fine-tuning : 128 Go sont recommandés. La capacité mémoire ne change pas la vitesse : un Mac Studio M5 Max de 64 Go et de 128 Go offrent tous deux 614 Go/s.
Quelle différence entre M5 Pro et M5 Max pour le LLM ?
Le M5 Pro a un GPU 16/20 cœurs, 307 Go/s de bande passante et jusqu'à 64 Go. Le M5 Max a un GPU 32/40 cœurs, 460/614 Go/s et jusqu'à 128 Go. La vitesse de génération suivant la bande passante, le M5 Max est environ 1,5× (460 Go/s) à 2× (614 Go/s) plus rapide sur le même modèle. Le M5 Ultra (Mac Studio uniquement) va plus loin : jusqu'à un GPU 80 cœurs, jusqu'à 1,2 To/s et jusqu'à 512 Go.
Quelle est la vitesse du Mac Studio M5 Ultra pour les LLM locaux ?
MacStories a mesuré 48 tokens/s en génération avec Qwen3.8 27B sur un M5 Ultra de 256 Go (RTX 5090 : 59) et 108 tokens/s avec un modèle Flash-Next plus petit, soit environ 54 % de plus qu'un M3 Ultra. Le plafond de bande passante pour un modèle 70B Q4 est d'environ 29 tokens/s ; aucun résultat indépendant en 70B n'a encore été publié.
Le MacBook Pro bride-t-il thermiquement en inférence LLM soutenue ?
Oui, après 2–3 heures d'inférence continue, le MacBook Pro peut perdre 10–15 % de performance (estimation). Le Mac Studio maintient la performance complète 24/7.
Puis-je exécuter Stable Diffusion sur Apple Silicon ?
Oui, Stable Diffusion XL tourne sur M5 à environ 8–12 s/image (plus lent qu'une RTX 4070 à environ 3 s). MLX le prend en charge nativement.
MLX est-il plus rapide qu'Ollama sur Mac ?
En général, pour les modèles disposant d'une version MLX : MLX est typiquement plus rapide que les modèles GGUF sur llama.cpp, avec des écarts de 10 % à 2× rapportés selon modèle et version. Ollama a ajouté un backend MLX en mars 2026 qui réduit l'écart pour les modèles pris en charge. Choisissez selon votre flux de travail, pas selon la vitesse brute.
Quelle consommation électrique pour un Mac Studio M5 Max en inférence LLM ?
Estimée à 65–100 W soutenus pour le M5 Max sous charge LLM ; Apple indique jusqu'à 480 W de puissance continue maximale pour le châssis du Mac Studio, que l'inférence seule n'atteint pas. Un mois d'inférence 24/7 (720 heures) à 100 W représente ~72 kWh, soit environ 8–12 $ d'électricité aux États-Unis ; une configuration RTX 4090 coûte environ 40–60 $.
Le Mac mini propose-t-il maintenant le M5 Pro ?
Oui. Le Mac mini M5 Pro démarre à 1 699 $ (24 Go, jusqu'à 64 Go), 307 Go/s de bande passante, Thunderbolt 5, et est livré depuis le 22 septembre 2026 — le Mac M5 Pro le moins cher jamais proposé.
Le Mac Studio propose-t-il encore une configuration M5 Pro ?
Non. Depuis la mise à jour du 25 août 2026, le Mac Studio démarre au M5 Max (2 499 $). Le Mac mini est désormais la porte d'entrée vers la puce M5 Pro.
Qu'est-ce que le Mac Studio M5 Ultra et quelle mémoire prend-il en charge ?
Le M5 Ultra est une puce au-dessus du M5 Max, exclusive au Mac Studio, dès 5 499 $ (96 Go). Elle monte à 256 Go dès maintenant et 512 Go fin octobre 2026 (nettement au-dessus de 10 000 $ attendu), avec jusqu'à 1,2 To/s de bande passante.
Puis-je affiner des modèles sur Apple Silicon ?
Oui, le fine-tuning LoRA fonctionne bien. Le fine-tuning de tous les poids est plus lent que sur un GPU de bureau (pas encore de prise en charge de l'entraînement distribué).
Apple Silicon est-il bon pour l'inférence mais mauvais pour l'entraînement ?
En partie. L'inférence est excellente. L'entraînement/fine-tuning fonctionne mais plus lentement que sur NVIDIA. Le framework MLX progresse rapidement.
En quoi le Neural Engine aide-t-il pour les LLM ?
La génération de tokens est limitée par la bande passante mémoire, pas par le Neural Engine. Sur les puces de la famille M5, les accélérateurs neuronaux de chaque cœur GPU accélèrent le traitement du prompt (délai avant le premier token) dans les moteurs qui les exploitent, comme MLX et le backend MLX d'Ollama.
Puis-je exécuter plusieurs modèles simultanément sur un M5 Max 128 Go ?
Oui. 128 Go permettent deux modèles 32B, ou un 70B plus un 14B, en parallèle à une vitesse correcte.
Quel est le temps de mise en place d'un LLM local sur Mac ?
15–30 minutes depuis un Mac neuf jusqu'au premier modèle 70B via Ollama (téléchargement de 20–40 min sur une connexion rapide inclus).
Apple Silicon fonctionne-t-il avec les derniers modèles à poids ouverts ?
La plupart des familles à poids ouverts — Llama, Qwen, Mistral, Gemma, DeepSeek — fonctionnent via llama.cpp (GGUF) ou MLX dans les jours suivant leur sortie. Consultez la communauté MLX sur Hugging Face et la bibliothèque Ollama pour la liste à jour.
Dois-je acheter le Mac mini M6 ou le Mac mini M5 Pro pour le LLM local ?
Le M6 est le Mac mini d'entrée de gamme (899 $, 16–32 Go, environ 153–170 Go/s) adapté aux petits modèles. Le M5 Pro (1 699 $, jusqu'à 64 Go, 307 Go/s) offre environ le double de bande passante et de mémoire : c'est le choix pour le LLM local.
Un Mac Studio reconditionné vaut-il le coup ?
Oui. Apple vend des Mac reconditionnés avec un an de garantie, généralement avec une remise par rapport au prix du neuf.
Vaut-il mieux prendre le M5 Max en 64 Go ou en 128 Go ?
Prenez 64 Go pour un seul modèle 70B Q4 et les modèles 32B ; 128 Go pour le 70B Q5/Q8, les longs contextes ou plusieurs modèles à la fois. Vérifiez aussi le niveau de GPU : sur le MacBook Pro, 64 Go viennent avec la puce à 460 Go/s et 128 Go avec celle à 614 Go/s.