重要なポイント
- ✅ チップ別の帯域幅: M5 153.6GB/s · M5 Pro 307GB/s · M5 Max 460GB/s(32コアGPU)または614GB/s(40コアGPU) · M5 Ultra 最大1.2TB/s。生成速度はおおよそ「帯域幅 ÷ モデルサイズ × 60〜80%」です。以下の帯域幅セクションをご覧ください。
- ✅ 2026年9月22日から出荷中:Mac mini M5 Proは1,699ドルから(最大64GB、307GB/s)。MacBook Proより安い、史上最安のM5 Pro搭載Macです。
- ✅ Mac Studio M5 Max(2,499ドル〜、最大128GB、614GB/s)とMac Studio M5 Ultra(5,499ドル〜、最大512GB、最大1.2TB/s)は出荷中です。512GB構成のM5 Ultraは2026年10月下旬に出荷され、10,000ドルを大きく上回る見込みです。
- Mac StudioにはM5 Pro構成がなくなり、M5 Maxからの開始になりました。M5 ProチップのMacへの入り口はMac miniです。
- MacBook Pro 16インチ M5 Max(2026年3月から販売中)は、同じGPU構成であればMac Studio M5 Maxとメモリ帯域幅が同じです:460GB/s(32コアGPU)と614GB/s(40コアGPU)。筐体による帯域幅の不利はありません。
- M5 Pro/Maxの全構成:メモリ帯域幅307〜614GB/s(RTX 4090は1,008GB/sだがVRAMは24GBまで)。M5 Ultraは最大1.2TB/sに達します。
- 静音性:MacBook Proは持続的な推論でファンが聞こえるようになります。Mac StudioとMac miniは典型的なローカルLLM負荷ではファンがほとんど回りません。
- MLXはApple Silicon上で通常最速のランタイムです。OllamaはMLXバックエンドを2026年3月に追加しました(プレビュー、Ollama 0.19、当初は32GB超のMac上の一部モデル向け)。その他のモデルはllama.cppのMetalバックエンドで動作します。
- ユニファイドメモリ:24GB(Mac mini M5 Pro基本構成)から512GB(Mac Studio M5 Ultra)まで、どのモデルにも利用可能。ディスクリートGPUのような専用VRAM上限はありません。
📍 一文で説明
M5 Proは307GB/s、M5 Maxは460〜614GB/s、M5 Ultraは最大1.2TB/sのメモリ帯域幅を持ち、Macが1秒に生成するトークン数を決めるのはコア数ではなくこの数値です。Mac mini M5 Proは1,699ドル、Mac Studio M5 Maxは2,499ドル、Mac Studio M5 Ultraは5,499ドルから。
💬 簡潔に説明
Apple SiliconのMacはユニファイドメモリを採用し、CPU・GPU・AIエンジンが同じ高速メモリを共有します。そのため128GBのM5 Maxは、消費者向けNVIDIA GPU(VRAM 24〜32GB)では載らない70Bモデルをまるごと読み込めます。M5 Ultraの512GBオプションはさらにその先に進みます。
🔄 2026年10月11日の更新:2026年9月22日の出荷日を過ぎ、Mac mini M5 Pro、Mac Studio M5 Max、Mac Studio M5 Ultra(96〜256GB)が購入可能になりました。512GB構成のM5 Ultraのみ未出荷です(2026年10月下旬)。今回の更新では、メモリ帯域幅のセクションを追加し、各チップの帯域幅上限を超えていたトークン/秒の範囲を差し替え、MacStoriesのレビューによる初の独立したM5 Ultra実測値を加えました。Mac mini M5 ProとMac Studio M5 Maxのトークン/秒は、帯域幅とMacBook Proの結果から導いた推定値であり、それらの筐体での実測ではありません。
ローカルLLMにApple Silicon M5が重要な理由
Apple SiliconはAIワークロードに対してまったく異なるアーキテクチャです。ローカルLLMユーザーにとって重要な理由は次のとおりです。
- ユニファイドメモリアーキテクチャ: M5 ProとM5 Maxは、CPU・GPU・Neural Engineが同時にアクセスできる単一の高速メモリプール(24〜128GB)を共有します。VRAMとRAMのボトルネックはなく、モデルは高速メモリに載ったまま応答性を保ちます。
- 真のボトルネックはメモリ帯域幅: LLMの生成は演算ではなくメモリに律速され、トークンを1つ生成するたびにモデルの重みを1回読み込みます。M5 Maxの460〜614GB/sは、小型モデルではRTX 4090の1,008GB/sに及びませんが、24GBに対して最大128GBを扱えるため、4090に載らないモデルも動かせます。M5 Ultraは最大1.2TB/sで4090を上回り、最大512GBを扱えます。
- MacでのVRAMはユニファイドメモリ: 専用のVRAMプールはありません。GPUはmacOSと同じメモリを使い、既定ではGPUが固定できるのはRAM全体のおよそ3分の2〜4分の3です(RAM容量により異なります)。64GBのMacではモデルとコンテキストに約48GBを見込んでください。上限は`sudo sysctl iogpu.wired_limit_mb=<MB>`で引き上げられます(再起動でリセット)。
- Apple Fusion Architecture(M5の新機能): M5 ProとM5 Maxは、CPUとGPUを1パッケージ内の別々の3nmダイに分離し、独立したスケーリングと熱設計を可能にします。モノリシックなチップより電力効率が良く、廃熱も抑えられます。
- 全GPUコアにニューラルアクセラレータ: 各GPUコアにAI処理向けのニューラルアクセラレータが入り、共有のNeural Engineを補完します。MLXやOllamaのMLXバックエンドなど、これを利用するランタイムではM5系チップでプロンプト処理が速くなります。
- M4からの世代間向上: AppleはM4 Pro/M4 Max比でマルチスレッドCPU性能が最大30%向上としています。LLM生成で重要なのは帯域幅で、M5 Pro 307GB/s対M4 Pro 273GB/s(+12%)、最上位のM5 Max 614GB/s対M4 Max 546GB/s(+12%)です。コアごとのニューラルアクセラレータにより、プロンプト処理の向上幅はさらに大きくなります。
- Thunderbolt 5(M5 Pro/Max): M5 ProとM5 MaxはThunderbolt 5(基本80Gbps、Thunderbolt 4の2倍)を搭載し、高速な外部ストレージやマルチディスプレイに対応します。
- Apple N1チップによるWi-Fi 7とBluetooth 6: M5システムは新しいN1ワイヤレスチップでWi-Fi 7とBluetooth 6.0に対応します。リモート推論クライアントやクラウドモデルAPI利用時の応答性が向上します。
- MLXフレームワークは急速に成熟: AppleのMLXフレームワークは、最適化カーネルでLlama 3.3、Qwen、Mistral、Gemmaに対応します。OllamaはApple Silicon向けMLXバックエンドを2026年3月から提供しています(プレビュー、当初は一部モデルに限定)。
- 電力効率は本物: M5 Maxの持続的推論時の消費電力は約65〜100Wと推定されます(Apple公表値ではなく推定)。AppleはMac Studio筐体の最大連続消費電力を480Wとしています。1か月の連続推論(720時間)を100Wで行うと約72kWhで、米国の電気代でおよそ8〜12ドルです。350WのRTX 4090では同じ期間で約40〜60ドルです。
- 静かな動作: Mac Studioのファンは典型的なLLM負荷ではほとんど聞こえません。MacStoriesはM5 Ultra搭載Mac Studioのファン音を日常利用で聞き取れなかったと報告しています。MacBook Proのファンは持続的な推論で聞こえるようになります。
Apple Silicon M5 比較表
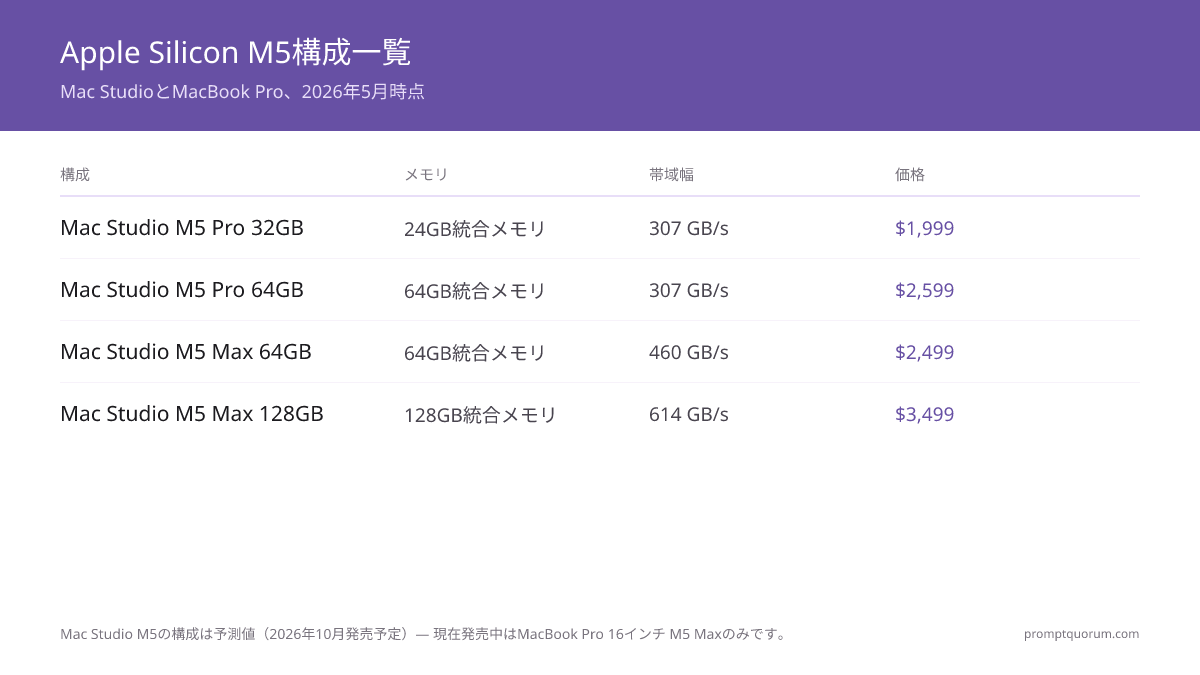
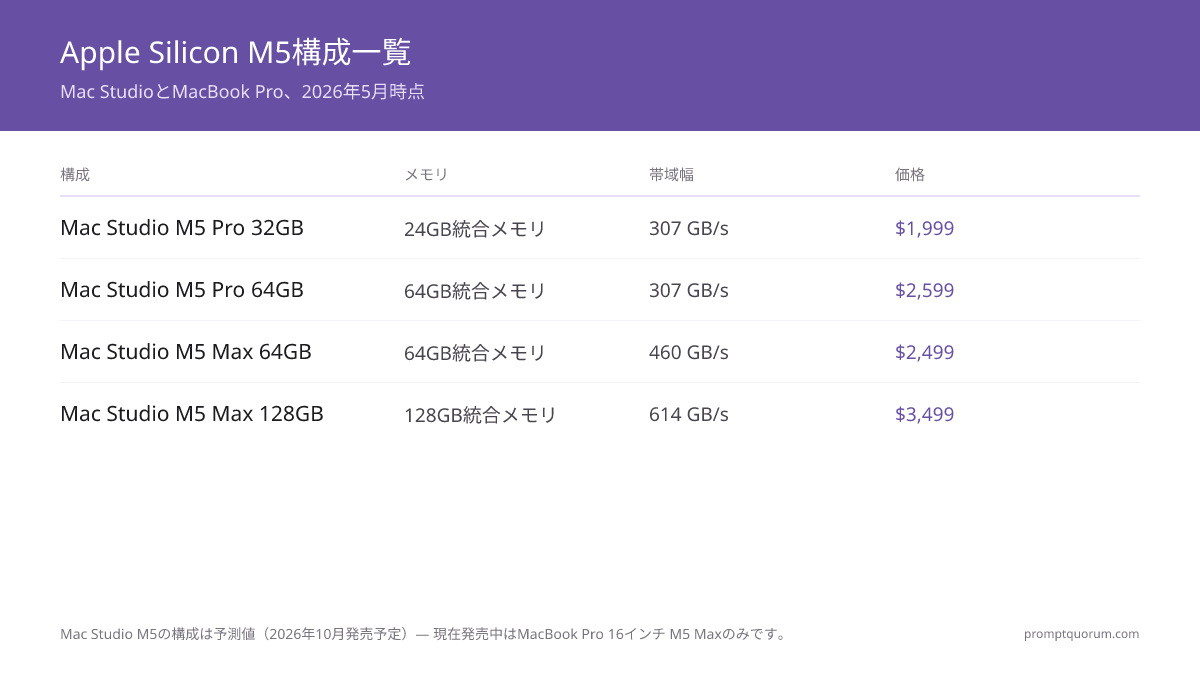
以下の構成は2026年8月25日の発表時のAppleの販売価格です。Mac mini・Mac Studio・MacBook Proは2026年9月22日から出荷中です(Mac Studio M5 Ultra 512GBは2026年10月下旬、10,000ドルを大きく上回る見込み)。価格:Apple Storeの米ドル価格。現時点で独立したトークン/秒の実測があるのはM5 Ultraのみです。実測と推定の区別は性能セクションをご覧ください。
構成 | チップ | GPUコア | メモリ | 帯域幅 | 価格 | 向いている用途 |
|---|---|---|---|---|---|---|
| Mac mini M5 Pro 24GB | M5 Pro | 16 | 24GB ユニファイド | 307 GB/s | $1,699 | 最安M5 Pro、7B〜14B |
| Mac mini M5 Pro 64GB | M5 Pro | 20 | 64GB ユニファイド | 307 GB/s | $2,699 | 30Bモデル、最安64GB |
| Mac Studio M5 Max 36GB | M5 Max | 32 | 36GB ユニファイド | 460 GB/s | $2,499 | 低価格デスクトップ入門 |
| Mac Studio M5 Max 64GB | M5 Max | 40 | 64GB ユニファイド | 614 GB/s | $3,499 | 70B Q4、コスパ最良 |
| Mac Studio M5 Max 128GB | M5 Max | 40 | 128GB ユニファイド | 614 GB/s | $5,099 | 70B Q5、パワーユーザー |
| Mac Studio M5 Ultra 96GB | M5 Ultra | 64 | 96GB ユニファイド | 最大1.2 TB/s | $5,499 | 最大級のローカルモデル |
| Mac Studio M5 Ultra 512GB | M5 Ultra | 80 | 512GB ユニファイド | 最大1.2 TB/s | $10,000+(推定) | 巨大モデル、10月下旬出荷 |
| MacBook Pro 16" M5 Max 64GB | M5 Max | 32 | 64GB ユニファイド | 460 GB/s | $3,499 | 携帯可能、70B Q4 |
| MacBook Pro 16" M5 Max 128GB | M5 Max | 40 | 128GB ユニファイド | 614 GB/s | $4,499 | 携帯可能、70B Q5 |
M5・M5 Pro・M5 Max・M5 Ultraのメモリ帯域幅比較
メモリ帯域幅は、Apple SiliconでのローカルLLM生成速度を決める仕様であり、多くの購入者が検索する数値です。表は各チップの公式値を示します。M5 Maxには2段階あり、32コアGPU版が460GB/s、40コアGPU版が614GB/sです。数値は理論上の最大値です。
📍 一文で説明
Apple M5のメモリ帯域幅は、M5が153.6GB/s、M5 Proが307GB/s、M5 Max(32コアGPU)が460GB/s、M5 Max(40コアGPU)が614GB/s、M5 Ultraが最大1.2TB/sです。
💬 簡潔に説明
帯域幅は、チップがメモリからモデルを読み出す速さです。1トークンの生成にはモデル全体をほぼ1回読み込むため、Macの生成速度は「帯域幅 ÷ モデルサイズ」を超えられません。
- M5 Pro vs M5 Max: M5 MaxはM5 Proの1.5倍(32コアGPU、460GB/s)または2倍(40コアGPU、614GB/s)の帯域幅を持つため、同じモデルでその分だけ生成が速くなります。
- M5 Max vs M5 Ultra: M5 Ultraは2つのM5 Maxを接続し、40コアGPU版M5 Maxの614GB/sを約1.2TB/sに倍増させます。前世代M3 Ultraの819GB/sより50%高い値です。
- 容量と帯域幅: メモリが増えてもチップは速くなりません。40コアGPUのM5 Maxは64GBでも128GBでも同じ614GB/sです。メモリ増量で可能になるのは、より大きなモデルや複数モデルの読み込みだけです。
チップ | GPUコア | 最大メモリ | 帯域幅 | 搭載製品 |
|---|---|---|---|---|
| M5 | 8–10 | 32GB | 153.6 GB/s | MacBook Air、14" MacBook Pro |
| M5 Pro | 16–20 | 64GB | 307 GB/s | MacBook Pro、Mac mini |
| M5 Max(32コアGPU) | 32 | 36GB+ | 460 GB/s | MacBook Pro、Mac Studio |
| M5 Max(40コアGPU) | 40 | 128GB | 614 GB/s | MacBook Pro、Mac Studio |
| M5 Ultra | 64–80 | 512GB | 1.2 TB/s (1,228.8 GB/s) | Mac Studio |
| M4 Max(参考) | 40 | 128GB | 546 GB/s | 前世代 |
| RTX 4090(参考) | 該当なし | 24GB VRAM | 1,008 GB/s | ディスクリートGPU |
帯域幅からトークン/秒へ
下の表はベンチマークではなく算術です。上限トークン/秒 = 帯域幅 ÷ モデルのファイルサイズ。実際の生成はKVキャッシュの読み込み、ランタイムのオーバーヘッド、熱の影響でこれより低くなります。Mixture-of-Expertsモデルはトークンごとにアクティブなエキスパートだけを読むため、同じファイルサイズの密モデルより速く動くことがあります。
📍 一文で説明
生成速度の上限は、メモリ帯域幅をモデルのファイルサイズで割った値です。たとえば614GB/s ÷ 42.5GB(Llama 3.3 70B Q4)≈ 14トークン/秒で、よく最適化されたランタイムは通常その約60〜80%に達します。
💬 簡潔に説明
動かしたい最大のモデルでチップを選び、この上限表を確認してください。上限が10トークン/秒を下回るなら、GPUコアをいくら増やしてもモデルは遅く感じます。
- 表の読み方: 数値は理論上のトークン/秒の上限です。現実的な範囲は0.6〜0.8を掛けてください。614GB/sのM5 MaxでのLlama 3.3 70B Q4なら、およそ9〜12トークン/秒です。
- 独立した検証:MacStoriesは、M5 Ultra搭載Mac StudioでQwen3.8 27Bの生成を48トークン/秒(6,091トークンのプロンプト)と計測しました。RTX 5090(帯域幅1.79TB/s)は59トークン/秒です。実際の速度はコア数ではなく帯域幅に沿っていました。
- サイズの目安: モデルファイルとKVキャッシュはユニファイドメモリの約3分の2〜4分の3に収まる必要があります。70B Q4モデル(約42.5GB)には64GBのMacが必要で、Q5・Q8には128GBが必要です。
モデル(Q4_K_M) | ファイルサイズ | M5 Pro 307 | M5 Max 460 | M5 Max 614 | M5 Ultra 1.2TB/s |
|---|---|---|---|---|---|
| Llama 3.1 8B | ~4.9GB | ~63 | ~94 | ~125 | ~250 |
| Mistral Small 24B | ~14GB | ~22 | ~33 | ~44 | ~88 |
| Qwen3 32B | ~20GB | ~15 | ~23 | ~31 | ~61 |
| Llama 3.3 70B | ~42.5GB | ~7 | ~11 | ~14 | ~29 |
Mac mini M5 Pro:ローカルLLM向けの新しい低価格の入り口
Appleは2026年8月25日、Mac miniに初めてM5 Proチップを搭載しました。それまでM5 ProはMacBook Proにしかありませんでした。24〜64GBのユニファイドメモリで1,699〜2,699ドルのMac mini M5 Proは、M5 Proの64GB上限に到達する最も安い方法で、MacBook Pro M5 Proより安価です。Mac StudioはM5 Maxからの開始になりました。2026年9月22日から出荷中です。
- CPU: 15コアまたは18コアのM5 Pro
- GPU: 16コアまたは20コアのM5 Pro GPU
- メモリ: 基本24GB、48GBまたは64GBのLPDDR5Xユニファイドメモリに変更可能
- メモリ帯域幅: 307GB/s(MacBook ProのM5 Proと同一)
- ストレージ: 512GB〜2TB SSD(変更可能)
- ポート: Thunderbolt 5(Mac miniでは新規)
- 接続: Wi-Fi 7、Bluetooth 6
- 価格: 1,699ドル(15コアCPU/16コアGPU、24GB)、2,699ドル(18コアCPU/20コアGPU、64GB)
- 提供状況: 2026年9月22日から出荷中
Mac Studio M5 Max 36GB:基本構成
基本のMac Studio M5 Maxは32コアGPUと36GBユニファイドメモリで2,499ドルから。より大きなメモリは下記の40コアGPU構成で選べます。2026年9月22日から出荷中。Mac StudioにはM5 Pro構成が一切なくなり、これが最も安いMac Studioです。
- CPU: 18コアM5 Max
- GPU: 32コアM5 Max GPU
- メモリ: このGPU構成では36GBのLPDDR5Xユニファイドメモリ
- メモリ帯域幅: 460GB/s(MacBook Proの32コアM5 Maxと同一)
- ストレージ: 512GB〜8TB SSD(変更可能)
- ポート: Thunderbolt 5
- 消費電力: 持続的推論で推定65〜100W、ファンはほとんど回りません
- 価格: 2,499ドル
- 提供状況: 2026年9月22日から出荷中
Mac Studio M5 Max 48〜128GB:70Bローカル運用で最高のコスパ
40コアGPUのMac Studio M5 Maxは3,099ドル(48GB)から、最大128GBで5,099ドルまで構成できます。「70Bに最高のコスパ」を実現するのはこの構成です。64GBは3,499ドルで、帯域幅は614GB/sをフルに活かせます。2026年9月22日から出荷中。
- CPU: 18コアM5 Max
- GPU: 40コアM5 Max GPU
- メモリ: 基本48GB、64GBまたは128GBのLPDDR5Xユニファイドメモリに変更可能
- メモリ帯域幅: 614GB/s(MacBook Proの40コアM5 Maxと同一)
- ストレージ: 512GB〜8TB SSD
- ポート: Thunderbolt 5
- 消費電力: 持続的推論で推定65〜100W、複数モデルの高負荷時はファンが適度に回ります
- 価格: 3,099ドル(48GB)、3,499ドル(64GB)、5,099ドル(128GB)
- 提供状況: 2026年9月22日から出荷中
Mac Studio M5 Ultra:新しい最大性能の階層
Mac Studio M5 UltraはM5 Maxの上に新設された最上位で、96GB構成の5,499ドルから最大512GBまで拡張できます。96〜256GB構成は2026年9月22日から出荷中で、512GB構成は2026年10月下旬に出荷され、10,000ドルを大きく上回る見込みです。前世代M3 Ultraと同じ512GBの上限を、50%高い帯域幅で実現します。
- CPU: 30コアM5 Ultra(36コアに変更可能)
- GPU: 基本64コア、80コアに変更可能
- メモリ: 基本96GB、現在は256GBまで、512GBは2026年10月下旬
- メモリ帯域幅: 最大1.2TB/s(1,228.8GB/s。M3 Ultraの819GB/sより50%高い)
- ストレージ: 1TB〜16TB SSD
- ポート: Thunderbolt 5
- 価格: 5,499ドル(基本96GB:30コアCPU/64コアGPU)、512GBは10,000ドルを大きく上回る見込み
- 提供状況: 2026年9月22日から出荷中(96〜256GB)、2026年10月下旬(512GB)
MacBook Pro 16インチ M5 Max:持ち運べるローカルLLM
MacBook Pro 16インチ M5 Max(3,499〜4,499ドル)は、Mac Studioと同じM5 Maxシリコンを携帯可能な形で提供します。メモリ帯域幅は各GPU構成でMac Studioと一致し、32コアGPUで460GB/s、40コアGPUで614GB/sです。ただし64GBのMacBook Proは32コアGPU、64GBのMac Studioは40コアGPUである点に注意してください。携帯性の代償は、持続的な推論時のサーマルスロットリングです。
- CPU: 18コアM5 Max(スーパー6+パフォーマンス12コア)
- GPU: 32コアまたは40コアのM5 Max GPU
- メモリ: 64GBまたは128GBのユニファイドメモリ
- ディスプレイ: 16.2インチLiquid Retina XDR、3456×2234
- メモリ帯域幅: 460GB/s(64GB、32コアGPU)または614GB/s(128GB、40コアGPU)
- ストレージ: 512GB〜8TB SSD
- バッテリー: ビデオ再生時間で表記。持続的な推論では大幅に早く減ります
- 重量: 2.14kg
- ポート: Thunderbolt 5×3、HDMI 2.1、SDカードスロット、ヘッドフォンジャック
- 価格: 3,499ドル(64GB、32コアGPU)〜4,499ドル(128GB、40コアGPU)
🏆 おすすめ:ローカルLLM向けにどのMacを買うか
用途別に、選択肢をはっきり整理します。
- 🏆 💰 最安のM5 Pro:Mac mini M5 Pro(1,699ドル、出荷中) • 理由:初のM5 Pro搭載Mac mini。MacBook Proを含むどの手段よりも安くM5 Proを入手できます。24GBの基本構成は7B〜14B向け、64GBにすれば30B向けです。 • 対象:予算重視で初めてApple Siliconを買う方。 • Apple Storeで購入 →
- 🥇 70B向け最高のコスパ:Mac Studio M5 Max 64GB(3,499ドル、出荷中) • 理由:614GB/sをフルに活かし、Llama 3.3 70B Q4を推定約9〜12トークン/秒で実行します。デスクトップ冷却のためサーマルスロットリングがありません。 • 対象:携帯性が不要で、70Bのワークフローに標準化したい開発者。 • Apple Storeで購入 →
- 🔥 最大パワー:Mac Studio M5 Ultra 96GB(5,499ドル、出荷中) • 理由:最上位。帯域幅は最大1.2TB/sでM5 Maxの2倍。512GB構成は2026年10月下旬に出荷され、最大級のローカルモデルに対応します。 • 状況:初の独立実測が公開されています(MacStories:Qwen3.8 27Bで48トークン/秒、RTX 5090は59)。 • Apple Storeで購入 →
- 💼 最高の携帯性:MacBook Pro 16インチ M5 Max(64GB・460GB/sで3,499ドル、128GB・614GB/sで4,499ドル) • 理由:Mac Studioと同じM5 MaxシリコンをLiquid Retina XDRディスプレイ搭載のノートで。サーマルスロットリングによる持続速度の10〜15%低下は許容してください。 • 代替:携帯性が不要なら、同価格のMac Studio M5 Max 64GB(3,499ドル)は614GB/sで持続冷却にも優れます。 • Apple Storeで購入 →
ローカルLLMの性能:帯域幅からの推定値とM5 Ultraの独立実測
独立した第三者の実測があるのは現時点でM5 Ultraのみです(MacStories、本セクション末尾)。M5 ProとM5 Maxの範囲は推定値で、帯域幅上限(帯域幅 ÷ モデルファイルサイズ)の60〜80%を、コミュニティの報告とMacBook Proの結果で検証したものです。Mac miniやMac Studio筐体での実験室測定ではありません。64GBのMacBook Pro(460GB/s)と64GBのMac Studio(614GB/s)は異なるため、範囲はメモリ帯域幅で区別しています。macOSやランタイムのバージョン、量子化、コンテキスト長により±10〜15%の変動があります。RTX 4090の参考値はコミュニティの概算です。
- ## Llama 3.1 8B(Q4_K_M、約4.9GB) • M5 Pro(307GB/s):38〜50トークン/秒 • M5 Max(460GB/s):56〜75トークン/秒 • M5 Max(614GB/s):75〜100トークン/秒 • 参考(RTX 4090):90〜120トークン/秒
- ## Mistral Small 24B(Q4_K_M、約14GB) • M5 Pro(307GB/s):13〜17トークン/秒 • M5 Max(460GB/s):19〜26トークン/秒 • M5 Max(614GB/s):26〜34トークン/秒
- ## Qwen3 32B(Q4_K_M、約20GB) • M5 Pro(307GB/s):9〜12トークン/秒 • M5 Max(460GB/s):14〜19トークン/秒 • M5 Max(614GB/s):19〜25トークン/秒
- ## Llama 3.3 70B(Q4_K_M、約42.5GB) • M5 Pro 64GB(307GB/s):4〜6トークン/秒 • M5 Max(460GB/s):6〜9トークン/秒 • M5 Max(614GB/s):9〜12トークン/秒 • M5 Ultra:上限は約29トークン/秒(70Bの独立実測はまだありません) • 参考(RTX 4090):CPUへの部分オフロードで6〜10トークン/秒
- ## Llama 3.3 70B(Q5_K_M、約50GB) • M5 Pro 64GB:余裕不足 • M5 Max 128GB(614GB/s):7〜10トークン/秒 • 参考(RTX 4090):不可(VRAM上限)
- ## Llama 3.3 70B(Q8_0、約75GB) • M5 Max 128GB(614GB/s):5〜7トークン/秒 • RTX 4090:不可(マルチGPUオフロードが必要)
- ## M5 Ultraの独立実測結果(MacStories、256GB機、oMLX) • Qwen3.8 27B、6,091トークンのプロンプト:M5 Ultraは生成48トークン/秒、プロンプト読み込み1,701トークン/秒、最初のトークンまで4.0秒。RTX 5090は59トークン/秒、3,031トークン/秒、2.0秒 • Qwen3.8 27Bの長いコンテキスト(生成):64Kで38.9、128Kで32.4、256Kで24.3トークン/秒。RTX 5090は49.6、40.4、30.0 • Flash-Next、短いプロンプト:M5 Ultraは108トークン/秒、M3 Ultraは70(+54%)
- ## 手法 M5 ProとM5 Maxの範囲は、帯域幅 ÷ モデルファイルサイズの60〜80%として導き、当サイトのM5 Pro vs M5 Maxベンチマークページで引用しているMLXとGGUFの比較テストなどコミュニティの結果と照合しています。M5 Ultraの数値はMacStoriesがmacOS 27.0上のoMLX 0.7.0.dev2で行った実測で、モデル名も同誌のものです。上記以外のモデルのM5 Ultraのトークン/秒は未検証として扱ってください。
Apple Silicon M5 vs PCワークステーション(ローカルLLM)
Apple SiliconとNVIDIAは設計思想が異なります。率直に比較します。
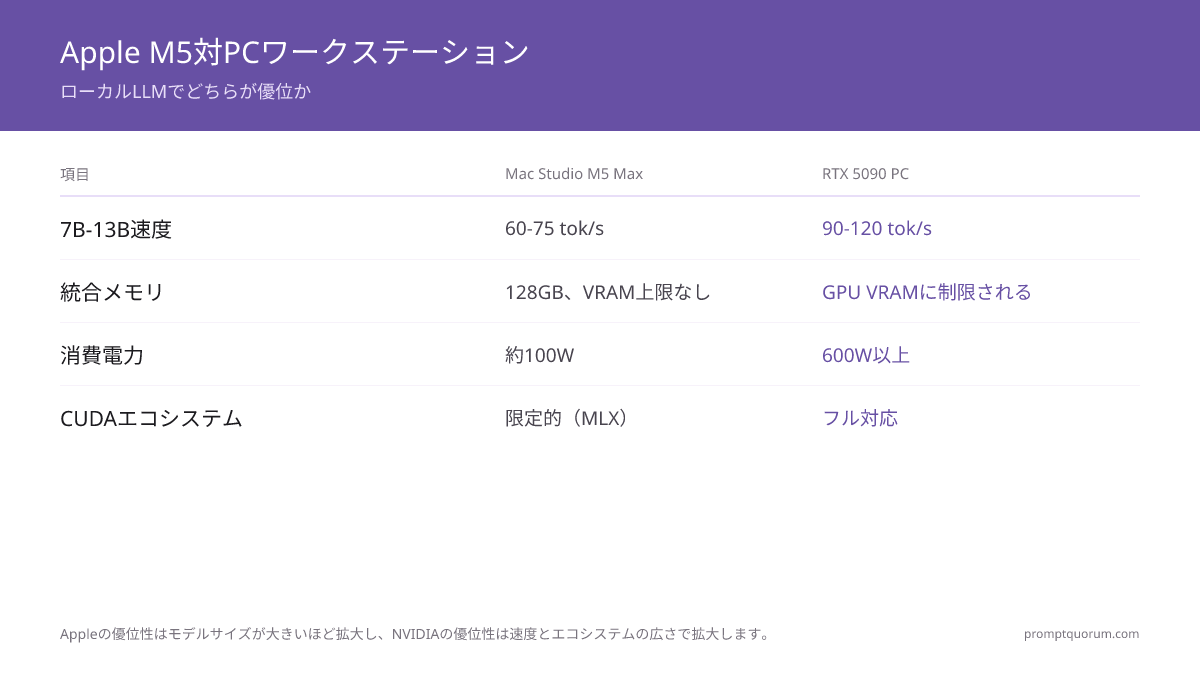
- ## Mac Studio M5 Max/Ultraが優れる点: • ユニファイドメモリ:最大128GB(M5 Max)または512GB(M5 Ultra)をどのモデルにも利用可能、VRAM上限なし • 電力効率:同等のPCが600W超に対し、約100W • 静音性:典型的な負荷ではファンがほとんど聞こえません • macOSエコシステム:MLX、Metal、Core MLとの統合 • 総所有コスト:3年間で電気代が少なくて済みます • 32GB超のモデル:RTX 5090のVRAMは最大32GBです
- ## PCワークステーション(RTX 4090/5090)が優れる点: • VRAMに収まるモデルの生のスピード:MacStoriesの計測では、Qwen3.8 27BでRTX 5090が59トークン/秒、M5 Ultraが48トークン/秒、プロンプト読み込みは約1.8倍高速(3,031対1,701トークン/秒) • CUDAエコシステムの広さ:モデル・ツール・研究コードが豊富 • ファインチューニング:PyTorch+CUDAがMLXを上回ります • 拡張性:GPUの交換やVRAMの追加が可能 • 低価格帯:安価なRTX 4070 Ti(800〜1,200ドル)は小型モデルでM5 Proを上回ります • LLM以外のAI:Stable Diffusion、学習、マルチモーダルは一般にNVIDIAが速い
- ## 率直な結論 30B〜70Bモデルの純粋なローカルLLM推論では、Mac Studio M5 Max 128GB(5,099ドル)は4,500ドル以上のPC構成と直接競合し、Mac Studio M5 Ultraは256GBや512GBが必要なモデルまで上限を引き上げます。ユニファイドメモリの優位性は現実的で、計測可能です。 VRAM 24〜32GBに収まるモデルでは、RTX 4090/5090搭載PCがどのMacよりも高速です。モデルが小さいほどAppleの優位は縮まります。 ファインチューニング、学習、大規模なStable Diffusion、本番のPyTorchではPC+NVIDIAが優位です。MLXは改善していますが差は残っています。
Apple SiliconでのMLX vs Ollama vs llama.cpp
M5では主に3つの推論エンジンが動作します。どれが最適でしょうか。
- ## MLX(Apple純正) • 性能:M5で通常最速のトークン/秒。ネイティブなMetal最適化とニューラルアクセラレータへの対応。 • 対応モデル:拡大中(Llama、Qwen、Mistral、Gemmaが利用可能) • セットアップ:Python中心でコマンドライン操作が必要 • 向いている人:最大性能を求めるパワーユーザー • トレードオフ:Ollamaより扱いにくい
- ## Ollama(クロスプラットフォーム) • 性能:GGUFモデルはllama.cppのMetalバックエンドで動作。MLXバックエンド(Ollama 0.19、2026年3月からプレビュー)は一部モデル、特にM5系チップで高速化 • 対応モデル:最大のモデルライブラリ。新モデルは毎週追加 • セットアップ:コマンド1つでインストール、すぐ動作 • 向いている人:初心者と大半の開発者。連携用のREST API • トレードオフ:モデルのMLXビルドがある場合は、ネイティブMLXより遅くなることがあります(差はモデルとバージョンによる)
- ## llama.cpp(クロスプラットフォーム、最も低レベルの制御) • 性能:最適化すればOllamaと同等(OllamaはGGUFモデルにこれを使用) • カスタマイズ:量子化や推論パラメータを最も細かく制御 • セットアップ:コンパイルとコマンドラインの知識が必要 • 向いている人:研究者、独自の量子化ワークフロー • トレードオフ:Ollamaより学習コストが高い
- ## ユーザータイプ別のおすすめ • 初心者:Ollama(すぐ動き、ドキュメントも豊富) • 開発者:Ollama REST API(アプリへの組み込みが容易) • パワーユーザー:MLXを直接(最大性能) • 研究者:llama.cpp(最大のカスタマイズ性)
macOSセットアップ クイックスタート(10ステップ)
Apple Siliconで最初の70Bローカルモデルを動かす最短ルートです。
- 1Macを購入する
Why it matters: 予算・入門ならMac mini M5 Pro、デスクトップの性能ならMac Studio M5 MaxまたはM5 Ultra、携帯性ならMacBook Pro 16インチ M5 Max。 - 2macOSの初期設定
Why it matters: 移行アシスタント(旧Macからの移行)またはクリーンインストールを使います。macOSは最新に保ってください。AppleはMetalの性能改善をポイントリリースで提供します。 - 3Homebrewをインストールする
Why it matters: /bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)" — 以降すべての導入に使うパッケージマネージャです。 - 4Ollamaをインストールする
Why it matters: brew install ollama — コマンド1つの簡単インストールです。 - 5Ollamaサービスを起動する
Why it matters: ollama serve(フォアグラウンドで実行)、またはアプリケーションフォルダのOllama.appを使います。 - 6最初のテストモデルを取得する
Why it matters: ollama pull llama3.1:8b — 小さなモデルで動作確認します(約4GBのダウンロード)。 - 7基本的な推論をテストする
Why it matters: ollama run llama3.1:8b "Explain local LLMs in one sentence" --verbose — eval rate行にトークン/秒が表示されます。 - 8目的の大型モデルを取得する
Why it matters: ollama pull llama3.1:70b-instruct-q4_K_M(約40GBのダウンロード)。高速回線で20〜40分かかり、64GB以上のMacが必要です。 - 9性能を監視する
Why it matters: asitopでApple Siliconのリソース使用状況を確認できます。別のターミナルで brew install asitop && asitop を実行します。 - 10任意:GUI用にLM Studioをインストールする
Why it matters: lmstudio.aiからダウンロードします。開発者でない方にはコマンドラインより簡単で、Apple Silicon向けMLXエンジンも含まれます。
Apple Silicon M5でOllamaを高速化する方法
Apple SiliconのOllamaはほとんどの環境で既定で高速な経路を使っているため、以下のチェックリストは特殊なチューニングではなく、気づかずに速度を落としている要因を取り除くためのものです。
📍 一文で説明
`ollama ps`でモデルが100% GPUで動いているか確認し、ユニファイドメモリを空け、コンテキスト長を縮め、Q4量子化を使い、flash attentionを有効にし、MacBook Proは電源に接続して持ち上げて使います。生成速度は帯域幅で頭打ちになるため、最大の改善は帯域幅に見合うモデルを選ぶことです。
💬 簡潔に説明
Ollamaは通常、M5 Macでは既定のままでも十分高速です。速度の問題の多くは、設定の見落としではなく、ユニファイドメモリを圧迫する他の処理や、帯域幅に対して大きすぎるモデル、ノートPCの発熱が原因です。
- まずモデルを帯域幅に合わせる。 トークン/秒は「帯域幅 ÷ モデルファイルサイズ」付近で頭打ちになります(上の帯域幅セクション参照)。307GB/sのM5 Proで42GBの70Bモデルを動かすと、どれだけチューニングしても約7トークン/秒を超えません。20GBの32Bモデルなら約15です。より小さいモデルや量子化に切り替えるのが最大の高速化です。
- モデルがCPUにフォールバックせず、完全にGPUにオフロードされているか確認する。 モデル読み込み中に`ollama ps`を実行し、PROCESSOR列が100% GPUであることを確認します。CPUとの分割は、設定不足ではなく、モデルがmacOSがGPUに許可するメモリに収まっていないことを示す場合がほとんどです。
- 長いセッションの前にユニファイドメモリを空ける。 メモリはmacOSとモデルで共有されます。バックグラウンドのタブだらけのブラウザ、Docker Desktop、Xcodeなどが、Ollamaから数GBを奪うことがあります。大きなモデルを読み込む前に終了し、アクティビティモニタまたは`asitop`で空きメモリを確認してください。大きなモデルでは`sudo sysctl iogpu.wired_limit_mb=<MB>`でGPUのメモリ上限を引き上げられます(再起動でリセット)。
- 不要ならコンテキストウィンドウを小さくする。 短い会話ではModelfileやAPIリクエストで`num_ctx`を小さく(32Kではなく4096など)設定します。KVキャッシュのメモリ圧迫が減り、生成が速くなります。
- flash attentionと量子化KVキャッシュを有効にする。 `OLLAMA_FLASH_ATTENTION=1`と`OLLAMA_KV_CACHE_TYPE=q8_0`でKVキャッシュのメモリを減らし、わずかな品質低下で長いコンテキストを高速化できます。
- 量子化は実際に必要な品質に合わせる。 Q4_K_MはQ8_0やQ5_K_Mより明らかに高速で、品質低下は小さく通常は許容範囲です(量子化ガイド参照)。上のベンチマークより遅い場合は、ハードウェアを疑う前にQ4版を試してください。
- 持続的な推論ではMacBook Proを電源接続し、持ち上げて使う。 MacBook Proは、薄い筐体に熱がこもるため2〜3時間の連続負荷で10〜15%低下することがあります。通気を改善するスタンドと電源接続でスロットリングを遅らせられます。数時間を超えるセッションでは、Mac Studioの冷却が性能を維持します。
- macOSとOllamaを更新する。 AppleはMetalの性能改善をポイントリリースで提供し、Ollamaは定期的により高速なバックエンドを公開しています。MLXに対応するモデルも増えています。新しいM5シリコンで古いバージョンを使うと、性能を取りこぼします。
- 必要がなければ複数モデルの同時実行を避ける。 読み込まれたモデルはそれぞれユニファイドメモリの一部を確保します。`OLLAMA_MAX_LOADED_MODELS`でOllamaが同時に保持するモデル数を制御できます。
# Check whether a model is fully offloaded to GPU (PROCESSOR column)
ollama ps

# Measure real speed: the "eval rate" line is generation tokens/sec
ollama run llama3.1:8b --verbose

# Faster long-context inference: flash attention + 8-bit KV cache
OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 ollama serve

# Or limit Ollama to one resident model at a time
OLLAMA_MAX_LOADED_MODELS=1 ollama serve

# Smaller context window in a Modelfile: PARAMETER num_ctx 4096
判断マトリクス:どのMac構成を買うか
用途に合わせて最適な構成を探すためのマトリクスです。メモリが同じなら、帯域幅の高いほうを選びます。
- 1. 予算優先で小型モデル(7〜14B)で試す:Mac mini M5 Pro 24GB(1,699ドル)— 史上最安のM5 Pro
- 2. 低予算デスクトップで30Bモデルを使いたい:Mac mini M5 Pro 64GB(2,699ドル)
- 3. 70Bモデルを快適に動かしたい:Mac Studio M5 Max 64GB(3,499ドル)
- 4. 32K超のコンテキストで70B Q5が必要:Mac Studio M5 Max 128GB(5,099ドル)
- 5. 最大級のローカルモデルに256〜512GBが必要:Mac Studio M5 Ultra(5,499〜10,000ドル超)
- 6. 携帯できるローカルLLM、サーマルスロットリングは許容:MacBook Pro 16インチ M5 Max 64GB(3,499ドル)
- 7. すでにmacOS環境(Xcode、Final Cut Pro):どのMac Studio M5構成でも可
- 8. MLXでの研究・ファインチューニング:Mac Studio M5 Max 128GBまたはM5 Ultra(メモリの余裕)
- 9. 最大の静音性とアイドル動作:Mac Studio(通常負荷ではファンがほとんど回りません)
- 10. 予算4,000ドル以上で携帯したい:MacBook Pro 16インチ M5 Max 128GB(4,499ドル)
- 11. 代替を検討:RTX 4090搭載PC(3,000ドル〜)またはAMD Ryzen AI Max+ミニPC(1,600〜2,000ドル)
ローカルLLMにApple Silicon M5が向かないケース
Apple Siliconは優れていますが万能ではありません。次のような場合はMacを避けてください。
- CUDA専用のワークフローが必要: LLM推論の大半はApple Siliconで動きますが、torch.cudaを使ったファインチューニング、vLLMのCUDAカーネル、独自のCUDA研究コードはMLXでは動きません。作業の大半がCUDA依存ならRTX GPUを選びましょう。
- Stable Diffusionを多用する: 拡散モデルは一般にM5ではRTX 4090より遅くなります。画像生成がワークフローの30%以上なら、PC+RTXが有利です。
- 予算が絶対的な最優先: 1,500ドルのRTX 4070 Ti搭載PCは、小型モデルの推論速度でMac mini M5 Proを上回ります。予算だけが条件ならPCが安価です。
- ワークステーションの拡張性が必要: Mac StudioのRAMとストレージは購入時に固定されます。PCは段階的にアップグレードできます。5年以上使うなら、PCのほうが長期的に安くなることがあります。
- 小型モデルで3桁のトークン/秒が必要: RTX 4090はLlama 8Bで90〜120トークン/秒に達します。M5 Maxは推定75〜100です。複数ユーザーへの高スループット提供ではNVIDIAが依然優位です。
- もともとmacOSを使っていない: ローカルLLMのためだけにWindows/LinuxからmacOSへ移行する価値は、他の理由でmacOSを使いたい場合を除き、ありません。
- 24時間365日の本番推論が必要: Mac Studioは優秀ですが、バースト的な利用を想定した設計です。SLA付きの連続推論には、エンタープライズ向けNVIDIAワークステーションが安全です。
よくある質問
M5 Pro・M5 Max・M5 Ultraのメモリ帯域幅は?
M5は153.6GB/s、M5 Proは307GB/s、M5 Maxは460GB/s(32コアGPU)または614GB/s(40コアGPU)、M5 Ultraは最大1.2TB/s(1,228.8GB/s)です。トークン生成のたびにモデルの重みをメモリから1回読み込むため、LLM生成ではGPUコア数より帯域幅が重要です。
M5 MacのVRAMはどれくらい?
専用VRAMはありません。M5 MacはCPUとGPUが共有するユニファイドメモリを備えます。既定ではmacOSがGPUに許可するのはRAM全体のおよそ3分の2〜4分の3なので、64GBのMacならモデルに約48GBです。M5 Proは最大64GB、M5 Maxは最大128GB、M5 Ultraは最大512GBです。
MacBook Pro M5でOllamaを速くするには?
帯域幅に見合うモデルを選び、`ollama ps`で100% GPUか確認し、メモリを多く使うバックグラウンドアプリを閉じ、長いコンテキストが不要なら`num_ctx`を下げ、Q5/Q8ではなくQ4_K_Mを使い、`OLLAMA_FLASH_ATTENTION=1`を有効にし、2〜3時間を超えるセッションではMacBook Proを電源接続して持ち上げて使います。完全なチェックリストは上の高速化セクションをご覧ください。
Mac Studio M5 MaxでLlama 3.3 70Bは動きますか?
はい、64GBまたは128GBで動きます。70B Q4(約42.5GB)は64GBが必要で、460GB/sのチップで推定約6〜9トークン/秒、614GB/sのチップで9〜12トークン/秒です。70B Q5(約50GB)は128GB構成が望ましく、推定約7〜10トークン/秒です。
ローカルLLMでM5 MaxはRTX 4090とどう比べられますか?
24GBに収まる小型モデルではM5 Maxのほうが遅くなります(Llama 8Bで推定75〜100対90〜120トークン/秒)。70Bモデルは4090には載らず、CPUオフロードで約6〜10トークン/秒になりますが、614GB/sのM5 Maxは推定約9〜12トークン/秒で、消費電力は約3分の1です。
RAMは64GBで足りますか、128GBが必要ですか?
70B Q4モデル1つなら64GBで足ります。70B Q5やQ8、複数モデルの同時実行、長いコンテキスト、ファインチューニングでは128GBがおすすめです。メモリ容量で速度は変わりません。64GBでも128GBでも、Mac Studio M5 Maxは614GB/sです。
LLM用途でM5 ProとM5 Maxの違いは?
M5 Proは16/20コアGPU、帯域幅307GB/s、最大64GB。M5 Maxは32/40コアGPU、460/614GB/s、最大128GB。生成速度は帯域幅に比例するため、同じモデルでM5 MaxはM5 Proの約1.5倍(460GB/s)〜2倍(614GB/s)高速です。M5 Ultra(Mac Studioのみ)はさらに上で、最大80コアGPU、最大1.2TB/s、最大512GBです。
Mac Studio M5 Ultraはローカルで動かすLLMでどれくらい速い?
MacStoriesは、256GBのM5 UltraでQwen3.8 27Bの生成を48トークン/秒(RTX 5090は59)、より小さなFlash-Nextモデルで108トークン/秒と計測し、M3 Ultraより約54%高速でした。70B Q4モデルの帯域幅上限は約29トークン/秒ですが、70Bの独立した結果はまだ公開されていません。
MacBook Proは持続的なLLM推論でサーマルスロットリングしますか?
はい。2〜3時間の連続推論後に、MacBook Proは10〜15%程度性能が低下することがあります(推定)。Mac Studioは24時間365日、性能を維持します。
Apple SiliconでStable Diffusionは動きますか?
はい。Stable Diffusion XLはM5で1枚あたり約8〜12秒で動作します(RTX 4070の約3秒より遅い)。MLXがネイティブに対応しています。
MacではMLXのほうがOllamaより速いですか?
MLXビルドのあるモデルでは通常そうです。llama.cpp上のGGUFモデルより一般にMLXが速く、モデルとバージョンにより約10%〜2倍の差が報告されています。OllamaがMLXバックエンドを2026年3月に追加し、対応モデルでは差が縮まっています。生の速度ではなく、ワークフローで選んでください。
Mac Studio M5 MaxのLLM推論時の消費電力は?
LLM負荷時のM5 Maxは持続的に推定65〜100Wです。AppleはMac Studio筐体の最大連続消費電力を480Wとしていますが、推論だけでは届きません。100Wで24時間365日の推論を1か月(720時間)行うと約72kWhで、米国の電気代でおよそ8〜12ドル。RTX 4090構成は約40〜60ドルです。
Mac miniにもM5 Proが搭載されましたか?
はい。Mac mini M5 Proは1,699ドルから(24GB、最大64GB)、帯域幅307GB/s、Thunderbolt 5で、2026年9月22日から出荷中です。史上最安のM5 Pro搭載Macです。
Mac StudioにはM5 Proの構成が残っていますか?
いいえ。2026年8月25日の更新以降、Mac StudioはM5 Max(2,499ドル)から始まります。M5 ProチップへのMacの入り口はMac miniです。
Mac Studio M5 Ultraとは何で、どれだけのメモリに対応しますか?
M5 UltraはM5 Maxの上位に位置するMac Studio専用チップで、5,499ドル(96GB)から。現在は256GB、2026年10月下旬に512GB(10,000ドルを大きく上回る見込み)まで拡張でき、帯域幅は最大1.2TB/sです。
Apple Siliconでモデルをファインチューニングできますか?
はい、LoRAのファインチューニングはうまく動作します。全重みのファインチューニングはデスクトップGPUより遅くなります(分散学習にはまだ非対応)。
Apple Siliconは推論には向いているが学習には不向きですか?
一部そうです。推論は優秀です。学習やファインチューニングも動作しますが、NVIDIAより遅くなります。MLXフレームワークは急速に改善しています。
Neural EngineはLLMにどう役立ちますか?
トークン生成を律速するのはNeural Engineではなくメモリ帯域幅です。M5系チップでは、各GPUコア内のニューラルアクセラレータが、MLXやOllamaのMLXバックエンドなどそれを利用するランタイムで、プロンプト処理(最初のトークンまでの時間)を高速化します。
M5 Max 128GBで複数モデルを同時に動かせますか?
はい。128GBなら、32Bモデル2つ、または70Bと14Bを十分な速度で同時に実行できます。
MacでのローカルLLMのセットアップ時間は?
まっさらなMacからOllamaで最初の70Bモデルを動かすまで15〜30分です(高速回線でのモデルダウンロード20〜40分を含む)。
Apple Siliconは最新のオープンウェイトモデルに対応しますか?
Llama、Qwen、Mistral、Gemma、DeepSeekなど、主要なオープンウェイトモデルの多くは、公開から数日でllama.cpp(GGUF)またはMLXで動作します。現在の一覧はHugging FaceのMLXコミュニティとOllamaライブラリで確認してください。
ローカルLLM用にMac mini M6とM5 Proのどちらを買うべきですか?
M6はエントリーのMac mini(899ドル、16〜32GB、帯域幅は約153〜170GB/s)で、小型モデル向けです。M5 Pro(1,699ドル、最大64GB、307GB/s)は帯域幅とメモリがおよそ2倍で、ローカルLLM向けの選択肢です。
整備済み製品のMac Studioは検討する価値がありますか?
はい。Appleは整備済みのMacを1年保証付きで販売しており、通常は新品価格より割安です。
M5 Maxは64GBと128GBのどちらを買うべきですか?
70B Q4モデル1つと32Bクラスなら64GB、70B Q5/Q8、長いコンテキスト、複数モデルの同時実行には128GBが向いています。GPU構成にも注意してください。MacBook Proでは64GBが460GB/sのチップ、128GBが614GB/sのチップです。