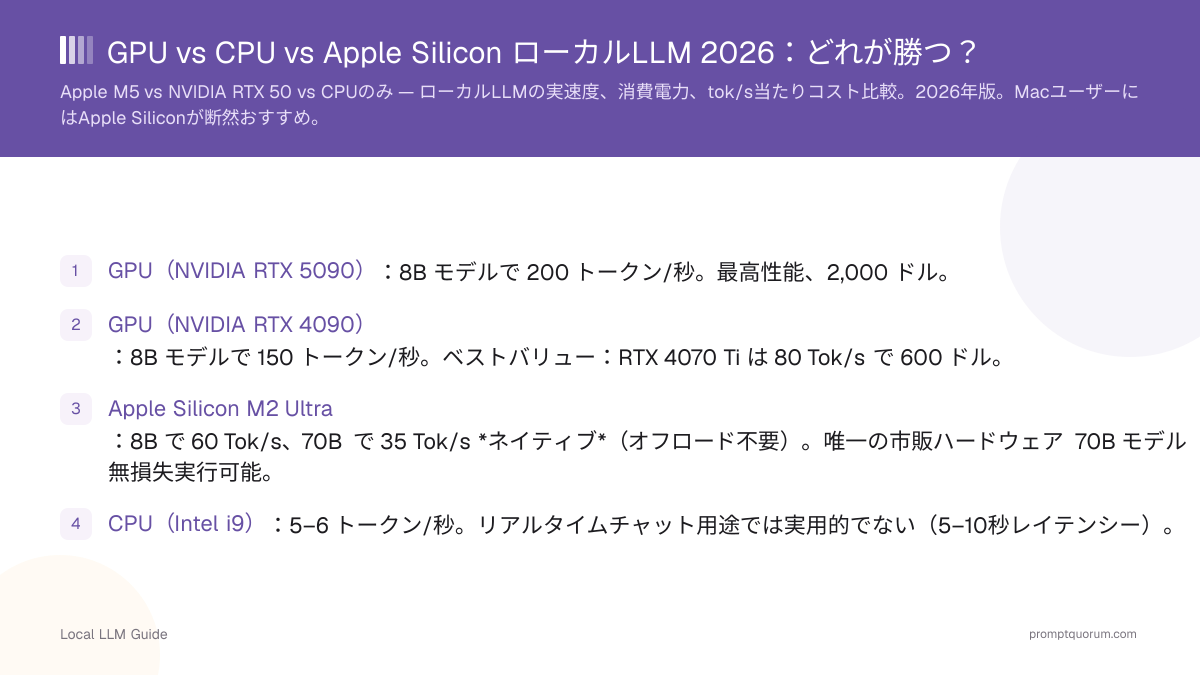
重要なポイント
- Apple M5 Pro(64GB、約2,399ドル):ほとんどのユーザーに最適なオールラウンド機。30Bモデルで40〜60 tok/s、低消費電力(推論時約25W)、VRAM上限なし。
- NVIDIA RTX 5090(32GB、2,000ドル):7B〜14Bモデルで最速の150〜200 tok/s。CPUオフロードなしに30B以上は不可。本番ワークロード向け。
- NVIDIA RTX 5070(12GB、約600ドル):最高コスパGPU。8Bモデルで60〜80 tok/s。7B〜8Bのフル精度に限定。
- Apple M5 Max(64〜128GB、約3,199ドル〜):460〜614 GB/sの帯域幅。30B〜70Bをネイティブ実行。研究者や30B以上のヘビーユーザー向け最適。
- CPUのみ(最新Ryzen/Intel):高速DDR5 RAM搭載で7Bモデル10〜20 tok/s。たまの利用には可、リアルタイムチャットには非実用的。
- 結論:ほとんどのユーザーにとってApple M5 Pro 64GBが勝者 — 単体GPUより大きなモデルを、GPU構成より低コストで、消費電力は10分の1。RTX 50シリーズを選ぶのは7B〜14Bの最高速度または本番ワークロードに限る場合のみ。
📍 一文で説明
ローカルLLM向け:Apple M5 Pro 64GB(約2,399ドル)が30Bモデルで40〜60トークン/秒のオールラウンド最良;RTX 5090 32GB(約2,000ドル)は7B〜14Bで最速(150〜200トークン/秒)だが30B以上は不可;RTX 5070 12GB(約600ドル)が最高コスパGPU;CPU単独は7Bで10〜20トークン/秒。
💬 簡潔に説明
GPUは小型モデル(14B未満)で最速です。Apple Siliconはメモリと計算を一体化し低消費電力で大型モデル(30B+)に最適。CPU単独は最も遅いですがあらゆるノートPCで動作します。
パフォーマンス比較:速度、帯域幅、コスト
*CPUオフロードが必要 — 大幅な速度低下と低ビット幅での品質劣化
ハードウェア | Qwen3 8B | Qwen3 30B | 消費電力 | コスト |
|---|---|---|---|---|
| RTX 5090(GPU、32GB GDDR7) | 150–200 tok/s | 実行不可* | 約450W | 2,000 ドル |
| RTX 5080(GPU、16GB GDDR7) | 100–130 tok/s | 実行不可* | 約360W | 1,000 ドル |
| RTX 5070 Ti(GPU、16GB) | 80–100 tok/s | 実行不可* | 約300W | 750 ドル |
| RTX 5070(GPU、12GB) | 60–80 tok/s | 実行不可* | 約250W | 600 ドル |
| MacBook Pro M5 Pro(36〜64GB、307 GB/s) | 40–60 tok/s | 20–30 tok/s | 約25W | 2,399 ドル〜 |
| MacBook Pro M5 Max(64〜128GB、460〜614 GB/s) | 60–80 tok/s | 35–50 tok/s | 約35W | 3,199 ドル〜 |
| Mac mini M5 base(16〜32GB、200 GB/s) | 25–35 tok/s | オフロード* | 約15W | 599 ドル〜 |
| Intel Core Ultra 9 / AMD Ryzen 9(CPU、DDR5) | 10–20 tok/s | 3–5 tok/s | 約65W | 内蔵 |

GPUを選ぶべき場合(RTX 50シリーズ)
7B〜14Bモデルで最高速度が必要、または24時間365日の本番ワークロードを実行する場合はRTX 50シリーズのNVIDIA GPUを選びましょう。
- RTX 5090(32GB GDDR7、1,792 GB/s):8Bモデルで150〜200 tok/s。2,000ドル。本番パイプライン、ファインチューニング、速度重視のアプリケーションに最適。
- RTX 5080(16GB GDDR7):8Bで100〜130 tok/s。1,000ドル。8B〜13Bで速度とコストのバランスが良い。
- RTX 5070 Ti / 5070(12〜16GB):8Bで60〜100 tok/s。600〜750ドル。個人利用のチャット・コーディング向け最高コスパ。
- CUDAエコシステムの強み:vLLM、llama.cpp、LM Studioはすべてネイティブ最適化済み。ネイティブ精度で最速の推論。
- 構造的な限界:RTX 50シリーズのどのカードも30Bモデルをフル品質でロードできない(20GB以上のVRAMが必要)。システムRAMへのオフロードは5〜10倍の速度低下を招く。
消費電力が最大のトレードオフ:RTX 5090は負荷時450Wを消費、M5 Proはわずか25W。0.35ドル/kWhの場合、1日8時間使用でRTX 5090は月額約55ドル多く電気代がかかる。
Apple Siliconを選ぶべき場合(M5)
14B〜70Bモデルの実行が必要、省電力を重視する、またはmacOSをメインOSとして使う場合はApple Silicon M5を選びましょう。
- M5 base(16〜32GB、200 GB/s):7B〜8Bをネイティブで25〜35 tok/s実行。599ドル〜(Mac mini)。良い入門機。
- M5 Pro(36〜64GB、307 GB/s):最大30Bをネイティブで20〜30 tok/s実行。約2,399ドル(MacBook Pro)。最高のオールラウンド価値。
- M5 Max(64〜128GB、460〜614 GB/s):30B〜70Bをネイティブで35〜50 tok/s実行。約3,199ドル〜。研究者や70Bのヘビーワークロード向け最適。
- 統合メモリの利点:VRAM上限なし。64GBのM5 Proは30Bモデルをネイティブでロード可能、128GBのM5 Maxは70Bモデルをネイティブでロード可能。
- Appleの発表:M5世代のLLM推論はM4比で4倍高速。
- MLXフレームワーク:AppleのMLXはApple Silicon向けに最適化。Qwen3モデルはMLXで優れた動作。DeepSeek-R1 14Bも良好な性能。
トレードオフ:7BではRTX 5090の生の速度に及ばない。ファインチューニングは遅い。CUDA専用ツールは使えない。
CPUのみで十分な場合
たまの応答だけで十分で小型モデル(7B Q4)を実行するならCPUのみの推論も実用的です。
- DDR5-5600搭載の最新Intel Core Ultra 9 / AMD Ryzen 9:Qwen3 8BやLlama 3.2 8Bで10〜20 tok/s。非対話的なバッチタスクに利用可能。
- 旧型CPU / DDR4:5〜8 tok/s。応答ごとに目立つ遅延(5〜8秒)で対話的チャットには不快。
- 追加ハードウェアコストゼロ:既に使えるデスクトップがあれば、llama.cppやOllamaはすぐに動作。
- 消費電力:フル推論負荷時のCPUは65〜125Wを消費 — GPUより少なく、Apple Siliconより多い。
CPU推論が向いているのは:ドキュメント要約のバッチ処理、夜間処理、たまの質問応答。リアルタイムチャット、コーディングアシスタント、8B超のモデルにはCPUのみを避けましょう。
メモリ帯域幅:本当のボトルネック
LLM推論はメモリ律速であり、計算律速ではありません。 トークン生成速度はモデルの重みをメモリからどれだけ速く読み込めるかで決まります。メモリ帯域幅が高いほど、トークン生成は速くなります。
計算式:推論速度 ≈ メモリ帯域幅 ÷ メモリ上のモデル重み
- RTX 5090の1,792 GB/sは2026年時点で入手可能な単体GPUとして最速の帯域幅。
- M5 Maxの460〜614 GB/sはRTX 5080の帯域幅に匹敵または上回る — 16GBのVRAMに対し128GBの統合メモリで。
- M5 Proの307 GB/sはスイートスポット:30Bモデルに十分な帯域幅を、M5 Maxの半分のコストで実現。
- CPUのDDR5は89 GB/sでRTX 5090より20倍遅いが、DDR4より4倍速い — CPU推論にとって意味のある改善。
- 統合メモリの利点:CPU↔GPU間の転送オーバーヘッドなし。M5 Proは30Bモデルを64GBのプール内に丸ごと保持。
プラットフォーム | メモリ帯域幅 | 実効速度(8B) |
|---|---|---|
| RTX 5090(GDDR7) | 1,792 GB/s | 150–200 tok/s |
| RTX 5080(GDDR7) | 960 GB/s | 100–130 tok/s |
| RTX 5070(GDDR7) | 672 GB/s | 60–80 tok/s |
| M5 Max(統合、128GB) | 460–614 GB/s | 60–80 tok/s |
| M5 Pro(統合、64GB) | 307 GB/s | 40–60 tok/s |
| M5 base(統合、32GB) | 200 GB/s | 25–35 tok/s |
| DDR5-5600 RAM(CPUのみ) | 89 GB/s | 10–20 tok/s |
| DDR4-3200 RAM(CPUのみ) | 51 GB/s | 5–8 tok/s |
tok/sあたりのコスト:真の価値分析
tok/sあたりのコストはハードウェアの価値を比較します:初期コストを持続的なトークン速度で割ったもの。
純粋な速度ではRTX 5070がtok/sあたりのコストで最良。 M5 Proは電力面で有利:0.15ドル/kWhで1日8時間使用した場合、M5 Proは月額約1.10ドル、RTX 5090は約16.50ドル。
すでにM5 Pro搭載のMacを持っている場合、ハードウェア分のtok/sあたりコストは実質0ドル。
ハードウェア | 初期コスト | Tok/s(8B) | tok/sあたりコスト | 消費電力(推論時) |
|---|---|---|---|---|
| RTX 5090(32GB) | 2,000 ドル | 175 | 11.4 ドル | 450W |
| RTX 5070(12GB) | 600 ドル | 70 | 8.6 ドル | 250W |
| M5 Pro MacBook Pro(64GB) | 2,399 ドル | 50 | 48 ドル | 25W |
| M5 Max MacBook Pro(128GB) | 3,199 ドル | 70 | 46 ドル | 35W |
| CPU(最新DDR5デスクトップ) | 内蔵 | 15 | 0 ドル | 65W |
プラットフォーム選択ガイド
モデルサイズ、予算、用途に基づく判断フレームワーク:
- RTX 5090 / 5080を選ぶ:7B〜14Bの最高速度、本番パイプライン、ファインチューニング、24時間稼働のサーバーワークロード。
- RTX 5070 / 5070 Tiを選ぶ:7B〜13Bでの個人利用のチャット・コーディングに最高コスパのGPU。600〜750ドル。
- M5 Pro(64GB)を選ぶ:ほとんどのユーザーに最適なオールラウンド。30Bをネイティブ実行、低消費電力、macOSワークフロー。約2,399ドル。
- M5 Max(128GB)を選ぶ:研究用途、70Bをネイティブ実行、Apple Silicon最高性能。約3,199ドル〜。
- CPUのみ:追加投資ゼロ、7Bのたまの利用、夜間バッチ処理。
ハードウェア選択でよくある誤解
- 1「30B以上にはGPUを選ぶべき」 — 誤り。RTX 50シリーズのどのカードも30BをVRAMにロードできない。RAMへのオフロードは5〜10倍の速度低下を招く。代わりにM5 ProやM5 Maxを使う。
- 2「M5 base(16GB)で十分」 — 誤り。7Bしかロードできない。14Bモデルには32GB、30Bには64GB(M5 Pro)が必要。
- 3「常時稼働GPUサーバーの電気代を軽視」 — RTX 5090を1日8時間使うと0.15ドル/kWhで年間約200ドルの電気代。M5 Proなら約14ドル。
- 4「8Bチャット用にRTX 5090を買う」 — 600ドルのRTX 5070でも8Bで70 tok/s出せる — 速度の80%をコストの30%で実現。
- 5「CPUでもリアルタイムチャットに使える」 — 20 tok/sでも遅く感じる。DDR4での5〜8 tok/sは対話用途には使い物にならない。
よくある質問
ローカルLLM実行にはGPUとCPUどちらが良い?
リアルタイム推論にはNVIDIA GPUの方が速い:RTX 5070は8Bモデルを60〜80 tok/sで実行、DDR5搭載の最新CPUでは10〜20 tok/s。Apple M5 Proも40〜60 tok/sでCPUを上回り、さらに30Bモデルをネイティブ実行できる。
Apple Siliconはローカル LLM を実行できる?
はい。Apple M5シリーズはチップの等級により7Bモデルを25〜80 tok/sで実行。M5 Pro(64GB)は30Bモデルをネイティブで20〜30 tok/s実行 — これはどの一般向けGPUでも実現できない。M5 Max(128GB)は70Bモデルをネイティブで35〜50 tok/s実行。
ローカルLLMに必要な最低限のGPU VRAMは?
12GBのVRAM(RTX 5070)は7B〜8BモデルをQ4〜Q8量子化で問題なく実行。16GB(RTX 5080)は13Bモデルに対応。単体の一般向けGPUで30Bを完全にロードできるものはなく、その場合は64GBのApple M5 Proを使う。
GPUはLLM推論でCPUより何倍速い?
RTX 5090はDDR5搭載の最新CPUより8〜15倍速い(8Bモデルで175 tok/s対15 tok/s)。差はメモリ帯域幅から生じる:1,792 GB/s(GDDR7)対89 GB/s(DDR5)。307 GB/sのApple M5 Proはその中間、40〜60 tok/s。
ローカルLLMのためだけにGPUを買う価値はある?
RTX 5070(600ドル)は3年償却で、1日2時間以上使うヘビーユーザーにとってOpenAI APIの利用料より安くなる。70 tok/sでリアルタイムチャットとコーディング支援に対応。30B以上のモデルが必要ならM5 Proの方が初期コストは高くても価値がある。
メモリ帯域幅とは何か、なぜLLMにとって重要?
LLM推論はメモリ律速。トークン速度 ≈ メモリ帯域幅 ÷ モデル重み。RTX 5090:1,792 GB/s。M5 Max:460〜614 GB/s。M5 Pro:307 GB/s。CPU DDR5:89 GB/s。だからこそ統合メモリを持つApple Siliconは、トップGPUより生の帯域幅が低くても大型モデルを効率的に実行できる。
2026年のローカルLLMに最適なApple Siliconチップは?
M5 Pro(64GB、307 GB/s)はほとんどのユーザーに最適なオールラウンド機 — 約2,399ドルで30Bモデルをネイティブ20〜30 tok/s実行。M5 Max(128GB、460〜614 GB/s)は70Bモデルを35〜50 tok/s(約3,199ドル〜)。7B超の用途にはM5 base(16GB)を避ける。
Apple Siliconは30Bや70Bモデルを実行できる?
M5 Pro(64GB)は30Bモデルをネイティブで20〜30 tok/s実行。M5 Max(128GB)は70Bモデルをネイティブで35〜50 tok/s実行。これはCPUオフロードなしの実際のスループット値であり、30B以上でこれに匹敵する一般向けGPUは存在しない。
2,000ドルのRTX 5090はローカルLLMに価値がある?
7B〜14Bモデルを最高速度で使うワークフロー、または本番推論パイプラインを運用する場合のみ。ほとんどのユーザーには、RTX 5070(600ドル)が速度の80%をコストの30%で提供する。30B以上のモデルには、予算に関わらずM5 Proの方が良い選択。
GPUとApple Siliconの消費電力はどう比較される?
RTX 5090は推論負荷時に約450Wを消費。M5 Proは約25W。1日8時間、0.15ドル/kWhの場合、年間200ドル(RTX 5090)対14ドル(M5 Pro)に相当する。家庭用途や商用電気料金を支払うユーザーにとって、M5 Proの電力効率は明確なコスト優位性となる。
Intel MacBook Pro(i9、16GB RAM)でのLLM推論速度は?
Apple Siliconより遅く、最新のDDR5デスクトップよりも遅い。Intel MacBook ProにはllamacppのGPU統合メモリ経路がなく、推論はDDR4上でCPUのみで実行される。DDR4のデュアルチャネル帯域幅は約38〜45 GB/sで、最新のDDR5デスクトップCPUの89 GB/sを大きく下回る。上記のメモリ帯域幅÷モデルサイズの式を使うと、量子化された7Bモデル(Q4で約4.5GB)は理論上約8〜10 tok/s、CPUの計算オーバーヘッドを考慮した実質値では4〜7 tok/sとなる。合計16GBのRAMではOS用の余裕を残すと7B〜8B(Q4)程度が限界で、大幅なスワップと速度低下なしに13B以上のモデルを実行することは期待できない。
pp tok/sとtg tok/sの違いは?
pp tok/s(プロンプト処理)は、モデルが入力プロンプトをどれだけ速く取り込むかを測る指標で、「プリフィル」フェーズにあたる。これは計算負荷が支配的で、GPUのような並列ハードウェアでよくスケールする。tg tok/s(トークン生成)は、新しい出力トークンをどれだけ速く生成するかを測る指標で、「デコード」フェーズにあたる。これは上記の帯域幅の式が示す通り、メモリ帯域幅が支配的である。GPUは通常pp/tgの差が大きく(プリフィルは速いが、生成は帯域幅に制限される)、Apple Siliconの統合メモリは両者の値をより近づける。ベンチマークを比較する際は、どちらの数値を読んでいるかを必ず確認すること — 同じハードウェアでもppとtgは5〜20倍異なることがある。
- NVIDIA GPU仕様 — RTX 50シリーズGPU仕様、VRAM、メモリ帯域幅 www.nvidia.com/en-us/geforce/
- Apple Metal for Machine Learning — 統合メモリ最適化 developer.apple.com/metal/
- vLLM テンソル並列化ドキュメント — マルチ GPU 推論 docs.vllm.ai/
- llama.cpp GitHub — オープンソース推論エンジン github.com/ggerganov/llama.cpp