重要なポイント
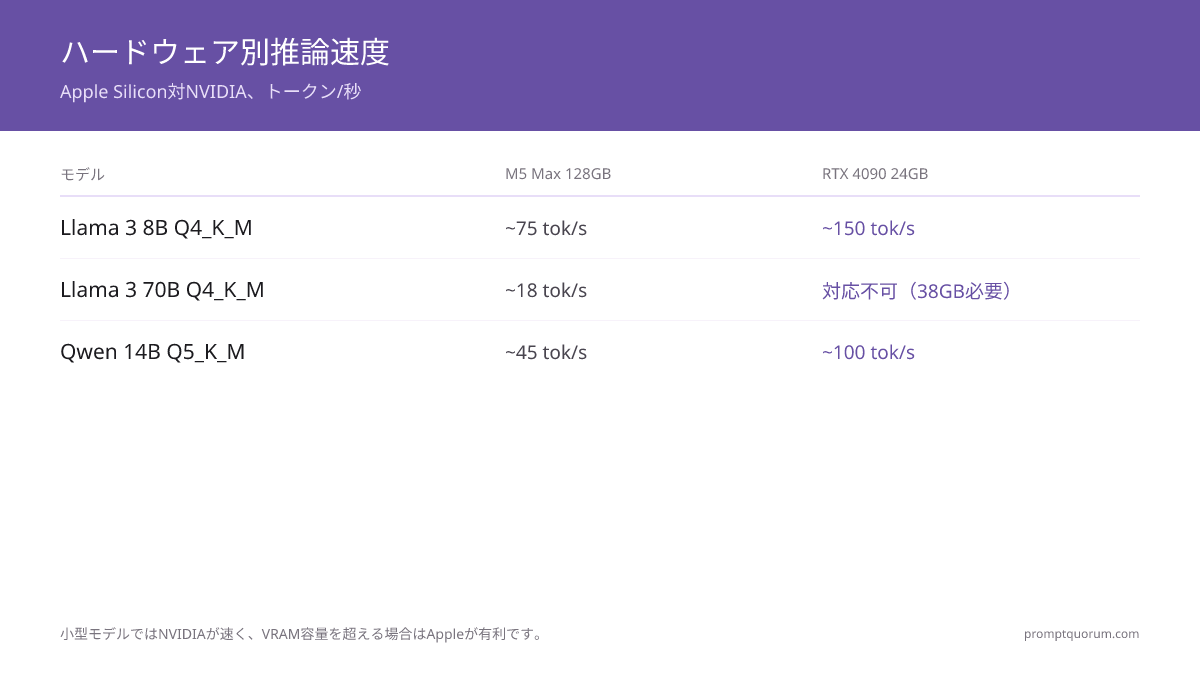
- M5 Max 128GB:Llama 3 8B Q4_K_M で約75トークン/秒;Llama 3 70B Q4_K_M で約18トークン/秒(メモリに収容)
- RTX 4090 24GB:Llama 3 8B で約150トークン/秒;Llama 3 70B は収まらない(約38GB VRAM必要)
- 70B対応コスト:Mac Studio M5 Max 36GB ~419,800円 vs 2× RTX 4090システム 約700,000円
- 電力:Apple 25〜35W;RTX 4090システム 約450W — 約10倍の差
- ソフトウェア:NVIDIA優位(CUDA、PyTorch、vLLM、TensorRT-LLM);Apple成長中(MLX、mlx-lm)
- トレーニング/ファインチューニング:NVIDIAのみ本格的なワークロードで実用的
- ポータビリティ:MacBook Pro M5はバッテリーで14Bモデルを実行;これに匹敵するNVIDIAラップトップなし
📍 一文で説明
Apple MLXは70B以上のモデルと電力効率で優位;NVIDIA CUDAは7〜14Bモデルの生の推論速度とトレーニングエコシステムで優位。
💬 簡潔に説明
Apple Siliconは大きなトランクを持つハイブリッド電気自動車—少ないエネルギーで巨大なモデルを収容。NVIDIAはスポーツカー—小さな積荷には猛スピードだが燃料を大量に消費。
📌補足: ベンチマーク数値はコミュニティテスト(2026年5月)による近似値で±10〜15%の誤差あり。量子化、コンテキスト長、システム負荷により結果は異なります。
2026年にこの比較が重要な理由
Apple Silicon M5シリーズは最大128GBのユニファイドメモリを搭載—コンシューマー価格で初めてMacでの大型モデル推論が実用的になりました。NVIDIAのRTX 5090は32GB GDDR7 VRAMで554,400円で登場。二つの根本的に異なるアーキテクチャが同じオープンソースモデルを実行するために競合しています。
📍 一文で説明
2026年、Apple SiliconとNVIDIA Discrete GPUはローカルで大規模言語モデルを実行するための二つの全く異なるハードウェア哲学を代表しています。
💬 簡潔に説明
Appleでは、CPU、GPU、RAMが同じメモリプールを共有—128GBのMac Studioは一度に70Bモデルをロードできます。NVIDIAは別のVRAMを使用;単一のRTX 4090(24GB)は70Bモデルを全くロードできません。
- Apple M5 Max:CPUとGPUで共有される最大128GBのユニファイドメモリ
- NVIDIA RTX 5090:554,400円で32GB GDDR7—最速のコンシューマーDiscreet GPU
- Llama 3 70B(Q4_K_M)には約38GBのメモリが必要
- Appleなら:1台で対応可能。NVIDIAなら:2× RTX 4090またはCPUオフロードが必要
💡ヒント: ターゲットモデルが40B以上のパラメータならApple MLXを選択。7〜14Bモデルで最大トークン/秒が必要か、ファインチューニングが必要ならNVIDIA CUDAを選択。
すべてを変えるアーキテクチャの違い
Apple SiliconとNVIDIA GPUは根本的に異なるメモリアーキテクチャを中心に構築されています。この単一の違い—共有か専用か—が実行できるモデルとその速度を決定します。
📍 一文で説明
Apple SiliconはCPU、GPU、Neural Engine間で共有されるユニファイドメモリを使用;NVIDIAはPCIeバスで接続されたGPUカード上の専用GDDR7 VRAMを使用。
💬 簡潔に説明
NVIDIAには2つの別々のバンクがある—システムRAMとGPU VRAM。それらの間でデータを移動させるのは遅い。Appleはすべてが共有する1つのバンクを持つ—コピーなし、ボトルネックなし。
Apple Silicon:ユニファイドメモリアーキテクチャ
M5 MaxはCPUコア、GPUコア、Neural Engineを1つのダイに統合。すべての演算ユニットが同じメモリプールから読み取ります。128GBのM5 MaxはCPUとGPUで同時に128GBを利用可能—VRAMの上限なし、転送ボトルネックなし。
- M5 Maxメモリ帯域幅:614 GB/s(CPU+GPU同じプール)
- ゼロコピーテンソル演算—CPUとGPU間にPCIeバスなし
- Neural Engine:加速されたML演算用38 TOPS
- Llama 3 70B Q4_K_M(約38GB)は64GBまたは128GB構成に収容可能
- Mac Studio M5 Max 36GB:~419,800円—70Bモデル推奨構成;Mac Studio M5 Ultraが登場、96GBで5,499ドルから、2026年9月22日出荷開始
NVIDIA:専用VRAM + PCIeバス
NVIDIA GPUはカード上に専用GDDR7 VRAMを搭載。システムRAMは別。モデルがVRAMを超えると、llama.cppはシステムRAMにレイヤーをオフロードしなければならない—それらのレイヤーでは10〜20倍遅くなります。
- RTX 5090:32GB GDDR7で1,792 GB/sのメモリ帯域幅
- RTX 4090:24GB GDDR6Xで1,008 GB/s
- PCIe 4.0 ×16バス:ピーク約32 GB/s(大型モデルオフロードのボトルネック)
- Llama 3 70B Q4_K_M は約38GB必要—単一RTX 4090(24GB)を超過
- 70BをVRAMに完全収容するには2× RTX 4090 + NVLink必要
メモリ帯域幅比較
LLM推論では、メモリ帯域幅が直接トークン/秒を決定します。生成される各トークンのためにモデルの重みをメモリから読み取る必要があります。
- RTX 5090:1,792 GB/s — 32GB GDDR7(最高帯域幅、Discrete GPU)
- RTX 4090:1,008 GB/s — 24GB GDDR6X(広く入手可能、実績あり)
- RTX 4070 Ti Super:672 GB/s — 16GB GDDR6X(NVIDIA中〜高レンジ)
- Apple M5 Max:614 GB/s — 最大128GB(CPU+GPU共有プール)
- Apple M5 Pro:273 GB/s — 最大48GB(MacBook/Mac Miniオプション)

💡ヒント: NVIDIAはコストあたりの生の帯域幅で勝り;Appleは総メモリ容量で勝ります。LLMでは、総メモリがどのモデルが収まるかを決定;帯域幅はその制約内での速度を決定します。
Apple SiliconはNVIDIAのメモリ帯域幅に匹敵できますか?
いいえ—RTX 4090は1,008 GB/s vs Apple M5 Maxの614 GB/s。Appleははるかに大きなメモリ容量(128GB vs 24GB)で補います。VRAMで十分な小型モデルではNVIDIAが速度で勝ります。VRAMを超える大型モデルではAppleが容量で勝ります。
パフォーマンスベンチマーク:モデル別トークン/秒
推論速度はトークン/秒(tok/s)で測定—インタラクティブな使用では高いほど良い。NVIDIAは小型モデルの速度で優位;AppleはモデルがVRAM容量を超える場合に勝ります。
📍 一文で説明
RTX 4090はLlama 3 8B Q4_K_Mで約150トークン/秒;Apple M5 Max 128GBは同じモデルで約75トークン/秒だが、RTX 4090が収容できないLlama 3 70Bも約18トークン/秒で実行可能。
💬 簡潔に説明
RTX 4090は7Bモデルで2倍速いが70Bモデルを物理的にロードできない。M5 Maxは小型モデルでは遅いが、単一NVIDIAカードが処理できない大型モデルを実行できる。
モデル | M5 Max 128GB | M5 Pro 48GB | RTX 5090 32GB | RTX 4090 24GB | RTX 4070 Ti S. 16GB | RTX 3060 12GB |
|---|---|---|---|---|---|---|
| Llama 3 8B Q4_K_M | 約75 tok/s | 約65 tok/s | 約145 tok/s | 約150 tok/s | 約95 tok/s | 約55 tok/s |
| Llama 3 70B Q4_K_M | 約18 tok/s ✓ | N/A(38GB必要) | N/A(32GB < 38GB必要) | N/A(38GB必要) | N/A | N/A |
| Qwen 14B Q5_K_M | 約45 tok/s | 約38 tok/s | 約130 tok/s | 約100 tok/s | 約58 tok/s | N/A(12GB上限) |
| Mixtral 8×7B Q4_K_M | 約22 tok/s | 約15 tok/s | 約95 tok/s ✓ | 約65 tok/s | N/A(約26GB必要) | N/A |
| Llama 3 8B Q8_0 | 約55 tok/s | 約45 tok/s | 約165 tok/s | 約110 tok/s | 約65 tok/s | N/A(約9GB必要) |

📌補足: ベンチマークはmlx-communityおよびllama.cppコミュニティテスト(2026年5月)から。近似値±10〜15%。正確な数値はお使いのハードウェアでllama-benchを実行してください。
Llama 3 70Bで18トークン/秒はインタラクティブな使用に十分ですか?
ほとんどのタスクでは十分です。18トークン/秒で500語の応答を生成するには約20〜25秒かかります。以前は4,000,000円以上のサーバーが必要だった70B品質のインタラクティブ使用が、~419,800円のMac Studio M5 Max 36GBで可能になりました。
なぜNVIDIAは小型モデルで速いのですか?
NVIDIAのGDDR7/GDDR6X帯域幅(1,008〜1,792 GB/s)はApple M5 Maxの帯域幅(614 GB/s)を超えています。LLM推論はメモリ帯域幅に制限される—高い帯域幅で小型モデルを速く実行できます。
コスト比較:モデルサイズ別総システムコスト
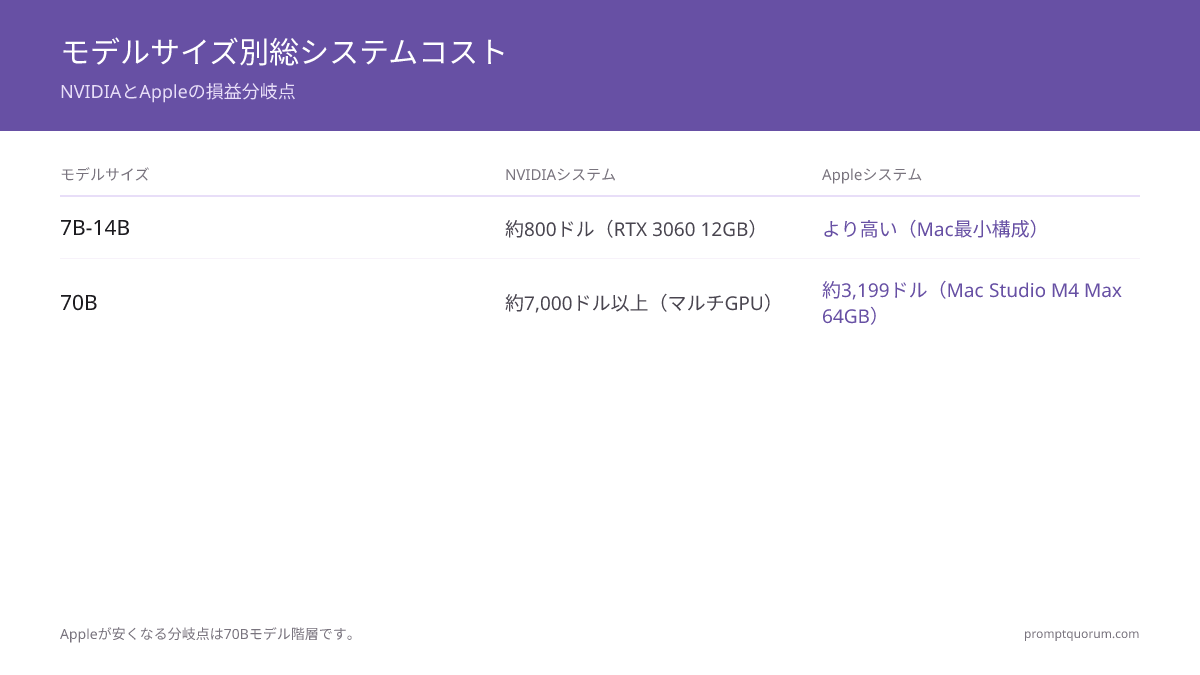
総システムコストにはNVIDIAのGPUカード+PCビルドが含まれ;Appleの場合はMacだけ。AppleがNVIDIAより安くなる分岐点は70Bモデルレベル。
📍 一文で説明
NVIDIAは7〜14Bモデルで安い(RTX 3060 12GB+PC 約80,000円);Appleは70Bモデルで安い(Mac Studio M5 Max 36GB ~419,800円 vs 2× RTX 4090システム 約700,000円)。
💬 簡潔に説明
小型モデルはNVIDIAが有利(GPUを買って挿すだけ)。大型モデルはAppleが有利(2枚のグラフィックカードとPCの代わりに1台のデバイス)。
ターゲットモデル | Appleオプション | Apple価格 | NVIDIAオプション | NVIDIA価格 | 安い方 |
|---|---|---|---|---|---|
| 7Bモデル | Mac Mini M4 24GB | 159,800円 | RTX 3060 12GB + PC | 約80,000円 | NVIDIA(2×) |
| 14Bモデル | Mac Mini M4 Pro 48GB | 219,800円 | RTX 4060 Ti 16GB + PC | 約120,000円 | NVIDIA(1.8×) |
| 32Bモデル | Mac Mini M4 Pro 48GB | 219,800円 | RTX 5090 32GB + PC | 約600,000円 | Apple(2.7×) |
| 70Bモデル | Mac Studio M5 Max 36GB | ~419,800円 | 2× RTX 4090 + PC | 約700,000円 | Apple(2.3×) |
| 96B+モデル | Mac Studio M5 Ultra 96GB | 5,499ドル | 4× A100 40GBサーバー | 約4,000,000円+ | Apple(7.3×) |
| 200B+モデル | Mac Studio M5 Ultra 256GB | 9,499ドル | 6× A100 40GBサーバー | 約6,000,000円+ | Apple(6.3×) |
💡ヒント: 32Bの分岐点が重要:RTX 5090(32GB)はカード単体で約450,000円+システム150,000円以上。Mac Mini M4 Pro 48GBは32Bを219,800円で全て込みで扱えます。
📌補足: 価格は2026年5月時点の近似値。NVIDIA GPU価格は在庫状況により変動。Apple価格は固定。
ソフトウェアエコシステム:NVIDIAが依然として優位
NVIDIAのCUDAエコシステムには15年の成熟度があります。すべての主要MLフレームワーク、推論サーバー、ファインチューニングツールがCUDA上でネイティブに動作します。Apple MLXは急速に成長していますが、推論のみに焦点を当てています。
📍 一文で説明
NVIDIA CUDAはPyTorch、vLLM、TensorRT-LLM、llama.cpp、Ollamaをネイティブにサポート;Apple MLXはmlx-lm、LM Studio、MLXバックエンド付きOllamaをサポート—macOSのみ。
💬 簡潔に説明
CUDAはMLのWindowsのようなもの—すべてがその上で動作する。MLXはmacOSのようなもの—洗練されて効率的だが、すべてのツールが利用可能なわけではなく、エコシステムを離れることができない。
Apple MLXエコシステム
- MLX — AppleのオープンソースMLフレームワーク、ネイティブMetal GPU加速
- mlx-lm — MLX用LLM推論ライブラリ
- LM Studio 0.3+ — macOSでMLXバックエンド利用可能
- Ollama — Apple Silicon用MLXバックエンド
- Jan.ai — macOSでMLXサポート
- Hugging Face mlx-community:2,000以上の事前量子化モデル(2026年5月)
- トレーニング:mlx-lm経由のLoRAファインチューニング(限定的)
- プラットフォーム:macOSのみ
NVIDIA CUDAエコシステム
- llama.cpp — 最も人気のオープンソース推論、CUDAバックエンド
- Ollama — CUDAバックエンド、クロスプラットフォーム
- vLLM — PagedAttentionによる本番推論
- TensorRT-LLM — NVIDIAの高スループット推論エンジン
- text-generation-webui — ローカルモデルのGUI
- PyTorch — ネイティブCUDA、事実上のML標準
- トレーニング:完全ファインチューニング、LoRA、QLoRA、RLHF — 完全なエコシステム
- プラットフォーム:Linux(最適)、Windows、Dockerコンテナ
⚠️注意: モデルのファインチューニングやトレーニングを計画している場合、NVIDIA CUDAが唯一の実用的な選択肢です。Apple MLXはmlx-lm経由でLoRAファインチューニングをサポートしていますが、Apple Siliconでの完全なパラメータファインチューニングとRLHFはまだ成熟していません。
OllamaをAppleとNVIDIA両方で使えますか?
はい。OllamaはApple Silicon(Metalバックエンド)とNVIDIA(CUDA)で動作します。同じコマンドが両方のプラットフォームで機能します。モデルファイルはプラットフォーム間で互換性があります。
消費電力と騒音:Appleが明確に優位
消費電力はApple Siliconの最も明確な優位点の1つです。1日8時間、30円/kWhで、M5 MaxとRTX 4090システムの差は年間15,000円以上になります。
📍 一文で説明
Mac Studio M4 MaxはローカルLLM負荷時25〜35W;RTX 4090システムは約450W—1日8時間、30円/kWhで年間約3,000円 vs 約39,600円の電力コスト。
💬 簡潔に説明
RTX 4090システムは年間の電力コストがいくつかのストリーミングサブスクリプションを合わせたより高くなります。Mac Studioは月300円未満で運用できます。
システム | ピーク消費電力 | 年間コスト(8時間/日、30円/kWh) | 騒音 |
|---|---|---|---|
| Mac Studio M4 Max | 25〜35W | 約3,000円/年 | 無音 |
| MacBook Pro M5 Max | 30〜40W | 約3,500円/年 | ほぼ無音 |
| RTX 3060システム | 約200W | 約17,500円/年 | ある程度のファン音 |
| RTX 4090システム | 約450W | 約39,600円/年 | 負荷時に大きい |
| RTX 5090システム | 約600W | 約52,800円/年 | 非常に大きい |
💡ヒント: ホームオフィスや寝室で作業する場合、騒音はコストと同じくらい重要です。Mac StudioはLLMを完全に無音で実行します。RTX 4090システムは数メートル離れても聞こえる能動冷却が必要です。
Apple MLXはNVIDIAより10倍効率的ですか?
継続的な推論時は概ねそうです。Mac Studio M4 Maxは25〜35Wを引き出すのに対し、RTX 4090システムは400〜500W。効率比はワークロードに応じて8〜15倍です。
ユースケース別推奨:どのシステムを選ぶか
適切なハードウェアはターゲットモデルサイズとワークフローに完全に依存します。これらは直接的で明確な推奨です。
📍 一文で説明
Apple Siliconを選ぶのは70B以上のモデル、無音動作、ポータブル推論のとき;NVIDIA CUDAを選ぶのは7〜14Bの最速スループット、トレーニング、マルチGPUスケーリング、または15万円以下の予算のとき。
💬 簡潔に説明
Llama 3 70Bをプライベートかつ手頃な価格で実行したいなら、今日Appleが唯一の現実的な選択肢です。最速の7Bアシスタントを15万円以下の予算で望むなら、NVIDIAが勝ります。
Apple Siliconを選ぶとき:
- "70Bモデルをプライベートに実行したい" → Mac Studio M5 Max 36GB(~419,800円)—唯一の手頃な単一デバイス選択肢
- "静かなホームオフィスLLMが欲しい" → 任意のMac Studio—完全推論負荷下で完全に無音
- "ラップトップで14B以上のモデルが必要" → MacBook Pro M5 Max—バッテリーでQwen 14B Q4_K_Mを実行
- "開発+推論+日常使用に1台のデバイスが欲しい" → 統合ワークステーションとしてのMac
- "電力代が重要" → Appleは推論セッションあたり8〜15倍少ない電力を使用
- "サーバーなしで96B以上のモデルが必要" → Mac Studio M5 Ultra 96GB 5,499ドル vs 400万円以上のサーバー。200B以上には256GB構成(9,499ドル)、どちらも2026年9月22日出荷開始
NVIDIA CUDAを選ぶとき:
- "予算15万円以下" → 中古RTX 3060 12GB + 格安PC(約80,000円)—最少の費用で最速の7B
- "7〜14B最大推論速度が必要" → RTX 4090の約150 tok/s vs M5 Maxの約75 tok/s
- "ファインチューニングやトレーニングを予定" → NVIDIAのみ:PyTorch、LoRA、QLoRA、RLHF、DPO
- "マルチGPUスケーリングが必要" → NVLinkが複数のRTXカードを接続;Apple相当品なし
- "Linuxで開発している" → CUDAエコシステムはLinuxネイティブ;MLXはmacOSのみ
- "最広のツール選択が必要" → vLLM、TensorRT-LLM、text-generation-webuiはすべてCUDA必須
💡ヒント: 最重要の質問:インタラクティブな速度で必要な最大のモデルは?70B以上ならAppleが自動的に勝ちます。7〜30Bなら予算に合わせて価格を比較してください。
ハイブリッドアプローチ:両方を使う
多くのパワーユーザーは両方を使用しています:ポータブル推論用のMacBookとトレーニング用のNVIDIAデスクトップ。OllamaのクロスプラットフォームサポートがこれをPracticalに—同じコマンド、同じモデルファイルが両システムで。
📍 一文で説明
一般的なパワーユーザー設定は、ポータブル14B推論用のMacBook Pro M5と、LoRAファインチューニングと高スループットバッチジョブ用のRTX 4090 Linuxワークステーション。
💬 簡潔に説明
モバイル時はMacを使用。夜間のファインチューニングランと大量サービングにはデスクトップGPUを使用。
- OllamaはAppleとNVIDIAで同一コマンドを実行—
ollama run llama3.2は両方で機能 - LM StudioはMLX(macOS)とCUDAバックエンドを同じインターフェースでサポート
- GGUFモデルファイル(llama.cpp形式)はクロスプラットフォーム;MLXモデルはAppleのみ
- 典型的なワークフロー分割:プライベート推論はMac、トレーニングとバッチ処理はNVIDIA
- LANサービング:NVIDIAサーバーでOllamaを実行し、Macからローカルネットワーク経由でアクセス
💡ヒント: 1システムしか購入できない場合:まずNVIDIAで7B作業(安い)から始め、70Bが必要になったらMac Studioにアップグレードしてください。両方の決断はそれぞれのレベルで成果を上げます。
今後の展望:2026〜2027年
両プラットフォームが急速に改善されています。2027年の主要な問題は、NVIDIAがコンシューマーカードに70Bモデルを収容できるだけのVRAMを搭載するか、またはAppleのユニファイドメモリの優位性が続くかです。
📍 一文で説明
Apple M6はユニファイドメモリ容量をさらに拡張すると予想;NVIDIAの次世代はコンシューマーVRAMを48GB以上に押し上げる可能性があり—大型モデルの優位性を大きく再均衡させるでしょう。
💬 簡潔に説明
2027年にNVIDIAが300万円の64GB VRAMのGPUを出荷すれば、70BレベルにおけるAppleの今日のコスト論拠は崩れます。AppleがM6を256GBのユニファイドメモリで出荷すれば、優位を拡大します。
Appleの方向性
- M6チップ:2027年予想、ユニファイドメモリ容量256GBまで噂
- MLXフレームワーク成熟:より広いトレーニングサポート、より多くのモデル互換性
- 逆トレンド:小さな効率的モデル(≤7B)が大きなものに追いつく—Appleの大型モデル優位を縮小
- コンテキストウィンドウ需要(128K+トークン)は引き続きVRAMよりユニファイドメモリを有利に
NVIDIAの方向性
- RTX 5090(32GB)—次世代は48〜64GB GDDR7という噂
- 48GB VRAMなら1枚のカードでLlama 3 70B Q4_K_Mを収容可能
- TensorRT-LLMとスペキュラティブデコーディングで継続的にスループット改善
- BlackwellコンシューマーカードはVRAM上限が高く2027年予想
💡ヒント: NVIDIAが3万円以下で48GB以上のコンシューマーカードをリリースしたらこの比較を再確認してください。今日のAppleの70B以上の優位性は現在の32GB VRAM上限に依存しています。
判定表:Apple vs NVIDIA 各要素別
この表を使用して、あなたのワークフローで最も重要なことに基づいて直接決定してください。
📍 一文で説明
Appleは11要素中5で勝利(大型モデル、70Bレベルのコスト、電力効率、騒音、ポータビリティ);NVIDIAは5で勝利(小型モデル速度、15万円以下のコスト、ソフトウェア、トレーニング、クロスプラットフォーム);1引き分け(将来性)。
要素 | 勝者 | 理由 |
|---|---|---|
| 大型モデル(70B+)推論 | Apple | Mac Studio M5 Max 36GB ~419,800円 vs 700,000円以上の2GPUシステム;RTX 5090 32GBも70B非対応 |
| 小型モデル(7〜14B)速度 | NVIDIA | RTX 4090:約150 tok/s vs M5 Max:約75 tok/s |
| 15万円以下のコスト | NVIDIA | RTX 3060 + PC 約80,000円 vs 最安Mac 159,800円 |
| 70Bモデルのコスト | Apple | Mac Studio M5 Max 36GB ~419,800円 vs 2× RTX 4090 + PC 約700,000円 |
| 電力効率 | Apple | 25〜35W vs 450W — 8〜15倍効率的 |
| 騒音 | Apple | 無音 vs うるさい能動冷却が必要 |
| ソフトウェアエコシステム | NVIDIA | CUDAがPyTorch、vLLM、TensorRT-LLM、全主要ツールを動かす |
| トレーニング / ファインチューニング | NVIDIA | PyTorch CUDAが標準;MLX LoRAは限定的 |
| ポータビリティ | Apple | MacBook Pro M5がバッテリーで14Bを実行;これに匹敵するNVIDIAラップトップなし |
| クロスプラットフォーム | NVIDIA | CUDAはLinux/Windowsで動作;MLXはmacOSのみ |
| 将来性 | 引き分け | Apple M6がメモリを拡張;NVIDIAがVRAMを押し上げ—両方が改善中 |

💡ヒント: 決定ルール:主要モデルが70B以上 → Appleを選ぶ。主要モデルが7〜30Bで予算30万円以下 → NVIDIAを選ぶ。
購入ガイド:ユースケース別推奨ハードウェア
これらは2026年5月現在の推奨される具体的なハードウェア選択肢と現在の円価格です。
低予算で7Bモデルに最適
RTX 3060 12GBを格安システムに搭載(合計約80,000円)。Llama 3 8B Q4_K_Mを約55 tok/sで実行—完全にインタラクティブ。
14Bモデルに最適
RTX 4060 Ti 16GB(約38,000円)でQwen 14B Q4_K_MをVRAMに完全収容し約58 tok/s。システム合計約100,000円。
70Bモデルに最適
Mac Studio M5 Max 36GB(~419,800円)。Llama 3 70B Q4_K_Mを使用可能な速度(約18 tok/s)で収容できる唯一の単一デバイス選択肢。
トレーニング + 高速推論に最適
RTX 4090 24GB(約275,000円)。7〜24Bモデルで最速の推論、かつ完全なPyTorchファインチューニングワークフローをサポート。
📌補足: PromptQuorumはこれらのリンクからコミッションを得ていません。Apple StoreとAmazonのリンクは参考価格として提供されています。購入前に必ず現在の価格を確認してください。
よくある質問
Apple MLXモデルをWindowsやLinuxで使えますか?
いいえ。MLXはmacOSのみでApple Siliconが必要です。llama.cpp経由のGGUFモデルはすべてのプラットフォームで動作します。クロスプラットフォームの使用には、GGUF形式のOllamaがMacとNVIDIAシステム両方で機能します。
OllamaはApple SiliconでMLXまたはMetalを使用しますか?
Apple SiliconのOllamaはデフォルトでMLXではなくMetal GPU加速を使用します。MLX特有の最適化には、mlx-lmを直接使用するか、MLXバックエンドを有効にしたLM Studioを使用してください。
70Bモデルを実行するための最低限のApple Macは何ですか?
64GBユニファイドメモリのMac Studio M4 Max(~419,800円)。Llama 3 70B Q4_K_Mは約38GB必要—64GB構成は十分な余裕で収容できます。
Apple M5 MaxはローカルLLMでRTX 4090より優れていますか?
モデルサイズによります。7B:RTX 4090が勝ち(150 tok/s vs 75 tok/s)。70B:M5 Max 128GBがデフォルトで勝ち—RTX 4090は70Bを全くロードできません。トレーニング:NVIDIAが大差で勝ち。
新しいApple M5 UltraはRTX 5090と比べてどうですか?
Appleは2026年8月25日にMac Studio M5 Ultraを発表しました—96GBユニファイドメモリで5,499ドルから(256GBは9,499ドル)。初期のベンチマークではLlama 3.3 70Bで約40〜52 tok/sを記録しており、これはRTX 5090の32GB VRAMではまったくロードできないモデルです。32GBに収まるモデルではRTX 5090がトークンあたりで依然として高速です。
ソースとさらなる読み物
- Apple MLX Framework — Apple Silicon用Metal GPU加速を備えたAppleのオープンソースMLフレームワークの公式リポジトリ。
- mlx-community — Hugging Face — 手動変換なしにApple Siliconで直接使用できる事前変換済みMLX形式モデル。
- llama.cpp — CUDA、Metal、CPUバックエンドを備えたクロスプラットフォームLLM推論。
- Mac Studio — Apple — M4 Max、M5 Max、M5 Ultraの仕様と価格(M5 Ultraは2026年8月25日発表)。
- Ollama — MLXおよびCUDAバックエンド経由でLlama、Mistral、Qwenモデルを実行するクロスプラットフォーム推論エンジン。
- LM Studio — Apple Silicon向けMLXバックエンドとNVIDIA向けCUDAバックエンドを備えたデスクトップGUI。
- NVIDIA GeForce GPU仕様 — RTX 4090およびRTX 5090のVRAM、メモリ帯域幅、TDP仕様。
- LLM量子化の解説 — Q4_K_M、Q8_0などの量子化形式の説明。
- ローカルLLMに必要なVRAM量 — モデルサイズ別のVRAM要件。
- ローカルLLM向け低価格GPU — RTX 3060 12GBと低価格オプション。
- Apple Silicon LLMガイド2026 — M1からM5 Maxのセットアップガイド。
- LM Studio vs Jan vs GPT4All 2026 — デスクトップGUIアプリ比較。
- GPU vs CPU vs Apple Silicon — 3種類のハードウェアの概要。
- LoRAによるファインチューニング — コンシューマーハードウェアでのLoRAトレーニング。
- コーディング向けベストローカルLLM — コード生成のモデル推奨。