Principais conclusões
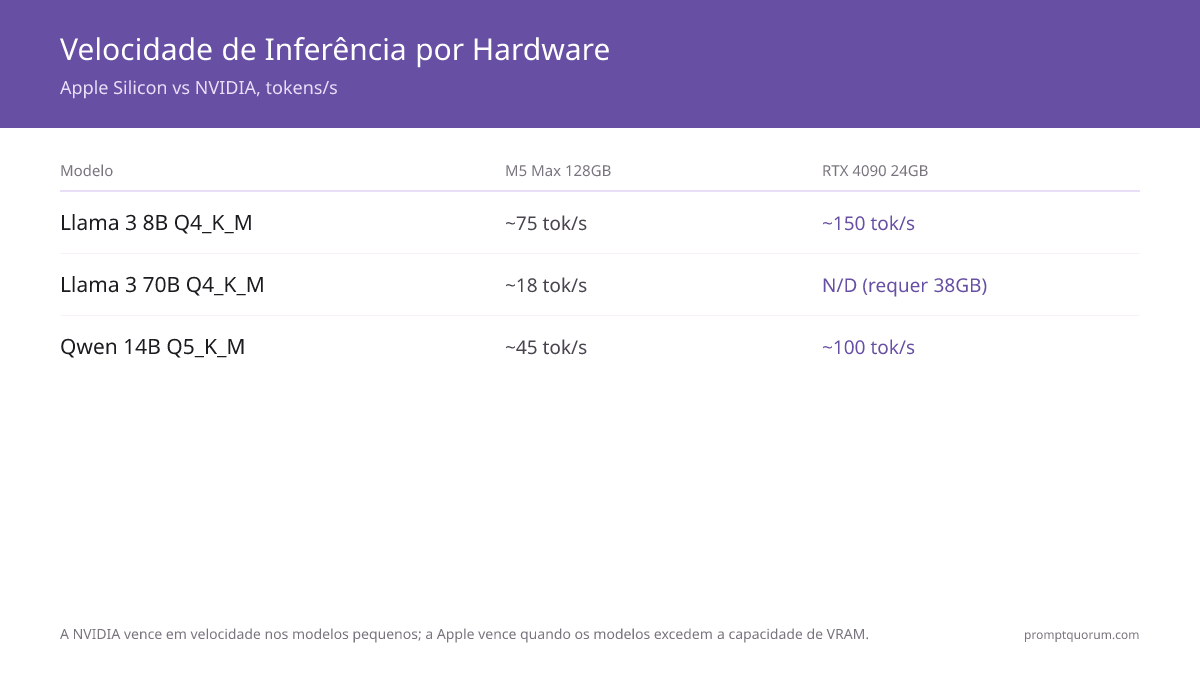
- M5 Max 128GB: ~75 tok/s Llama 3 8B Q4_K_M; ~18 tok/s Llama 3 70B Q4_K_M (cabe na memória)
- RTX 4090 24GB: ~150 tok/s Llama 3 8B; Llama 3 70B não cabe (precisa de ~38GB de VRAM)
- Custo para capacidade de 70B: Mac Studio M5 Max 36GB ~$2,499 vs sistema 2× RTX 4090 ~$7,000
- Energia: Apple 25–35W; sistema RTX 4090 ~450W — diferença de cerca de 10× por sessão
- Software: NVIDIA domina (CUDA, PyTorch, vLLM, TensorRT-LLM); Apple em crescimento (MLX, mlx-lm)
- Treinamento/fine-tuning: NVIDIA é a única opção viável para cargas de trabalho sérias
- Portabilidade: o MacBook Pro M5 roda modelos de 14B na bateria; nenhum laptop NVIDIA é comparável
📍 Em uma frase
A Apple MLX vence na inferência de modelos de 70B ou mais e na eficiência energética; a NVIDIA CUDA vence na velocidade bruta de inferência para modelos de 7–14B e no ecossistema de treinamento.
💬 Em termos simples
O Apple Silicon é um híbrido elétrico com um porta-malas enorme — consome pouca energia e carrega modelos gigantes. A NVIDIA é um carro esportivo — rapidíssimo, mas só para carga pequena, e consome muito combustível.
📌Nota: Os números de benchmark vêm de testes da comunidade (maio de 2026) e são aproximados ±10–15%. Os resultados variam conforme a quantização, o comprimento de contexto e a carga do sistema.
Por que esta comparação importa em 2026
O Apple Silicon M5 chegou com até 128GB de memória unificada — tornando a inferência de modelos grandes viável em um Mac pela primeira vez a preços de consumidor. A RTX 5090 da NVIDIA chegou com 32GB de VRAM GDDR7 por $3,949. Duas arquiteturas fundamentalmente diferentes agora competem para rodar os mesmos modelos de código aberto.
📍 Em uma frase
Em 2026, o Apple Silicon e as GPUs discretas da NVIDIA representam duas filosofias de hardware completamente diferentes para rodar grandes modelos de linguagem localmente.
💬 Em termos simples
Com a Apple, CPU, GPU e RAM compartilham o mesmo pool de memória — um Mac Studio de 128GB pode carregar um modelo de 70B de uma só vez. A NVIDIA usa VRAM separada; uma única RTX 4090 (24GB) não consegue carregar um modelo de 70B de jeito nenhum.
- Apple M5 Max: até 128GB de memória unificada compartilhada entre CPU e GPU
- NVIDIA RTX 5090: 32GB GDDR7 por $3,949 — a GPU discreta de consumidor mais rápida
- Llama 3 70B em quantização Q4_K_M precisa de ~38GB de memória
- Na Apple: um dispositivo dá conta. Na NVIDIA: são necessárias 2× RTX 4090 ou descarregamento na CPU
💡Dica: Escolha Apple MLX se seus modelos alvo tiverem 40B ou mais parâmetros. Escolha NVIDIA CUDA para o máximo de tokens por segundo em modelos de 7–14B ou se você precisar fazer fine-tuning.
Diferenças de arquitetura que mudam tudo
O Apple Silicon e as GPUs NVIDIA são construídos em torno de arquiteturas de memória fundamentalmente diferentes. Essa única diferença — memória compartilhada versus dedicada — determina quais modelos você pode rodar e a que velocidade.
📍 Em uma frase
O Apple Silicon usa memória unificada compartilhada entre CPU, GPU e Neural Engine; a NVIDIA usa VRAM GDDR7 dedicada na placa da GPU, conectada pelo barramento PCIe.
💬 Em termos simples
A NVIDIA tem dois bancos separados — RAM do sistema e VRAM da GPU. Mover dados entre eles é lento. A Apple tem um único banco compartilhado por tudo — sem cópias, sem gargalo.
Apple Silicon: arquitetura de memória unificada
O M5 Max integra núcleos de CPU, GPU e um Neural Engine em um único chip. Todas as unidades de processamento leem do mesmo pool de memória. Um M5 Max com 128GB tem 128GB disponíveis simultaneamente para CPU e GPU — sem limite de VRAM, sem gargalo de transferência.
- Largura de banda de memória do M5 Max: 614 GB/s (mesmo pool para CPU + GPU)
- Operações de tensor sem cópia — sem barramento PCIe entre CPU e GPU
- Neural Engine: 38 TOPS para operações de ML aceleradas
- Llama 3 70B Q4_K_M (~38GB) cabe em configurações de 64GB ou 128GB
- Configurações: 64GB (Mac Studio M4 Max ~$2,499) — recomendado para Llama 3 70B
NVIDIA: VRAM dedicada + barramento PCIe
As GPUs NVIDIA têm VRAM GDDR7 dedicada na placa. A RAM do sistema é separada. Quando um modelo excede a VRAM, o llama.cpp precisa descarregar camadas para a RAM do sistema — o que é de 10 a 20× mais lento para essas camadas. É por isso que um modelo de 70B em uma RTX 4090 de 24GB roda a 3–5 tok/s (descarregamento na CPU) em vez de 150 tok/s (VRAM pura).
- RTX 5090: 32GB GDDR7 com 1.792 GB/s de largura de banda de memória
- RTX 4090: 24GB GDDR6X a 1.008 GB/s
- Barramento PCIe 4.0 ×16: ~32 GB/s de pico (gargalo para descarregamento de modelos grandes)
- Llama 3 70B Q4_K_M precisa de ~38GB — excede uma única RTX 4090 (24GB)
- São necessárias 2× RTX 4090 com NVLink para alojar o 70B completo na VRAM
Comparativo de largura de banda de memória
Na inferência com LLMs, a largura de banda de memória determina diretamente os tokens por segundo. Os pesos do modelo precisam ser lidos da memória a cada token gerado.
- RTX 5090: 1.792 GB/s — 32GB GDDR7 (maior largura de banda, GPU discreta)
- RTX 4090: 1.008 GB/s — 24GB GDDR6X (amplamente disponível, comprovada)
- RTX 4070 Ti Super: 672 GB/s — 16GB GDDR6X (média-alta NVIDIA)
- Apple M5 Max: 614 GB/s — até 128GB (pool compartilhado CPU+GPU)
- Apple M5 Pro: 273 GB/s — até 48GB (opção MacBook/Mac Mini)

💡Dica: A NVIDIA vence em largura de banda bruta por dólar; a Apple vence em capacidade total de memória. Para LLMs, a memória total determina quais modelos cabem; a largura de banda determina a velocidade dentro dessa restrição.
O Apple Silicon consegue igualar a largura de banda de memória da NVIDIA?
Não — a RTX 4090 tem 1.008 GB/s vs o Apple M5 Max a 614 GB/s. A Apple compensa com capacidade de memória muito maior (128GB vs 24GB). Para modelos pequenos em que a VRAM é suficiente, a NVIDIA vence em velocidade. Para modelos grandes que excedem a VRAM, a Apple vence em capacidade.
Benchmarks de desempenho: tokens por segundo por modelo
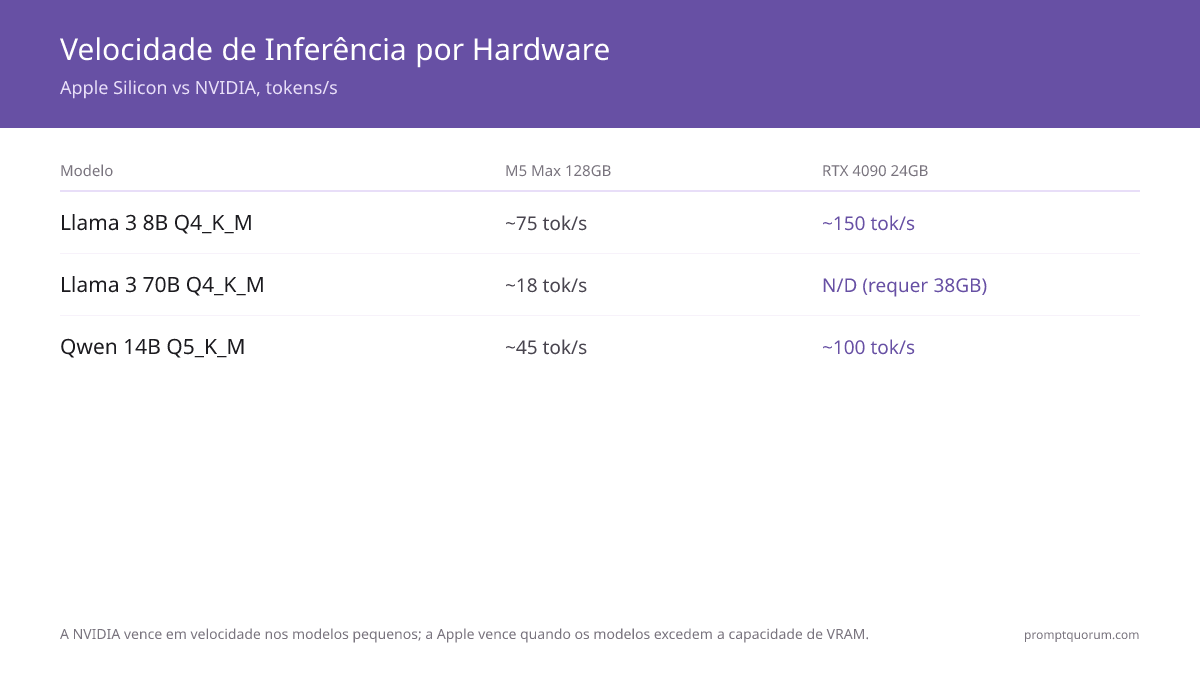
A velocidade de inferência é medida em tokens por segundo (tok/s) — quanto maior, melhor para uso interativo. A NVIDIA domina na velocidade de modelos pequenos; a Apple vence quando os modelos excedem a capacidade de VRAM.
📍 Em uma frase
A RTX 4090 alcança ~150 tok/s no Llama 3 8B Q4_K_M; o Apple M5 Max 128GB roda ~75 tok/s no mesmo modelo, mas também executa o Llama 3 70B a ~18 tok/s, o que a RTX 4090 não consegue alojar.
💬 Em termos simples
A RTX 4090 é duas vezes mais rápida para um modelo de 7B, mas fisicamente não consegue carregar um modelo de 70B. O M5 Max é mais lento em modelos pequenos, mas pode rodar os grandes que nenhuma placa NVIDIA individual consegue lidar.
Model | M5 Max 128GB | M5 Pro 48GB | RTX 5090 32GB | RTX 4090 24GB | RTX 4070 Ti S. 16GB | RTX 3060 12GB |
|---|---|---|---|---|---|---|
| Llama 3 8B Q4_K_M | ~75 tok/s | ~65 tok/s | ~145 tok/s | ~150 tok/s | ~95 tok/s | ~55 tok/s |
| Llama 3 70B Q4_K_M | ~18 tok/s ✓ | N/A (precisa de 38GB) | N/A (32GB < 38GB necessários) | N/A (precisa de 38GB) | N/A | N/A |
| Qwen 14B Q5_K_M | ~45 tok/s | ~38 tok/s | ~130 tok/s | ~100 tok/s | ~58 tok/s | N/A (limite de 12GB) |
| Mixtral 8×7B Q4_K_M | ~22 tok/s | ~15 tok/s | ~95 tok/s ✓ | ~65 tok/s | N/A (precisa de ~26GB) | N/A |
| Llama 3 8B Q8_0 | ~55 tok/s | ~45 tok/s | ~165 tok/s | ~110 tok/s | ~65 tok/s | N/A (precisa de ~9GB) |
📌Nota: Benchmarks obtidos de testes da comunidade no mlx-community e no llama.cpp, maio de 2026. Aproximados ±10–15%. Execute o llama-bench no seu hardware para números exatos.
💡Dica: Use o Llama 3 8B Q4_K_M como benchmark de referência — é o modelo mais testado e oferece comparações confiáveis entre hardwares.
18 tok/s no Llama 3 70B é rápido o suficiente para uso interativo?
Sim, para a maioria das tarefas. 18 tok/s geram uma resposta de 500 palavras em cerca de 20–25 segundos. O uso interativo com qualidade de 70B que antes exigia um servidor de mais de $40,000 agora está disponível em um Mac Studio M5 Max de ~$2,499.
Por que a NVIDIA é mais rápida em modelos pequenos?
A largura de banda GDDR7/GDDR6X da NVIDIA (1.008–1.792 GB/s) supera a do Apple M5 Max (614 GB/s). A inferência com LLMs é limitada pela largura de banda de memória — maior largura de banda roda modelos pequenos mais rápido. A vantagem da Apple é a capacidade de memória, não a largura de banda.
Comparativo de custos: custo total do sistema por tamanho de modelo
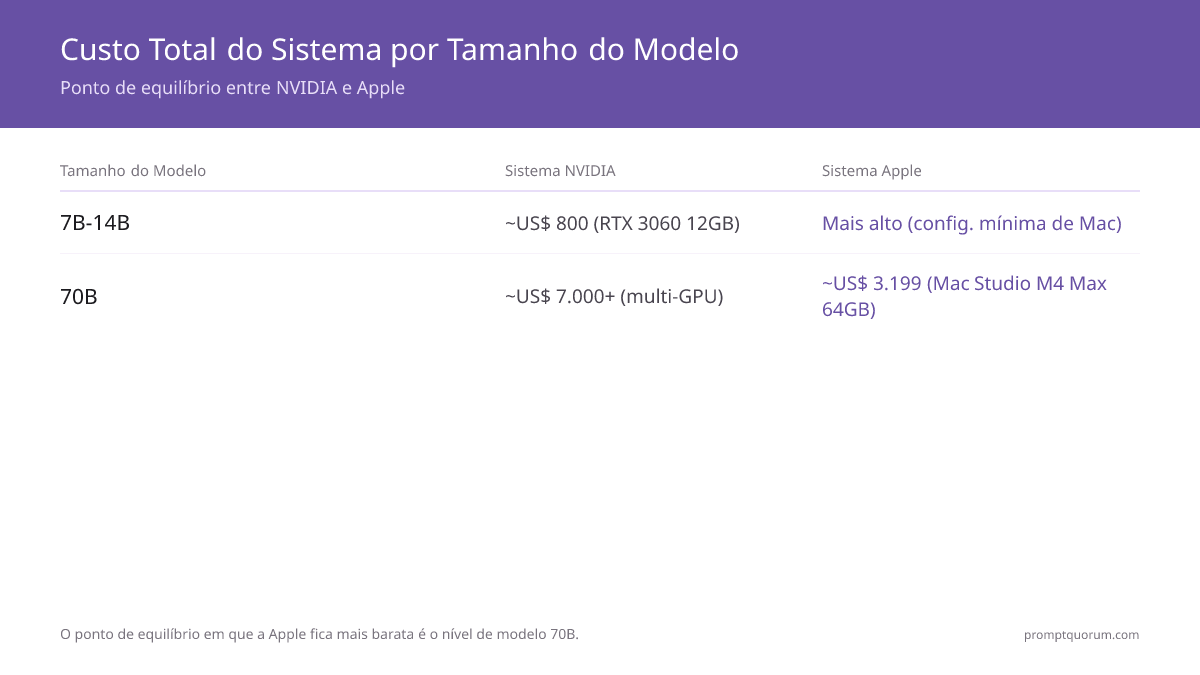
O custo total do sistema inclui a placa GPU mais o PC para a NVIDIA; apenas o Mac para a Apple. O ponto de cruzamento em que a Apple fica mais barata é o nível dos modelos de 70B.
📍 Em uma frase
A NVIDIA é mais barata para modelos de 7–14B (RTX 3060 12GB + PC ~$800); a Apple é mais barata para modelos de 70B (Mac Studio M5 Max 36GB ~$2,499 vs sistema 2× RTX 4090 ~$7,000).
💬 Em termos simples
Modelos pequenos favorecem a NVIDIA (compre uma GPU, plugue e use). Modelos grandes favorecem a Apple (um dispositivo em vez de duas placas de vídeo mais um PC personalizado inteiro).
Modelo alvo | Opção Apple | Custo Apple | Opção NVIDIA | Custo NVIDIA | Mais barato |
|---|---|---|---|---|---|
| Modelos 7B | Mac Mini M4 24GB | $1,599 | RTX 3060 12GB + PC | ~$800 | NVIDIA (2×) |
| Modelos 14B | Mac Mini M4 Pro 48GB | $2,199 | RTX 4060 Ti 16GB + PC | ~$1,200 | NVIDIA (1.8×) |
| Modelos 32B | Mac Mini M4 Pro 48GB | $2,199 | RTX 5090 32GB + PC | ~$5,500 | Apple (2.5×) |
| Modelos 70B | Mac Studio M5 Max 36GB | ~$2,499 | 2× RTX 4090 + PC | ~$7,000 | Apple (2.2×) |
| Modelos 96B+ | Mac Studio M5 Ultra 96GB | $5,499 | Servidor 4× A100 40GB | ~$40,000+ | Apple (7.3×) |
| Modelos 200B+ | Mac Studio M5 Ultra 256GB | $9,499 | Servidor 6× A100 40GB | ~$60,000+ | Apple (6.3×) |
💡Dica: O ponto de inflexão em 32B é fundamental: a RTX 5090 de 32GB custa ~$3,949 só pela placa mais $1,500+ pelo sistema. O Mac Mini M4 Pro de 48GB lida com 32B por $2,199 no total. Para builds econômicos, veja as melhores GPUs econômicas para LLMs locais.
📌Nota: Preços aproximados de maio de 2026. Os preços das GPUs NVIDIA flutuam conforme a disponibilidade. Os preços da Apple são fixos.
Ecossistema de software: a NVIDIA ainda domina
O ecossistema CUDA da NVIDIA tem 15 anos de maturidade. Todo framework de ML, servidor de inferência e ferramenta de fine-tuning relevante roda nativamente em CUDA. A MLX da Apple cresce rapidamente, mas continua focada apenas em inferência.
📍 Em uma frase
A NVIDIA CUDA suporta PyTorch, vLLM, TensorRT-LLM, llama.cpp e Ollama nativamente; a Apple MLX suporta mlx-lm, LM Studio e Ollama com o backend MLX — apenas macOS.
💬 Em termos simples
O CUDA é como o Windows para ML — tudo roda nele. A MLX é como o macOS — polida e eficiente, mas nem toda ferramenta está disponível e você não pode sair do ecossistema.
Ecossistema Apple MLX
- MLX — framework de ML de código aberto da Apple, aceleração GPU Metal nativa
- mlx-lm — biblioteca de inferência de LLM para MLX
- LM Studio 0.3+ — backend MLX disponível no macOS
- Ollama — backend MLX para Apple Silicon
- Jan.ai — suporte a MLX no macOS
- mlx-community no Hugging Face: mais de 2.000 modelos pré-quantizados (maio de 2026)
- Treinamento: fine-tuning LoRA via mlx-lm (escopo limitado)
- Plataforma: apenas macOS
Ecossistema NVIDIA CUDA
- llama.cpp — inferência de código aberto mais popular, backend CUDA
- Ollama — backend CUDA, multiplataforma
- vLLM — inferência em produção com PagedAttention
- TensorRT-LLM — o motor de inferência de maior throughput da NVIDIA
- text-generation-webui — GUI para modelos locais
- PyTorch — CUDA nativo, padrão de fato em ML
- Treinamento: fine-tuning completo, LoRA, QLoRA, RLHF — ecossistema completo
- Plataforma: Linux (melhor), Windows, contêineres Docker
⚠️Aviso: Se você planeja fazer fine-tuning ou treinar modelos, a NVIDIA CUDA é a única escolha prática. A Apple MLX suporta fine-tuning LoRA via mlx-lm, mas o fine-tuning de parâmetros completos, RLHF e DPO ainda não estão maduros no Apple Silicon.
💡Dica: A maioria dos modelos no Hugging Face agora tem variantes tanto em GGUF (multiplataforma) quanto em formato MLX. A organização mlx-community fornece modelos pré-quantizados, então nenhuma conversão manual é necessária.
Posso usar o Ollama tanto na Apple quanto na NVIDIA?
Sim. O Ollama roda no Apple Silicon (backend Metal) e na NVIDIA (CUDA). Os mesmos comandos funcionam em ambos. Os arquivos de modelo são compatíveis entre as plataformas.
O llama.cpp roda no Apple Silicon?
Sim — o llama.cpp tem aceleração GPU Metal nativa no Apple Silicon. Para otimizações específicas de MLX, use o mlx-lm ou o LM Studio com o backend MLX habilitado.
Consumo de energia e ruído: a Apple vence de forma decisiva
O consumo de energia é uma das vantagens mais claras do Apple Silicon. Rodando 8 horas por dia a $0.15/kWh, a diferença entre um M5 Max e um sistema RTX 4090 ultrapassa os $220 por ano.
📍 Em uma frase
O Mac Studio M4 Max usa 25–35W rodando LLMs locais; um sistema RTX 4090 usa ~450W — resultando em ~$22 vs ~$248 de custo anual de eletricidade a 8 horas/dia, $0.15/kWh.
💬 Em termos simples
O sistema RTX 4090 custa mais em eletricidade por ano do que a maioria das assinaturas de streaming juntas. O Mac Studio custa menos de $2 por mês para operar.
Sistema | Potência de pico sob carga | Custo anual (8h/dia, $0.15/kWh) | Ruído |
|---|---|---|---|
| Mac Studio M4 Max | 25–35W | ~$22/ano | Silencioso |
| MacBook Pro M5 Max | 30–40W | ~$26/ano | Quase silencioso |
| Sistema RTX 3060 | ~200W | ~$110/ano | Ruído moderado de ventoinha |
| Sistema RTX 4090 | ~450W | ~$248/ano | Barulhento sob carga |
| Sistema RTX 5090 | ~600W | ~$329/ano | Muito barulhento |
💡Dica: Se você trabalha em um home office ou quarto, o ruído importa tanto quanto o custo. O Mac Studio roda LLMs em silêncio absoluto. Os sistemas RTX 4090 exigem resfriamento ativo audível a vários metros de distância.
A Apple MLX é 10× mais eficiente que a NVIDIA?
Aproximadamente sim, sob inferência contínua. O Mac Studio M4 Max consome 25–35W vs um sistema RTX 4090 a 400–500W. A razão de eficiência é de 8–15× dependendo da carga de trabalho. Em repouso, os sistemas NVIDIA reduzem o consumo, diminuindo a diferença.
Recomendações por caso de uso: qual sistema escolher
O hardware certo depende inteiramente do tamanho do modelo alvo e do fluxo de trabalho. Estas são recomendações diretas e sem ambiguidade.
📍 Em uma frase
Escolha Apple Silicon para modelos de 70B+, operação silenciosa ou inferência portátil; escolha NVIDIA CUDA para o maior throughput em 7–14B, treinamento, escalonamento multi-GPU ou orçamentos abaixo de $1,000.
💬 Em termos simples
Se você quer rodar o Llama 3 70B de forma privada e acessível, a Apple é sua única opção real hoje. Se você quer o assistente 7B mais rápido com orçamento abaixo de $1,500, a NVIDIA vence.
Escolha Apple Silicon quando:
- "Quero rodar modelos de 70B de forma privada" → Mac Studio M5 Max 36GB (~$2,499) — única opção acessível em um único dispositivo
- "Quero um LLM silencioso para o home office" → Qualquer Mac Studio — completamente silencioso sob carga total de inferência
- "Preciso de modelos de 14B+ em um laptop" → MacBook Pro M5 Max — roda Qwen 14B Q4_K_M na bateria
- "Quero um dispositivo para desenvolvimento + inferência + uso diário" → Mac como estação de trabalho unificada
- "A conta de luz importa" → a Apple usa de 8 a 15× menos eletricidade por sessão de inferência
- "Preciso de modelos de 96B+ sem servidor" → Mac Studio M5 Ultra 96GB por $5,499 vs servidor de $40,000+; a configuração de 256GB ($9,499) cobre modelos de 200B+, ambas com envio a partir de 22 de setembro de 2026
Escolha NVIDIA CUDA quando:
- "Orçamento abaixo de $1,000" → RTX 3060 12GB usada + PC econômico (~$800) — o 7B mais rápido pelo menor preço
- "Preciso da máxima velocidade de inferência em 7–14B" → RTX 4090 a ~150 tok/s supera o M5 Max a ~75 tok/s
- "Planejo fazer fine-tuning ou treinar" → Apenas NVIDIA: PyTorch, LoRA, QLoRA, RLHF, DPO
- "Preciso escalar com múltiplas GPUs" → o NVLink conecta várias placas RTX; sem equivalente na Apple
- "Desenvolvo no Linux" → o ecossistema CUDA é nativo do Linux; a MLX é apenas macOS
- "Preciso da maior seleção de ferramentas" → vLLM, TensorRT-LLM e text-generation-webui exigem CUDA
💡Dica: A pergunta mais importante: qual é o maior modelo que você precisa rodar em velocidade interativa? Se for 70B ou maior, a Apple vence automaticamente. Se for 7–30B, compare preços conforme o seu orçamento.
A abordagem híbrida: usar os dois
Muitos usuários avançados usam ambos: um MacBook para inferência portátil e um desktop NVIDIA para treinamento. O suporte multiplataforma do Ollama torna isso prático — os mesmos comandos e os mesmos arquivos de modelo em ambos os sistemas.
📍 Em uma frase
Uma configuração comum de usuário avançado é um MacBook Pro M5 para inferência portátil de 14B mais uma workstation Linux com RTX 4090 para fine-tuning LoRA e trabalhos em lote de alto throughput.
💬 Em termos simples
Use o Mac quando estiver em movimento. Use a GPU de desktop para rodadas de fine-tuning durante a noite e atendimento de alto volume.
- O Ollama executa comandos idênticos na Apple e na NVIDIA —
ollama run llama3.2funciona em ambos - O LM Studio suporta os backends MLX (macOS) e CUDA a partir da mesma interface
- Os arquivos de modelo GGUF (formato llama.cpp) são multiplataforma; os modelos MLX são apenas da Apple
- Divisão típica do fluxo de trabalho: Mac para inferência privada, NVIDIA para treinamento e processamento em lote
- Atendimento via LAN: rode o Ollama no servidor NVIDIA e acesse a partir do Mac pela rede local
💡Dica: Se você só pode pagar por um sistema: comece com NVIDIA para trabalho com 7B (mais barato), faça upgrade para o Mac Studio quando precisar de 70B. Ambas as decisões compensam no nível correspondente.
Perspectivas futuras: 2026–2027
Ambas as plataformas estão melhorando rapidamente. A questão central para 2027 é se a NVIDIA vai colocar VRAM suficiente nas placas de consumidor para alojar modelos de 70B, ou se a vantagem de memória unificada da Apple vai persistir.
📍 Em uma frase
Espera-se que o Apple M6 amplie ainda mais a capacidade de memória unificada; a próxima geração da NVIDIA pode ultrapassar os 48GB de VRAM para consumidor — o que reequilibraria significativamente a vantagem em modelos grandes.
💬 Em termos simples
Se a NVIDIA lançar uma GPU de $3,000 com 64GB de VRAM em 2027, o argumento de custo da Apple no nível de 70B desmorona. Se a Apple lançar o M6 com 256GB de memória unificada, ela amplia a vantagem.
Trajetória da Apple
- Chip M6: esperado em 2027, capacidade de memória unificada rumores de até 256GB
- Framework MLX amadurecendo: maior suporte a treinamento, mais compatibilidade de modelos
- Contratendência: modelos eficientes menores (≤7B) igualando os maiores — reduz a vantagem da Apple em modelos grandes
- A demanda por janela de contexto (128K+ tokens) ainda favorece a memória unificada sobre a VRAM
Trajetória da NVIDIA
- RTX 5090 a 32GB — a próxima geração tem rumores de 48–64GB GDDR7
- 48GB de VRAM permitiriam alojar o Llama 3 70B Q4_K_M em uma única placa
- TensorRT-LLM e decodificação especulativa melhoram continuamente o throughput
- Placas Blackwell para consumidor esperadas em 2027 com maior teto de VRAM
💡Dica: Reveja esta comparação se a NVIDIA lançar uma placa de consumidor de 48GB+ por menos de $3,000. A vantagem atual da Apple para 70B+ depende do teto atual de 32GB de VRAM.
Tabela de veredito: Apple vs NVIDIA fator a fator
Use esta tabela para tomar uma decisão direta com base no que mais importa para o seu fluxo de trabalho.
📍 Em uma frase
A Apple vence 5 dos 11 fatores (modelos grandes, custo no nível de 70B, eficiência energética, ruído, portabilidade); a NVIDIA vence 5 (velocidade em modelos pequenos, custo abaixo de $1K, software, treinamento, multiplataforma); 1 empate (preparação para o futuro).
Fator | Vencedor | Por quê |
|---|---|---|
| Inferência de modelos grandes (70B+) | Apple | Mac Studio M5 Max 36GB ~$2,499 vs sistema de duas GPUs a mais de $7,000 |
| Velocidade em modelos pequenos (7–14B) | NVIDIA | RTX 4090: ~150 tok/s vs M5 Max: ~75 tok/s |
| Custo abaixo de $1,000 | NVIDIA | RTX 3060 + PC ~$800 vs Mac mais barato $1,599 |
| Custo para modelos 70B | Apple | Mac Studio M5 Max 36GB ~$2,499 vs 2× RTX 4090 + PC ~$7,000 |
| Eficiência energética | Apple | 25–35W vs 450W — 8–15× mais eficiente |
| Ruído | Apple | Silencioso vs resfriamento ativo barulhento necessário |
| Ecossistema de software | NVIDIA | O CUDA impulsiona PyTorch, vLLM, TensorRT-LLM, todas as principais ferramentas |
| Treinamento / fine-tuning | NVIDIA | PyTorch CUDA é o padrão; o LoRA da MLX é limitado |
| Portabilidade | Apple | MacBook Pro M5 roda 14B na bateria; nenhum laptop NVIDIA é comparável |
| Multiplataforma | NVIDIA | CUDA no Linux/Windows; a MLX é apenas macOS |
| Preparação para o futuro | Empate | Apple M6 ampliando a memória; NVIDIA empurrando a VRAM — ambos melhorando |
💡Dica: Regra de decisão: modelo principal de 70B ou maior → escolha Apple. Modelo principal de 7–30B e orçamento abaixo de $3,000 → escolha NVIDIA.
Guia de compra: hardware recomendado por caso de uso
Estas são as escolhas de hardware específicas que recomendamos em maio de 2026, com preços atuais.
Melhor opção para modelos 7B com orçamento limitado
RTX 3060 12GB em um sistema econômico (~$800 no total). Roda o Llama 3 8B Q4_K_M a ~55 tok/s — totalmente interativo.
Melhor opção para modelos 14B
RTX 4060 Ti 16GB (~$424) aloja o Qwen 14B Q4_K_M totalmente na VRAM a ~58 tok/s. Sistema total ~$1,200.
Melhor opção para modelos 70B
Mac Studio M5 Max 36GB (~$2,499). A única opção em um único dispositivo que aloja o Llama 3 70B Q4_K_M em velocidade utilizável (~18 tok/s).
Melhor opção para treinamento + inferência rápida
RTX 4090 24GB (~$2,755 novo / ~$2,268 usado). A inferência mais rápida em modelos de 7–24B E suporta fluxos de trabalho completos de fine-tuning com PyTorch.
📌Nota: A PromptQuorum não recebe comissão destes links. Os links da Apple Store e da Amazon são fornecidos como referência de preço. Sempre verifique os preços atuais antes de comprar.
Perguntas frequentes
Posso rodar modelos Apple MLX no Windows ou Linux?
Não. A MLX é apenas para macOS e exige Apple Silicon. Os modelos GGUF via llama.cpp funcionam em todas as plataformas. Para uso multiplataforma, o Ollama com formato GGUF funciona tanto no Mac quanto em sistemas NVIDIA.
O Ollama usa MLX ou Metal no Apple Silicon?
O Ollama no Apple Silicon usa aceleração GPU Metal por padrão, não MLX. Para otimizações específicas de MLX (muitas vezes mais rápidas para certos modelos), use o mlx-lm diretamente ou o LM Studio com o backend MLX habilitado.
Posso usar uma eGPU com um Mac para NVIDIA CUDA?
Não. O macOS removeu o suporte a eGPU CUDA em 2019. GPUs NVIDIA externas não são compatíveis com o macOS para processamento CUDA. A alternativa prática é um sistema Linux separado com uma GPU NVIDIA.
Qual é melhor para rodar o Mistral Small?
NVIDIA RTX 4090 a ~150 tok/s vs Apple M5 Max a ~75 tok/s — a NVIDIA é 2× mais rápida. Até uma RTX 3060 12GB (~$280 usada) supera um Mac Mini M4 ($1,599) em pura velocidade de inferência com 7B.
Qual é o Mac mínimo para rodar modelos de 70B?
Mac Studio M5 Max com 36GB de memória unificada (~$2,499). O Llama 3 70B Q4_K_M precisa de ~38GB — a configuração de 64GB oferece margem suficiente para os pesos mais o contexto.
O Apple M5 Max é melhor que a RTX 4090 para LLMs locais?
Depende do tamanho do modelo. Para 7B: a RTX 4090 vence (150 tok/s vs 75 tok/s). Para 70B: o M5 Max 128GB vence por padrão — a RTX 4090 não consegue carregar 70B de jeito nenhum. Para treinamento: a NVIDIA vence por uma ampla margem.
Como o novo Apple M5 Ultra se compara à RTX 5090?
A Apple anunciou o Mac Studio com M5 Ultra em 25 de agosto de 2026 — a partir de $5.499 por 96GB de memória unificada (256GB por $9.499). Números iniciais mostram ~40–52 tok/s no Llama 3.3 70B, um modelo que os 32GB de VRAM da RTX 5090 não conseguem carregar de jeito nenhum. Para modelos que cabem em 32GB, a RTX 5090 ainda é mais rápida por token.
Fontes e leituras adicionais
- Apple MLX Framework — Framework de ML de código aberto oficial da Apple com aceleração GPU Metal para Apple Silicon.
- mlx-community no Hugging Face — Modelos em formato MLX pré-convertidos para uso direto no Apple Silicon.
- llama.cpp — Inferência de LLM multiplataforma com backends CUDA, Metal e CPU; inclui o llama-bench para benchmarking de hardware.
- Mac Studio — Apple — Especificações e preços do M4 Max, M5 Max e M5 Ultra (M5 Ultra anunciado em 25 de agosto de 2026).
- Ollama — Motor de inferência multiplataforma para modelos Llama, Mistral e Qwen via backends MLX e CUDA.
- LM Studio — GUI de desktop com backend MLX nativo para Apple Silicon e backend CUDA para GPUs NVIDIA.
- Especificações de GPU NVIDIA GeForce — VRAM, largura de banda de memória e TDP das RTX 4090 e RTX 5090.
- Quantização de LLMs explicada — Formatos Q4_K_M, Q8_0 e outros explicados.
- Quanta VRAM para LLMs locais — Requisitos de VRAM por tamanho de modelo.
- As melhores GPUs econômicas para LLMs locais — RTX 3060 12GB e opções mais econômicas.
- Guia de Apple Silicon para LLMs locais 2026 — Guia de configuração do M1 ao M5 Max.
- LM Studio vs Jan vs GPT4All 2026 — Comparativo de aplicativos GUI de desktop.
- GPU vs CPU vs Apple Silicon — Panorama de hardware em três frentes.
- Fine-Tuning de LLMs locais com LoRA — Treinamento LoRA em hardware de consumidor.
- Melhores LLMs locais para programação — Recomendações de modelos para geração de código.