关键要点
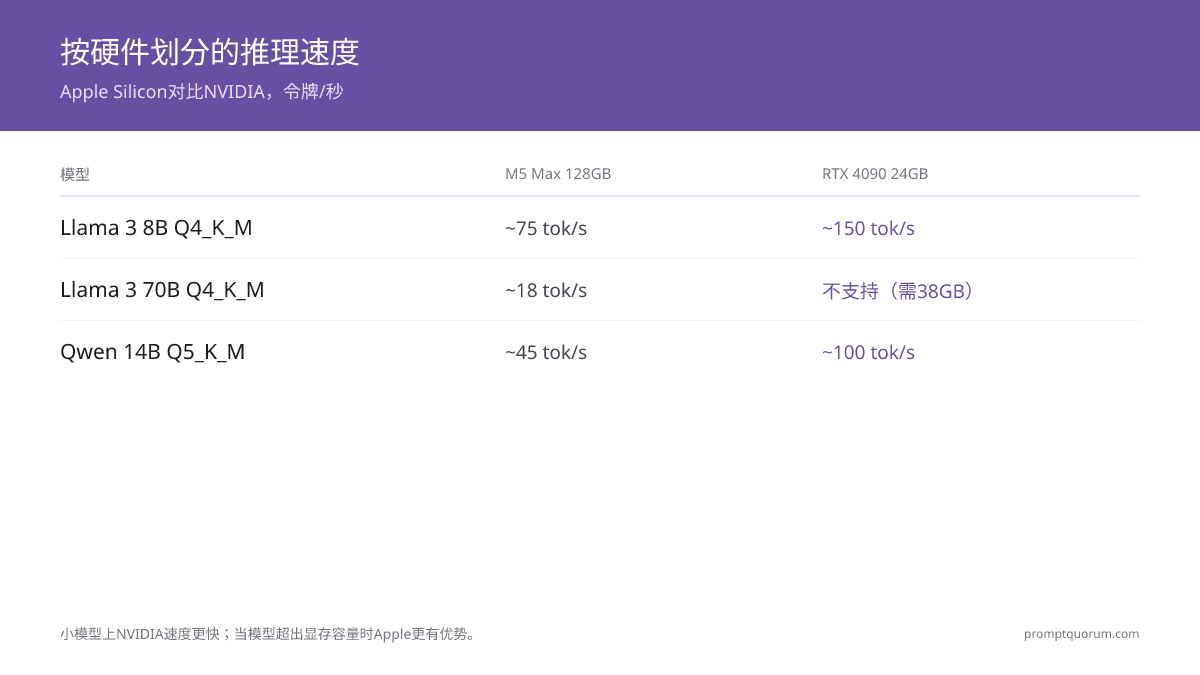
- M5 Max 128GB:Llama 3 8B Q4_K_M约75 tok/s;Llama 3 70B Q4_K_M约18 tok/s(可放入内存)
- RTX 4090 24GB:Llama 3 8B约150 tok/s;Llama 3 70B放不进(需约38GB VRAM)
- 70B能力成本:Mac Studio M5 Max 36GB约$2,499 vs 双RTX 4090系统约$7,000
- 功耗:Apple 25–35W;RTX 4090系统约450W — 差距约10倍
- 软件:NVIDIA占优(CUDA、PyTorch、vLLM、TensorRT-LLM);Apple在成长(MLX、mlx-lm)
- 训练/微调:NVIDIA是严肃工作负载的唯一可行选择
- 便携性:MacBook Pro M5用电池运行14B模型;没有NVIDIA笔记本能与之媲美
📍 简单一句话
Apple MLX在70B以上模型和能效方面更胜;NVIDIA CUDA在7–14B模型原始推理速度和训练生态方面更强。
💬 简单来说
Apple Silicon就像一辆大后备箱的混合动力车——耗电少、能装巨大的模型。NVIDIA是一辆跑车——速度极快,但只适合小货物,且非常耗油。
📌注: 基准数据来自社区测试(2026年5月),为近似值±10–15%。结果因量化、上下文长度和系统负载而异。
为什么2026年这个对比很重要
Apple Silicon M5系列最高配备128GB统一内存——首次让Mac在消费者价格下进行大型模型推理成为可能。NVIDIA RTX 5090以32GB GDDR7 VRAM、约28,000元上市。两种根本不同的架构如今竞相运行相同的开源模型。
📍 简单一句话
2026年,Apple Silicon和NVIDIA独立GPU代表了本地运行大型语言模型的两种截然不同的硬件理念。
💬 简单来说
使用Apple时,CPU、GPU和RAM共享同一内存池——128GB的Mac Studio可以一次性加载70B模型。NVIDIA使用独立VRAM;单张RTX 4090(24GB)根本无法加载70B模型。
- Apple M5 Max:CPU和GPU共享最高128GB统一内存
- NVIDIA RTX 5090:约28,000元、32GB GDDR7——最快消费级独立GPU
- Llama 3 70B(Q4_K_M)需要约38GB内存
- Apple上:一台设备搞定。NVIDIA上:需要双RTX 4090或CPU卸载
💡提示: 如果目标模型有40B以上参数,选Apple MLX。如果需要7–14B模型最大token/s或需要微调,选NVIDIA CUDA。
改变一切的架构差异
Apple Silicon和NVIDIA GPU围绕根本不同的内存架构构建。这个单一差异——共享vs专用——决定了您能运行哪些模型以及速度如何。
📍 简单一句话
Apple Silicon使用CPU、GPU和神经引擎共享的统一内存;NVIDIA使用通过PCIe总线连接的GPU卡上的专用GDDR7 VRAM。
💬 简单来说
NVIDIA有两个独立的存储库——系统RAM和GPU VRAM。在它们之间移动数据很慢。Apple只有一个所有组件共享的存储库——无需复制,无瓶颈。
Apple Silicon:统一内存架构
M5 Max在单一芯片上集成了CPU核心、GPU核心和神经引擎。所有计算单元从同一内存池读取。配备128GB的M5 Max的CPU和GPU可同时使用128GB——没有VRAM上限,没有传输瓶颈。
- M5 Max内存带宽:614 GB/s(CPU+GPU同一内存池)
- 零拷贝张量运算——CPU和GPU之间没有PCIe总线
- 神经引擎:38 TOPS用于加速ML运算
- Llama 3 70B Q4_K_M(约38GB)可放入64GB或128GB配置
- Mac Studio M5 Max 36GB:约$2,499——推荐70B模型配置;Mac Studio M5 Ultra现已推出,96GB版本5,499美元起,2026年9月22日开始发货
NVIDIA:专用VRAM + PCIe总线
NVIDIA GPU在卡上有专用GDDR7 VRAM。系统RAM是独立的。当模型超过VRAM时,llama.cpp必须将层卸载到系统RAM——这些层会慢10–20倍。
- RTX 5090:32GB GDDR7,内存带宽1,792 GB/s
- RTX 4090:24GB GDDR6X,1,008 GB/s
- PCIe 4.0 ×16总线:峰值约32 GB/s(大型模型卸载的瓶颈)
- Llama 3 70B Q4_K_M需约38GB——超过单张RTX 4090(24GB)
- 需要双RTX 4090 + NVLink才能将完整70B放入VRAM
内存带宽对比
对于LLM推理,内存带宽直接决定每秒token数。每生成一个token都需要从内存读取模型权重。
- RTX 5090:1,792 GB/s — 32GB GDDR7(最高带宽,独立GPU)
- RTX 4090:1,008 GB/s — 24GB GDDR6X(广泛可用,久经考验)
- RTX 4070 Ti Super:672 GB/s — 16GB GDDR6X(NVIDIA中高端)
- Apple M5 Max:614 GB/s — 最高128GB(CPU+GPU共享池)
- Apple M5 Pro:273 GB/s — 最高48GB(MacBook/Mac Mini选项)

💡提示: NVIDIA每元原始带宽更高;Apple总内存容量更大。对于LLM,总内存决定哪些模型能放进去;带宽决定在该约束内的速度。
Apple Silicon能匹敌NVIDIA的内存带宽吗?
不能——RTX 4090有1,008 GB/s vs Apple M5 Max的614 GB/s。Apple以更大的内存容量(128GB vs 24GB)来弥补。对于VRAM足够的小型模型,NVIDIA在速度上更快。对于超出VRAM的大型模型,Apple在容量上获胜。
性能基准测试:各模型每秒token数
推理速度以每秒token数(tok/s)衡量——越高越好用于交互。NVIDIA在小模型速度上占优;Apple在模型超出VRAM容量时获胜。
📍 简单一句话
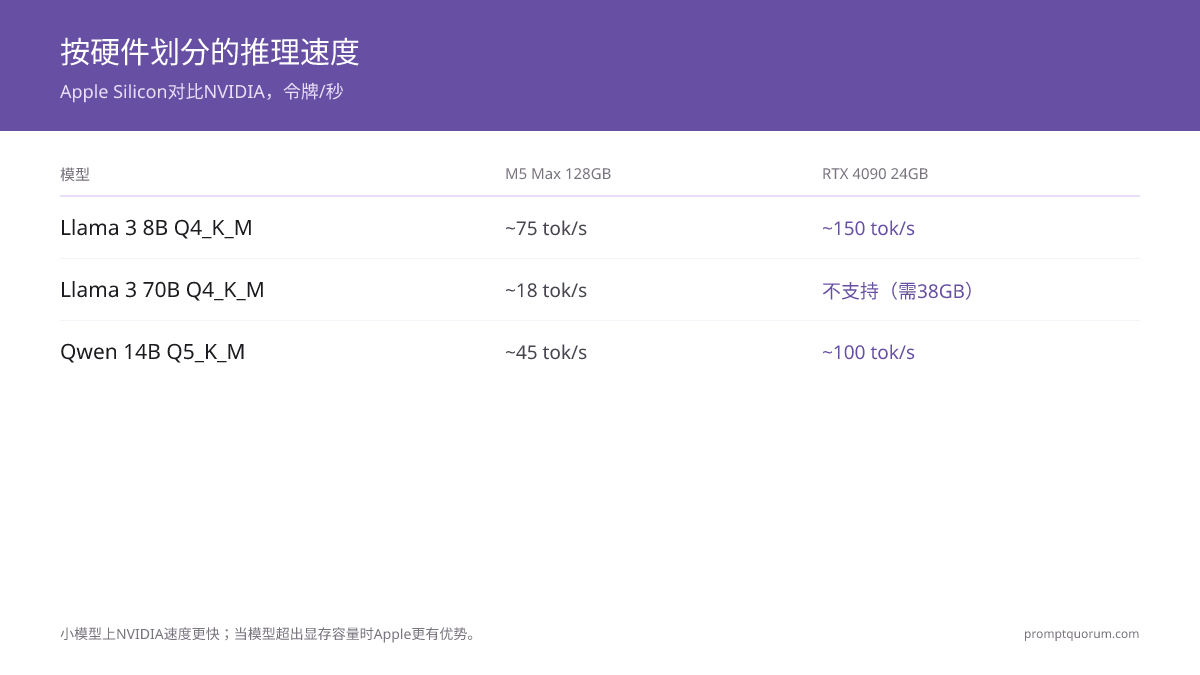
RTX 4090在Llama 3 8B Q4_K_M上达约150 tok/s;Apple M5 Max 128GB在同模型上约75 tok/s,但也能以约18 tok/s运行RTX 4090无法容纳的Llama 3 70B。
💬 简单来说
RTX 4090在7B模型上快两倍,但物理上无法加载70B模型。M5 Max在小模型上较慢,但能运行任何单张NVIDIA显卡无法处理的大型模型。
模型 | M5 Max 128GB | M5 Pro 48GB | RTX 5090 32GB | RTX 4090 24GB | RTX 4070 Ti S. 16GB | RTX 3060 12GB |
|---|---|---|---|---|---|---|
| Llama 3 8B Q4_K_M | 约75 tok/s | 约65 tok/s | 约145 tok/s | 约150 tok/s | 约95 tok/s | 约55 tok/s |
| Llama 3 70B Q4_K_M | 约18 tok/s ✓ | N/A(需38GB) | N/A(32GB < 38GB) | N/A(需38GB) | N/A | N/A |
| Qwen 14B Q5_K_M | 约45 tok/s | 约38 tok/s | 约130 tok/s | 约100 tok/s | 约58 tok/s | N/A(12GB限制) |
| Mixtral 8×7B Q4_K_M | 约22 tok/s | 约15 tok/s | 约95 tok/s ✓ | 约65 tok/s | N/A(需约26GB) | N/A |
| Llama 3 8B Q8_0 | 约55 tok/s | 约45 tok/s | 约165 tok/s | 约110 tok/s | 约65 tok/s | N/A(需约9GB) |
📌注: 基准来自mlx-community和llama.cpp社区测试,2026年5月。近似值±10–15%。在您的硬件上运行llama-bench获取精确数值。
Llama 3 70B的18 tok/s够用于交互吗?
大多数任务够用。18 tok/s生成500字回复大约需要20–25秒。以前需要300,000元以上服务器才能实现的70B质量交互,现在~$2,499的Mac Studio M5 Max 36GB就能做到。
为什么NVIDIA在小模型上更快?
NVIDIA的GDDR7/GDDR6X带宽(1,008–1,792 GB/s)超过Apple M5 Max的带宽(614 GB/s)。LLM推理受内存带宽限制——更高带宽运行小模型更快。Apple的优势在容量,不在带宽。
成本对比:各模型大小的总系统成本
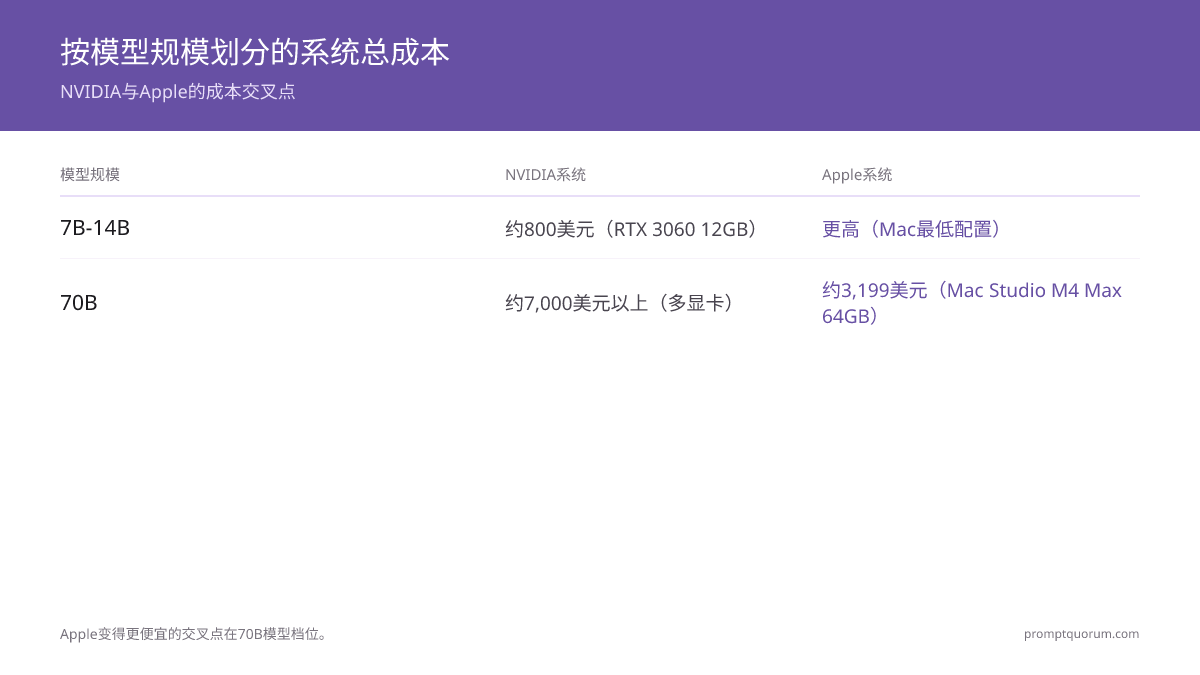
总系统成本NVIDIA包含显卡加PC构建;Apple只是Mac本身。Apple变得更便宜的交叉点是70B模型级别。
📍 简单一句话
NVIDIA在7–14B模型上更便宜(RTX 3060 12GB + PC约6,000元);Apple在70B模型上更便宜(Mac Studio M5 Max 36GB约$2,499 vs 双RTX 4090系统约$7,000)。
💬 简单来说
小模型偏向NVIDIA(买显卡插上就用)。大模型偏向Apple(一台设备代替两张显卡加整套自组PC)。
目标模型 | Apple方案 | Apple价格 | NVIDIA方案 | NVIDIA价格 | 更便宜 |
|---|---|---|---|---|---|
| 7B模型 | Mac Mini M4 24GB | 约10,000元 | RTX 3060 12GB + PC | 约6,000元 | NVIDIA(1.7×) |
| 14B模型 | Mac Mini M4 Pro 48GB | 约16,000元 | RTX 4060 Ti 16GB + PC | 约9,000元 | NVIDIA(1.8×) |
| 32B模型 | Mac Mini M4 Pro 48GB | 约16,000元 | RTX 5090 32GB + PC | 约42,000元 | Apple(2.6×) |
| 70B模型 | Mac Studio M5 Max 36GB | 约$2,499 | 双RTX 4090 + PC | 约$7,000 | Apple(2.2×) |
| 96B+模型 | Mac Studio M5 Ultra 96GB | 5,499美元 | 4× A100 40GB服务器 | 约300,000元以上 | Apple(7.3×) |
| 200B+模型 | Mac Studio M5 Ultra 256GB | 9,499美元 | 6× A100 40GB服务器 | 约4$7,000以上 | Apple(6.3×) |
💡提示: 32B这个关键节点:RTX 5090(32GB)仅显卡就约28,000元加上系统约12,000元。Mac Mini M4 Pro 48GB以约16,000元全包处理32B模型。
📌注: 价格为2026年5月近似值(人民币)。NVIDIA GPU价格随库存波动。Apple价格固定。
软件生态:NVIDIA仍然占主导
NVIDIA的CUDA生态已有15年的成熟度。每个主要ML框架、推理服务器和微调工具都在CUDA上原生运行。Apple MLX正在快速增长,但仍专注于仅推理。
📍 简单一句话
NVIDIA CUDA原生支持PyTorch、vLLM、TensorRT-LLM、llama.cpp和Ollama;Apple MLX支持mlx-lm、LM Studio和带MLX后端的Ollama——仅限macOS。
💬 简单来说
CUDA就像ML领域的Windows——一切都在上面运行。MLX像macOS——精致高效,但不是所有工具都可用,且无法离开生态系统。
Apple MLX生态系统
- MLX — Apple的开源ML框架,原生Metal GPU加速
- mlx-lm — MLX的LLM推理库
- LM Studio 0.3+ — macOS上可用MLX后端
- Ollama — Apple Silicon的MLX后端
- Jan.ai — macOS上支持MLX
- Hugging Face mlx-community:2,000多个预量化模型(2026年5月)
- 训练:通过mlx-lm的LoRA微调(范围有限)
- 平台:仅限macOS
NVIDIA CUDA生态系统
- llama.cpp — 最流行的开源推理,CUDA后端
- Ollama — CUDA后端,跨平台
- vLLM — 带PagedAttention的生产推理
- TensorRT-LLM — NVIDIA高吞吐量推理引擎
- text-generation-webui — 本地模型GUI
- PyTorch — 原生CUDA,事实上的ML标准
- 训练:完整微调、LoRA、QLoRA、RLHF — 完整生态
- 平台:Linux(最佳)、Windows、Docker容器
⚠️警告: 如果您计划微调或训练模型,NVIDIA CUDA是唯一可行的选择。Apple MLX通过mlx-lm支持LoRA微调,但Apple Silicon上的完整参数微调和RLHF还不够成熟。
我可以在Apple和NVIDIA上都使用Ollama吗?
可以。Ollama在Apple Silicon(Metal后端)和NVIDIA(CUDA)上均可运行。相同的命令在两个平台上都有效。模型文件跨平台兼容。
功耗与噪音:Apple明显占优
功耗是Apple Silicon最明显的优势之一。每天8小时、1元/度电,M5 Max与RTX 4090系统之间的差距每年超过1,600元。
📍 简单一句话
Mac Studio M4 Max运行本地LLM时消耗25–35W;RTX 4090系统约450W——每天8小时、1元/度电,年电费约180元 vs 约2,700元。
💬 简单来说
RTX 4090系统每年电费比许多流媒体订阅加起来还贵。Mac Studio每月运行费不到15元。
系统 | 峰值功耗 | 年电费(8小时/天,1元/度) | 噪音 |
|---|---|---|---|
| Mac Studio M4 Max | 25–35W | 约180元/年 | 无声 |
| MacBook Pro M5 Max | 30–40W | 约210元/年 | 几乎无声 |
| RTX 3060系统 | 约200W | 约580元/年 | 中等风扇噪音 |
| RTX 4090系统 | 约450W | 约1,314元/年 | 负载下较大 |
| RTX 5090系统 | 约600W | 约1,752元/年 | 非常大 |
💡提示: 如果在家庭办公室或卧室工作,噪音和成本一样重要。Mac Studio运行LLM完全无声。RTX 4090系统需要在数米外都能听到的主动散热。
Apple MLX比NVIDIA效率高10倍吗?
在持续推理时大致如此。Mac Studio M4 Max消耗25–35W vs RTX 4090系统400–500W。效率比为8–15倍,取决于工作负载。
使用场景推荐:选哪个系统
正确的硬件完全取决于目标模型大小和工作流程。以下是直接、明确的推荐。
📍 简单一句话
选Apple Silicon:70B以上模型、无声运行或便携推理;选NVIDIA CUDA:7–14B最快吞吐量、训练、多GPU扩展或预算1万元以下。
💬 简单来说
如果想私密且经济实惠地运行Llama 3 70B,Apple是当下唯一真正可行的选择。如果想要最快的7B助手且预算1.5万元以下,NVIDIA胜出。
选Apple Silicon的情况:
- "我想私密运行70B模型" → Mac Studio M5 Max 36GB(约$2,499)——唯一实惠的单设备选择
- "我想要安静的家庭办公室LLM" → 任何Mac Studio——在完整推理负载下完全无声
- "我需要笔记本上运行14B以上模型" → MacBook Pro M5 Max——用电池运行Qwen 14B Q4_K_M
- "我想要一台用于开发+推理+日常使用的设备" → Mac作为统一工作站
- "电费很重要" → Apple每次推理会话耗电少8–15倍
- "不用服务器需要96B以上模型" → Mac Studio M5 Ultra 96GB售价5,499美元 vs 30万元以上的服务器;200B以上模型可选256GB配置(9,499美元),两者均于2026年9月22日发货
选NVIDIA CUDA的情况:
- "预算1万元以下" → 二手RTX 3060 12GB + 入门PC(约6,000元)——最少的钱买最快的7B
- "需要最快的7–14B推理速度" → RTX 4090约150 tok/s超过M5 Max约75 tok/s
- "计划微调或训练" → 仅限NVIDIA:PyTorch、LoRA、QLoRA、RLHF、DPO
- "需要多GPU扩展" → NVLink连接多张RTX卡;Apple没有等效方案
- "在Linux上开发" → CUDA生态是Linux原生的;MLX仅限macOS
- "需要最广泛的工具选择" → vLLM、TensorRT-LLM、text-generation-webui都需要CUDA
💡提示: 最重要的问题:您需要以交互速度运行的最大模型是什么?如果是70B或更大,Apple自动胜出。如果是7–30B,按您的预算比较价格。
混合方案:两者都用
许多高级用户两者都用:用MacBook进行便携推理,用NVIDIA台式机进行训练。Ollama的跨平台支持让这变得实用——两个系统上相同的命令、相同的模型文件。
📍 简单一句话
常见的高级用户配置是MacBook Pro M5用于便携14B推理,加上带RTX 4090的Linux工作站用于LoRA微调和高吞吐量批处理任务。
💬 简单来说
外出时用Mac。用台式GPU做夜间微调训练和大批量服务。
- Ollama在Apple和NVIDIA上运行相同命令——
ollama run llama3.2在两者都有效 - LM Studio支持MLX(macOS)和CUDA后端,从同一界面操作
- GGUF模型文件(llama.cpp格式)跨平台;MLX模型仅限Apple
- 典型工作流分工:Mac用于私密推理,NVIDIA用于训练和批处理
- LAN服务:在NVIDIA服务器上运行Ollama,从Mac通过局域网访问
💡提示: 如果只能买一个系统:先从NVIDIA做7B工作(更便宜),当需要70B时再升级到Mac Studio。这两个决定在各自的层次上都物有所值。
未来展望:2026–2027年
两个平台都在快速改进。2027年的关键问题是NVIDIA是否会在消费级显卡上放足够多的VRAM来容纳70B模型,或者Apple的统一内存优势是否会持续。
📍 简单一句话
Apple M6预计将进一步扩展统一内存容量;NVIDIA下一代可能将消费级VRAM推过48GB——这将显著重新平衡大型模型优势。
💬 简单来说
如果NVIDIA在2027年推出20,000元64GB VRAM的GPU,Apple在70B级别的今日成本论点就会崩溃。如果Apple发布256GB统一内存的M6,则会扩大领先优势。
Apple发展轨迹
- M6芯片:预计2027年,统一内存容量传言高达256GB
- MLX框架日趋成熟:更广泛的训练支持,更多模型兼容性
- 反向趋势:更小的高效模型(≤7B)赶上大模型——减少Apple大模型优势
- 上下文窗口需求(128K+个token)仍然有利于统一内存而非VRAM
NVIDIA发展轨迹
- RTX 5090(32GB)——下一代传言达48–64GB GDDR7
- 48GB VRAM将使Llama 3 70B Q4_K_M适配单张显卡
- TensorRT-LLM和推测解码持续提升吞吐量
- Blackwell消费级显卡预计2027年推出,VRAM上限更高
💡提示: 如果NVIDIA发布20,000元以下48GB以上的消费级显卡,请重新评估这一对比。Apple今日70B以上的优势依赖于当前32GB VRAM上限。
对比总结:Apple vs NVIDIA各因素评判
使用此表格根据您工作流中最重要的内容做出直接决定。
📍 简单一句话
Apple在11个因素中赢得5个(大型模型、70B级别成本、能效、噪音、便携性);NVIDIA赢得5个(小模型速度、1万元以下成本、软件、训练、跨平台);1个平局(未来保值性)。
因素 | 胜者 | 原因 |
|---|---|---|
| 大型模型(70B+)推理 | Apple | Mac Studio M5 Max 36GB约$2,499 vs 约$7,000以上双GPU系统;RTX 5090 32GB也无法装入70B |
| 小型模型(7–14B)速度 | NVIDIA | RTX 4090:约150 tok/s vs M5 Max:约75 tok/s |
| 1万元以下成本 | NVIDIA | RTX 3060 + PC约6,000元 vs 最便宜Mac约10,000元 |
| 70B模型成本 | Apple | Mac Studio M5 Max 36GB约$2,499 vs 双RTX 4090 + PC约$7,000 |
| 能源效率 | Apple | 25–35W vs 450W — 8–15倍高效 |
| 噪音 | Apple | 无声 vs 需要嘈杂主动散热 |
| 软件生态 | NVIDIA | CUDA驱动PyTorch、vLLM、TensorRT-LLM、所有主要工具 |
| 训练/微调 | NVIDIA | PyTorch CUDA是标准;MLX LoRA有限制 |
| 便携性 | Apple | MacBook Pro M5用电池运行14B;没有可比的NVIDIA笔记本 |
| 跨平台 | NVIDIA | CUDA在Linux/Windows;MLX仅限macOS |
| 未来保值性 | 平局 | Apple M6扩展内存;NVIDIA推进VRAM——两者都在改进 |

💡提示: 决策规则:主要模型70B或更大 → 选Apple。主要模型7–30B且预算3万元以下 → 选NVIDIA。
购买指南:按使用场景推荐硬件
以下是2026年5月的具体硬件建议,含当前人民币价格。
低预算7B模型最佳选择
RTX 3060 12GB配入门系统(总计约6,000元)。以约55 tok/s运行Llama 3 8B Q4_K_M——完全交互式。
14B模型最佳选择
RTX 4060 Ti 16GB(~$424 USD)将Qwen 14B Q4_K_M完全放入VRAM,约58 tok/s。系统总计约$1,200。
70B模型最佳选择
Mac Studio M5 Max 36GB(约$2,499)。唯一能以可用速度(约18 tok/s)容纳Llama 3 70B Q4_K_M的单设备选择。
训练+快速推理最佳选择
RTX 4090 24GB(约~$2,755新品/~$2,268二手)。7–24B模型最快推理,同时支持完整PyTorch微调工作流。
📌注: PromptQuorum不从这些链接获取佣金。Apple Store和京东链接仅供参考定价。购买前请核实当前价格。
常见问题
能在Windows或Linux上使用Apple MLX模型吗?
不能。MLX仅限macOS,需要Apple Silicon。llama.cpp的GGUF模型在所有平台上都可用。跨平台使用时,GGUF格式的Ollama在Mac和NVIDIA系统上都能用。
Ollama在Apple Silicon上使用MLX还是Metal?
Apple Silicon上的Ollama默认使用Metal GPU加速,不是MLX。要获得MLX特有的优化,请直接使用mlx-lm或启用MLX后端的LM Studio。
运行70B模型的最低配置Mac是什么?
配备64GB统一内存的Mac Studio M4 Max(约$2,499)。Llama 3 70B Q4_K_M需约38GB——64GB配置可以容纳,余量充足。
Apple M5 Max对本地LLM比RTX 4090更好吗?
取决于模型大小。7B:RTX 4090胜(150 tok/s vs 75 tok/s)。70B:M5 Max 128GB自动胜——RTX 4090根本无法加载70B。训练:NVIDIA大幅胜出。
新款Apple M5 Ultra与RTX 5090相比如何?
Apple于2026年8月25日发布了搭载M5 Ultra的Mac Studio——96GB统一内存版本5,499美元起(256GB版本9,499美元)。早期数据显示其在Llama 3.3 70B上约为40–52 tok/s,而这个模型RTX 5090的32GB显存根本无法加载。对于能装入32GB显存的模型,RTX 5090每token速度仍然更快。
参考来源与延伸阅读
- Apple MLX Framework — Apple面向Apple Silicon的开源ML框架官方仓库,含Metal GPU加速。
- mlx-community — Hugging Face — 无需手动转换即可在Apple Silicon上直接使用的预转换MLX格式模型。
- llama.cpp — 支持CUDA、Metal和CPU后端的跨平台LLM推理。
- Mac Studio — Apple — M4 Max、M5 Max和M5 Ultra规格及定价(M5 Ultra于2026年8月25日发布)。
- Ollama — 通过MLX和CUDA后端运行Llama、Mistral和Qwen模型的跨平台推理引擎。
- LM Studio — 适用于Apple Silicon的原生MLX后端和适用于NVIDIA的CUDA后端桌面GUI。
- NVIDIA GeForce GPU规格 — RTX 4090和RTX 5090的VRAM、内存带宽和TDP规格。
- LLM量化说明 — Q4_K_M、Q8_0等量化格式说明。
- 本地LLM需要多少VRAM? — 按模型大小划分的VRAM需求。
- 本地LLM最佳预算GPU — RTX 3060 12GB及更便宜的选项。
- Apple Silicon本地LLM指南2026 — M1到M5 Max安装指南。
- LM Studio vs Jan vs GPT4All 2026 — 桌面GUI应用比较。
- GPU vs CPU vs Apple Silicon — 三路硬件概述。
- 使用LoRA微调本地LLM — 消费级硬件上的LoRA训练。
- 最佳本地编程LLM — 代码生成模型推荐。