- Todos os chips série M usam memória unificada (GPU + CPU compartilham o mesmo pool de RAM).
- M6 (Mac mini) e M5 Pro/M5 Max/M5 Ultra (Mac mini e Mac Studio) são as recomendações de 2026 após a renovação da Apple de 25/8/2026; M4 e anteriores ainda são viáveis, mas menos preparados para o futuro.
- Metal é o framework de programação GPU da Apple; está integrado no macOS e não requer bibliotecas externas.
- A escolha do framework (Ollama, MLX, llama.cpp) afeta a velocidade em 0-25%, mas não muda quais modelos cabem na memória.
- Mac Mini M6 é o ponto de entrada mais econômico (US$ 899 base com 16 GB, até 32 GB) e quase silencioso (a Apple indica 5 dBA em repouso).
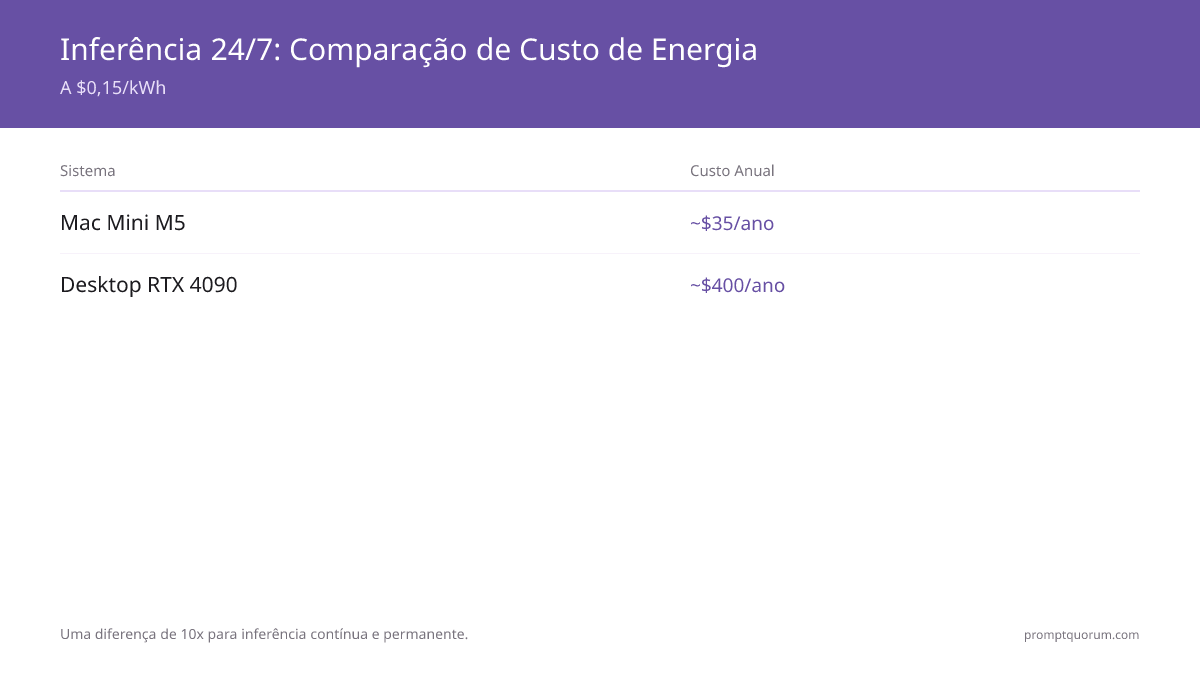
- Custo anual estimado de eletricidade (ilustrativo, 24/7 a US$ 0,15/kWh; não medido): Mac Mini M6 ~US$ 35 vs RTX 4090 de mesa ~US$ 400 -- cerca de 10×.
Por que Apple Silicon para LLMs locais?
O Apple Silicon se destaca na inferência LLM local por uma razão: memória unificada. Quando você compra um Mac com 64 GB de RAM, cerca de 56 GB (64 GB menos os 8 GB de que o macOS precisa) ficam disponíveis para o seu modelo LLM. Uma GPU discreta como a RTX 4090 tem 24 GB de VRAM (separado da RAM do sistema) -- modelos maiores que 24 GB simplesmente não cabem sem configurações multi-GPU complexas.
Essa única diferença arquitetural é transformadora:
- Memória unificada: RAM disponível menos cerca de 8 GB para o macOS (de 16 GB a 512 GB no total conforme o chip). RTX 4090: apenas VRAM discreta (limite rígido de 24 GB).
- Aceleração Metal: inferência GPU sem dependência de CUDA ou drivers proprietários.
- Eficiência energética: 20-100 W sob carga vs 300 W+ para GPU de mesa. Permite operação sem ventilador ou quase silenciosa.
- Silêncio: o MacBook Air não tem ventilador; a Apple indica 5 dBA em repouso para o Mac mini.
- Sem gerenciamento de drivers: Metal funciona nativamente no macOS. Sem conflitos de versão CUDA, sem atualizações de driver NVIDIA.
- Custo de hardware: Mac Mini M5 Pro (US$ 1.200) com configuração de 64 GB vs configuração dual-GPU (US$ 4.000+) para capacidade de modelo equivalente.
Chips Apple Silicon para LLMs -- Comparação completa
Chip | Memória máx. | Largura de banda | Núcleos GPU | Ponto ideal LLM | Lançamento |
|---|---|---|---|---|---|
| M1 | 16 GB | 68 GB/s | 8 | 7B Q4 | Nov 2020 |
| M1 Pro | 32 GB | 200 GB/s | 16 | 13B Q4 | Out 2021 |
| M1 Max | 64 GB | 400 GB/s | 32 | 32B Q4 | Out 2021 |
| M1 Ultra | 128 GB | 800 GB/s | 64 | 70B Q4 | Mar 2022 |
| M2 | 24 GB | 100 GB/s | 10 | 7-13B Q4 | Jun 2022 |
| M2 Pro | 32 GB | 200 GB/s | 19 | 13B Q4 | Jan 2023 |
| M2 Max | 96 GB | 400 GB/s | 38 | 34-70B Q4 | Jan 2023 |
| M2 Ultra | 192 GB | 800 GB/s | 76 | 70B+ Q4 | Jun 2023 |
| M3 | 24 GB | 100 GB/s | 10 | 7-13B Q4 | Out 2023 |
| M3 Pro | 36 GB | 150 GB/s | 18 | 13-32B Q4 | Out 2023 |
| M3 Max | 128 GB | 400 GB/s | 40 | 70B Q4 | Out 2023 |
| M4 | 32 GB | 120 GB/s | 10 | 13B Q4 | Mai 2024 |
| M4 Pro | 48 GB | 273 GB/s | 20 | 32B Q4 | Out 2024 |
| M4 Max | 128 GB | 546 GB/s | 40 | 70B Q4 | Out 2024 |
| M5 (base) | 32 GB | ~150 GB/s | 10 | 13B Q4 | Out 2025 |
| M6 (Mac mini) | 32 GB | Até 170 GB/s | 12 | 13B Q4 | Ago 2026 |
| M5 Pro | 64 GB | 307 GB/s | Até 20 | 32B Q5 | Ago 2026 |
| M5 Max | 128 GB | 460-614 GB/s | 32-40 | 70B Q5 | Ago 2026 |
| M5 Ultra | 512 GB | 1.2 TB/s | Até 80 | 120B+ Q4 / 70B FP16 | Ago 2026 |
O M5 Pro estreou no MacBook Pro (mar 2026); a renovação de 25/8/2026 o trouxe ao Mac mini junto com o M6, totalmente novo. M5 Max e M5 Ultra são novidades no Mac Studio desde 25/8/2026. Todos os quatro estão à venda desde 22/9/2026; a configuração M5 Ultra de 512GB passou a poder ser pedida em 28/10/2026. Os números de M6, M5 Pro, M5 Max e M5 Ultra vêm das especificações da Apple para Mac mini e Mac Studio.
Renovação de agosto de 2026: Mac mini M6/M5 Pro, Mac Studio M5 Max/M5 Ultra
A Apple anunciou uma renovação do Mac mini e do Mac Studio em 25 de agosto de 2026. Os dois equipamentos estão à venda desde 22 de setembro de 2026, e a configuração M5 Ultra de 512 GB passou a poder ser pedida em 28 de outubro de 2026. As afirmações de desempenho da própria Apple são identificadas como tais; resultados independentes são citados com a fonte.
- Mac mini M6: a partir de US$ 899 (US$ 799 educação) com 16 GB, configurável até 32 GB. CPU de 12 núcleos, GPU de 12 núcleos, até 170 GB/s de largura de banda. A Apple afirma CPU 40% mais rápida e até 4x mais desempenho de IA em relação ao Mac mini M4 -- números da Apple, não verificados de forma independente.
- Mac mini M5 Pro: a partir de US$ 1.699. Até 18 núcleos de CPU, até 20 núcleos de GPU, 307 GB/s de largura de banda, até 64 GB de memória unificada.
- Mac Studio M5 Max: a partir de US$ 2.499. CPU de 18 núcleos, GPU de 32 ou 40 núcleos, até 128 GB de memória unificada, 460-614 GB/s conforme a configuração.
- Mac Studio M5 Ultra: a partir de US$ 5.499 (US$ 5.099 educação), base de 96 GB de memória unificada, com 256 GB e 512 GB como opções sob encomenda. Até 36 núcleos de CPU, até 80 núcleos de GPU, 1.2 TB/s de largura de banda. A opção de 512 GB exige o modelo com CPU de 36 núcleos e GPU de 80 núcleos, passou a poder ser pedida em 28 de outubro de 2026 e leva a configuração mínima de 512 GB a US$ 22.299.
- O Mac Studio oferece clustering via Thunderbolt 5 com RDMA; a Apple afirma até 3x mais desempenho em inferência de IA distribuída em comparação com um único equipamento -- número da Apple, não verificado de forma independente.
- Primeiros resultados independentes do M5 Ultra (BGR, 21 de setembro de 2026; modelo de 256 GB, LM Studio, MLX de 4 bits): cerca de 55 tok/s com o Qwen 3.8 27B contra cerca de 40 em um M3 Ultra, e cerca de 80 contra 60 tok/s com o Qwen 3.5 122B A10B. A BGR relata desempenho médio 30-40% melhor que o M3 Ultra em seus testes; não informou comprimento de contexto nem número de execuções.
- O Mac mini M4/M4 Pro e o Mac Studio M4 Max/M3 Ultra agora são a geração anterior.
- Os 512 GB do M5 Ultra são a configuração máxima; é o que permite rodar modelos de 120B+ parâmetros localmente em um único Mac de consumo.
A largura de banda de memória importa mais do que o tamanho da memória
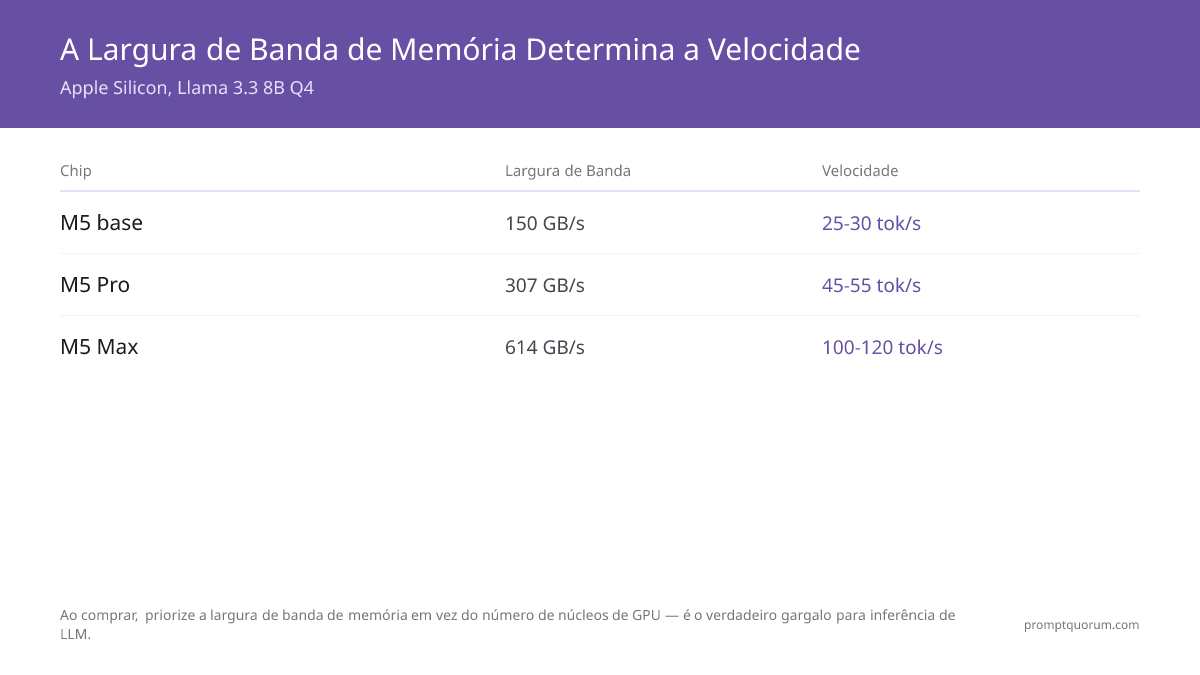
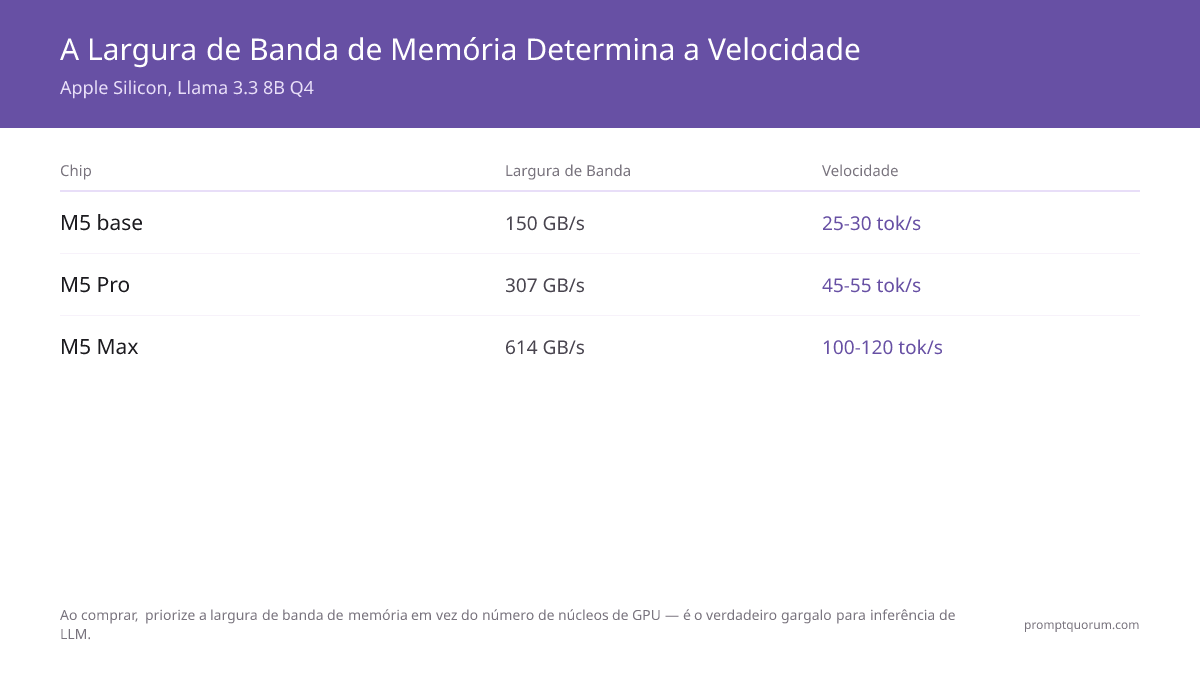
A inferência LLM é limitada pela largura de banda de memória, não pela capacidade de computação. Isso significa que a velocidade de geração de tokens escala linearmente com a largura de banda, não com os núcleos GPU.
M5 Max a 614 GB/s vs RTX 4090 a 1.008 GB/s parece que a NVIDIA vence em largura de banda bruta. Mas os usuários do Apple Silicon podem usar a maior parte da memória (o total menos cerca de 8 GB para o macOS, até o limite padrão de memória da GPU do macOS, que pode ser elevado), portanto podem carregar modelos maiores que a NVIDIA não consegue acomodar em 24 GB. A comparação real: M5 Max a 614 GB/s rodando um modelo 70B vs um RTX 4090 que não comporta o modelo 70B inteiro nos 24 GB (descarregar parte na CPU é possível, mas bem mais lento).
Dentro da linha M, as diferenças de largura de banda se traduzem diretamente em tok/s:
- M5 base (150 GB/s) → ~25-30 tok/s (estimativa) no Llama 3.1 8B Q4
- Mac mini M6 (até 170 GB/s) → faixa semelhante ao M5 base, um pouco maior pela largura de banda superior. A Apple publica apenas afirmações relativas (até 4x de desempenho de IA em relação ao Mac mini M4) e não verificamos números independentes de tok/s do M6.
- M5 Pro (307 GB/s) → ~45-55 tok/s (estimativa) no Llama 3.1 8B Q4 (2× o M5 base por 2× a largura de banda)
- M5 Max (614 GB/s) → ~100-120 tok/s (estimativa) no Llama 3.1 8B Q4
- M5 Ultra (1.2 TB/s, especificação da Apple) → a BGR mediu cerca de 55 tok/s com um Qwen 3.8 27B de 4 bits contra cerca de 40 em um M3 Ultra (cerca de 819 GB/s). Isso é cerca de 1,4× mais velocidade de geração para cerca de 1,5× mais largura de banda -- coerente com uma inferência limitada pela largura de banda.
- Lição: na inferência limitada pela largura de banda, dobrá-la tende a aumentar a velocidade de geração de forma aproximadamente proporcional (estimativa; a arquitetura também influencia). Ao comprar, priorize a largura de banda sobre o número de núcleos GPU.
Eficiência energética e temperatura -- a vantagem silenciosa
Configuração | Consumo (repouso) | Consumo (LLM) | Ruído | Calor |
|---|---|---|---|---|
| Mac Mini M6 | 5 W | 25-35 W | Quase silencioso (5 dBA em repouso) | Morno |
| MacBook Air M5 | 3 W | 20-30 W | Silencioso (sem ventilador) | Morno |
| Mac Mini M5 Pro | 5 W | 40-60 W | Silencioso (ventilador raramente ativo) | Fresco |
| Mac Studio M5 Max | 10 W | 60-100 W | Silencioso | Fresco |
| Mac Studio M5 Ultra | 10 W | Máx. 480 W contínuos (Apple) | Silencioso | Fresco |
| RTX 4090 de mesa | 50 W | 350-450 W | Ruído de ventoinhas audível sob carga | Quente |
| RTX 3060 de mesa | 30 W | 170-200 W | Moderado | Morno |
Custo anual estimado de eletricidade a US$ 0,15/kWh para um servidor de IA 24/7 (ilustrativo, não medido; o custo real depende do uso): Mac Mini M6 (~US$ 35/ano) vs RTX 4090 de mesa (~US$ 400/ano). Os valores de consumo em repouso e sob carga são estimativas da PromptQuorum, não medições nem especificações da Apple; a Apple indica consumo contínuo máximo de 155 W para o Mac mini e 480 W para o Mac Studio.
Cenários de usuários reais no Apple Silicon
- 1Agente de código
Why it matters: Llama 3.1 8B no M5 Pro entrega 45-55 tok/s (estimativa); a latência da completação de código depende do tamanho do modelo e das configurações (não medida pela PromptQuorum). Roda silenciosamente em segundo plano no MacBook Pro. - 2Pipeline RAG
Why it matters: Modelo de embedding + Llama 3.1 8B + ChromaDB cabe inteiramente nos 36 GB de memória unificada do M5 Pro. Sem limitações de GPU. - 3Assistente de voz
Why it matters: Whisper Metal + Ollama Llama + Piper TTS : a latência depende do tamanho dos modelos e das configurações; a PromptQuorum não a mediu no M5 Pro. Mac mini silencioso, adequado para uma configuração sempre ativa. - 4Multimodal
Why it matters: Whisper + LLaVA 7B visão + Llama 3.1 8B raciocínio = tudo cabe em 36 GB, processamento simultâneo. - 5Escrita privada
Why it matters: Llama 3.3 70B Q5 no M5 Max 128 GB = alta qualidade para textos longos, funciona offline depois que o modelo é baixado, sem custos de API por token e com os prompts permanecendo no dispositivo durante a inferência. No novo Mac Studio M5 Ultra (até 512 GB), modelos de 120B+ se tornam possíveis para quem quer mais margem.
Qual Mac você deve comprar para LLMs locais?
Matriz de decisão: adapte sua necessidade à configuração de Mac correta, atualizada após a renovação de Mac mini e Mac Studio de 25 de agosto de 2026.
Sua necessidade | Mac a comprar | Memória | Preço aproximado |
|---|---|---|---|
| Apenas experimentar LLMs locais | Mac Mini M6 | 16 GB | US$ 899 |
| Modelos 7-13B diários | Mac Mini M6 | 32 GB | US$ 899+ (32 GB custa mais) |
| Modelos 13-32B, servidor silencioso | Mac Mini M5 Pro | 64 GB | US$ 1.699 |
| Estação de trabalho de IA portátil | MacBook Pro M5 Pro | 48 GB | US$ 2.500 |
| Modelos 70B, qualidade máxima | Mac Studio M5 Max | 128 GB | US$ 2.499 |
| Stacks multi-modelo (visão + LLM + TTS) | Mac Studio M5 Max | 128 GB | US$ 2.499 |
| Modelos 120B+, memória máxima | Mac Studio M5 Ultra | Até 512 GB | US$ 5.499 (96 GB) a US$ 22.299+ (512 GB) |
Crítico: a memória é fixa na compra e não pode ser atualizada, então compre a maior configuração que caiba no seu orçamento e nos modelos que pretende rodar. Só a opção de 512 GB do M5 Ultra acrescenta US$ 15.500 (MacRumors). Todos os modelos acima estão à venda desde 22/9/2026; a configuração M5 Ultra de 512 GB passou a poder ser pedida em 28/10/2026. Preços de tabela nos EUA; no Brasil podem variar bastante devido a impostos de importação.
Primeiros passos: visão geral dos frameworks
Três frameworks prontos para produção rodam LLMs na GPU Metal do Apple Silicon:
- Ollama: configuração mais simples (instalação com um clique), detecção automática de Metal, sem configuração. REST API incluída. Ideal para iniciantes.
- MLX: framework nativo da Apple, frequentemente mais rápido que o Ollama em testes da comunidade, integração com Python, suporte a fine-tuning LoRA. Curva de aprendizado mais íngreme.
- llama.cpp: C++ multiplataforma, maior suporte a formatos de modelo (GGUF), backend Metal disponível via flag de compilação. Ideal para integração em aplicações maiores.
Perguntas frequentes
O que a Apple anunciou para Mac mini e Mac Studio em 25 de agosto de 2026?
A Apple renovou o Mac mini com o novo chip M6 (US$ 899 com 16 GB, configurável até 32 GB) e o M5 Pro (US$ 1.699, até 64 GB), e renovou o Mac Studio com o M5 Max (US$ 2.499, até 128 GB) e o M5 Ultra (US$ 5.499 com 96 GB, até 512 GB). Todos estão à venda desde 22 de setembro de 2026; a configuração M5 Ultra de 512 GB passou a poder ser pedida em 28 de outubro de 2026, a partir de US$ 22.299.
M5 Pro ou M5 Max é melhor para LLMs locais?
M5 Pro (64 GB) é o melhor custo-benefício -- roda modelos 32B bem e custa a partir de US$ 1.699. M5 Max (a partir de US$ 2.499) só é necessário se você precisar frequentemente de modelos 70B ou stacks multimodais. O M5 Pro (64 GB) oferece ótimo custo-benefício para a maioria dos casos de uso de classe 32B abordados neste guia; o M5 Max vale a pena se você precisa de modelos 70B com frequência.
Posso atualizar a memória após comprar um Mac?
Não. A memória do Apple Silicon é soldada e não é atualizável. Compre a memória máxima que puder pagar no momento da compra.
Como o M5 Pro se compara ao RTX 4090 para LLMs?
Em modelos que cabem em 24 GB de VRAM, o RTX 4090 costuma ser mais rápido; a diferença varia conforme o modelo e a quantização, e a PromptQuorum não a mediu. Um modelo 70B não cabe inteiro nos 24 GB de um RTX 4090 (é possível descarregar parte na CPU, mas fica bem mais lento), enquanto um M5 Pro de 64 GB consegue alojá-lo com quantização de 4 bits. Consulte Apple Silicon vs GPU NVIDIA para LLMs.
Preciso do Ollama, MLX ou llama.cpp?
Comece com o Ollama (mais fácil). Se precisar de inferência mais rápida ou fine-tuning, mude para MLX. Se precisar de compatibilidade multiplataforma, use llama.cpp. Os três funcionam no Apple Silicon.
O M5 Ultra com até 512 GB de memória vai mudar algo?
Sim. O M5 Ultra (Mac Studio, a partir de US$ 5.499 com 96 GB, 1.2 TB/s de largura de banda, até 512 GB a partir de US$ 22.299) roda modelos 70B em FP16 (sem quantização, sem perda por quantização) e habilita modelos de 120B+ em um único Mac de consumo (a configuração de 512 GB). O primeiro teste independente que verificamos (BGR, 21 de setembro de 2026, modelo de 256 GB) mediu cerca de 55 tok/s com um Qwen 3.8 27B de 4 bits, contra cerca de 40 em um M3 Ultra. A PromptQuorum não executou benchmarks próprios do M5 Ultra.
O Apple Silicon vale a pena para LLMs locais em 2026?
Sim, especialmente para modelos de 32B+. O Apple Silicon é uma das poucas opções de consumo que roda modelos 70B sem configurações multi-GPU complexas, e o novo Mac Studio M5 Ultra é um dos poucos que comporta modelos de 120B+. Para modelos 8B que cabem na VRAM da NVIDIA, o RTX 4090 é mais rápido, mas custa mais para operar. O Mac mini M5 Pro (a partir de US$ 1.699, até 64 GB) oferece ótimo custo-benefício para a maioria dos casos de uso de classe 32B abordados neste guia; o M5 Max vale a pena se você precisa de modelos 70B com frequência.
Um MacBook Air M5 consegue rodar LLMs locais?
Sim, com limitações. MacBook Air M5 roda modelos 7-8B com 16 GB (sobram cerca de 8 GB após o macOS) e até 13B com 24-32 GB. O design sem ventilador pode sofrer throttling térmico sob carga sustentada. Para uso ocasional: ótimo. Para inferência sempre ativa: Mac Mini M5 Pro é mais adequado.
Qual é o desempenho do Apple M6 com LLMs locais?
A Apple publicou apenas afirmações relativas: até 4x mais desempenho de IA e CPU 40% mais rápida que o Mac mini M4. Na renovação de agosto de 2026, o M6 estreou apenas no Mac mini (US$ 899 com 16 GB, até 32 GB, até 170 GB/s). Como a velocidade de geração acompanha a largura de banda da memória, espere algo próximo do M5 base, e não do M5 Pro; ainda não verificamos números independentes de tok/s do M6.
Qual a melhor configuração de LLM local para um Mac M1 com 32 GB?
Um M1 Pro ou M1 Max com 32 GB (200 GB/s e 400 GB/s) roda modelos 13B em Q4 com folga, que é o ponto ideal da tabela de chips acima; um M1 Max com 64 GB chega a 32B em Q4. O M1 original vai só até 16 GB, então fique em 7B Q4 nele.
Como o M3 Ultra se compara ao M5 Max para LLMs locais?
Um M3 Ultra supera um M5 Max em capacidade de memória (até 512 GB contra 128 GB), o que permite acomodar os maiores modelos. Em velocidade, a BGR relatou que um MacBook Pro M5 Max teve desempenho semelhante ao de um Mac Studio M3 Ultra em seu teste de 27B, e que o M5 Ultra rende em média 30-40% mais que o M3 Ultra. Um M5 Pro de 48 GB fica abaixo dos dois e é o ponto ideal para quem quer folga sem preços de Ultra.
Metodologia de benchmarks e atualidade
- Dados de M5 Pro/Max para configurações de MacBook Pro baseados em benchmarks da comunidade de março-maio de 2026
- M5 Ultra: existem resultados independentes (BGR, 21 de setembro de 2026, modelo de 256 GB -- veja a seção da renovação de agosto de 2026). Os números de tok/s do M6 e de M5 Pro/M5 Max no Mac mini/Mac Studio são estimativas baseadas na largura de banda ou resultados da comunidade; as afirmações de desempenho da própria Apple são identificadas como tais.
- Última verificação: 2026-11-02
- O desempenho melhora com atualizações de frameworks (Ollama, MLX, llama.cpp lançam versões mensalmente)
- Este artigo é revisado trimestralmente e passará a incluir resultados independentes do M6 e do Mac Studio M5 Max quando os tivermos verificado