- すべてのM-seriesチップは統一メモリ使用(GPU+CPUが同じRAMプール共有)。
- 2026年8月25日のApple刷新後は、M6(Mac mini)とM5 Pro/M5 Max/M5 Ultra(Mac miniおよびMac Studio)が2026年の推奨;M4以前も実用的だが将来対応でない。
- MetalはAppleのGPUプログラミングフレームワーク;macOS統合、外部ライブラリ不要。
- フレームワーク選択(Ollama、MLX、llama.cpp)は速度を0~25%影響するがモデル適合性を変更しない。
- Mac mini M6は最安のエントリー機です(899ドルベース、16GB、最大32GB)。アイドル時はほぼ無音です(Apple公表で5 dBA)。
- 年間電力コストの推定(目安、24時間365日・0.15ドル/kWh、実測なし):Mac mini M6(~35ドル)対デスクトップRTX 4090(~400ドル)——約10倍の差。
Apple SiliconがローカルLLMに最適な理由
Apple Siliconはローカル LLM推論で優れている一つの理由:統一メモリ。64GB RAMのMacを購入すると、macOSに必要な8GBを除く約56GBをLLMモデルで利用可能。RTX 4090などの離散GPUは24GB VRAM(システムRAMから分離)を持つ——24GBより大きいモデルは複雑マルチGPUセットアップなしで単に適合しません。
- 統一メモリ:macOS用の約8GBを除くRAMを利用可能(チップにより合計16~512GB)。RTX 4090:離散VRAMのみ(ハード24GB上限)。
- Metal加速:CUDA依存性や独自ドライバなしのGPU推論。
- 電力効率:負荷時20~100W対デスクトップGPU 300W+。ファンレスまたはほぼ無音運用可能。
- 静寂:MacBook Airはファンレスで、Mac miniはApple公表でアイドル時5 dBAです。
- ドライバ管理なし:MetalはmacOSで既成事実。CUDA version conflicts無し、NVIDIAドライバ更新無し。
- ハード費用:M5 Pro Mac mini(1,699ドルから)と64GB構成対デュアルGPUセットアップ(4,000ドル+)相応モデル容量。
Apple Siliconチップ:完全比較
チップ | 最大メモリ | メモリ帯域幅 | GPUコア | LLM最適点 | リリース |
|---|---|---|---|---|---|
| M1 | 16 GB | 68 GB/s | 8 | 7B Q4 | 2020年11月 |
| M1 Pro | 32 GB | 200 GB/s | 16 | 13B Q4 | 2021年10月 |
| M1 Max | 64 GB | 400 GB/s | 32 | 32B Q4 | 2021年10月 |
| M1 Ultra | 128 GB | 800 GB/s | 64 | 70B Q4 | 2022年3月 |
| M2 | 24 GB | 100 GB/s | 10 | 7–13B Q4 | 2022年6月 |
| M2 Pro | 32 GB | 200 GB/s | 19 | 13B Q4 | 2023年1月 |
| M2 Max | 96 GB | 400 GB/s | 38 | 34–70B Q4 | 2023年1月 |
| M2 Ultra | 192 GB | 800 GB/s | 76 | 70B+ Q4 | 2023年6月 |
| M3 | 24 GB | 100 GB/s | 10 | 7–13B Q4 | 2023年10月 |
| M3 Pro | 36 GB | 150 GB/s | 18 | 13–32B Q4 | 2023年10月 |
| M3 Max | 128 GB | 400 GB/s | 40 | 70B Q4 | 2023年10月 |
| M4 | 32 GB | 120 GB/s | 10 | 13B Q4 | 2024年5月 |
| M4 Pro | 48 GB | 273 GB/s | 20 | 32B Q4 | 2024年10月 |
| M4 Max | 128 GB | 546 GB/s | 40 | 70B Q4 | 2024年10月 |
| M5(ベース) | 32 GB | ~150 GB/s | 10 | 13B Q4 | 2025年10月 |
| M6(Mac mini) | 32 GB | 最大170 GB/s | 12 | 13B Q4 | 2026年8月 |
| M5 Pro | 64 GB | 307 GB/s | 最大20 | 32B Q5 | 2026年8月 |
| M5 Max | 128 GB | 460–614 GB/s | 32–40 | 70B Q5 | 2026年8月 |
| M5 Ultra | 512 GB | 1.2 TB/s | 最大80 | 120B+ Q4 / 70B FP16 | 2026年8月 |
M5 ProはMacBook Proで先行登場(2026年3月);2026年8月25日の刷新で、まったく新しいM6とともにMac miniにも搭載。M5 MaxとM5 Ultraは2026年8月25日以降Mac Studioで新規登場。4チップとも2026年9月22日から販売中で、M5 Ultraの512GB構成は2026年10月28日から注文できます。M6、M5 Pro、M5 Max、M5 Ultraの数値はAppleのMac miniとMac Studioの仕様に基づきます。
メモリ帯域幅がメモリサイズより重要
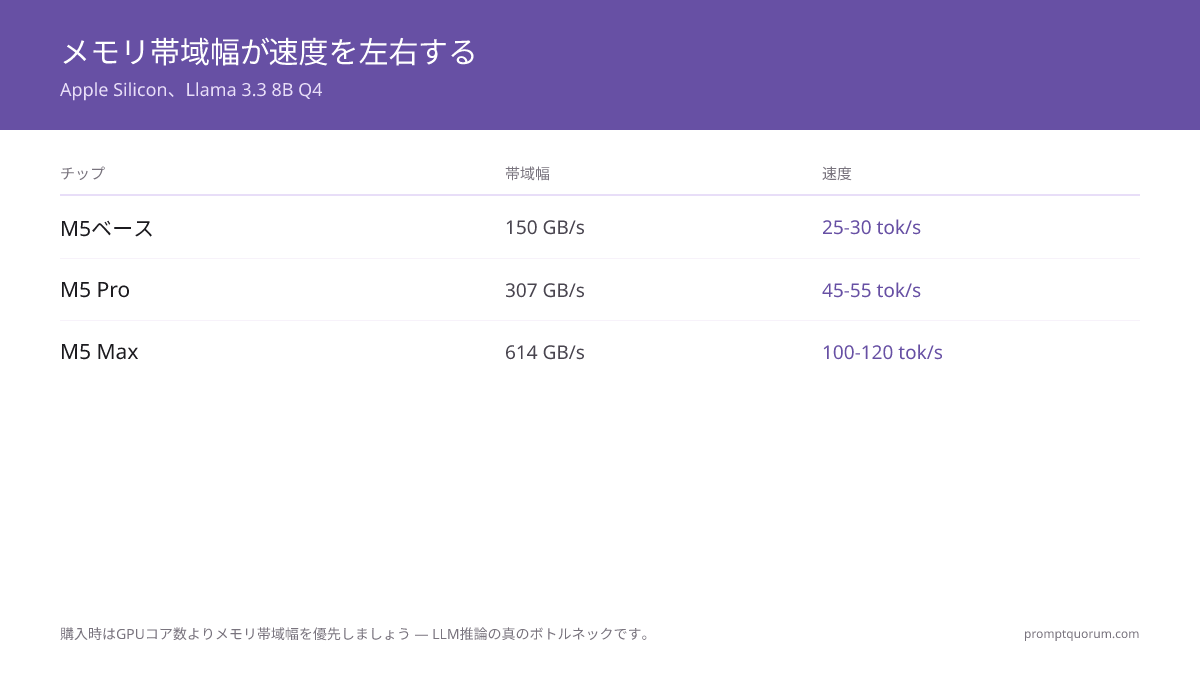
LLM推論はメモリ帯域幅限定で、計算限定ではない。つまりトークン生成速度は帯域幅と線形スケールし、GPU coresではない。
M5 Max 614 GB/sが RTX 4090 1,008 GB/s対は、NVIDIAが生帯域で勝つように見える。しかしApple Siliconユーザーはほぼすべてのメモリを利用可能(合計からmacOS用の約8GBを引いた分、離散VRAM制限なし)なので、NVIDIAが24GBに適合できない大きいモデルを読み込める。
- M5ベース(150 GB/s)→ Llama 3.1 8B Q4で~25~30 tok/s(推定)
- Mac mini M6(最大170 GB/s)→ M5ベースと同程度で、帯域幅が高い分やや上回ります。Appleは相対的な主張(M4 Mac mini比でAI性能最大4倍)のみを公開しており、M6の独立したtok/s数値は未確認です。
- M5 Pro(307 GB/s)→ Llama 3.1 8B Q4で~50~60 tok/s(推定)(2倍帯域幅のため2倍M5ベース)
- M5 Max(614 GB/s)→ Llama 3.1 8B Q4で~100~120 tok/s(推定)
- M5 Ultra(1.2 TB/s、Apple仕様)→ BGRは4ビットQwen 3.8 27Bで約55 tok/sを測定し、M3 Ultra(約819 GB/s)は約40 tok/sでした。帯域幅が約1.5倍で生成速度が約1.4倍であり、帯域幅に律速される推論と整合します。
- レッスン:購入時に帯域幅をGPU coresより優先。

電力効率と熱管理——静粛の利点
セットアップ | 消費電力(アイドル) | 消費電力(LLM) | ノイズ | 熱 |
|---|---|---|---|---|
| Mac mini M6 | 5W | 25–35W | ほぼ無音(アイドル5 dBA) | 暖かい |
| MacBook Air M5 | 3W | 20–30W | 無音(ファンレス) | 暖かい |
| Mac mini M5 Pro | 5W | 40–60W | 静か(ファン少) | 冷たい |
| Mac Studio M5 Max | 10W | 60–100W | 静か | 冷たい |
| Mac Studio M5 Ultra | 10W | 最大480W連続(Apple) | 静か | 冷たい |
| デスクトップRTX 4090 | 50W | 350–450W | 負荷時はファン音が聞こえる | 熱い |
| デスクトップRTX 3060 | 30W | 170–200W | 中程度 | 暖かい |
年間電力費用の推定(0.15ドル/kWh、24時間365日のAIサーバー。目安であり実測ではなく、実際の費用は使用状況によります):Mac mini M6(~35ドル/年)対デスクトップRTX 4090(~400ドル/年)。アイドル時と負荷時の電力値はPromptQuorumの推定で、実測値でもApple仕様でもありません。Appleは最大連続電力をMac miniで155W、Mac Studioで480Wと公表しています。

Apple Siliconでの実ユーザーシナリオ
- 1コーディング エージェント
Why it matters: Llama 3.1 8B on M5 Pro提供50 tok/s(推定)。コード補完の遅延はモデルサイズや設定によって異なり、PromptQuorumでは実測していません。MacBook Proで背景で無音実行。 - 2RAG パイプライン
Why it matters: Embedding model + Llama 3.1 8B + ChromaDB完全36GB M5 Pro統一メモリ適合。GPU制限なし。 - 3ボイス アシスタント
Why it matters: Whisper Metal + Ollama Llama + Piper TTS :遅延はモデルサイズや設定によって異なり、PromptQuorumではM5 Proで実測していません。静かなMac miniがalways-on運用に向いています。 - 4マルチモーダル
Why it matters: Whisper + LLaVA 7B vision + Llama 3.1 8B reasoning = 36GB全対応、同時処理。 - 5プライベート ライティング
Why it matters: Llama 3.3 70B Q5 on M5 Max 128GB = 長文執筆に十分な高品質、モデルのダウンロード後はオフラインで動作、トークン従量のAPIコストなし、推論中のプロンプトは端末内に留まります。新しいMac Studio M5 Ultra(最大512GB)では、より余裕を求めるユーザー向けに120B+モデルも可能になります。
どのMacを購入すべきか?
- 899ドル:Mac mini M6(16GB)→ 試用に十分、7~8Bモデル、最大170 GB/s帯域幅、2026年9月22日から販売
- 899ドル以上:Mac mini M6(32GB、増量は追加料金)→ 13Bまでのモデル
- 1,699ドル:Mac mini M5 Pro(64GB)→ 最大32Bモデルで15~20 tok/s(推定)
- 約2,500ドル:MacBook Pro M5 Pro(48GB)→ ポータブルAIワークステーション
- 2,499ドル:Mac Studio M5 Max(128GB)→ 70Bモデルで12~18 tok/s(推定)、always-onサーバー
- 5,499ドル(96GB)~22,299ドル以上(512GB):Mac Studio M5 Ultra → 120B+モデルに対応する数少ない民生用ハードウェアの一つ、512GB構成は2026年10月28日から注文可
- 重要:メモリは購入時に固定され、アップグレードできません。予算と実行したいモデルに合う最大の構成を購入してください。M5 Ultraの512GBオプションだけで15,500ドルが加算されます(MacRumors)。価格は米国の定価で、日本では異なる場合があります。
はじめに:フレームワーク概要
- Ollama:最も簡単なセットアップ、Metal自動検出、設定なし。REST API含む。初心者に最適。
- MLX:Apple Native framework、コミュニティのテストではOllamaより高速なことが多い、Python統合、LoRA fine-tuning。学習曲線が急。
- llama.cpp:クロスプラットフォームC++、最多モデル形式対応(GGUF)、Metalバックエンド。大型アプリ統合に最適。
2026年8月の刷新:Mac mini M6/M5 Pro、Mac Studio M5 Max/M5 Ultra
Appleは2026年8月25日にMac miniとMac Studioの刷新を発表しました。両機種とも2026年9月22日から販売中で、M5 Ultraの512GB構成は2026年10月28日から注文できます。Apple自身の性能に関する主張はその旨を明記し、独立した結果は出典とともに示します。
- Mac mini M6:899ドルから(教育向け799ドル)、16GB、最大32GBまで構成可能。12コアCPU、12コアGPU、最大170 GB/sのメモリ帯域幅。AppleはM4 Mac mini比でCPU 40%高速、AI性能最大4倍を主張していますが、Apple自身の数値であり独立検証はされていません。
- Mac mini M5 Pro:1,699ドルから。最大18コアCPU、最大20コアGPU、307 GB/s、最大64GB統一メモリ。
- Mac Studio M5 Max:2,499ドルから。18コアCPU、32または40コアGPU、最大128GB統一メモリ、構成により460~614 GB/s。
- Mac Studio M5 Ultra:5,499ドルから(教育向け5,099ドル)、基本96GB統一メモリ、256GBと512GBは受注構成オプション。最大36コアCPU、最大80コアGPU、1.2 TB/sのメモリ帯域幅。512GBオプションは36コアCPU/80コアGPUモデルが必要で、2026年10月28日から注文でき、512GB構成の最低価格は22,299ドルです。
- Mac StudioはRDMA対応のThunderbolt 5クラスタリングをサポートします。Appleは単一システムと比べて分散AI推論が最大3倍高速と主張していますが、Apple自身の数値であり独立検証はされていません。
- 最初の独立したM5 Ultraの結果(BGR、2026年9月21日、256GBモデル、LM Studio、4ビットMLX):Qwen 3.8 27Bで約55 tok/s対M3 Ultraの約40 tok/s、Qwen 3.5 122B A10Bで約80対60 tok/s。BGRは自社テストでM3 Ultraより平均30~40%優れていたと報告しており、コンテキスト長と実行回数は明記していません。
- 旧世代のM4 Mac mini/M4 Pro Mac miniおよびMac Studio M4 Max/M3 Ultraは、現在では前世代です。
- M5 Ultraの512GBは最上位構成であり、120B+パラメータモデルを1台の民生用Macでローカル実行できるようにします。
よくある質問
2026年8月25日にAppleはMac miniとMac Studioについて何を発表した?
Appleは新チップM6(899ドル、16GB、最大32GBまで構成可能)とM5 Pro(1,699ドル、最大64GB)でMac miniを刷新し、M5 Max(2,499ドル、最大128GB)とM5 Ultra(5,499ドル、96GB、最大512GB)でMac Studioを刷新しました。すべて2026年9月22日から販売中で、M5 Ultraの512GB構成は2026年10月28日から22,299ドルで注文できます。
ローカルLLM用ってM5 ProとM5 Maxどっち?
M5 Pro(64GB)がベスト value——32Bモデル実行良好で1,699ドルから。M5 Max(2,499ドル以上)は70Bモデル定期必要時のみ。M5 Pro(64GB)は、本ガイドで扱う32Bクラスの多くの用途で高いコストパフォーマンスを発揮します。70Bモデルを定期的に使うならM5 Maxが有力です。
購入後Macのメモリをアップグレードできる?
いいえ。Apple Siliconメモリははんだ付けで非アップグレード。購入時に最大メモリを買える範囲で購入。
M5 Proでは RTX 4090に競争可能?
24GB VRAMに収まるモデルでは、RTX 4090のほうが高速なことが多いですが、差はモデルと量子化によって異なり、PromptQuorumは測定していません。70Bモデルは、RTX 4090の24GBには全体が収まらず(一部をCPUにオフロードできますが大幅に遅くなります)、64GBのM5 Proなら4ビット量子化で保持できます。参照:Apple Silicon vs NVIDIA GPU for LLMs。
OllamaとMLXとllama.cppどれ使う?
Ollama(最簡単)から開始。高速推論またはファインチューニング必要ならMLXに切り替え。クロスプラットフォーム互換性必要ならllama.cpp。すべてApple Siliconで動作。
M5 Ultraが最大512GBメモリで何変わる?
はい、変わります。M5 Ultra(Mac Studio、96GBで5,499ドルから、1.2 TB/s、最大512GBは22,299ドルから)は70BモデルをFP16(量子化なし、量子化による劣化なし)で実行でき、1台の民生用Mac(512GB構成)で120B+モデルに対応します。確認できた最初の独立テスト(BGR、2026年9月21日、256GBモデル)では、4ビットQwen 3.8 27Bが約55 tok/sで、M3 Ultraの約40 tok/sを上回りました。PromptQuorumは独自のM5 Ultraベンチマークを実施していません。
2026年にApple Siliconはローカルに価値?
はい、特に32B+モデルなら。Apple Siliconは複雑なマルチGPUセットアップなしで70Bモデルを実行できる数少ない民生ハードウェアの一つであり、Mac Studio M5 Ultraは120B+モデルを収容できる数少ない民生用ハードウェアの一つです。24GB NVIDIAに収まる8Bモデルではマシン高速ですが、運用費高。ほぼユーザーはMac mini M5 Pro(1,699ドルから、最大64GB)をベスト value-performanceとして落ち着く。
MacBook Air M5でローカルLLMを実行できる?
はい、制限あり。MacBook Air M5は16GBで7~8Bモデル(macOS後に約8GB残る)、24~32GBで13Bまで実行可能。ファンレス設計のため、高負荷が続くと熱スロットリングが起きることがあります。時々使用:問題なし。常時推論:Mac mini M5 Proが最適。
Apple M6のローカルLLM性能はどのくらい?
Appleが公開しているのは相対的な主張のみで、M4 Mac mini比でAI性能最大4倍、CPU 40%高速です。2026年8月の刷新では、M6はMac miniにのみ搭載されました(899ドル、16GB、最大32GB、最大170 GB/s)。生成速度はメモリ帯域幅に比例するため、M5 ProではなくベースのM5に近い水準と予想されます。M6の独立したtok/s数値は未確認です。
32GBのM1 MacにはどんなローカルLLM構成が最適?
32GBのM1 ProまたはM1 Max(200 GB/sと400 GB/s)は、上のチップ比較表の最適点である13B Q4モデルを余裕をもって実行できます。64GBのM1 Maxなら32B Q4まで届きます。無印のM1は最大16GBなので、7B Q4が目安です。
ローカルLLMでM3 UltraとM5 Maxはどう違う?
M3 Ultraはメモリ容量でM5 Maxを上回り(最大512GB対128GB)、最大級のモデルを収容できます。速度についてBGRは、27BテストでM5 Max搭載MacBook ProがM3 Ultra搭載Mac Studioと同程度の性能で、M5 Ultraは平均でM3 Ultraより30~40%優れていたと報告しています。48GBのM5 Proは両者の下に位置し、Ultraの価格なしで余裕を求める人に最適です。
日本の規制要件を検討すべき?
ローカルLLMを導入する場合は、METIのAIガバナンス指針などの確認をお勧めします。データをオンプレミスのデバイスに留めることで対応を進めやすくなる場合がありますが、適合を保証するものではなく、個別の状況によります。
日本の企業でローカルLLMを導入するメリット?
メリットの例:(1)データ主権——データを社内デバイスに留め、クラウドへ送信しない運用が可能 (2)規制対応の負担軽減——METI指針や個人情報保護法への対応を進めやすくなる場合がありますが、適合を保証するものではありません (3)運用コスト——従量課金のクラウドAPI費用を抑えられる場合があります。実際の効果は利用量と構成によります。
ベンチマーク手法と鮮度
- MacBook Pro構成のM5 Pro/Maxデータは2026年3月~5月のコミュニティベンチマークに基づく
- M5 Ultra:独立した結果があります(BGR、2026年9月21日、256GBモデル。2026年8月の刷新セクション参照)。M6およびMac mini/Mac StudioのM5 Pro/M5 Maxのtok/s数値は、帯域幅に基づく推定またはコミュニティ結果です。Apple自身の性能に関する主張はその旨を明記しています
- 最終検証:2026-11-02
- パフォーマンスはフレームワーク更新(Ollama、MLX、llama.cppは月間リリース)で改善
- この記事は四半期ごとに見直し、M6とMac Studio M5 Maxの独立した結果を確認でき次第追加します