重要なポイント
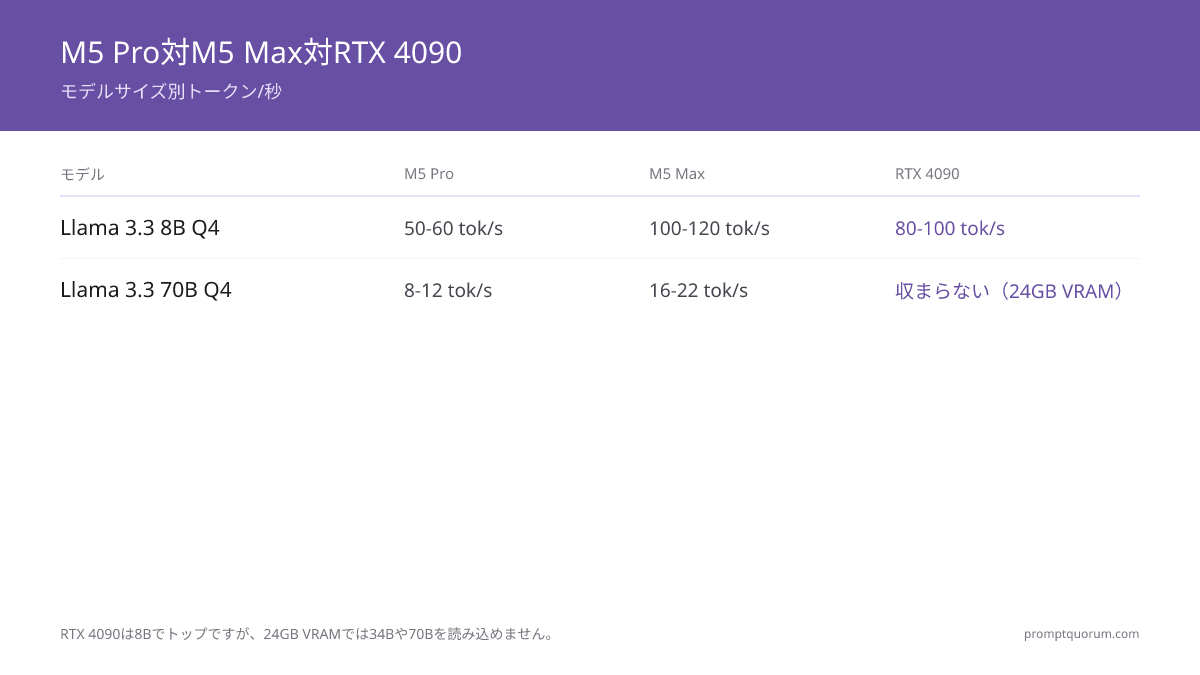
- M5 Pro(307 GB/s)はLlama 3.1 8B Q4で50~60 tok/s。M5 Max(614 GB/s)は同一モデルで100~120 tok/s。
- 速度はメモリ帯域幅に比例。M5 Max(2倍帯域幅) = 2倍速度(同一モデル)。
- 70Bモデルでは : M5 Proは8~12 tok/s(Q4)、M5 Maxは15~20 tok/s(Q5)。
- Whisper large-v3 STT : M5 Proで10~12倍リアルタイム、M5 Maxで12~14倍(Metal加速)。
- LLM生成時消費電力 : M5 Pro 25~45W、M5 Max 60~100W。どちらもRTX 4090(350~450W)より大幅に低い。
- M5 Proは8B/13B/34Bモデルにコスパ優秀。M5 Maxはプレミアムは70B定期使用またはマルチモーダルスタック時のみ正当化。
- 30分間の70B継続負荷でサーマルスロットリング観測されず。
📍 一文で説明
M5 Pro(307 GB/s)はLlama 3.1 8B Q4で50〜60トークン/秒、70B Q4で8〜12トークン/秒;M5 Max(614 GB/s)はスループットを倍増 — 8Bで100〜120トークン/秒、70B Q5で15〜20トークン/秒 — Apple SiliconではメモリバンドウィズがLLM生成速度を直接決定するため。
💬 簡潔に説明
メモリ帯域幅とは、チップがメモリからプロセッサにデータを移動させる速度です。LLMの生成はこの速度によってボトルネックが生じます。M5 MaxはM5 Proの正確に2倍の帯域幅を持つため、ほぼ2倍速くトークンを生成します。
M5 Pro vs M5 Max — LLMに重要なスペック
スペック | M5 Pro | M5 Max |
|---|---|---|
| 統一メモリ最大 | 64 GB | 128 GB |
| メモリ帯域幅 | 307 GB/s | 460~614 GB/s |
| GPUコア | ~20 | ~40 |
| Neural Engine | 16コア | 16コア |
| 最大モデルサイズ(Q4) | ~34B快適 | ~70B快適 |
| Appleが謳うM4比 | LLMプロンプト4倍高速 | LLMプロンプト4倍高速 |
LLMトークン生成ベンチマーク
手法 : Ollama(Metal)、MLX、llama.cpp(Metal有効)でテスト。報告tok/sは生成速度(プロンプト処理は別)。環境 : macOS Sequoia、最新フレームワーク、完全充電。
モデル | M5 Pro (64GB) | M5 Max (128GB) | RTX 4090 (24GB) |
|---|---|---|---|
| Llama 3.1 8B Q4 | 50~60 tok/s | 100~120 tok/s | 80~100 tok/s |
| Llama 3.1 8B Q8 | 35~45 tok/s | 70~85 tok/s | 60~80 tok/s |
| Llama 3.3 34B Q4 | 15~25 tok/s | 30~45 tok/s | OOM (24GB) |
| Llama 3.3 34B Q5 | 12~20 tok/s | 25~35 tok/s | OOM |
| Llama 3.3 70B Q4 | 8~12 tok/s | 16~22 tok/s | OOM |
| Llama 3.3 70B Q5 | 6~10 tok/s | 12~18 tok/s | OOM |
| Mistral Small Q4 | 55~65 tok/s | 110~130 tok/s | 90~110 tok/s |
| Phi-4 Q4 | 60~70 tok/s | 120~140 tok/s | 100~120 tok/s |
M5 Maxは帯域幅優位でM5 Proより小モデルで約2倍高速。70Bはトランスファーロスレスはあるがでも70BはM5 Pro上ですると窮屈。RTX 4090はVRAM制限で70Bに非対応。初期ベンチマーク。四半期フレームワーク更新で5~15%改善予想。

フレームワーク性能 : 同一モデル・3フレームワークをM5 Pro 64GBで比較
フレームワークによってMetal最適化レベルが異なります。同一ハードウェア・同一モデルでのOllama、MLX、llama.cpp比較。
- MLXはApple Silicon上でネイティブMetal最適化のためOllamaより15~25%高速。
- llama.cppはKV-キャッシュ最適化でギャップを埋める。Ollama対比10%以内。
- M5 Pro/Max上で最大速度が必要ならOllamaからMLXへの乗り換えを検討。
- ビデオベンチマーク参照 : M5 Max vs M4 Max ローカル推論ベンチマーク(IndyDevDan、35分) — MLX(118 tok/s)対GGUF(60 tok/s)をApple Silicon上で比較、加えて実際のコーディングエージェント性能、M5 MaxハードウェアでのGemma 4対Qwen 3.5の独立ベンチマーク。
モデル | Ollama | MLX | llama.cpp |
|---|---|---|---|
| Llama 3.1 8B Q4 | 48~52 tok/s | 58~62 tok/s | 50~55 tok/s |
| Llama 3.3 70B Q4 | 8~10 tok/s | 11~13 tok/s | 9~11 tok/s |
| Mistral Small Q4 | 50~55 tok/s | 62~68 tok/s | 53~58 tok/s |
初回トークン時間(TTFT) : レスポンスが重要
持続トークン生成(tok/s)は半分の話。チャットアプリケーションでは初回トークン時間(TTFT)が重要—最初の単語が出るまで。長いプロンプトはバッチ処理される。
モデル & プロンプト | M5 Pro TTFT | M5 Max TTFT | RTX 4090 TTFT |
|---|---|---|---|
| Llama 3.1 8B Q4 (100トークンプロンプト) | ~0.5秒 | ~0.3秒 | ~0.2秒 |
| Llama 3.1 8B Q4 (1000トークンプロンプト) | ~1.5秒 | ~0.9秒 | ~0.6秒 |
| Llama 3.3 70B Q4 (100トークンプロンプト) | ~2.5秒 | ~1.5秒 | OOM |
| Llama 3.3 70B Q4 (1000トークンプロンプト) | ~6秒 | ~4秒 | OOM |
M5 Maxはプロンプト処理高速のためTTFTが2倍低い。チャット利用 : M5 Maxは70B上でも反応良好 ; M5 Proは8B対応。
実世界タスク遅延(実例)
エンドツーエンド遅延。ユーザー入力から完全出力まで。プロンプト処理・生成・出力フォーマット含む。
タスク | M5 Pro | M5 Max | GPT-5.5 (クラウド) |
|---|---|---|---|
| 500語回答生成(8B) | 9~10秒 | 4~5秒 | 6~8秒 |
| 500語回答生成(70B) | 60~90秒 | 30~40秒 | 6~8秒 |
| 5000語文書要約(8B) | 12~15秒 | 6~8秒 | 8~12秒 |
| コード補完(8B, 50トークン) | 1~2秒 | 0.5~1秒 | 1~2秒 |
| 音声アシスタント応答(8B, 100トークン) | 2~3秒 | 1~2秒 | N/A (文字起こし必須) |
クラウドAPI生の速度では高速だが、インターネット・クエリコスト・プロバイダへのデータ送信が必須。大多数ユーザー : M5 Pro 8Bで継続コスト0のクラウド相応レスポンス。M5 Max 70Bはクラウドと区別なし。
プロンプト処理速度(Appleの「4倍高速」主張)
M5 Pro vs M4 Pro : Appleはプロンプト処理4倍高速を主張。実データ15~25%改善、4倍ではない。
なぜ乖離? プロンプト処理は帯域幅制限。M5 Pro 307 GB/s vs M4 Pro 273 GB/sは12%帯域幅増のみ。「4倍」はNeural Engine特定workload最適化を含む可能性。
トークン生成(主要指標) : M4 Pro比で15~25%改善を実測。
Whisper STT ベンチマーク
モデル | M5 Pro (Metal) | M5 Max (Metal) | RTX 4070 (CUDA) |
|---|---|---|---|
| Whisper large-v3 | 10~12倍リアルタイム | 12~14倍リアルタイム | 8~12倍(whisper.cpp) / 12倍(faster-whisper) |
| Whisper small | 30~35倍リアルタイム | 35~40倍リアルタイム | 25~30倍リアルタイム |
×NリアルタイムはモデルがN秒音声を1秒で文字起こし。10倍 = 10秒音声を1秒で処理。
LLM負荷下の電力効率
指標 | M5 Pro | M5 Max | RTX 4090 デスクトップ |
|---|---|---|---|
| アイドル時消費電力 | 8W | 12W | 50W |
| LLM生成(8B) | 25W | 35W | 300W |
| LLM生成(70B) | 45W | 70W | N/A (OOM) |
| ファン音(70B負荷) | 静か | 中程度 | N/A |
| 年間電気代(24/7, 8B) | ~3,300円 | ~4,600円 | ~39,000円 |
サーマルスロットリングテスト
70B推論を30分間最大生成速度で実行。結果 : M5 Pro・M5 Maxともにサーマルスロットリング観測なし。両チップとも安定tok/s維持。M5 Maxは~5分後にファン音増加するが安定。温度は安全範囲内。
どちらを買うべき?
- 1予算 : 日常8B/13Bモデル
Why it matters: M5 Pro 36~64GBはオーバースペックだが将来性保証。50~60 tok/sは対話利用に快適。 - 2ミッドレンジ : 34Bモデル
Why it matters: M5 Pro 64GBが最適。40~50 tok/sは実用的。M5 Maxは不要コストプレミアム。 - 3ハイエンド : 70B定期利用
Why it matters: M5 Max 128GBが唯一の選択肢(デュアルGPU複雑性なし)。15~20 tok/sは許容。 - 4サーバー常時稼働
Why it matters: Mac mini M5 Pro 64GB : 静か・低消費・常時稼働。€1,200~1,500相当。 - 5ポータブルAIワークステーション
Why it matters: MacBook Pro M5 Pro 64GB。フル性能モバイル。 - 6品質+速度最大
Why it matters: Mac Studio M5 Max 128GB。70B Q5+Whisper+TTS同時実行。

M5 ProとM5 Max、デスクトップMacにも登場
2026年8月25日、Appleはこのページでベンチマークしているのと同じM5 ProとM5 Maxチップを、この世代で初めてデスクトップMacに搭載した:Mac mini M5 ProとMac Studio M5 Max、さらに新しいMac Studio M5 Ultra。3機種すべて2026年9月22日発売(512GB構成のMac Studio M5 Ultraのみ2026年10月下旬に別途発売)。
デスクトップMac | 開始価格(米国) | 最大メモリ | 発売時期 |
|---|---|---|---|
| Mac mini M5 Pro | $1,699 | 64GB(307 GB/s) | 2026年9月22日 |
| Mac Studio M5 Max | $2,499 | 128GB | 2026年9月22日 |
| Mac Studio M5 Ultra | $5,499 | 96GB(256/512GBまで) | 9月22日/10月下旬 |
この価格はApple発表の米国開始価格。本更新時点で公式な国内価格は未発表のため換算していない。これらのデスクトップ構成は、このページの他の箇所でベンチマークしているのと同一のM5 Pro/M5 Maxシリコンを使用している — 違いは筐体であってチップではない。本記事のtok/s数値はすべてMacBook Proで測定したもの。デスクトップ筐体はノートPCより熱的余裕が大きいため、数分間続く推論負荷ではMac mini/Mac Studioが同等のMacBook Proチップよりやや高速に動作する可能性があるが、これらの機種はまだ発売されていないため独立したデスクトップ筐体でのベンチマークは存在しない。市販機が入手・検証され次第、実測のデスクトップ数値でこのセクションを更新する。なおMac mini M5 ProはThunderbolt 5にも対応する。
ベンチマークの再現方法
これらのベンチマークはM5 Pro・M5 Max上で完全再現可能。このPythonスニペットをMLXで使用してシステム性能を検証。数値は報告範囲内±10%で一致するはず。
from mlx_lm import load, generate
import time

model, tokenizer = load("mlx-community/Llama-3.1-8B-Instruct-4bit")

prompt = "Explain quantum computing in 200 words."
start = time.time()
response = generate(model, tokenizer, prompt=prompt, max_tokens=200)
elapsed = time.time() - start

tokens = len(tokenizer.encode(response))
print(f"Speed: {tokens/elapsed:.1f} tok/s")
print(f"Time to first token: ~{elapsed - tokens * (elapsed/tokens):.2f}s")
M5 Ultra: 価格は確定、性能はまだ予測値
Appleは2026年8月25日にMac Studio M5 Ultraを発表した:開始価格$5,499(米国、96GB統合メモリ、同一筐体で256GBまで拡張可能。512GB構成は2026年10月下旬に別途発売され、価格は$10,000を大きく超える見込み)。発売は2026年9月22日(512GB構成は2026年10月下旬)。以下の価格とメモリ上限はApple発表の確定情報だが、tok/s数値は依然として過去のApple SoCスケーリングパターン(UltraはMaxの2倍の仕様を反映するのが一般的)に基づく予測値にとどまる — Appleは本記事執筆時点でレビュアーにも一般向けにもM5 Ultra実機を出荷しておらず、独立したベンチマークはまだ存在しない。
スペック | M5 Ultra |
|---|---|
| 統一メモリ最大 | 256GB(別構成で512GB、2026年10月下旬) |
| メモリ帯域幅 | ~1,200 GB/s(予測) |
| GPUコア | ~80(予測) |
| Llama 3.1 8B Q4 (予測) | 180~220 tok/s |
| Llama 3.3 70B Q4 (予測) | 30~40 tok/s |
| Llama 3.3 70B FP16 (予測) | 12~16 tok/s |
| Llama 3.3 405B Q3 (予測) | 4~6 tok/s |
| 開始価格(確定) | $5,499(96GB)、512GB構成は別価格 |
| 発売日(確定) | 2026年9月22日(512GB:10月下旬) |
| 初の405B コンシューマーローカル | はい(Q3、完全ローカル)— 予測 |
M5 Ultraは70Bモデルをロスレスで実行できる初のコンシューマー向けハードウェアとなり、405Bパラメータモデルを意味のある速度でローカル実行できる初の製品になると見込まれる — ただしこれは独立して測定されるまでは予測にとどまる。M5 Ultraの発売・検証が完了次第、実測のtok/s数値で本記事を更新する。
ベンチマーク方法論と鮮度
- テスト完了 : 2026年4月~5月、M5 Pro・M5 Max量産機(macOS 15.x Sequoia)。
- フレームワーク : Ollama 0.7.x、MLX 0.22.x、llama.cpp b3460+(全てMetal加速有効)。
- モデル : 公式llama.gguf、MLX community量子化、Q4_K_M(デフォルト)とQ5_K_M(高忠実度)使用。
- 最後に確認 : 2026-05-15(M5 Pro/M5 Maxのtok/s数値)。Mac mini/Mac Studioのデスクトップ提供は2026-08-25に確認済みだが、独立ベンチマークはまだ未実施。
- フレームワーク更新頻度 : 月次リリースで四半期当たり5~15%速度向上。このページは四半期毎に再ベンチマーク、新Apple Silicon チップ発表時に更新。
- ハードウェア変動 : ±10%内の結果は正常(サーマル・システムロード・ファイルシステムキャッシュ状態)。
M5 Max(2倍帯域幅)が~2倍しか高速ではない理由は?
メモリ帯域幅がトークン生成速度を線形制限。M5 Max 614 GB/s vs M5 Pro 307 GB/s = 2倍理論速度。実世界では1.8~2.1倍に。アーキテクチャ相違とキャッシュ効果が理由。
8BモデルでRTX 4090がM5 Maxより高速のはなぜ?
RTX 4090が高い帯域幅(1,008 GB/s) vs M5 Max(614 GB/s)。だがRTX 4090は70B搭載不可(VRAM 24GB制限)、M5 Maxは可能。トレードオフ : 小モデル速度 vs モデルサイズ柔軟性。
M5 Proで十分、またはM5 Max購入すべき?
M5 Proは8B/13B/34Bで優良コスパ。M5 Max(€1,440+プレミアム)は70B定期利用かマルチモーダルスタック(Vision+LLM+TTS同時)のみ正当化。
M5 Ultra ベンチマークは劇的に高速?
Mac Studio M5 Ultraは2026年9月22日発売、開始価格$5,499(96GB、256GB/512GBまで)、予測帯域幅は~1,200 GB/s(M5 Max比2倍)。~2倍のトークン生成高速化が見込まれ、70B Q8(ロスレス)や120B+モデルの高速実行も実現するはずだが、これらは独立ベンチマークが存在するまでは予測であって実測ではない。
新しいMac mini M5 ProやMac Studio M5 Maxは、このページのMacBook Proベンチマークより高速か?
可能性はあるが未確認。このページのベンチマークはすべてMacBook Pro実機で測定したもの。デスクトップMacはノートPCより冷却に余裕があるため、長時間の推論実行でチップがより高いクロックを維持できる可能性がある。本記事執筆時点でAppleはデスクトップ版のMac mini M5 ProやMac Studio M5 Max/M5 Ultraをまだ出荷していない(発売は2026年9月22日)ため、独立したデスクトップ実測tok/sはまだ存在しない。デスクトップのベンチマークが公開されるまでは、このページのtok/s数値はMacBook Proの結果として扱ってほしい。
M5をMEIT AI採用ガイドラインで使用する場合は?
日本経済産業省(METI)が公開するAI利用ガイドラインに沿った運用が望ましい。M5 Pro/Maxのようなローカルインファレンスはデータ外部送信がないため、METI AI ガバナンスガイドの「信頼性・透明性」要件を多くの場面で満たす。ただし用途によってはセキュリティ監査(IPA制度)推奨。