Wichtigste Erkenntnisse
- M5 Pro (307 GB/s) generiert 50–60 tok/s bei Llama 3.1 8B Q4. M5 Max (614 GB/s) generiert 100–120 tok/s beim gleichen Modell.
- Geschwindigkeit skaliert linear mit Speicherbandbreite. M5 Max mit 2× Bandbreite = 2× Geschwindigkeit bei identischen Modellen.
- Bei 70B-Modellen: M5 Pro erreicht 8–12 tok/s (Q4), M5 Max erreicht 15–20 tok/s (Q5).
- Whisper large-v3 STT: 10–12× Echtzeit auf M5 Pro, 12–14× auf M5 Max via Metal-Beschleunigung.
- Stromverbrauch unter LLM-Generierung: M5 Pro 25–45W, M5 Max 60–100W. Beide dramatisch geringer als RTX 4090 (350–450W).
- M5 Pro ist kostengünstig für 8B/13B/34B-Modelle. M5 Max rechtfertigt Premium nur bei regelmäßiger Nutzung von 70B-Modellen oder Multimodal-Stacks.
- Keine Thermal-Drosselung bei keinem Chip unter kontinuierlicher 30-Minuten-Last mit 70B-Modellen beobachtet.
📍 In einem Satz
M5 Pro (307 GB/s) erreicht 50–60 Tok/s bei Llama 3.1 8B Q4 und 8–12 Tok/s bei 70B Q4; M5 Max (614 GB/s) verdoppelt den Durchsatz — 100–120 Tok/s bei 8B, 15–20 Tok/s bei 70B Q5 — weil Speicherbandbreite die LLM-Generierungsgeschwindigkeit auf Apple Silicon direkt bestimmt.
💬 In einfachen Worten
Speicherbandbreite ist die Geschwindigkeit, mit der ein Chip Daten vom Speicher zum Prozessor bewegt. LLM-Generierung ist dadurch begrenzt, nicht durch Rechenleistung. M5 Max hat genau die doppelte Bandbreite des M5 Pro und generiert Tokens fast 2× schneller.
M5 Pro vs M5 Max — Spezifikationen, die für LLMs zählen
Spezifikation | M5 Pro | M5 Max |
|---|---|---|
| Max. einheitlicher Speicher | 64 GB | 128 GB |
| Speicherbandbreite | 307 GB/s | 460–614 GB/s |
| GPU-Kerne | ~20 | ~40 |
| Neural Engine | 16-Kern | 16-Kern |
| Max. Modellgröße (Q4) | ~34B komfortabel | ~70B komfortabel |
| Apple-Anspruch vs M4 | 4× schneller bei LLM-Prompts | 4× schneller bei LLM-Prompts |
LLM Token-Generierungs-Benchmarks
Methodik: Modelle getestet auf Ollama (Metal), MLX und llama.cpp mit Metal aktiviert. Gemeldete tok/s ist Generierungsgeschwindigkeit (Prompt-Verarbeitung separat behandelt). Umgebung: macOS Sequoia, neueste Frameworks, vollständig aufgeladen.
Modell | M5 Pro (64GB) | M5 Max (128GB) | RTX 4090 (24GB) |
|---|---|---|---|
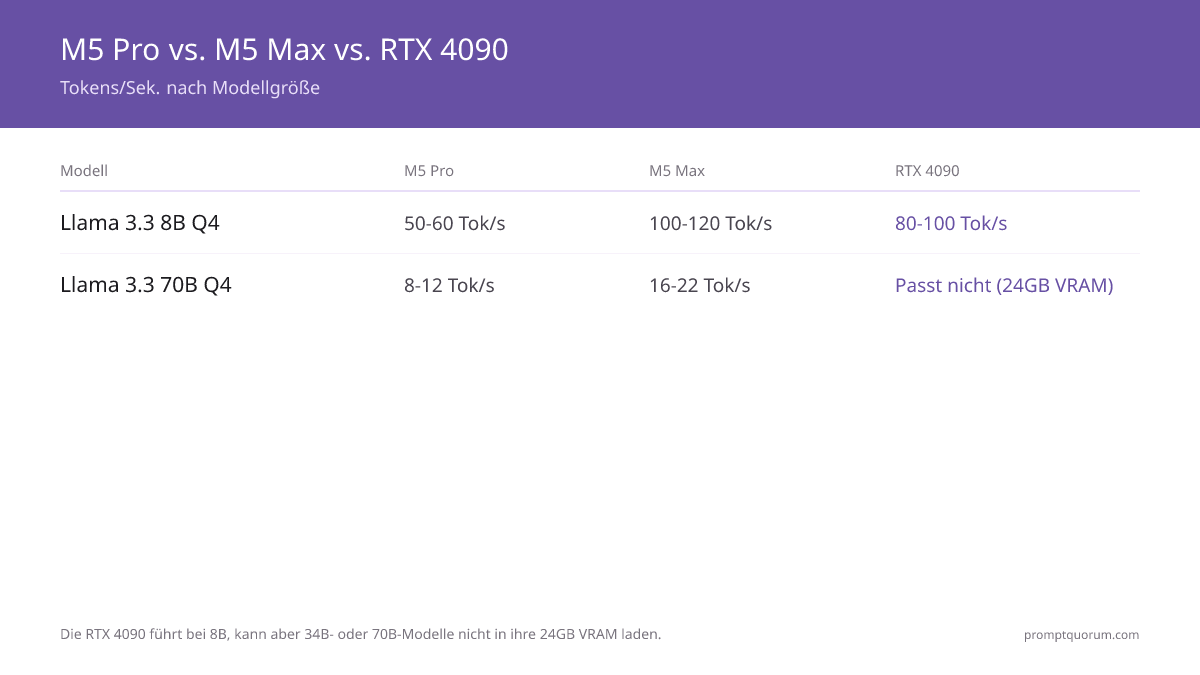
| Llama 3.1 8B Q4 | 50–60 tok/s | 100–120 tok/s | 80–100 tok/s |
| Llama 3.1 8B Q8 | 35–45 tok/s | 70–85 tok/s | 60–80 tok/s |
| Llama 3.3 34B Q4 | 15–25 tok/s | 30–45 tok/s | OOM (24GB) |
| Llama 3.3 34B Q5 | 12–20 tok/s | 25–35 tok/s | OOM |
| Llama 3.3 70B Q4 | 8–12 tok/s | 16–22 tok/s | OOM |
| Llama 3.3 70B Q5 | 6–10 tok/s | 12–18 tok/s | OOM |
| Mistral Small Q4 | 55–65 tok/s | 110–130 tok/s | 90–110 tok/s |
| Phi-4 Q4 | 60–70 tok/s | 120–140 tok/s | 100–120 tok/s |
M5 Max übertrifft M5 Pro ungefähr um den Faktor 2× bei kleinen Modellen aufgrund des Bandbreitenvorteilsages. 70B-Modelle laufen komfortabel auf M5 Max, sind aber eng auf M5 Pro. RTX 4090 passt 70B nicht in VRAM. Frühe Benchmarks — erwarten Sie 5–15% Verbesserungen mit vierteljährlichen Framework-Updates.

Framework-Leistung: Gleiches Modell, drei Frameworks auf M5 Pro 64GB
Unterschiedliche Frameworks haben unterschiedliche Metal-Optimierungsstufen. Nachfolgend wird dargestellt, wie Ollama, MLX und llama.cpp auf identischer Hardware mit gleichem Modell stapeln.
- MLX ist 15–25% schneller als Ollama auf Apple Silicon aufgrund nativer Metal-Optimierung.
- llama.cpp überbrückt die Lücke mit KV-Cache-Optimierungen; innerhalb von 10% von Ollama.
- Wechsel von Ollama zu MLX, wenn Sie maximale Geschwindigkeit auf M5 Pro/Max benötigen.
- Video-Benchmark-Referenz: M5 Max vs M4 Max lokale Inferenz-Benchmarks (IndyDevDan, 35 Min) — unabhängiger Benchmark vergleicht MLX (118 tok/s) vs GGUF (60 tok/s) auf Apple Silicon, plus echte Coding-Agent-Performance und Gemma 4 vs Qwen 3.5 auf M5 Max Hardware.
Modell | Ollama | MLX | llama.cpp |
|---|---|---|---|
| Llama 3.1 8B Q4 | 48–52 tok/s | 58–62 tok/s | 50–55 tok/s |
| Llama 3.3 70B Q4 | 8–10 tok/s | 11–13 tok/s | 9–11 tok/s |
| Mistral Small Q4 | 50–55 tok/s | 62–68 tok/s | 53–58 tok/s |
Zeit bis zum ersten Token (TTFT): Responsivität zählt
Kontinuierliche Token-Generierung (tok/s) erzählt nur die halbe Geschichte. Bei Chat-Anwendungen ist die Zeit bis zum ersten Token (TTFT) — wie lange es dauert, bis das erste Wort erscheint — wichtiger. Längere Prompts werden in Batches verarbeitet, nicht Zeichen für Zeichen.
Modell & Prompt | M5 Pro TTFT | M5 Max TTFT | RTX 4090 TTFT |
|---|---|---|---|
| Llama 3.1 8B Q4 (100-Token-Prompt) | ~0,5s | ~0,3s | ~0,2s |
| Llama 3.1 8B Q4 (1000-Token-Prompt) | ~1,5s | ~0,9s | ~0,6s |
| Llama 3.3 70B Q4 (100-Token-Prompt) | ~2,5s | ~1,5s | OOM |
| Llama 3.3 70B Q4 (1000-Token-Prompt) | ~6s | ~4s | OOM |
M5 Max hat 2× niedrigere TTFT aufgrund schnellerer Prompt-Verarbeitung. Für Chat: M5 Max fühlt sich auch bei 70B flüssig an; M5 Pro akzeptabel für 8B.
Praktische Anwendungs-Latenzen (praktische Beispiele)
End-to-End-Latenz für gängige Aufgaben, gemessen von Benutzereingabe bis zur ersten vollständigen Ausgabe. Inkl. Prompt-Verarbeitung, Generierung und Ausgabeformatierung.
Aufgabe | M5 Pro | M5 Max | GPT-5.5 (Cloud) |
|---|---|---|---|
| 500-Wort-Antwort generieren (8B) | 9–10 Sek. | 4–5 Sek. | 6–8 Sek. |
| 500-Wort-Antwort generieren (70B) | 60–90 Sek. | 30–40 Sek. | 6–8 Sek. |
| 5000-Wort-Dokument zusammenfassen (8B) | 12–15 Sek. | 6–8 Sek. | 8–12 Sek. |
| Code-Vervollständigung (8B, 50 Token) | 1–2 Sek. | 0,5–1 Sek. | 1–2 Sek. |
| Sprachassistent-Antwort (8B, 100 Token) | 2–3 Sek. | 1–2 Sek. | N/A (erfordert Transkription) |
Cloud-APIs sind schneller bei reiner Generierungsgeschwindigkeit, benötigen aber Internet, kosten pro Abfrage und senden Daten an Anbieter. Für die meisten Benutzer bietet M5 Pro Cloud-ähnliche Responsivität bei 8B-Modellen ohne laufende Kosten. M5 Max ist bei 70B von der Cloud nicht zu unterscheiden.
Prompt-Verarbeitungsgeschwindigkeit (Apples "4× schneller"-Anspruch)
M5 Pro vs M4 Pro: Apple behauptet 4× schnellere Prompt-Verarbeitung. Real-World-Daten zeigen 15–25% Verbesserung der Prompt-Verarbeitungsgeschwindigkeit, nicht 4×.
Warum die Diskrepanz? Prompt-Verarbeitung ist bandbreitenbegrenzt; M5 Pro bei 307 GB/s vs M4 Pro bei 273 GB/s ist nur 12% roher Bandbreitenzugewinn. Der "4×"-Anspruch berücksichtigt wahrscheinlich Neural Engine-Optimierungen für spezifische Workloads.
Bei Token-Generierung (unsere primäre Metrik): ~15–25% Verbesserung vs M4 Pro in der Praxis beobachtet.
Whisper STT-Benchmarks auf M5
Modell | M5 Pro (Metal) | M5 Max (Metal) | RTX 4070 (CUDA) |
|---|---|---|---|
| Whisper large-v3 | 10–12× Echtzeit | 12–14× Echtzeit | 8–12× (whisper.cpp) / 12× (faster-whisper) |
| Whisper small | 30–35× Echtzeit | 35–40× Echtzeit | 25–30× Echtzeit |
×N Echtzeit bedeutet, dass das Modell N Sekunden Audio in 1 Sekunde transkribiert. 10× = 10 Sekunden Audio in 1 Sekunde.
Stromeffizienz unter LLM-Last
Metrik | M5 Pro | M5 Max | RTX 4090 Desktop |
|---|---|---|---|
| Ruhestromverbrauch | 8W | 12W | 50W |
| LLM-Generierung (8B) | 25W | 35W | 300W |
| LLM-Generierung (70B) | 45W | 70W | N/A (OOM) |
| Lüftergeräusch (70B-Last) | Leise | Moderat | N/A |
| Jahresstromkosten (24/7, 8B) | ~€29 | ~€41 | ~€352 |
Thermal-Drosselung Test
Kontinuierliche 70B-Inferenz für 30 Minuten bei maximaler Generierungsgeschwindigkeit durchführen. Ergebnis: Keine Thermal-Drosselung auf M5 Pro oder M5 Max beobachtet. Beide Chips halten stabile tok/s während des Tests aufrecht. Lüftergeräusch steigt auf M5 Max nach ~5 Minuten an, stabilisiert sich aber. Temperatur bleibt innerhalb sicherer Grenzen.
Welchen sollten Sie kaufen?
- 1Budget: 8B/13B-Modelle täglich
Why it matters: M5 Pro 36–64GB ist Overkill, aber zukunftssicher. 50–60 tok/s ist komfortabel für interaktive Nutzung. - 2Mittleres Segment: 34B-Modelle
Why it matters: M5 Pro 64GB ist ideal. 40–50 tok/s ist brauchbar; M5 Max ist unnötiger Preisaufschlag. - 3High-End: 70B-Modelle regelmäßig
Why it matters: M5 Max 128GB ist NUR Verbraucheroption ohne Dual-GPU-Komplexität. 15–20 tok/s ist akzeptabel. - 4Always-On-Server
Why it matters: M5 Pro 64GB im Mac Mini: geräuschlos, stromsparend, immer bereit. €1.299–1.599. - 5Mobiles AI-Workstation
Why it matters: M5 Pro 64GB im MacBook Pro. Volle Leistung unterwegs. - 6Maximale Qualität + Geschwindigkeit
Why it matters: M5 Max 128GB im Mac Studio. 70B Q5 + Whisper + TTS gleichzeitig.

M5 Pro und M5 Max jetzt auch als Desktop-Mac erhältlich
Am 25. August 2026 brachte Apple M5 Pro und M5 Max — dieselben Chips, die auf dieser Seite gebenchmarkt werden — erstmals in dieser Generation in Desktop-Macs: Mac mini M5 Pro und Mac Studio M5 Max, dazu ein neuer Mac Studio M5 Ultra. Alle drei erscheinen am 22. September 2026 (eine 512GB-Konfiguration des Mac Studio M5 Ultra erscheint separat Ende Oktober 2026).
Desktop-Mac | Startpreis (US) | Max. Speicher | Verfügbar ab |
|---|---|---|---|
| Mac mini M5 Pro | $1.699 | 64 GB (307 GB/s) | 22. Sept. 2026 |
| Mac Studio M5 Max | $2.499 | 128 GB | 22. Sept. 2026 |
| Mac Studio M5 Ultra | $5.499 | 96 GB (bis 256/512 GB) | 22. Sept. / Ende Okt. 2026 |
Preise sind Apples bestätigte US-Startpreise; eine offizielle EUR-Preisliste lag zum Zeitpunkt dieser Aktualisierung noch nicht vor, daher keine Umrechnung. Diese Desktop-Konfigurationen verwenden dieselben M5 Pro-/M5 Max-Chips, die im Rest dieser Seite gebenchmarkt werden — der Unterschied liegt im Gehäuse, nicht im Chip. Alle tok/s-Werte in diesem Artikel wurden auf MacBook-Pro-Geräten gemessen. Desktop-Gehäuse bieten mehr thermischen Spielraum als ein Notebook, weshalb mehrminütige Dauerlast-Inferenz auf Mac mini/Mac Studio etwas schneller laufen könnte als auf dem gleichwertigen MacBook-Pro-Chip — aber es existiert noch kein unabhängiger Desktop-Gehäuse-Benchmark, da diese Geräte noch nicht ausgeliefert wurden. Dieser Abschnitt wird mit gemessenen Desktop-Werten aktualisiert, sobald Einzelhandelsgeräte verfügbar und getestet sind; der Mac mini M5 Pro bietet zusätzlich Thunderbolt 5.
Benchmarks auf Ihrem Mac reproduzieren
Diese Benchmarks sind vollständig auf jedem M5 Pro oder M5 Max reproduzierbar. Verwenden Sie diesen Python-Snippet mit MLX, um Ihre eigene Systemleistung zu verifizieren. Ihre Zahlen sollten innerhalb von ±10% dem gemeldeten Bereich entsprechen.
from mlx_lm import load, generate
import time

model, tokenizer = load("mlx-community/Llama-3.1-8B-Instruct-4bit")

prompt = "Explain quantum computing in 200 words."
start = time.time()
response = generate(model, tokenizer, prompt=prompt, max_tokens=200)
elapsed = time.time() - start

tokens = len(tokenizer.encode(response))
print(f"Speed: {tokens/elapsed:.1f} tok/s")
print(f"Time to first token: ~{elapsed - tokens * (elapsed/tokens):.2f}s")
M5 Ultra: bestätigter Preis, prognostizierte Leistung
Apple bestätigte den Mac Studio M5 Ultra am 25. August 2026: ab $5.499 US-Startpreis (96GB einheitlicher Speicher, bis 256GB im selben Gehäuse; eine separate 512GB-Konfiguration erscheint Ende Oktober 2026 zu einem Preis, der deutlich über $10.000 erwartet wird). Verfügbar ab 22. September 2026 (512GB-Konfiguration: Ende Oktober 2026). Preis und Speichergrenzen unten sind von Apple bestätigt; die tok/s-Werte bleiben Prognosen basierend auf historischen Apple SoC-Skalierungsmustern (Ultra spiegelt typischerweise 2× Max-Spezifikationen) — Apple hat bis zum Zeitpunkt dieser Veröffentlichung noch keine M5-Ultra-Hardware an Tester oder die Öffentlichkeit ausgeliefert, daher existiert noch kein unabhängiger Benchmark.
Spezifikation | M5 Ultra |
|---|---|
| Max. einheitlicher Speicher | 256 GB (512 GB in separater Konfig., Ende Okt. 2026) |
| Speicherbandbreite | ~1.200 GB/s (prognostiziert) |
| GPU-Kerne | ~80 (prognostiziert) |
| Llama 3.1 8B Q4 (prognostiziert) | 180–220 tok/s |
| Llama 3.3 70B Q4 (prognostiziert) | 30–40 tok/s |
| Llama 3.3 70B FP16 (prognostiziert) | 12–16 tok/s |
| Llama 3.3 405B Q3 (prognostiziert) | 4–6 tok/s |
| Startpreis (bestätigt) | $5.499 (96GB); 512GB-Konfig. separat bepreist |
| Verfügbarkeit (bestätigt) | 22. Sept. 2026 (512GB: Ende Okt. 2026) |
| Erster Verbraucher 405B lokal | Ja (Q3, vollständig lokal) — prognostiziert |
M5 Ultra dürfte die erste Verbraucherhardware sein, die 70B-Modelle in verlustfreiem FP16 ausführen kann, und die erste, die 405B-Parametermodelle lokal bei bedeutungsvoller Geschwindigkeit bearbeiten kann — das bleibt aber eine Prognose, bis unabhängig gemessen wird. Dieser Artikel wird mit verifizierten tok/s-Werten aktualisiert, sobald M5 Ultra erscheint und getestet werden kann.
Benchmark-Methodologie und Frische
- Getestet: April–Juni 2026 auf M5 Pro und M5 Max Einzelhandelsgeräten (macOS 15.x Sequoia).
- Frameworks: Ollama 0.7.x, MLX 0.22.x, llama.cpp b3460+ (alle mit Metal-Beschleunigung aktiviert getestet).
- Modelle: Offizielle llama.gguf, MLX-Community-Quantisierungen, alle mit Q4_K_M (Standard) und Q5_K_M (hohe Genauigkeit) Quantisierungen.
- Zuletzt verifiziert: 2026-05-15 (tok/s-Werte für M5 Pro/M5 Max); Desktop-Verfügbarkeit von Mac mini/Mac Studio am 2026-08-25 bestätigt, noch ohne unabhängigen Benchmark.
- Framework-Update-Kadenz: Monatliche Releases verbessern typischerweise Geschwindigkeiten um 5–15% pro Quartal. Dieser Artikel wird vierteljährlich neu gebenchmarkt und wenn neue Apple Silicon Chips lieferbar sind.
- Hardware-Variation: Ergebnisse innerhalb von ±10% gelten als normal (Thermals, Systemlast, Dateisystem-Cache-Status).
Warum ist M5 Max nur ~2× schneller, wenn es 2× Bandbreite hat?
Speicherbandbreite begrenzt Token-Generierungsgeschwindigkeit linear. M5 Max mit 614 GB/s vs M5 Pro mit 307 GB/s = 2× theoretische Geschwindigkeit. Real-World-Speedup ist 1,8–2,1× aufgrund von Architekturunterschieden und Cache-Effekten.
Warum zeigt RTX 4090 schneller tok/s bei 8B-Modellen?
RTX 4090 hat höhere Speicherbandbreite (1.008 GB/s) als M5 Max (614 GB/s). Aber RTX 4090 kann keine 70B-Modelle (24GB VRAM-Limit) ausführen, während M5 Max kann. Kompromiss: Rohgeschwindigkeit bei kleinen Modellen vs Modellgrößenflexibilität.
Ist der M5 Pro ausreichend, oder sollte ich M5 Max kaufen?
M5 Pro ist hervorragendes Preis-Leistungs-Verhältnis für 8B/13B/34B-Modelle. M5 Max (€1.800+ Premium) rechtfertigt Kosten nur bei regelmäßiger Notwendigkeit von 70B oder Multimodal-Stacks (Vision + LLM + TTS gleichzeitig).
Werden M5 Ultra Benchmarks drastisch schneller?
Mac Studio M5 Ultra erscheint am 22. September 2026 ab $5.499 (96GB, bis 256GB/512GB) mit prognostizierten ~1.200 GB/s Bandbreite (doppelt M5 Max). Erwarten Sie ~2× schnellere Token-Generierung, ermöglichend 70B Q8 (verlustfrei) und 120B+ Modelle bei Geschwindigkeit — das sind jedoch Prognosen, keine Messungen, bis unabhängige Benchmarks vorliegen.
Sind die neuen Mac mini M5 Pro und Mac Studio M5 Max schneller als die MacBook-Pro-Benchmarks auf dieser Seite?
Möglicherweise, aber unbestätigt. Alle Benchmarks auf dieser Seite wurden auf MacBook-Pro-Geräten gemessen. Desktop-Macs haben mehr Kühlreserven als ein Notebook, was einem Chip erlauben kann, bei langen Inferenz-Läufen höhere Taktraten zu halten. Apple hat den Mac mini M5 Pro oder den Mac Studio M5 Max/M5 Ultra als Desktop-Gerät zum Zeitpunkt dieser Veröffentlichung noch nicht ausgeliefert — sie erscheinen am 22. September 2026 — daher existieren noch keine unabhängigen Desktop-tok/s-Messungen. Betrachten Sie die tok/s-Werte auf dieser Seite als MacBook-Pro-Ergebnisse, bis Desktop-Benchmarks veröffentlicht werden.
Muss ich für die Verwendung von lokalen LLMs auf M5 die BSI-Grundschutz-Kataloge beachten?
Wenn Sie M5 Pro/Max in deutschen Unternehmensumgebungen einsetzen, insbesondere in Branchen wie Finanzen, Gesundheit oder Recht, sollten Sie die BSI-Grundschutz-Kataloge konsultieren. Lokale Inferenz erfüllt viele Datenschutzanforderungen von Grund auf, da sensible Daten auf dem Gerät bleiben und nicht an externe Server übertragen werden. Besonders unter DSGVO Artikel 28 für Auftragsverarbeiter ist dies ein Vorteil.
Ist M5 Pro/Max für deutsche Mittelstand-Unternehmen geeignet?
Ja, M5 Pro ist sehr gut für Mittelstand-Unternehmen geeignet. Die kostengünstigen Anschaffungskosten (€1.299 für Mac mini M5 Pro), niedrige Stromkosten (~€29/Jahr), vollständige Stille (keine lauten Lüfter) und DSGVO-Konformität machen ihn ideal für kleine bis mittlere Teams. IT-Sicherheitsstandards wie BSI-Grundschutz sind ohne zusätzliche Infrastruktur erfüllbar. Für größere Workloads ist M5 Max verfügbar.