Warum 70B wichtig ist: Der Qualitätssprung gegenüber 8B
Der Sprung von 8B auf 70B Parameter ist der bedeutendste Qualitätsschwellenwert bei lokaler KI. Branchen-Benchmark-Werte:
Benchmark | Llama 3.1 8B | Llama 3.3 70B Q5 | GPT-5.6 |
|---|---|---|---|
| MMLU (Allgemeinwissen) | 73,0 | 86,1 | 88,7 |
| HumanEval (Code) | 72,6 | 80,5 | 90,2 |
| GSM8K (Mathematik) | 84,5 | 95,1 | 95,8 |
| BBH (Schlussfolgern) | 71,0 | 85,3 | 88,9 |
| Durchschnitt | 75,3 | 86,8 | 90,9 |
70B Q5 schließt 75 % der Qualitätslücke zwischen 8B und GPT-5.6 – und läuft lokal für 0 €/Monat.
Welche Hardware 70B-Modelle ausführt
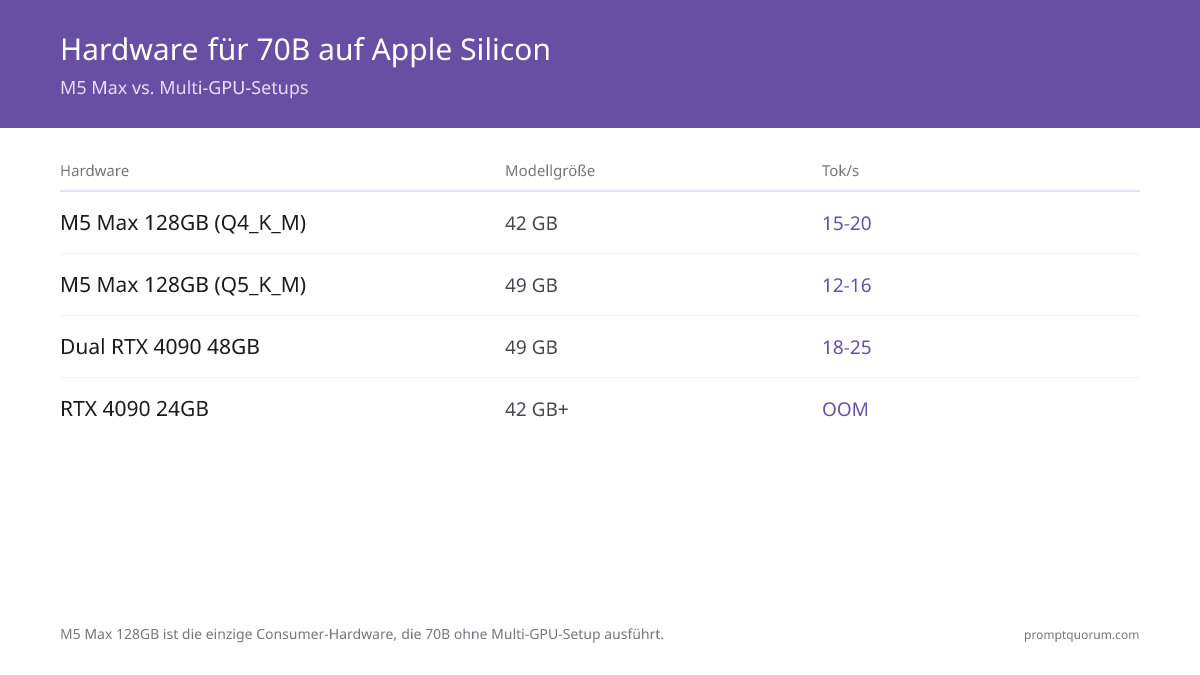
Hardware | Quantisierung | Modellgröße | tok/s | Qualität | Passt? |
|---|---|---|---|---|---|
| M3 Max 96 GB | Q4_K_M | 42 GB | 9–13 | Gut | ✓ Ja |
| M3 Max 128 GB | Q5_K_M | 49 GB | 8–12 | Sehr gut | ✓ Ja |
| M4 Max 128 GB | Q5_K_M | 49 GB | 10–14 | Sehr gut | ✓ Ja |
| M5 Max 128 GB | Q4_K_M | 42 GB | 15–20 | Gut | ✓ Ja |
| M5 Max 128 GB | Q5_K_M | 49 GB | 12–16 | Sehr gut | ✓ Ja |
| M5 Max 128 GB | Q8_0 | 74 GB | 8–12 | Verlustfrei | ✓ Ja |
| M5 Ultra 256 GB (Prognose) | FP16 | 140 GB | 14–18 | Perfekt | ✓ Ja |
| RTX 4090 24 GB | Any | 42 GB+ | — | — | ✗ OOM |
| Dual RTX 3090 48 GB | Q4_K_M | 42 GB | 12–15 | Gut | ✓ Ja (komplex) |
| Dual RTX 4090 48 GB | Q5_K_M | 49 GB | 18–25 | Sehr gut | ✓ Ja (5.000 €+) |
| 4× RTX 3090 96 GB | Q8_0 | 74 GB | 12–16 | Verlustfrei | ✓ Ja (teuer) |
M5 Max 128 GB ist die einzige Consumer-Hardware, die 70B-Modelle ohne komplexe Multi-GPU-Konfigurationen ausführt. M5 Max gibt es in zwei Bauformen: im MacBook Pro (seit März 2026 erhältlich) und – seit Apples Mac-Studio-Auffrischung vom 25. August 2026 – auch im Mac Studio Desktop. Beide nutzen denselben Chip und erreichen maximal 128 GB Unified Memory bei 614 GB/s Bandbreite. Der Mac Studio (M5 Max) startet bei ca. 2.499 €, die 128-GB-Konfiguration kostet mehr; diese Desktop-Konfiguration ersetzt weiterhin NVIDIA-Multi-GPU-Setups für 5.000–8.000 €. Für dauerhafte 70B+-Inferenz empfiehlt sich der Mac Studio gegenüber dem MacBook Pro: Die Desktop-Kühlung hält die Taktraten unter Dauerlast länger, und es gibt keinen Akku, um den man sich bei langen Inferenz-Sitzungen sorgen müsste.

Schritt für Schritt: 70B auf M5 Max 128 GB ausführen
Schritt 1: Hardware prüfen. Schritt 2: Ollama installieren und konfigurieren.
# Schritt 1: Unified Memory prüfen (muss 128 GB anzeigen)
system_profiler SPHardwareDataType | grep Memory
# → Memory: 128 GB

# Schritt 2: Ollama installieren
brew install ollama
brew services start ollama

# Schritt 3: Für 70B konfigurieren (Modell geladen halten, 60-Sek.-Warmup vermeiden)
echo 'export OLLAMA_KEEP_ALIVE=1h' >> ~/.zshrc
echo 'export OLLAMA_NUM_PARALLEL=1' >> ~/.zshrc
source ~/.zshrc
brew services restart ollama
Schritt 3: Das 70B-Modell herunterladen
Download-Zeit bei 100 Mbit/s: 45–90 Minuten. Bei 1 Gbit/s: 5–10 Minuten.
# Empfohlen: Q5_K_M — bestes Qualitäts-/Geschwindigkeitsverhältnis (49 GB Download)
ollama pull llama3.1:70b-instruct-q5_K_M

# Alternative: Q4 — maximale Geschwindigkeit, 42 GB Download
ollama pull llama3.1:70b-instruct-q4_K_M

# Alternative: Q8 — verlustfreie Qualität, 74 GB Download
ollama pull llama3.1:70b-instruct-q8_0
Schritte 4–6: Erster Start, Metal prüfen, Arbeitsspeicher kontrollieren
Die erste Anfrage dauert 30–60 Sekunden zum Laden von 49 GB in den Unified Memory. Nachfolgende Anfragen sind sofort.
# Schritt 4: Erster Start (30-60 Sek. auf Modell-Ladevorgang warten)
ollama run llama3.1:70b-instruct-q5_K_M "Schreibe einen 200-Wort-Aufsatz über lokale KI"

# Schritt 5: Metal-GPU-Beschleunigung prüfen
ollama run llama3.1:70b-instruct-q5_K_M --verbose
# Erwartet: ggml_metal_init: found device: Apple M5 Max

# Schritt 6: API-Zugriff für eigene Anwendungen
curl http://localhost:11434/api/chat -d '{
  "model": "llama3.1:70b-instruct-q5_K_M",
  "messages": [{"role": "user", "content": "Erkläre Quantencomputing"}]
}'
Qualitätsvergleich: 8B vs 70B vs GPT-5.6
Ein Stack-Overflow tritt auf, wenn zu viele Funktionsaufrufe den Speicher überschreiten.
Prompt: „Erkläre, warum ein Stack-Overflow bei rekursiven Funktionen auftritt, und schreibe eine Python-Funktion, die unendliche Rekursion erkennt, bevor sie abstürzt."
Llama 3.1 8B Q4 Antwort (läuft auf jedem Mac mit 16 GB+):
def detect_recursion(func):
    count = 0
    try:
        func()
    except RecursionError:
        count += 1
    return count > 0
Llama 3.3 70B Q5 Antwort (M5 Max 128 GB)
Stack-Overflow bei Rekursion tritt auf, wenn der Aufrufstapel das vom Betriebssystem festgelegte Limit überschreitet (typischerweise 1 MB–8 MB). Jeder rekursive Aufruf fügt einen Stack-Frame mit lokalen Variablen und der Rücksprungadresse hinzu. Pythons Standardlimit beträgt 1.000 Aufrufe.
import sys
import functools

def detect_recursion(threshold=900):
    def decorator(func):
        depth = 0
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            nonlocal depth
            depth += 1
            try:
                if depth > threshold:
                    raise RecursionError(
                        f"Detected potential infinite recursion at depth {depth}"
                    )
                return func(*args, **kwargs)
            finally:
                depth -= 1
        return wrapper
    return decorator
Quantisierung im Detail für 70B-Modelle
- Der Qualitätsunterschied zwischen Q4 und Q5 ist bei 70B GRÖSSER als bei 8B. Q4: ~3–5 % Qualitätsverlust. Q5: ~0,5–1 % Verlust vs FP16.
- Bei 8B-Modellen ist Q4 vs Q8 kaum wahrnehmbar. Bei 70B ist Q4 vs Q8 bei komplexem Schlussfolgern und Code erheblich.
- Empfehlung: Q5_K_M ist die beste Balance. Bei kritischer Geschwindigkeit (Chat, Autovervollständigung) Q4 verwenden. Bei kritischer Ausgabequalität (Recht, Code-Review) Q8 verwenden.
- Speicher: Q4 = 42 GB, Q5 = 49 GB, Q8 = 74 GB. Alle passen in M5 Max 128 GB. Puffer für OS (~8 GB) und Apps einplanen.
- Praktische tok/s: Q4 = 15–20, Q5 = 12–16, Q8 = 8–12. Bei 12 tok/s dauert eine 500-Wort-Antwort ca. 40 Sekunden.

Alternative 70B+-Modelle für Apple Silicon
Modell | Größe (Q5) | Ideal für | tok/s auf M5 Max |
|---|---|---|---|
| Llama 3.3 70B Instruct | 49 GB | Allgemein, Schlussfolgern | 12–16 |
| Qwen2.5-72B Instruct | 51 GB | Mehrsprachig, Mathematik, Code | 11–15 |
| DeepSeek 67B | 47 GB | Coding-Exzellenz | 12–16 |
| Llama 3.3 70B Coder | 49 GB | Reine Coding-Aufgaben | 13–17 |
| Mixtral 8x22B (MoE) | — | Hochwertiges Schlussfolgern | 18–22 |
| Cohere Command A+ 104B | — | RAG, 128K Kontext | 8–12 |
Empfehlungen nach Anwendungsfall: Allgemeines Schlussfolgern → Llama 3.3 70B Q5. Code → DeepSeek 67B. Nicht-Englisch → Qwen2.5-72B. Dokument-Q&A → Command A+. Maximale Geschwindigkeit → Mixtral 8x22B (MoE verwendet weniger aktive Parameter). (DeepSeek hat inzwischen DeepSeek-V4 — Flash/Pro — als neuere offene Generation veröffentlicht; R1/V3 bleiben weiterhin lokal nutzbar.)
Alternative Modelle herunterladen
ollama pull qwen2.5:72b-instruct-q5_K_M
ollama pull deepseek-coder:67b-q5_K_M
ollama pull mixtral:8x22b
70B Lokal vs Cloud-APIs — Ausführlicher Vergleich
Kennzahl | 70B Q5 Lokal (M5 Max) | GPT-5.6 API | Claude Sonnet 5 | Gemini 3.5 Pro |
|---|---|---|---|---|
| Qualität (MMLU) | 86,1 | 88,7 | 88,7 | 85,9 |
| Geschwindigkeit (tok/s) | 12–16 | 50–80 | 50–80 | 60–100 |
| Erstes Token (Latenz) | 1–2 Sek. | 0,3–0,8 Sek. | 0,4–0,9 Sek. | 0,5–1 Sek. |
| Kosten pro 1M Token | 0 € | 2,50 $/10,00 $ | 3,00 $/15,00 $ | 1,25 $/5,00 $ |
| Kosten/Monat (5M Token) | 0 € | 50–150 $ | 75–200 $ | 30–80 $ |
| Datenschutz | 100 % lokal | Gesendet an OpenAI | Gesendet an Anthropic | Gesendet an Google |
| Internet erforderlich | Nein | Ja | Ja | Ja |
| Ratenlimits | Keine | Stufenbasiert | Stufenbasiert | Stufenbasiert |
| Anpassbarkeit | Vollständig (lokal fine-tunen) | Begrenzt | Begrenzt | Begrenzt |
70B Q5 lokal erreicht innerhalb von 3 % die Cloud-Qualität auf MMLU. Bei Hardware-Kosten von ca. 4.000 € und 50–150 $ monatlichen Ersparnissen beträgt die Amortisationszeit 27–80 Monate. Datenschutzsensible Arbeiten (Medizin, Recht, Finanzen) haben keine Cloud-Alternative.
Praxisanwendungen für lokale 70B-Inferenz
- 1Analyse vertraulicher Dokumente
Why it matters: Rechtsverträge, medizinische Unterlagen, Finanzberichte, M&A Due Diligence. Cloud-APIs sind unter DSGVO, HIPAA oder NDA nicht akzeptabel. 70B Q5 auf M5 Max liefert Cloud-Qualitätsanalyse bei null Datenabfluss. - 2Hochvolumige Coding-Unterstützung
Why it matters: Einzelentwickler mit Copilot 8h/Tag: ~10 €/Monat. Team von 10 Personen mit lokalem 70B Coder: 0 €/Monat. Code verlässt nie das Firmennetzwerk. M5 Max als geteilter Inferenzserver amortisiert sich für ein 10-köpfiges Team in 3 Monaten. - 3Erstellung langer Inhalte
Why it matters: 5.000-Wort-Blogbeiträge, technische Dokumentation. 70B produziert deutlich bessere Langtexte als 8B. Lokal: keine Token-Limits, keine Ratenlimits. 50.000 Wörter/Tag für 0 € statt 50–100 $ API-Kosten. - 4Forschung und wissenschaftlicher Einsatz
Why it matters: Tausende Facharbeiten für Literaturrecherche verarbeiten, Hypothesen in vielen Bereichen generieren. 70B-Reasoning-Qualität ist erforderlich. Cloud-Kosten übersteigen Studenten- und Postdoc-Budgets. - 5Datenschutzorientierter persönlicher KI-Assistent
Why it matters: Analyse persönlicher Tagebücher, Finanzplanung für die Familie, gesundheitliche Reflexion mit privaten Daten. Ersetzt ChatGPT Plus für einen ganzen Haushalt. Keine Daten an Dritte übermittelt. - 6Offline-kritische Arbeitsabläufe
Why it matters: Journalisten in restriktiven Regionen, Mediziner in abgelegenen Gebieten, Reisen ohne zuverlässiges Internet, abgesicherte Einrichtungen ohne externen Netzzugang.
Geschwindigkeitsoptimierung: MLX vs Ollama
MLX ist Apples natives ML-Framework und läuft auf demselben Modell 15–25 % schneller als Ollama. M5 Max mit 70B Q5: Ollama = 12–16 tok/s, MLX = 18–22 tok/s.
from mlx_lm import load, generate

# 70B Q5 Modell laden (MLX-konvertierte Version von Hugging Face)
model, tokenizer = load("mlx-community/Llama-3.1-70B-Instruct-Q5")

# Streaming-Generierung — Nutzer sieht erstes Wort in 1-2 Sek.
from mlx_lm import stream_generate
for chunk in stream_generate(model, tokenizer, "Erkläre Quantencomputing", max_tokens=500):
    print(chunk, end="", flush=True)
Weitere Tipps zur Geschwindigkeitsoptimierung
- Modell warm halten: OLLAMA_KEEP_ALIVE=1h setzen (oder 24h für dauerhaft aktiven Mac Mini), um den 30–60-Sekunden-Neustart bei jeder Anfrage zu vermeiden.
- Streaming verwenden: Nutzer sehen das erste Token in 1–2 Sekunden statt 25–40 Sekunden auf die vollständige Antwort zu warten.
- max_tokens reduzieren: Bei Bedarf von 200-Wort-Antworten max_tokens=200 setzen. Bei 14 tok/s: 200 Token = 14 Sek. vs 36 Sek. für 500 Token.
- Q4-vs-Q5-Geschwindigkeitskompromiss: Q4 = 15–20 tok/s (+25 % schneller als Q5). Qualitätsunterschied ~2–3 % bei den meisten Aufgaben. Für Chat Q4 verwenden, für kritisches Schlussfolgern Q5.
- Andere GPU-intensive Apps während der Inferenz vermeiden – der GPU-Verlauf in Activity Monitor zeigt, ob andere Prozesse um Metal-Bandbreite konkurrieren.
M5 Ultra: bestätigt am 25. August 2026 in der Mac-Studio-Auffrischung
Apple bestätigte den M5 Ultra am 25. August 2026 zusammen mit einem aufgefrischten Mac Studio, das auch den M5 Max auf den Desktop brachte. M5 Ultra kombiniert zwei M5-Max-Chips über Apples UltraFusion-Architektur. Basiskonfiguration: 96 GB Unified Memory, 36-Core-CPU, 80-Core-GPU, ab ca. 5.499 €. Konfigurierbar bis 256 GB oder 512 GB Unified Memory. Basiskonfigurationen werden ab 22. September 2026 ausgeliefert; die 512-GB-Konfiguration folgt Ende Oktober 2026 und dürfte deutlich über 10.000 € kosten. Die 512-GB-Stufe bietet genug Unified Memory für MoE-Modelle mit einer Gesamtparameterzahl weit über 70B (auch wenn pro Token deutlich weniger Parameter aktiv sind, als die Gesamtzahl vermuten lässt). Für den Mac Studio M5 Max oder M5 Ultra existieren noch keine unabhängigen Benchmarks – die tok/s-Werte unten sind Prognosen auf Basis der Bandbreiten-Skalierung des M5 Max, keine gemessenen Ergebnisse, und PromptQuorum hat diese Hardware nicht getestet.
Modell | M5 Max 128 GB | M5 Ultra 256 GB (Prognose) |
|---|---|---|
| Llama 3.3 70B Q5 | 12–16 tok/s | 24–32 tok/s |
| Llama 3.3 70B Q8 | 8–12 tok/s | 16–24 tok/s |
| Llama 3.3 70B FP16 (verlustfrei) | ✗ Passt nicht | 14–18 tok/s |
| Qwen2.5-72B Q8 | 8–12 tok/s | 16–24 tok/s |
| Mixtral 8x22B Q5 | 14–18 tok/s | 28–36 tok/s |
| Llama 3.3 405B Q3 | ✗ Passt nicht | 4–6 tok/s |
| Llama 3.3 405B Q4 (~200 GB) | ✗ Passt nicht | 3–5 tok/s |
M5 Ultra ermöglicht: (1) Verlustfreies 70B FP16 – erstmals auf Consumer-Hardware, ab der 256-GB-Konfiguration. (2) Modelle der 405B-Klasse. (3) Zwei simultane 70B-Modelle. (4) Mit 512 GB Spielraum für MoE-Modelle, die deutlich über 70B Gesamtparameter liegen. Bestätigter Preis: ab 5.499 € (96-GB-Basis); die Konfigurationen mit 256 GB und 512 GB kosten mehr, wobei die 512-GB-Stufe voraussichtlich deutlich über 10.000 € liegt. Basiskonfigurationen werden ab 22. September 2026 ausgeliefert; die 512-GB-Konfiguration Ende Oktober 2026.
Häufig gestellte Fragen
Ist 70B Q4 für die meisten Aufgaben gut genug?
Ja. Q4 ist die branchenübliche Quantisierung. Der ~3–5 % Qualitätsverlust gegenüber Q5 ist bei den meisten Chat-, Schreib- und Allzweck-Aufgaben nicht wahrnehmbar. Q5 oder Q8 nur verwenden, wenn die Ausgabequalität kritisch ist (Rechtsanalyse, Code-Review, medizinische Nutzung).
Kann ich 70B Q5 und ein anderes Modell gleichzeitig ausführen?
Ja, mit einem kleineren Modell. 70B Q5 = 49 GB. 128 GB minus 8 GB OS-Overhead = 120 GB. 70B Q5 (49 GB) + ein 7–8B-Modell (5 GB) = 54 GB – gut innerhalb des Budgets. Zwei simultane 70B-Modelle erfordern M5 Ultra 256 GB.
Sollte ich jetzt den Mac Studio M5 Max kaufen oder auf M5 Ultra warten?
M5 Ultra ist jetzt bestätigt (angekündigt am 25. August 2026, Basiskonfigurationen ab 22. September 2026 verfügbar, ab ca. 5.499 € für 96 GB). M5 Ultra wählen, wenn: (1) verlustfreies 70B FP16 benötigt wird, (2) Modelle der 405B-Klasse erforderlich sind, oder (3) Modelle mit mehr als 128 GB geplant sind – die 512-GB-Konfiguration, verfügbar Ende Oktober 2026, ermöglicht sehr große MoE-Modelle. Mac Studio M5 Max jetzt kaufen (ab ca. 2.499 €), wenn 70B heute ausreicht und das Budget unter 5.000 € liegt – die 256-GB- und 512-GB-Stufen des M5 Ultra kosten deutlich mehr.
Wie viel schneller wird 70B auf M5 Ultra gegenüber M5 Max sein?
Etwa doppelt so schnell, basierend auf der verdoppelten Speicherbandbreite (~1.200 GB/s vs 614 GB/s). M5 Max führt 70B Q5 mit 12–16 tok/s aus; M5 Ultra ist auf 24–32 tok/s projiziert. Dies ist eine bandbreitenbasierte Prognose – unabhängige Benchmarks für den Mac Studio M5 Ultra existieren noch nicht. M5 Ultra wird zudem ab der 256-GB-Konfiguration 70B FP16 ausführen können, das auf M5 Max nicht passt.
Kann ich zwei 70B-Modelle gleichzeitig auf M5 Max 128 GB ausführen?
Nein, nicht zwei vollständige 70B-Modelle. Zwei 70B Q4 = 84 GB plus OS-Overhead = ~95 GB, was auf 128 GB knapp ist. M5 Ultra 256 GB verarbeitet problemlos zwei simultane 70B-Modelle oder ein 70B + ein 34B.
Wie viel Festplattenspeicher brauche ich für 70B-Modelle?
Jedes 70B-Modell benötigt 42 GB (Q4), 49 GB (Q5) oder 74 GB (Q8) auf der Festplatte. Für drei Quantisierungen eines Modells: 165 GB. Für professionelle 70B-Arbeit mit mehreren Modellen empfiehlt sich 1 TB oder 2 TB SSD im Mac Studio.
Ist lokal laufendes 70B wirklich so gut wie GPT-5.6 für meinen Anwendungsfall?
70B Q5 erreicht 86,1 auf MMLU vs GPT-5.6 mit 88,7 – ein 3 % Unterschied bei Benchmarks. Für datenschutzsensible Aufgaben, intensivere Nutzung (50 €+/Monat) oder Offline-Einsatz gewinnt lokal automatisch. Eigene Prompts testen, um den Einsatz für den jeweiligen Workflow zu validieren.
Funktionieren Llama 4 oder neuere 70B-Modelle auf M5 Max?
Ja. M5 Max 128 GB passt jedes 70B-Modell in Q4/Q5/Q8-Quantisierung, unabhängig von der Architektur. Neue 70B-Versionen erscheinen typischerweise innerhalb von Tagen auf Ollama. Den neuen Modellnamen mit ollama pull abrufen.
Verarbeitet M5 Max lokale 70B-Modelle DSGVO-konform?
Ja. Da alle Daten lokal auf dem Gerät verarbeitet werden und keine Übertragung an externe Server stattfindet, fallen keine personenbezogenen Daten unter Art. 28 DSGVO (Auftragsverarbeitung). Für den Unternehmenseinsatz: BSI-Grundschutz empfiehlt lokale Verarbeitung für besonders sensible Daten ausdrücklich.
Lohnt sich ein M5 Max für KMU in Deutschland?
Ja, insbesondere wenn ein Team von 5–15 Personen täglich mit sensiblen Dokumenten arbeitet. Ein M5 Max Mac Studio für ca. 4.000 € amortisiert sich gegenüber GPT-5.6-API-Kosten (50–200 €/Monat/Nutzer) innerhalb von 3–12 Monaten, während das gesamte Datenmaterial im Unternehmen bleibt.