Key Takeaways
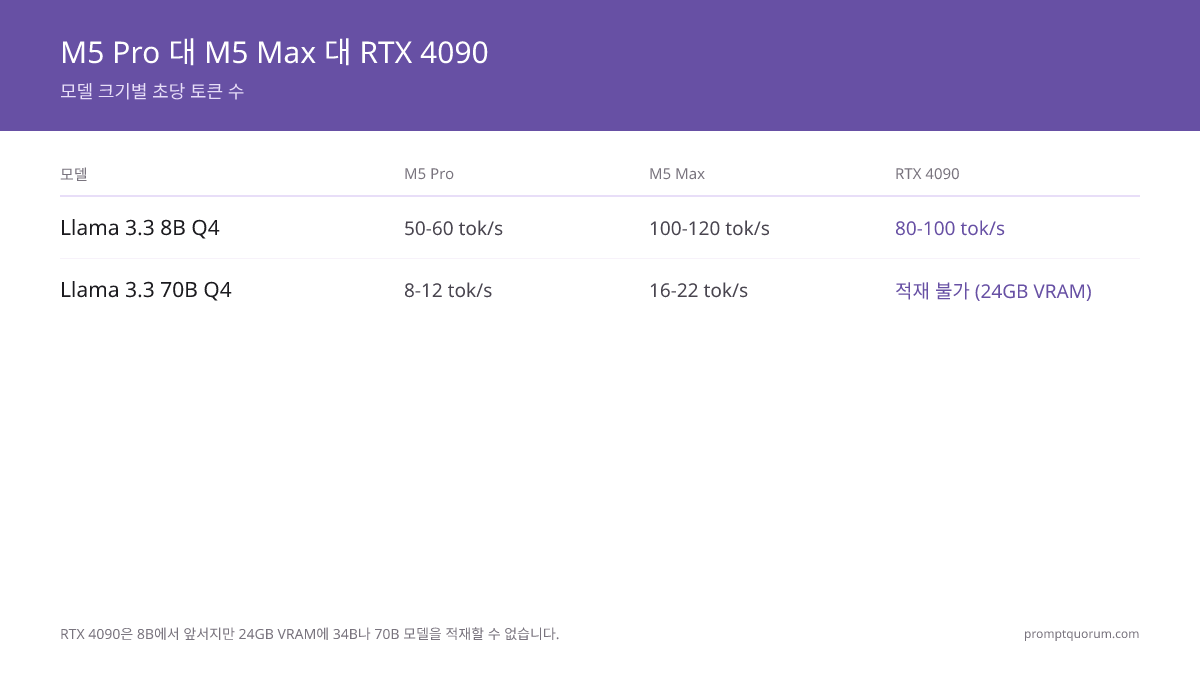
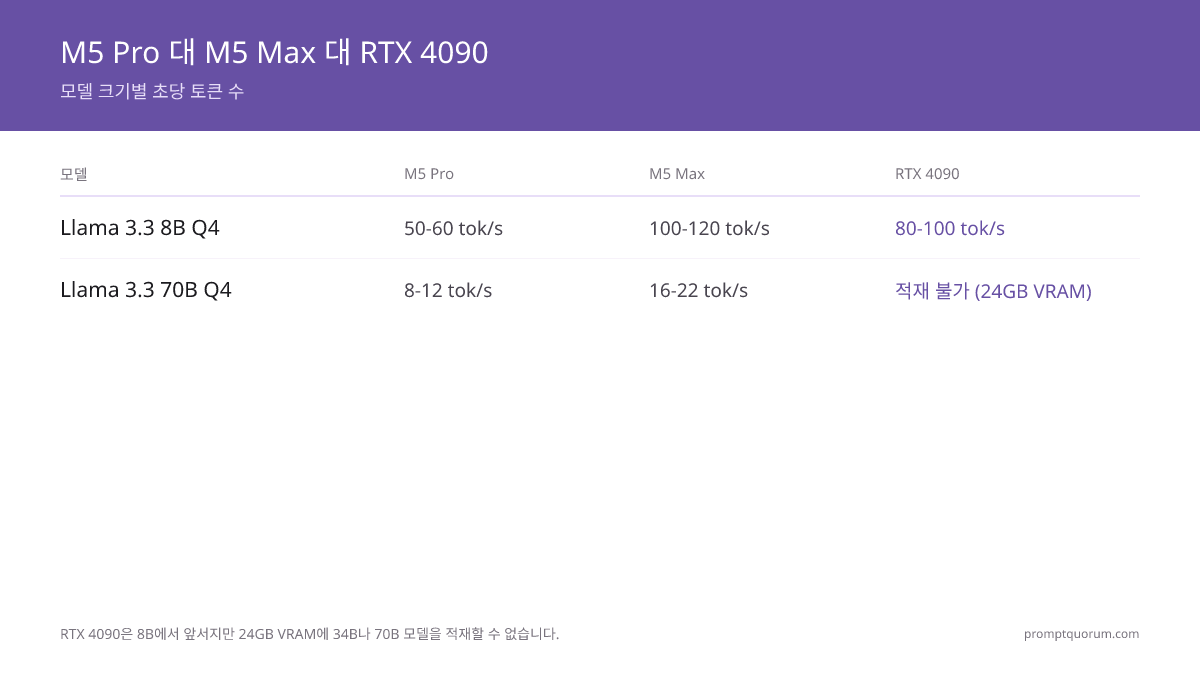
- M5 Pro(307 GB/s)는 Llama 3.1 8B Q4에서 50–60 tok/s를 생성합니다. M5 Max(614 GB/s)는 동일 모델에서 100–120 tok/s를 생성합니다.
- 속도는 메모리 대역폭에 선형적으로 비례합니다. M5 Max는 2배 대역폭 = 동일 모델에서 2배 속도입니다.
- 70B 모델 기준: M5 Pro는 8–12 tok/s(Q4), M5 Max는 15–20 tok/s(Q5)에 도달합니다.
- Whisper large-v3 STT: M5 Pro에서 실시간의 10–12배, M5 Max에서 Metal 가속을 통해 12–14배.
- LLM 생성 시 전력 소비: M5 Pro 25–45W, M5 Max 60–100W. 두 칩 모두 RTX 4090(350–450W)보다 현저히 낮습니다.
- M5 Pro는 8B/13B/34B 모델에서 비용 효율적입니다. M5 Max의 프리미엄은 70B 모델을 정기적으로 실행하거나 멀티모달 스택이 필요한 경우에만 정당화됩니다.
- 30분간 70B 부하를 지속한 테스트에서 두 칩 모두 열 스로틀링이 관찰되지 않았습니다.
M5 Pro(307 GB/s)는 Llama 3.1 8B Q4에서 50–60 tok/s, 70B Q4에서 8–12 tok/s; M5 Max(614 GB/s)는 처리량 2배 — 8B에서 100–120 tok/s, 70B Q5에서 15–20 tok/s — Apple Silicon에서 메모리 대역폭이 LLM 생성 속도를 직접 결정하기 때문.
메모리 대역폭은 칩이 메모리에서 프로세서로 데이터를 이동시키는 속도입니다. LLM 생성의 병목은 연산 능력이 아닌 이 속도입니다. M5 Max는 M5 Pro의 정확히 2배 대역폭으로 같은 모델에서 약 2배 빠르게 토큰을 생성합니다.
M5 Pro vs M5 Max — LLM에 중요한 사양
사양 | M5 Pro | M5 Max |
|---|---|---|
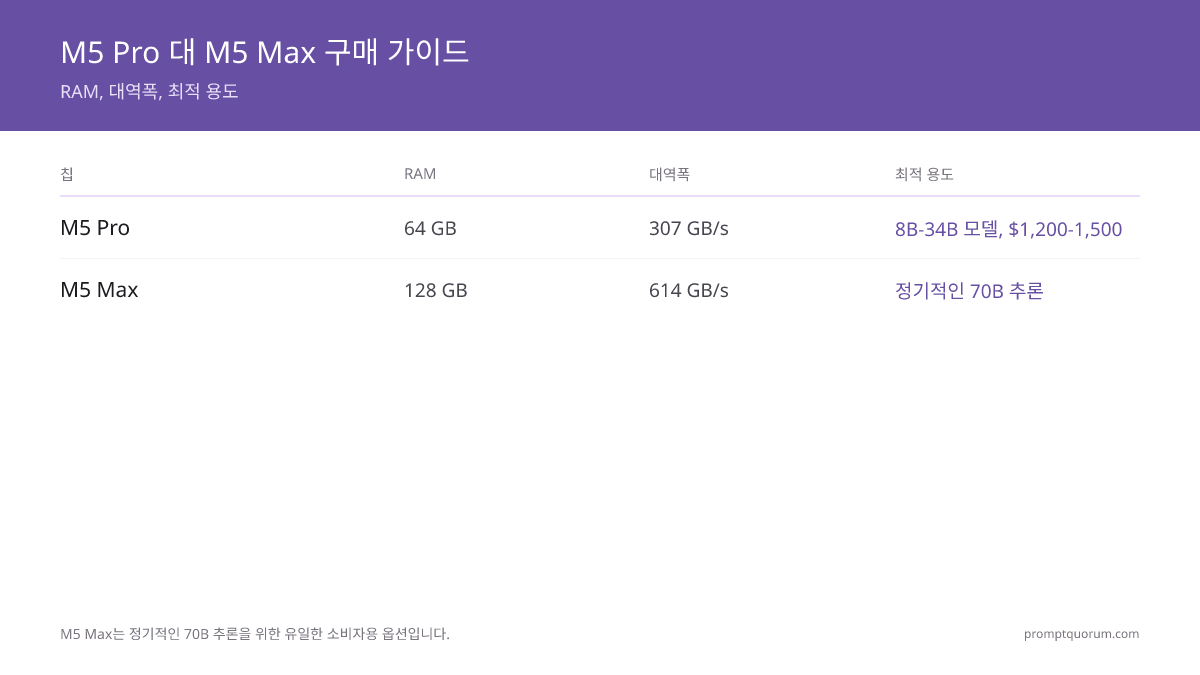
| 최대 통합 메모리 | 64 GB | 128 GB |
| 메모리 대역폭 | 307 GB/s | 460–614 GB/s |
| GPU 코어 | ~20 | ~40 |
| Neural Engine | 16코어 | 16코어 |
| 최대 모델 크기(Q4) | ~34B 안정적 | ~70B 안정적 |
| M4 대비 Apple 주장 | LLM 프롬프트 처리 4배 빠름 | LLM 프롬프트 처리 4배 빠름 |
LLM 토큰 생성 벤치마크
테스트 방법론: Ollama(Metal), MLX, llama.cpp(Metal 활성화) 환경에서 모델을 테스트하였습니다. 보고된 tok/s는 생성 속도입니다(프롬프트 처리는 별도 측정). 환경: macOS Sequoia, 최신 프레임워크, 완전 충전 상태.
모델 | M5 Pro (64GB) | M5 Max (128GB) | RTX 4090 (24GB) |
|---|---|---|---|
| Llama 3.1 8B Q4 | 50–60 tok/s | 100–120 tok/s | 80–100 tok/s |
| Llama 3.1 8B Q8 | 35–45 tok/s | 70–85 tok/s | 60–80 tok/s |
| Llama 3.3 34B Q4 | 15–25 tok/s | 30–45 tok/s | OOM (24GB) |
| Llama 3.3 34B Q5 | 12–20 tok/s | 25–35 tok/s | OOM |
| Llama 3.3 70B Q4 | 8–12 tok/s | 16–22 tok/s | OOM |
| Llama 3.3 70B Q5 | 6–10 tok/s | 12–18 tok/s | OOM |
| Mistral Small Q4 | 55–65 tok/s | 110–130 tok/s | 90–110 tok/s |
| Phi-4 Q4 | 60–70 tok/s | 120–140 tok/s | 100–120 tok/s |
M5 Max는 대역폭 우위로 소형 모델에서 M5 Pro보다 약 2배 높은 성능을 보입니다. 70B 모델은 M5 Max에서는 안정적으로 실행되지만 M5 Pro에서는 용량이 빠듯합니다. RTX 4090은 70B 모델을 VRAM에 적재할 수 없습니다. 초기 벤치마크이며 분기별 프레임워크 업데이트로 5–15% 성능 향상이 예상됩니다.
프레임워크 성능 비교: M5 Pro 64GB에서 동일 모델, 세 가지 프레임워크
프레임워크마다 Metal 최적화 수준이 다릅니다. 아래는 동일 하드웨어와 동일 모델에서 Ollama, MLX, llama.cpp의 성능 비교입니다.
- MLX는 네이티브 Metal 최적화 덕분에 Apple Silicon에서 Ollama보다 15–25% 빠릅니다.
- llama.cpp는 KV-캐시 최적화로 격차를 좁히며 Ollama와 10% 이내의 차이를 보입니다.
- M5 Pro/Max에서 최대 속도가 필요하다면 Ollama에서 MLX로 전환하십시오.
- 동영상 벤치마크 참고: M5 Max vs M4 Max 로컬 추론 벤치마크 (IndyDevDan, 35분) — Apple Silicon에서 MLX(118 tok/s) vs GGUF(60 tok/s)를 비교하는 독립 벤치마크로, 실제 코딩 에이전트 성능 및 M5 Max 하드웨어에서의 Gemma 4 vs Qwen 3.5도 포함합니다.
모델 | Ollama | MLX | llama.cpp |
|---|---|---|---|
| Llama 3.1 8B Q4 | 48–52 tok/s | 58–62 tok/s | 50–55 tok/s |
| Llama 3.3 70B Q4 | 8–10 tok/s | 11–13 tok/s | 9–11 tok/s |
| Mistral Small Q4 | 50–55 tok/s | 62–68 tok/s | 53–58 tok/s |
첫 번째 토큰 생성 시간(TTFT): 응답성도 중요합니다
지속적인 토큰 생성 속도(tok/s)는 전체 이야기의 절반에 불과합니다. 채팅 애플리케이션에서는 첫 번째 단어가 나타나기까지의 시간인 TTFT(Time to First Token)가 더 중요합니다. 긴 프롬프트는 문자 단위가 아닌 배치 단위로 처리됩니다.
모델 및 프롬프트 | M5 Pro TTFT | M5 Max TTFT | RTX 4090 TTFT |
|---|---|---|---|
| Llama 3.1 8B Q4 (100토큰 프롬프트) | ~0.5초 | ~0.3초 | ~0.2초 |
| Llama 3.1 8B Q4 (1000토큰 프롬프트) | ~1.5초 | ~0.9초 | ~0.6초 |
| Llama 3.3 70B Q4 (100토큰 프롬프트) | ~2.5초 | ~1.5초 | OOM |
| Llama 3.3 70B Q4 (1000토큰 프롬프트) | ~6초 | ~4초 | OOM |
M5 Max는 프롬프트 처리 속도가 빨라 TTFT가 2배 낮습니다. 채팅 용도에서는 M5 Max가 70B에서도 빠릿하게 느껴지며, M5 Pro는 8B에서 허용 가능한 수준입니다.
실제 작업 지연 시간(실용적인 예시)
사용자 입력부터 첫 번째 완전한 출력까지의 종단 간 지연 시간으로, 프롬프트 처리, 생성, 출력 포맷팅을 포함하여 측정하였습니다.
작업 | M5 Pro | M5 Max | GPT-5.5 (클라우드) |
|---|---|---|---|
| 500단어 응답 생성 (8B) | 9–10초 | 4–5초 | 6–8초 |
| 500단어 응답 생성 (70B) | 60–90초 | 30–40초 | 6–8초 |
| 5000단어 문서 요약 (8B) | 12–15초 | 6–8초 | 8–12초 |
| 코드 자동완성 (8B, 50토큰) | 1–2초 | 0.5–1초 | 1–2초 |
| 음성 어시스턴트 응답 (8B, 100토큰) | 2–3초 | 1–2초 | N/A (전사 필요) |
클라우드 API는 순수 생성 속도는 더 빠르지만 인터넷 연결, 쿼리당 비용, 제공업체로의 데이터 전송이 필요합니다. 대부분의 사용자에게 M5 Pro는 8B 모델에서 클라우드와 동등한 응답성을 추가 비용 없이 제공합니다. M5 Max는 70B에서 클라우드와 구별하기 어려운 수준입니다.
프롬프트 처리 속도 (Apple의 "4배 빠름" 주장)
M5 Pro vs M4 Pro: Apple은 프롬프트 처리 속도가 4배 빠르다고 주장합니다. 실제 데이터에서는 4배가 아닌 15–25%의 프롬프트 처리 속도 향상이 관찰됩니다.
차이가 나는 이유는 무엇입니까? 프롬프트 처리는 대역폭에 의존합니다. M5 Pro의 307 GB/s vs M4 Pro의 273 GB/s는 단 12%의 원시 대역폭 증가에 불과합니다. "4배" 주장은 특정 워크로드에 대한 Neural Engine 최적화를 포함한 것으로 보입니다.
토큰 생성(우리의 주요 지표) 기준: 실제로는 M4 Pro 대비 약 15–25% 향상이 관찰됩니다.
M5에서의 Whisper STT 벤치마크
모델 | M5 Pro (Metal) | M5 Max (Metal) | RTX 4070 (CUDA) |
|---|---|---|---|
| Whisper large-v3 | 실시간의 10–12배 | 실시간의 12–14배 | 8–12배(whisper.cpp) / 12배(faster-whisper) |
| Whisper small | 실시간의 30–35배 | 실시간의 35–40배 | 실시간의 25–30배 |
×N 실시간이란 모델이 1초에 N초 분량의 오디오를 전사한다는 의미입니다. 10×는 10초 오디오를 1초에 전사함을 나타냅니다.
LLM 부하 시 전력 효율
지표 | M5 Pro | M5 Max | RTX 4090 데스크탑 |
|---|---|---|---|
| 유휴 전력 | 8W | 12W | 50W |
| LLM 생성 (8B) | 25W | 35W | 300W |
| LLM 생성 (70B) | 45W | 70W | N/A (OOM) |
| 70B 부하 시 팬 소음 | 조용함 | 보통 | N/A |
| 연간 전기요금 (24시간, 8B) | ~$33 | ~$46 | ~$394 |
열 스로틀링 테스트
최대 생성 속도로 30분간 70B 추론을 지속 실행하였습니다. 결과: M5 Pro와 M5 Max 모두 열 스로틀링이 발생하지 않았습니다. 두 칩 모두 테스트 내내 안정적인 tok/s를 유지하였습니다. M5 Max에서는 약 5분 후 팬 소음이 증가하였으나 이후 안정화되었습니다. 온도는 안전 한계 이내를 유지하였습니다.
어떤 칩을 구매해야 합니까?
- 1예산: 8B/13B 모델 일상 사용
Why it matters: M5 Pro 36–64GB는 과사양이지만 미래 대비에 적합합니다. 50–60 tok/s는 대화형 사용에 충분히 편안합니다. - 2중간급: 34B 모델
Why it matters: M5 Pro 64GB가 이상적입니다. 40–50 tok/s는 사용 가능한 수준이며 M5 Max는 불필요한 비용 프리미엄입니다. - 3고급: 70B 모델 정기 사용
Why it matters: M5 Max 128GB는 이중 GPU 구성 없이 유일한 소비자용 옵션입니다. 15–20 tok/s는 허용 가능한 수준입니다. - 4항상 켜두는 서버
Why it matters: Mac Mini의 M5 Pro 64GB: 무음, 저전력, 항상 준비 상태. $1,200–1,500. - 5이동형 AI 워크스테이션
Why it matters: MacBook Pro의 M5 Pro 64GB. 이동 중에도 전체 성능 발휘. - 6최고 품질 + 최대 속도
Why it matters: Mac Studio의 M5 Max 128GB. 70B Q5 + Whisper + TTS 동시 실행 가능.
M5 Pro와 M5 Max, 이제 데스크톱 Mac에서도 사용 가능
2026년 8월 25일, Apple은 이 페이지에서 벤치마크한 것과 동일한 M5 Pro 및 M5 Max 칩을 이번 세대 최초로 데스크톱 Mac에 탑재했습니다: Mac mini M5 Pro와 Mac Studio M5 Max, 그리고 새로운 Mac Studio M5 Ultra입니다. 세 모델 모두 2026년 9월 22일 출시됩니다(512GB 구성의 Mac Studio M5 Ultra는 2026년 10월 말에 별도로 출시).
데스크톱 Mac | 시작 가격(미국) | 최대 메모리 | 출시일 |
|---|---|---|---|
| Mac mini M5 Pro | $1,699 | 64GB(307 GB/s) | 2026년 9월 22일 |
| Mac Studio M5 Max | $2,499 | 128GB | 2026년 9월 22일 |
| Mac Studio M5 Ultra | $5,499 | 96GB(최대 256/512GB) | 9월 22일 / 10월 말 |
위 가격은 Apple이 발표한 미국 시작 가격입니다. 이 업데이트 시점에는 공식 원화 가격이 발표되지 않아 별도 환산은 하지 않았습니다. 이 데스크톱 구성은 이 페이지의 다른 부분에서 벤치마크한 것과 동일한 M5 Pro / M5 Max 실리콘을 사용합니다 — 차이는 칩이 아니라 케이스입니다. 이 기사의 모든 tok/s 수치는 MacBook Pro 기기에서 측정되었습니다. 데스크톱 케이스는 노트북보다 열 여유가 크기 때문에, 수 분간 지속되는 추론 부하에서는 Mac mini/Mac Studio가 동등한 MacBook Pro 칩보다 다소 빠르게 동작할 가능성이 있습니다 — 다만 이 기기들이 아직 출시되지 않아 독립적인 데스크톱 케이스 벤치마크는 아직 존재하지 않습니다. 소매 제품이 출시되고 테스트되는 대로 실측 데스크톱 수치로 이 섹션을 업데이트할 예정입니다. Mac mini M5 Pro에는 Thunderbolt 5도 추가되었습니다.
Mac에서 이 벤치마크를 직접 재현하는 방법
이 벤치마크는 M5 Pro 또는 M5 Max가 탑재된 모든 기기에서 완전히 재현 가능합니다. 아래 Python 코드를 MLX와 함께 사용하여 자신의 시스템 성능을 직접 확인하십시오. 측정값은 보고된 범위의 ±10% 이내여야 합니다.
from mlx_lm import load, generate
import time

model, tokenizer = load("mlx-community/Llama-3.1-8B-Instruct-4bit")

prompt = "Explain quantum computing in 200 words."
start = time.time()
response = generate(model, tokenizer, prompt=prompt, max_tokens=200)
elapsed = time.time() - start

tokens = len(tokenizer.encode(response))
print(f"Speed: {tokens/elapsed:.1f} tok/s")
print(f"Time to first token: ~{elapsed - tokens * (elapsed/tokens):.2f}s")
M5 Ultra: 가격은 확정, 성능은 아직 예측치
Apple은 2026년 8월 25일 Mac Studio M5 Ultra를 공식 발표했습니다: 미국 시작 가격 $5,499(96GB 통합 메모리, 동일 케이스 내 최대 256GB까지 확장 가능; 512GB 별도 구성은 2026년 10월 말 출시 예정이며 가격은 $10,000를 크게 상회할 것으로 예상됩니다). 출시일은 2026년 9월 22일(512GB 구성: 2026년 10월 말)입니다. 아래 가격과 메모리 상한은 Apple이 확정 발표한 정보이며, tok/s 수치는 여전히 과거 Apple SoC 확장 패턴(Ultra는 일반적으로 Max 사양의 2배)에 기반한 예측치입니다 — Apple은 이 글 작성 시점까지 리뷰어나 일반 소비자에게 M5 Ultra 실기를 아직 공급하지 않아 독립적인 벤치마크가 존재하지 않습니다.
사양 | M5 Ultra |
|---|---|
| 최대 통합 메모리 | 256GB(별도 구성으로 512GB, 2026년 10월 말) |
| 메모리 대역폭 | ~1,200 GB/s(예측) |
| GPU 코어 | ~80(예측) |
| Llama 3.1 8B Q4 (예측) | 180–220 tok/s |
| Llama 3.3 70B Q4 (예측) | 30–40 tok/s |
| Llama 3.3 70B FP16 (예측) | 12–16 tok/s |
| Llama 3.3 405B Q3 (예측) | 4–6 tok/s |
| 시작 가격(확정) | $5,499(96GB); 512GB 구성은 별도 가격 |
| 출시일(확정) | 2026년 9월 22일(512GB: 10월 말) |
| 최초 소비자용 405B 로컬 실행 | 가능 (Q3, 완전 로컬) — 예측 |
M5 Ultra는 70B 모델을 무손실 FP16으로 실행할 수 있는 최초의 소비자용 하드웨어이자, 405B 파라미터 모델을 로컬에서 의미 있는 속도로 처리할 수 있는 첫 번째 기기가 될 것으로 예상됩니다 — 다만 독립적으로 측정되기 전까지는 예측치일 뿐입니다. M5 Ultra가 출시되고 테스트가 가능해지는 대로 검증된 tok/s 수치로 이 기사를 업데이트할 예정입니다.
벤치마크 방법론 및 최신성
- 테스트 기간: 2026년 4–5월, M5 Pro 및 M5 Max 정품 출시 기기(macOS 15.x Sequoia).
- 프레임워크: Ollama 0.7.x, MLX 0.22.x, llama.cpp b3460+ (모두 Metal 가속 활성화 상태에서 테스트).
- 모델: 공식 llama.gguf, MLX 커뮤니티 양자화 버전, 모두 Q4_K_M(기본) 및 Q5_K_M(고품질) 양자화 사용.
- 마지막 검증: 2026-05-15 (M5 Pro/M5 Max tok/s 수치); Mac mini/Mac Studio 데스크톱 출시는 2026-08-25에 확정 발표되었으나 아직 독립 벤치마크는 없습니다.
- 프레임워크 업데이트 주기: 월별 릴리스로 분기당 일반적으로 5–15% 속도 향상. 이 기사는 분기별, 그리고 새로운 Apple Silicon 칩 출시 시 재벤치마킹됩니다.
- 하드웨어 편차: ±10% 이내의 결과 차이는 정상입니다(열 상태, 시스템 부하, 파일 시스템 캐시 상태에 따라 다름).
M5 Max가 2배 대역폭임에도 왜 약 2배만 빠릅니까?
메모리 대역폭은 토큰 생성 속도를 선형적으로 제한합니다. M5 Max의 614 GB/s vs M5 Pro의 307 GB/s = 이론적 2배 속도. 실제 가속은 아키텍처 차이와 캐시 효과로 인해 1.8–2.1배입니다.
왜 RTX 4090이 8B 모델에서 더 높은 tok/s를 보입니까?
RTX 4090은 M5 Max(614 GB/s)보다 높은 메모리 대역폭(1,008 GB/s)을 갖습니다. 그러나 RTX 4090은 24GB VRAM 한계로 70B 모델을 실행할 수 없는 반면 M5 Max는 가능합니다. 소형 모델의 순수 속도 vs 모델 크기 유연성 사이의 트레이드오프입니다.
M5 Pro로 충분합니까, 아니면 M5 Max를 구매해야 합니까?
M5 Pro는 8B/13B/34B 모델에서 뛰어난 가성비를 제공합니다. M5 Max($1,800+ 프리미엄)는 70B 모델을 정기적으로 사용하거나 멀티모달 스택(비전 + LLM + TTS 동시 실행)이 필요한 경우에만 비용이 정당화됩니다.
M5 Ultra 벤치마크는 극적으로 더 빠를 것입니까?
Mac Studio M5 Ultra는 2026년 9월 22일 출시 예정이며 시작 가격 $5,499(96GB, 최대 256GB/512GB)에 예상 대역폭 ~1,200 GB/s(M5 Max의 2배)를 갖출 것입니다. 약 2배 빠른 토큰 생성이 예상되며, 70B Q8(무손실) 및 120B 이상 모델을 의미 있는 속도로 처리할 수 있게 될 것으로 보이나, 이는 독립 벤치마크가 나오기 전까지는 예측치일 뿐 실측값이 아닙니다.
새로운 Mac mini M5 Pro와 Mac Studio M5 Max는 이 페이지의 MacBook Pro 벤치마크보다 빠릅니까?
그럴 가능성은 있지만 아직 확인되지 않았습니다. 이 페이지의 모든 벤치마크는 MacBook Pro 기기에서 측정되었습니다. 데스크톱 Mac은 노트북보다 냉각 여유가 커서, 긴 추론 작업 시 칩이 더 높은 클럭을 유지할 수 있을 가능성이 있습니다. 이 글 작성 시점까지 Apple은 데스크톱용 Mac mini M5 Pro나 Mac Studio M5 Max/M5 Ultra를 아직 출시하지 않았으며(출시일은 2026년 9월 22일), 따라서 독립적인 데스크톱 tok/s 측정값은 아직 존재하지 않습니다. 데스크톱 벤치마크가 공개되기 전까지는 이 페이지의 tok/s 수치를 MacBook Pro 결과로 간주하십시오.