Direktvergleich
Eigenschaft | |||
|---|---|---|---|
| Setup-Zeit | 2 Min. | 5 Min. | 10 Min. |
| Metal GPU | Automatisch | Nativ | Unterstützt |
| Modellformat | GGUF | MLX-Format | GGUF |
| API | REST (localhost:11434) | Python-nativ | CLI + HTTP |
| Geschwindigkeit (8B Q4) | 45–50 tok/s | 55–65 tok/s | 45–55 tok/s |
| Geschwindigkeit (70B Q4) | ~10 tok/s | ~14 tok/s | ~11 tok/s |
| Fine-Tuning | Nein | Ja (LoRA) | Nein |
| Ideal für | Einsteiger, API | ML-Entwickler | Plattformübergreifend |
Ollama auf Apple Silicon
- Ein-Befehl-Installation: `brew install ollama`
- Metal GPU automatisch — keine Konfiguration erforderlich
- REST-API für die Integration (jede Sprache)
- Modellverwaltung: `ollama pull`, `ollama list`, `ollama rm`
- Einschränkung: kein Fine-Tuning, keine benutzerdefinierte Quantisierung
- Einschränkung: etwas langsamer als MLX aufgrund von GGUF-Overhead
- Ideal für: Einsteiger, API-Nutzer, Whisper-Integration
Von Ollama unterstützte Modelle (100+ kuratiert)
- Llama 3.1 (8B, 70B, 405B), Llama 3.2 (1B, 3B), Llama 3.3 (70B)
- Ministral 3 8B, Mixtral 8x22B/22B
- Qwen3 (0,5B bis 72B)
- Phi-3, Phi-4
- Gemma 3 (4B, 12B, 27B)
- DeepSeek Coder V2
- Vision: Llama 3.2 Vision, LLaVA
- Einbettung: nomic-embed-text, mxbai-embed-large
MLX — Apples natives Framework
- Von Apple speziell für Apple Silicon entwickelt
- NumPy-ähnliche Python-API: `import mlx.core as mx`
- Lazy Evaluation + Unified Memory = optimale Auslastung
- MLX-LM: dediziertes Paket für LLM-Inferenz und Fine-Tuning
- Schnellste Inferenz auf Apple Silicon (20–40% schneller als Ollama)
- Fine-Tuning-Unterstützung: LoRA und QLoRA direkt auf dem Mac
- Einschränkung: nur MLX-Format-Modelle (wachsende Bibliothek)
- Einschränkung: nur macOS — Code nicht portierbar
- Ideal für: ML-Entwickler, maximale Geschwindigkeit, Fine-Tuning
Von MLX unterstützte Modelle (mlx-community auf HuggingFace)
- Alle wichtigen LLMs (Llama, Mistral, Qwen, Gemma, Phi)
- Quantisierungsversionen (Q3, Q4, Q5, Q6, Q8)
- Vision-Modelle: Llama 3.2 Vision, LLaVA, Qwen3-VL, Qwen2.5-VL
- Hinweis: erfordert Konvertierung ins MLX-Format (Community konvertiert die meisten)
llama.cpp auf Apple Silicon
- Plattformübergreifendes C/C++ — dieselbe Binary läuft auf Mac, Linux, Windows
- Metal-Unterstützung über Build-Flag: `make LLAMA_METAL=1`
- GGUF-Format: größte Modellbibliothek
- Server-Modus: `./llama-server -m model.gguf` — REST-API
- Whisper.cpp vom selben Autor — Metal STT-Unterstützung
- Einschränkung: Kompilierung aus dem Quellcode (keine Ein-Klick-Installation)
- Einschränkung: langsamer als MLX, vergleichbar mit Ollama
- Ideal für: plattformübergreifende Projekte, maximale Modellformat-Unterstützung
Von llama.cpp unterstützte Modelle (beliebiges GGUF)
- Jedes GGUF auf HuggingFace funktioniert (10.000+ Modelle)
- Größtes Ökosystem für fein abgestimmte und benutzerdefinierte Modelle
- Ursprüngliche/experimentelle Modelle erscheinen hier oft zuerst
- Für gängige Modelle (Llama, Mistral, Qwen) decken alle drei Frameworks ab. Für unbekannte oder experimentelle Modelle gewinnt llama.cpp durch die Ökosystemgröße.
Setup-Vergleich: 5 Codezeilen, um Llama 3.1 8B auszuführen
Ollama (2 Befehle):
```bash
brew install ollama
ollama run llama3.1:8b "Hello, world"
```
MLX (4 Python-Zeilen):
```python
from mlx_lm import load, generate
model, tokenizer = load("mlx-community/Llama-3.1-8B-Instruct-4bit")
response = generate(model, tokenizer, prompt="Hello, world", max_tokens=100)
print(response)
```
llama.cpp (5 Befehle):
```bash
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp
make LLAMA_METAL=1
wget https://huggingface.co/ggml-org/models/resolve/main/llama-3.1-8b-q4.gguf
./main -m llama-3.1-8b-q4.gguf -p "Hello, world"
```
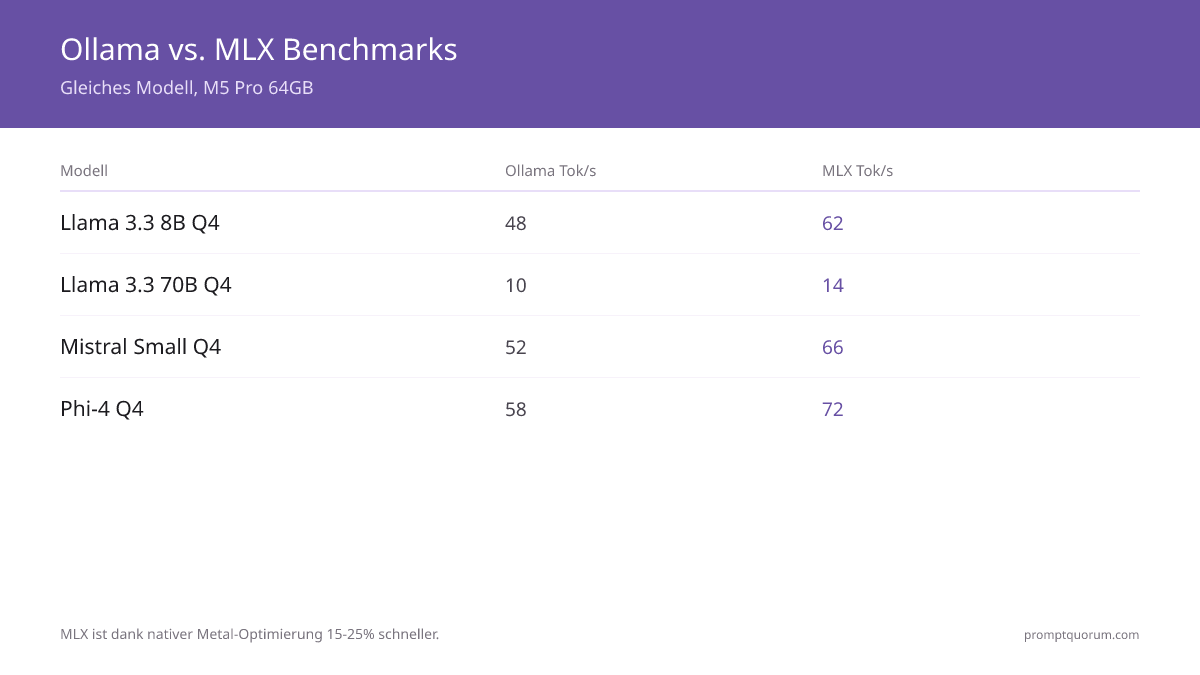
Benchmarks: Gleiches Modell, drei Frameworks, M5 Pro 64 GB
Modell | |||
|---|---|---|---|
| Llama 3.1 8B Q4 | 48 | 62 | 52 |
| Llama 3.1 8B Q8 | 38 | 48 | 40 |
| Llama 3.3 70B Q4 | 10 | 14 | 11 |
| Ministral 3 8B Q4 | 52 | 66 | 55 |
| Phi-4 Q4 | 58 | 72 | 60 |
MLX ist 20–40% schneller aufgrund nativer Metal-Optimierung. Frühe Benchmarks — Framework-Verbesserungen erwartet. Die Werte sind Richtwerte für eine Konfiguration, keine unabhängigen Labormessungen; Ergebnisse variieren je nach Modell, Version und Einstellungen.

Speichernutzung: Gleiches Modell, drei Frameworks (M5 Pro 64 GB)
Modell | |||
|---|---|---|---|
| Llama 3.1 8B Q4 | 5,2 GB | 4,8 GB | 5,0 GB |
| Llama 3.3 70B Q4 | 43 GB | 41 GB | 42 GB |
| Ministral 3 8B Q4 | 4,6 GB | 4,3 GB | 4,4 GB |
In der Tabelle oben zeigt MLX für dasselbe Modell einen etwas geringeren Speicherverbrauch als Ollama; die Werte sind Richtwerte. Bei knappen Speicherstufen (16 GB, 36 GB) kann dies den Unterschied machen, ob ein Modell passt oder in den Swap ausgelagert wird.
Entscheidungsmatrix: Wann welches Framework verwenden
- 1Einstieg
Why it matters: Ollama — 2-Minuten-Setup, funktioniert sofort. - 2Python-App entwickeln
Why it matters: MLX — natives Python, höchste Geschwindigkeit. - 3REST-API benötigt
Why it matters: Ollama — integrierten API-Server inklusive. - 4Fine-Tuning auf dem Mac
Why it matters: MLX — unter diesen dreien die Option mit eingebauter LoRA-Unterstützung. - 5Plattformübergreifendes Projekt
Why it matters: llama.cpp — derselbe Code auf Mac + Linux + Windows. - 6
- 7Maximale Geschwindigkeit
Why it matters: MLX — 20–40% schneller als Alternativen. - 8Seltene Modelle
Why it matters: llama.cpp — größte GGUF-Modellbibliothek.

Wann welches Framework NICHT verwenden
Ollama nicht verwenden, wenn:
• Fine-Tuning benötigt wird (nicht unterstützt)
• Jedes letzte bisschen Geschwindigkeit benötigt wird (20–30% langsamer als MLX)
• Vollständig benutzerdefinierte Quantisierung gewünscht wird (eingeschränkte Kontrolle)
MLX nicht verwenden, wenn:
• Plattformübergreifende Bereitstellung erforderlich ist (nur macOS)
• Python nicht vertraut ist
• Eine REST-API direkt benötigt wird (muss umhüllt werden)
• Vision-Modelle in der Produktion benötigt werden (kleinere Auswahl)
llama.cpp nicht verwenden, wenn:
• Ein Ein-Klick-Erlebnis gewünscht wird (Kompilierung erforderlich)
• Fine-Tuning benötigt wird (nicht unterstützt)
• Keine eigene Verwaltung von Modell-Downloads gewünscht wird
Mehrere Frameworks gleichzeitig verwenden?
Ja — sie konfligieren nicht. Alle drei installieren. Gängiges Muster: Ollama für den täglichen Einsatz, MLX für geschwindigkeitskritische Aufgaben, llama.cpp für Modelle, die nicht in Ollama/MLX verfügbar sind. Alle verwenden dieselben Grundmodelle (in verschiedenen Formaten).
Was bedeutet MLX?
MLX ist Apples eigenes Machine-Learning-Framework, speziell für Apple Silicon entwickelt. Es bietet eine NumPy-ähnliche Python-API, Lazy Evaluation und Unified-Memory-Optimierung sowie natives LoRA/QLoRA-Fine-Tuning. MLX steht in keiner Beziehung zu Ollama oder llama.cpp — das sind separate Inference-Engines. Auf Apple Silicon ist MLX typischerweise 20–40% schneller als Ollama, läuft aber nur mit MLX-Format-Modellen und nur unter macOS.
Welches Framework ist am schnellsten?
MLX, 20–40% schneller als Ollama auf Apple Silicon. llama.cpp ist vergleichbar mit Ollama. Der Geschwindigkeitsunterschied ist nur bei großen Modellen (70B+) relevant; für 8B sind alle schnell genug.
Kann ich später das Framework wechseln?
Ja. Ollama heute installieren, morgen zu MLX wechseln. Modelle sind kompatibel (nur in verschiedenen Formaten). Kein Lock-in.
Ist MLX nur für Python?
MLX hat eine native Python-API, kann aber über Subprocess oder HTTP-Server-Wrapper aus anderen Sprachen aufgerufen werden. Am besten von Python aus verwendet.
Hat Ollama eine grafische Benutzeroberfläche?
Ollama selbst ist nur CLI. Verwenden Sie Open-Source-Frontends wie Open-WebUI für eine Chat-Oberfläche.
Kann ich Ollama und MLX gleichzeitig ausführen?
Ja. Sie verwenden separate Modellverzeichnisse und konfligieren nicht. Viele Entwickler betreiben Ollama als Hintergrunddienst für API-Zugriff und nutzen MLX für Python-Notebook-Experimente. Bei ausreichend Unified Memory können sie sogar dasselbe Modell gleichzeitig im Arbeitsspeicher halten.
Funktioniert MLX auf Intel-Macs?
Nein. MLX wurde speziell für Apple Silicon (M1+) entwickelt. Intel-Mac-Nutzer müssen Ollama oder llama.cpp verwenden. Beide funktionieren auf Intel, aber ohne Metal GPU-Beschleunigung — deutlich langsamer als Apple Silicon.
Welches Framework unterstützt Vision-Modelle am besten?
Ollama hat die sauberste Vision-Modell-Integration über `ollama run llama3.2-vision`. MLX unterstützt Vision-Modelle, erfordert aber mehr Einrichtung. llama.cpp hat Vision-Unterstützung via separater llava-Executable. Für multimodale Arbeiten mit Ollama beginnen.
Muss ich bei der Verwendung lokaler LLM-Frameworks die DSGVO beachten?
Da die Daten lokal auf Ihrem Mac verarbeitet werden und keine externen Server involviert sind, entfällt in der Regel die Auftragsverarbeitungsvereinbarung nach DSGVO-Artikel 28, sofern kein Drittanbieter Zugriff auf die Daten erhält; die DSGVO gilt für Ihre Verarbeitung weiterhin. Lokale Inferenz mit Ollama, MLX oder llama.cpp kann datenschutzrechtlich vorteilhaft sein — besonders relevant für Mittelstandsunternehmen im DACH-Raum, die Datenschutz und BSI-Grundschutz-Anforderungen berücksichtigen müssen. Dies ist keine Rechtsberatung.
Ist der Einsatz lokaler LLM-Frameworks für den deutschen Mittelstand geeignet?
Oft ja. Wenn keine Daten an externe KI-Dienste gesendet werden, kann das die Weitergabe an Dritte für diesen Verarbeitungsschritt vermeiden; ob Datensparsamkeit und Zweckbindung der DSGVO eingehalten sind, hängt jedoch von Ihrer gesamten Verarbeitung ab. Für Mittelstandsunternehmen mit sensiblen Daten (Kundendaten, Geschäftsgeheimnisse, Personalunterlagen) kann lokale Inferenz eine sinnvolle Option sein. Dies ist keine Rechtsberatung. Ollama eignet sich besonders für einen schnellen Einstieg in der mittelständischen IT-Infrastruktur.
Framework-Versionen & Aktualität
• Die Werte in den Tabellen sind Richtwerte für eine Konfiguration, keine unabhängigen Labormessungen; die zugrunde liegenden Framework-Versionen hat PromptQuorum nicht unabhängig geprüft
• Zuletzt überprüft: 2026-08-28
• Framework-Performance verbessert sich monatlich — vierteljährliches Re-Benchmarking für aktuelle Zahlen empfohlen