- Alle M-Serie-Chips verwenden einheitlichen Speicher (GPU + CPU teilen denselben RAM-Pool) — dies ist der Hauptvorteil gegenüber diskreten GPUs.
- M6 (Mac mini) sowie M5 Pro/M5 Max/M5 Ultra (Mac mini und Mac Studio) sind nach Apples Refresh vom 25.8.2026 die 2026-Empfehlungen für neue Käufer; M4 und älter sind noch lebensfähig, aber weniger zukunftssicher für wachsende Modellgrößen.
- Metal ist Apples GPU-Programmierframework; es ist in macOS integriert und erfordert keine externen Bibliotheken oder Treiber-Updates.
- Framework-Wahl (Ollama, MLX, llama.cpp) beeinflusst die Geschwindigkeit um 0–25%, ändert aber nicht, welche Modelle in den Speicher passen.
- Mac mini M6 (ab 899 $ mit 16 GB, bis 32 GB) ist der günstigste Einstiegspunkt und nahezu lautlos (Apple nennt 5 dBA im Leerlauf).
- Geschätzte jährliche Stromkosten (Richtwert, 24/7 bei 0,15 $/kWh, nicht gemessen): Mac mini M6 ca. 35 $ vs. Desktop RTX 4090 ca. 400 $ — etwa das Zehnfache.
Warum Apple Silicon für lokale LLMs?
Apple Silicon zeichnet sich beim lokalen LLM-Inferencing aus einem Grund aus: einheitlicher Speicher. Wenn Sie einen Mac mit 64 GB RAM kaufen, stehen etwa 56 GB (64 GB abzüglich der 8 GB, die macOS braucht) dem LLM-Modell zur Verfügung. Eine diskrete GPU wie RTX 4090 hat nur 24 GB VRAM (getrennt von Ihrem Arbeitsspeicher) — Modelle größer als 24 GB passen einfach nicht ohne komplexe Multi-GPU-Setups und zusätzliche Hardwarekosten.
Dieser architektonische Unterschied ist transformativ für lokale KI:
- Einheitlicher Speicher: RAM abzüglich etwa 8 GB für macOS verfügbar (insgesamt 16–512 GB je nach Chip). RTX 4090: nur diskreter VRAM (24 GB hartkodiert).
- Metal-Beschleunigung: GPU-Inferencing ohne CUDA-Abhängigkeit oder proprietäre Treiber-Updates.
- Stromeffizienz: 20–100 W unter Last versus 300 W+ für Desktop-GPU. Ermöglicht lüfterloses oder fast lautloses Betrieb.
- Stille: Das MacBook Air ist lüfterlos; für den Mac mini nennt Apple 5 dBA im Leerlauf.
- Keine Treiberverwaltung: Metal funktioniert out-of-the-box auf macOS. Keine CUDA-Versionskonflikte, keine NVIDIA-Treiber-Updates erforderlich.
- Hardwarekosten: M5-Pro-Mac-mini (ab 1.699 $) mit 64-GB-Speicher versus Dual-GPU-Setup (4.000 $+) für entsprechende Modellkapazität.
Apple-Silicon-Chips für LLMs — Vollständiger Vergleich
Chip | Max. Speicher | Speicherbandbreite | GPU-Kerne | LLM-Optimum | Veröffentlicht |
|---|---|---|---|---|---|
| M1 | 16 GB | 68 GB/s | 8 | 7B Q4 | Nov 2020 |
| M1 Pro | 32 GB | 200 GB/s | 16 | 13B Q4 | Okt 2021 |
| M1 Max | 64 GB | 400 GB/s | 32 | 32B Q4 | Okt 2021 |
| M1 Ultra | 128 GB | 800 GB/s | 64 | 70B Q4 | Mär 2022 |
| M2 | 24 GB | 100 GB/s | 10 | 7–13B Q4 | Jun 2022 |
| M2 Pro | 32 GB | 200 GB/s | 19 | 13B Q4 | Jan 2023 |
| M2 Max | 96 GB | 400 GB/s | 38 | 34–70B Q4 | Jan 2023 |
| M2 Ultra | 192 GB | 800 GB/s | 76 | 70B+ Q4 | Jun 2023 |
| M3 | 24 GB | 100 GB/s | 10 | 7–13B Q4 | Okt 2023 |
| M3 Pro | 36 GB | 150 GB/s | 18 | 13–32B Q4 | Okt 2023 |
| M3 Max | 128 GB | 400 GB/s | 40 | 70B Q4 | Okt 2023 |
| M4 | 32 GB | 120 GB/s | 10 | 13B Q4 | Mai 2024 |
| M4 Pro | 48 GB | 273 GB/s | 20 | 32B Q4 | Okt 2024 |
| M4 Max | 128 GB | 546 GB/s | 40 | 70B Q4 | Okt 2024 |
| M5 (Basis) | 32 GB | ~150 GB/s | 10 | 13B Q4 | Okt 2025 |
| M6 (Mac mini) | 32 GB | Bis 170 GB/s | 12 | 13B Q4 | Aug 2026 |
| M5 Pro | 64 GB | 307 GB/s | Bis 20 | 32B Q5 | Aug 2026 |
| M5 Max | 128 GB | 460–614 GB/s | 32–40 | 70B Q5 | Aug 2026 |
| M5 Ultra | 512 GB | 1,2 TB/s | Bis 80 | 120B+ Q4 / 70B FP16 | Aug 2026 |
M5 Pro debütierte im MacBook Pro (März 2026); der Refresh vom 25.8.2026 brachte ihn zusammen mit dem neuen M6 in den Mac mini. M5 Max und M5 Ultra sind seit dem 25.8.2026 neu im Mac Studio. Alle vier sind seit 22.9.2026 erhältlich; die 512-GB-Konfiguration des M5 Ultra ist seit 28.10.2026 bestellbar. Die Angaben zu M6, M5 Pro, M5 Max und M5 Ultra stammen aus Apples Spezifikationen für Mac mini und Mac Studio.
Refresh August 2026: Mac mini M6/M5 Pro, Mac Studio M5 Max/M5 Ultra
Apple hat am 25. August 2026 einen Refresh von Mac mini und Mac Studio angekündigt. Beide Geräte sind seit dem 22. September 2026 erhältlich, die 512-GB-Konfiguration des M5 Ultra ist seit dem 28. Oktober 2026 bestellbar. Apples eigene Leistungsangaben sind als solche gekennzeichnet; unabhängige Ergebnisse werden mit Quelle genannt.
- Mac mini M6: ab 899 $ (799 $ Bildung) mit 16 GB, konfigurierbar bis 32 GB. 12-Kern-CPU, 12-Kern-GPU, bis zu 170 GB/s Speicherbandbreite. Apple nennt eine 40 % schnellere CPU und bis zu 4x mehr KI-Leistung gegenüber dem Mac mini M4 — Apples Angaben, nicht unabhängig geprüft.
- Mac mini M5 Pro: ab 1.699 $. Bis zu 18 CPU-Kerne, bis zu 20 GPU-Kerne, 307 GB/s, bis zu 64 GB einheitlicher Speicher.
- Mac Studio M5 Max: ab 2.499 $. 18-Kern-CPU, 32- oder 40-Kern-GPU, bis zu 128 GB einheitlicher Speicher, 460–614 GB/s je nach Konfiguration.
- Mac Studio M5 Ultra: ab 5.499 $ (5.099 $ Bildung), 96 GB einheitlicher Speicher in der Basis, 256 GB und 512 GB als Konfigurationsoptionen. Bis zu 36 CPU-Kerne, bis zu 80 GPU-Kerne, 1,2 TB/s Speicherbandbreite. Die 512-GB-Option setzt das Modell mit 36-Kern-CPU und 80-Kern-GPU voraus, ist seit dem 28. Oktober 2026 bestellbar und hebt den Mindestpreis einer 512-GB-Konfiguration auf 22.299 $.
- Der Mac Studio unterstützt Thunderbolt-5-Clustering mit RDMA; Apple nennt bis zu 3x schnellere verteilte KI-Inferenz gegenüber einem einzelnen System — Apples Angabe, nicht unabhängig geprüft.
- Erste unabhängige M5-Ultra-Ergebnisse (BGR, 21. September 2026; 256-GB-Modell, LM Studio, 4-Bit-MLX): rund 55 tok/s mit Qwen 3.8 27B gegenüber rund 40 auf einem M3 Ultra sowie rund 80 gegenüber 60 tok/s mit Qwen 3.5 122B A10B. BGR berichtet im Schnitt 30–40 % mehr Leistung als beim M3 Ultra; Kontextlänge und Anzahl der Durchläufe nennt BGR nicht.
- Mac mini M4/M4 Pro sowie Mac Studio M4 Max/M3 Ultra sind jetzt die Vorgängergeneration.
- Die 512 GB des M5 Ultra sind die Top-Konfiguration; sie erlauben lokale Modelle mit 120B+ Parametern auf einem einzelnen Verbraucher-Mac.
Speicherbandbreite ist wichtiger als Speichergröße
LLM-Inferencing ist speicherbandbreitenbegrenzt, nicht rechenbegrenzt. Das bedeutet, die Token-Generierungsgeschwindigkeit skaliert linear mit der Bandbreite, nicht mit GPU-Kernzahl.
M5 Max bei 614 GB/s gegenüber RTX 4090 bei 1.008 GB/s könnte den Anschein erwecken, dass NVIDIA bei Rohbandbreite gewinnt. Aber Apple-Silicon-Benutzer können den größten Teil des Speichers nutzen (Gesamtspeicher abzüglich etwa 8 GB für macOS, bis zum standardmäßigen GPU-Speicherlimit von macOS, das sich anheben lässt), daher können sie größere Modelle laden, die NVIDIA nicht in 24 GB Speicher passen kann. Der echte Vergleich: M5 Max beim Ausführen eines 70B-Modells versus eine RTX 4090, die das 70B-Modell nicht vollständig in ihren 24 GB halten kann (Auslagerung auf die CPU ist möglich, aber deutlich langsamer).
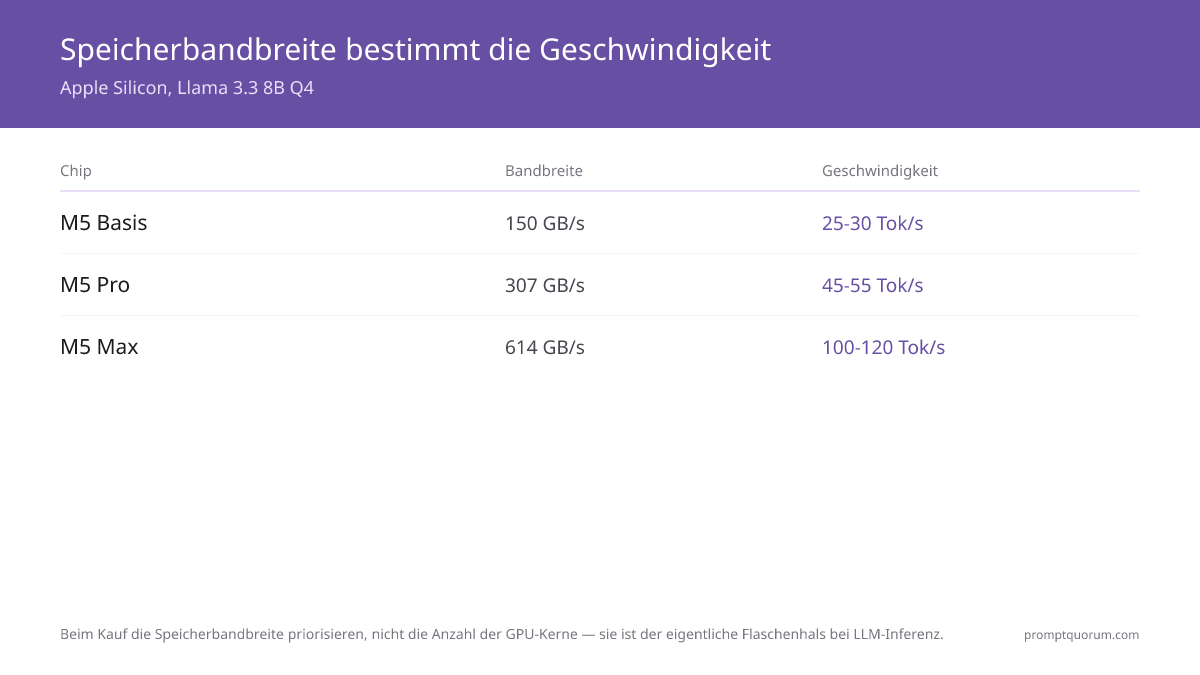
- M5 Basis (150 GB/s) → ~25–30 tok/s (Schätzung) auf Llama 3.1 8B Q4
- Mac mini M6 (bis 170 GB/s) → ähnlicher Bereich wie M5 Basis, dank höherer Bandbreite etwas höher. Apple veröffentlicht nur relative Angaben (bis zu 4x KI-Leistung gegenüber dem Mac mini M4); unabhängige tok/s-Werte für den M6 haben wir nicht geprüft.
- M5 Pro (307 GB/s) → ~45–55 tok/s (Schätzung) auf Llama 3.1 8B Q4 (2× schneller als M5 Basis wegen 2× Bandbreite)
- M5 Max (614 GB/s) → ~100–120 tok/s (Schätzung) auf Llama 3.1 8B Q4
- M5 Ultra (1,2 TB/s, Apple-Angabe) → BGR maß rund 55 tok/s mit einem 4-Bit-Qwen-3.8-27B gegenüber rund 40 auf einem M3 Ultra (rund 819 GB/s). Das sind etwa 1,4× mehr Generierungsgeschwindigkeit bei etwa 1,5× mehr Bandbreite — stimmig mit bandbreitenbegrenzter Inferenz.
- Fazit: Bei bandbreitenbegrenzter Inferenz erhöht eine Verdopplung der Bandbreite die Generierungsgeschwindigkeit tendenziell etwa proportional (Schätzung; auch die Architektur spielt eine Rolle). Beim Kauf sollten Sie die Bandbreite gegenüber GPU-Kernzahl priorisieren.

Stromeffizienz und Thermalmanagement — Der stille Vorteil
Setup | Stromverbrauch (Idle) | Stromverbrauch (LLM) | Lautstärke | Wärmestrahlung |
|---|---|---|---|---|
| Mac mini M6 | 5W | 25–35W | Nahezu lautlos (5 dBA im Leerlauf) | Warm |
| MacBook Air M5 | 3W | 20–30W | Geräuschlos (lüfterlos) | Warm |
| Mac mini M5 Pro | 5W | 40–60W | Leise (Lüfter selten) | Kühl |
| Mac Studio M5 Max | 10W | 60–100W | Leise | Kühl |
| Mac Studio M5 Ultra | 10W | Max. 480W Dauerlast (Apple) | Leise | Kühl |
| Desktop RTX 4090 | 50W | 350–450W | Lüftergeräusch unter Last hörbar | Heiß |
| Desktop RTX 3060 | 30W | 170–200W | Moderat | Warm |
Geschätzte jährliche Stromkosten bei 0,15$/kWh für einen 24/7-KI-Server (Richtwert, nicht gemessen; die tatsächlichen Kosten hängen von der Auslastung ab): Mac mini M6 (~35$/Jahr) vs. Desktop RTX 4090 (~400$/Jahr). Die Leerlauf- und Lastwerte sind Schätzungen von PromptQuorum, keine Messungen und keine Apple-Spezifikationen; Apple nennt eine maximale Dauerleistung von 155W für den Mac mini und 480W für den Mac Studio.

Echte Anwenderszenarien auf Apple Silicon
- 1Coding-Agent
Why it matters: Llama 3.1 8B auf M5 Pro liefert 45–55 tok/s (Schätzung); die Latenz der Code-Vervollständigung hängt von Modellgröße und Einstellungen ab (von PromptQuorum nicht gemessen). Läuft lautlos im Hintergrund auf MacBook Pro. - 2RAG-Pipeline
Why it matters: Embedding-Modell + Llama 3.1 8B + ChromaDB passt vollständig in 36GB M5-Pro-Speicher. Keine GPU-Grenzen. - 3Sprachassistent
Why it matters: Whisper Metal + Ollama Llama + Piper TTS : Die Latenz hängt von Modellgrößen und Einstellungen ab; PromptQuorum hat sie auf M5 Pro nicht gemessen. Leises Mac mini für ein Always-On-Setup geeignet. - 4Multimodal
Why it matters: Whisper + LLaVA 7B Vision + Llama 3.1 8B Reasoning = alle passen in 36GB, gleichzeitige Verarbeitung. - 5Private Schrift
Why it matters: Llama 3.3 70B Q5 auf M5 Max 128GB = hohe Qualität für längere Texte, läuft nach dem Modell-Download offline, keine API-Kosten pro Token, und Ihre Prompts bleiben bei der Inferenz auf dem Gerät. Auf dem neuen Mac Studio M5 Ultra (bis 512GB) werden 120B+-Modelle möglich, wenn Sie mehr Spielraum brauchen.
Welchen Mac sollten Sie kaufen?
- Ab 899 $: Mac mini M6 (16 GB, bis 32 GB gegen Aufpreis) → Modelle 7–13B, bis 170 GB/s Bandbreite, seit 22.9.2026 erhältlich
- 1.699$: Mac mini M5 Pro (64GB) → bis zu 32B-Modelle bei 15–20 tok/s (Schätzung)
- 1.500–2.500€: MacBook Pro M5 Pro (64GB) → tragbare KI-Workstation, gleiche Leistung wie Mac mini
- 2.499$: Mac Studio M5 Max (128GB) → 70B-Modelle bei 12–18 tok/s (Schätzung), Always-On-Server
- Von 5.499 $ (96 GB) bis 22.299 $ und mehr (512 GB): Mac Studio M5 Ultra → einer der wenigen Verbraucher-Macs für 120B+-Modelle; 512-GB-Konfiguration seit 28.10.2026 bestellbar
- Kritisch: Der Speicher ist beim Kauf fixiert und kann nicht aufgerüstet werden — kaufen Sie die größte Konfiguration, die zu Budget und geplanten Modellen passt. Allein die 512-GB-Option des M5 Ultra kostet 15.500 $ Aufpreis (MacRumors). US-Listenpreise; Preise in Deutschland können abweichen.
Erste Schritte: Framework-Überblick
- Ollama: einfachste Einrichtung, automatische Metal-Erkennung, keine Konfiguration. REST-API inbegriffen. Beste für Anfänger.
- MLX: Apples nationales Framework, in Community-Tests oft schneller als Ollama, Python-Integration, LoRA-Feinabstimmung. Steilere Lernkurve.
- llama.cpp: plattformübergreifend, meiste Modellformatunterstützung, Metal-Backend. Beste für Integration in größere Anwendungen.
Was hat Apple am 25. August 2026 für Mac mini und Mac Studio angekündigt?
Apple überarbeitete den Mac mini mit dem neuen M6-Chip (899 $ mit 16 GB, konfigurierbar bis 32 GB) und M5 Pro (1.699 $, bis 64 GB) sowie den Mac Studio mit M5 Max (2.499 $, bis 128 GB) und M5 Ultra (5.499 $ mit 96 GB, bis 512 GB). Alle sind seit dem 22. September 2026 erhältlich; die 512-GB-Konfiguration des M5 Ultra ist seit dem 28. Oktober 2026 bestellbar, ab 22.299 $.
Ist M5 Pro oder M5 Max besser für lokale LLMs?
M5 Pro (64GB) ist das beste Preis-Leistungs-Verhältnis — führt 32B-Modelle gut aus und kostet ab 1.699 $. M5 Max (ab 2.499 $) ist nur notwendig, wenn Sie häufig 70B-Modelle benötigen. M5 Pro (64 GB) bietet ein starkes Preis-Leistungs-Verhältnis für die meisten der in diesem Leitfaden behandelten Anwendungsfälle der 32B-Klasse; M5 Max lohnt sich, wenn Sie regelmäßig 70B-Modelle benötigen.
Kann ich den Speicher nach dem Kauf eines Mac aufgerüsten?
Nein. Apple-Silicon-Speicher ist gelötet und nicht aufrüstbar. Kaufen Sie den maximalen Speicher, den Sie sich leisten können.
Welche deutschen Compliance-Anforderungen sollte ich beachten?
Wenn Sie personenbezogene Daten verarbeiten, sollten Sie die Anforderungen der DSGVO (z. B. Art. 28) und die BSI-Grundschutz-Kataloge prüfen. Lokale Modelle auf Apple Silicon können Datentransfers an Dritte vermeiden und die Umsetzung erleichtern; ob Ihr konkreter Einsatz konform ist, hängt vom Einzelfall ab und ist keine Rechtsberatung.
Kann das M5 Pro mit RTX 4090 konkurrieren?
Bei Modellen, die in 24GB VRAM passen, ist die RTX 4090 meist schneller; der Abstand hängt von Modell und Quantisierung ab, und PromptQuorum hat ihn nicht gemessen. Ein 70B-Modell passt nicht vollständig in die 24GB einer RTX 4090 (Auslagerung auf die CPU ist möglich, aber deutlich langsamer), ein M5 Pro mit 64GB kann es mit 4-Bit-Quantisierung aufnehmen.
Ändert der M5 Ultra mit bis zu 512 GB Speicher etwas?
Ja. Der M5 Ultra (Mac Studio, ab 5.499 $ mit 96 GB, 1,2 TB/s Bandbreite, bis 512 GB ab 22.299 $) führt 70B-Modelle in FP16 (unquantisiert, ohne Quantisierungsverlust) aus und ermöglicht 120B+-Modelle auf einem einzelnen Verbraucher-Mac (512-GB-Konfiguration). Der erste von uns geprüfte unabhängige Test (BGR, 21. September 2026, 256-GB-Modell) maß rund 55 tok/s mit einem 4-Bit-Qwen-3.8-27B gegenüber rund 40 auf einem M3 Ultra. PromptQuorum hat keine eigenen M5-Ultra-Benchmarks durchgeführt.
Brauche ich Ollama, MLX oder llama.cpp?
Beginnen Sie mit Ollama (am einfachsten). Wenn Sie schnellere Inferenz oder Fine-Tuning brauchen, wechseln Sie zu MLX. Für plattformübergreifende Kompatibilität nutzen Sie llama.cpp. Alle drei laufen auf Apple Silicon.
Lohnt sich Apple Silicon für lokale LLMs im Jahr 2026?
Ja, besonders für Modelle ab 32B. Apple Silicon ist eine der wenigen Verbraucher-Optionen, die 70B-Modelle ohne komplexe Multi-GPU-Setups ausführt, und der Mac Studio M5 Ultra ist eine der wenigen, die 120B+-Modelle fasst. Bei 8B-Modellen, die in NVIDIA-VRAM passen, ist die RTX 4090 schneller, im Betrieb aber teurer.
Kann ein MacBook Air M5 lokale LLMs ausführen?
Ja, mit Einschränkungen. Ein MacBook Air M5 führt 7–8B-Modelle mit 16 GB aus (etwa 8 GB bleiben nach macOS) und bis zu 13B-Modelle mit 24–32 GB. Das lüfterlose Design kann bei dauerhafter Last thermisch drosseln. Für gelegentliche Nutzung: gut. Für Dauerbetrieb: ein Mac mini M5 Pro passt besser.
Wie ist die Leistung des Apple M6 bei lokalen LLMs?
Apple hat nur relative Angaben veröffentlicht: bis zu 4x KI-Leistung und 40 % schnellere CPU gegenüber dem Mac mini M4. Beim Refresh im August 2026 debütierte der M6 nur im Mac mini (899 $ mit 16 GB, bis 32 GB, bis zu 170 GB/s). Da die Generierungsgeschwindigkeit der Speicherbandbreite folgt, ist ein Niveau nahe am M5 Basis zu erwarten, nicht am M5 Pro; unabhängige tok/s-Werte für den M6 haben wir noch nicht geprüft.
Welche lokale LLM-Konfiguration passt zu einem M1 Mac mit 32 GB?
Ein M1 Pro oder M1 Max mit 32 GB (200 GB/s bzw. 400 GB/s) führt 13B-Modelle in Q4 komfortabel aus, das Optimum in der Chip-Tabelle oben; ein M1 Max mit 64 GB erreicht 32B in Q4. Der ursprüngliche M1 endet bei 16 GB, dort bleiben Sie bei 7B Q4.
Wie schneidet der M3 Ultra im Vergleich zum M5 Max bei lokalen LLMs ab?
Ein M3 Ultra schlägt einen M5 Max bei der Speicherkapazität (bis 512 GB gegenüber 128 GB) und fasst deshalb die größten Modelle. Bei der Geschwindigkeit berichtete BGR, ein MacBook Pro mit M5 Max habe im 27B-Test ähnlich wie ein Mac Studio mit M3 Ultra abgeschnitten, der M5 Ultra liege im Schnitt 30–40 % über dem M3 Ultra. Ein M5 Pro mit 48 GB liegt unter beiden und ist das Optimum für alle, die Reserve ohne Ultra-Preise wollen.
Benchmark-Methodik und Aktualität
- Die M5-Pro/Max-Werte für MacBook-Pro-Konfigurationen beruhen auf Community-Benchmarks von März bis Mai 2026
- M5 Ultra: Es gibt unabhängige Ergebnisse (BGR, 21. September 2026, 256-GB-Modell — siehe Abschnitt zum Refresh im August 2026). Die tok/s-Werte für M6 sowie M5 Pro/M5 Max in Mac mini/Mac Studio sind bandbreitenbasierte Schätzungen oder Community-Ergebnisse; Apples eigene Leistungsangaben sind als solche gekennzeichnet.
- Zuletzt geprüft: 2026-11-02
- Die Leistung steigt mit Framework-Updates (Ollama, MLX, llama.cpp erscheinen monatlich)
- Dieser Artikel wird vierteljährlich überprüft und um unabhängige Ergebnisse für M6 und Mac Studio M5 Max ergänzt, sobald wir sie geprüft haben