- كل شرائح سلسلة M تستخدم ذاكرة موحدة (يتشارك GPU وCPU مجموعة RAM نفسها).
- M6 (Mac mini) وM5 Pro/M5 Max/M5 Ultra (Mac mini وMac Studio) هي توصيات 2026 بعد تحديث Apple في 25 أغسطس 2026؛ وتبقى M4 وما قبلها قابلة للاستخدام لكن أقل استعدادًا للمستقبل.
- Metal هو إطار برمجة GPU من Apple؛ مدمج في macOS ولا يتطلب مكتبات خارجية.
- اختيار الإطار (Ollama، MLX، llama.cpp) يؤثر في السرعة بنسبة 0–25% لكنه لا يغيّر أي النماذج تتسع في الذاكرة.
- Mac Mini M6 هو نقطة الدخول الأكثر اقتصادًا (899 دولارًا أساسيًا بسعة 16GB، حتى 32GB) وشبه صامت (تذكر Apple مستوى 5 dBA في الخمول).
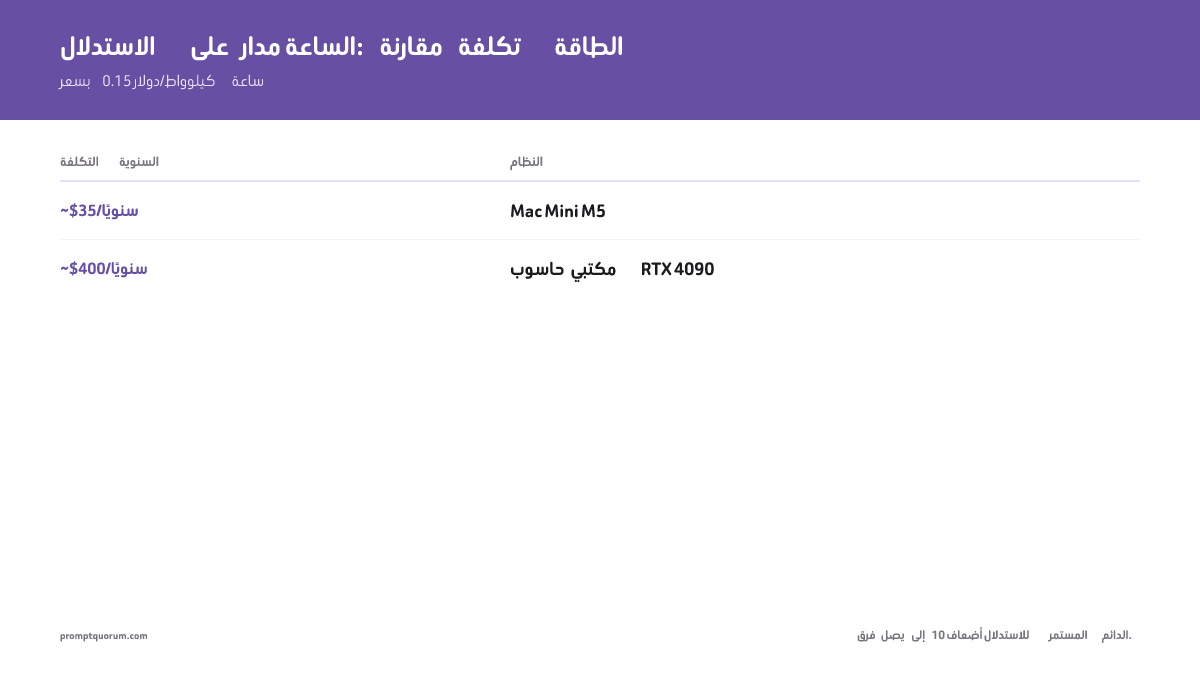
- التكلفة السنوية التقديرية للكهرباء (تقدير توضيحي، على مدار الساعة بسعر 0.15 دولار/kWh دون قياس): Mac Mini M6 نحو 35 دولارًا مقابل RTX 4090 المكتبي نحو 400 دولار — فارق يقارب 10 أضعاف.
لماذا Apple Silicon لنماذج LLM المحلية؟
يتفوق Apple Silicon في استدلال LLM المحلي لسبب واحد: الذاكرة الموحدة. عندما تشتري جهاز Mac بذاكرة 64GB، يتبقى نحو 56GB (64GB ناقص 8GB يحتاجها macOS) متاحة لنموذج LLM لديك. أما GPU منفصل مثل RTX 4090 فيملك 24GB من VRAM (منفصلة عن ذاكرة النظام) — والنماذج الأكبر من 24GB ببساطة لا تتسع دون تهيئات تعدد كروت رسوميات معقّدة.
هذا الفارق المعماري الوحيد تحويلي:
- ذاكرة موحدة: الذاكرة المتاحة بعد خصم نحو 8GB لنظام macOS (من 16GB إلى 512GB إجمالًا حسب الشريحة). RTX 4090: VRAM منفصلة فقط (حد صارم 24GB).
- تسريع Metal: استدلال GPU دون اعتماد على CUDA أو برامج تشغيل مملوكة.
- كفاءة الطاقة: 30–70 واط تحت الحمل مقابل 300 واط فأكثر لكرت رسوميات سطح المكتب. يتيح تشغيلًا بلا مروحة أو شبه صامت.
- الصمت: MacBook Air بلا مروحة، وتذكر Apple مستوى 5 dBA في الخمول لجهاز Mac mini.
- بلا إدارة برامج تشغيل: يعمل Metal أصليًا على macOS. لا تعارض إصدارات CUDA، ولا تحديثات برامج تشغيل NVIDIA.
- تكلفة العتاد: Mac Mini M5 Pro (1,200 دولار) بتهيئة 64GB مقابل تهيئة كرتي رسوميات (4,000 دولار فأكثر) لسعة نموذج مكافئة.
شرائح Apple Silicon لنماذج LLM — مقارنة كاملة
الشريحة | أقصى ذاكرة | عرض النطاق | أنوية GPU | النقطة المثلى لـ LLM | الإطلاق |
|---|---|---|---|---|---|
| M1 | 16 GB | 68 GB/s | 8 | 7B Q4 | نوفمبر 2020 |
| M1 Pro | 32 GB | 200 GB/s | 16 | 13B Q4 | أكتوبر 2021 |
| M1 Max | 64 GB | 400 GB/s | 32 | 32B Q4 | أكتوبر 2021 |
| M1 Ultra | 128 GB | 800 GB/s | 64 | 70B Q4 | مارس 2022 |
| M2 | 24 GB | 100 GB/s | 10 | 7–13B Q4 | يونيو 2022 |
| M2 Pro | 32 GB | 200 GB/s | 19 | 13B Q4 | يناير 2023 |
| M2 Max | 96 GB | 400 GB/s | 38 | 34–70B Q4 | يناير 2023 |
| M2 Ultra | 192 GB | 800 GB/s | 76 | 70B+ Q4 | يونيو 2023 |
| M3 | 24 GB | 100 GB/s | 10 | 7–13B Q4 | أكتوبر 2023 |
| M3 Pro | 36 GB | 150 GB/s | 18 | 13–32B Q4 | أكتوبر 2023 |
| M3 Max | 128 GB | 400 GB/s | 40 | 70B Q4 | أكتوبر 2023 |
| M4 | 32 GB | 120 GB/s | 10 | 13B Q4 | مايو 2024 |
| M4 Pro | 48 GB | 273 GB/s | 20 | 32B Q4 | أكتوبر 2024 |
| M4 Max | 128 GB | 546 GB/s | 40 | 70B Q4 | أكتوبر 2024 |
| M5 (base) | 32 GB | نحو 150 GB/s | 10 | 13B Q4 | أكتوبر 2025 |
| M6 (Mac mini) | 32 GB | حتى 170 GB/s | 12 | 13B Q4 | أغسطس 2026 |
| M5 Pro | 64 GB | 307 GB/s | حتى 20 | 32B Q5 | أغسطس 2026 |
| M5 Max | 128 GB | 460–614 GB/s | 32–40 | 70B Q5 | أغسطس 2026 |
| M5 Ultra | 512 GB | 1.2 TB/s | حتى 80 | 120B+ Q4 / 70B FP16 | أغسطس 2026 |
ظهر M5 Pro أولًا في MacBook Pro (مارس 2026)؛ وجلبه تحديث 25 أغسطس 2026 إلى Mac mini إلى جانب M6 الجديد كليًا. أما M5 Max وM5 Ultra فجديدان على Mac Studio منذ 25 أغسطس 2026. الأربعة جميعها متاحة للبيع منذ 22 سبتمبر 2026؛ وأصبحت تهيئة M5 Ultra بسعة 512GB قابلة للطلب منذ 28 أكتوبر 2026. أرقام M6 وM5 Pro وM5 Max وM5 Ultra مأخوذة من مواصفات Apple لـ Mac mini وMac Studio.
تحديث أغسطس 2026: Mac mini M6/M5 Pro، Mac Studio M5 Max/M5 Ultra
أعلنت Apple عن تحديث لأجهزة Mac mini وMac Studio في 25 أغسطس 2026. أصبح الجهازان متاحين للبيع منذ 22 سبتمبر 2026، وأصبحت تهيئة M5 Ultra بسعة 512GB قابلة للطلب منذ 28 أكتوبر 2026. ادعاءات الأداء الصادرة عن Apple موسومة على هذا الأساس، أما النتائج المستقلة فتُذكر مع مصدرها.
- Mac mini M6: من 899 دولارًا (799 دولارًا للتعليم) بسعة 16GB، قابلة للترقية إلى 32GB. معالج بـ 12 نواة، GPU بـ 12 نواة، عرض نطاق ذاكرة حتى 170 GB/s. تدّعي Apple معالجًا أسرع بنسبة 40% وأداء ذكاء اصطناعي أسرع حتى 4 أضعاف مقارنةً بـ Mac mini M4 — أرقام Apple نفسها، لم يُتحقق منها بشكل مستقل.
- Mac mini M5 Pro: من 1,699 دولارًا. حتى 18 نواة معالج، حتى 20 نواة GPU، عرض نطاق ذاكرة 307 GB/s، حتى 64GB من الذاكرة الموحدة.
- Mac Studio M5 Max: من 2,499 دولارًا. معالج بـ 18 نواة، GPU بـ 32 أو 40 نواة، حتى 128GB من الذاكرة الموحدة، وعرض نطاق 460–614 GB/s حسب التهيئة.
- Mac Studio M5 Ultra: من 5,499 دولارًا (5,099 دولارًا للتعليم)، بذاكرة موحدة أساسية 96GB، مع خيارَي 256GB و512GB عند الطلب. حتى 36 نواة معالج وحتى 80 نواة GPU، وعرض نطاق ذاكرة 1.2 TB/s. يتطلب خيار 512GB طراز المعالج ذي 36 نواة وGPU ذي 80 نواة، وأصبح قابلًا للطلب منذ 28 أكتوبر 2026، ويرفع الحد الأدنى لسعر تهيئة 512GB إلى 22,299 دولارًا.
- يدعم Mac Studio التجميع عبر Thunderbolt 5 مع RDMA؛ وتدّعي Apple استدلالًا موزعًا للذكاء الاصطناعي أسرع حتى 3 أضعاف مقارنةً بجهاز واحد — رقم Apple نفسها، لم يُتحقق منه بشكل مستقل.
- أولى النتائج المستقلة لـ M5 Ultra (BGR، 21 سبتمبر 2026؛ طراز 256GB، LM Studio، MLX بدقة 4 بت): نحو 55 tok/s على Qwen 3.8 27B مقابل نحو 40 على M3 Ultra، ونحو 80 مقابل 60 tok/s على Qwen 3.5 122B A10B. وتذكر BGR أداءً متوسطًا أفضل بنسبة 30–40% من M3 Ultra في اختباراتها؛ ولم تذكر طول السياق ولا عدد مرات التشغيل.
- أصبح Mac mini M4/M4 Pro وMac Studio M4 Max/M3 Ultra الآن الجيل السابق.
- تمثّل سعة 512GB في M5 Ultra الإعداد الأعلى، وهي ما يتيح تشغيل نماذج 120B فأكثر محليًا على جهاز Mac استهلاكي واحد.
عرض نطاق الذاكرة أهم من حجم الذاكرة
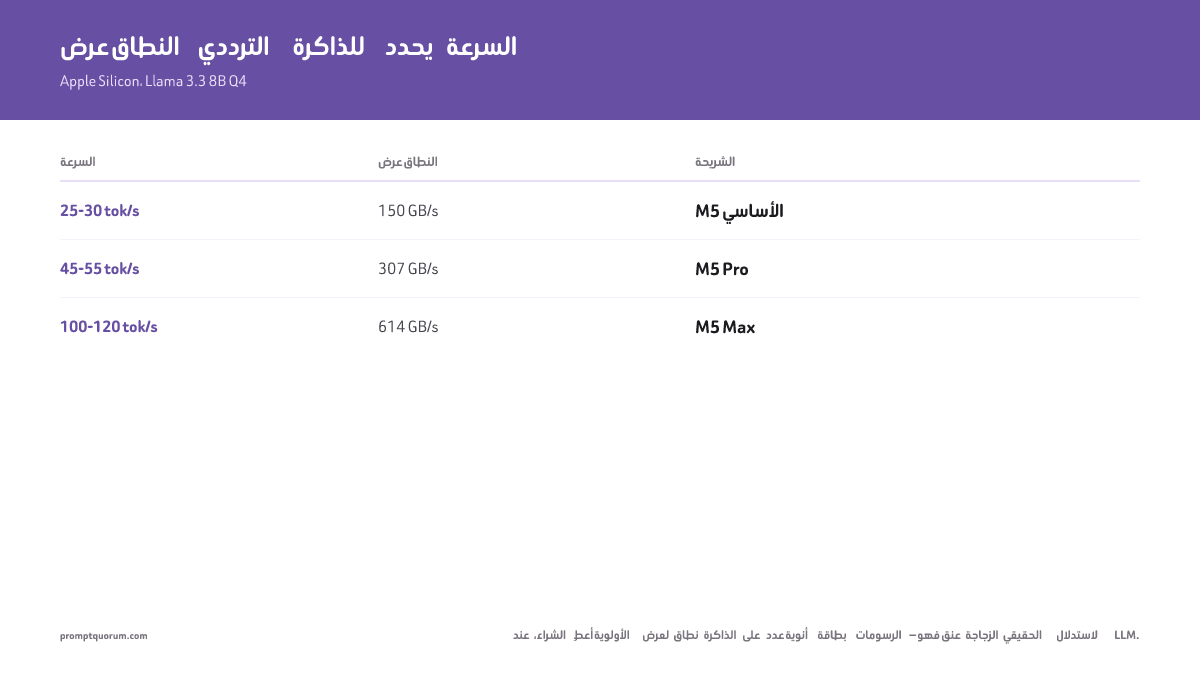
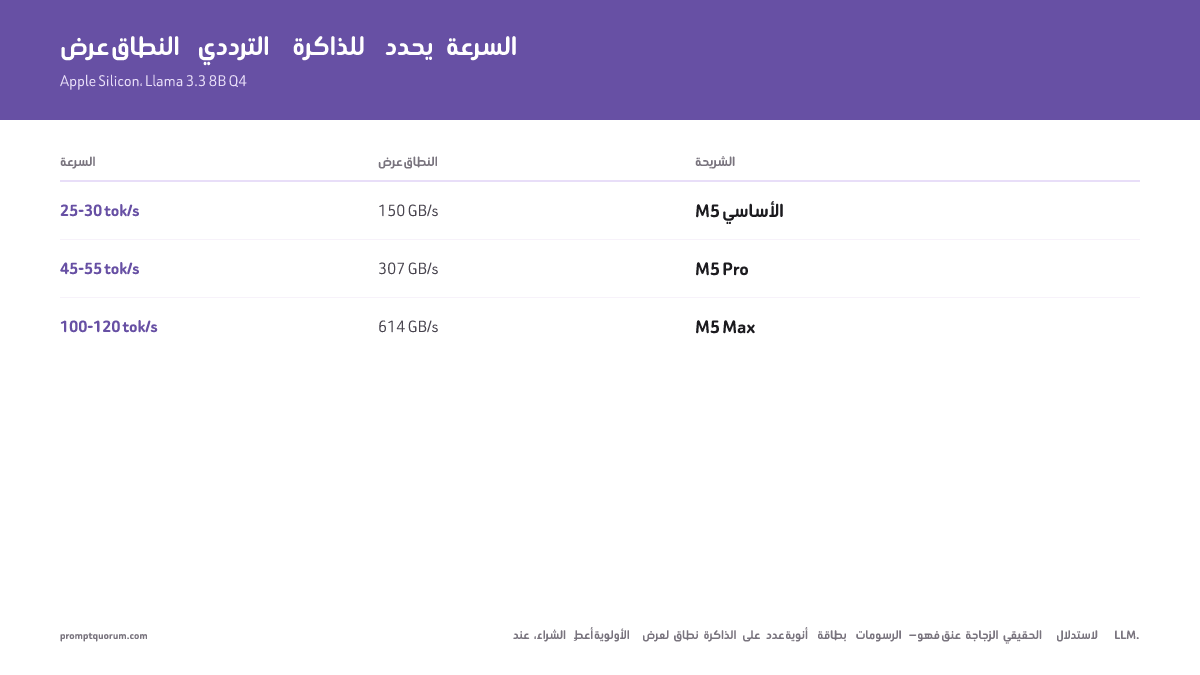
استدلال LLM محدود بعرض نطاق الذاكرة، لا بقدرة الحوسبة. هذا يعني أن سرعة توليد الـ tokens تتناسب خطيًا مع عرض النطاق، لا مع أنوية GPU.
M5 Max عند 614 GB/s مقابل RTX 4090 عند 1,008 GB/s يبدو أن NVIDIA تفوز في عرض النطاق الخام. لكن مستخدمي Apple Silicon يستطيعون استخدام معظم الذاكرة (الإجمالي ناقص نحو 8GB لنظام macOS، حتى الحد الافتراضي لذاكرة الرسومات في macOS الذي يمكن رفعه)، لذا يمكنهم تحميل نماذج أكبر لا يستطيع NVIDIA استضافتها في 24GB. المقارنة الحقيقية: M5 Max عند 614 GB/s يشغّل نموذج 70B مقابل RTX 4090 الذي لا يستوعب نموذج 70B كاملًا في 24GB (يمكن تفريغ جزء منه إلى المعالج لكن ببطء شديد).
داخل خط M، تترجم فروق عرض النطاق مباشرةً إلى tok/s:
- M5 الأساسي (150 GB/s) ← نحو 25–30 tok/s (تقدير) على Llama 3.1 8B Q4
- Mac mini M6 (حتى 170 GB/s) ← في نطاق مشابه لـ M5 الأساسي، أعلى قليلًا بسبب عرض النطاق الأكبر. تنشر Apple ادعاءات نسبية فقط (أداء ذكاء اصطناعي حتى 4 أضعاف مقارنةً بـ Mac mini M4)، ولم نتحقق من أرقام tok/s مستقلة لـ M6.
- M5 Pro (307 GB/s) ← نحو 45–55 tok/s (تقدير) على Llama 3.1 8B Q4 (ضعف M5 الأساسي بسبب ضعف عرض النطاق)
- M5 Max (614 GB/s) ← نحو 100–120 tok/s (تقدير) على Llama 3.1 8B Q4
- M5 Ultra (1.2 TB/s، مواصفات Apple) ← قاست BGR نحو 55 tok/s على Qwen 3.8 27B بدقة 4 بت مقابل نحو 40 على M3 Ultra (نحو 819 GB/s). أي نحو 1.4 ضعف سرعة التوليد مقابل نحو 1.5 ضعف عرض النطاق — وهذا متسق مع استدلال محدود بعرض النطاق.
- الدرس: في الاستدلال المحدود بعرض النطاق، يميل تضاعف عرض النطاق إلى رفع سرعة التوليد بشكل تناسبي تقريبًا (تقدير؛ وللبنية المعمارية أثر أيضًا). عند الشراء، رتّب عرض النطاق فوق عدد أنوية GPU.
كفاءة الطاقة والحرارة — الميزة الصامتة
التهيئة | الاستهلاك (خمول) | الاستهلاك (LLM) | الضوضاء | الحرارة |
|---|---|---|---|---|
| Mac Mini M6 | 5W | 25–35W | شبه صامت (5 dBA في الخمول) | دافئ |
| MacBook Air M5 | 3W | 20–30W | صامت (بلا مروحة) | دافئ |
| Mac Mini M5 Pro | 5W | 40–60W | صامت (المروحة نادرًا ما تنشط) | بارد |
| Mac Studio M5 Max | 10W | 60–100W | صامت | بارد |
| Mac Studio M5 Ultra | 10W | حتى 480W مستمرة (Apple) | صامت | بارد |
| RTX 4090 مكتبي | 50W | 350–450W | ضجيج مراوح مسموع تحت الحمل | ساخن |
| RTX 3060 مكتبي | 30W | 170–200W | متوسط | دافئ |
التكلفة السنوية التقديرية للكهرباء بسعر 0.15 دولار/kWh لخادم ذكاء اصطناعي على مدار الساعة (تقدير توضيحي دون قياس؛ التكلفة الفعلية تعتمد على نمط الاستخدام): Mac Mini M6 (نحو 35 دولارًا سنويًا) مقابل RTX 4090 المكتبي (نحو 400 دولار سنويًا). أرقام استهلاك الخمول وتحت الحمل هي تقديرات من PromptQuorum وليست قياسات أو مواصفات من Apple؛ وتذكر Apple حدًا أقصى للاستهلاك المستمر قدره 155W لـ Mac mini و480W لـ Mac Studio. قد تتفاوت الأسعار حسب بلدك.
سيناريوهات مستخدمين واقعية على Apple Silicon
- 1وكيل برمجة
Why it matters: يقدّم Llama 3.1 8B على M5 Pro سرعة 45–55 tok/s (تقدير)؛ يعتمد زمن إكمال الكود على حجم النموذج والإعدادات (لم تقِسه PromptQuorum). يعمل بصمت في الخلفية على MacBook Pro. - 2خط أنابيب RAG
Why it matters: نموذج تضمين + Llama 3.1 8B + ChromaDB يتسع كاملًا في 36GB من الذاكرة الموحدة لـ M5 Pro. دون قيود GPU. - 3مساعد صوتي
Why it matters: Whisper Metal + Ollama Llama + Piper TTS : يعتمد زمن الاستجابة على أحجام النماذج والإعدادات؛ لم تقِسه PromptQuorum على M5 Pro. Mac mini الهادئ مناسب للتهيئة دائمة التشغيل. - 4متعدد الوسائط
Why it matters: Whisper + LLaVA 7B رؤية + Llama 3.1 8B استدلال = الكل يتسع في 36GB، معالجة متزامنة. - 5كتابة خاصة
Why it matters: Llama 3.3 70B Q5 على M5 Max 128GB = جودة عالية للكتابة الطويلة، ويعمل دون اتصال بعد تنزيل النموذج، بلا تكاليف API لكل رمز، وتبقى الموجّهات على الجهاز أثناء الاستدلال. وعلى Mac Studio M5 Ultra الجديد (حتى 512GB)، تصبح نماذج 120B فأكثر ممكنة لمن يريد هامشًا أكبر.
أي جهاز Mac يجب أن تشتري لنماذج LLM المحلية؟
مصفوفة القرار: طابق حالة استخدامك مع تهيئة Mac الصحيحة، محدّثة بعد تحديث Mac mini وMac Studio في 25 أغسطس 2026. قد تتفاوت الأسعار حسب بلدك.
حاجتك | Mac لشرائه | الذاكرة | السعر التقريبي |
|---|---|---|---|
| تجربة نماذج LLM المحلية فقط | Mac Mini M6 | 16GB | 899 دولارًا |
| نماذج 7–13B يوميًا | Mac Mini M6 | 32GB | 899 دولارًا فأكثر (ترقية 32GB بتكلفة إضافية) |
| نماذج 13–32B، خادم صامت | Mac Mini M5 Pro | 64GB | 1,699 دولار |
| محطة عمل ذكاء اصطناعي محمولة | MacBook Pro M5 Pro | 48GB | 2,500 دولار |
| نماذج 70B، أقصى جودة | Mac Studio M5 Max | 128GB | 2,499 دولار |
| حزم متعددة النماذج (رؤية + LLM + TTS) | Mac Studio M5 Max | 128GB | 2,499 دولار |
| نماذج 120B فأكثر، أقصى ذاكرة | Mac Studio M5 Ultra | حتى 512GB | 5,499 دولار (96GB) إلى 22,299 دولارًا فأكثر (512GB) |
حاسم: الذاكرة ثابتة عند الشراء ولا يمكن ترقيتها، فاشترِ أكبر تهيئة تناسب ميزانيتك والنماذج التي تنوي تشغيلها. وخيار 512GB وحده في M5 Ultra يضيف 15,500 دولار (MacRumors). جميع الطرازات أعلاه متاحة للبيع منذ 22 سبتمبر 2026؛ وأصبحت تهيئة M5 Ultra بسعة 512GB قابلة للطلب منذ 28 أكتوبر 2026. الأسعار هي أسعار القائمة في الولايات المتحدة.
البدء: نظرة عامة على الأطر
ثلاثة أطر جاهزة للإنتاج تشغّل نماذج LLM على GPU Metal في Apple Silicon:
- Ollama: أبسط إعداد (تثبيت بنقرة واحدة)، اكتشاف تلقائي لـ Metal، دون تهيئة. يتضمن REST API. مثالي للمبتدئين.
- MLX: إطار Apple الأصلي، غالبًا أسرع من Ollama في اختبارات المجتمع، تكامل مع Python، دعم الضبط الدقيق LoRA. منحنى تعلّم أحدّ.
- llama.cpp: C++ متعدد المنصات، أكبر توافق لصيغ النماذج (GGUF)، خلفية Metal متاحة عبر علم تجميع. مثالي للتكامل في تطبيقات أكبر.
الأسئلة الشائعة
ماذا أعلنت Apple بشأن Mac mini وMac Studio في 25 أغسطس 2026؟
حدّثت Apple جهاز Mac mini بشريحة M6 الجديدة (899 دولارًا لسعة 16GB، قابلة للترقية إلى 32GB) وM5 Pro (1,699 دولارًا، حتى 64GB)، وحدّثت Mac Studio بـ M5 Max (2,499 دولارًا، حتى 128GB) وM5 Ultra (5,499 دولارًا بسعة 96GB، حتى 512GB). أصبحت جميعها متاحة للبيع منذ 22 سبتمبر 2026؛ وأصبحت تهيئة M5 Ultra بسعة 512GB قابلة للطلب منذ 28 أكتوبر 2026 بسعر يبدأ من 22,299 دولارًا.
هل M5 Pro أم M5 Max أفضل لنماذج LLM المحلية؟
M5 Pro (64GB) هو أفضل قيمة مقابل السعر — يشغّل نماذج 32B جيدًا ويبدأ سعره من 1,699 دولارًا. أما M5 Max (من 2,499 دولارًا) فضروري فقط إذا كنت تحتاج نماذج 70B أو حزمًا متعددة الوسائط بشكل متكرر. يقدّم M5 Pro (64GB) قيمة ممتازة لمعظم حالات الاستخدام من فئة 32B التي يغطيها هذا الدليل؛ ويستحق M5 Max إذا كنت تحتاج نماذج 70B بانتظام. قد تتفاوت الأسعار حسب بلدك.
هل يمكنني ترقية الذاكرة بعد شراء جهاز Mac؟
لا. ذاكرة Apple Silicon ملحومة وغير قابلة للترقية. اشترِ أقصى ذاكرة تستطيع تحمّل تكلفتها وقت الشراء.
كيف يُقارن M5 Pro بـ RTX 4090 لنماذج LLM؟
في النماذج التي تتسع في 24GB من VRAM، يكون RTX 4090 في الغالب أسرع؛ ويختلف الفارق حسب النموذج والتكميم ولم تقسه PromptQuorum. أما نموذج 70B فلا يتسع كاملًا في 24GB من RTX 4090 (يمكن تفريغ جزء منه إلى المعالج لكن ببطء شديد)، بينما يستطيع M5 Pro بسعة 64GB استيعابه بتكميم 4 بت. انظر Apple Silicon مقابل GPU من NVIDIA لنماذج LLM.
هل أحتاج Ollama أم MLX أم llama.cpp؟
ابدأ بـ Ollama (الأسهل). إذا احتجت استدلالًا أسرع أو ضبطًا دقيقًا، انتقل إلى MLX. وإذا احتجت توافقًا متعدد المنصات، استخدم llama.cpp. الثلاثة يعملون على Apple Silicon.
هل يغيّر M5 Ultra بذاكرة حتى 512GB أي شيء؟
نعم. يشغّل M5 Ultra (Mac Studio، من 5,499 دولارًا بسعة 96GB، وعرض نطاق 1.2 TB/s، حتى 512GB من 22,299 دولارًا) نماذج 70B بـ FP16 (دون تكميم ودون فقدان ناتج عن التكميم) ويتيح نماذج 120B فأكثر على جهاز Mac استهلاكي واحد (إعداد 512GB). وقد قاس أول اختبار مستقل تحققنا منه (BGR، 21 سبتمبر 2026، طراز 256GB) نحو 55 tok/s على Qwen 3.8 27B بدقة 4 بت مقابل نحو 40 على M3 Ultra. لم تُجرِ PromptQuorum اختبارات M5 Ultra خاصة بها.
هل يستحق Apple Silicon العناء لنماذج LLM المحلية في 2026؟
نعم، خاصةً لنماذج 32B فأكثر. Apple Silicon من القلائل بين عتاد المستهلك الذي يشغّل نماذج 70B دون تهيئات تعدد كروت رسوميات معقّدة، وMac Studio M5 Ultra الجديد من القلائل القادرة على استيعاب نماذج 120B فأكثر. أما لنماذج 8B التي تتسع في VRAM الخاصة بـ NVIDIA، فيكون RTX 4090 أسرع لكنه أغلى في التشغيل. يقدّم Mac mini M5 Pro (من 1,699 دولارًا، حتى 64GB) قيمة ممتازة لمعظم حالات الاستخدام من فئة 32B التي يغطيها هذا الدليل؛ ويستحق M5 Max إذا كنت تحتاج نماذج 70B بانتظام.
هل يستطيع MacBook Air M5 تشغيل نماذج LLM المحلية؟
نعم، مع قيود. يشغّل MacBook Air M5 نماذج 7–8B بسعة 16GB (يتبقى نحو 8GB بعد macOS) ونماذج حتى 13B بسعة 24–32GB. قد يحدث خنق حراري في التصميم بلا مروحة عند الحمل المستمر. للاستخدام العرضي: مثالي. أما للاستدلال دائم التشغيل: فإن Mac Mini M5 Pro أنسب.
ما أداء Apple M6 مع نماذج LLM المحلية؟
لم تنشر Apple سوى ادعاءات نسبية: أداء ذكاء اصطناعي أسرع حتى 4 أضعاف ومعالج أسرع بنسبة 40% مقارنةً بـ Mac mini M4. وفي تحديث أغسطس 2026 ظهرت M6 لأول مرة في Mac mini فقط (899 دولارًا لسعة 16GB، حتى 32GB، وبعرض نطاق حتى 170 GB/s). ولأن سرعة التوليد تتبع عرض نطاق الذاكرة، يُتوقع أن تقترب من M5 الأساسي لا من M5 Pro؛ ولم نتحقق بعد من أرقام tok/s مستقلة لـ M6.
ما أفضل تهيئة LLM محلية لجهاز Mac M1 بذاكرة 32GB؟
يشغّل M1 Pro أو M1 Max بذاكرة 32GB (بعرض نطاق 200 GB/s و400 GB/s) نماذج 13B بدقة Q4 بأريحية، وهي النقطة المثلى في جدول الشرائح أعلاه؛ ويصل M1 Max بذاكرة 64GB إلى نماذج 32B بدقة Q4. أما M1 الأساسي فيتوقف عند 16GB، لذا ابقَ عند 7B Q4.
كيف يُقارن M3 Ultra بـ M5 Max لنماذج LLM المحلية؟
يتفوق M3 Ultra على M5 Max في سعة الذاكرة (حتى 512GB مقابل 128GB)، وهو ما يتيح له استيعاب أكبر النماذج. أما في السرعة، فقد ذكرت BGR أن MacBook Pro بشريحة M5 Max أدى أداءً مماثلًا تقريبًا لـ Mac Studio بشريحة M3 Ultra في اختبار نموذج 27B، وأن M5 Ultra أفضل من M3 Ultra بنحو 30–40% في المتوسط. ويقع M5 Pro بسعة 48GB دونهما، وهو النقطة المثلى لمن يريد هامشًا إضافيًا دون أسعار Ultra.
منهجية الاختبارات المرجعية والوقت المرجعي
- بيانات M5 Pro/Max لتهيئات MacBook Pro مبنية على اختبارات مجتمعية مرجعية من مارس–مايو 2026
- M5 Ultra: توجد نتائج مستقلة (BGR، 21 سبتمبر 2026، طراز 256GB — راجع قسم تحديث أغسطس 2026). أرقام tok/s لشريحة M6 ولتهيئات M5 Pro/M5 Max في Mac mini/Mac Studio هي تقديرات مبنية على عرض النطاق أو نتائج مجتمعية؛ وادعاءات الأداء الصادرة عن Apple موسومة على هذا الأساس.
- آخر تحقق: 2026-11-02
- يتحسّن الأداء مع تحديثات الأطر (Ollama وMLX وllama.cpp تطلق إصدارات شهرية)
- تتم مراجعة هذا المقال كل ثلاثة أشهر، وسيضيف نتائج مستقلة لشريحة M6 ولـ Mac Studio M5 Max فور تحققنا منها