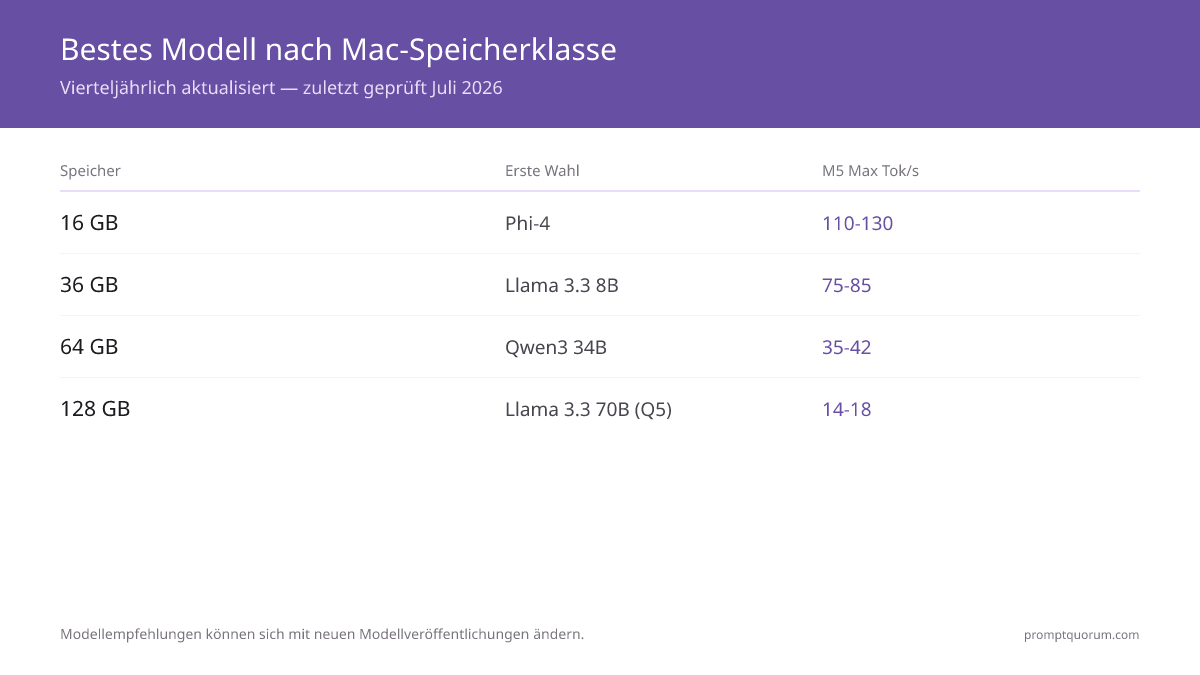
Beste Modellempfehlungen nach Mac-Speicher
Zuletzt verifiziert: 2026-08-27. Apples Refresh vom 25. August 2026: Der Mac mini ist jetzt in den Konfigurationen M6 (max. 32 GB, ab 899 $) und M5 Pro (max. 64 GB, ab 1.699 $) erhältlich; der Mac Studio in M5 Max (max. 128 GB, ab 2.499 $) und M5 Ultra (bis zu 512 GB, ab 5.499 $). Alle Modelle werden ab dem 22. September 2026 ausgeliefert (die 512-GB-Konfiguration erst Ende Oktober 2026). Modellempfehlungen können sich mit neuen Releases ändern. Wir aktualisieren diese Seite vierteljährlich.
Speicher | Primäre Wahl | Quantisierung | Größe | M5 Pro tok/s | M5 Max tok/s | Alternative |
|---|---|---|---|---|---|---|
| 16 GB | Phi-4 | Q4_K_M | 2,5 GB | 60–70 | 110–130 | Llama 3.1 8B Q4 (knapp) |
| 36 GB | Llama 3.1 8B | Q8 | 8,5 GB | 38–45 | 75–85 | Qwen3 14B Q4 (8,5 GB) |
| 48 GB | Qwen3 14B | Q8 | 16 GB | 25–30 | 50–60 | Mixtral 8x7B Q4 (26 GB) |
| 64 GB | Qwen3 32B | Q5 | 24 GB | 18–22 | 35–42 | Mixtral 8x7B Q5 (33 GB) |
| 96 GB | Llama 3.3 70B | Q4 | 42 GB | 10–13 | 20–25 | — |
| 128 GB | Llama 3.3 70B | Q5 | 49 GB | 8–11 | 14–18 | — |
| 128 GB | Llama 3.3 70B | Q8 | 74 GB | N/A | 9–12 | Beste Qualität, nur M5 Max |
Größen im GGUF-Format. MLX 4-Bit-Äquivalente sind vergleichbar. Die 36-GB-Stufe entspricht den Basiskonfigurationen des MacBook Pro mit M-Pro/M-Max und nicht dem Mac mini oder Mac Studio — seit dem Refresh im August 2026 springen Mac mini und Mac Studio direkt von 32 GB auf 64 GB. Die tok/s-Werte sind Schätzungen; PromptQuorum hat sie nicht eigenständig gemessen.

Modell-Qualitätsbenchmarks (Standardtests 2026)
Modell | MMLU | HumanEval | GSM8K | Durchschn. | Hinweise |
|---|---|---|---|---|---|
| Llama 3.1 8B | 73,0 | 72,6 | 84,5 | 76,7 | Solides Allround-Modell |
| Qwen3 14B | 79,7 | 83,5 | 90,2 | 84,5 | Starkes Reasoning |
| Qwen3 32B | 83,3 | 88,4 | 93,0 | 88,2 | Bestes mittelgroßes Modell |
| Mixtral 8x7B | 70,6 | 40,2 | 60,4 | 57,1 | MoE-Architektur |
| Llama 3.3 70B | 86,0 | 80,5 | 95,1 | 87,2 | Bestes allgemeines Modell |
Richtwerte; prüfen Sie die jeweilige Modellkarte. PromptQuorum hat diese Benchmarks nicht eigenständig durchgeführt.

Beste Modelle nach Anwendungsfall (2026)
Anwendungsfall | Bestes für 36-GB-Mac | Bestes für 64-GB-Mac | Bestes für 128-GB-Mac |
|---|---|---|---|
| Programmierung (allgemein) | Llama 3.1 8B | DeepSeek Coder V2 16B | Llama 3.3 70B |
| Programmierung (Python) | DeepSeek Coder V2 Lite | DeepSeek Coder V2 16B | DeepSeek Coder V2 236B |
| Langtexte verfassen | Llama 3.1 8B Q8 | Qwen3 32B Q5 | Llama 3.3 70B Q5 |
| Chat / Konversation | Mistral Small | Mixtral 8x7B | Llama 3.3 70B |
| Reasoning / Mathematik | Qwen3 14B | Qwen3 32B | Qwen3 32B |
| RAG / Frage & Antwort | Llama 3.1 8B + nomic-embed | Llama 3.1 8B + bge-large | Llama 3.3 70B + bge-large |
| Vision / Multimodal | LLaVA 7B | Llama 3.2 Vision 11B | Llama 3.2 Vision 90B |
| Übersetzung | Qwen3 14B | Qwen3 32B | Aya Expanse 32B |
| Zusammenfassung | Llama 3.1 8B | Qwen3 32B | Llama 3.3 70B |
| Code-Review | DeepSeek Coder V2 Lite | DeepSeek Coder V2 16B | Llama 3.3 70B |
Spezialisierte Modelle übertreffen allgemeine Modelle oft bei spezifischen Aufgaben.
Praxisszenarien nach Nutzertyp
💡Tipp: Indie-Entwickler (Mac Mini M5 Pro 64 GB, ca. 1.650 €) - Programmierung: DeepSeek Coder V2 Lite (16B Q4, 10 GB) - Texte: Llama 3.1 8B Q8 (8,5 GB) für Dokumentation und E-Mails - Permanent aktiv: beide Modelle warm mit `OLLAMA_MAX_LOADED_MODELS=2` - Tageskosten: 0 € (vs. 28–90 €/Monat für Copilot + ChatGPT)
💡Tipp: Datenschutzbewusster Profi (MacBook Pro M5 Pro 48 GB, ca. 2.400 €) - Hauptmodell: Llama 3.1 8B Q8 für allgemeine Arbeit - Sensibel: Qwen3 14B Q5 für rechtliche/medizinische/finanzielle Dokumente - Reisen: funktioniert offline im Flugzeug, in sicheren Einrichtungen - Die Inferenz läuft lokal; die App kann dennoch nach Updates suchen, sofern nicht anders konfiguriert - Allgemeine Informationen, keine Rechts-, Medizin- oder Finanzberatung; die Entscheidung trifft eine qualifizierte Person
💡Tipp: Forscher / ML-Ingenieur (Mac Studio M5 Max 128 GB, ca. 2.400 €) - Primär: Llama 3.3 70B Q5 (49 GB) für Qualität - Spezialisiert: Qwen3 32B Q4 für nicht-englische Forschung - Programmierung: DeepSeek Coder V2 16B - Vision: Llama 3.2 Vision 11B für Papierfiguren - Alle vier Modelle gleichzeitig geladen
💡Tipp: Familien-KI-Server (Mac Mini M5 Pro 64 GB, dauerhaft aktiv) - Sprachassistent: Llama 3.1 8B + Whisper + Piper - RAG: Familiendokument-Frage & Antwort mit Embeddings - Programmierhilfe für Familienmitglieder via REST API - Stromkosten: ca. 30 €/Jahr - Ersetzt: ChatGPT Plus für 4 Personen = ca. 900 €/Jahr
Zu vermeidende Modelle in 2026 (und warum)
⚠️Warnung: Llama 2 (jede Größe) nicht mehr empfohlen — von Llama 3.3 abgelöst; Standard-Leaderboards zeigen deutlich schwächere Ergebnisse gegenüber neueren Releases. Taucht noch in älteren Tutorials auf — diesen nicht folgen. Ersetzen durch: Llama 3.1 8B.
⚠️Warnung: Vicuna, Alpaca, WizardLM vermeiden — Community-Feinabstimmungen aus 2023. Moderne Basismodelle (Llama 3.3, Qwen3) entsprechen oder übertreffen ihre Leistung. Ersetzen durch: Qwen3 14B oder Llama 3.1 8B.
⚠️Warnung: Falcon 180B vermeiden — Passt nicht auf Consumer-Apple-Silicon. Llama 3.3 70B (kleiner) übertrifft es. Ersetzen durch: Llama 3.3 70B Q5.
⚠️Warnung: FP16-Quantisierung auf Consumer-Hardware vermeiden — Llama 3.3 70B FP16 = 140 GB, passt auf keinen Mac. Qualitätsgewinn gegenüber Q5 ist unter 1%. Ersetzen durch: Q4_K_M oder Q5_K_M.
⚠️Warnung: Reine Basismodelle vermeiden (keine Instruct-Variante) — Basismodelle ergänzen Text, folgen aber keine Anweisungen. Auf "-instruct" oder "-chat"-Suffix achten. Ersetzen durch: die Instruct-Variante desselben Modells.
⚠️Warnung: Bei Modellen mit geringer Entwicklungsaktivität Vorsicht walten lassen — StableLM, RedPajama, MPT, Pythia: mit geringer neuerer Entwicklungsaktivität (Stand Mitte 2026). Modelle von Meta, Alibaba, Mistral, Microsoft mit regelmäßigen Updates verwenden.
Modellformat-Kurzreferenz
Format | Verwendet von | Größe vs. Original |
|---|---|---|
| GGUF Q4_K_M | Ollama, llama.cpp | ~30% von FP16 |
| GGUF Q5_K_M | Ollama, llama.cpp | ~35% von FP16 |
| GGUF Q8_0 | Ollama, llama.cpp | ~50% von FP16 |
| MLX 4-bit | MLX Framework | ~30% von FP16 |
| MLX 8-bit | MLX Framework | ~50% von FP16 |
| FP16 (Original) | Alle Frameworks | 100% |
Größen in diesem Artikel sind GGUF Q4_K_M, sofern nicht anders angegeben. MLX 4-Bit-Äquivalente sind ähnlich groß. Für genaue Bytes die Modellkarte auf HuggingFace prüfen. llama.cpp führt GGUF direkt über das Metal-Backend aus und ist die Grundlage, auf der Ollama intern aufbaut — MLX ist Apples eigenes Framework und ist bei MLX-nativen Builds auf demselben Chip tendenziell schneller. LM Studio unterstützt sowohl GGUF als auch MLX und erlaubt es, das Backend pro Modell direkt in der Benutzeroberfläche zu wechseln.
Kurzreferenz: Diese Modelle herunterladen
# 16 GB Mac
ollama pull phi4

# 36 GB Mac (eines wählen)
ollama pull llama3.1:8b
ollama pull qwen3:14b
ollama pull mistral-small

# 64 GB Mac
ollama pull qwen3:32b
ollama pull mixtral:8x7b

# 128 GB Mac
ollama pull llama3.3:70b

# Spezialmodelle
ollama pull deepseek-coder-v2:16b   # Programmierung
ollama pull llama3.2-vision:11b     # Vision
ollama pull aya-expanse:32b # ÜbersetzungKann ich zwei verschiedene Modelle gleichzeitig ausführen?
Ja, `OLLAMA_MAX_LOADED_MODELS=2` in der Umgebungsvariablen setzen. 64 GB kann 8B + 32B gleichzeitig ausführen.
Welches Modell eignet sich am besten für Anfänger?
Llama 3.1 8B. Weit verbreitet, gute Ausgabequalität, bewährte Erfolgsbilanz. Läuft auf jedem M1+ Mac.
Ist Mixtral 8x7B schneller als Llama 8B?
Wahrscheinlich nicht: Mixtral 8x7B ist deutlich größer (etwa 26 GB bei Q4 gegenüber 8,5 GB bei Llama 3.1 8B Q8), daher sind weniger tok/s zu erwarten als bei den Llama-3.1-8B-Q8-Werten in der obigen Tabelle (Schätzungen für M5 Pro; von PromptQuorum nicht eigenständig gemessen). Welches Modell besser ist, hängt von der Aufgabe ab.
Was ist das beste lokale LLM im Jahr 2026?
Für die meisten Benutzer auf Apple Silicon: Qwen3 (jede Größe, die auf Ihren Mac passt) ist eine starke Wahl, und Llama 3.3 70B ist eine weitere starke Option für 128-GB-Macs. Unter 16 GB: Phi-4 ist eine leistungsfähige kleine Option.
Kann ich Llama 3.1 405B auf einem Mac ausführen?
Nur mit sehr viel vereinigtem Speicher. Llama 3.1 405B benötigt selbst bei Q4-Quantisierung über 200 GB. Frühere Mac-Studio-Konfigurationen mit 512 GB können 405B ebenfalls in Q4 aufnehmen; Apples Mac Studio M5 Ultra, angekündigt am 25. August 2026 (Auslieferung ab 22. September 2026; die 512-GB-Konfiguration erst Ende Oktober 2026), bietet bis zu 512 GB vereinigten Speicher ab 5.499 $ und zusätzlichen Spielraum bei der Bandbreite.
Ist Qwen besser als Llama für den lokalen Einsatz?
Die Ergebnisse hängen von Aufgabe und Modellgröße ab; vergleichen Sie die Modellkarten für Ihren Anwendungsfall. Llama hat eine breitere Community und mehr Feinabstimmungen. Die meisten Benutzer werden den Unterschied nicht bemerken — die Wahl nach Verfügbarkeit und Feinabstimmungs-Ökosystem treffen.
Was ist das kleinste Modell, das wirklich nützlich ist?
Phi-4 Mini mit 3,8B Parametern. Für Chat und Fragen & Antworten ist es für seine Größe leistungsfähig. Für Programmierung oder komplexes Reasoning zu Llama 3.1 8B oder Qwen3 14B wechseln.
Muss ich bei der Nutzung lokaler Modelle die DSGVO beachten?
Wenn Daten ausschließlich lokal verarbeitet werden und keine Modelle über Cloud-APIs aufgerufen werden, findet keine Datenübertragung an Dritte statt. Lokale KI-Modelle verarbeiten Eingaben auf dem eigenen Gerät — das entspricht dem Prinzip der Datenminimierung gemäß DSGVO Art. 5. Im Unternehmenskontext empfiehlt sich dennoch eine Dokumentation des Verarbeitungsverzeichnisses nach Art. 30 DSGVO.
Eignen sich lokale Modelle für den Mittelstand?
Ja. Mit einem Mac Mini M5 Pro (64 GB, ca. 1.650 €) lassen sich mehrere 8B- bis 32B-Modelle dauerhaft betreiben. Im Vergleich zu Cloud-APIs (GPT-4: ca. 50–200 €/Monat pro Nutzer) amortisiert sich die Hardware innerhalb von 6–18 Monaten. Besonders für DSGVO-konforme Verarbeitung vertraulicher Dokumente (z. B. Verträge, Kundenanfragen) ist die lokale Option attraktiv.
Läuft vLLM auf Apple Silicon?
Die Metal-Unterstützung von vLLM ist im Vergleich zum CUDA-Pfad eingeschränkt — die Durchsatz- und Batching-Optimierungen, die vLLM auf Nvidia-GPUs attraktiv machen, greifen auf dem Mac größtenteils nicht. Für Apple Silicon liefern Ollama (llama.cpp/Metal) oder LM Studio (GGUF/MLX) bessere Einzelnutzer-tok/s und eine einfachere Einrichtung. vLLM lohnt sich nur, wenn viele gleichzeitige Anfragen von einer Linux/Nvidia-Maschine neben dem Mac bedient werden.
Was schafft ein MacBook Air M5?
Das MacBook Air M5 hat ein lüfterloses Design und in der Regel 16–32 GB vereinigten Speicher — es entspricht also der 16-GB- oder 36-GB-Stufe aus der obigen Tabelle: Phi-4 problemlos, Llama 3.1 8B Q8 ab 24 GB aufwärts. Bei anhaltend langen Generierungen kann es ohne Lüfter leicht drosseln — im unteren Bereich der M5-Pro-tok/s-Werte aus diesem Artikel bleiben.
Was ist das beste Setup für ein MacBook Pro M5 Max mit 128 GB RAM?
Llama 3.3 70B Q5 (49 GB) für den täglichen Einsatz, mit genug Spielraum, um gleichzeitig ein zweites Modell — Qwen3 14B Q5 oder DeepSeek Coder V2 16B — über `OLLAMA_MAX_LOADED_MODELS=2` geladen zu halten. Zu erwarten sind ca. 14–18 tok/s bei 70B Q5. Wer maximale Qualität möchte und ~9–12 tok/s toleriert, kann auch Llama 3.3 70B Q8 (74 GB) nutzen — das passt ebenfalls.