TL;DR
- 16GB:7Bモデルのみ(ギリギリ)
- 36GB:13Bは余裕、32B Q4はギリギリ
- 64GB:32B Q5は余裕
- 128GB:70B Q5は余裕
- 購入後のアップグレード不可——購入時に最大限を選択
LLMにおけるユニファイドメモリの仕組み
ユニファイドメモリはCPUとGPUで共有され、すべてモデルとmacOSで共有されます。ディスクリートGPU(RTX 4070は12GB VRAM + 32GB RAM別々)とは異なり、Apple Siliconは1つのプールを共有します。64GB Mac = 合計64GB。macOSとアプリ用に最低8GBを見込む必要があり、LLMに使えるのは約56GBです。
ユニファイドメモリはVRAMと同じか?
はい——Apple Siliconでは、ユニファイドメモリは事実上GPUのVRAMです。ディスクリートGPUのような固定・独立したVRAMプールは存在しません。MシリーズチップのCPU、GPU、Neural Engineは同じ物理メモリを読み書きするため、ユニファイドメモリプールのほぼ全体——一部だけでなく——がLLM実行時にGPUで利用可能です(macOS用に最低8GBを確保した後)。macOSは既定でGPUメモリの上限(搭載メモリの約3分の2〜4分の3、容量により異なり、引き上げ可能)も適用するため、合計から8GBを引いた値は上限であり保証ではありません。
- ディスクリートGPU(RTX 4070):PCが64GBの独立したシステムRAMを持っていても、12GBのVRAMがモデル重みの固定上限になる。
- Apple Silicon:GPUはmacOS用の最低8GBを除くユニファイドメモリプール全体にアクセス可能——64GB Macなら固定の12〜24GB VRAM枠ではなく、GPUに~56GBを与える。
- 64GB Macが32Bモデルを余裕で実行できるのに対し、12GB GPUを積んだ64GB PCではできないのはこのため——PCのGPUアクセス可能メモリは総RAMではなくVRAMに上限がある。
- 「共有メモリ」と「ユニファイドメモリ」は同じアーキテクチャを指す:手動のVRAM割り当て不要で、CPUとGPU双方がアドレス指定できる単一プール。
マスターテーブル:メモリ層対モデルサイズ
Model | Parameters | Q3_K | Q4_K_M | Q5_K_M | Q8 | FP16 |
|---|---|---|---|---|---|---|
| Phi-4 Mini | 3.8B | 2.1 GB | 2.5 GB | 2.9 GB | 4.0 GB | 7.6 GB |
| Mistral 7B | 7B | 3.8 GB | 4.5 GB | 5.2 GB | 7.5 GB | 14 GB |
| Llama 3.1 8B | 8B | 4.2 GB | 5.0 GB | 5.8 GB | 8.5 GB | 16 GB |
| Gemma 3 12B | 12B | 6.5 GB | 7.8 GB | 9.0 GB | 12.9 GB | 24 GB |
| Qwen3 32B | 32B | 16 GB | 20 GB | 23 GB | 35 GB | 66 GB |
| Llama 3.3 70B | 70B | 36 GB | 42 GB | 49 GB | 74 GB | 140 GB |
| Llama 3.1 405B | 405B | 200+ GB | 240 GB | 280 GB | 410 GB | 810 GB |
MacでのFit計算時には、必ずmacOS用に最低8GBを差し引いてください。
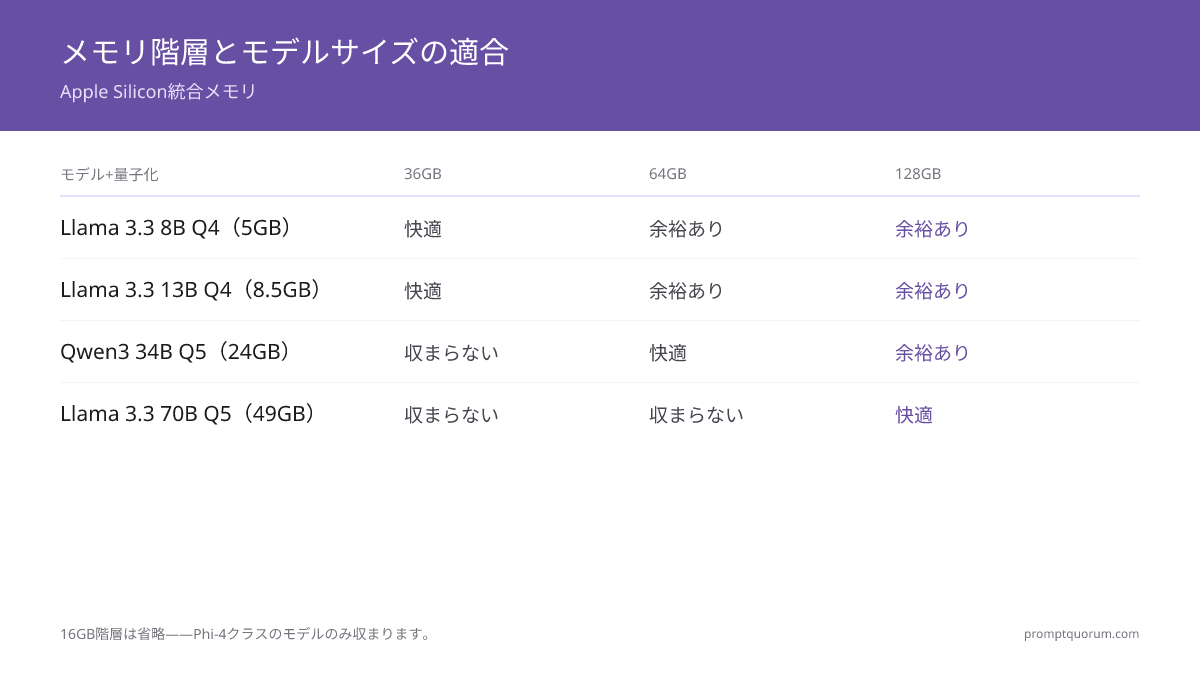
収まる/収まらないマトリクス
モデル + 量子化 | 16GB | 36GB | 64GB | 128GB |
|---|---|---|---|---|
| Phi-4 Mini Q4 (2.5 GB) | ✓ 余裕 | ✓ 余裕 | ✓ 余裕 | ✓ 余裕 |
| Llama 3.1 8B Q4 (5 GB) | ⚠️ ギリギリ | ✓ 余裕あり | ✓ 余裕 | ✓ 余裕 |
| Llama 3.1 8B Q8 (8.5 GB) | ✗ 収まらない | ✓ 余裕あり | ✓ 余裕 | ✓ 余裕 |
| Gemma 3 12B Q4 (7.8 GB) | ✗ 収まらない | ✓ 余裕あり | ✓ 余裕 | ✓ 余裕 |
| Qwen3 32B Q4 (20 GB) | ✗ 収まらない | ⚠️ ギリギリ | ✓ 余裕あり | ✓ 余裕 |
| Qwen3 32B Q5 (23 GB) | ✗ 収まらない | ✗ 収まらない | ✓ 余裕あり | ✓ 余裕 |
| Llama 3.3 70B Q3 (36 GB) | ✗ 収まらない | ✗ 収まらない | ⚠️ ギリギリ | ✓ 余裕あり |
| Llama 3.3 70B Q4 (42 GB) | ✗ 収まらない | ✗ 収まらない | ⚠️ 非常にギリギリ | ✓ 余裕あり |
| Llama 3.3 70B Q5 (49 GB) | ✗ 収まらない | ✗ 収まらない | ✗ 収まらない | ✓ 余裕あり |
| Llama 3.3 70B Q8 (74 GB) | ✗ 収まらない | ✗ 収まらない | ✗ 収まらない | ✓ 収まる |
✓ 余裕 = 4GB以上空き | ✓ 余裕あり = 2〜4GB空き | ⚠️ ギリギリ = 2GB未満空き | ✗ 収まらない = スワップまたはクラッシュ

各メモリ層に収まるもの(実際)
- 116 GB(M5 base、MacBook Air)
Why it matters: Llama 3.1 8B Q4は収まる(5GBモデル + 8GB OS = 13GB)✓ だがギリギリ。Llama 8B Q8はスワップなしでは収まらない。Whisper smallは並行して収まる。 - 236 GB(M5 Pro ベース)
Why it matters: Llama 3.1 8B Q8は余裕で収まる。13Bクラスのモデルは収まる。Qwen3 32B Q4はギリギリ(20GB + 8GB OS = 28GB)。マルチモデル:Whisper + LLaVA + TTSが収まる ✓ - 364 GB(M5 Pro max)
Why it matters: Qwen3 32B Q5は余裕で収まる(23GB)。Llama 70B Q3はかろうじて収まる。マルチモデルスタックには十分な余裕がある。 - 4128 GB(M5 Max)
Why it matters: 128GBに最適なモデル:Llama 3.3 70B Q5(49GB)——余裕をもって収まる最大級のモデル。70B Q8も収まり(74GB)ほぼ無損失の品質。マルチモーダル:Whisper + 90Bビジョンモデル + 8B LLMが同時に収まる ✓
マルチモデルスタックのメモリ要件
スタックのユースケース | 必要なメモリ |
|---|---|
| LLMのみ(Llama 8B Q4) | 5 GB + OS = 13 GB |
| LLM + STT(Llama 8B + Whisper large-v3) | 8 GB + OS = 16 GB |
| LLM + STT + TTS(音声アシスタント) | 9 GB + OS = 17 GB |
| LLM + Vision(Llama 8B + LLaVA 7B) | 11 GB + OS = 19 GB |
| フルマルチモーダル(LLM + Vision + STT + TTS) | 14 GB + OS = 22 GB |
| LLM + RAG(Llama 8B + 埋め込み + ChromaDB) | 8 GB + OS = 16 GB |
| ヘビーマルチモーダル(Llama 70B Q4 + Vision 90B) | 100 GB以上 |
22GBを超えるスタックは最低36GBのMacが必要。50GBを超えるスタックは最低64GBが必要。ヘビーマルチモーダルスタックは128GB M5 Maxのみで動作。
コンテキストウィンドウが追加のメモリオーバーヘッドを生成する
KVキャッシュはコンテキスト長に比例してスケールします——コンテキストウィンドウが長いほど、モデルがランタイムで使用するメモリが増えます。これはギリギリの設定をスワップに押し込む可能性がある一般的な落とし穴です。
- Llama 3.1 8B(8Kコンテキスト時):+0.5 GB
- Llama 3.1 8B(32Kコンテキスト時):+2 GB
- Llama 3.1 8B(128Kコンテキスト時):+8 GB
- Llama 3.3 70B(32Kコンテキスト時):+6 GB
- Llama 3.3 70B(128Kコンテキスト時):+24 GB
最大メモリを購入すべき理由
- Apple Siliconメモリは購入後にアップグレードできない。
- モデルサイズは成長中:今日8B → 2027年には13〜32Bがスイートスポット。
- 16GBはLLMには既に不十分——最低36GB推奨。
- 価格差:36GBから64GBへのアップグレードは購入時に追加費用がかかります(最新価格はAppleのコンフィギュレーターで確認してください)が、モデルが36GBを超えた場合に2年後の新しいMac購入を節約できる可能性があります。
- M5 Pro 36GBと64GBの比較——最新価格はAppleのコンフィギュレーターで確認してください。後からMac全体を買い替えると、購入時に大きいメモリ階層を選ぶより通常は高くつきます。
- 36GB以上のユニファイドメモリを手頃に手に入れる方法:36GB構成のM5 Pro Mac miniは13Bモデルを余裕で実行できるメモリを備えています(価格と構成はAppleの最新コンフィギュレーターで確認してください)。
- Appleは2026年8月25日にMac miniとMac Studioのラインアップを刷新し、本ガイドの128GBという上限を超える階層を追加した:Mac mini M6(最大32GB、約112,000円)、Mac mini M5 Pro(最大64GB、約212,000円)、Mac Studio M5 Max(最大128GB、約312,000円)、Mac Studio M5 Ultra(256GBまたは512GB、約687,000円から)。512GB構成は2026年10月下旬に発売予定で、価格は150万円を大きく超える。本ガイドが対象とするモデルサイズ(70Bまで)では、64〜128GBが依然として実用的な範囲であり、256GB以上は70Bを超えるモデルや複数の大規模モデルを同時に運用する場合にのみ意味を持つ。

量子化が品質に与える影響
Q4_K_M(4ビット):品質の低下は通常小さく、モデルやタスクによって異なります。一般的なデフォルト。
Q5_K_M(5ビット):品質の低下は通常Q4より小さく、モデルやタスクによって異なります。余裕がある場合は推奨。
Q8(8ビット):品質の低下は通常非常に小さく、モデルやタスクによって異なります。
Q3_K(3ビット):品質の低下は通常より大きく、モデルやタスクによって異なります。複雑な推論では目立つことがあります。スペース制約のあるシナリオのみ許容。
36GBと64GBどちらを選ぶべきですか?
予算が許す場合は64GBを選択(価格差はAppleの最新コンフィギュレーターで確認してください)。36GBは今日機能しますが、モデルが成長するにつれ12ヶ月後にはギリギリになる可能性があります。モデルサイズがこれまで通り大きくなり続けるなら、64GBは本ガイドのモデルサイズを今後1〜2年はカバーできるはずです。
メモリは後でアップグレードできますか?
できません。Apple Siliconメモリははんだ付けされており、アップグレード不可です。購入時に最大限を選択してください。
なぜ16GBでは不十分なのですか?
合計16GB − macOS用に最低8GB = モデルに使えるのは約8GB。Llama 8B Q4は5GBを必要とし、Whisperやタスクのためのスペースがありません。不十分です。
本当に128GBが必要ですか?
定期的に70Bモデルを実行するか、同時にVision + LLM + STTが必要な場合のみ。それ以外は64GBで十分です。
48GBはローカルLLMに十分ですか?
はい——48GB(M4 ProおよびM5 Pro一部設定で利用可能)は快適な中間点です。全32Bモデル、限界での70B Q3、フルマルチモーダルスタックを実行できます。36GBより優れており、64GBが手頃なら将来性の価値があります。
Llama 3.3 70Bをローカルで実行するには?
最低48GB(Q3量子化、品質損失が顕著)。推奨64GB(Q4量子化、ギリギリ)。快適な選択128GB(Q5/Q8量子化、高品質)。64GBレベルは慎重なメモリ管理が必要;128GBは70Bに対して唯一の心配のない選択肢。
2026年のローカルAIに128GBは必要ですか?
定期的に70Bモデルを実行するか、Vision + LLM + STTスタックを同時に使用する場合のみ。日常のLLM使用(8B〜32Bモデル、RAG、コーディング支援)にはM5 Pro 64GBがスイートスポット。特に70Bが必要でない限り、128GBは2〜3倍のコスト増です。
Apple Siliconのユニファイドメモリは VRAM と同じですか?
はい。固定・独立したVRAMを持つディスクリートGPU(例:RTX 4070の12GB)と異なり、Apple SiliconのGPUはCPUと同じ物理メモリを読み書きします。GPUはMacのユニファイドメモリのほぼ全体にアクセス可能——64GB MacならmacOS用の8GBを確保した後、GPUに~56GBを与えます。固定のVRAM枠ではありません。
128GBのユニファイドメモリに収まる最大のLLMは?
Q5_K_M量子化のLlama 3.3 70B(49GB)が余裕で収まる最大級のモデルで、コンテキストとオーバーヘッド用に~70GBが残ります。Q8(74GB)でもmacOS分の余裕を残して収まります。405BモデルはQ4でも240GB以上必要——128GBのMacのユニファイドメモリを超えるため、128GBのMacでは70Bが実用上の上限です。
メモリとは別に、ローカルLLMにはどれだけのストレージが必要ですか?
メモリ(RAM)とディスクストレージは別物です:メモリは実行中のモデルを保持し、ストレージはダウンロードしたモデルファイルを永続的に保持します。Q4の8Bモデルはメモリ・ディスクとも約5GB必要です。70B Q5モデルは約49GBのメモリと約49GBのディスク——同じファイル——が必要です。複数のモデル(例:8B、32B、70B、ビジョンモデル)をローカルで実行するには、Macのメモリ層に関係なく100〜150GBの空きディスク容量が必要です。
Macで128GBを超えるユニファイドメモリを搭載できますか?
はい。2026年8月25日の刷新でMac Studio M5 Ultraが追加され、256GBと512GBのユニファイドメモリ構成が約687,000円から利用可能になりました。512GB構成は2026年10月下旬に発売され、価格は150万円を大きく超えます。これは70Bクラスのモデルの実行に必要な水準をはるかに超えており、本ガイドの16GB〜128GBの階層でほとんどのローカルLLM用途の実用範囲をカバーしています。256GB以上が意味を持つのは、70Bを超えるモデルを実行する場合や複数の大規模モデルを同時に運用する場合のみです。M5 Ultraについてはまだ独立したベンチマークが存在しません。
ローカルLLMは日本のAIガバナンスガイドラインに準拠していますか?
はい。データがデバイス上でローカルに処理され外部サーバーに送信されないため、個人情報保護法の第三者提供規制を完全に満たします。経済産業省(METI)のAIガバナンスガイドラインでも、機密データを扱う企業にはローカル処理が推奨されています。