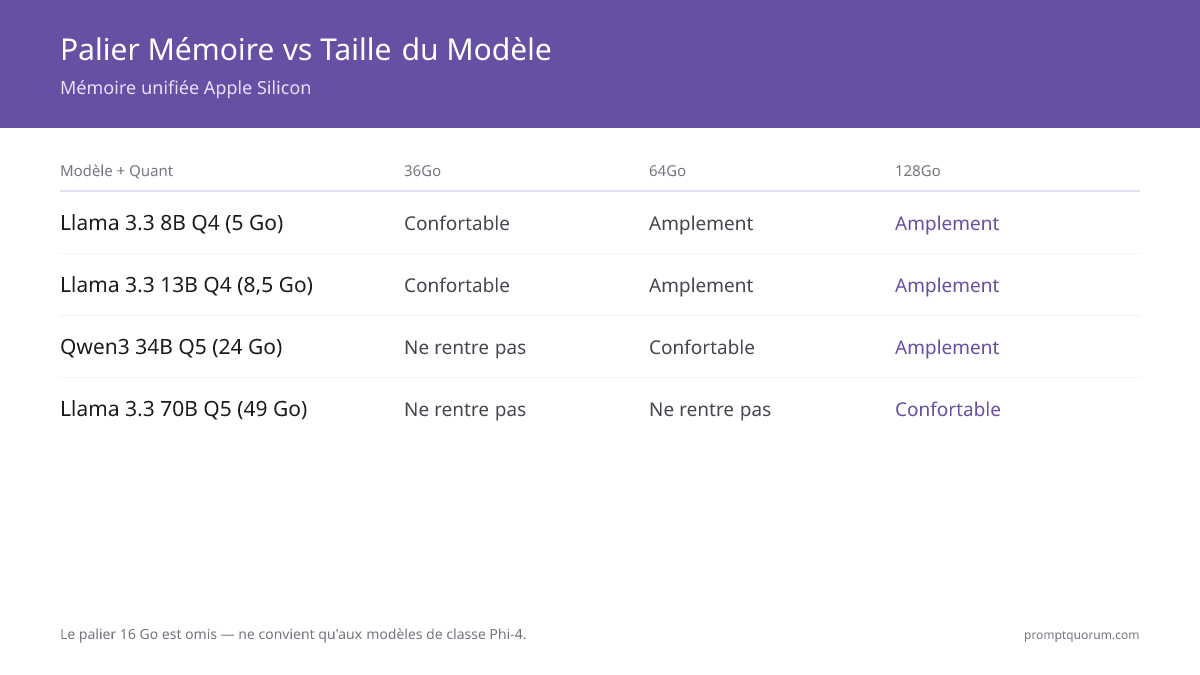
TL;DR
- 16 Go : modèles 7B uniquement (serré)
- 36 Go : 13B confortablement, 32B Q4 serré
- 64 Go : 32B Q5 confortablement
- 70B Q5 confortablement avec 128 Go
- Impossible de mettre à niveau après l'achat — acheter le maximum à l'achat
Fonctionnement de la mémoire unifiée pour les LLM
La mémoire unifiée est partagée entre CPU et GPU — tout est partagé entre le modèle et macOS. Contrairement aux GPU discrets (la RTX 4070 a 12 Go VRAM + 32 Go RAM séparés), l'Apple Silicon partage un seul pool. Mac 64 Go = 64 Go au total. Prévoyez au moins 8 Go pour macOS et les applications, ce qui laisse ~56 Go pour le LLM.
La mémoire unifiée est-elle la même chose que la VRAM ?
Oui — sur Apple Silicon, la mémoire unifiée *est* la VRAM du GPU. Il n'existe pas de pool de VRAM séparé et fixe comme sur un GPU dédié. Le CPU, le GPU et le Neural Engine d'une puce M lisent et écrivent dans la même mémoire physique, si bien que la quasi-totalité du pool de mémoire unifiée — et non une simple fraction — est disponible pour le GPU lors de l'exécution d'un LLM, une fois au moins 8 Go réservés à macOS. macOS applique aussi par défaut une limite de mémoire GPU d'environ deux tiers à trois quarts de la RAM totale selon la taille (elle peut être relevée) ; le total moins 8 Go est donc un plafond, pas une garantie.
- GPU dédié (RTX 4070) : 12 Go de VRAM constituent un plafond fixe pour les poids du modèle, même si le PC dispose de 64 Go de RAM système séparée.
- Apple Silicon : le GPU peut accéder à tout le pool de mémoire unifiée moins 8 Go minimum pour macOS — un Mac 64 Go donne au GPU ~56 Go, pas une tranche fixe de VRAM de 12-24 Go.
- C'est pourquoi un Mac 64 Go peut exécuter un modèle 32B confortablement alors qu'un PC 64 Go avec un GPU 12 Go ne le peut pas — la mémoire accessible au GPU du PC est plafonnée par sa VRAM, pas par sa RAM totale.
- « Mémoire partagée » et « mémoire unifiée » décrivent la même architecture : un seul pool, adressable à la fois par le CPU et le GPU, sans étape manuelle d'allocation de VRAM.
Tableau principal : niveau mémoire vs taille de modèle
Model | Parameters | Q3_K | Q4_K_M | Q5_K_M | Q8 | FP16 |
|---|---|---|---|---|---|---|
| Phi-4 Mini | 3,8B | 2,1 Go | 2,5 Go | 2,9 Go | 4,0 Go | 7,6 Go |
| Mistral 7B | 7B | 3,8 Go | 4,5 Go | 5,2 Go | 7,5 Go | 14 Go |
| Llama 3.1 8B | 8B | 4,2 Go | 5,0 Go | 5,8 Go | 8,5 Go | 16 Go |
| Gemma 3 12B | 12B | 6,5 Go | 7,8 Go | 9,0 Go | 12,9 Go | 24 Go |
| Qwen3 32B | 32B | 16 Go | 20 Go | 23 Go | 35 Go | 66 Go |
| Llama 3.3 70B | 70B | 36 Go | 42 Go | 49 Go | 74 Go | 140 Go |
| Llama 3.1 405B | 405B | 200+ Go | 240 Go | 280 Go | 410 Go | 810 Go |
Toujours déduire au moins 8 Go pour macOS lors du calcul de la compatibilité sur votre Mac.
Matrice compatible / incompatible
Modèle + Quantification | 16 Go | 36 Go | 64 Go | 128 Go |
|---|---|---|---|---|
| Phi-4 Mini Q4 (2,5 Go) | ✓ Largement | ✓ Largement | ✓ Largement | ✓ Largement |
| Llama 3.1 8B Q4 (5 Go) | ⚠️ Serré | ✓ Confortable | ✓ Largement | ✓ Largement |
| Llama 3.1 8B Q8 (8,5 Go) | ✗ Incompatible | ✓ Confortable | ✓ Largement | ✓ Largement |
| Gemma 3 12B Q4 (7,8 Go) | ✗ Incompatible | ✓ Confortable | ✓ Largement | ✓ Largement |
| Qwen3 32B Q4 (20 Go) | ✗ Incompatible | ⚠️ Serré | ✓ Confortable | ✓ Largement |
| Qwen3 32B Q5 (23 Go) | ✗ Incompatible | ✗ Incompatible | ✓ Confortable | ✓ Largement |
| Llama 3.3 70B Q3 (36 Go) | ✗ Incompatible | ✗ Incompatible | ⚠️ Serré | ✓ Confortable |
| Llama 3.3 70B Q4 (42 Go) | ✗ Incompatible | ✗ Incompatible | ⚠️ Très serré | ✓ Confortable |
| Llama 3.3 70B Q5 (49 Go) | ✗ Incompatible | ✗ Incompatible | ✗ Incompatible | ✓ Confortable |
| Llama 3.3 70B Q8 (74 Go) | ✗ Incompatible | ✗ Incompatible | ✗ Incompatible | ✓ Compatible |
✓ Largement = 4+ Go libres | ✓ Confortable = 2–4 Go libres | ⚠️ Serré = moins de 2 Go libres | ✗ Incompatible = swap ou plantage

Ce qui tient dans chaque niveau mémoire (pratique)
- 116 Go (M5 base, MacBook Air)
Why it matters: Llama 3.1 8B Q4 tient (5 Go modèle + 8 Go OS = 13 Go) ✓ mais serré. Llama 8B Q8 ne tient pas sans swap. Whisper small tient à côté. - 236 Go (M5 Pro base)
Why it matters: Llama 3.1 8B Q8 tient confortablement. Les modèles de classe 13B tiennent. Qwen3 32B Q4 tient tout juste (20 Go + 8 Go OS = 28 Go). Multi-modèle : Whisper + LLaVA + TTS tiennent ✓ - 364 Go (M5 Pro max)
Why it matters: Qwen3 32B Q5 tient confortablement (23 Go). Llama 70B Q3 tient à peine. Les stacks multi-modèles ont beaucoup de place. - 4128 Go (M5 Max)
Why it matters: Meilleur modèle pour 128 Go : Llama 3.3 70B Q5 (49 Go) — le plus grand modèle courant qui tient avec de la marge. 70B Q8 tient (74 Go) pour une qualité quasi sans perte. Multi-modal : Whisper + modèle vision 90B + LLM 8B tiennent simultanément ✓
Besoins mémoire pour les stacks multi-modèles
Cas d'utilisation (stack) | Mémoire nécessaire |
|---|---|
| LLM seul (Llama 8B Q4) | 5 Go + OS = 13 Go |
| LLM + STT (Llama 8B + Whisper large-v3) | 8 Go + OS = 16 Go |
| LLM + STT + TTS (assistant vocal) | 9 Go + OS = 17 Go |
| LLM + Vision (Llama 8B + LLaVA 7B) | 11 Go + OS = 19 Go |
| Multimodal complet (LLM + Vision + STT + TTS) | 14 Go + OS = 22 Go |
| LLM + RAG (Llama 8B + embeddings + ChromaDB) | 8 Go + OS = 16 Go |
| Multimodal lourd (Llama 70B Q4 + Vision 90B) | 100+ Go |
Les stacks dépassant 22 Go nécessitent un Mac minimum 36 Go. Les stacks dépassant 50 Go nécessitent un Mac minimum 64 Go. Le stack multimodal lourd ne fonctionne que sur M5 Max 128 Go.
La fenêtre de contexte génère un overhead mémoire supplémentaire
Le cache KV évolue avec la longueur du contexte — plus la fenêtre de contexte est grande, plus le modèle utilise de mémoire à l'exécution. C'est un piège courant qui peut faire basculer une configuration serrée vers le swap.
- Llama 3.1 8B avec contexte 8K : +0,5 Go
- Llama 3.1 8B avec contexte 32K : +2 Go
- Llama 3.1 8B avec contexte 128K : +8 Go
- Llama 3.3 70B avec contexte 32K : +6 Go
- Llama 3.3 70B avec contexte 128K : +24 Go
Acheter le maximum de mémoire — voici pourquoi
- La mémoire Apple Silicon ne peut pas être mise à niveau après l'achat.
- Les tailles de modèles augmentent : 8B aujourd'hui → sweet spot 13–32B en 2027.
- 16 Go est déjà marginal pour les LLM — 36 Go minimum recommandé.
- Différence de prix : passer de 36 Go à 64 Go coûte un supplément à l'achat (voir le configurateur Apple actuel pour les prix) et peut éviter l'achat d'un nouveau Mac dans 2 ans si les modèles dépassent 36 Go.
- M5 Pro 36 Go face à 64 Go — voir le configurateur Apple actuel pour les prix ; remplacer tout le Mac plus tard coûte généralement plus cher que de choisir le palier de mémoire supérieur à l'achat.
- Une façon économique d'obtenir 36 Go+ de mémoire unifiée : un Mac mini M5 Pro configuré avec 36 Go dispose d'assez de mémoire pour exécuter des modèles 13B confortablement (voir le configurateur Apple actuel pour les prix et configurations).
- Apple a renouvelé la gamme Mac mini et Mac Studio le 25 août 2026, ajoutant des paliers au-delà du plafond de 128 Go de ce guide : Mac mini M6 (32 Go max, ~899 €), Mac mini M5 Pro (64 Go max, ~1 699 €), Mac Studio M5 Max (128 Go max, ~2 499 €) et Mac Studio M5 Ultra (256 Go ou 512 Go, à partir de ~5 499 €). La configuration 512 Go arrive fin octobre 2026, à un prix bien supérieur à 10 000 €. Pour les tailles de modèles couvertes par ce guide (jusqu'à 70B), 64–128 Go reste la plage pratique — 256 Go+ n'a d'intérêt que pour des modèles plus grands que 70B ou pour exécuter plusieurs gros modèles simultanément.

Impact de la quantification sur la qualité
Q4_K_M (4 bits) : la perte de qualité est généralement faible et varie selon le modèle et la tâche. Un choix par défaut courant.
Q5_K_M (5 bits) : la perte de qualité est généralement plus faible qu'en Q4 et varie selon le modèle et la tâche. Recommandé si de la mémoire est disponible.
Q8 (8 bits) : la perte de qualité est généralement très faible et varie selon le modèle et la tâche.
Q3_K (3 bits) : la perte de qualité est généralement plus élevée et varie selon le modèle et la tâche ; elle peut être perceptible sur le raisonnement complexe. Acceptable uniquement pour les scénarios contraints en espace.
Dois-je choisir 36 Go ou 64 Go ?
Prendre 64 Go si le budget le permet (voir le configurateur Apple actuel pour l'écart de prix). 36 Go fonctionne aujourd'hui mais pourrait devenir serré dans 12 mois avec la croissance des modèles. 64 Go devrait couvrir les tailles de modèles de ce guide pour la prochaine année ou deux, si les modèles continuent de grossir au rythme actuel.
Puis-je mettre à niveau la mémoire plus tard ?
Non. La mémoire Apple Silicon est soudée et non mise à niveau. Acheter le maximum à l'achat.
Pourquoi 16 Go ne suffit-il pas ?
16 Go au total − au moins 8 Go pour macOS = environ 8 Go disponibles pour le modèle. Llama 8B Q4 nécessite 5 Go, ne laissant aucune place pour Whisper ou autres tâches. Trop serré.
Ai-je vraiment besoin de 128 Go ?
Seulement si vous exécutez régulièrement des modèles 70B ou avez besoin de Vision + LLM + STT simultanément. Sinon, 64 Go est largement suffisant.
48 Go suffisent-ils pour les LLM locaux ?
Oui — 48 Go (disponible sur M4 Pro et certaines configs M5 Pro) est un bon compromis. Fait tourner tous les modèles 32B, 70B Q3 à la limite, et les stacks multimodaux complets. Mieux que 36 Go ; si 64 Go est abordable, l'avenir le justifie.
Quelle mémoire pour exécuter Llama 3.3 70B en local ?
Minimum 48 Go (quantification Q3, perte de qualité perceptible). Recommandé 64 Go (quantification Q4, fit serré). Confortable 128 Go (quantification Q5/Q8, haute qualité). Le niveau 64 Go exige une gestion mémoire soigneuse ; 128 Go est la seule option sans contrainte pour le 70B.
Ai-je besoin de 128 Go pour l'IA locale en 2026 ?
Seulement pour exécuter régulièrement des modèles 70B ou des stacks Vision + LLM + STT simultanément. Pour l'usage LLM courant (modèles 8B–32B, RAG, assistance au code), le M5 Pro 64 Go est le sweet spot. 128 Go représente un surcoût de 2–3× pour un bénéfice marginal sans besoin spécifique de 70B.
La mémoire unifiée Apple Silicon est-elle la même chose que la VRAM ?
Oui. Contrairement à un GPU dédié avec un pool de VRAM fixe et séparé (par ex. 12 Go sur une RTX 4070), le GPU d'Apple Silicon lit et écrit dans la même mémoire physique que le CPU. Le GPU peut accéder à la quasi-totalité de la mémoire unifiée d'un Mac — un Mac 64 Go donne au GPU ~56 Go après la réserve de 8 Go pour macOS, pas une tranche fixe de VRAM.
Quel est le plus grand LLM qui tient dans 128 Go de mémoire unifiée ?
Llama 3.3 70B en quantification Q5_K_M (49 Go) est le plus grand modèle courant qui tient confortablement, laissant ~70 Go libres pour le contexte et l'overhead. En Q8 (74 Go), il tient encore avec de la marge pour macOS. Un modèle 405B nécessite 240 Go+ même en Q4 — au-delà de la mémoire unifiée d'un Mac de 128 Go, donc 70B reste le plafond pratique sur un Mac de 128 Go.
Quel espace de stockage nécessite un LLM local, indépendamment de la mémoire ?
Mémoire (RAM) et stockage disque sont différents : la mémoire contient le modèle pendant son exécution ; le stockage contient le fichier du modèle téléchargé de façon permanente. Un modèle 8B en Q4 nécessite ~5 Go de mémoire et de disque. Un modèle 70B Q5 nécessite ~49 Go de mémoire et ~49 Go de disque — le même fichier. Exécuter plusieurs modèles en local (par ex. 8B, 32B, 70B, plus un modèle vision) nécessite 100-150 Go d'espace disque libre, indépendamment du niveau de mémoire de votre Mac.
Puis-je obtenir plus de 128 Go de mémoire unifiée sur un Mac ?
Oui. La mise à jour du 25 août 2026 a ajouté le Mac Studio M5 Ultra avec des configurations de 256 Go et 512 Go de mémoire unifiée, à partir de ~5 499 €. Le palier 512 Go arrive fin octobre 2026 et coûte bien plus de 10 000 €. C'est très au-delà de ce qu'exigent les modèles de classe 70B — les paliers 16 Go à 128 Go de ce guide couvrent la plage pratique pour presque tous les usages de LLM local. Les 256 Go+ n'ont d'intérêt que pour des modèles plus grands que 70B ou pour servir plusieurs gros modèles simultanément. Aucun benchmark indépendant n'existe encore pour le M5 Ultra.
Les LLM locaux sur M5 Max sont-ils conformes au RGPD ?
Oui. Toutes les données étant traitées localement sans transmission vers des serveurs externes, aucune donnée personnelle n'est soumise à l'article 28 RGPD. La CNIL recommande les solutions d'IA en local pour les traitements de données sensibles, en particulier dans les secteurs médical, juridique et financier.