Faits rapides
- Couche STT : whisper.cpp (optimal pour Apple Silicon et embarqué), faster-whisper (optimal pour les pipelines Python GPU NVIDIA).
- Couche LLM : Ollama avec Llama 3.1 8B (recommandé), Phi-4 (plus léger) ou Ministral 3 8B.
- Couche TTS : Piper (rapide, CPU uniquement, temps réel sur Pi), Coqui TTS (meilleure qualité, GPU requis).
- Options de mot de déclenchement : OpenWakeWord (code Apache 2.0, modèles non commerciaux, entièrement hors ligne), Porcupine (tier gratuit, 1 mot personnalisé).
- Matériel minimum : Raspberry Pi 5 avec 8 Go de RAM (~90 €) pour une latence de 5 à 8 secondes.
- Matériel recommandé : Mac Mini M5 24 Go (~600 €) ou PC de bureau avec RTX 3060 12 Go (~750 €) pour 1 à 2 secondes.
- Langues : Whisper supporte 99 langues. Piper supporte 20+ packs vocaux. Les performances LLM varient selon la langue.
Pourquoi construire un assistant vocal local ?
Alexa, Siri et Google Assistant acheminent la plupart des requêtes vocales via des serveurs cloud (consultez la documentation de confidentialité actuelle de chaque fournisseur). Un assistant vocal local traite tout sur votre propre matériel.
- Confidentialité : Par défaut, aucun audio ne quitte votre réseau. Aucun historique de conversation sur des serveurs tiers. Essentiel pour les professionnels de santé, avocats, journalistes et toute personne traitant des données sensibles.
- Coût : Pas d'abonnement. Google One coûte environ 1,99 à 9,99 €/mois. Un assistant local est un investissement matériel unique.
- Personnalisation : Choisissez votre mot de déclenchement, la personnalité, le prompt système et les fonctionnalités. Connectez des systèmes domotiques locaux, intégrez des API locales.
- Fonctionnement hors ligne : Fonctionne sans internet. Panne de courant (avec onduleur) + panne internet : votre assistant local continue de fonctionner.
- Ce que vous perdez : Recherche web, intégration domotique avec les clouds propriétaires, synchronisation d'agenda cloud, et les années d'optimisation RLHF qui rendent Alexa/Siri fluides pour les cas limites.
- Intégration domotique : Connectez votre assistant vocal local directement à Home Assistant pour contrôler les lumières, thermostats et capteurs par la voix — l'inférence s'exécute hors ligne. Voir assistant vocal local pour smart home → pour le guide complet Piper + Whisper + Home Assistant.
L'architecture en trois couches
L'assistant vocal hors ligne repose sur trois couches indépendantes connectées par un orchestrateur Python.
📍 En une phrase
Microphone → whisper.cpp (STT) → Ollama LLM → Piper TTS → haut-parleur : trois composants indépendants reliés par un orchestrateur Python d'environ 50 lignes.
💬 En termes simples
Imaginez un relais téléphonique : vous parlez, Whisper l'écrit, le LLM formule une réponse et l'écrit, Piper la lit à voix haute. Chaque étape est un programme distinct ; Python fait passer le texte entre eux.
- Couche 1 — STT : whisper.cpp ou faster-whisper. Convertit l'audio du microphone en texte. Fonctionne hors ligne, sans réseau.
- Couche 2 — LLM : Ollama avec Llama 3.1 8B, Phi-4 ou Ministral 3 8B. Reçoit le texte transcrit + l'historique + le prompt système et génère une réponse. Fonctionne hors ligne.
- Couche 3 — TTS : Piper ou Coqui TTS. Convertit le texte de réponse en audio et le diffuse via le haut-parleur. Fonctionne hors ligne.
- Orchestrateur : Un script Python qui relie les trois : capture audio → STT → transcript → LLM → réponse → TTS → audio diffusé.
- Mot de déclenchement optionnel : Un détecteur léger en permanence (OpenWakeWord, Porcupine) qui ne lance le pipeline complet que lorsque la phrase d'activation est détectée.

Configuration matérielle
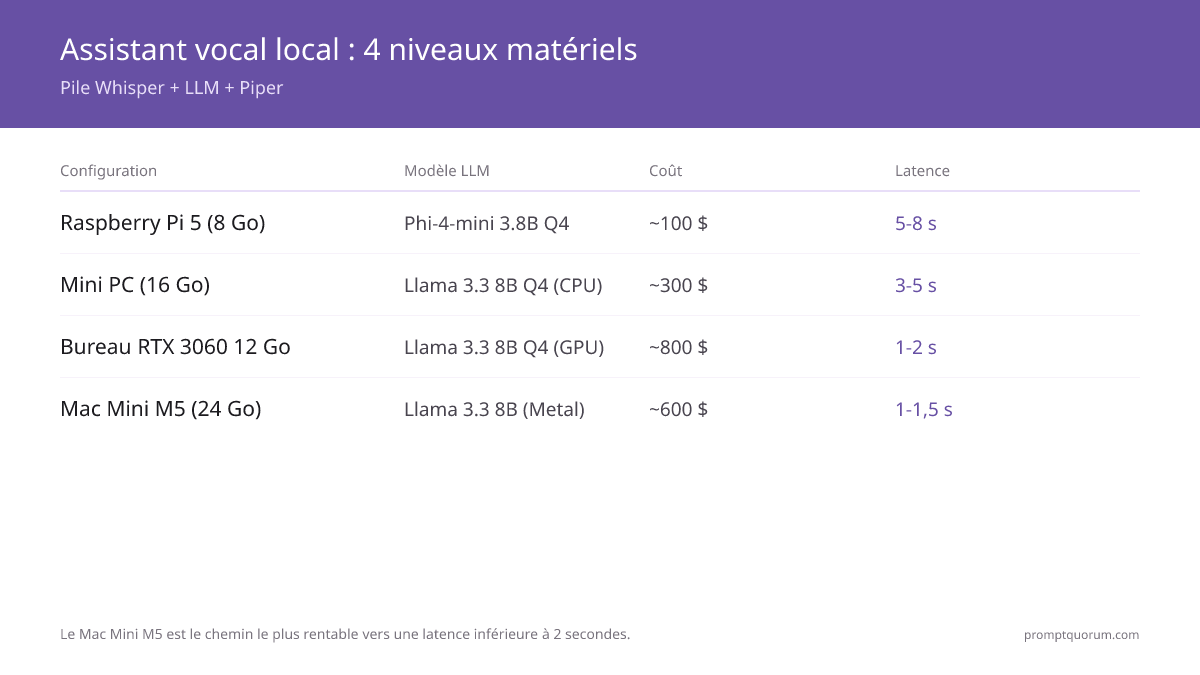
Quatre configurations matérielles, classées par latence et coût. Toutes supportent le pipeline complet Whisper + LLM + Piper. Les chiffres sont des valeurs typiques ou indicatives pour chaque classe de matériel, non mesurées par PromptQuorum.
Configuration | Modèle STT | Modèle LLM | TTS | Coût total | Latence totale |
|---|---|---|---|---|---|
| Raspberry Pi 5 (8 Go) | Whisper base (CPU) | Phi-4-mini 3.8B Q4 | Piper (CPU) | ~90 € | 5–8 s |
| Mini PC (16 Go RAM) | Whisper small (CPU) | Llama 3.1 8B Q4 (CPU) | Piper (CPU) | ~270 € | 3–5 s |
| PC de bureau (RTX 3060 12 Go) | Whisper large-v3 (GPU) | Llama 3.1 8B Q4 (GPU) | Piper ou Coqui (CPU/GPU) | ~750 € | 1–2 s |
| Mac Mini M5 (24 Go) | Whisper large-v3 (Metal) | Llama 3.1 8B (Metal) | Piper (CPU) | ~600 € | 1–1,5 s |
💡Astuce: Le Mac Mini M5 est le chemin le plus rentable vers une latence inférieure à 2 secondes. Silencieux au repos, il fait tourner Whisper Metal et Ollama simultanément sur la mémoire unifiée, sans gestion de pilotes NVIDIA.
Étape 1 : Configurer la reconnaissance vocale
Installez whisper.cpp pour Apple Silicon et le matériel embarqué ; installez faster-whisper pour les setups GPU NVIDIA.
- Installer whisper.cpp :
git clone https://github.com/ggerganov/whisper.cpp && cd whisper.cpp && make -j4 - Télécharger le modèle :
bash ./models/download-ggml-model.sh small(small = 3.4 % WER, bon équilibre vitesse/précision) - Tester la transcription :
./main -m models/ggml-small.bin -f test.wav— doit produire une sortie texte précise. - Activer Metal sur Mac :
make -j4 WHISPER_COREML=1puisbash models/generate-coreml-model.sh small - Sélection du modèle : base pour Raspberry Pi (1 Go RAM, faible latence), small pour le meilleur compromis (2 Go RAM, 3.4 % WER), large-v3 pour la précision maximale (10 Go VRAM/RAM).
- Configurer la suppression du silence : Ajoutez
--no-speech-threshold 0.6 --suppress-blankpour éviter de transcrire le silence en texte halluciné. - Tester avec un enregistrement de 10 secondes : Vérifiez la transcription en conditions bruyantes et en parole faible.
Étape 2 : Configurer le LLM local
Installez Ollama et téléchargez le modèle LLM. Configurez un prompt système adapté — réponses courtes, pas de markdown, personnalité appropriée.
- Installer Ollama : Téléchargez depuis ollama.com. Disponible pour macOS, Linux et Windows. Installation en moins de 2 minutes.
- Télécharger le modèle :
ollama pull llama3.1:8b(recommandé) ouollama pull phi4(plus léger, pour 16 Go de RAM). - Tester :
ollama run llama3.1:8b "What is the capital of France?"— vérifiez la précision et la rapidité. - Prompt système pour la voix : « You are a helpful voice assistant. Keep responses concise — 1–3 sentences maximum. Never use bullet points, markdown, or formatting. Speak naturally as if in conversation. »
- Température : Réglez à 0.3–0.5 pour des réponses plus prévisibles et factuelles. Réduit les hallucinations.
- Nombre maximum de tokens : Limitez avec
--num-predict 150— les longues réponses prennent plus de temps en TTS et sonnent peu naturel à l'oral.
Étape 3 : Configurer la synthèse vocale
Installez Piper pour toutes les configurations matérielles. Fonctionne en temps réel sur CPU, y compris Raspberry Pi, avec 20+ packs vocaux et sans GPU.
- Installer Piper :
pip install piper-tts - Télécharger une voix :
piper --download-dir voices --update-voices --voice en_US-lessac-medium - Tester :
echo "Hello, how can I help you today?" | piper --model voices/en_US-lessac-medium.onnx --output-raw | aplay -r 22050 -f S16_LE -c 1 - Sortie audio : Piper génère du PCM brut ou du WAV. Redirigez vers
aplay(Linux),afplay(Mac), ou utilisezsounddevicePython. - Alternative (meilleure qualité) : Backend Coqui VITS —
pip install TTS,tts --model_name tts_models/en/vctk/vits. Nécessite ~2 Go de VRAM, 2–3× plus lent. - Sélection de la voix : Choisissez une voix de qualité moyenne — plus rapide et la différence est négligeable via un haut-parleur.
Étape 4 : Connecter le pipeline
Un orchestrateur Python connecte STT → LLM → TTS. Le script capture l'audio du microphone, le transcrit avec Whisper, envoie la transcription à Ollama, convertit la réponse en parole avec Piper et la diffuse.
#!/usr/bin/env python3
"""Minimal offline voice assistant: Whisper STT + Ollama LLM + Piper TTS."""

import subprocess
import tempfile
import sounddevice as sd
import soundfile as sf
import numpy as np
import requests
import json

SAMPLE_RATE = 16000
RECORD_SECONDS = 5
OLLAMA_URL = "http://localhost:11434/api/generate"
WHISPER_BIN = "./whisper.cpp/main"
WHISPER_MODEL = "./whisper.cpp/models/ggml-small.bin"
PIPER_BIN = "piper"
PIPER_VOICE = "voices/en_US-lessac-medium.onnx"
SYSTEM_PROMPT = (
    "You are a helpful voice assistant. Keep responses to 1-3 sentences. "
    "Never use markdown, bullet points, or formatting. Speak naturally."
)

conversation_history = []

def record_audio(seconds: int = RECORD_SECONDS) -> np.ndarray:
    print("Listening...")
    audio = sd.rec(int(seconds * SAMPLE_RATE), samplerate=SAMPLE_RATE, channels=1, dtype="int16")
    sd.wait()
    return audio

def transcribe(audio: np.ndarray) -> str:
    with tempfile.NamedTemporaryFile(suffix=".wav", delete=False) as f:
        sf.write(f.name, audio, SAMPLE_RATE)
        result = subprocess.run(
            [WHISPER_BIN, "-m", WHISPER_MODEL, "-f", f.name, "--no-timestamps", "--no-prints"],
            capture_output=True, text=True
        )
    return result.stdout.strip()

def ask_llm(text: str) -> str:
    conversation_history.append({"role": "user", "content": text})
    response = requests.post(OLLAMA_URL, json={
        "model": "llama3.1:8b",
        "system": SYSTEM_PROMPT,
        "messages": conversation_history,
        "stream": False,
    })
    reply = response.json()["message"]["content"]
    conversation_history.append({"role": "assistant", "content": reply})
    return reply

def speak(text: str) -> None:
    with tempfile.NamedTemporaryFile(suffix=".wav", delete=False) as f:
        subprocess.run(
            [PIPER_BIN, "--model", PIPER_VOICE, "--output_file", f.name],
            input=text.encode("utf-8"), check=True
        )
        data, sr = sf.read(f.name)
        sd.play(data, sr)
        sd.wait()

def main():
    print("Voice assistant ready. Press Ctrl+C to stop.")
    while True:
        audio = record_audio()
        transcript = transcribe(audio)
        if not transcript or len(transcript) < 3:
            continue
        print(f"You: {transcript}")
        response = ask_llm(transcript)
        print(f"Assistant: {response}")
        speak(response)

if __name__ == "__main__":
main()📌Remarque: Il s'agit d'un pipeline minimal — il enregistre avec une durée fixe. Pour la production, utilisez la VAD (détection d'activité vocale) pour enregistrer jusqu'à la fin de la parole. faster-whisper intègre Silero VAD ; pour whisper.cpp, utilisez le mode --stream ou implémentez une VAD WebRTC avec la bibliothèque Python webrtcvad.
Étape 5 : Détection du mot de déclenchement
Un détecteur de mot de déclenchement fait tourner un modèle léger en permanence et ne lance le pipeline complet que lorsque la phrase choisie est détectée. Sans lui, Whisper tourne en continu — consommant plus de CPU/GPU et générant plus de faux positifs.
- OpenWakeWord (code : Apache 2.0 ; modèles pré-entraînés : CC BY-NC-SA 4.0, non commercial) : Les modèles pré-entraînés ne sont sous licence que pour un usage non commercial ; vérifiez la licence dans le dépôt OpenWakeWord avant tout usage commercial. Le code est open-source, tourne sur CPU, supporte des mots personnalisés via fine-tuning. Installation :
pip install openwakeword. Fonctionne sur Raspberry Pi. - Porcupine (Picovoice) : Propriétaire avec tier gratuit pour usage personnel. Mots préconfigurés : « Alexa », « Hey Siri », « Ok Google », « Hey Jarvis ». Très bonne précision. Installation :
pip install pvporcupine. - Schéma d'intégration : Faites tourner le détecteur en boucle. À la détection, jouez un son « ding », déclenchez le pipeline pour une requête, puis revenez à l'écoute.
- Fonctionnement en continu : La détection utilise ~2–5 % de CPU sur Raspberry Pi 5 — négligeable. L'assistant peut tourner 24h/24.
- Mots personnalisés (OpenWakeWord) : Générez 500 exemples positifs et 500 négatifs via TTS, puis affinez OpenWakeWord en moins de 30 minutes sur CPU.
Optimisation de la latence
L'objectif de 1 à 2 secondes est atteignable sur du matériel de bureau avec les bons réglages. La latence se décompose sur les trois couches :
📍 En une phrase
Le STT ajoute 0,2–0,5 s, le premier token du LLM ajoute 0,5–1,5 s, le TTS ajoute 0,1–0,3 s — total 1 à 2 secondes sur GPU de bureau.
💬 En termes simples
Le LLM est le principal goulot d'étranglement. L'optimisation la plus efficace : démarrer le TTS en streaming pendant que le LLM génère ses tokens — l'utilisateur entend la réponse avant que le LLM ait fini.
- Optimisation STT (~0,2–0,5 s) : Utilisez Whisper small plutôt que large-v3. Utilisez la VAD pour couper le silence avant de passer l'audio à Whisper.
- Optimisation LLM (~0,5–1,5 s premier token) : Préchargez le modèle au démarrage (Ollama le fait automatiquement). Utilisez Q4_K_M. Définissez
--num-predict 100–150. - Streaming LLM → TTS : Streamez la sortie du LLM token par token. Lancez le TTS à chaque phrase complète. Réduit la latence perçue de 0,3 à 0,7 s.
- Optimisation TTS (~0,1–0,3 s) : Piper génère le premier audio en 50 ms. Pré-initialisez Piper au démarrage. Utilisez
--output-rawpour le streaming. - Maintenir les modèles en mémoire : Ollama maintient les modèles chauds en VRAM automatiquement. Évitez de recharger les modèles entre les requêtes.
- Objectifs par configuration : Pi 5 : 5–8 s. Mini PC CPU : 3–5 s. GPU de bureau : 1–2 s. Mac M5 : 1–1,5 s.

Confidentialité et sécurité
Dans un assistant vocal local correctement configuré, l'inférence s'exécute sur votre matériel et aucun audio ni texte n'est envoyé par défaut à un service cloud. Tout le traitement — capture audio, reconnaissance vocale, inférence LLM et TTS — s'exécute entièrement sur votre matériel.
- Vérifiez avec Wireshark : Lancez Wireshark pendant une conversation. Vous ne devriez voir aucun audio ni aucune transcription quitter la machine ; les vérifications de mise à jour et la validation de clé peuvent toutefois apparaître si elles ne sont pas bloquées. Tout trafic inattendu indique une mauvaise configuration.
- Aucun audio stocké : Ni whisper.cpp ni faster-whisper n'écrivent de fichiers audio par défaut. L'orchestrateur écrit un fichier WAV temporaire supprimé après la transcription.
- Aucun historique stocké : L'historique dans le script d'exemple est en mémoire uniquement. Pour un historique persistant, implémentez un stockage local avec chiffrement au repos.
- Conformité RGPD : Comme l'inférence s'exécute en local, un assistant vocal local purement interne peut ne pas nécessiter de contrat de sous-traitance pour la couche d'inférence ; cela dépend de votre configuration et ne constitue pas un conseil juridique. La conformité RGPD de votre exploitation dépend toujours de la base légale, des mesures techniques et organisationnelles et de la finalité.
- Isolation réseau : Ajoutez une règle de pare-feu bloquant le trafic sortant du processus assistant pour une confidentialité maximale. Ollama et whisper.cpp fonctionneront normalement après le téléchargement des modèles.
Questions fréquemment posées
Puis-je utiliser un assistant vocal local pour contrôler ma domotique ?
Oui, si votre système domotique dispose d'une API locale. Home Assistant (HASS) offre une excellente intégration locale — vous pouvez appeler l'API REST HASS depuis l'orchestrateur après que le LLM a interprété la commande. Le LLM sert de parseur d'intentions : « Allume les lumières du salon » → JSON → appel API HASS. Pour les systèmes propriétaires (Ring, Nest, Philips Hue cloud) sans API locale, l'intégration locale n'est pas possible sans internet.
Combien de langues l'assistant vocal local supporte-t-il ?
Whisper supporte 99 langues pour la reconnaissance vocale. Piper supporte 20+ packs vocaux pour le TTS. Le support linguistique du LLM dépend du modèle — Llama 3.1 8B gère bien l'anglais, le français, l'allemand, l'espagnol, l'italien et le portugais. Pour les langues moins répandues, choisissez un modèle spécifiquement entraîné.
Quel est le matériel minimum pour une latence inférieure à 2 secondes ?
Un Mac Mini M5 (24 Go, ~600 €) ou un PC de bureau avec NVIDIA RTX 3060 12 Go (GPU ~330 €, système ~750 €) atteignent tous deux 1 à 2 secondes. Les exigences clés : 8 Go+ de VRAM GPU pour Llama 3.1 8B en Q4, plus Metal ou CUDA pour Whisper. Un setup CPU uniquement (Mini PC, ~270 €) atteint 3 à 5 secondes.
Le pipeline Whisper + LLM + Piper fonctionne-t-il sous Windows ?
Oui. whisper.cpp dispose d'instructions de build Windows avec cmake et Visual Studio. Ollama fonctionne nativement sous Windows 10/11 avec GPU NVIDIA. Piper a des binaires Windows. La principale complexité est la compilation de whisper.cpp — utilisez faster-whisper (pip install, aucune compilation) sous Windows avec GPU NVIDIA.
Comment ajouter la recherche web à l'assistant vocal local ?
Intégrez un outil de recherche dans l'orchestrateur. Options : (1) API DuckDuckGo (gratuite, sans compte) pour les requêtes générales. (2) Flux RSS local pour l'actualité. (3) Système RAG local (AnythingLLM, PrivateGPT) avec votre propre collection de documents. Cela ajoute 0,5 à 2 secondes de latence selon la méthode.
Sources
- whisper.cpp sur GitHub — Code source, instructions de build, documentation du mode stream.
- Ollama sur ollama.com — Installation, bibliothèque de modèles, référence API.
- Piper TTS sur GitHub — Code source, téléchargements de packs vocaux, guide Raspberry Pi.
- OpenWakeWord sur GitHub — Code source, guide d'entraînement de mots personnalisés.
- Porcupine par Picovoice — SDK de mot de déclenchement, conditions du tier gratuit, documentation Python.
- Picovoice Console — Créez une clé API gratuite pour Porcupine (usage personnel).