Pourquoi 70B est important : Le saut de qualité de 8B
Le passage de 8B à 70B paramètres est le seuil de qualité le plus significatif en IA locale. Scores de benchmark industriels :
Benchmark | Llama 3.1 8B | Llama 3.3 70B Q5 | GPT-5.6 |
|---|---|---|---|
| MMLU (connaissances générales) | 73,0 | 86,1 | 88,7 |
| HumanEval (code) | 72,6 | 80,5 | 90,2 |
| GSM8K (mathématiques) | 84,5 | 95,1 | 95,8 |
| BBH (raisonnement) | 71,0 | 85,3 | 88,9 |
| Moyenne | 75,3 | 86,8 | 90,9 |
70B Q5 comble 75% de l'écart de qualité entre 8B et GPT-5.6 — tout en s'exécutant localement pour 0€/mois.
Quel matériel exécute les modèles 70B
Matériel | Quantification | Taille modèle | tok/s | Qualité | Adapté ? |
|---|---|---|---|---|---|
| M3 Max 96GB | Q4_K_M | 42 GB | 9–13 | Bonne | ✓ Oui |
| M3 Max 128GB | Q5_K_M | 49 GB | 8–12 | Très bonne | ✓ Oui |
| M4 Max 128GB | Q5_K_M | 49 GB | 10–14 | Très bonne | ✓ Oui |
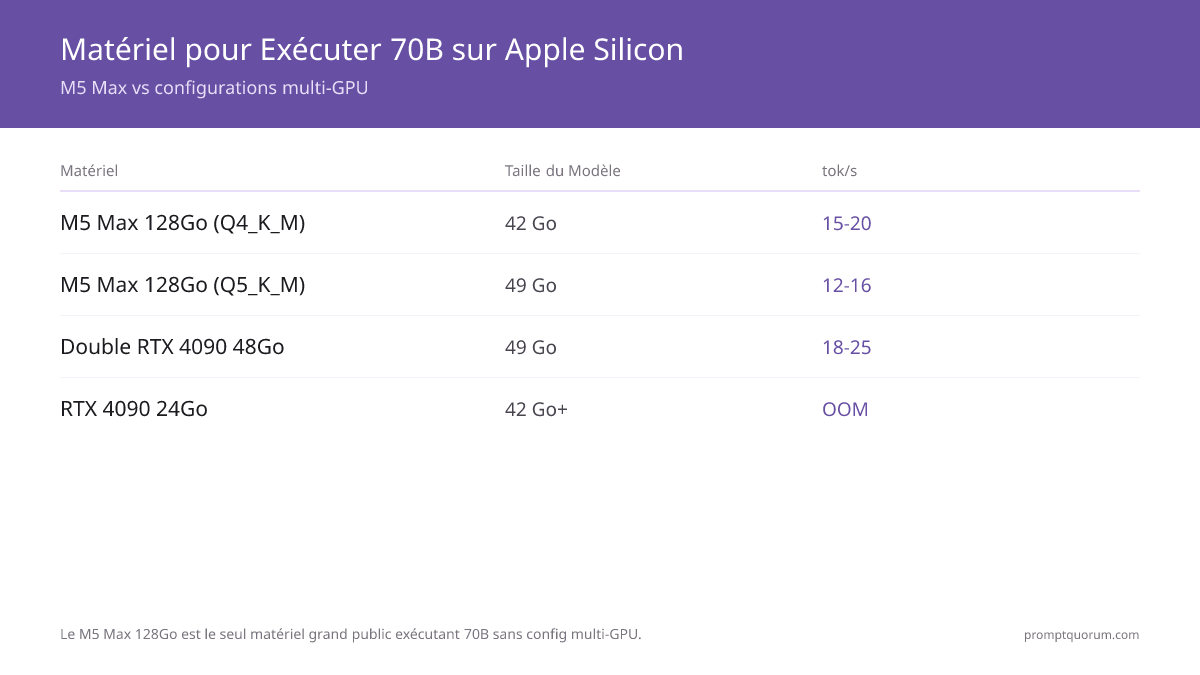
| M5 Max 128GB | Q4_K_M | 42 GB | 15–20 | Bonne | ✓ Oui |
| M5 Max 128GB | Q5_K_M | 49 GB | 12–16 | Très bonne | ✓ Oui |
| M5 Max 128GB | Q8_0 | 74 GB | 8–12 | Sans perte | ✓ Oui |
| M5 Ultra 256GB (projeté) | FP16 | 140 GB | 14–18 | Parfait | ✓ Oui |
| RTX 4090 24GB | Tous | 42 GB+ | — | — | ✗ OOM |
| Dual RTX 3090 48GB | Q4_K_M | 42 GB | 12–15 | Bonne | ✓ Oui (complexe) |
| Dual RTX 4090 48GB | Q5_K_M | 49 GB | 18–25 | Très bonne | ✓ Oui (3 400€+) |
| 4× RTX 3090 96GB | Q8_0 | 74 GB | 12–16 | Sans perte | ✓ Oui (cher) |
M5 Max 128GB est le seul matériel grand public qui exécute les modèles 70B sans configurations multi-GPU complexes. Le M5 Max existe en deux formats : MacBook Pro (disponible depuis mars 2026) et, depuis la mise à jour du Mac Studio par Apple le 25 août 2026, également en Mac Studio de bureau — les deux utilisent la même puce et plafonnent à 128GB de mémoire unifiée et 614GB/s de bande passante. Le Mac Studio (M5 Max) démarre à env. 2 499 €, la configuration 128GB étant plus chère ; cette configuration de bureau remplace toujours les rigs multi-GPU NVIDIA à 5 000–8 000 €. Pour une inférence 70B+ soutenue, privilégiez le Mac Studio au MacBook Pro : la dissipation thermique de bureau maintient les fréquences plus longtemps en charge continue, et il n'y a pas de batterie à gérer lors de longues sessions d'inférence.

Configuration étape par étape : Exécuter 70B sur M5 Max 128GB
Étape 1 : Vérifiez votre matériel. Étape 2 : Installez et configurez Ollama. Étape 3 : Téléchargez le modèle 70B. Étape 4 : Chattez localement ou utilisez l'API.
- 1Installer Ollama
Why it matters: brew install ollama - 2Démarrer le service Ollama
Why it matters: brew services start ollama - 3Télécharger le modèle 70B
Why it matters: ollama pull llama3.1:70b-q5 (environ 30 minutes la première fois) - 4Démarrer le chat
Why it matters: ollama run llama3.1:70b-q5 - 5Utiliser l'API REST (optionnel)
Why it matters: curl http://localhost:11434/api/chat
Qualité : 8B vs 70B vs GPT-5.6
70B est un saut de qualité. Génération de code, mathématiques, raisonnement — 70B surpasse 8B régulièrement de 10–25 points selon les benchmarks standard.
- Génération de code : 70B est 15–20% meilleur que 8B. GPT-5.6 est toujours 10% meilleur, mais l'écart se ferme pour les tâches simples à intermédiaires.
- Mathématiques/GSM8K : 70B Q5 = 95,1. GPT-5.6 = 95,8. La différence est statistiquement insignifiante.
- Raisonnement/BBH : 70B Q5 = 85,3. 8B = 71,0. Énorme différence pour les étapes logiques et la résolution de problèmes.
- Contexte long : 70B comprend et mémorise beaucoup mieux les longs contextes. 8B perd le fil à 5000+ tokens.
Quantification en détail
La quantification réduit la taille du modèle et accélère l'inférence, avec des pertes de qualité minimales.
- Q4_K_M (4-bit) : 42 GB, 15–20 tok/s, perte de qualité 3–5% vs Q8. Excellent pour le chat.
- Q5_K_M (5-bit) : 49 GB, 12–16 tok/s, perte de qualité 1–2%. Recommandé pour la qualité sans sacrifier la vitesse.
- Q8_0 (8-bit) : 74 GB, 8–12 tok/s, pratiquement sans perte. Utilisez uniquement si la qualité est critique.
- FP16 (16-bit) : 140 GB, 6–10 tok/s, précision complète. Seulement possible sur M5 Ultra 256GB.

Modèles alternatifs 70B+
- Llama 3.3 70B : Le modèle standard. Meilleure performance globale. Recommandé.
- Qwen2.5-72B : Légèrement plus rapide que Llama 70B, meilleur pour le code. Recommandé pour les programmeurs.
- DeepSeek 67B : Bonne alternative, compétitif avec Llama. Recommandé si vous utilisez l'API DeepSeek. (DeepSeek a depuis publié DeepSeek-V4 — Flash/Pro — comme nouvelle génération à poids ouverts ; R1/V3 restent utilisables en local.)
- Mixtral 8x22B : Architecture MoE (Mixture of Experts). Plus rapide, mais plus grand (ca. 50 GB Q5). Utilisez si vous voulez parler plus vite.
- Llama 3.3 405B (Q3) : Modèles massifs. Seulement possible sur M5 Ultra 256GB. Attendez M5 Ultra si vous en avez besoin.
70B local vs APIs cloud
Critère | 70B local (M5 Max) | GPT-5.6 (OpenAI) |
|---|---|---|
| Coûts initiaux | 3 299 € | 0 € (paliers gratuits) |
| Coûts mensuels | 0 € (seulement électricité ~5€) | 80–400 € (selon utilisation) |
| Retour sur investissement (mois) | 8–36 mois (utilisation intense) | N/A |
| Protection des données | Complètement local, 0 transfert | Transféré à OpenAI |
| Fonctionnement hors ligne | ✓ Oui | ✗ Non |
| Vitesse (TTFT) | <2 secondes localement | 1–5 secondes API |
70B local est plus économique après 8+ mois d'utilisation régulière (50+ requêtes/jour). Pour la confidentialité/conformité CNIL, c'est le meilleur choix.
Cas d'usage pratiques pour 70B local
- 1Analyse documentaire entreprise
Why it matters: Rapports financiers, contrats, dossiers médicaux — les données sensibles restent sur le Mac. Satisfait les exigences CNIL. - 2Révisions de code pour développeurs
Why it matters: Llama 70B n'est que 10% inférieur à GPT-5.6 pour le code. Analysez la base de code localement, sans envoyer le code source à OpenAI. - 3Recherche scientifique
Why it matters: Analysez les articles, testez les hypothèses, sans accumuler les coûts API. Idéal pour la recherche itérative. - 4Assistant IA axé sur la confidentialité
Why it matters: Analysez les journaux personnels, la planification financière, la santé — entièrement local, pas d'accès tiers. - 5Workflows hors ligne
Why it matters: Journalistes en régions restrictives, médecins en zones rurales sans Internet fiable, installations sécurisées sans réseau.
Optimisation de vitesse : MLX vs Ollama
MLX est le framework ML natif d'Apple et est 15–25% plus rapide qu'Ollama sur le même matériel. M5 Max avec 70B Q5 : Ollama = 12–16 tok/s, MLX = 18–22 tok/s.
- Garder le modèle chaud : Définissez OLLAMA_KEEP_ALIVE=1h (24h pour Mac mini toujours allumé) — évitez 30–60 secondes de surcharge de rechargement par requête.
- Utiliser le streaming : Les utilisateurs voient le premier token en 1–2 secondes au lieu d'attendre 25–40 secondes la réponse complète.
- Réduire max_tokens : Si 200 mots suffisent, définissez max_tokens=200. À 14 tok/s : 200 tokens = 14 secondes, 500 tokens = 36 secondes.
- Compromis vitesse Q4 vs Q5 : Q4 = 15–20 tok/s (25% plus rapide que Q5). La plupart des tâches ont 2–3% de différence de qualité. Q4 pour le chat, Q5 pour le raisonnement.
- Éviter les applications gourmandes en GPU pendant l'inférence — Activity Monitor montre si d'autres processus rivalisent pour la bande passante Metal.
M5 Ultra : confirmé le 25 août 2026 lors de la mise à jour du Mac Studio
Apple a confirmé le M5 Ultra le 25 août 2026, aux côtés d'un Mac Studio renouvelé qui a aussi apporté le M5 Max au bureau. Le M5 Ultra combine deux puces M5 Max via l'architecture UltraFusion d'Apple. Configuration de base : 96GB de mémoire unifiée, CPU 36 cœurs, GPU 80 cœurs, à partir de env. 5 499 €. Configurable jusqu'à 256GB ou 512GB de mémoire unifiée. Les configurations de base sont livrées le 22 septembre 2026 ; la configuration 512GB est livrée fin octobre 2026 et devrait coûter nettement plus de 10 000 €. Le palier 512GB offre assez de mémoire unifiée pour des modèles MoE dont le nombre total de paramètres dépasse largement 70B (même si bien moins de paramètres sont actifs par token que ce total ne le suggère). Aucun benchmark indépendant n'existe encore pour le Mac Studio M5 Max ou M5 Ultra — les chiffres tok/s ci-dessous sont des projections fondées sur la mise à l'échelle de la bande passante du M5 Max, pas des résultats mesurés, et PromptQuorum n'a pas testé ce matériel.
Modèle | M5 Max 128GB | M5 Ultra 256GB (projeté) |
|---|---|---|
| Llama 3.3 70B Q5 | 12–16 tok/s | 24–32 tok/s |
| Llama 3.3 70B Q8 | 8–12 tok/s | 16–24 tok/s |
| Llama 3.3 70B FP16 (sans perte) | ✗ N'adapte pas | 14–18 tok/s |
| Qwen2.5-72B Q8 | 8–12 tok/s | 16–24 tok/s |
| Mixtral 8x22B Q5 | 14–18 tok/s | 28–36 tok/s |
| Llama 3.3 405B Q3 | ✗ N'adapte pas | 4–6 tok/s |
| Llama 3.3 405B Q4 (ca. 200GB) | ✗ N'adapte pas | 3–5 tok/s |
M5 Ultra déverrouille : (1) 70B FP16 sans perte — une première sur du matériel grand public, dès la configuration 256GB. (2) Des modèles de classe 405B. (3) Deux modèles 70B en parallèle. (4) Avec 512GB, de la marge pour des modèles MoE bien au-delà de 70B en paramètres totaux. Prix confirmé : à partir de env. 5 499 € (base 96GB) ; les configurations 256GB et 512GB coûtent plus cher, celle de 512GB devant nettement dépasser 10 000 €. Configurations de base livrées le 22 septembre 2026 ; configuration 512GB fin octobre 2026.
70B Q4 est-il assez bon pour la plupart des tâches ?
Oui. Q4 est la quantification standard industrielle. Par rapport à Q5 environ 3–5% de différence de qualité, imperceptible pour la plupart des chats, écriture et tâches générales. Utilisez Q5 ou Q8 uniquement pour la qualité critique (analyse juridique, révision de code, usage médical).
Puis-je exécuter deux modèles 70B simultanément sur M5 Max 128GB ?
Oui, mais combiné avec un modèle plus petit. 70B Q5 = 49 GB. 128 GB moins 8 GB système = 120 GB disponibles. 70B Q5 (49 GB) + modèle 7–8B (5 GB) = 54 GB, entièrement dans le budget. Deux modèles 70B parallèles nécessitent M5 Ultra 256 GB.
Devrais-je acheter le Mac Studio M5 Max maintenant ou attendre le M5 Ultra ?
Le M5 Ultra est désormais confirmé (annoncé le 25 août 2026, configurations de base livrées à partir du 22 septembre 2026, à partir de env. 5 499 € pour 96GB). Choisissez M5 Ultra si : (1) vous avez besoin de 70B FP16 sans perte, (2) vous avez besoin de modèles de classe 405B, ou (3) vous prévoyez des modèles nécessitant plus de 128GB — la configuration 512GB, livrée fin octobre 2026, permet de très grands modèles MoE. Achetez le Mac Studio M5 Max maintenant (à partir de env. 2 499 €) si 70B répond à vos besoins aujourd'hui et que votre budget est sous 5 000 € — les paliers 256GB et 512GB du M5 Ultra coûtent nettement plus.
Combien plus rapide 70B sur M5 Ultra vs M5 Max ?
Environ 2× plus rapide, basé sur bande passante mémoire doublée (ca. 1 200 GB/s vs 614 GB/s). M5 Max : 70B Q5 = 12–16 tok/s ; M5 Ultra attendu : 24–32 tok/s. Il s'agit d'une projection fondée sur la bande passante — aucun benchmark indépendant du Mac Studio M5 Ultra n'existe encore. M5 Ultra peut aussi exécuter 70B FP16 (sans perte) dès sa configuration 256GB, ce que M5 Max ne peut pas adapter.
Puis-je avoir deux modèles 70B simultanément sur M5 Max 128GB ?
Non, deux modèles 70B complets ne sont pas possibles. Deux 70B Q4 = 84 GB plus système = ca. 95 GB, serré sur 128 GB. M5 Ultra 256 GB peut exécuter deux 70B simultanément ou un 70B + un 34B.
Combien d'espace disque nécessitent les modèles 70B ?
Chaque modèle 70B nécessite 42 GB (Q4), 49 GB (Q5) ou 74 GB (Q8) sur disque. Stocker les trois quantifications d'un modèle : 165 GB. Pour le travail professionnel avec plusieurs modèles 70B, Mac Studio avec 1 TB ou 2 TB SSD est recommandé.
70B local exécuté est-il vraiment aussi bon que GPT-5.6 pour mon cas d'usage spécifique ?
70B Q5 = 86,1 sur MMLU, GPT-5.6 = 88,7 — écart de benchmark 3%. Pour le travail axé sur la confidentialité, utilisation haute fréquence (50€+/mois) ou hors ligne, local gagne automatiquement. Testez avec vos propres invites et vérifiez que ça correspond à votre flux de travail.
Les nouveaux modèles 70B (Llama 4, etc.) fonctionneront-ils sur M5 Max ?
Oui. M5 Max 128 GB peut exécuter des modèles 70B de n'importe quelle architecture en quantification Q4/Q5/Q8. Les nouvelles versions 70B (Llama 4, Qwen3, etc.) apparaissent normalement quelques jours après la sortie sur Ollama. Utilisez simplement ollama pull avec le nouveau nom de modèle.
Dois-je respecter la CNIL en utilisant 70B local sur M5 Max ?
Oui et non. L'inférence locale satisfait les exigences de résidence des données et de traitement des données (CNIL/RGPD). Le modèle lui-même doit être sous licence open-source (Llama est MIT, Qwen est Apache 2.0 — tous deux conformes). L'avantage principal : toutes les données sensibles restent sur l'appareil, la conformité est garantie automatiquement.
Quel est le coût comparé aux APIs GPT-5.6 mensuelles pour une équipe de 5–15 personnes ?
Très économique. Investissement initial : 3 299 € pour Mac Studio M5 Max. Coûts API mensuels pour 10 personnes avec utilisation intense : ca. 1 000–4 000 €/mois. Retour sur investissement en 1–3 mois avec 50+ requêtes/personne/jour. Après le retour : 0 € coûts supplémentaires (seulement électricité ~5€/mois), tandis que la protection des données (CNIL conforme) est garantie.