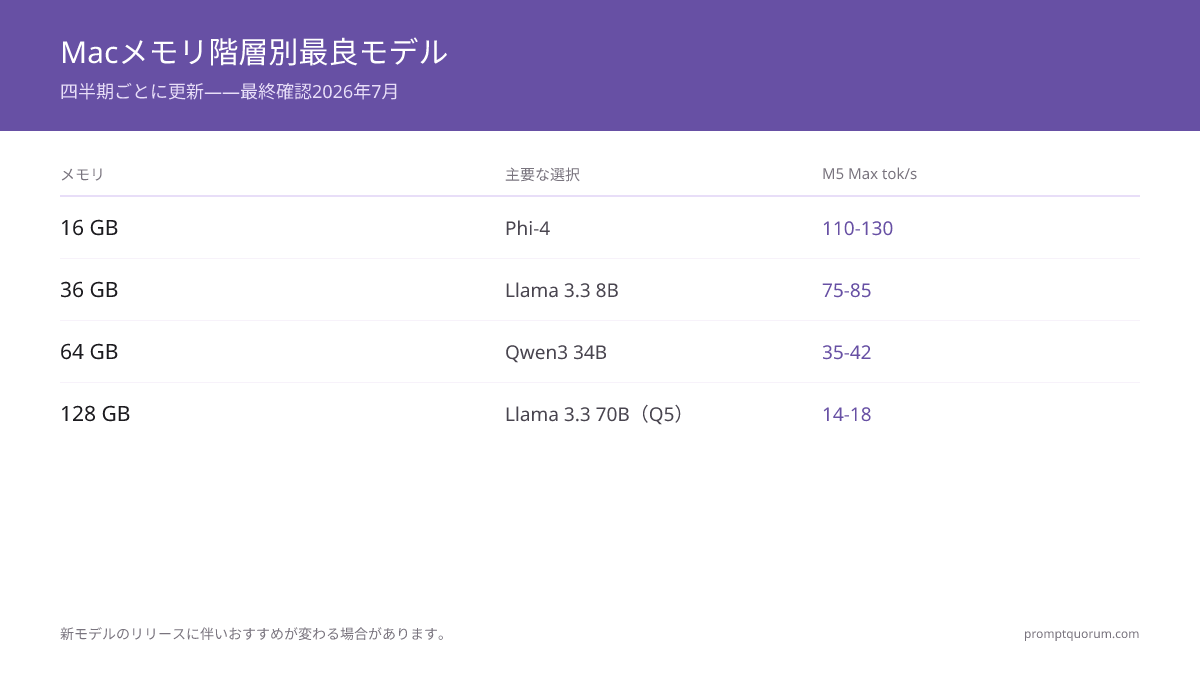
Macメモリ別ベストモデル推奨
最終確認:2026-08-27。Appleが2026年8月25日に発表した刷新内容:Mac miniはM6(最大32GB、899ドルから)とM5 Pro(最大64GB、1,699ドルから)の構成に、Mac StudioはM5 Max(最大128GB、2,499ドルから)とM5 Ultra(最大512GB、5,499ドルから)の構成になりました。出荷は2026年9月22日から(512GB構成は2026年10月下旬出荷)。モデル推奨は新モデルのリリースとともに変わる可能性があります。四半期ごとに更新。
メモリ | 第一選択 | 量子化 | サイズ | M5 Pro tok/s | M5 Max tok/s | 代替 |
|---|---|---|---|---|---|---|
| 16 GB | Phi-4 | Q4_K_M | 2.5 GB | 60–70 | 110–130 | Llama 3.1 8B Q4(ギリギリ) |
| 36 GB | Llama 3.1 8B | Q8 | 8.5 GB | 38–45 | 75–85 | Qwen3 14B Q4(8.5 GB) |
| 48 GB | Qwen3 14B | Q8 | 16 GB | 25–30 | 50–60 | Mixtral 8x7B Q4(26 GB) |
| 64 GB | Qwen3 32B | Q5 | 24 GB | 18–22 | 35–42 | Mixtral 8x7B Q5(33 GB) |
| 96 GB | Llama 3.3 70B | Q4 | 42 GB | 10–13 | 20–25 | — |
| 128 GB | Llama 3.3 70B | Q5 | 49 GB | 8–11 | 14–18 | — |
| 128 GB | Llama 3.3 70B | Q8 | 74 GB | N/A | 9–12 | 最高品質、M5 Maxのみ |
サイズはGGUFフォーマット。MLX 4ビット相当品は同等です。36GB階層はMac miniやMac StudioではなくMacBook ProのM-Pro/M-Max基本構成に対応します——2026年8月の刷新以降、Mac miniとMac Studioは32GBから直接64GBへ移行します。tok/sの値は推定値であり、PromptQuorumが独自に測定したものではありません。

モデル品質ベンチマーク(2026標準テスト)
モデル | MMLU | HumanEval | GSM8K | 平均 | 備考 |
|---|---|---|---|---|---|
| Llama 3.1 8B | 73.0 | 72.6 | 84.5 | 76.7 | 万能型 |
| Qwen3 14B | 79.7 | 83.5 | 90.2 | 84.5 | 強力な推論力 |
| Qwen3 32B | 83.3 | 88.4 | 93.0 | 88.2 | ベスト中型モデル |
| Mixtral 8x7B | 70.6 | 40.2 | 60.4 | 57.1 | MoEアーキテクチャ |
| Llama 3.3 70B | 86.0 | 80.5 | 95.1 | 87.2 | ベスト汎用モデル |
参考値です。各モデルのモデルカードをご確認ください。PromptQuorumはこれらのベンチマークを独自に実施していません。

ユースケース別ベストモデル(2026)
ユースケース | 36GB Mac向けベスト | 64GB Mac向けベスト | 128GB Mac向けベスト |
|---|---|---|---|
| コーディング(一般) | Llama 3.1 8B | DeepSeek Coder V2 16B | Llama 3.3 70B |
| コーディング(Python) | DeepSeek Coder V2 Lite | DeepSeek Coder V2 16B | DeepSeek Coder V2 236B |
| 長文ライティング | Llama 3.1 8B Q8 | Qwen3 32B Q5 | Llama 3.3 70B Q5 |
| チャット / 会話 | Mistral Small | Mixtral 8x7B | Llama 3.3 70B |
| 推論 / 数学 | Qwen3 14B | Qwen3 32B | Qwen3 32B |
| RAG / Q&A | Llama 3.1 8B + nomic-embed | Llama 3.1 8B + bge-large | Llama 3.3 70B + bge-large |
| ビジョン / マルチモーダル | LLaVA 7B | Llama 3.2 Vision 11B | Llama 3.2 Vision 90B |
| 翻訳 | Qwen3 14B | Qwen3 32B | Aya Expanse 32B |
| 要約 | Llama 3.1 8B | Qwen3 32B | Llama 3.3 70B |
| コードレビュー | DeepSeek Coder V2 Lite | DeepSeek Coder V2 16B | Llama 3.3 70B |
専門モデルは特定タスクで汎用モデルを上回ることが多い。
ユーザータイプ別の実際の設定
💡ヒント: インディー開発者(Mac Mini M5 Pro 64GB、約255,000円) - コーディング:DeepSeek Coder V2 Lite(16B Q4、10 GB) - 執筆:Llama 3.1 8B Q8(8.5 GB)でドキュメントとメール - 常時稼働:`OLLAMA_MAX_LOADED_MODELS=2`で両モデルをウォーム状態に - 1日のコスト:0円(vs Copilot + ChatGPT月4,000–15,000円)
💡ヒント: プライバシー重視のプロ(MacBook Pro M5 Pro 48GB、約380,000円) - メイン:一般業務にLlama 3.1 8B Q8 - 機密:法律/医療/金融文書にQwen3 14B Q5 - 出張:飛行機や安全施設でオフライン動作 - 推論はローカルで実行されますが、設定によってはアプリが更新確認を行う場合があります - 一般的な情報であり、法律・医療・金融上の助言ではありません。判断は有資格者が行ってください
💡ヒント: 研究者 / MLエンジニア(Mac Studio M5 Max 128GB、約375,000円) - メイン:品質のためLlama 3.3 70B Q5(49 GB) - 専門:非英語研究にQwen3 32B Q4 - コーディング:DeepSeek Coder V2 16B - ビジョン:論文の図のためLlama 3.2 Vision 11B - 4モデルを同時にロード
💡ヒント: 家族用AIサーバー(Mac Mini M5 Pro 64GB、常時稼働) - 音声アシスタント:Llama 3.1 8B + Whisper + Piper - RAG:埋め込みによる家族文書Q&A - REST API経由で家族のコーディング支援 - 電力コスト:約5,000円/年 - 代替:4人分のChatGPT Plus = 約150,000円/年
2026年に避けるべきモデル(その理由)
⚠️注意: Llama 2(全サイズ)は推奨されなくなりました — Llama 3.3に置き換えられており、標準的なリーダーボードでは新しいリリースと比較して著しく弱い結果を示しています。古いチュートリアルにまだ登場する — 従わないこと。代替:Llama 3.1 8B。
⚠️注意: Vicuna、Alpaca、WizardLMは避ける — 2023年のコミュニティファインチューン。現代のベースモデル(Llama 3.3、Qwen3)が同等以上のパフォーマンス。代替:Qwen3 14BまたはLlama 3.1 8B。
⚠️注意: Falcon 180Bは避ける — コンシューマーApple Siliconには収まらない。Llama 3.3 70B(より小型)が上回る。代替:Llama 3.3 70B Q5。
⚠️注意: コンシューマーハードウェアでのFP16量子化は避ける — Llama 3.3 70B FP16 = 140GB、どのMacにも収まらない。Q5に対する品質向上は1%未満。代替:Q4_K_MまたはQ5_K_M。
⚠️注意: 純粋なベースモデル(instructバリアントなし)は避ける — ベースモデルはテキストを補完するが指示に従わない。"-instruct"または"-chat"サフィックスを探すこと。代替:同じモデルのinstructバリアント。
⚠️注意: 最近の開発活動が少ないモデルには注意が必要 — StableLM、RedPajama、MPT、Pythia:最近のコミット活動が少ない(2026年中頃時点)。定期的なアップデートがあるMeta、Alibaba、Mistral、Microsoftのモデルを使用。
モデルフォーマットクイックリファレンス
フォーマット | 使用ツール | オリジナル比サイズ |
|---|---|---|
| GGUF Q4_K_M | Ollama、llama.cpp | FP16の約30% |
| GGUF Q5_K_M | Ollama、llama.cpp | FP16の約35% |
| GGUF Q8_0 | Ollama、llama.cpp | FP16の約50% |
| MLX 4-bit | MLXフレームワーク | FP16の約30% |
| MLX 8-bit | MLXフレームワーク | FP16の約50% |
| FP16(オリジナル) | 全フレームワーク | 100% |
この記事のサイズは特記なき限りGGUF Q4_K_M。MLX 4ビット相当品は同様のサイズ。正確なバイト数はHuggingFaceのモデルカードを確認。llama.cppはMetalバックエンド上でGGUFを直接実行し、Ollamaも内部でこれを使用しています——MLXはApple独自のフレームワークで、同じチップ上でもMLXネイティブビルドではより高速になる傾向があります。LM StudioはGGUFとMLXの両方をサポートし、UIからモデルごとにバックエンドを切り替えられます。
クイックリファレンス:これらのモデルのダウンロード
# 16 GB Mac
ollama pull phi4

# 36 GB Mac (いずれか選択)
ollama pull llama3.1:8b
ollama pull qwen3:14b
ollama pull mistral-small

# 64 GB Mac
ollama pull qwen3:32b
ollama pull mixtral:8x7b

# 128 GB Mac
ollama pull llama3.3:70b

# 専門モデル
ollama pull deepseek-coder-v2:16b   # コーディング
ollama pull llama3.2-vision:11b     # ビジョン
ollama pull aya-expanse:32b # 翻訳2つの異なるモデルを同時に実行できますか?
はい、`OLLAMA_MAX_LOADED_MODELS=2`を環境変数に設定します。64GBで8B + 32Bを同時実行できます。
初心者に最適なモデルはどれですか?
Llama 3.1 8B。広く利用可能で、良好な出力品質、実績があります。M1+ Macで動作します。
Mixtral 8x7BはLlama 8Bより高速ですか?
おそらく高速ではありません。Mixtral 8x7BはQ4で約26 GBと、Llama 3.1 8B Q8(8.5 GB)よりかなり大きいため、上の表のLlama 3.1 8B Q8の値(M5 Pro向けの推定値で、PromptQuorumが独自に測定したものではありません)より低いtok/sを想定してください。どちらが優れているかはタスク次第です。
2026年のベストローカルLLMは何ですか?
Apple Silicon上のほとんどのユーザーに:Qwen3(Macに収まる任意のサイズ)は有力な選択肢で、128GB MacではLlama 3.3 70Bも有力です。16GB未満:Phi-4は小型ながら有能な選択肢です。
MacでLlama 3.1 405Bを実行できますか?
非常に大容量のユニファイドメモリが必要です。Llama 3.1 405BはQ4量子化でも200GB以上必要です。従来の512GB構成のMac StudioでもQ4の405Bを保持できます。Appleが2026年8月25日に発表したMac Studio M5 Ultra(出荷は2026年9月22日から、512GB構成は2026年10月下旬出荷)は最大512GBのユニファイドメモリを5,499ドルから搭載し、メモリ帯域の余裕も加わります。
ローカル使用ではQwenはLlamaより優れていますか?
結果はタスクやモデルサイズによって異なります。ご自身の用途に合わせてモデルカードを比較してください。Llamaはより広いコミュニティサポートとファインチューンが豊富。ほとんどのユーザーは違いに気付かないでしょう — 可用性とファインチューンエコシステムに基づいて選択してください。
実際に役立つ最小のモデルは何ですか?
Phi-4 Mini(3.8Bパラメータ)。チャットやQ&Aでは、サイズの割に有能です。コーディングや複雑な推論はLlama 3.1 8BやQwen3 14Bに進んでください。
vLLMはApple Siliconで動作しますか?
vLLMのMetalサポートはCUDAパスに比べて限定的です — vLLMをNvidia GPUで魅力的にしているスループットやバッチ処理の最適化は、Macにはほとんど当てはまりません。Apple SiliconではOllama(llama.cpp/Metal)やLM Studio(GGUF/MLX)の方がシングルユーザーのtok/sが高く、セットアップも簡単です。vLLMを検討すべきは、MacとあわせてLinux/NvidiaマシンでLLMを提供し、多数の同時リクエストを処理する場合のみです。
MacBook Air M5では何が実行できますか?
MacBook Air M5はファンレス設計で、ユニファイドメモリは通常16〜32GB — 上記の表では16GBまたは36GBティアのMacとして扱ってください:Phi-4は快適に動作し、24GB以上あればLlama 3.1 8B Q8も可能です。ファンがないため、長時間の連続生成ではわずかにスロットリングする可能性があります — この記事のM5 Pro tok/s範囲の下限を目安にしてください。
128GB RAMを搭載したMacBook Pro M5 Maxに最適な構成は?
日常使いにはLlama 3.3 70B Q5(49 GB)。`OLLAMA_MAX_LOADED_MODELS=2`で2つ目のモデル — Qwen3 14B Q5またはDeepSeek Coder V2 16B — を同時にロードする余裕もあります。70B Q5では約14〜18 tok/sが目安です。最高品質を求め、約9〜12 tok/sを許容できるならLlama 3.3 70B Q8(74 GB)も収まります。