Melhores recomendações de modelos por memória do Mac
Última verificação: 2026-08-27. Atualização da Apple em 25 de agosto de 2026: o Mac mini passa a vir em configurações M6 (até 32 GB, a partir de US$ 899) e M5 Pro (até 64 GB, a partir de US$ 1.699); o Mac Studio passa a vir em M5 Max (até 128 GB, a partir de US$ 2.499) e M5 Ultra (até 512 GB, a partir de US$ 5.499). Todos com envio a partir de 22 de setembro de 2026 (a configuração de 512 GB chega no final de outubro de 2026). As recomendações podem mudar com novos lançamentos. Atualizamos esta página trimestralmente.
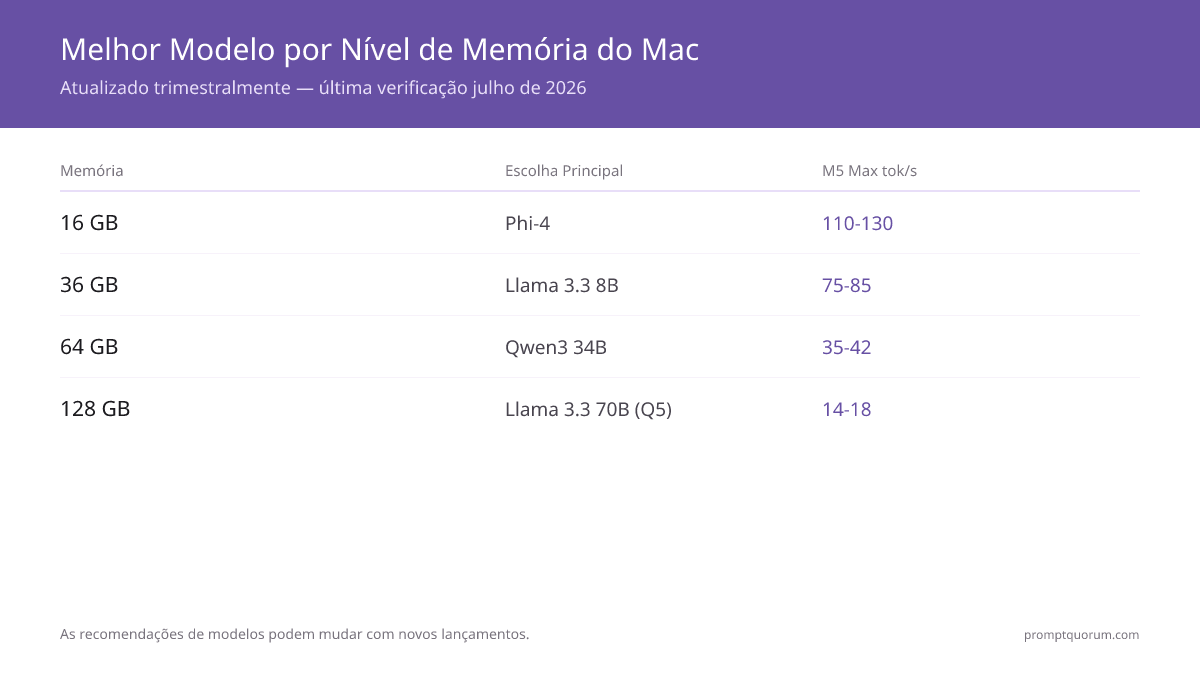
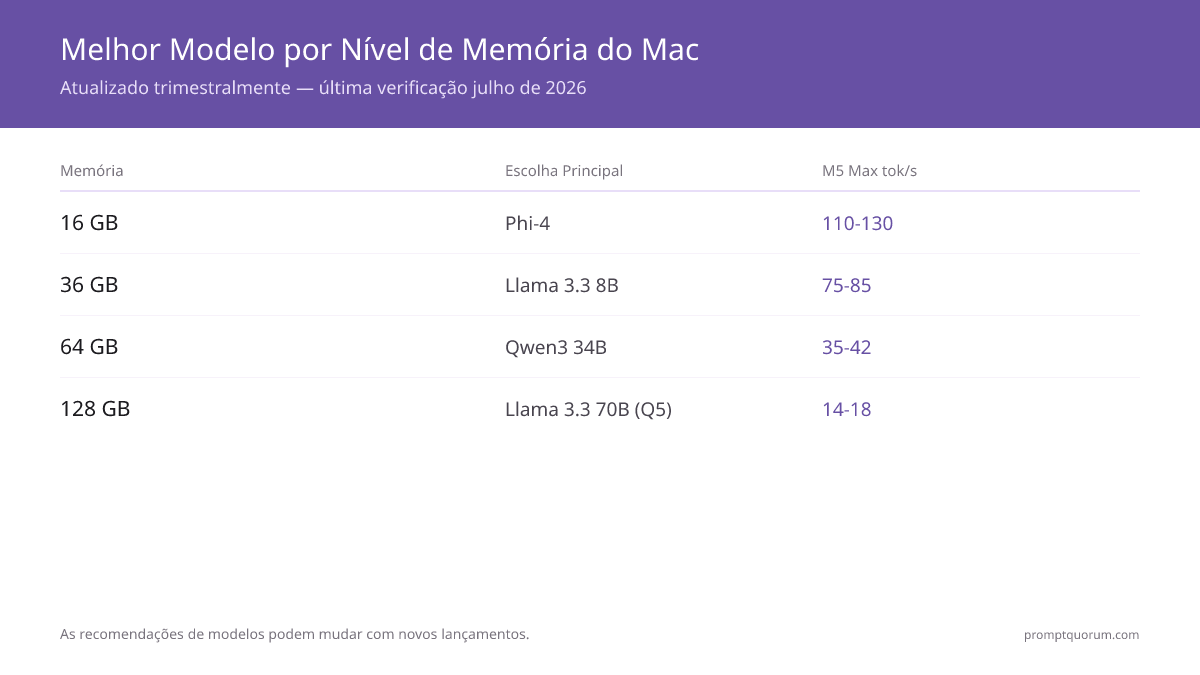
Memória | Escolha principal | Quantização | Tamanho | M5 Pro tok/s | M5 Max tok/s | Alternativa |
|---|---|---|---|---|---|---|
| 16 GB | Phi-4 | Q4_K_M | 2,5 GB | 60–70 | 110–130 | Llama 3.1 8B Q4 (no limite) |
| 36 GB | Llama 3.1 8B | Q8 | 8,5 GB | 38–45 | 75–85 | Qwen3 14B Q4 (8,5 GB) |
| 48 GB | Qwen3 14B | Q8 | 16 GB | 25–30 | 50–60 | Mixtral 8x22B Q4 (26 GB) |
| 64 GB | Qwen3 34B | Q5 | 24 GB | 18–22 | 35–42 | Mixtral 8x22B Q5 (32 GB) |
| 96 GB | Llama 3.3 70B | Q4 | 42 GB | 10–13 | 20–25 | Qwen3 72B Q4 (44 GB) |
| 128 GB | Llama 3.3 70B | Q5 | 49 GB | 8–11 | 14–18 | Qwen3 72B Q5 (51 GB) |
| 128 GB | Llama 3.3 70B | Q8 | 74 GB | N/A | 9–12 | Melhor qualidade, só M5 Max |
Os tamanhos são em formato GGUF. Os equivalentes MLX 4-bit são comparáveis. Os preços variam conforme o país; no Brasil, a Apple cobra valores bem mais altos em reais. O nível de 36 GB corresponde às configurações básicas do MacBook Pro M-Pro/M-Max, não ao Mac mini nem ao Mac Studio — desde a atualização de agosto de 2026, o Mac mini e o Mac Studio pulam diretamente de 32 GB para 64 GB.
Benchmarks de qualidade de modelos (testes padrão 2026)
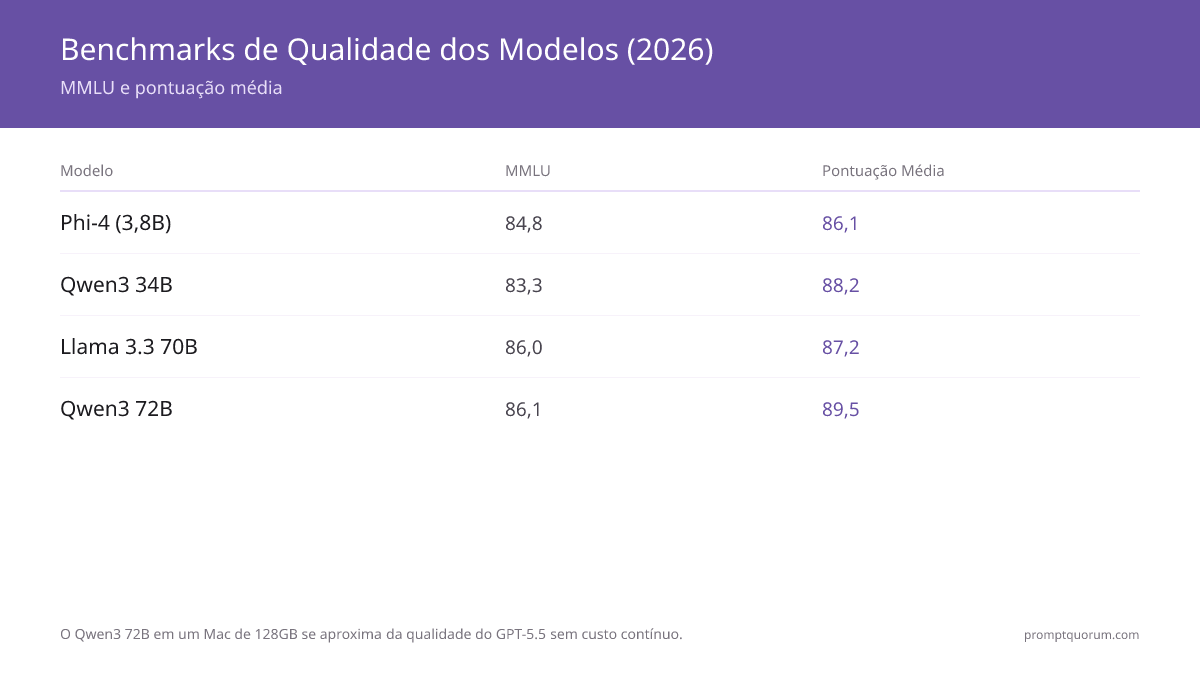
Modelo | MMLU | HumanEval | GSM8K | Média | Notas |
|---|---|---|---|---|---|
| Phi-4 (3,8B) | 84,8 | 82,6 | 91,0 | 86,1 | Melhor modelo pequeno |
| Llama 3.1 8B | 73,0 | 72,6 | 84,5 | 76,7 | Bom para tudo |
| Qwen3 14B | 79,7 | 83,5 | 90,2 | 84,5 | Raciocínio sólido |
| Mistral Small | 60,1 | 30,5 | 50,0 | 46,9 | Antigo, mas rápido |
| Qwen3 34B | 83,3 | 88,4 | 93,0 | 88,2 | Melhor tamanho médio |
| Mixtral 8x22B | 70,6 | 40,2 | 60,4 | 57,1 | Arquitetura MoE |
| Llama 3.3 70B | 86,0 | 80,5 | 95,1 | 87,2 | Melhor geral |
| Qwen3 72B | 86,1 | 86,6 | 95,8 | 89,5 | Raciocínio de topo |
| Llama 3.3 405B | 88,6 | 89,0 | 96,8 | 91,5 | Não cabe localmente |
| GPT-5.5 (referência) | 88,7 | 90,2 | 95,8 | 91,6 | Referência na nuvem |
O Qwen3 72B em um Mac de 128 GB se aproxima da qualidade do GPT-5.5 com custo contínuo zero. Este é o avanço mais importante em IA local em 2026.
Melhores modelos por caso de uso (2026)
Caso de uso | Melhor para Mac 36 GB | Melhor para Mac 64 GB | Melhor para Mac 128 GB |
|---|---|---|---|
| Programação (geral) | Llama 3.1 8B | DeepSeek Coder V2 16B | Llama 3.3 70B |
| Programação (Python) | DeepSeek Coder V2 Lite | DeepSeek Coder V2 16B | DeepSeek Coder V2 236B |
| Escrita longa | Llama 3.1 8B Q8 | Qwen3 34B Q5 | Llama 3.3 70B Q5 |
| Chat / conversa | Mistral Small | Mixtral 8x22B | Llama 3.3 70B |
| Raciocínio / matemática | Qwen3 14B | Qwen3 34B | Qwen3 72B |
| RAG / perguntas e respostas | Llama 3.1 8B + nomic-embed | Llama 3.1 8B + bge-large | Llama 3.3 70B + bge-large |
| Visão / multimodal | LLaVA 7B | Llama 3.2 Vision 11B | Llama 3.2 Vision 90B |
| Tradução | Qwen3 14B | Qwen3 34B | Aya Expanse 32B |
| Resumo | Llama 3.1 8B | Qwen3 34B | Llama 3.3 70B |
| Revisão de código | DeepSeek Coder V2 Lite | DeepSeek Coder V2 16B | Llama 3.3 70B |
Os modelos especializados costumam superar os gerais em tarefas concretas. O DeepSeek Coder supera o Llama 3.3 em código mesmo quando o Llama é o modelo maior.
Configurações reais por tipo de usuário
💡Dica: Desenvolvedor independente (Mac Mini M5 Pro 64 GB, US$ 1.699) - Programação: DeepSeek Coder V2 Lite (16B Q4, 10 GB) - Escrita: Llama 3.1 8B Q8 (8,5 GB) para documentação e e-mails - Sempre ativo: ambos os modelos em cache com `OLLAMA_MAX_LOADED_MODELS=2` - Custo diário: US$ 0 (vs US$ 30–100/mês por Copilot + ChatGPT) - Os preços variam conforme o país; no Brasil, a Apple cobra mais.
💡Dica: Profissional focado em privacidade (MacBook Pro M5 Pro 48 GB, US$ 2.500) - Principal: Llama 3.1 8B Q8 para trabalho geral - Sensível: Qwen3 14B Q5 para documentos jurídicos/médicos/financeiros - Viagens: funciona offline em aviões e ambientes seguros - Nenhum dado sai do computador - Os preços variam conforme o país; no Brasil, a Apple cobra mais.
💡Dica: Pesquisador / Engenheiro de ML (Mac Studio M5 Max 128 GB, US$ 2.499) - Principal: Llama 3.3 70B Q5 (49 GB) para qualidade - Especializado: Qwen3 72B Q4 para pesquisa em outros idiomas - Programação: DeepSeek Coder V2 16B - Visão: Llama 3.2 Vision 11B para figuras de artigos - Os quatro modelos carregados simultaneamente - Os preços variam conforme o país; no Brasil, a Apple cobra mais.
💡Dica: Servidor de IA familiar (Mac Mini M5 Pro 64 GB, sempre ligado) - Assistente de voz: Llama 3.1 8B + Whisper + Piper - RAG: perguntas e respostas sobre documentos da família com embeddings - Ajuda de programação para os familiares via REST API - Custo de energia: ~US$ 35/ano - Substitui: ChatGPT Plus para 4 pessoas = US$ 1.000/ano - Os preços variam conforme o país; no Brasil, a Apple cobra mais.
Modelos que você deve evitar em 2026 (e por quê)
⚠️Aviso: Llama 2 (qualquer tamanho) já não é recomendado — substituído por Llama 3.3; os leaderboards padrão mostram resultados notavelmente mais fracos em comparação com as versões mais recentes. Ainda aparece em tutoriais antigos — não os siga. Substitua por: Llama 3.1 8B.
⚠️Aviso: Evite Vicuna, Alpaca, WizardLM — Fine-tunes da comunidade de 2023. Os modelos base modernos (Llama 3.3, Qwen3) igualam ou superam o desempenho deles. Substitua por: Qwen3 14B ou Llama 3.1 8B.
⚠️Aviso: Evite Falcon 180B — Não cabe em Apple Silicon de consumo. O Llama 3.3 70B (menor) o supera. Substitua por: Llama 3.3 70B Q5.
⚠️Aviso: Evite a quantização FP16 em hardware de consumo — Llama 3.3 70B FP16 = 140 GB, não cabe em nenhum Mac. O ganho de qualidade frente ao Q5 é menor que 1%. Substitua por: Q4_K_M ou Q5_K_M.
⚠️Aviso: Evite os modelos base puros (sem variante instruct) — Os modelos base completam texto, mas não seguem instruções. Procure o sufixo "-instruct" ou "-chat". Substitua por: a variante instruct do mesmo modelo.
⚠️Aviso: Tenha cautela com modelos com baixa atividade recente — StableLM, RedPajama, MPT, Pythia: com pouca atividade de desenvolvimento recente (meados de 2026). Use modelos da Meta, Alibaba, Mistral, Microsoft com atualizações regulares.
Referência rápida de formatos de modelo
Formato | Usado por | Tamanho vs original |
|---|---|---|
| GGUF Q4_K_M | Ollama, llama.cpp | ~30% do FP16 |
| GGUF Q5_K_M | Ollama, llama.cpp | ~35% do FP16 |
| GGUF Q8_0 | Ollama, llama.cpp | ~50% do FP16 |
| MLX 4-bit | Framework MLX | ~30% do FP16 |
| MLX 8-bit | Framework MLX | ~50% do FP16 |
| FP16 (original) | Todos os frameworks | 100% |
Os tamanhos neste artigo são GGUF Q4_K_M salvo indicação em contrário. Os equivalentes MLX 4-bit têm tamanho similar. Para bytes exatos, consulte a ficha do modelo no HuggingFace. O llama.cpp roda GGUF diretamente no backend Metal e é o que o Ollama usa por baixo dos panos — o MLX é o framework da própria Apple e costuma ser mais rápido para builds nativas em MLX no mesmo chip. O LM Studio suporta tanto GGUF quanto MLX e permite trocar de backend por modelo direto na interface.
Referência rápida: baixar estes modelos
# Mac 16 GB
ollama pull phi4

# Mac 36 GB (escolha um)
ollama pull llama3.1:8b
ollama pull qwen3:14b
ollama pull mistral-small

# Mac 64 GB
ollama pull qwen3:34b
ollama pull mixtral:8x22b

# Mac 128 GB
ollama pull llama3.3:70b
ollama pull qwen3:72b

# Modelos especializados
ollama pull deepseek-coder-v2:16b   # programação
ollama pull llama3.2-vision:11b     # visão
ollama pull aya-expanse:32b # traduçãoPosso rodar dois modelos diferentes ao mesmo tempo?
Sim, defina `OLLAMA_MAX_LOADED_MODELS=2` nas variáveis de ambiente. Com 64 GB você pode rodar 8B + 34B simultaneamente.
Qual modelo é melhor para iniciantes?
Llama 3.1 8B. Amplamente disponível, boa qualidade de saída e histórico comprovado. Funciona em qualquer Mac M1+.
O Mixtral 8x22B é mais rápido que o Llama 8B?
Não, é um pouco mais lento (40–50 tok/s vs 50–60 tok/s no M5 Pro). Mas o raciocínio é superior.
Qual é o melhor LLM local em 2026?
Para a maioria dos usuários em Apple Silicon: o Qwen3 (qualquer tamanho que caiba no seu Mac) lidera atualmente os benchmarks de qualidade. O Llama 3.3 70B é comparável em Macs de 128 GB. Abaixo de 16 GB: o Phi-4 supera a categoria com 3,8B parâmetros, igualando modelos 8B de 2024.
Posso rodar o Llama 3.3 405B em um Mac?
Nos Macs de gerações anteriores, não. O Llama 3.3 405B exige mais de 200 GB mesmo com quantização Q4. O Mac Studio M5 Ultra da Apple, anunciado em 25 de agosto de 2026 (com envio a partir de 22 de setembro de 2026; a configuração de 512 GB chega no final de outubro de 2026), oferece até 512 GB de memória unificada a partir de US$ 5.499 — margem suficiente para rodar o 405B em quantização Q4 pela primeira vez em hardware de consumo da Apple.
O Qwen é melhor que o Llama para uso local?
Na maioria das tarefas, o Qwen3 supera ligeiramente o Llama 3.3 com o mesmo número de parâmetros em benchmarks (1–3 pontos no MMLU). O Llama tem uma comunidade maior e mais fine-tunes disponíveis. A maioria dos usuários não notará a diferença — escolha conforme a disponibilidade e o ecossistema de fine-tunes.
Qual é o menor modelo que realmente é útil?
Phi-4 com 3,8B parâmetros. Obtém 84,8 no MMLU — igualando alguns modelos 8B de 2024. Para chat e perguntas e respostas é surpreendentemente capaz. Para programação ou raciocínio complexo, passe para o Llama 3.1 8B ou Qwen3 14B.
O vLLM roda em Apple Silicon?
O suporte do vLLM ao Metal é limitado se comparado ao caminho CUDA — as otimizações de throughput e batching que tornam o vLLM atraente em GPUs Nvidia praticamente não se aplicam no Mac. Para Apple Silicon, o Ollama (llama.cpp/Metal) ou o LM Studio (GGUF/MLX) entregam melhor tok/s para uso individual e configuração mais simples. Considere o vLLM só se você estiver atendendo muitas requisições simultâneas em uma máquina Linux/Nvidia ao lado do seu Mac.
O que um MacBook Air M5 consegue rodar?
O MacBook Air M5 vem em design sem ventoinha e tipicamente com 16–32 GB de memória unificada, então trate-o como um Mac de nível 16 GB ou 36 GB conforme a tabela acima: Phi-4 tranquilamente, Llama 3.1 8B Q8 se você tiver 24 GB ou mais. Gerações longas e contínuas podem sofrer leve throttling sem ventoinha — espere a faixa inferior dos valores de tok/s do M5 Pro citados neste artigo.
Qual é a melhor configuração para um MacBook Pro M5 Max com 128 GB de RAM?
Llama 3.3 70B Q5 (49 GB) para uso diário, com folga para manter um segundo modelo — Qwen3 14B Q5 ou DeepSeek Coder V2 16B — carregado simultaneamente via `OLLAMA_MAX_LOADED_MODELS=2`. Espere ~14–18 tok/s no 70B Q5. Se você quiser qualidade máxima e tolerar ~9–12 tok/s, o Llama 3.3 70B Q8 (74 GB) também cabe.