Key Takeaways
- Qwen3.8-27B é o melhor em geral em hardware de consumo: 61,7 SWE-bench Pro (melhor modelo denso), cabe em 24 GB a Q4.
- Llama 4 Scout 17B (MoE): melhor para contexto longo (10M tokens) e multimodal — mas requer ~55 GB de VRAM a Q4, não cabe em uma GPU de consumo de 24 GB com quantizações normais.
- Mistral Small 3.1 24B: melhor qualidade por GB de RAM (14 GB), 79% MMLU — ideal para hardware com pouca memória.
- Para programação: Qwen3.8-27B (denso) ou Devstral Small 2 (agentivo, multi-arquivo).
- Para autocompletar em IDE: Codestral 22B.
- Todos via Ollama: `ollama pull qwen3` / `ollama pull llama4` / `ollama pull mistral`.
Qwen3.8-27B vence na programação em hardware de consumidor (61,7 SWE-bench Pro, cabe em 24 GB no Q4); Llama 4 Scout lidera em contexto longo e multimodal (10M de contexto, MoE, ~55 GB no Q4).
Estas são três das famílias de modelos de IA open source mais populares para rodar localmente. Qwen3 (Alibaba) se destaca em programação, Llama 4 (Meta) lida com documentos muito longos e imagens, e Mistral (IA francesa) oferece modelos compactos eficientes. Todos são gratuitos e rodam offline.
•Info: 📌 Procurando a comparação anterior? Vá para os benchmarks legados de Mistral 24B vs Qwen3 14B vs Llama 3.1 8B mais abaixo.
Qual família de modelos de pesos abertos escolher?
Modelos da geração anterior (Qwen3, Llama 3.3) continuam disponíveis no Ollama e ainda são muito usados. Esta comparação foca nos modelos da geração atual. Pronto para rodar um? Guia completo de instalação local do Qwen →
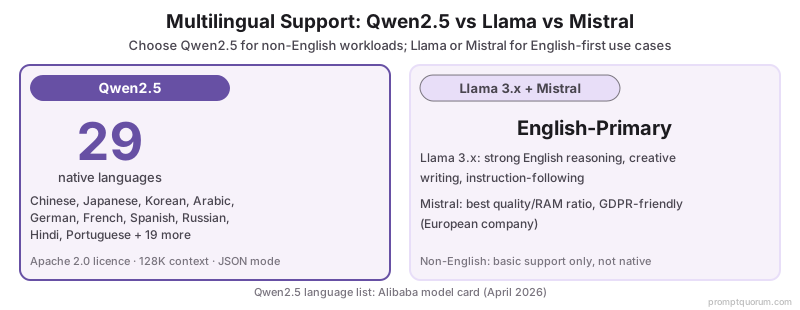
Família | Desenvolvedor | Versões atuais | Licença |
|---|---|---|---|
| Qwen3 | Alibaba | Qwen3 (abril de 2026), Qwen3.8-27B (61,7 SWE-bench Pro, segundo a Qwen) | Apache 2.0 (maioria dos tamanhos) |
| Llama 4 | Meta | Scout (17B ativos/109B MoE, 16 especialistas, contexto de 10M, multimodal, ~55 GB de VRAM em Q4), Maverick (17B ativos/400B MoE); legado: 3.3 70B | Llama Community (personalizada) |
| Mistral | Mistral AI | Small 3.1 (24B), Devstral Small 2 (agêntico), Codestral 22B (FIM/IDE) | Apache 2.0 (maioria dos tamanhos) |
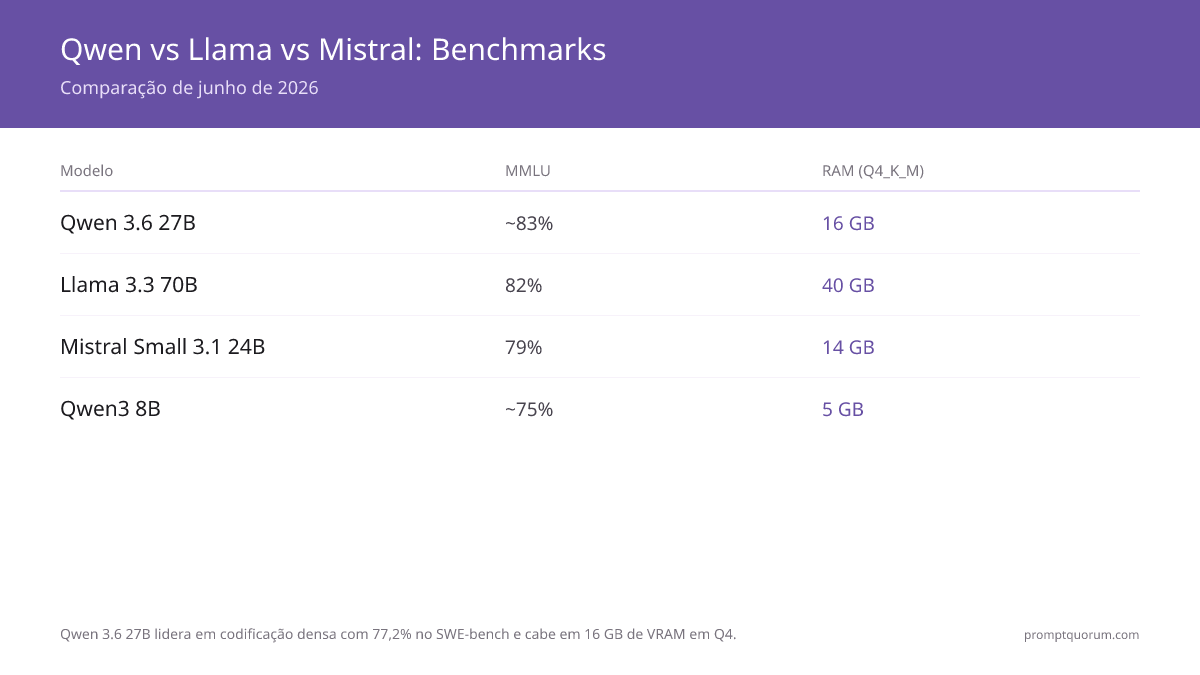
Como esses modelos se comparam nos benchmarks?
O SWE-bench (resolução de issues reais do GitHub) é o principal benchmark de programação em 2026 para avaliação prática. Ele testa mudanças em vários arquivos, compreensão da base de código e escrita de testes. O HumanEval (função Python única) continua útil para comparação, mas é secundário. MMLU e MATH avaliam conhecimento geral e raciocínio. Os benchmarks do Llama 4 Scout são limitados pelo lançamento recente e pela complexidade do MoE. Traços indicam benchmarks ainda não publicados ou não aplicáveis. As pontuações são divulgadas pelos fabricantes com protocolos diferentes; SWE-bench Pro e Verified são variantes distintas e não devem ser comparadas diretamente.
Modelo | MMLU | SWE-bench | MATH | RAM (Q4_K_M) |
|---|---|---|---|---|
| Qwen3.8-27B | — | 61,7 (Pro) | — | 18 GB (placa de 24 GB) |
| Qwen3 72B | ~85% | — | ~84% | 43 GB |
| Llama 4 Scout 17B (MoE) | — | — | — | ~55 GB |
| Llama 3.3 70B (legado) | 82% | — | 77% | 40 GB |
| Mistral Small 3.1 24B | 79% | — | 65% | 14 GB |
| Devstral Small 2 | — | 65,8% (Verified) | — | 15 GB |
| Qwen3 8B | ~75% | — | ~55% | 5 GB |
| Mistral Small v0.3 | 64% | — | 28% | 4,5 GB |
Em quais tarefas o Qwen3 / Qwen3.8-27B se destaca?
O Qwen3 (abril de 2026) e o Qwen3.8-27B (agosto de 2026), da Alibaba, lideram os benchmarks de programação. A Qwen informa 61,7 no SWE-bench Pro e 89,2% no GPQA Diamond para o Qwen3.8-27B — o melhor modelo denso para código disponível — e, ao contrário do Qwen 3.6 27B que ele substituiu, é um modelo nativo de visão e linguagem (entende imagens e vídeo, não apenas texto). O Qwen3 72B continua liderando o MMLU, com ~85%. A família Qwen3 inclui modelos densos e variantes MoE (35B-A3B).
Pontos fortes: programação (Python, JavaScript, SQL, líder no SWE-bench), raciocínio matemático (84% no MATH com 72B), suporte nativo a 29 idiomas, modo JSON, chamada de funções, janela de contexto de 128K em todos os tamanhos.
Pontos fracos: o estilo de seguimento de instruções em inglês pode soar menos natural que o do Llama ou do Mistral; alguns usuários relatam escrita criativa em inglês menos fluente. A origem na Alibaba gera preocupações com tratamento de dados para alguns usuários corporativos, apesar dos pesos abertos.
Por que o Llama 4 Scout é a opção para contexto longo?
O Llama 4 (abril de 2025) trouxe a arquitetura MoE para a família Llama. O Scout (17B ativos / 109B total, 16 especialistas, multimodal) oferece uma janela de contexto de 10M tokens — a maior entre os modelos executáveis localmente — mas precisa de ~55 GB de VRAM a Q4 e não cabe em uma GPU de consumo de 24 GB com quantizações normais (somente a 1,78 bit, ~20 tok/s). O Maverick (17B ativos / 400B total) mira configurações com várias GPUs. O Llama 3.3 70B continua sendo o modelo denso mais testado em produção. Para o melhor desempenho geral em hardware de consumo, o Qwen3.8-27B (cabe em 24 GB a Q4) supera o Scout; escolha o Scout quando precisar do contexto de 10M ou da entrada multimodal.
Pontos fortes: janela de contexto de 10M (Scout), entrada multimodal, melhor seguimento de instruções e escrita criativa em inglês, o maior suporte de ecossistema entre as famílias abertas, Llama 3.3 70B ainda muito ajustado (fine-tuned).
Pontos fracos: a alta demanda de VRAM (~55 GB a Q4) deixa o Scout fora do alcance de uma única GPU de consumo de 24 GB com quantizações normais; sem suporte multilíngue nativo (o Qwen3 ainda lidera com ampla vantagem em idiomas não ingleses); benchmarks do Llama 4 Scout ainda surgindo. O Llama 3.3 70B e o Llama 3.1 8B continuam disponíveis e são as bases mais ajustadas.
Qual é a maior vantagem da Mistral?
A Mistral AI produz os modelos mais eficientes em parâmetros desta comparação e agora oferece variantes especializadas. O Mistral Small 3.1, com 24B, entrega pontuações próximas às da classe de 70B exigindo só 14 GB de RAM — a melhor relação qualidade/RAM. O Devstral Small 2 (Mistral AI, 24B, 15 GB) foi feito para programação agêntica — edições em vários arquivos, chamada de ferramentas e ciclos de depuração. O Codestral 22B é o modelo da Mistral otimizado para FIM no autocompletar de IDE — o recomendado para integrações com Continue.dev e Cursor.
Pontos fortes: melhor relação qualidade/RAM (Small 3.1), Devstral para programação agêntica, Codestral para IDE/FIM, boa chamada de funções e uso de ferramentas, licença Apache 2.0 limpa nos modelos principais, origem europeia (França).
Pontos fracos: o Mistral Small v0.3 é hoje superado em benchmarks pelo Qwen3 8B e pelo Llama 3.1 8B; menos opções de tamanho no topo do que Qwen ou Llama (embora a especialização compense em parte).
Comparação de chamada de ferramentas e raciocínio
A chamada de ferramentas (function calling) permite que um modelo acione APIs e ferramentas externas em fluxos agênticos. As três famílias a suportam nativamente.
Modelo | Chamada de ferramentas | Raciocínio (MATH) | Ideal para |
|---|---|---|---|
| Qwen3 72B | ✅ Nativa | 83% | Agentes complexos de várias etapas |
| Llama 3.3 70B | ✅ Nativa | 77% | Fluxos agênticos em inglês |
| Mistral Small 3.1 24B | ✅ Nativa, bem testada | 65% | Uso de ferramentas em produção com 16 GB |
| Qwen3 14B | ✅ Nativa | 70% | Chamada de ferramentas econômica |
| Llama 3.2 3B | ✅ Nativa | 51% | Agentes leves |
| Mistral Small v0.3 | ⚠️ Limitada | 28% | Não recomendado para uso de ferramentas |
Para tarefas pesadas em raciocínio (matemática, lógica, revisão de código): o DeepSeek-R1 (licença MIT, 7B-32B) supera as três famílias nos benchmarks de MATH. Considere-o junto com elas em fluxos analíticos. (A DeepSeek lançou depois o DeepSeek-V4 — Flash/Pro — como geração mais nova de pesos abertos; R1/V3 continuam válidos para rodar localmente.)
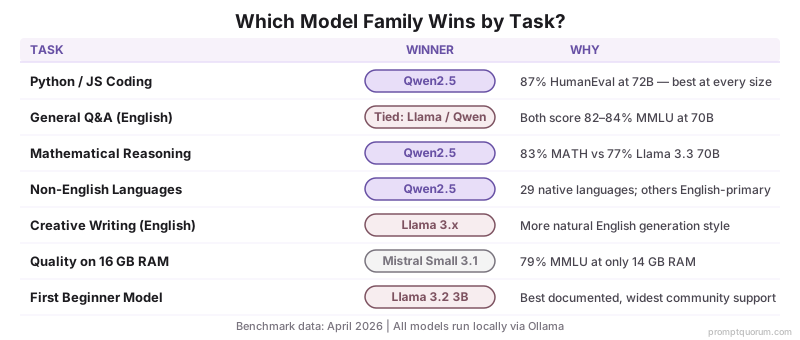
Qual família de modelos vence em cada tarefa?
Escolher o modelo é a primeira etapa; o design do prompt é a segunda. O mesmo prompt pode gerar resultados muito diferentes em Qwen, Llama e Mistral. Para técnicas sistemáticas que dão resultados consistentes em qualquer família, veja o guia de engenharia de prompts.
Tarefa | Vencedor | Por quê |
|---|---|---|
| Programação Python / JavaScript (geração) | Qwen3.8-27B | 61,7 SWE-bench Pro — melhor modelo denso para código |
| Programação agêntica (vários arquivos, depuração) | Mistral (Devstral) | Feito para fluxos agênticos |
| Autocompletar em IDE (FIM) | Mistral (Codestral) | Otimizado para FIM, suporte a Continue.dev/Cursor |
| Perguntas gerais (inglês) | Llama 3.3 / Qwen3 (empate) | Ambos fazem 82-85% no MMLU com 70B |
| Raciocínio matemático | Qwen3 | 84% no MATH com 72B contra 77% do Llama 3.3 70B |
| Idiomas além do inglês | Qwen3 | 29 idiomas nativos; Llama e Mistral focam em inglês |
| Escrita criativa (inglês) | Llama 3.x/4 | Estilo de geração em inglês mais natural |
| Qualidade com 16 GB de RAM | Mistral Small 3.1 | Qualidade próxima à de 70B com 14 GB de RAM |
| Tarefas de contexto longo (10M+ tokens) | Llama 4 Scout | Janela de 10M tokens — nenhum concorrente iguala |
| Primeiro modelo para iniciantes | Llama 3.2 3B | Mais documentação e apoio da comunidade |
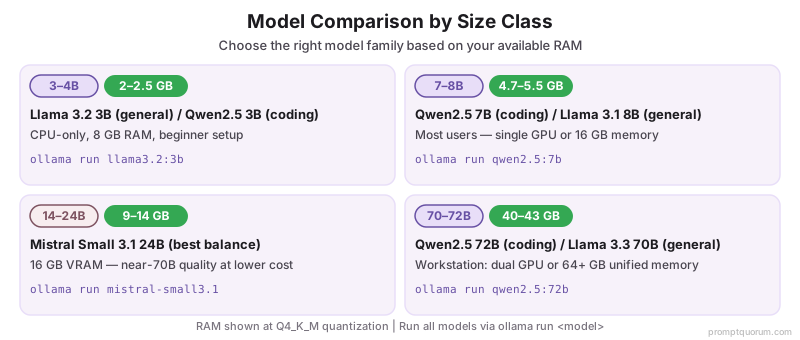
Como os modelos se comparam na mesma escala?
Classe 3B-4B: Qwen3 3B e Phi-4 Mini 3.8B superam o Llama 3.2 3B em programação e matemática. Para uso geral em inglês, o Llama 3.2 3B é mais confiável.
Classe 7B-8B: Qwen3 8B (~5 GB) e Llama 3.1 8B (~5,5 GB) superam bastante o Mistral Small v0.3. O Qwen3 8B lidera em programação; o Llama 3.1 8B lidera em seguimento de instruções em inglês.
Classe 14B-24B: Qwen3 14B e Mistral Small 3.1 24B são as principais opções. O Mistral Small 3.1 é mais forte no geral, apesar de exigir mais RAM. O Devstral Small 2 é a melhor escolha para quem faz programação agêntica nessa faixa.
Classe MoE: Llama 4 Scout (17B ativos / 109B total, 16 especialistas) e Qwen3.6-35B-A3B (3B ativos / 35B total) usam Mixture-of-Experts — só uma fração dos parâmetros é ativada por token. O Scout precisa de ~55 GB de VRAM a Q4 (cabe em uma GPU de 24 GB só a 1,78 bit, ~20 tok/s), então é uma opção de contexto longo/multimodal e não de eficiência em VRAM de consumo; as variantes MoE menores são bem mais amigáveis à VRAM. O gpt-oss:20b (21B total / 3,6B ativos, MoE) também roda em 16 GB com raciocínio ajustável.
Classe 70B-72B: Llama 3.3 70B e Qwen3 72B são os melhores modelos densos executáveis localmente em 2026. Escolha o Qwen3 72B para programação e multilíngue; o Llama 3.3 70B para tarefas gerais em inglês.
Qwen, Llama e Mistral cobrem o cenário open source. Para uma comparação que inclua alternativas comerciais — GPT-5.6, Claude Opus 5 e Gemini 3.5 — e quando escolher proprietário em vez de aberto, veja como escolher o modelo de IA certo.
Mistral Small 24B vs Qwen3 14B vs Llama 3.1 8B: referência de benchmarks legados
Muitos desenvolvedores ainda usam a geração anterior: Mistral Small 24B (2024), Qwen3 14B (2024) e Llama 3.1 8B (2024). Esses modelos continuam disponíveis no Ollama e muito usados em produção. Esta seção os compara diretamente para equipes que ainda não migraram e explica quando vale atualizar para Qwen 3, Llama 4 ou Mistral atual.
- O Mistral Small 24B entrega os maiores benchmarks absolutos dos três, mas exige 14 GB de RAM. Ideal para máquinas de 16 GB+ em que a qualidade importa mais que a folga.
- O Qwen3 14B é o modelo de programação mais forte desta faixa legada, com 71% no HumanEval e 8 GB de RAM. Ideal para quem desenvolve em máquinas de 12-16 GB de RAM e prioriza geração de código.
- O Llama 3.1 8B tem o suporte de ecossistema mais amplo — mais fine-tunes, tutoriais e ajuda da comunidade. Ideal para iniciantes ou equipes que precisam de muitos recursos da comunidade.
- Quando migrar do Mistral Small 24B para o Mistral Small 3.1 24B: se precisar de programação agêntica (use o Devstral Small 2), autocompletar em IDE (use o Codestral 22B) ou ganhos incrementais de qualidade com a mesma RAM.
- Quando migrar do Qwen3 14B para o Qwen3.8-27B: se precisar de desempenho no SWE-bench (61,7 SWE-bench Pro segundo a Qwen), tiver uma placa de 24 GB ou um Mac de 32 GB, ou precisar de suporte nativo a 29 idiomas.
- Quando migrar do Llama 3.1 8B para o Llama 4 Scout: só se tiver ~55 GB+ de VRAM a Q4 (o MoE de 16 especialistas ativa 17B/109B parâmetros, mas precisa de ~55 GB a Q4; cabe em uma GPU de 24 GB só a 1,78 bit, ~20 tok/s) e precisar do contexto de 10M tokens (contra 128K do Llama 3.3) ou da entrada multimodal. Em uma única GPU de consumo de 24 GB, o Qwen3.8-27B é a melhor atualização.
- Fique nos modelos legados se: seus fine-tunes são baseados no Llama 3.1 8B ou no Qwen 3 (custo de migração > benefício), a estabilidade em produção importa mais que benchmarks, ou sua carga de trabalho não exige as novas capacidades (chat geral, resumo, perguntas e respostas básicas).
- Matriz rápida de decisão para usuários legados:
- • Tem 8 GB de RAM, faz chat geral: fique no Llama 3.1 8B ou no Mistral Small v0.3.
- • Tem 12-16 GB de RAM, faz programação: fique no Qwen3 14B ou suba para o Devstral Small 2 (15 GB); o Qwen3.8-27B exige uma placa de 24 GB.
- • Tem 16+ GB de RAM e quer a melhor qualidade: migre do Mistral 24B para o Mistral Small 3.1 24B (geral) ou o Devstral Small 2 (programação agêntica).
- • Tem 24 GB de VRAM: use o Qwen3.8-27B para o melhor desempenho geral em hardware de consumo. Reserve o Llama 4 Scout (MoE, contexto de 10M, ~55 GB a Q4) para estações com várias GPUs que precisem de contexto longo ou entrada multimodal.
Modelo | Parâmetros | RAM (Q4_K_M) | MMLU | HumanEval | Ideal para |
|---|---|---|---|---|---|
| Mistral Small 24B | 24B denso | 14 GB | 79% | 73% | Melhor qualidade por RAM (faixa legada) |
| Qwen3 14B | 14B denso | 8 GB | 73% | 71% | Programação em hardware intermediário |
| Llama 3.1 8B | 8B denso | 5 GB | 68% | 65% | Mais documentado, início mais fácil |
Contexto regional: qual família para UE, Japão, China e Brasil
UE e RGPD: as três famílias (Qwen3, Llama 3.x/4, Mistral) rodam totalmente em local, sem transmissão externa de dados, o que apoia — mas por si só não garante — a conformidade com o RGPD. A Mistral (origem francesa) tem a postura de conformidade mais favorável na UE. O Devstral Small 2 (Apache 2.0) e o Codestral 22B são de origem francesa; para o Codestral, confira os termos de licença. Qwen3 (Apache 2.0) e Llama 3.x/4 funcionam igualmente bem em auditoria e transparência de código aberto. O Qwen3 suporta alemão, francês e outros idiomas da UE sem perda de qualidade. Verifique as obrigações do AI Act da UE aplicáveis ao seu uso antes de lançar comercialmente.
Brasil (LGPD): rodar o modelo localmente mantém código proprietário e dados de clientes dentro da infraestrutura da organização, o que reduz a exposição a transferências internacionais de dados sob a LGPD (Lei nº 13.709/2018). A conformidade depende da base legal, das medidas técnicas e organizacionais da empresa — não só do software. O Qwen3 funciona bem com português do Brasil; a Mistral também tem bom suporte ao português.
Japão e METI: Qwen3 e Llama 3.x/4 estão alinhados às diretrizes de governança de IA do METI para IA local. Nenhum relatório especial é exigido ao implantar em infraestrutura privada dentro de redes corporativas japonesas. O Qwen3 tem forte suporte ao japonês (tokenização nativa) entre seus 29 idiomas, o que o torna preferido para cargas de trabalho em japonês.
China e CAC: o Qwen3 (Alibaba, doméstico) é fortemente preferido para a conformidade com a CAC (Administração do Ciberespaço da China), com otimização nativa para tokenização em chinês. O Kimi K2.6 (Moonshot AI, MoE de 1T total / 32B ativos, licença MIT modificada) também é de origem chinesa, mas o Ollama o lista apenas como tag em nuvem e a execução local exige hardware de servidor (300+ GB). Llama e Mistral são aceitáveis em servidores privados em território chinês, mas chamadas de API em nuvem têm escrutínio mais rígido da CAC.
Erros comuns ao escolher famílias de modelos
- Comparar modelos com contagens de parâmetros diferentes — Qwen 32B vs Llama 70B não é um teste equivalente.
- Ler errado a VRAM de modelos MoE. O Llama 4 Scout tem 109B de parâmetros totais mas só 17B ativos por token — ainda assim, a Q4 precisa de ~55 GB de VRAM (todos os especialistas ficam residentes), e não dos ~14 GB de um modelo denso de 17B. Não cabe em uma GPU de consumo de 24 GB com quantizações normais (só a 1,78 bit, ~20 tok/s). Compare pela VRAM real e pelo benchmark, não pelos parâmetros ativos.
- Ficar nos tamanhos antigos do Qwen3 quando o hardware aguenta o Qwen3.8-27B. O Qwen3.8 hoje só existe como modelo de 27B (18 GB no Ollama), então Qwen3 8B e 14B continuam certos para máquinas menores; com uma placa de 24 GB ou um Mac de 32 GB, migre para o Qwen3.8-27B, a menos que um fine-tune prenda você ao Qwen3.
- Ignorar os modelos específicos da Mistral. A Mistral tem hoje três linhas distintas: Small 3.1 (geral), Devstral (programação agêntica) e Codestral (autocompletar em IDE). Escolher "Mistral" sem dizer qual modelo para qual tarefa desperdiça a principal vantagem da família — a especialização.
- Ignorar benchmarks multilíngues ao escolher entre modelos se a sua carga de trabalho é multilíngue.
- Deixar de lado o Mistral Small 3.1: muitos usuários o descartam por achar que exige 30+ GB de RAM. Ele cabe com quantização Q5 em 22 GB e supera o Llama 3.1 8B em muitas tarefas.
Perguntas frequentes
Qwen ou Llama é melhor para meu caso de uso?
Melhor em geral em hardware de consumo: Qwen3.8-27B (61,7 SWE-bench Pro, cabe em 24 GB a Q4). Para programação e multilíngue: Qwen3.8-27B ou Qwen3 8B. Para contexto longo (10M tokens) ou multimodal: Llama 4 Scout (requer ~55 GB de VRAM a Q4). Para máxima qualidade por GB de RAM: Mistral Small 3.1.
O que é o Llama 4 Scout e como ele difere do Llama 3.3?
O Llama 4 Scout usa uma arquitetura Mixture-of-Experts (MoE) de 16 especialistas — 17B parâmetros ativos por token de um total de 109B, e é multimodal. Todos os especialistas devem residir na memória, então a Q4 requer ~55 GB de VRAM (não os ~14 GB de um modelo denso de 17B). Sua atração é a janela de contexto de 10M tokens. O Llama 3.3 70B é denso (40 GB).
Devo continuar no Qwen3 ou migrar para o Qwen3.8?
Migre para o Qwen3.8-27B (61,7 no SWE-bench Pro, segundo a Qwen) se tiver uma GPU de 24 GB ou um Mac de 32 GB; é o melhor modelo denso para código desta comparação. O Qwen3.8 hoje só existe no Ollama como modelo de 27B (18 GB), então Qwen3 8B e 14B continuam sendo as escolhas Qwen certas para máquinas de 8–16 GB. Fique no Qwen3 apenas se um fine-tune ou fluxo existente depender do comportamento dele.
O que mudou para Qwen, Llama e Mistral desde setembro?
O Qwen3.8 hoje só existe no Ollama como modelo de 27B (18 GB em Q4_K_M, contexto de 256K), então Qwen3 8B e 14B continuam sendo as opções menores do Qwen. O Devstral Small 2 (Mistral AI, 24B, 15 GB, 65,8% no SWE-bench Verified segundo a Mistral, Apache 2.0) é a tag atual do Devstral, e o Mistral Large 4 (1,05T de parâmetros totais / 52B ativos, segundo sua página no Ollama) chegou como modelo em escala de datacenter que não cabe em hardware de consumo. O Llama 4 Scout (cerca de 55 GB em Q4) continua sendo a opção de contexto longo desta comparação. O ranking para hardware de consumo acima não muda.
O Mistral é mais rápido em hardware de consumo?
O Mistral Small 3.1 (24B) executa 1,5–2× mais rápido que o Llama 3.1 8B. Para velocidade, o Mistral Small é o mais rápido com 40–60 tok/seg. O Codestral 22B é otimizado para FIM (fill-in-the-middle) em fluxos de trabalho de autocompletar em IDE.
Os três podem executar com 8 GB de VRAM?
Sim, todos podem executar modelos de 7B-8B a quantização Q4 com 8 GB. O Qwen3 8B usa ~5 GB, o Llama 3.1 8B usa ~5,5 GB, o Mistral Small usa ~4,5 GB a Q4_K_M. O Llama 4 Scout (MoE) NÃO cabe em 8 GB — requer ~55 GB de VRAM a Q4.
Qual é melhor para programação?
Qwen3 8B (~76% HumanEval) para o nível de 8 GB. Qwen3.8-27B (61,7 SWE-bench Pro) para a melhor programação densa. Devstral Small 2 para fluxos de trabalho agentivos em múltiplos arquivos. Codestral 22B para autocompletar em IDE (FIM).
Qual modelo devo usar com 24 GB de RAM?
Mistral Small 3.1 24B a Q4_K_M (14 GB) — melhor qualidade geral a 24 GB de RAM (79% MMLU). Alternativa: Qwen3.8-27B a Q4_K_M (24 GB) para a melhor programação.
O Qwen é melhor que o Llama para raciocínio?
O Qwen3 72B obtém 84% no MATH vs 77% para o Llama 3.3 70B — uma vantagem de 7 pontos. Para MMLU: Qwen3 72B 85% vs Llama 3.3 70B 82% — bem próximos. O Qwen vence em raciocínio; o Llama 3.3 vence em seguimento de instruções em inglês.
Fontes
- Equipe Qwen. (2026). Qwen3 Technical Report. -- Benchmarks da família Qwen3 e variantes MoE.
- Qwen. (2026). Qwen3.8-27B (model card). -- 61,7 SWE-bench Pro, Apache 2.0, contexto de 256K.
- Meta AI. (2025). Llama 4 Model Card. -- Benchmarks e arquitetura oficiais do Llama 4 Scout/Maverick MoE, contexto de 10M.
- Ollama. (2026). devstral-small-2. -- 15 GB, SWE-bench Verified 65,8%, requer Ollama 0.13.3 ou superior.
- Mistral AI. (2025). Codestral. -- Modelo de programação otimizado para FIM no autocompletar de IDE.
- Meta AI. (2024). Llama 3.3 Model Card. -- Dados oficiais de benchmark do Llama 3.3 70B (legado, ainda muito usado).
Registro de atualizações
- 2026-10-17: Seções completas adicionadas em português (visão geral, benchmarks, pontos fortes e fracos, ferramentas, tarefas, tamanhos, contexto regional, erros comuns), tamanho e benchmark do Devstral Small 2 corrigidos, tamanho do Qwen3.8-27B esclarecido (18 GB) e FAQ sobre lançamentos recentes.