模型族概述:Qwen、Llama和Mistral
族 | 开发者 | 可用大小 | 许可证 |
|---|---|---|---|
| Qwen3 | Alibaba | 0.6B、1.7B、4B、8B、14B、30B-A3B、32B、235B-A22B | Apache 2.0(大多数) |
| Llama 3.x | Meta | 1B、3B、8B、70B | Llama Community(定制) |
| Mistral | Mistral AI | 7B、Small 3.1(24B)、Large(123B) | Apache 2.0(7B、Small) |
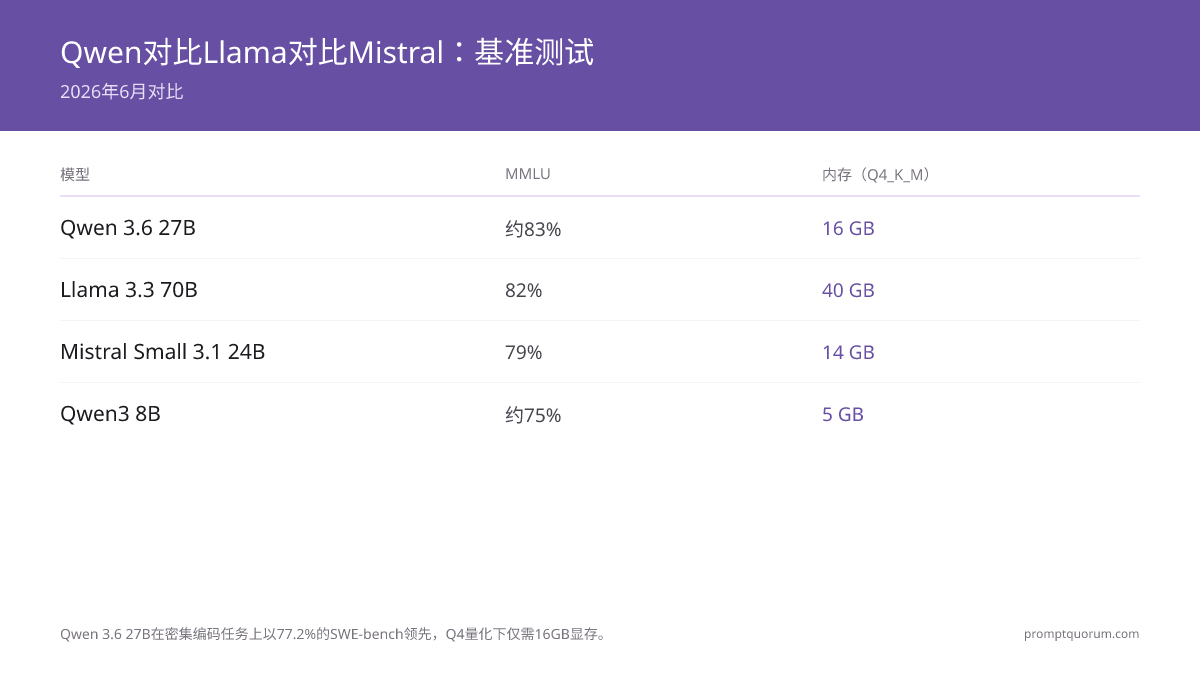
基准对比:Qwen3 vs Llama 3.x vs Mistral
破折号表示未发布或不适用的基准。数值为厂商公布的参考值,并非PromptQuorum的测量结果,请查阅各模型卡。SWE-bench Pro与Verified是不同的变体,不应直接比较。
模型 | MMLU | HumanEval | MATH | RAM (Q4_K_M) |
|---|---|---|---|---|
| Llama 3.3 70B | — | — | — | 40 GB |
| Mistral Small 3.1 24B | — | — | — | 14 GB |
| Qwen3 32B | — | — | — | 20 GB |
| Qwen3 14B | — | — | — | 9 GB |
| Llama 3.2 3B | — | — | — | 5.5 GB |
| Mistral Small v0.3 | — | — | — | 4.5 GB |
| Qwen3 8B | — | — | — | 4.7 GB |

Qwen3:最适合编码、数学和非英文语言
阿里巴巴的Qwen3是编码基准上最强的模型系列之一。 阿里巴巴报告Qwen3.8-27B在SWE-bench Pro上为61.7,这是此处比较的模型中最强的稠密模型编码结果(厂商公布数值,非PromptQuorum测量)。
优势:编码(Python、JavaScript、SQL)、数学推理、29种语言原生支持、JSON模式、函数调用、所有大小的128K上下文窗口。
劣势:英文指导风格可能不如Llama或Mistral自然;一些用户报告英文创意写作流畅性较低。Alibaba源点对某些企业用户提出数据处理问题,尽管开放权重。

Llama 3.x:最适合一般英文任务和生态系统支持
Meta的Llama 3 .x族是最广泛支持的开放权重模型系列。存在比任何其他族更多为Llama编写的工具、微调、量化和社区指南。Llama 3.3 70B在一般英文基准上与所有竞争对手相当或更优。
优势:最广泛的生态系统支持(每个工具都支持Llama)、最佳英文创意写作、强指导遵循、3.1/3.2/3.3变体中的128K上下文、社区测试的可靠性。
劣势:基本功能外没有原生多语言支持;Llama 3.2 3B在编码和数学上不及Qwen3 4B和Phi-4 Mini,尽管参数数相同。
Mistral:最佳效率和最强的7B级历史
Mistral AI生产本对比中最参数高效的模型。 Mistral Small 3.1在24B处提供接近70B级的基准分数,仅需14 GB RAM----本对比中任何模型的最佳质量对RAM比。
优势:最佳质量对RAM比(Small 3.1)、强函数调用和工具使用、多个模型采用Apache 2.0许可(商用前请核对各模型的许可)、欧洲(法国)原产地。
劣势:Mistral Small v0.3现在在基准上被Qwen3 8B和Llama 3.1 8B超越;比Qwen或Llama的大小选项少。

工具调用和推理对比
工具调用(函数调用)让模型能在代理工作流中调用外部API和工具。自2026年4月起,三个系列都原生支持此功能。
模型 | 工具调用 | 推理 (MATH) | 最佳用途 |
|---|---|---|---|
| Llama 3.3 70B | ✅ 原生 | 77% | 英文中心的代理工作流 |
| Mistral Small 3.1 24B | ✅ 原生,经过良好测试 | 65% | 16GB生产工具使用 |
| Qwen3 14B | ✅ 原生 | 70% | 成本高效工具调用 |
| Llama 3.2 3B | ✅ 原生 | 51% | 轻量代理 |
| Mistral Small v0.3 | ⚠️ 有限 | 28% | 不推荐工具使用 |
对于推理密集型任务(数学、逻辑、代码审查):DeepSeek-R1(MIT许可证,7B-32B)在MATH基准上超过所有三个系列。 (DeepSeek 此后发布了开源权重新一代模型 DeepSeek-V4——Flash/Pro;R1/V3 仍可在本地正常使用。)
按任务划分,哪个模型族获胜?
模型选择是第一步,提示词设计是第二步。同一个提示词在Qwen、Llama和Mistral上可能产生截然不同的结果。要了解从任何模型系列获得一致结果的系统化技术,请参阅Prompt工程指南。
任务 | 获胜者 | 原因 |
|---|---|---|
| Python / JavaScript编码 | Qwen3 | Qwen3.8-27B报告61.7 SWE-bench Pro(Qwen公布数值),为此处最强稠密编码模型 |
| 一般Q&A(英文) | Llama 3.x | 英文指令跟随能力强;Llama 3.3 70B报告约82% MMLU(仅供参考,请查阅模型卡) |
| 数学推理 | Qwen3 | 据Qwen报告,数学整体表现强;请根据你的用例查阅模型卡 |
| 非英文语言 | Qwen3 | 29种原生语言;Llama和Mistral是英文优先 |
| 创意写作(英文) | Llama 3.x | 更自然的英文生成风格 |
| 16 GB RAM上的质量 | Mistral Small 3.1 | 14 GB RAM处接近70B质量 |
| 初学者的第一个模型 | Llama 3.2 3B | 文档最充分,社区支持最多 |

大小对大小比较:每个规模上哪个族更好?
3B-4B级:Qwen3 4B和Phi-4 Mini 3.8B在编码和数学上超越Llama 3.2 3B。对于一般英文使用,Llama 3.2 3B更可靠。
7B-8B级:Qwen3 8B和Llama 3.1 8B都显著超越Mistral Small v0.3。Qwen3 8B在编码上领先;Llama 3.1 8B在英文指导遵循上领先。
14B-24B级:Qwen3 14B和Mistral Small 3.1 24B是主要选项。Mistral Small 3.1总体更强,尽管需要更多RAM。Qwen3 14B在较低RAM处更好的编码和多语言。
70B级:Llama 3.3 70B是这一规模下最广为人知的本地可运行稠密模型,适合以英文为主的一般任务。对于编码和多语言,请先对比所需内存少得多的Qwen3 32B或Qwen3.8-27B。
Qwen、Llama和Mistral涵盖了开源领域。要了解包括商业替代品的比较——GPT-5.6、Claude Opus 5和Gemini 3.5——以及何时选择专有模型而非开源模型,请参阅如何选择合适的AI模型。

如何开始每个族
在macOS、Windows或Linux上安装Ollama(单个命令),在一个步骤中拉取任何模型。
# Qwen3族
ollama run qwen3:8b
ollama run qwen3:14b
ollama run qwen3:32b

# Llama 3.x族
ollama run llama3.2:3b
ollama run llama3.2
ollama run llama3.3:70b

# Mistral族
ollama run mistral          # 7B
ollama run mistral-small3.1 # 24B
来源
- Qwen3技术报告(Qwen Team,2025)-- arXiv:2505.09388 -- Qwen3系列在编码、数学和多语言任务上的基准数据。
- Llama 3 Model Card(Meta AI,2024)-- ai.meta.com/blog/meta-llama-3 -- Llama 3.3 70B规格、评估结果和许可条款。
- Mistral 7B(Jiang et al.,Mistral AI,2023)-- arXiv:2310.06825 -- 原始Mistral架构、滑动窗口注意和初始基准数据。
- Open LLM Leaderboard(Hugging Face,2026)-- huggingface.co/spaces/HuggingFaceH4/open_llm_leaderboard -- 所有开放模型的实时MMLU、HumanEval和MATH基准排名。
选择模型族时的常见误区
- 比较不同参数数的模型----Qwen 32B对Llama 70B不是苹果对苹果的测试。
- 当工作负载是多语言时忽略多语言基准。
- 假设最新模型版本总是最好的----有时较旧的量化具有更好的社区支持。
- 忽视许可证要求----Llama模型使用限制700M月活跃用户以上使用的自定义Llama社区许可;大规模部署前验证。
- 仅在一个基准上测试----MMLU测量知识,HumanEval测量编码,MATH测量推理。在一个基准上领先的模型在另一个上可能落后。
地区背景:欧盟/GDPR、日本和中国
欧盟/GDPR:三个模型系列(Qwen3、Llama 3.x/4、Mistral)都可以完全在你自己的硬件上运行,推理数据不会发送给外部服务商。这消除了数据传输方面的一个问题,但并不会自动让部署符合GDPR:合法性基础、技术和组织措施,以及必要时的数据保护影响评估仍然需要。Mistral AI是法国公司;Devstral Small 2以Apache 2.0发布,Codestral 22B在商用前请核对其许可条款。Qwen3(Apache 2.0)同样可以在欧盟使用。Llama 4多模态模型在Llama许可证中有地域限制,在欧盟使用前请核对许可证。商用前请确认适用于你部署的欧盟AI法案义务。以上为一般性信息,不构成法律建议。
日本(METI AI治理):METI的AI治理指南鼓励企业在部署时记录模型来源和性能;Qwen3、Llama 3.x/4和Mistral都发布了模型卡或技术报告,可供引用。在私有基础设施上运行可以让数据留在自己的网络内,但是否另有报告等义务取决于具体用途,请向法律顾问确认。Qwen3在其29种语言中原生支持日文分词,是日文任务的自然候选。
中国(CAC):2023年《生成式人工智能服务管理暂行办法》由国家互联网信息办公室(CAC)负责实施,主要针对向中国公众提供的服务;具体部署是否适用取决于提供方式,请向当地法律顾问确认。Qwen3(Alibaba)在其29种原生语言中以中文使用场景为设计考虑之一。如果你在中国处理数据,使用云端API前请核对数据本地化和跨境传输要求。
常见问题
编码方面哪个最好:Qwen、Llama还是Mistral?
Qwen3系列在编码方面通常表现出色;Qwen3.8-27B报告61.7 SWE-bench Pro(Qwen公布数值)。与Llama、Mistral对比时,请查阅你所运行大小(Qwen3 8B、14B、32B)的模型卡。在7B-8B级别,Qwen3 8B和Llama 3.1 8B通常被认为显著优于Mistral Small v0.3。
哪个本地LLM支持最多语言?
Qwen3原生支持29种语言,包括阿拉伯语、日语、韩语、中文和所有主要欧洲语言。Llama 4官方支持8种语言。Mistral模型主要关注英语和主要欧洲语言。
8 GB RAM下应选择哪个模型?
有8 GB RAM时,对一般任务使用Llama 3.2 3B(Q4,约2 GB)或编码使用Qwen3 8B(Q4,约4.7 GB)。两者在8 GB RAM的CPU上以15-25令牌/秒运行。安装方式:ollama pull llama3.2:3b 或 ollama pull qwen2.5:7b。
Qwen3是否优于Llama 3.3?
这取决于用例。不存在70B级的稠密Qwen3模型;最大的稠密模型是Qwen3 32B和Qwen3.8-27B。通常认为Qwen在多语言和编码方面更强,Llama 3.3 70B在英文指令跟随方面更强。请根据你的用例对比各模型卡。
VRAM有限时哪个本地LLM最高效?
Mistral Small 3.1 24B通常被认为最高效:仅需14 GB RAM,常被描述为接近70B级质量(请查阅模型卡)。
Qwen3能否替代编码任务的云模型?
对于许多标准编码任务(Python、JavaScript、SQL生成),Qwen3 32B或Qwen3.8-27B等模型可能已经足够。对于复杂的多文件重构,前沿云模型(GPT-5.6、Claude Opus 5)通常仍保持优势;请用你自己的任务测试。
2026年Mistral Small是否仍值得使用?
对于仅有4-5 GB VRAM的系统,Mistral Small仍是可用的选项。但是,Qwen3 8B和Llama 3.1 8B在需要类似VRAM的情况下在所有主要基准上都超越Mistral Small v0.3。Mistral Small今天的主要优势是其长期建立的社区支持和工具集成。
Llama Community许可证限制是什么?
Meta的Llama Community许可证对700M月活跃用户以下的商用免费。超过该阈值,需要与Meta的单独商用协议。对大多数用例,此限制不是问题。
能否完全离线运行这些模型?
是的(指推理)。一次性下载模型后,三个系列(Qwen、Llama、Mistral)都可以通过Ollama或LM Studio在无需互联网连接和API密钥的情况下运行。如有严格要求,请核对各工具的遥测和更新设置。
哪个模型族最容易入门?
Llama 3.2 3B拥有最大的社区和大多数初学者教程。使用以下命令运行:ollama run llama3.2:3b(需要8 GB RAM,无GPU)。所有主要本地LLM工具(Ollama、LM Studio、OpenWebUI)默认支持Llama模型。
Mistral Small 24B与Qwen3 14B和Llama 3.1 8B相比如何?
Mistral Small 3.1 24B需要14GB RAM,Qwen3 14B约9GB,Llama 3.1 8B约5.5GB。Mistral Small 3.1通常被认为是三者中综合能力最强的,但占用内存最多;内存较少时做编码可选Qwen3 14B。如果16GB RAM是你的上限,选择Mistral Small 3.1。请查阅模型卡获取最新基准。
哪个模型具有最佳的工具调用支持?
自2026年4月起,三个系列都原生支持工具调用(函数调用)。Mistral Small 3.1 24B在生产环境中的工具使用可靠性享有最佳声誉。Qwen3和Llama 3.3 70B原生支持工具调用。对于代理工作流中的函数调用,Mistral Small 3.1和Qwen3 14B经过最充分的测试。
2026年最佳GGUF聊天模型是什么?
7B:Llama 3.2 3B-instruct-Q4_K_M或Qwen3-8B-instruct-Q4_K_M。14B:Qwen3-14B-instruct-Q4_K_M(9GB)。24B:Mistral-Small-3.1-24B-instruct-Q4_K_M(14GB)。最佳单GPU质量:Qwen3-32B-instruct-Q4_K_M(20GB)。请查阅模型卡获取最新基准。
我应该在16GB RAM上使用哪个模型?
Mistral Small 3.1 24B at Q4_K_M(14GB)是16GB RAM上整体质量较好的选择。或者:Qwen3 14B at Q4_K_M(9GB)为更长的上下文留出更多空间。避免在16GB上运行Llama 3.3 70B----需要40GB,会大量卸载到CPU。
Qwen在推理方面是否优于Llama?
通常认为Qwen模型在数学和逻辑推理方面较强,Llama 3.x在英文指令跟随方面较强;已发布的分数因模型大小和基准版本而异,请对比各模型卡(例如Qwen3 32B或Qwen3.8-27B对比Llama 3.3 70B)。对于链式思维推理任务,DeepSeek-R1(MIT,7B-32B)超越两个系列。
9月以来,Qwen、Llama和Mistral有哪些变化?
Qwen3.8目前在Ollama上只有27B版本(Q4_K_M下18GB,256K上下文),因此Qwen3 8B和14B仍是较小的Qwen选择。Devstral Small 2(Mistral AI,24B,15GB,Mistral公布的SWE-bench Verified为65.8%,Apache 2.0)是当前的Devstral标签;Mistral Large 4(据其Ollama页面,总参数1.05T/激活52B)以数据中心规模的模型出现,无法装入消费级硬件。Llama 4 Scout(Q4下约55GB)仍是本对比中的长上下文选择。上述面向消费级硬件的排名保持不变。