モデルファミリー概要:Qwen、Llama、Mistral
ファミリー | 開発者 | 利用可能なサイズ | ライセンス |
|---|---|---|---|
| Qwen3 | Alibaba | 0.6B、1.7B、4B、8B、14B、30B-A3B、32B、235B-A22B | Apache 2.0(ほとんど) |
| Llama 3.x | Meta | 1B、3B、8B、70B | Llama Community(カスタム) |
| Mistral | Mistral AI | 7B、Small 3.1(24B)、Large(123B) | Apache 2.0(7B、Small) |
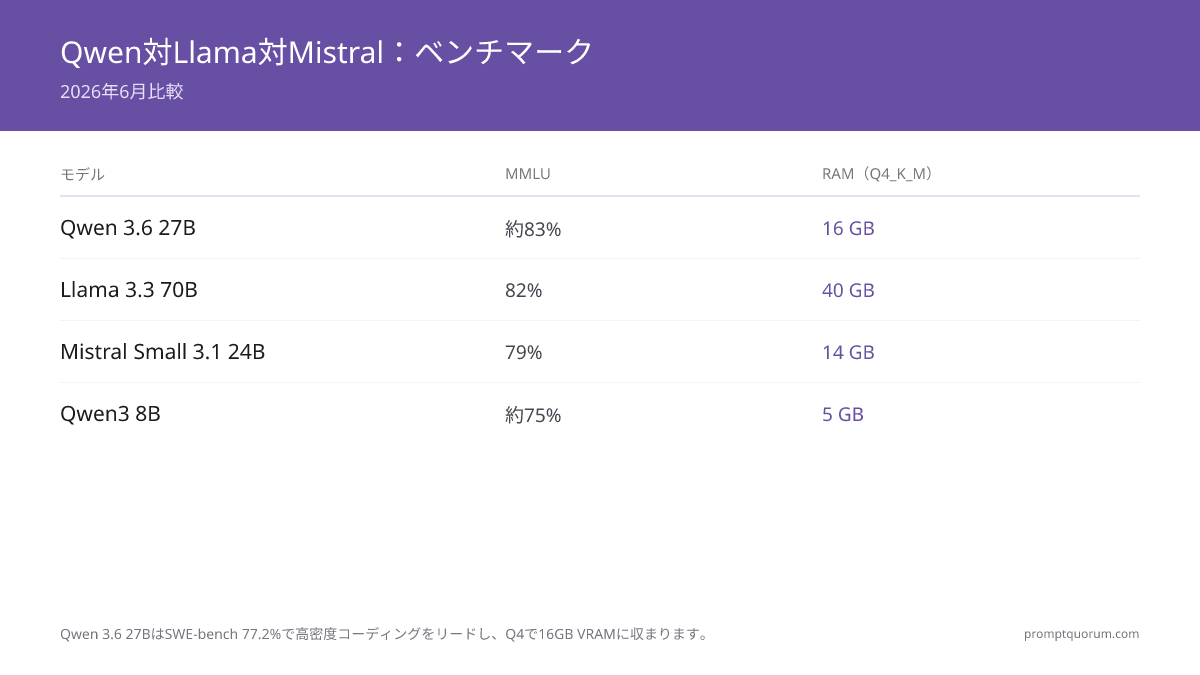
ベンチマーク比較:Qwen3 vs Llama 3.x vs Mistral
ダッシュは未公開または対象外のベンチマークを示します。数値はメーカーが報告した目安であり、PromptQuorumの測定値ではありません。各モデルカードで確認してください。SWE-bench ProとVerifiedは異なる種別のため、直接比較しないでください。
モデル | MMLU | HumanEval | MATH | RAM (Q4_K_M) |
|---|---|---|---|---|
| Llama 3.3 70B | — | — | — | 40 GB |
| Mistral Small 3.1 24B | — | — | — | 14 GB |
| Qwen3 32B | — | — | — | 20 GB |
| Qwen3 14B | — | — | — | 9 GB |
| Llama 3.2 3B | — | — | — | 5.5 GB |
| Mistral Small v0.3 | — | — | — | 4.5 GB |
| Qwen3 8B | — | — | — | 4.7 GB |

Qwen3:コーディング、数学、非英語言語に最適
AlibabaのQwen3は、コーディング系ベンチマークで最も強いモデルファミリーの一つです。 AlibabaはQwen3.8-27Bについて61.7 SWE-bench Proを報告しており、ここで比較したモデルの中で最も強い密モデルのコーディング結果です(メーカー報告値で、PromptQuorumの測定値ではありません)。
強み:コーディング(Python、JavaScript、SQL)、数学的推論、29言語ネイティブサポート、JSONモード、Function Calling、すべてのサイズで128Kコンテキストウィンドウ。
弱み:英語の指示スタイルはLlamaやMistralより自然でない場合があります;一部のユーザーは英語での創造的なライティングの流暢性が低いと報告;Alibaba発祥はオープンウェイトにもかかわらず一部の企業ユーザーにとってデータ処理の懸念を提起。

Llama 3.x:一般的な英語タスクとエコシステムサポートに最適
MetaのLlama 3 .xファミリーは最も広くサポートされているオープンウェイトモデルシリーズです。他のどのファミリーよりもLlamaに対するより多くのツール、ファインチューン、量子化、コミュニティガイドが存在します。Llama 3.3 70Bは一般的な英語ベンチマークのすべての競合他社と同等かそれ以上です。
強み:最も幅広いエコシステムサポート(すべてのツールがLlamaをサポート)、最高の英語創造的なライティング、強い指示追従、3.1/3.2/3.3バリアントで128Kコンテキスト、コミュニティテスト済みの信頼性。
弱み:基本的な機能を超えた多言語ネイティブサポートなし;Llama 3.2 3Bは同じパラメータ数であるにもかかわらずQwen3 4BおよびPhi-4 Miniのコーディングと数学で遅い。
Mistral:最高の効率と最強の7B級の歴史
Mistral AIはこの比較で最もパラメータ効率の良いモデルを生産します。 Mistral Small 3.1は24Bで70Bクラスに近いベンチマークスコアを提供しながら、わずか14 GB RAMしか必要としません----この比較のどのモデルよりも最高の品質対RAM比。
強み:最高の品質対RAM比(Small 3.1)、強いFunction CallingとTool使用、複数のモデルでApache 2.0ライセンス(商用利用の前に各モデルのライセンスを確認)、ヨーロッパ(フランス)発祥。
弱み:Mistral Small v0.3はベンチマークでQwen3 8BおよびLlama 3.1 8Bに上回られるようになった;Qwenやllamaより少ないサイズオプション。

ツール呼び出しと推論の比較
ツール呼び出し(関数呼び出し)により、モデルはエージェント ワークフロー内で外部APIとツールを呼び出すことができます。2026年4月から、3つのファミリー すべてがこれをネイティブにサポートします。
モデル | ツール呼び出し | 推論 (MATH) | ベストフォー |
|---|---|---|---|
| Llama 3.3 70B | ✅ ネイティブ | 77% | 英語中心のエージェント ワークフロー |
| Mistral Small 3.1 24B | ✅ ネイティブ、よくテストされ | 65% | 16 GBでの本番ツール使用 |
| Qwen3 14B | ✅ ネイティブ | 70% | コスト効果的なツール呼び出し |
| Llama 3.2 3B | ✅ ネイティブ | 51% | 軽量エージェント |
| Mistral Small v0.3 | ⚠️ 制限あり | 28% | ツール使用は推奨されない |
推論集約的なタスク(数学、ロジック、コード レビュー)の場合:DeepSeek-R1(MIT ライセンス、7B-32B)は MATH ベンチマークですべての 3 つのファミリーを上回ります。 (DeepSeekはその後、オープンウェイトの新世代としてDeepSeek-V4—Flash/Pro—をリリースしました。R1/V3は引き続きローカルで利用可能です。)
タスク別にはどのモデルファミリーが勝つ?
モデルの選択はステップ1、プロンプトの設計はステップ2です。同じプロンプトでも、Qwen・Llama・Mistralでは全く異なる結果が生じることがあります。どのモデルファミリーからも一貫した結果を得るための体系的テクニックについては、プロンプトエンジニアリングガイドをご覧ください。
タスク | 勝者 | 理由 |
|---|---|---|
| Python / JavaScriptコーディング | Qwen3 | Qwen3.8-27Bは61.7 SWE-bench Pro(Qwen報告値)。ここで比較した中で最も強い密モデルのコーディング結果 |
| 一般的なQ&A(英語) | Llama 3.x | 英語の指示追従が強い。Llama 3.3 70Bは約82% MMLUと報告(目安。モデルカードで確認) |
| 数学的推論 | Qwen3 | Qwenの報告では数学に概ね強い。用途に合わせてモデルカードで確認 |
| 非英語言語 | Qwen3 | 29ネイティブ言語;LlamaとMistralは英語優先 |
| 創造的なライティング(英語) | Llama 3.x | より自然な英語生成スタイル |
| 16 GB RAMでの品質 | Mistral Small 3.1 | 14 GB RAMでほぼ70B品質 |
| 初心者の最初のモデル | Llama 3.2 3B | 最も文書化されて、最も多くのコミュニティサポート |

サイズ別比較:どのファミリーが各スケールで優れているか?
3B~4Bクラス:Qwen3 4BおよびPhi-4 Mini 3.8BはLlama 3.2 3Bをコーディングと数学で上回る。一般的な英語使用の場合、Llama 3.2 3Bはより信頼性が高い。
7B~8Bクラス:Qwen3 8BおよびLlama 3.1 8Bの両方がMistral Small v0.3を大幅に上回る。Qwen3 8Bはコーディングで先導;Llama 3.1 8Bは英語指示追従で先導。
14B~24Bクラス:Qwen3 14BとMistral Small 3.1 24Bが主な選択肢。Mistral Small 3.1は全体的により強いですがより多くのRAMが必要。Qwen3 14Bはより低いRAMでコーディングと多言語に優れている。
70Bクラス:Llama 3.3 70Bはこのサイズで最もよく知られたローカル実行可能な密モデルで、英語中心の一般的なタスクに適しています。コーディングや多言語では、必要なRAMがはるかに少ないQwen3 32BまたはQwen3.8-27Bを先に比較してください。
Qwen・Llama・Mistralはオープンソース領域をカバーしています。GPT-5.6・Claude Opus 5・Gemini 3.5などの商用代替品との比較や、オープンソースよりプロプライエタリを選ぶべき場面については適切なAIモデルの選び方をご覧ください。

各ファミリーで始める方法
macOS、WindowsまたはLinuxでOllamaをインストール(単一コマンド)し、1ステップで任意のモデルをプル。
# Qwen3ファミリー
ollama run qwen3:8b
ollama run qwen3:14b
ollama run qwen3:32b

# Llama 3.xファミリー
ollama run llama3.2:3b
ollama run llama3.2
ollama run llama3.3:70b

# Mistralファミリー
ollama run mistral          # 7B
ollama run mistral-small3.1 # 24B
ソース
- Qwen3 Technical Report(Qwen Team、2025)-- arXiv:2505.09388 -- Qwen3ファミリーのコーディング、数学、多言語タスクに関するベンチマークデータ。
- Llama 3 Model Card(Meta AI、2024)-- ai.meta.com/blog/meta-llama-3 -- Llama 3.3 70B仕様、評価結果、ライセンス条件。
- Mistral 7B(Jiang et al.、Mistral AI、2023)-- arXiv:2310.06825 -- オリジナルMistralアーキテクチャ、スライディングウィンドウ注意、初期ベンチマークデータ。
- Open LLM Leaderboard(Hugging Face、2026)-- huggingface.co/spaces/HuggingFaceH4/open_llm_leaderboard -- すべてのオープンモデルに対するリアルタイムMMUL、HumanEval、およびMATHベンチマークランキング。
模型ファミリー選択時の一般的な誤り
- 異なるパラメータ数のモデルを比較----Qwen 32B対Llama 70Bはりんご対りんご比較ではない。
- ワークロードが多言語の場合、多言語ベンチマークを無視する。
- 最新のモデルバージョンが常に最高と仮定----時々古い量子化はより良いコミュニティサポートを持つ。
- ライセンス要件を見落とす----Llamaモデルはカスタムllama Community Licenseを使用し、700M月間アクティブユーザー以上の使用を制限;スケール展開前に確認。
- 1つのベンチマークのみでテスト----MMLUは知識、HumanEvalはコーディング、MATHは推論を測定。1つのベンチマークで先導するモデルは別のベンチマークで遅い場合があります。
地域的コンテキスト:EU/GDPR、日本、中国
EU/GDPR:3つのモデルファミリー(Qwen3、Llama 3.x/4、Mistral)はいずれも自分のハードウェア上で完全に実行でき、推論データを外部の事業者に送らずに済みます。これでデータ移転に関する論点の一つは解消されますが、それだけでGDPR準拠になるわけではなく、適法性の根拠、技術的・組織的措置、必要に応じてデータ保護影響評価が引き続き必要です。Mistral AIはフランスの企業です。Devstral Small 2はApache 2.0として公開されており、Codestral 22Bは商用利用の前にライセンス条件を確認してください。Qwen3(Apache 2.0)もEUで利用できます。Llama 4のマルチモーダルモデルにはLlamaライセンス上の地域的な制限があるため、EUで使用する前にライセンスを確認してください。商用利用の前に、ご自身の運用に適用されるEU AI Actの義務を確認してください。これは一般的な情報であり、法的助言ではありません。
日本(METI AIガバナンス):METIのAIガバナンス指針は、企業での導入にあたりモデルの出所や性能を文書化することを促しています。Qwen3、Llama 3.x/4、Mistralはいずれもモデルカードや技術レポートを公開しており、参照できます。社内ネットワーク内の自社インフラで運用すればデータは自社環境にとどまりますが、報告などの義務が生じるかどうかは用途次第ですので、法務の専門家に確認してください。Qwen3は29言語のうち日本語のネイティブなトークン化に対応しており、日本語のタスクで有力な候補です。
中国(CAC):2023年の生成AIサービス暫定措置(中国サイバースペース管理局=CACが所管)は主に中国国内の一般向けサービスを対象としており、個別の運用が対象になるかは提供形態によります。現地の専門家に確認してください。Qwen3(Alibaba)は29のネイティブ言語の中で中国語での利用を想定して作られています。中国でデータを処理する場合は、クラウドAPIを使う前にデータ所在地と越境移転の要件を確認してください。
よくある質問
コーディングに最適なのはどれ:Qwen、Llama、Mistral?
Qwen3系はコーディングに強いとされています。Qwen3.8-27Bは61.7 SWE-bench Proと報告されています(Qwen報告値)。LlamaやMistralとの比較は、実行するサイズ(Qwen3 8B、14B、32B)のモデルカードを確認してください。7B~8Bクラスでは、Qwen3 8BとLlama 3.1 8BはいずれもMistral Small v0.3を大きく上回るとされています。
最も多くの言語をサポートするLocal LLMはどれですか?
Qwen3は、アラビア語、日本語、韓国語、中国語、すべての主要ヨーロッパ言語を含む29言語をネイティブにサポート。Llama 4は公式に8言語をサポート。Mistralモデルは主に英語と主要ヨーロッパ言語に焦点を当てる。
8 GB RAMでどのモデルを選ぶべき?
8 GB RAMで、一般的なタスクの場合はLlama 3.2 3B(Q4、〜2 GB)またはコーディングの場合はQwen3 8B(Q4、〜4.7 GB)を使用。どちらも8 GB RAMのCPUで15~25トークン/秒で実行。以下でインストール:ollama pull llama3.2:3b またはollama pull qwen2.5:7b。
Qwen3はLlama 3.3より優れていますか?
用途によります。70Bクラスの密なQwen3モデルは存在せず、最大の密モデルはQwen3 32BとQwen3.8-27Bです。Qwenは多言語とコーディングに、Llama 3.3 70Bは英語の指示追従に強いとされています。用途に合わせてモデルカードを比較してください。
VRAMが限られている場合、最も効率的なLocal LLMは?
Mistral Small 3.1 24Bが最も効率的とされています:わずか14 GB RAMで動作し、70Bクラスに近い品質と説明されることが多いモデルです(モデルカードで確認してください)。
Qwen3はコーディングタスク用のクラウドモデルを置き換えることができますか?
標準的なコーディングタスク(Python、JavaScript、SQL生成)の多くは、Qwen3 32BやQwen3.8-27Bなどで十分な場合があります。複雑なマルチファイル再構成やアーキテクチャ推論では、フロンティアのクラウドモデル(GPT-5.6、Claude Opus 5)が通常まだ優位です。自分のタスクで試してください。
Mistral Smallは2026年で使う価値がありますか?
わずか4~5 GB VRAMしかないシステムの場合、Mistral Smallは使用可能なオプションのままです。ただし、Qwen3 8BおよびLlama 3.1 8Bの両方がMistral Small v0.3を同様のVRAMが必要でもすべての主要ベンチマークで上回る。Mistral Smallの主な利点は今日はその長く確立されたコミュニティサポートとツール統合。
Llama Community Licenseの制限は何ですか?
MetaのLlama Community Licenseは700百万月間アクティブユーザー以下の商用使用のために無料。その閾値の上、Metaを使用した別の商用契約が必要。ほとんどのユースケース、この限度は問題ではない。
これらのモデルを完全にオフラインで実行できますか?
はい(推論の場合)。1回限りのモデルダウンロード後は、3つのファミリー(Qwen、Llama、Mistral)すべてをOllamaまたはLM Studioで、インターネット接続やAPIキーなしで実行できます。厳格な要件がある場合は、各ツールのテレメトリーおよびアップデートの設定を確認してください。
どのモデルファミリーが最も簡単に始めることができますか?
Llama 3.2 3Bは最大のコミュニティと最も多くの初心者チュートリアルを持つ。以下で実行:ollama run llama3.2:3b(8 GB RAM必須、GPU不要)。すべてのメジャーLocal LLMツール(Ollama、LM Studio、OpenWebUI)はデフォルトでLlamaモデルをサポート。
Mistral Small 24BはQwen3 14BおよびLlama 3.1 8Bとどう比較されますか?
Mistral Small 3.1 24Bは14 GB RAM、Qwen3 14Bは約9 GB、Llama 3.1 8Bは約5.5 GB RAMが必要です。Mistral Small 3.1は3つの中で総合力が高いとされますが、最もRAMを使います。少ないメモリでコーディングならQwen3 14Bが向いています。16GB RAMが上限ならMistral Small 3.1を選んでください。最新のベンチマークはモデルカードで確認してください。
どのモデルが最高のツール呼び出しサポートを持っていますか?
3つのファミリーはすべて、2026年4月からツール呼び出し(関数呼び出し)をネイティブにサポート。Mistral Small 3.1 24Bは本番環境でツール使用の信頼性のための最高の評判を持つ。Qwen3およびLlama 3.3 70Bはツール呼び出しをネイティブサポート。エージェントワークフローの関数呼び出しについて、Mistral Small 3.1およびQwen3 14Bが最もテストされている。
2026年の最高のGGUFチャットモデルは何ですか?
7Bで:Llama 3.2 3B-instruct-Q4_K_MまたはQwen3-8B-instruct-Q4_K_M。14Bで:Qwen3-14B-instruct-Q4_K_M(9GB)。24Bで:Mistral-Small-3.1-24B-instruct-Q4_K_M(14GB)。最高品質Single-GPU:Qwen3-32B-instruct-Q4_K_M(20GB)。最新のベンチマークはモデルカードで確認してください。
16GB RAMで使用するモデルはどれですか?
Mistral Small 3.1 24B at Q4_K_M(14GB)は、16GB RAMで総合品質の高い選択肢です。または:Qwen3 14B at Q4_K_M(9GB)は、より長いコンテキストのためより多くのスペースを残します。Llama 3.3 70Bを16GBで避ける----40GBが必要で、CPUに大幅にオフロードされます。
9月以降、Qwen・Llama・Mistralに何が変わりましたか?
Qwen3.8はOllamaでは現在27Bのみ(Q4_K_Mで18GB、256Kコンテキスト)のため、Qwen3 8Bと14Bが引き続き小型のQwen選択肢です。Devstral Small 2(Mistral AI、24B、15GB、Mistral公表のSWE-bench Verified 65.8%、Apache 2.0)が現行のDevstralタグで、Mistral Large 4(Ollamaの掲載によると総計1.05T/アクティブ52Bパラメータ)はデータセンター規模のモデルとして登場し、一般向けハードウェアには収まりません。Llama 4 Scout(Q4で約55GB)は、この比較での長コンテキストの選択肢のままです。上記の一般向けハードウェア向けランキングは変わりません。