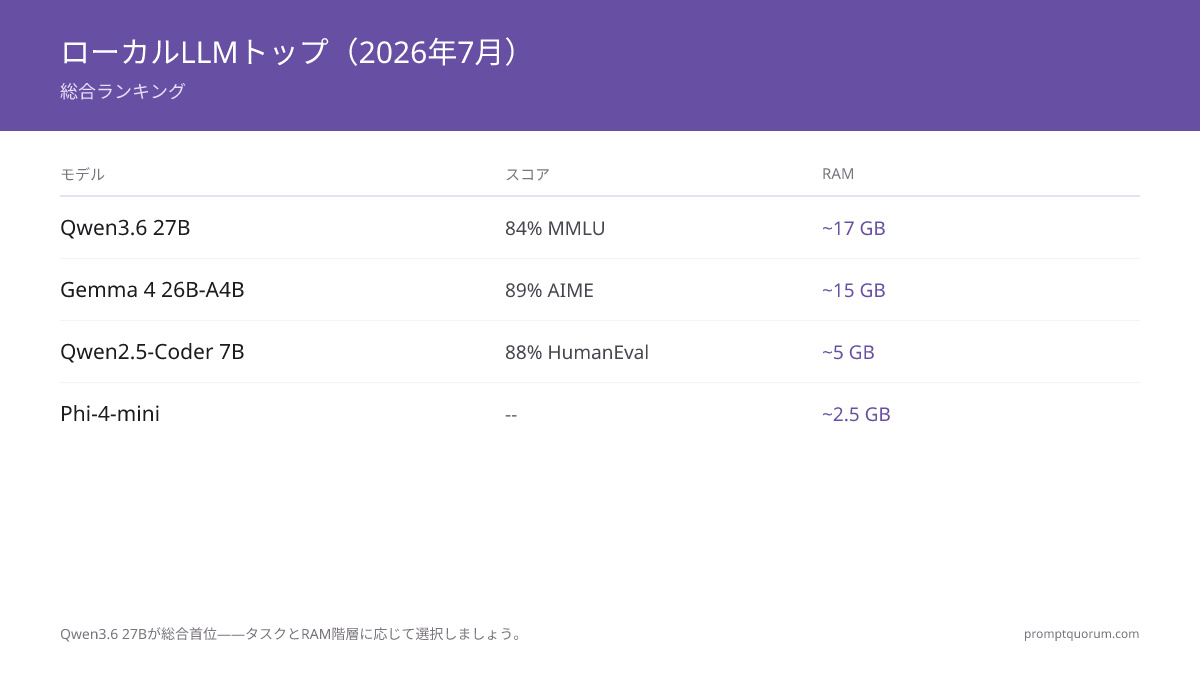
これらのモデルがどのように評価されたか
ランキングは各ラボが公開したベンチマークと独立したコミュニティ測定に基づいています:MMLU(一般知識)、HumanEvalおよびSWE-bench Verified(コーディング能力)、AIME(競技数学)、GPQA Diamond(大学院レベルの推論)。 スコアは各モデルの公式モデルカードとコミュニティのベンチマークトラッカーから2026年Q3時点で取得しました。
ハードウェア要件はQ4_K_M量子化で計算しています。これは品質とRAM使用量のバランスをとる標準的な初心者向け設定です。量子化の入門については、Local LLM Hardware Guideを参照してください。
すべてのモデルはOllamaで利用可能です。インストール方法については、How to Install Ollamaを参照してください。

#1 Qwen3.8-27B -- 2026年の総合性能最高ローカルLLM
Qwen3.8-27Bは、2026年時点でほとんどのユーザーにとって最高のローカルLLMです。GPQA Diamond 89.2%、SWE-bench Pro 61.7%を達成し、Q4_K_Mで約24GBのRAMに収まります。従来のQwen3.6 27Bと異なり、ネイティブのビジョン言語モデルです——テキストだけでなく画像や動画も直接理解します。ネイティブ262Kトークン(拡張で1Mまで)のコンテキストウィンドウを備えています。
この高密度27Bアーキテクチャは前世代のQwen3(現在は非推奨)を置き換えるもので、必要なRAMは大幅に増えています。16GBのマシンにはMoEバリアントのQwen3.6-35B-A3Bまたはより小型のモデルをお勧めします。
仕様 | 値 |
|---|---|
| GPQA Diamond | 89.2% |
| SWE-bench Pro | 61.7% |
| RAM要件(Q4_K_M) | 約24GB |
| コンテキストウィンドウ | 262Kトークン(拡張で1M) |
| Ollamaコマンド | ollama pull qwen3.8:27b |
#2 Gemma 4 26B-A4B -- 推論タスク最高
Gemma 4 26B-A4Bは、2026年時点で推論を多用するタスクに最適なローカルモデルです。AIME 2026で88.3%を達成しています。トークンごとに約4Bパラメータのみを活性化するMixture-of-Expertsの設計により、26Bのパラメータをメモリに読み込みながらも4Bモデルに近い速度で生成します。
Ollamaのダウンロードサイズは16〜19GBです(既定タグの量子化はOllamaに明記されていません)。この容量のRAMにコンテキスト用の余裕を加えて見込む必要があり、RTX 4090一枚、または32GB以上のユニファイドメモリを持つMac(macOSが約8GBを使用)で動作します。詳細はDeepSeek vs Qwen コーディング比較を参照してください。
仕様 | 値 |
|---|---|
| AIME 2026スコア | 88.3% |
| アクティブパラメータ | 26B中約4B(MoE) |
| RAM要件(Ollamaのダウンロードサイズ) | 16〜19GB |
| コンテキストウィンドウ | 256Kトークン |
| Ollamaコマンド | ollama pull gemma4:26b |
#3 Qwen2.5-Coder 7B -- 小型コード生成最高
Qwen2.5-Coder 7Bは、コーディング向けの堅実な小型ローカルモデルです。HumanEval 88%を達成し、Q4_K_Mで約5GBに収まり、80以上のプログラミング言語で学習しています。
24GB以上のRAMがあれば、Qwen3.8-27B(Qwen公表のSWE-bench Pro 61.7、Ollamaで18GB、`ollama run qwen3.8`)がより強力なコーディング向けの選択肢で、16GBマシンにはDevstral Small 2(15GB)が適しています。7Bは手軽で軽量な出発点です。詳細はBest Local LLMs for Codingを参照してください。
仕様 | 値 |
|---|---|
| HumanEvalスコア | 88% |
| EvalPlusスコア | 78% |
| RAM要件(Q4_K_M) | 約5GB |
| コンテキストウィンドウ | 128Kトークン |
| Ollamaコマンド | ollama run qwen2.5-coder:7b |
#4 Phi-4-mini -- CPU専用最高モデル
Microsoft Phi-4-miniは、高品質な合成推論データによりMMLU 67.3%(5-shot、Microsoft公式モデルカード)を達成しています。Q4_K_Mで約2.5GBのRAMのみ必要で、最新のノートパソコンCPUで毎秒30〜50トークンの速度で動作します。
4~8GB RAMのマシン、Raspberry Pi/SBC向けの推奨モデルです。命令追従性能は、同等のRAMでGemma 4 E2Bを上回ります。
仕様 | 値 |
|---|---|
| MMLUスコア | 67.3% |
| HumanEvalスコア | — |
| RAM要件(Q4_K_M) | 約2.5GB |
| コンテキストウィンドウ | 128Kトークン |
| Ollamaコマンド | ollama run phi4-mini |
#5 Gemma 4 E2B -- 小型モデル最高
Google Gemma 4 E2Bは、実効パラメータ3B未満のクラスで最高のモデルです。実効パラメータ2.3B(埋め込みを含めると5.1B)で、約2GBのVRAMのみ必要です。128Kのコンテキストウィンドウはこのサイズのモデルとしては異例の大きさです。
エッジ、SBC(Raspberry Pi 5で動作)、NVIDIA Jetsonボード、スマートフォン向けの推奨モデルです。ほとんどのデスクトップ/ノートパソコンユーザーには、Phi-4-miniが同等のRAMでより高い品質を提供します。ダウンロード:`ollama pull gemma4:e2b`。
仕様 | 値 |
|---|---|
| 実効パラメータ | 2.3B(埋め込み込みで5.1B) |
| VRAM要件(Q4_K_M) | 約2GB |
| コンテキストウィンドウ | 128Kトークン |
| Ollamaコマンド | ollama pull gemma4:e2b |
2026年トップ5ローカルLLMの完全なベンチマーク比較
モデル | MMLU | HumanEval | RAM | 最適な用途 |
|---|---|---|---|---|
| Qwen3.8-27B | — | — | 24GB | 総合(SWE-bench Pro 61.7%) |
| Gemma 4 26B-A4B | — | — | 16〜19GB | 推論、AIME(88.3%) |
| Qwen2.5-Coder 7B | — | 88% | 5GB | コード生成 |
| Phi-4-mini 3.8B | 67.3% | — | 2.5GB | CPU専用、エッジ |
| Gemma 4 E2B | — | — | 2GB | 小型 / SBC |
2026年にどのローカルLLMを使うべきか
- 4GB未満、CPU専用: Phi-4-mini(`ollama run phi4-mini`)-- CPUのみでの最高品質。
- 2~4GB、小型/エッジ: Gemma 4 E2B(`ollama pull gemma4:e2b`)-- 小型クラスで最高。
- 8~16GB RAM: Phi-4-miniまたはMoEバリアントのQwen3.6-35B-A3B -- Qwen3.8-27B(約24GB)はこの帯域には収まりにくくなりました。
- 24GB以上のVRAM/RAM(総合性能最高): Qwen3.8-27B(`ollama pull qwen3.8:27b`)-- 総合性能最高。
- コードタスク: 小型マシンではQwen2.5-Coder 7B(`ollama run qwen2.5-coder:7b`)、16GBならDevstral Small 2(`ollama run devstral-small-2`)、24GB以上のRAMならQwen3.8-27B。詳細はBest Local LLMs for Codingを参照。
- 推論/数学: Gemma 4 26B-A4B(16〜19GB RAM、AIME 2026 88.3%)。
- 英語以外の言語: Qwen3.8-27B。詳細はQwen vs Llama vs Mistral 多言語比較を参照。

ローカルLLM使用の地域別規制コンテキスト
日本の企業はAI事業者ガイドラインを見据えてローカルLLMを導入することがあります。 経済産業省(METI)と総務省(MIC)は、任意の指針である「AI事業者ガイドライン」(第1.0版、2024年4月19日、METIの発表)を公表しています。ローカル実行を求める内容ではありませんが、ローカルLLMは内部文書処理で個人データを自社システムの外に出さずに済むため、同ガイドラインが示すデータの取り扱いへの期待に沿う運用を支援します。要件を満たすかどうかは組織全体の運用次第であり、モデル単体の性質ではありません。大企業の中には、エアギャップネットワーク上でローカルモデルを実行して、データ処理の監視と記録を維持する例もあります。
東アジア・アジア太平洋地域の企業はデータレジデンシー法規に対応するためにローカルLLMを使用しています。 シンガポール、オーストラリア、韓国の金融・医療企業は、個人データのクラウド移送に関する法的制限に直面しており、ローカル推論で対応しています。ASEAN地域では、データクロスボーダー移転規制がますます厳しくなっており、ローカルホスティングが標準実装となっています。
大規模企業のエンタープライズ展開では、規制コンプライアンスとデータセキュリティがローカルLLM採用の主要な要因です。 銀行、病院、法律事務所は、API呼び出しによる外部データ送信を回避するため、オンプレミスやプライベートクラウドでQwen3.8-27BやGemma 4 26B-A4Bなどのローカルモデルを実行しています。監査可能性、データ所有権の保持、規制当局への説明責任がすべてローカル推論の選択を推進しています。
よくある質問
2026年の最高のローカルLLMは何ですか?
Qwen3.8-27Bが2026年時点の総合最高のローカルLLMです -- GPQA Diamond 89.2%、SWE-bench Pro 61.7%、Q4_K_Mで約24GB RAM、262Kコンテキスト。用途別では、推論と数学にはGemma 4 26B-A4B(AIME 2026 88.3%、16〜19GB RAM)、コーディングにはQwen2.5-Coder 7B(約5GB RAM)、CPU専用にはPhi-4-mini(約2.5GB RAM)、最小RAMフットプリントにはGemma 4 E2B(約2GB RAM)が最適です。
Qwen3.8-27Bにはどれくらいのメモリが必要ですか?
Qwen3.8-27BはQ4_K_M量子化で約24GBのRAMが必要です。24GBのVRAMを搭載したGPU(RTX 4090、RTX 3090)や32GB以上のユニファイドメモリを持つMac(macOSが約8GBを使用)であれば動作し、16GBのカードでは厳しくなります。Ollama公式ライブラリに既に登録されています: `ollama pull qwen3.8:27b`。16GB未満の場合はMoEバリアントのQwen3.6-35B-A3Bまたはより小型のモデルを使用してください。
Gemma 4 26B-A4BはQwen3.8-27Bより優れていますか?
用途によります。Gemma 4 26B-A4Bは、両者のうちAIME 2026のスコア(88.3%)が公表されている唯一のモデルで、Mixture-of-Experts設計により4Bモデルに近い速度で生成します。両社が公表しているベンチマークではQwen3.8-27Bが上回ります:GPQA Diamondは89.2%対82.3%、LiveCodeBench v6は90.3%対77.1%です(各社の公表値で、評価条件はそれぞれ異なります)。汎用タスク(文章作成、分析、多言語、画像理解)ではQwen3.8-27Bの方が幅広く対応でき、ネイティブにマルチモーダルです。必要なメモリは、Gemma 4 26B-A4Bが16〜19GB(Ollamaのダウンロードサイズ)、Qwen3.8-27Bが約24GB RAMで、両モデルとも活性パラメータ数に関わらず全パラメータをメモリに読み込みます。
8GB RAM向けの最高のローカルLLMは何ですか?
Phi-4-miniが8GB RAMマシン向けの推奨モデルです -- Q4_K_Mで約2.5〜3.5GBに収まり、他のアプリケーション用に十分な余裕を残しながら、サイズの割に良好な命令追従品質を維持します。Qwen3.8-27B(約24GB)もGemma 4 26B-A4B(16〜19GB)も8GBマシンには収まらず、16〜24GB以上の帯域が必要です。
2026年のコーディング向け最高のローカルLLMは何ですか?
Qwen2.5-Coder 7BはHumanEvalで88%を達成し、10GB未満のRAMでは堅実な選択肢です。コード専用に学習されています。24GB以上のRAMがあるならQwen3.8-27B(Qwen公表のSWE-bench Pro 61.7、18GB)がより強力なコーディング向けの選択肢で、16GBにはDevstral Small 2(15GB)が適しています。詳細はBest Local LLMs for Codingを参照してください。
9月以降に登場した新しいローカルモデルは?
Ollamaでの注目の追加は3つです。Gemma 4にはE2B、E4B、26B-A4Bに加えて12Bモデル(256Kコンテキスト、約8GB)と31B密集モデル(256Kコンテキスト、19〜20GB)が加わりました。NVIDIA Nemotron 3.5 Lightning(`ollama run nemotron-3.5-lightning`)は30B総計/3Bアクティブの専門家混合モデルで、19〜25GB、最大1Mコンテキストの常時稼働エージェント向けです。IBM Granite 4.2(`ollama run granite4.2`、Apache 2.0、128Kコンテキスト)は3B(2.2GB)、8B(5.3GB)、30B(18GB)で提供されます。いずれも上記の推奨は変わりません。24GBではQwen3.8-27Bが引き続き総合最高ですが、8〜16GBのマシンではGranite 4.2 8BとGemma 4 12Bも試す価値があります。
これらのモデルは商用利用に無料で使えますか?
はい、5つのモデルはすべてオープンウェイトで商用利用が許可されています:Qwen3.8-27B、Qwen2.5-Coder 7B、Gemma 4(26B-A4BとE2Bの両方)は公式モデルカードによるとApache 2.0ライセンス、Phi-4-miniはMITライセンスです。導入前に必ずご自身の管轄区域におけるライセンス条項を確認してください。
Q4_K_M量子化とは何ですか?
Q4_K_Mはllama.cppとOllamaが提供する4ビット量子化方式です。モデルの重みを16ビットから4ビット精度に圧縮し、Qwen3.8-27Bを約56GB(フルBF16精度)から約24GBまで、最小限の品質低下で削減します。「Q4」は重みごとの4ビット精度を意味し、「K_M」は重要な重みパターンを保持する特定のバリアント(K-quants方式)です。初心者にはQ4_K_Mが推奨デフォルトです:速度、RAM使用量、出力品質のバランスが取れています。Ollamaは自動的にQ4_K_Mを適用するため、手動で設定する必要はありません。
これらのモデルは完全にオフラインで実行できますか?
はい。5つのモデルすべてが、一度マシンにダウンロードすれば完全にオフラインで動作します。Ollama(またはHugging FaceからのGGUFファイル)でダウンロードし、ローカルに読み込めば、推論は100%お使いのハードウェア上で行われ、ネットワーク呼び出しは一切発生しません。これはクラウドAPIに対する重要な利点です:機密文書、エアギャップネットワーク、プライバシーが重視される業務に向いています(GDPRへの準拠は、モデル単体ではなく組織全体の運用によって決まります)。
ベンチマーク比較表にQwen3.8-27BのMMLU・HumanEval・AIMEスコアが載っていないのはなぜですか?
Alibabaが公開しているQwen3.8-27Bの公式モデルカードには、MMLU・HumanEval・AIMEのスコアが記載されていません——これは本ページの記載漏れではなく、実際に非公開の情報です。Alibabaが公開しているベンチマークはGPQA Diamond(89.2%)、SWE-bench Pro(61.7%)、LiveCodeBench v6(90.3%)、Terminal-Bench 2.1(73.0%)で、いずれも上記の通りです。同程度のサイズでMMLU・HumanEvalスコアが公開されているモデルが必要な場合は、Qwen2.5-Coder 7B(HumanEval 88%)やPhi-4-mini(MMLU 67.3%)が該当します。Qwen3の他のサイズ(8B・14B・32B)やDeepSeek・Llamaとの比較についてはQwen vs Llama vs Mistralをご覧ください。
Qwen3ファミリーのHumanEval・GSM8K・AIMEスコアはいくつですか?Hugging Face Open LLM Leaderboardでの順位は?
Qwenチームが公式に公開している数値(Technical Report)は次の通りです:Qwen3-8BはHumanEvalで72.0%、GSM8Kで84.2%。Qwen3-32B(post-trained)はAIME 2024で81.4%、AIME 2025で72.9%です。これらは上記のQwen3.8-27Bの数値とは別物です——AlibabaのQwen3.8-27Bモデルカードはこの特定モデルのHumanEval・GSM8K・MMLUスコアを公開していません(前の質問を参照)。そのためQwen3のサイズをDeepSeekやLlamaとこれらの正確なベンチマークで比較する場合は、Qwen3.8-27Bの非公開項目ではなく、上記のQwen3-8B/32Bの数値を使用してください。Qwen・DeepSeek・LlamaのMMLU・HumanEval・MATHにおける継続更新されるオープンウェイトモデルのランキングは、ライブのHugging Face Open LLM Leaderboardを参照してください——新しいチェックポイントが提出されるたびに順位は変動するため、本ページは数日で古くなるライブリーダーボードのスナップショットではなく、各ラボの公式モデルカードが開示している数値を報告しています。
これらのモデルは現在のフロンティアクラウドモデルとどう比較されますか?
Qwen3.8-27BとGemma 4 26B-A4Bは、テキストのみのベンチマークにおいて過去のフロンティアクラウドモデルに近づいていますが、現在のフロンティアクラウドモデルは複雑な推論、視覚タスク、現実世界の指示追従において依然としてリードしています。テキストのみの作業(分析、コーディング、文章作成)ではローカルモデルは競争力があり、プライバシーとゼロレイテンシーを提供します。最大限の能力やマルチモーダルタスクが必要な場合はフロンティアクラウドモデルを、プライバシー、コスト、速度を重視する場合はローカルモデルを選んでください。
よくある間違い
- ベンチマークスコアのみで選択する -- 実際のパフォーマンスはあなたのタスクで大きく異なる可能性があります。
- モデル出力を展開前に特定のユースケースでテストしない。
- 商用利用のライセンス制限を確認し忘れる。
- 異なるハードウェア階層間でモデルを比較する -- Qwen3.8-27B(GPQA Diamond 89.2%)はQwen2.5-Coder 7B(HumanEval 88%)と根本的に異なるRAM要件(約24GB対約5GB)のため直接「競合」しません。ハードウェア制約に合うモデルを選び、その上でタスクでの性能を確認してください。
- 利用可能なRAMを確認せずに大型モデルをダウンロードする -- 約17〜20GBのダウンロードは一般家庭のインターネットで30〜60分かかります。大型モデルをダウンロードする前に`free -h`(Linux)またはアクティビティモニタ(macOS)を確認してください。RAMが不足すると、OllamaはCPUオフロードを開始し、速度が毎秒2〜5トークンまで低下します。
- MoEモデルの「アクティブパラメータ」数がRAM使用量を決定すると誤解する -- Gemma 4 26B-A4Bなどの類似MoEモデルでは、推論前にすべてのエキスパートがメモリに読み込まれるため、アクティブ数ではなく総パラメータ数を基準にRAMを計画してください。
ローカルがあなたに適しているか不確実ですか?
Qwen3.8-27BとGemma 4 26B-A4Bの間で選択する前に、ローカル推論が実際にあなたのニーズに合致していることを確認してください。ローカルLLMとクラウドAPIの完全な権衡分析を比較してください — クラウドAPIがあなたの特定のユースケースにより安価で、より速く、またはより実用的である可能性があることに気付くかもしれません(特にリアルタイム情報アクセスやfrontierレベルの推論パフォーマンスが必要な場合)。
最高のローカルモデルはスピードとセットアップの複雑性とプライバシーおよび費用管理をトレードオフします。ハードウェアが限定的(16GB未満)、インターネット接続が不確実、または現在の情報が必要なタスクをお持ちの場合、クラウドAPIがより良い選択かもしれません。
モデルを選んだら、多くの読者にとっての次の一歩はそれを自分のマシンにつなぐことです。上記のいずれのモデルも、ファイルの読み書き、データベース照会、ブラウザ操作ができるエージェントに変えるプロトコルについては、MCP を使ったローカル AI エージェントを参照してください。
ソース
- Hugging Face Open LLM Leaderboard -- リアルタイムベンチマークランキング
- Ollama Model Library -- 利用可能なモデルとダウンロードサイズ
- Model Release Announcements -- 公式モデルカードと機能
- Qwen Team, "Qwen3 Technical Report" -- arxiv.org/abs/2505.09388 -- Qwen3-8BおよびQwen3-32Bベースモデルの公式HumanEval・GSM8K・AIMEスコア