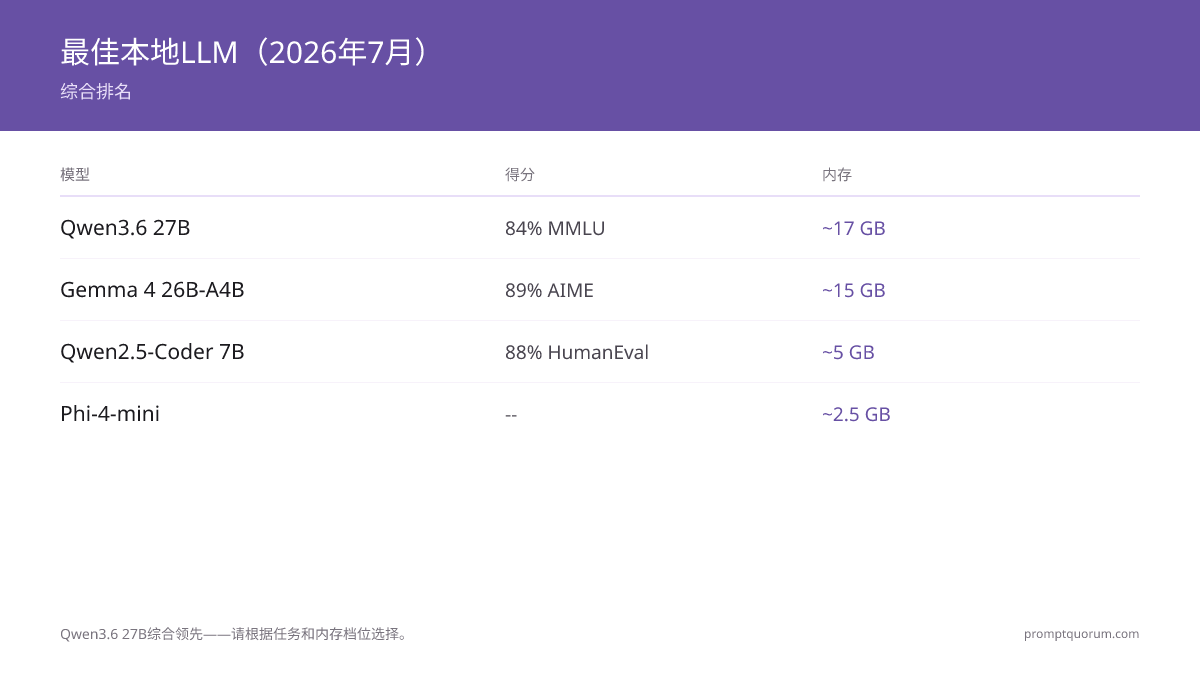
关键要点
- 综合性能最佳:Qwen3.8-27B -- GPQA Diamond 89.2%、SWE-bench Pro 61.7%。Q4_K_M量化约需24GB RAM。262K上下文窗口。
- 推理最佳:Gemma 4 26B-A4B -- MoE架构(总计26B,激活约4B),AIME 2026得分89%。约需15GB RAM。
- 代码最佳:Qwen2.5-Coder 7B -- HumanEval 88%。约需5GB RAM。专为代码训练,支持80多种编程语言。
- 仅CPU最佳:Microsoft Phi-4-mini 3.8B -- MMLU 68%、HumanEval 70%。约需2.5GB RAM,每秒30-50个标记。
- 小型模型最佳:Gemma 4 E2B -- 有效参数2.3B。约需2GB RAM,128K上下文,可在Raspberry Pi 5上运行。
📍 简单一句话
Qwen3.8-27B是整体最佳的本地LLM(GPQA Diamond达89.2%,原生视觉语言能力,约24 GB内存),Gemma 4 26B-A4B在推理方面领先(AIME 2026达89%,约15 GB内存),Qwen2.5-Coder 7B在编程方面领先(HumanEval达88%,约5 GB内存),Phi-4-mini是纯CPU运行的最佳选择(约2.5 GB内存)。
💬 简单来说
如果你不确定该选哪个本地AI模型:如果你有24 GB内存,Qwen3.8-27B是最全面的选择;数学和逻辑问题首选Gemma 4 26B-A4B;写代码专用的是Qwen2.5-Coder 7B;即使没有显卡,Phi-4-mini也能良好运行。像Gemma 4 E2B这样的小模型几乎可以在任何设备上运行,包括树莓派。
这些模型如何被评估
排名基于各实验室自行发布的基准测试以及独立的社区实测:MMLU(通用知识)、HumanEval和SWE-bench Verified(编码能力)、AIME(竞技数学)和GPQA Diamond(研究生水平推理)。 分数来自各模型的官方模型卡以及截至2026年Q3的社区基准测试追踪器。
硬件要求按Q4_K_M量化计算----这是平衡质量和RAM使用的标准初学者设置。有关量化的入门知识,请参阅Local LLM Hardware Guide 2026。
所有模型都可通过Ollama获得。有关安装说明,请参阅How to Install Ollama。

#1 Qwen3.8-27B -- 2026年综合性能最佳的本地大模型
Qwen3.8-27B是2026年适合大多数用户的最佳本地大语言模型。它在GPQA Diamond上得分89.2%、SWE-bench Pro上得分61.7%,在Q4_K_M量化下约需24GB RAM。与上一代Qwen3.6 27B不同,它是原生视觉-语言模型——可以直接理解图像和视频,而不仅仅是文本。原生262K标记上下文窗口(可扩展至1M)。
这一密集27B架构取代了上一代Qwen3(现已过时),所需RAM大幅增加。16GB内存的机器应改用MoE变体Qwen3.6-35B-A3B或更小的模型。
规格 | 值 |
|---|---|
| GPQA Diamond | 89.2% |
| SWE-bench Pro | 61.7% |
| RAM要求(Q4_K_M) | 约24GB |
| 上下文窗口 | 262K标记(扩展至1M) |
| Ollama命令 | ollama pull qwen3.8:27b |
#2 Gemma 4 26B-A4B -- 推理任务最佳
Gemma 4 26B-A4B是2026年处理推理密集型任务的最佳本地模型。它在AIME 2026上得分89%----采用Mixture-of-Experts设计,每个标记仅激活约4B参数,尽管需要将全部26B参数加载到内存中,生成速度却接近4B模型。
在Q4_K_M量化下约需15GB RAM;可在单张RTX 4090或拥有24GB以上统一内存的Mac上运行。详见DeepSeek vs Qwen 代码比较。
规格 | 值 |
|---|---|
| AIME 2026得分 | 89% |
| 激活参数 | 26B中约4B(MoE) |
| RAM要求(Q4_K_M) | 约15GB |
| 上下文窗口 | 128K标记 |
| Ollama命令 | ollama pull gemma4:26b |
#3 Qwen2.5-Coder 7B -- 代码生成最佳
Qwen2.5-Coder 7B是2026年最佳的本地代码模型。它在HumanEval上得分88%,在Q4_K_M量化下约需5GB RAM,基于80多种编程语言训练。
对于拥有24GB以上RAM的用户,Qwen2.5-Coder 32B在HumanEval上得分92%。大多数用户推荐使用7B版本。详见最佳代码本地LLM。
规格 | 值 |
|---|---|
| HumanEval得分 | 88% |
| EvalPlus得分 | 78% |
| RAM要求(Q4_K_M) | 约5GB |
| 上下文窗口 | 128K标记 |
| Ollama命令 | ollama run qwen2.5-coder:7b |
#4 Phi-4-mini -- 仅CPU最佳模型
Microsoft Phi-4-mini通过高质量合成推理数据训练,在MMLU上得分68%、HumanEval上得分70%。Q4_K_M量化下约需2.5GB RAM,在任何现代笔记本CPU上以每秒30-50个标记的速度运行。
推荐用于4-8GB RAM的机器以及Raspberry Pi/SBC。在同等RAM下,其指令跟随能力超过Gemma 4 E2B。
规格 | 值 |
|---|---|
| MMLU得分 | 68% |
| HumanEval得分 | 70% |
| RAM要求(Q4_K_M) | 约2.5GB |
| 上下文窗口 | 128K标记 |
| Ollama命令 | ollama run phi4-mini |
#5 Gemma 4 E2B -- 小型模型最佳
Google Gemma 4 E2B是有效参数3B以下类别中最佳的模型。它拥有2.3B有效参数(含嵌入层为5.1B),仅需约2GB显存。128K上下文窗口对这一尺寸的模型来说异常大。
推荐用于边缘设备、SBC(可在Raspberry Pi 5上运行)、NVIDIA Jetson开发板和手机。对于大多数台式机/笔记本用户,Phi-4-mini在相近RAM下提供更高质量。下载:`ollama pull gemma4:e2b`。
规格 | 值 |
|---|---|
| 有效参数 | 2.3B(含嵌入层5.1B) |
| 显存要求(Q4_K_M) | 约2GB |
| 上下文窗口 | 128K标记 |
| Ollama命令 | ollama pull gemma4:e2b |
2026年5大本地大模型完整基准测试对比
模型 | MMLU | HumanEval | RAM | 最佳用途 |
|---|---|---|---|---|
| Qwen3.8-27B | — | — | 24GB | 综合(SWE-bench Pro 61.7%) |
| Gemma 4 26B-A4B | — | — | 15GB | 推理、AIME(89%) |
| Qwen2.5-Coder 7B | — | 88% | 5GB | 代码生成 |
| Phi-4-mini 3.8B | 68% | 70% | 2.5GB | 仅CPU、边缘 |
| Gemma 4 E2B | — | — | 2GB | 小型 / SBC |
2026年应该使用哪个本地大语言模型
- 4GB以下RAM、仅CPU:Phi-4-mini(`ollama run phi4-mini`)----低RAM下的最佳推理。
- 2~4GB RAM、小型/边缘:Gemma 4 E2B(`ollama pull gemma4:e2b`)----SBC的最佳选择。
- 8~16GB RAM:Phi-4-mini或MoE变体Qwen3.6-35B-A3B----Qwen3.8-27B(约24GB)已不再适合这一档位。
- 24GB以上显存/RAM(综合性能最佳):Qwen3.8-27B(`ollama pull qwen3.8:27b`)----综合性能最佳。
- 代码任务:Qwen2.5-Coder 7B----24GB以上RAM可用32B版本。详见Best Local LLMs for Coding。
- 推理/数学:Gemma 4 26B-A4B(约15GB RAM)----AIME 2026得分89%。
- 非英文语言:Qwen3.8-27B----详见Qwen vs Llama vs Mistral 多语言比较。

本地大模型使用的地区背景
中国企业采用本地大模型来支持满足《数据安全法》的要求。 中国于2021年颁布的《数据安全法》要求企业对个人信息和生产数据的处理方式进行分级保护。在金融、制造、医疗和政府部门工作的企业部署本地大模型以避免个人数据或机密信息经由API外传。本地推理完全绕过外部API调用,使企业能够完全控制数据流和访问日志,这有助于满足中国的数据保护要求,但完整合规仍取决于企业整体的数据治理措施,而非模型本身。Qwen3.8-27B特别适合中国企业,因为它原生支持中文,并由中国公司Alibaba维护;Gemma 4 26B-A4B(由Google开发)同样适合本地推理任务。
亚太地区企业因数据驻留法规采用本地大模型。 新加坡、澳大利亚、韩国和东盟国家对个人数据跨境转移设置了法律限制。新加坡的PDPA(个人数据保护法)和澳大利亚的Privacy Act限制向海外传输敏感信息。本地LLM部署已成为这些地区金融、医疗和政府机构的标准做法。企业在本地或区域数据中心上运行模型,以确保完全遵守数据驻留框架。亚太地区合规性倾向于本地基础设施而非第三方云服务。
大型企业的部署战略通常将合规性和数据所有权放在首位。 金融机构、医疗机构和律师事务所部署本地大模型以维持对客户数据的完全控制。银行必须遵守支付卡行业标准(PCI DSS)和反洗钱法规,这些标准禁止通过互联网将支付信息发送到外部API。医疗机构必须遵守各国的医疗隐私法规,防止患者信息外传。法律事务所处理机密信息,需要确保与律师-委托人保密性兼容的处理流程。在所有情况下,本地推理消除了外部API依赖关系,使企业能够审计、记录和验证每个模型调用,满足监管机构的要求。
常见问题
2026年最佳的本地大语言模型是什么?
Qwen3.8-27B是2026年综合性能最佳的本地大语言模型——GPQA Diamond 89.2%,SWE-bench Pro 61.7%,Q4_K_M量化下约需24GB RAM,262K上下文。针对具体场景:推理和数学任务首选Gemma 4 26B-A4B(AIME 2026得分89%,约需15GB RAM),代码任务首选Qwen2.5-Coder 7B(约需5GB RAM),仅CPU环境首选Phi-4-mini(约需2.5GB RAM),最小内存占用首选Gemma 4 E2B(约需2GB RAM)。
运行Qwen3.8-27B需要多少内存?
Qwen3.8-27B在Q4_K_M量化下大约需要24GB内存。配备24GB显存的GPU(RTX 4090、RTX 3090)或拥有24GB以上统一内存的Mac可以轻松运行;16GB显卡则较为紧张。已正式收录于Ollama官方库:`ollama pull qwen3.8:27b`。如果硬件内存低于16GB,请改用MoE变体Qwen3.6-35B-A3B或更小的模型。
Gemma 4 26B-A4B比Qwen3.8-27B更好吗?
在推理和数学任务上是的——Gemma 4 26B-A4B在AIME 2026上得分89%,得益于Mixture-of-Experts设计,生成速度接近4B模型。对于通用任务(写作、分析、多语言、代码相关工作),Qwen3.8-27B能力更全面,且拥有更大的262K上下文窗口。Gemma 4 26B-A4B约需15GB RAM,Qwen3.8-27B约需24GB RAM——两者都会将全部参数加载到内存中,无论激活参数数量多少。
8GB内存下最佳的本地大语言模型是什么?
Phi-4-mini是8GB内存机器的推荐选择——在Q4_K_M量化下仅占用约2.5-3.5GB,为其他应用留出充足空间,同时保持与两倍体积模型相当的指令遵循质量。Qwen3.8-27B(约24GB)和Gemma 4 26B-A4B(约15GB)都无法在8GB机器上运行;这些需要16-24GB以上的档位。
2026年最佳的本地代码大语言模型是什么?
Qwen2.5-Coder 7B在HumanEval上得分88%——在10GB内存以下可本地运行的模型中得分最高。它专门基于代码训练(而非从通用模型改造而来),在函数补全、调试和代码解释方面更可靠。使用`ollama run qwen2.5-coder:7b`运行。对于拥有24GB以上内存的用户,Qwen2.5-Coder 32B在HumanEval上得分92%,是本地可用的最强代码模型。详见最佳代码本地LLM。
这些模型可以免费商用吗?
可以,五个模型均为开源权重,允许商业使用:Qwen3.8-27B和Qwen2.5-Coder采用Qwen许可证(允许商用),Gemma 4(26B-A4B和E2B均适用)采用Google的Gemma许可证(在可接受使用限制下允许商用),Phi-4-mini采用MIT许可证。部署前请务必核实您所在司法管辖区的具体许可条款。
Q4_K_M量化是什么意思?
Q4_K_M是llama.cpp和Ollama提供的4位量化方案。它将模型权重从16位压缩到4位精度,将Qwen3.8-27B从约56GB(完整BF16精度)压缩到约24GB,同时质量损失极小。"Q4"表示每个权重4位精度;"K_M"是一种保留重要权重模式的特定变体(K-quants方法)。对于初学者,Q4_K_M是推荐的默认设置:它在速度、内存使用和输出质量之间取得平衡。Ollama会自动应用Q4_K_M,无需手动设置。
我能完全离线运行这些模型吗?
可以。五个模型一旦下载到您的机器上,都可以完全离线运行。通过Ollama(或从Hugging Face下载GGUF文件)下载并本地加载后,推理100%在您的硬件上进行,无需任何网络调用。这是相较于云API的关键优势:非常适合机密文档、隔离网络、GDPR合规以及注重隐私的工作负载。
为什么基准对比表没有列出Qwen3.8-27B的MMLU、HumanEval或AIME分数?
阿里巴巴发布的Qwen3.8-27B官方模型卡并未公布该模型的MMLU、HumanEval或AIME分数——这些数据确实未被公开,并非本页遗漏。阿里巴巴公布的基准是GPQA Diamond(89.2%)、SWE-bench Pro(61.7%)、LiveCodeBench v6(90.3%)和Terminal-Bench 2.1(73.0%),均已在上文列出。如果您需要同等规模且公布了MMLU/HumanEval分数的模型,Qwen2.5-Coder 7B(HumanEval 88%)和Phi-4-mini(MMLU 68%、HumanEval 70%)都公布了这些数字。关于Qwen3的其他规格(8B、14B、32B)以及该系列与DeepSeek、Llama的对比,参见Qwen vs Llama vs Mistral。
Qwen3系列的HumanEval、GSM8K和AIME分数是多少?它在Hugging Face Open LLM Leaderboard上排名如何?
Qwen团队官方公布的分数(Technical Report)为:Qwen3-8B在HumanEval上得72.0%,GSM8K上得84.2%;Qwen3-32B(post-trained)在AIME 2024上得81.4%,AIME 2025上得72.9%。这些数字与上文推荐的Qwen3.8-27B不同——阿里巴巴的Qwen3.8-27B模型卡并未公布该特定模型的HumanEval、GSM8K或MMLU分数(见上一问题)。因此,若要在这些具体基准上比较Qwen3各规格与DeepSeek或Llama,请使用上方的Qwen3-8B/32B分数,而非Qwen3.8-27B未公开的字段。要查看Qwen、DeepSeek、Llama在MMLU、HumanEval和MATH上持续更新的开放权重模型排名,请参考实时的Hugging Face Open LLM Leaderboard——排名会随新检查点的提交而变化,因此本页报告的是各实验室官方模型卡公布的数据,而非几天内就会过时的实时排行榜快照。
这些模型与当前的前沿云端模型相比如何?
Qwen3.8-27B和Gemma 4 26B-A4B在纯文本基准测试上接近以往的前沿云端模型,但当前的前沿云端模型在复杂推理、视觉任务和真实世界指令遵循方面仍然领先。对于纯文本工作(分析、编码、写作),本地模型具有竞争力,并提供隐私保护和零延迟。需要最大能力或多模态任务时选择前沿云端模型;注重隐私、成本和速度时选择本地模型。
常见错误
- 仅基于基准测试进行选择----实际性能在您的任务中可能差异显著。
- 未在特定用例上部署前测试模型输出。
- 忘记检查商业使用的许可证限制。
- 在不同硬件档位之间比较模型----Qwen3.8-27B的GPQA Diamond 89.2%不能直接与Qwen2.5-Coder 7B的HumanEval 88%"竞争",因为它们所需的内存(约24GB对约5GB)完全不同。请先选择符合您硬件条件的模型,再验证其在具体任务上的表现。
- 下载大型模型前未确认可用内存----约24GB的下载在普通家庭网络下需要30-60分钟。下载大型模型前请运行`free -h`(Linux)或查看活动监视器(macOS)。如果可用内存不足,Ollama将开始CPU卸载,速度会降至每秒2-5个标记。
- 误以为MoE模型的"激活参数"数量决定其内存占用----对于Gemma 4 26B-A4B等MoE模型,推理前所有专家都必须加载到内存中,因此应按总参数量而非激活参数量来规划内存。
不确定本地是否适合您?
在Qwen3.8-27B、Gemma 4或Qwen2.5-Coder之间选择之前,先确认本地推理确实符合您的需求。**比较本地LLM vs云API的完整权衡分析** — 您可能会发现云API对于您特定的用例来说成本更低、速度更快或更实用,特别是如果您需要实时信息访问或frontier级别的推理性能。
最佳本地模型在速度和设置复杂性与隐私和成本控制之间进行权衡。如果您的硬件有限(< 16 GB RAM)、互联网下载不可靠或任务需要最新知识,云API可能是更好的选择。
选好模型之后,大多数读者的下一步是把它接到自己的机器上。要让上面任何一款模型都变成能够读写文件、查询数据库、操作浏览器的代理,请参阅使用 MCP 的本地 AI 代理介绍的协议。
信息来源
- Hugging Face Open LLM排行榜 -- 实时基准排名
- Ollama模型库 -- 可用模型和下载大小
- 模型发布公告 -- 官方模型卡和功能
- Qwen Team, "Qwen3 Technical Report" -- arxiv.org/abs/2505.09388 -- Qwen3-8B和Qwen3-32B基础模型的官方HumanEval、GSM8K、AIME分数