クイックスタート:最初のローカルLLMを3分で実行
1. Ollamaのインストール (1分)
ollama.comからダウンロードしてインストーラーを実行。設定不要です。
2. Llama 3.2 3Bを実行 (2分)
ターミナルを開いて実行:`ollama run llama3.2:3b`
Ollamaは最初の実行時にモデル(~2 GB)をダウンロードします。ほとんどのユーザーにお勧めの最初のモデルです。
3. チャット開始 (即座)
モデルが読み込まれたら、質問やプロンプトを入力してEnterキーを押します。典型的なラップトップで25~45トークン/秒のスピードで回答が表示されます。
以上です。 手動設定不要、GPU不要。8GB以上RAMがあれば準備完了。4~6GBの場合は`ollama run gemma4:e2b`を使用してください(より高速、1.7 GB RAM使用)。
初心者向けチェックリスト:ローカルはあなたに適していますか?
最初のモデルをダウンロードする前に、これら3つの質問に答えてください:
1. 8GB以上のRAMをお持ちですか? (いいえの場合、クラウドAPIの方が開始が速いです。)
2. データをプライベートに保つ必要がありますか? (いいえの場合、クラウドAPIはより良い品質を提供します。)
3. 20~40分のセットアップを許容できますか? (いいえの場合、クラウドAPIは5分で準備完了です。)
2つ以上の質問に「いいえ」と答えた場合、ローカルvsクラウド比較をお読みください - クラウドAPIがハードウェアとタイムラインに適しているかを確認してください。初心者はしばしばローカルLLMが常に良いと仮定します——それは真実ではありません。正しい選択はあなたの特定の制約に依存します。
初心者向けローカルLLMモデルの選び方
ローカルLLMのモデル選択は3つの制約に依存します:利用可能なRAM、推論速度、タスクの種類——この優先順位で。
パラメータ数(3B、7B、13B)がRAM要件の主な決定要因です。4ビット量子化——ほとんどのローカル推論ツールのデフォルト——では、パラメータ数に~0.5を掛けて必要なGB RAMを推定できます。Q4_K_Mの7Bモデルは約4.5 GBのRAMを必要とします。
ほとんどの初心者にとって、Q4_K_M量子化の7Bモデルが8 GB以上のマシンで品質・速度・RAM使用のバランスが最良です。4〜6 GB RAMのマシンでは3Bモデルが実用的な上限です。

#1 Meta Llama 3.2 3B — 総合的に最適な入門モデル
Meta Llama 3.2 3Bはほとんどのユーザーにとって最良の出発点です。 5分以内にダウンロードでき、4 GB RAMのどのマシンでも動作し、以前の3Bモデルより明らかに優れた指示追従性能を発揮します。128Kコンテキストウィンドウを使用——同サイズモデルより大幅に広い。
Llama 3.2 3Bは8コアのノートPC CPUで25〜45トークン/秒程度、M3 ProなどのApple Siliconではそれ以上が目安です(大まかな推定値で、PromptQuorumはここで計測していません。速度はハードウェアや設定により異なります)。要約・Q&A・簡単なコーディングタスクには十分な品質ですが、多段階推論では7Bモデルに及びません。
スペック | 値 |
|---|---|
| パラメータ数 | 3B |
| 必要RAM | ~2.5 GB (Q4_K_M) |
| ダウンロードサイズ | ~2 GB |
| コンテキストウィンドウ | 128Kトークン |
| CPU速度(8コアノートPC) | 25〜45トークン/秒 |
| Ollamaコマンド | ollama run llama3.2:3b |
#2 Microsoft Phi-4 Mini 3.8B — 低RAM向けの最良モデル
Phi-4 MiniはMicrosoftの小規模での推論・コーディングタスク向けに最適化されたコンパクトモデルです。 68% MMLU・70% HumanEvalを達成——問題解決に特化した高品質合成データによる訓練のおかげで、多くの2024年製7Bモデルを超えます。
4〜6 GB RAMで品質が重要なマシンに推奨されるモデルです。Phi-4 MiniはRAM 2.5 GB使用(Phi-3.5 Miniの3 GBから削減)で、4 GBマシンでも使いやすくなっています。
スペック | 値 |
|---|---|
| パラメータ数 | 3.8B |
| 必要RAM | ~2.5 GB (Q4_K_M) |
| ダウンロードサイズ | ~2.3 GB |
| MMLUスコア | 68% |
| コンテキストウィンドウ | 128Kトークン |
| CPU速度(8コアノートPC) | 30〜50トークン/秒 |
| Ollamaコマンド | ollama run phi4-mini |
#3 Google Gemma 4 E2B — 比較的高速な2Bモデル
Gemma 4 E2BはGoogleの更新された2Bモデルで、CPUのみの推論で比較的高速な選択肢の一つです。 ミッドレンジのノートPC CPUで約40〜60トークン/秒を生成します(大まかな推定値でPromptQuorumの測定値ではなく、ハードウェアにより異なります)。Gemma 4 E2Bは以前のGemma世代を大幅に改善:コンテキストウィンドウが8K(Gemma 2)から128Kトークンに拡大し、文書タスクの主要な制限が解消されました。
Gemma 4 E2Bは応答速度が最優先の場合、≤4 GB RAMのマシン、またはより大きなモデルをダウンロードする前にローカルLLMセットアップを確認するテストモデルとして適しています。
スペック | 値 |
|---|---|
| パラメータ数 | 2B |
| 必要RAM | ~1.7 GB (Q4_K_M) |
| ダウンロードサイズ | ~1.6 GB |
| コンテキストウィンドウ | 128Kトークン |
| CPU速度(8コアノートPC) | 40〜60トークン/秒 |
| Ollamaコマンド | ollama run gemma4:e2b |
#4 Meta Llama 3.1 8B — 最良の7B/8Bオールラウンダー
Meta Llama 3.1 8Bは現在このサイズでの汎用オールラウンダーで、HumanEval 72%を達成し、堅実な英語推論力を持ちます。 このリストの7B/8B枠としてMistral 7Bを置き換えました——Mistral 7Bは2023〜2024年のコミュニティ標準でしたが、現在は同じRAM階層でより新しいモデルが公開ベンチマークで上回る傾向があり、レガシーな選択肢として扱う方が適切です(デフォルトとして推奨しなくなった理由は下記の「よくある失敗」を参照)。
8 GB RAMのマシンでは、Llama 3.1 8Bは3Bモデルからの自然なステップアップです。長いテキスト、複雑な指示、多段階会話をどの3Bモデルよりも確実に処理し、128Kコンテキストウィンドウを備えています。
スペック | 値 |
|---|---|
| パラメータ数 | 8B |
| 必要RAM | ~5.5 GB (Q4_K_M) |
| ダウンロードサイズ | ~5 GB |
| コンテキストウィンドウ | 128Kトークン |
| HumanEvalスコア | 72% |
| CPU速度(8コアノートPC) | 10〜18トークン/秒 |
| Ollamaコマンド | ollama run llama3.1:8b-instruct |
#5 Qwen3 8B — 多言語用途に最適
Qwen3 8B(82億パラメータ)はHumanEval 57.3%を達成し、MMLUではLlama 3.1 8Bと同等かそれ以上、中国語・日本語・韓国語・アラビア語・主要欧州語を含む29言語以上にネイティブ対応しています。 非英語ワークフローやコーディング主体のユースケースに推奨される選択肢で、このリストの多言語枠として旧Qwen2.5 7Bを置き換えました。
Qwen3 8Bは32Kコンテキストウィンドウ(YaRNで131Kまで拡張可能)を使用し、JSONモードによる構造化出力をサポートします。さらに、より難しい推論タスク向けにオプションの「思考モード」も備えています(速度は落ちますが精度が上がります)。モデルはInstructバージョンとBaseバージョンで利用可能——チャット用途には必ずInstructバージョンを使用してください。詳細なベンチマークデータはQwen vs Llama vs Mistralベンチマーク比較を参照。
スペック | 値 |
|---|---|
| パラメータ数 | 8.2B |
| 必要RAM | ~5.2 GB (Q4_K_M) |
| ダウンロードサイズ | ~5.2 GB |
| コンテキストウィンドウ | 32Kトークン(YaRNで131K) |
| HumanEvalスコア | 57.3% |
| CPU速度(8コアノートPC) | 10〜18トークン/秒(非思考モード) |
| Ollamaコマンド | ollama run qwen3:8b |
RAM・速度・コンテキストウィンドウ別の最優秀モデルは?
モデル | RAM | 速度(CPU) | コンテキスト | 最適用途 |
|---|---|---|---|---|
| Llama 3.2 3B | 2.5 GB | 25〜45トークン/秒 | 128K | 汎用・最初のモデル |
| Phi-4 Mini 3.8B | 2.5 GB | 30〜50トークン/秒 | 128K | 推論・コーディング・低RAM |
| Gemma 4 E2B | 1.7 GB | 40〜60トークン/秒 | 128K | 速度・超低RAM |
| Llama 3.1 8B | 5.5 GB | 10〜18トークン/秒 | 128K | 汎用オールラウンダー、HumanEval 72% |
| Qwen3 8B | 5.2 GB | 10〜18トークン/秒 | 32K(YaRNで131K) | 多言語・コーディング |

どのモデルから始めるべきか?
- 4 GB RAM以下:`ollama run gemma4:e2b` — 最速ダウンロード、最小メモリ使用、128Kコンテキスト。基本タスクに許容できる品質。
- 8 GB RAM、最初のモデル:`ollama run llama3.2:3b` — 最初の体験に品質とRAMの最良バランス。
- 4〜6 GB RAM、推論/コーディング:`ollama run phi4-mini` — 68% MMLU、70% HumanEval(わずか2.5 GB RAM)。構造化タスクでLlama 3.2 3Bより優秀。
- 8 GB RAM、本格的な使用:`ollama run llama3.1:8b-instruct` または `ollama run qwen3:8b` — 長文書・複雑な指示向けのステップアップ。
- 主にコーディングタスク:`ollama run llama3.1:8b-instruct` — このリストで最も高いHumanEval値(72%);コーディング専用なら `ollama run qwen2.5-coder:7b` を試してください。
- 日本語・多言語:`ollama run qwen3:8b` — 29言語以上のネイティブサポート、翻訳オーバーヘッドなし。

地域に応じたモデル選択は?
日本(METI):日本語ワークフローには、Qwen3 8Bは最初のモデルとして有力な選択肢です——コミュニティの報告では、Qwen3のトークナイザーは日本語テキストでLlamaより少ないトークンで済む傾向がありますが、結果はテキストによって異なります。コマンド:`ollama run qwen3:8b`。モデル名とバージョンの文書化は、日本におけるAIガバナンスの良い実践です(METIのAIガイドライン参照)——ここに記載された5つのモデルすべてに、これを容易にするバージョン付きOllamaタグがあります。
東アジア(データ主権):中国語・韓国語ワークフローにもQwen3 8Bが推奨されます。29言語以上のネイティブサポートにより、アジア太平洋地域で効率的な選択肢の一つです。Ollama経由のローカル推論はプロンプトと出力を手元のハードウェアに保持するため、APAC地域のデータ越境規制への対応を簡素化できる場合がありますが、実際に適合するかは処理全体によります。
グローバル(EU・その他):EU組織がローカルで個人データを処理する場合、モデルの出所はコンプライアンス文書上重要です。業務でAIシステムを使用する際は、モデルの出所とライセンス種別を文書化することが良い実践です。Llama(Meta/米国)、Gemma(Google/米国)、Qwen(Alibaba/中国)について、ローカル推論であること自体がGDPR上これらのモデルを除外する理由にはならず、導入が適法かどうかは法的根拠、技術的・組織的措置、目的によって決まります——最もクリーンなEU出自を求めるなら、Mistral AI(フランス)がApache 2.0ライセンスのモデルを提供していますが、現行のMistral Small系(24B以上)はこのページの初心者向け4〜8 GB RAM範囲を超えます。必要なGPU階層についてはハードウェアガイドを参照してください。
韓国:この5つの初心者向けモデルの中では、Qwen3 8Bが最も強いネイティブ韓国語トークン化を持ちます。この入門レベルを超えた韓国語専用のローカルモデルについては、韓国語対応のベストローカルモデルを参照してください。
一般情報であり法的助言ではありません:上記の地域別の記述は一般的な情報であり、法的助言ではありません。ご自身の状況に必要な要件は、資格のある専門家にご確認ください。
これらのモデルをどうやってダウンロード・実行するか?
5つのモデルすべてがOllamaコマンド1つでインストールできます——手動設定は不要です。 セットアップはOllamaのインストール方法を参照し、初回実行の手順は初めてのローカルLLM実行をご覧ください。RAMが限られたノートPCで実行する場合は、ノートPCでローカルLLMを実行する方法で量子化と制約されたハードウェアのパフォーマンスチューニングを参照。
最初のモデルが動いたら、次のステップは効果的なプロンプトの作り方を学ぶことです。プロンプトエンジニアリングの基礎から始めましょう——温度設定から出力フォーマットまで、すべてのプロンプトに必要な基本要素を16のガイドで解説しています。
ローカルLLM選択で初心者がよくやる失敗は?
- パラメータ数だけでモデルサイズを選ぶ——4ビット量子化の7Bは、量子化が不適切な13Bより高性能なことがある。
- GPU VRAMの量子化オーバーヘッドを考慮しない——モデルはファイルサイズより10〜15%多いVRAMを必要とする場合がある。
- 新しい量子化(Q4_K_M)が同サイズで優れた品質を提供するのに、古い量子化(Q3_K_S)を使用する。
- Mistral 7Bをデフォルトの7Bモデルに選ぶ: 2023〜2024年のコミュニティ標準(7B、ダウンロード約4.1 GB、`ollama run mistral`)でしたが、現在は同じRAM要件で、コーディングのQwen3 8Bや英語推論のLlama 3.1 8Bなど、より新しいモデルが公開ベンチマークで上回る傾向があります。ツールやチュートリアルがデフォルトで`ollama run mistral`を使う場合は、RAMを増やさずに良い結果を得るために`ollama run qwen3:8b`または`ollama run llama3.1:8b-instruct`に切り替えてください。なお、これは現行の24B以上の「Mistral Small 3.x」系とは無関係の別モデルで、このページのどのモデルよりもはるかに多くのRAMを必要とします。
- 利用可能なRAMを確認せずにモデルをダウンロードする: 利用可能なRAMを超えるモデルをプルすると、Ollamaはディスクスワップを伴う低速なCPU推論にフォールバックし——時に1トークン/秒未満。7Bを超えるモデルをプルする前に、必ず`free -h`(Linux/macOS)を実行するかタスクマネージャー(Windows)を確認してください。
よくある質問
2026年に初心者向けの最良のローカルLLMモデルは何ですか?
ほとんどのユーザーにはLlama 3.2 3B——4 GB RAMのどのマシンでも動作し、5分以内にダウンロードでき、優れた指示追従出力を提供します。8 GB RAMにはQwen3 8Bがより良いコーディングと多言語性能を提供。最低RAMにはGemma 4 E2Bが1.7 GBでCPUで40〜60トークン/秒で動作、またはRAM 2 GB以下ならLlama 3.2 1B。
ローカルLLMを実行するために必要な最低RAMはどれくらいですか?
有用な出力の実用的な最低値はQ4_K_M量子化の3Bモデルで4 GB RAMです。RAM 2 GB以下では、Llama 3.2 1Bが実用的な最小構成ですが、品質は明らかに低下します。8 GB RAMで7-8Bモデルが解放され、複雑なタスクで明らかに優れた結果を生成します。
最良の1BパラメータのローカルLLMは何ですか?
Llama 3.2 1Bが推奨の1Bモデルです——ダウンロード約1.3 GB、`ollama run llama3.2:1b`でRAM 2 GB以下でも動作します。基本的な要約や短いQ&Aには使えますが、多段階推論では3B以上のモデルより明らかに弱くなります。ハードウェアが本当に3Bモデルを動かせない場合のみ使用してください。
Mistral Small 3.2は初心者向けのローカルLLMとして良い選択ですか?
いいえ——Mistral Small 3.2は240億パラメータのモデルで、RAM/VRAMが14 GB以上必要になり、このページで扱う4〜8 GBの初心者向け範囲を大きく超えます。これはかつてここで推奨していた7Bの「Mistral 7B」とは異なる、より大きな別モデルです。RAM 8 GBがある場合は、代わりにLlama 3.1 8BまたはQwen3 8Bから始めてください。Mistral Small 3.2の実行に必要な16 GB以上のGPU階層についてはハードウェアガイドを参照してください。
Ollamaでこれらのモデルをどうやって実行しますか?
ollama.comからOllamaをインストールし、推奨入門モデルのために`ollama run llama3.2:3b`を実行します。Ollamaは最初の実行時にモデルをダウンロードします。ここに記載された5つのモデルはすべてOllamaライブラリにあります。
Llama 3.2 3Bは日常的なタスクに十分ですか?
可:要約、シンプルなQ&A、基本的なコード説明、会話チャット。不可:多段階推論、複雑なコーディング、長形式の構造化文章作成。それらのタスクには8 GB RAMでLlama 3.1 8BまたはQwen3 8Bにアップグレード。
3Bモデルと7Bモデルの違いは何ですか?
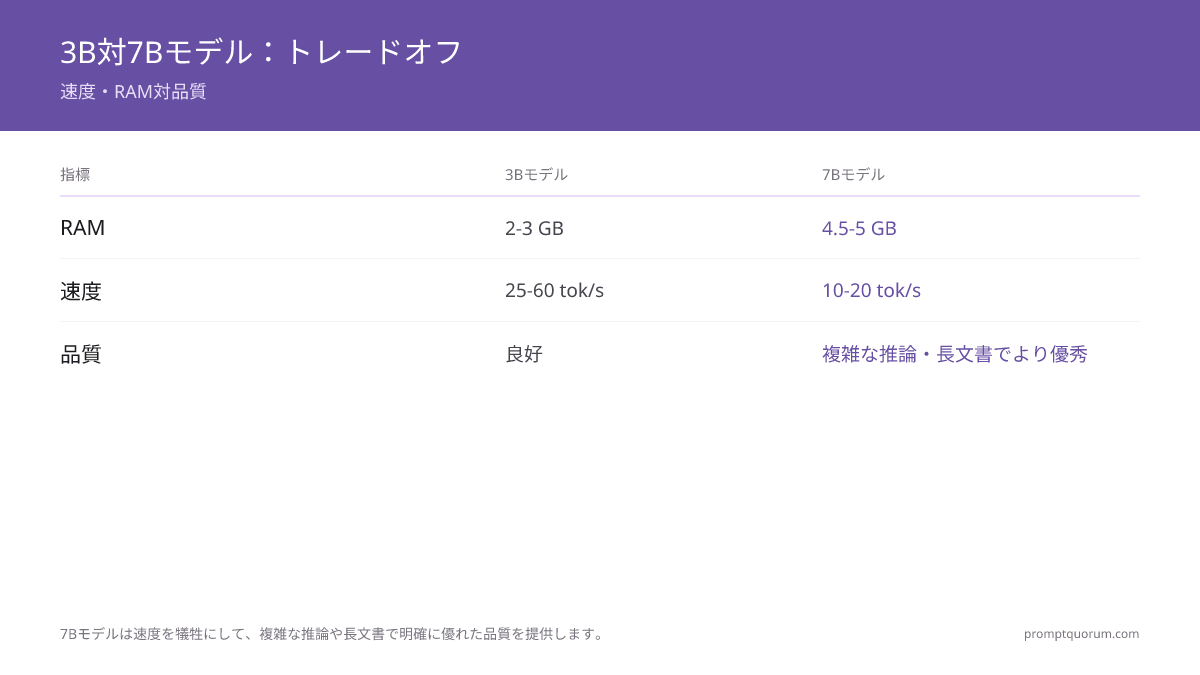
7Bモデルは複雑な指示と推論で明らかに優れた出力を生成します。3Bモデルは約半分のRAMを使用し、2〜3倍速く動作します。選択はほぼ常に利用可能なRAMで決まります——4〜6 GBマシンには3B、8 GBマシンには7B。
コーディングタスクに最適なモデルはどれですか?
この表の5モデルの中でHumanEval値が最も高いのはLlama 3.1 8Bです(72%。Phi-4 Mini 3.8Bは70%、Qwen3 8Bは57.3%)。多言語用途にはQwen3 8Bが向いています。コーディング専用モデルなら `ollama run qwen2.5-coder:7b` を試してください。4〜6 GB RAMに限定される場合は、ここで紹介するモデルの中でPhi-4 Mini 3.8BのHumanEval値が最も高くなります(2.5 GB RAMで70%)。
日本語や非英語言語にはどのモデルを使うべきですか?
Qwen3 8Bは中国語・日本語・韓国語・アラビア語・主要欧州語を含む29言語以上をネイティブサポートします。コミュニティの報告では、日本語テキストでLlamaより少ないトークンで済む傾向がありますが、結果はテキストによって異なります。
これらのモデルは個人データに使っても安全ですか?
推論は手元のハードウェア上で実行されるため、プロンプトはクラウドAPIに送信されません。ただしOllamaは、無効化しない限りモデルのダウンロードや更新確認のためにネットワークへ接続することがあります。機密データについてはクラウド事業者とプロンプトを共有せずに済みますが、コンプライアンスを保証するものではありません。
これらのモデルのダウンロードにどれくらいかかりますか?
100 Mbps接続で:Llama 3.2 1B(1.3 GB)約2分。Gemma 4 E2B(1.6 GB)約2分。Llama 3.2 3B(2 GB)約3分。Phi-4 Mini(2.3 GB)約3分。Llama 3.1 8B(約5 GB)とQwen3 8B(約5.2 GB)はそれぞれ約6〜7分。モデルは初回ダウンロード後にキャッシュされ——次回の起動は数秒で開始。
同じマシンで複数のモデルを実行できますか?
はい——5つすべてがディスク上に同時に共存できます。5つすべてをインストールする場合は15〜20 GBを計画してください。Ollamaは一度に1つのモデルをロードし、5分の非アクティブ後にアンロードします。
参考文献
- Meta AI. (2024). "Llama 3.2 Model Card." llama.meta.com/ — Llama 3.2 3Bと1Bモデルの公式仕様とベンチマーク。
- Microsoft. (2025). "Phi-4 Mini Technical Report." huggingface.co/microsoft/Phi-4-mini-instruct — Phi-4 Miniのベンチマークデータ(68% MMLU、70% HumanEval)。
- Google DeepMind. (2025). "Gemma Documentation." ai.google.dev/gemma/docs/core — 128Kコンテキストウィンドウ更新を含むGemma 4 E2Bの仕様と性能。
- Ollama. (2026). "Ollama Model Library." ollama.com/library — Ollamaモデルタグ・サイズ・プルコマンドの正規ソース。
- Mistral AI. (2024). "Mistral 7B Release Notes." mistral.ai/news/announcing-mistral-7b/ — 「よくある失敗」で言及したレガシー7Bモデルの技術仕様とApache 2.0ライセンスの詳細。
- Alibaba Qwen Team. (2025). "Qwen3 Technical Report." arXiv:2505.09388. arxiv.org/abs/2505.09388 — Qwen3 8Bの多言語ベンチマークデータとアーキテクチャの詳細。
- Meta AI. (2025). "Llama 3.1 Model Card." llama.meta.com/ — Llama 3.1 8Bの公式仕様とベンチマーク。