Key Takeaways
- Melhor modelo de código local no geral: Qwen3.8 27B — denso 27B, Apache 2.0, download de 18 GB, contexto 256K, 61,7 SWE-bench Pro e 90,3 LiveCodeBench v6 (segundo a Qwen). `ollama run qwen3.8`.
- Melhor para programação agêntica com 16 GB: Devstral Small 2 (Mistral AI) — 24B, 15 GB, 65,8% SWE-bench Verified (segundo a Mistral), criado para chamadas de ferramentas e edições em vários arquivos.
- Melhor para sessões agênticas longas: Laguna XS 2.1 (Poolside) — MoE 33B total / 3B ativos, 20 GB, contexto 256K, licença OpenMDW-1.1.
- Melhor para autocompletar no IDE: Codestral 22B (Mistral AI) — otimizado para FIM, 13 GB, suporte nativo ao Continue.dev.
- Melhor para 8 GB de RAM: Qwen3 8B — usa 5 GB de VRAM, melhor equilíbrio entre qualidade e velocidade nessa faixa.
- Kimi K2.6 e K2.7 Code não são uma escolha para hardware doméstico: ambos têm 1T de parâmetros e o Ollama os lista apenas como tags na nuvem; rodar localmente exige cerca de 300 GB de memória ou mais.
- SWE-bench Pro e Verified substituem o HumanEval como benchmarks principais — testam a resolução de issues reais do GitHub, não a geração de funções Python isoladas. As pontuações dos fabricantes usam protocolos diferentes e são referências, não comparações diretas.
- Para fluxos de trabalho com assistentes de código com IA (VS Code, Cursor), veja LLMs locais para fluxos de programação.
O melhor LLM local para programar em 2026 é o Qwen3.8 27B (Apache 2.0, 18 GB, 61,7 SWE-bench Pro segundo a Qwen) para uma GPU de 24 GB ou um Mac de 32 GB, com o Devstral Small 2 para programação agêntica com 16 GB e o Qwen3 8B para 8 GB.
O SWE-bench mede o quanto uma IA corrige bugs reais do GitHub — quanto maior, melhor. Um modelo "denso" como o Qwen3.8 27B usa todos os parâmetros em cada token, o que mantém o comportamento previsível; os enormes modelos Kimi são de "mistura de especialistas" e ainda precisam de centenas de gigabytes de memória para guardar seus pesos.
De onde vêm os números deste guia
SWE-bench é o benchmark principal para programação prática em 2026 -- ele avalia modelos na resolução de issues reais do GitHub, não apenas na geração de funções isoladas (HumanEval). Um modelo com 60% no SWE-bench Pro não resolve necessariamente 6 de 10 bugs reais: as variantes Pro e Verified têm tarefas e protocolos diferentes.
As pontuações vêm de páginas de modelos e relatórios técnicos dos próprios fabricantes (Qwen, Mistral AI, Poolside, Moonshot AI), e os tamanhos e comandos vêm das páginas das bibliotecas do Ollama. Os números dos fabricantes usam protocolos distintos e servem como referência; a PromptQuorum não executou esses benchmarks por conta própria.
Fatos rápidos — LLMs locais para programar num relance
- Melhor no geral: Qwen3.8 27B (Alibaba) — denso 27B, Apache 2.0, 18 GB no Ollama, contexto 256K, 61,7 SWE-bench Pro, 90,3 LiveCodeBench v6 (segundo a Qwen).
- Geração anterior da Qwen: Qwen 3.6 27B — 77,2% SWE-bench Verified e 53,5 SWE-bench Pro (segundo a Qwen); continua sendo uma alternativa sólida, superado pelo Qwen3.8 27B.
- Melhor para programação agêntica em 24B: Devstral Small 2 (Mistral AI, França) — 15 GB, 65,8% SWE-bench Verified, Apache 2.0, chamadas de ferramentas e edições em vários arquivos. Requer Ollama 0.13.3 ou superior.
- Melhor para sessões agênticas longas: Laguna XS 2.1 (Poolside) — MoE 33B total / 3B ativos, 20 GB, contexto 256K, SWE-bench Verified 70,9%, SWE-bench Multilingual 63,1%, licença OpenMDW-1.1.
- Grande MoE para máquinas de 64 GB: Qwen3-Coder-Next — 80B total / 3B ativos, 52 GB (Q4), contexto 256K.
- Melhor para autocompletar no IDE: Codestral 22B (Mistral) — otimizado para FIM, integração com Continue.dev, 13 GB, contexto 32K.
- Melhor para 8 GB de RAM: Qwen3 8B — usa 5 GB de VRAM, melhor equilíbrio entre qualidade e velocidade.
- Pesos abertos em escala de fronteira: Kimi K2.6 e Kimi K2.7 Code (Moonshot AI) — MoE 1T total / 32B ativos, contexto 256K. O Ollama oferece apenas tags `:cloud`; builds GGUF locais precisam de cerca de 310 a 470 GB conforme a quantização.
- Mudança de benchmark: SWE-bench Pro e Verified (issues reais do GitHub) são as métricas principais para programação prática. O HumanEval (funções Python isoladas) continua útil para comparar modelos pequenos.
- Configuração recomendada: GPU de 24 GB ou 32 GB de memória unificada (Qwen3.8 27B com folga); 16 GB bastam para o Devstral Small 2.
🏆 Melhores LLMs locais para programar (seleção rápida)
- Melhor no geral: Qwen3.8 27B — denso 27B, 18 GB, contexto 256K, 61,7 SWE-bench Pro (segundo a Qwen). `ollama run qwen3.8`
- Melhor programação agêntica em 24B: Devstral Small 2 — edições em vários arquivos, chamadas de ferramentas, 15 GB. `ollama run devstral-small-2`
- Melhor para sessões agênticas longas: Laguna XS 2.1 — MoE 33B/3B ativos, 20 GB, contexto 256K. `ollama run laguna-xs-2.1`
- Grande MoE (máquinas de 64 GB): Qwen3-Coder-Next — 80B/3B ativos, 52 GB. `ollama run qwen3-coder-next`
- Melhor para completar com consciência do repositório em 24 GB: Qwen3-Coder 30B — MoE 30B/3,3B ativos, 19 GB, contexto 256K. `ollama run qwen3-coder:30b`
- Melhor para autocompletar no IDE: Codestral 22B — otimizado para FIM com Continue.dev, 13 GB. `ollama run codestral:22b`
- Melhor para 8 GB de RAM: Qwen3 8B — 5 GB de VRAM. `ollama run qwen3:8b`
- 👉 Na dúvida: Qwen3 8B em notebooks de 8–16 GB, Qwen3.8 27B com 24 GB de memória de GPU ou unificada.
- 👉 Com 16 GB: o Devstral Small 2 é o que melhor se encaixa para programação agêntica; o Qwen3.8 27B (18 GB) pede uma placa de 24 GB ou um Mac de 32 GB.
- 👉 Para sessões agênticas longas: experimente o Laguna XS 2.1 ou o Devstral Small 2.
- 👉 Para completar no IDE: use o Codestral 22B com Continue.dev.
🛠️Boa prática: Ajuste primeiro o tamanho do modelo ao seu hardware. Com 8 GB, use o Qwen3 8B; com 16 GB, o Devstral Small 2; com 24 GB de memória de GPU ou unificada, o Qwen3.8 27B. Kimi K2.6 e K2.7 Code não são escolhas locais práticas: o Ollama os oferece apenas como tags na nuvem e os builds locais exigem 300 GB ou mais.
Em uma frase
O melhor LLM local para programar em 2026 é o Qwen3.8 27B (18 GB, 61,7 SWE-bench Pro segundo a Qwen), com o Devstral Small 2 para programação agêntica com 16 GB, o Laguna XS 2.1 para sessões longas, o Codestral 22B para autocompletar no IDE e o Qwen3 8B para 8 GB de RAM.
Em Termos Simples
Rodar um modelo de código localmente é como instalar um assistente de programação com IA no seu laptop — mantém seu código privado, funciona offline, mas é mais lento que APIs na nuvem como o GitHub Copilot.
O que torna um LLM local bom para programar?
Em 2026, SWE-bench Pro e SWE-bench Verified substituíram em grande parte o HumanEval como benchmarks práticos de código. Eles testam se o modelo resolve issues reais do GitHub — mudanças em vários arquivos, compreensão de bases de código, escrita de testes — e não apenas a geração de funções isoladas. A Qwen informa 61,7 no SWE-bench Pro para o Qwen3.8 27B e 77,2% no SWE-bench Verified para o anterior Qwen 3.6 27B.
Modelos específicos para código são ajustados em grandes corpora de código (GitHub, Stack Overflow, documentação) e costumam incluir treinamento fill-in-the-middle (FIM) -- a capacidade de completar código com o contexto antes e depois do cursor, necessária para o autocompletar no IDE.
Modelos gerais como o Llama 3.1 8B chegam a 72% no HumanEval, o que é competitivo. Mas modelos de código dedicados do mesmo tamanho pontuam 5-15% mais, porque seus dados e ajuste priorizam a precisão do código em vez de tarefas de linguagem geral.
📌Nota: As pontuações SWE-bench informadas pelos fabricantes usam arneses de agente, conjuntos de tarefas e configurações diferentes (os 61,7 da Qwen no SWE-bench Pro usam o arnês do Claude Code com tarefas corrigidas), portanto dois números publicados são referências, não uma comparação direta. O HumanEval continua útil para comparar funções isoladas, mas o SWE-bench prevê melhor o desempenho em fluxos de desenvolvimento reais.
#1 Qwen3.8 27B -- Melhor LLM local para programar no geral
O Qwen3.8 27B (Alibaba, lançado em agosto de 2026) é o melhor LLM local para programar em uma GPU de 24 GB ou um Mac de 32 GB. É um modelo denso de 27B (todos os parâmetros ativos por token) com licença Apache 2.0. A Qwen informa 61,7 no SWE-bench Pro, 73,0 no Terminal Bench 2.1 e 90,3 no LiveCodeBench v6. O download no Ollama tem 18 GB com janela de contexto de 256K.
`ollama run qwen3.8`. Aceita texto e imagens, suporta chamadas de ferramentas e modo de raciocínio, e serve para análise de vários arquivos, depuração e refatoração. A Qwen informou 53,5 no SWE-bench Pro para o anterior Qwen 3.6 27B (77,2% no SWE-bench Verified); `ollama run qwen3.6:27b` continua sendo uma alternativa válida.
Especificação | Valor |
|---|---|
| SWE-bench Pro | 61,7 (segundo a Qwen) |
| LiveCodeBench v6 | 90,3 (segundo a Qwen) |
| Arquitetura | Denso (27B ativos) |
| Tamanho no Ollama (Q4_K_M) | 18 GB |
| Janela de contexto | 256K tokens |
| Licença | Apache 2.0 |
| Comando do Ollama | ollama run qwen3.8 |
🔍Insight: A Qwen executa o SWE-bench Pro com o arnês do Claude Code e um conjunto de tarefas refinado, com tarefas problemáticas corrigidas; por isso 61,7 não é diretamente comparável às pontuações publicadas por outros fabricantes. É um sinal forte do fabricante, não um teste comparativo direto.
#2 Devstral Small 2 -- Melhor para programação agêntica em 24B
O Devstral Small 2 (Mistral AI) foi criado para fluxos de programação agêntica — edições em vários arquivos, geração de código com chamadas de ferramentas e ciclos de depuração. 24B de parâmetros, 15 GB no Ollama, 65,8% no SWE-bench Verified (segundo a Mistral), Apache 2.0. `ollama run devstral-small-2` (requer Ollama 0.13.3 ou superior).
A melhor escolha para quem usa aider, fluxos no estilo Claude Code ou modificações de código em várias etapas em uma máquina de 16 GB. Ele lê o retorno de erros, edita vários arquivos e aceita entrada de imagens.
Especificação | Valor |
|---|---|
| SWE-bench Verified | 65,8% (segundo a Mistral) |
| Ideal para | Fluxos agênticos, vários arquivos |
| Tamanho no Ollama | 15 GB |
| Janela de contexto | 384K tokens (Ollama) |
| Licença | Apache 2.0 |
| Comando do Ollama | ollama run devstral-small-2 |
💡Dica: Programação agêntica = raciocinar → escrever código → executar → observar erros → corrigir → iterar. O Devstral Small 2 cuida desse ciclo com 15 GB, o que o torna a escolha agêntica prática para máquinas de 16 GB em que o Qwen3.8 27B (18 GB) não cabe.
#3 Laguna XS 2.1 e Qwen3-Coder-Next -- Programação agêntica de longa duração
O Laguna XS 2.1 (Poolside, 2 de julho de 2026) mira a programação agêntica de longa duração. MoE 33B total / 3B ativos, contexto 256K, licença OpenMDW-1.1, SWE-bench Verified 70,9% e SWE-bench Multilingual 63,1%. A tag padrão do Ollama tem 20 GB (Q4_K_M). `ollama run laguna-xs-2.1`.
O Qwen3-Coder-Next (Alibaba, fevereiro de 2026) é a opção MoE maior para máquinas de 64 GB: 80B total / 3B ativos, 52 GB em Q4_K_M, contexto 256K. `ollama run qwen3-coder-next`. Para um modelo de código menor e consciente do repositório com 24 GB, `ollama run qwen3-coder:30b` (30B total / 3,3B ativos, 19 GB, Apache 2.0) é a alternativa consolidada.
Se você quer a maior janela de contexto para sessões agênticas de várias horas, escolha o Laguna XS 2.1; se prefere um modelo de origem europeia com Apache 2.0 e menor consumo de memória, escolha o Devstral Small 2.
Especificação | Valor |
|---|---|
| Tamanho do Laguna XS 2.1 | 20 GB (33B total / 3B ativos) |
| SWE-bench do Laguna XS 2.1 | 70,9% Verified / 63,1% Multilingual |
| Tamanho do Qwen3-Coder-Next | 52 GB (80B total / 3B ativos) |
| Janela de contexto | 256K tokens (ambos) |
| Comandos do Ollama | laguna-xs-2.1 / qwen3-coder-next |
🔍Insight: Modelos MoE mantêm todos os parâmetros na memória, mas calculam com apenas alguns bilhões por token: geram rápido para o tamanho, mas ainda precisam de RAM para todos os pesos (20 GB para o Laguna XS 2.1, 52 GB para o Qwen3-Coder-Next).
#4 Codestral 22B -- Melhor para autocompletar no IDE
O Codestral 22B (Mistral AI) continua sendo o modelo FIM dedicado ao autocompletar no IDE. Criado para completar com fill-in-the-middle usando Continue.dev no VS Code e no Cursor. É o modelo mais antigo desta página (o build do Ollama tem cerca de dois anos) e continua sendo a opção mais focada em FIM.
`ollama run codestral:22b`. Treinado para completar no estilo IDE, em que o contexto vem antes e depois do cursor. Forte em Python, JavaScript, TypeScript, Go e Rust. O build do Ollama tem janela de contexto de 32K.
Para completar com consciência do repositório, `ollama run qwen3-coder:30b` é a melhor alternativa de pesos abertos (Apache 2.0, 19 GB). Para um modelo de código pequeno com raciocínio em 16 GB, `ollama run gpt-oss:20b` (pesos abertos da OpenAI, MoE 21B total / 3,6B ativos, raciocínio ajustável) também é uma escolha sólida.
Especificação | Valor |
|---|---|
| Ideal para | FIM (autocompletar no IDE) |
| Tamanho no Ollama | 13 GB |
| Janela de contexto | 32K tokens |
| Suporte a FIM | Sim (uso principal) |
| Integração com IDE | Continue.dev, Cursor |
| Comando do Ollama | ollama run codestral:22b |
🔍Insight: O Codestral 22B, da Mistral AI, foi criado especificamente para completar com FIM (fill-in-the-middle). Com o Continue.dev, oferece uma alternativa local ao autocompletar do GitHub Copilot.
#5 Qwen3 8B -- Melhor modelo de código para 8 GB de RAM
O Qwen3 8B é a recomendação para a faixa de 8 GB. Bom desempenho em código, multilíngue, usa apenas 5 GB de VRAM. O Qwen3.8 existe no Ollama por enquanto só como modelo de 27B, então o Qwen3 8B continua sendo a menor opção Qwen atual. Para mais detalhes sobre a VRAM de outros modelos de código, veja o guia de requisitos de VRAM →. `ollama run qwen3:8b`.
🔍Insight: O Qwen3 8B é o ponto de partida recomendado para máquinas de 8 GB: ótimo suporte multilíngue, inferência rápida e boa qualidade de código em tarefas reais.
Por que Kimi K2.6 e K2.7 Code não são uma escolha local prática
Kimi K2.6 e Kimi K2.7 Code (Moonshot AI) são os maiores modelos de código de pesos abertos desta lista, mas não são uma escolha para hardware doméstico. Ambos são modelos MoE de 1T de parâmetros com 32B ativos e janela de contexto de 256K. A Moonshot AI informou 58,6 no SWE-bench Pro para o Kimi K2.6; o Kimi K2.7 Code se baseia no K2.6 para sessões longas de programação.
No Ollama, ambos aparecem apenas como tags na nuvem (`kimi-k2.6:cloud`, `kimi-k2.7-code:cloud`), que enviam seus prompts ao serviço hospedado do Ollama. Rodar localmente exige um build GGUF da comunidade: a Unsloth indica cerca de 310 GB em 1 bit e 325–350 GB em 2 bits para o K2.7 Code, ou seja, hardware de estação de trabalho ou servidor, não notebooks.
⚠️Aviso: Uma tag `:cloud` não é inferência local. Se a privacidade é o motivo de usar um modelo local, use o Qwen3.8 27B, o Devstral Small 2 ou o Laguna XS 2.1.
Como os modelos de código se comparam? SWE-bench + HumanEval
Modelo | HumanEval | SWE-bench | RAM | FIM |
|---|---|---|---|---|
| Qwen3.8 27B | — | 61,7 (Pro) | 18 GB | — |
| Qwen 3.6 27B | — | 77,2% (Verified) / 53,5 (Pro) | ~22 GB | — |
| Devstral Small 2 | — | 65,8% (Verified) | 15 GB | — |
| Laguna XS 2.1 (MoE) | — | 70,9% (Verified) | 20 GB (3B ativos) | — |
| Qwen3-Coder-Next (MoE) | — | varia conforme o arnês | 52 GB (3B ativos) | — |
| Kimi K2.6 (MoE) | — | 58,6 (Pro) | 300+ GB (nuvem no Ollama) | — |
| Codestral 22B | — | — | 13 GB | Sim (principal) |
| Qwen2.5-Coder 32B | — | — | 20 GB | Sim |
| Qwen3 8B | — | — | 5 GB | Sim |
| DeepSeek-R1 14B | — | — | 10 GB | Não |
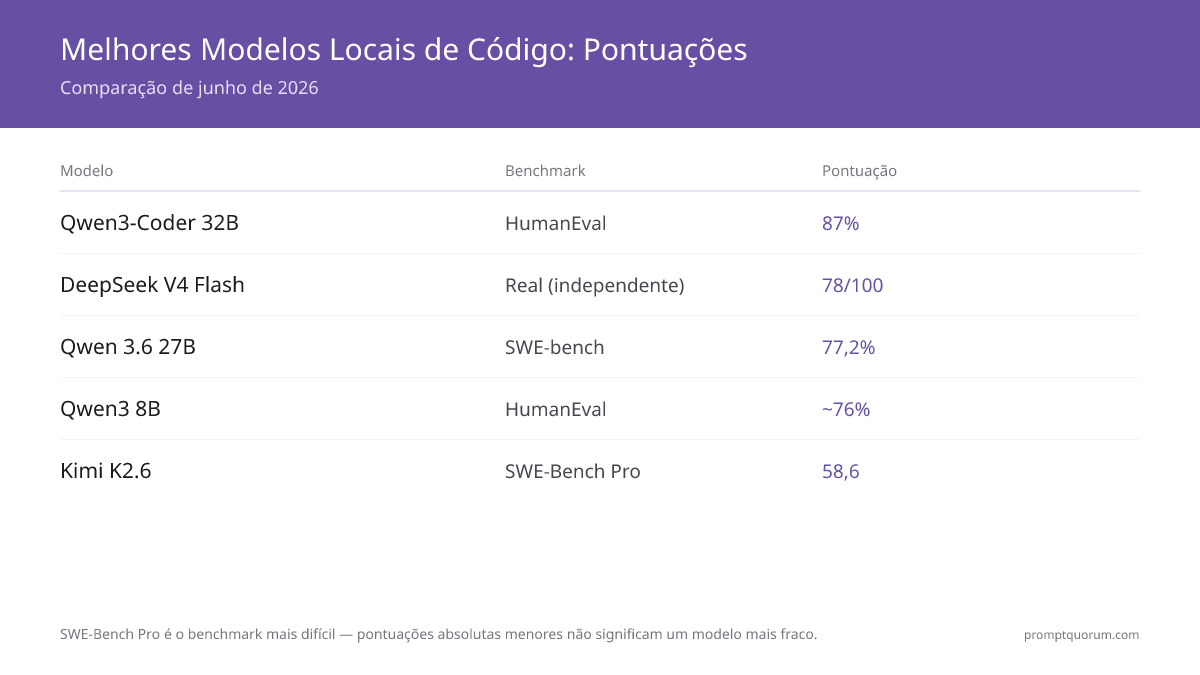
📌Nota: O HumanEval mede a geração de funções Python isoladas. O SWE-bench mede mudanças reais de código em vários arquivos. "Pro" e "Verified" são variantes diferentes do SWE-bench e não são intercambiáveis: 77,2% Verified e 61,7 Pro não podem ser comparados diretamente. Todas as pontuações são informadas pelos fabricantes. Os números de HumanEval de modelos mais antigos (Qwen2.5-Coder 32B, Qwen3 8B) vêm de versões anteriores desta página e não foram reverificados.
Qual modelo serve para qual tarefa de programação?
- 1Depuração de funções Python e refatoração em vários arquivos -- O Qwen3.8 27B é a primeira escolha: um modelo denso mantém todos os 27B parâmetros ativos por token, o que favorece o raciocínio em vários arquivos. O Devstral Small 2 é a alternativa mais leve quando só há 16 GB. Escolha: Qwen3.8 27B.
- 2Ciclos agênticos (planejar → editar → rodar testes → corrigir) -- O Devstral Small 2 e o Laguna XS 2.1 foram criados para chamadas de ferramentas e sessões longas. O Laguna XS 2.1 oferece 256K de contexto; o Devstral Small 2 usa menos memória. Escolha: Laguna XS 2.1 para sessões longas, Devstral Small 2 para máquinas de 16 GB.
- 3FIM / autocompletar no IDE (VS Code) -- O fill-in-the-middle exige um modelo treinado para isso. Codestral 22B e Qwen3 8B funcionam via Continue.dev; os modelos Kimi, Laguna e Devstral não são focados em FIM. Escolha: Codestral 22B.
- 4Scripts rápidos em notebooks de 8 GB -- O Qwen3 8B resolve scripts do dia a dia, SQL e código repetitivo com baixa latência. Espere resultados mais fracos em sistemas de tipos grandes e mudanças em vários arquivos. Escolha: Qwen3 8B.
🔍Insight: Modelos maiores pontuam mais que modelos de 8B em tarefas no estilo SWE-bench (depuração e refatoração em vários arquivos); em scripts do dia a dia a diferença diminui. Escolha o modelo primeiro pela tarefa e depois pelo seu orçamento de memória.
Qual modelo de código equilibra melhor velocidade e qualidade de saída?
Tarefa | Qwen3.8 27B | Devstral Small 2 | Qwen3 8B | Codestral 22B |
|---|---|---|---|---|
| Refatoração e depuração em vários arquivos | Primeira escolha (denso, 18 GB) | Bom (15 GB) | Limitado em mudanças grandes | Não é o foco |
| Ciclos agênticos com ferramentas | Forte (ferramentas, raciocínio) | Feito para isso | Básico | Não é o foco |
| Código repetitivo, APIs REST, testes | Forte, mais lento | Forte | Rápido, conferir validação | Rápido, genérico |
| Autocompletar FIM (cursor no meio da linha) | Não é o foco | Não é o foco | Suportado | Melhor opção (FIM) |
💡Dica: Ponto-chave: os modelos de 18 GB e 15 GB são mais lentos por token que os de 8B, mas mais precisos em tarefas de raciocínio. Para autocompletar no IDE, use apenas modelos otimizados para FIM (Codestral 22B, Qwen3 8B). O desempenho depende da sua GPU, da quantização e do tamanho do contexto; teste na sua própria máquina.
🛠️Boa prática: Recomendação prática: escolha pelo tipo de tarefa. Para geração de código em lote ou revisões de refatoração, use o Qwen3.8 27B. Para ciclos agênticos com 16 GB, o Devstral Small 2. Para autocompletar em tempo real no IDE, o Codestral 22B ou o Qwen3 8B, onde a latência mais importa.
Qual LLM local para programar você deve usar?
O modelo escolhido importa, mas a forma como você o instrui importa ainda mais para a qualidade do código. Técnicas de prompt estruturado — indicar linguagem, restrições, casos de teste e formato de saída — melhoram muito a precisão da geração de código. O guia de engenharia de prompts cobre 80 técnicas de fundamentos, frameworks e métodos de avaliação.
Para um fluxo completo de IDE com esses modelos, veja Substituir o GitHub Copilot por um LLM local — a pilha de código aberto (Continue.dev + Ollama + Qwen3-Coder) combina bem com as escolhas acima.
- 8 GB de RAM, foco em código: `ollama run qwen3:8b` -- 5 GB de VRAM, melhor modelo dessa faixa.
- 16 GB de RAM: `ollama run devstral-small-2` -- melhor para programação agêntica em 24B (edições em vários arquivos, ciclos de depuração), 15 GB.
- GPU de 24 GB ou Mac de 32 GB (melhor qualidade): `ollama run qwen3.8` -- Qwen3.8 27B, 18 GB, 61,7 SWE-bench Pro (segundo a Qwen).
- Sessões agênticas longas: `ollama run laguna-xs-2.1` -- 20 GB, contexto 256K, SWE-bench Verified 70,9%.
- Máquinas de 64 GB: `ollama run qwen3-coder-next` -- MoE de 80B com 3B ativos, 52 GB.
- Autocompletar no IDE no VS Code: `ollama run codestral:22b` via Continue.dev -- otimizado para FIM, melhor alternativa local ao Copilot.
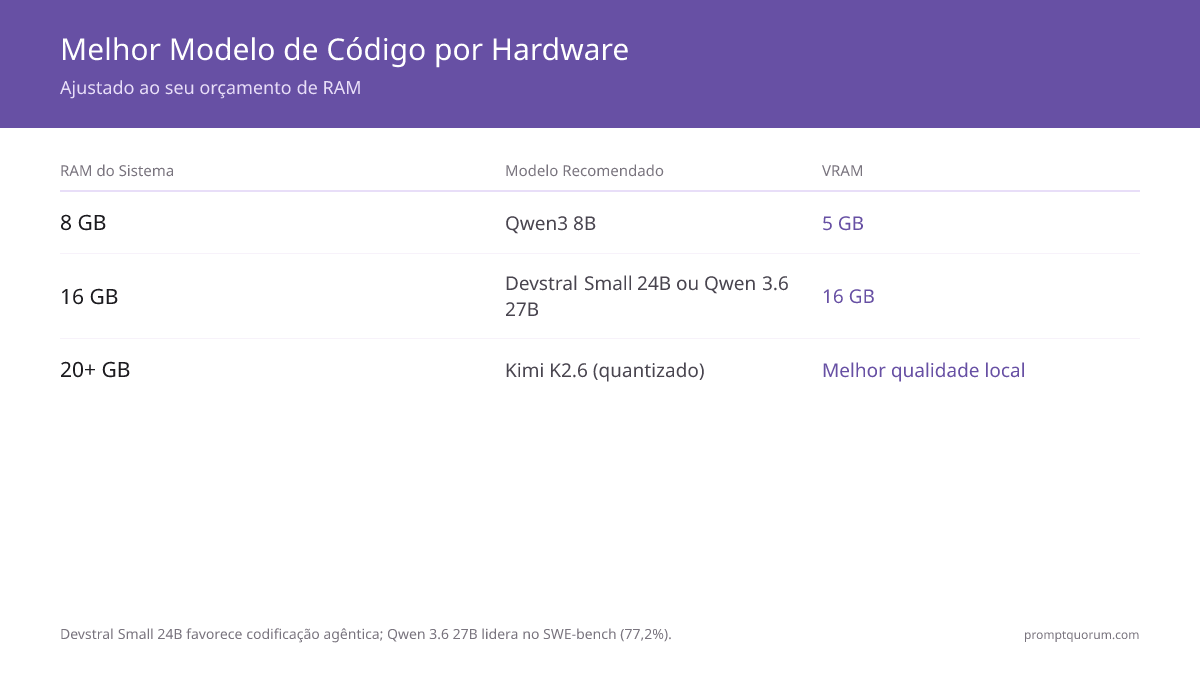
🛠️Boa prática: Ajuste primeiro o tamanho do modelo ao seu hardware e depois otimize para o seu caso de uso. Com 8 GB, o Qwen3 8B é a melhor escolha. Com 16 GB, use o Devstral Small 2. Com 24 GB ou mais, o Qwen3.8 27B. É melhor um modelo que roda bem do que o modelo perfeito que sofre.
Melhores LLMs de Código para 8 GB de VRAM (RTX 3060 12GB / RTX 3070 8GB / RX 6800 16GB)
Em máquinas com 8 GB de RAM, o Qwen3 8B é a melhor escolha para programação -- usa apenas 5 GB de VRAM, deixando 3 GB para seu IDE, navegador e outras aplicações. O Qwen3 8B inclui suporte a FIM (fill-in-the-middle) para autocompletado no VS Code via Continue.dev.
- Qwen3 8B (recomendado) — 5 GB VRAM, 20–35 tok/seg, suporte a FIM. `ollama run qwen3:8b`
- Phi-4 Mini 3.8B — 68% MMLU (raciocínio), 2,5 GB VRAM, ótimo para inferência leve. `ollama run phi4-mini`
- Llama 3.2 3B — 40–60 tok/seg, 2,5 GB VRAM, boa alternativa para configurações bem limitadas. `ollama run llama3.2:3b`
Melhores LLMs de código para 16 GB de VRAM (RTX 4070 Ti 16GB / RTX 5070 Ti 16GB / placas de 24 GB)
Com 16 GB, o Devstral Small 2 (15 GB) é o que melhor se encaixa para programação agêntica. O Qwen3.8 27B (download de 18 GB) pede uma GPU de 24 GB ou um Mac de 32 GB de memória unificada; é a melhor escolha quando você tem essa folga.
- Devstral Small 2 — melhor para programação agêntica, chamadas de ferramentas, edições em vários arquivos, 15 GB. `ollama run devstral-small-2`
- Qwen3.8 27B — melhor no geral, denso 27B, 18 GB, contexto 256K, cabe em uma placa de 24 GB. `ollama run qwen3.8`
- Qwen3-Coder 30B — MoE 30B/3,3B ativos, 19 GB, completar com consciência do repositório em uma placa de 24 GB. `ollama run qwen3-coder:30b`
Melhores LLMs de Código para 6 GB de VRAM (GPUs Econômicas / Gráficos Integrados)
Para máquinas com 4–6 GB de VRAM (GPUs econômicas, laptops mais antigos, iGPU Intel), o Phi-4 Mini 3.8B é a melhor escolha -- atinge 68% de desempenho de raciocínio no MMLU usando apenas 2,5 GB de VRAM. Isso deixa ~3,5 GB para o sistema.
- Phi-4 Mini 3.8B (recomendado) — 68% de raciocínio MMLU, 2,5 GB VRAM, excelente para lógica e depuração. `ollama run phi4-mini`
- Qwen3 4B — variante menor, 4 GB VRAM, equilíbrio entre qualidade e velocidade para hardware econômico. `ollama run qwen3:4b`
🧭 Quem deve usar o quê: perfis e recomendações
- Iniciante (sem experiência com LLMs locais): LM Studio + Qwen3 8B -- interface gráfica, sem terminal, inclui FIM para completar código, 5 GB de VRAM.
- Desenvolvedor de notebook (8–16 GB de RAM, código do dia a dia): Ollama + Qwen3 8B (máquinas de 8 GB) ou Devstral Small 2 (máquinas de 16 GB) -- qualidade e desempenho equilibrados, roda bem por horas.
- Desenvolvedor avançado (depuração, refatoração, raciocínio complexo, 24 GB ou mais): Ollama + Qwen3.8 27B (modelo denso, 18 GB) -- lida com contexto de vários arquivos e design de algoritmos.
- Sessões agênticas longas (planejar → programar → testar → iterar): Ollama + Laguna XS 2.1 (contexto 256K, SWE-bench Verified 70,9%) ou Devstral Small 2 -- criados para chamadas de ferramentas e execuções em várias etapas.
- Fluxo centrado no IDE (VS Code, Cursor, JetBrains): Continue.dev + Codestral 22B -- otimizado para FIM na posição do cursor, melhor alternativa local ao Copilot.
- Ambientes críticos para privacidade (LGPD, HIPAA, código proprietário): qualquer modelo local acima via Ollama (não uma tag `:cloud`) -- sem chamadas externas de API na inferência, então seu código fica na sua máquina enquanto plugins do editor e outras ferramentas também não usarem a rede.
⚠️Aviso: ❌ Evite: rodar o Qwen3.8 27B (18 GB) em máquinas com menos de cerca de 24 GB de memória de GPU ou unificada. Quando o modelo transborda para a RAM do sistema, a velocidade cai muito. Use o Qwen3 8B ou o Devstral Small 2 em máquinas menores.
⚠️Aviso: ❌ Evite: usar modelos de uso geral (Llama 3.1 8B) quando precisar de autocompletar no IDE. Apenas modelos específicos de código com suporte a FIM funcionam para completar no editor -- Codestral 22B, Qwen3 8B.
🔍Insight: Iniciante → intermediário → avançado também é uma progressão de requisitos de hardware. Comece com o Qwen3 8B (8 GB), passe para o Devstral Small 2 (16 GB) ao adicionar ferramentas e fluxos de trabalho, e chegue ao Qwen3.8 27B (24 GB ou mais) quando precisar da máxima qualidade de raciocínio.
❌ Quando NÃO Usar LLMs Locais para Programação
- Você precisa de conhecimento dos frameworks mais recentes (APIs de 2025+): modelos locais são treinados com datas de corte fixas e não conhecem APIs lançadas depois. Para versões recentes de frameworks, forneça a documentação atual no prompt ou use um modelo de nuvem de ponta, como o GPT-5.6 ou o Claude Sonnet 5.
- Você precisa de raciocínio multi-arquivo em grandes bases de código (100 mil+ tokens): modelos locais degradam em contextos muito longos. A latência se torna proibitiva. Modelos na nuvem (GPT-5.6, Claude) lidam nativamente com contextos de 100 mil+ tokens. Para refatoração arquitetural de serviços inteiros, use modelos na nuvem.
- A latência precisa ser menor que 300ms (codificação interativa em tempo real): modelos locais rodam a 15-25 tokens/seg em CPU (laptops típicos), gerando um atraso de 5-10 segundos por resposta. O GitHub Copilot e o Claude no IDE completam sugestões em menos de 1 segundo. Para autocompletado no nível de tecla, modelos locais são lentos demais.
- Você precisa da melhor precisão de depuração: em tarefas complexas de depuração (rastrear múltiplas pilhas de chamadas, identificar erros de tipo sutis), modelos de nuvem de ponta como o GPT-5.6 e o Claude Sonnet 5 costumam continuar à frente em issues reais de código. Modelos locais são fortes em geração; modelos de ponta tendem a ser melhores em diagnóstico.
- Você não pode tolerar alucinação no código gerado: modelos locais pequenos podem gerar código sintaticamente válido mas logicamente incorreto em tarefas complexas, e modelos maiores na nuvem costumam ser mais confiáveis. Para código de missão crítica (sistemas de pagamento, segurança), exija revisão humana de todo o código gerado.
🔍Insight: 👉 LLMs locais são melhores para: privacidade + trabalho offline + controle de custos — NÃO para desempenho máximo. Se a precisão máxima importa mais que esses três fatores, use APIs na nuvem.
📊 Melhores LLMs locais para programar comparados (matriz de decisão)
Não sabe qual modelo de código escolher? O PromptQuorum envia um mesmo prompt para vários modelos ao mesmo tempo (Qwen3.8, Devstral, GPT-5.6, Claude) e mostra lado a lado as saídas, os tempos de resposta reais e a precisão no SEU código. Experimente o PromptQuorum grátis — 5 minutos, sem cadastro.
Modelo | Ideal para | VRAM | Velocidade | Ponto forte | Quando escolher |
|---|---|---|---|---|---|
| Qwen3.8 27B | Melhor no geral, raciocínio em vários arquivos | ~18 GB | depende da GPU | 61,7 SWE-bench Pro (segundo a Qwen), denso 27B, contexto 256K, Apache 2.0 | Você tem GPU de 24 GB ou Mac de 32 GB e quer a melhor qualidade local |
| Devstral Small 2 | Programação agêntica em 24B | ~15 GB | depende da GPU | 65,8% SWE-bench Verified (segundo a Mistral), chamadas de ferramentas, vários arquivos, Apache 2.0 | Você usa aider ou agentes no estilo Claude Code com 16 GB |
| Laguna XS 2.1 | Programação agêntica de longa duração | ~20 GB (3B ativos) | depende da GPU | SWE-bench Verified 70,9%, contexto 256K, MoE 33B/3B ativos, OpenMDW-1.1 | Você faz sessões agênticas de várias horas e precisa de 256K de contexto |
| Qwen3-Coder-Next | Grande MoE em máquinas de 64 GB | ~52 GB (3B ativos) | depende da GPU | MoE 80B total/3B ativos, contexto 256K | Você tem 64 GB de memória unificada e quer um modelo de código maior |
| Codestral 22B | Autocompletar no IDE (VS Code, Cursor) | ~13 GB | depende da GPU | Otimizado para FIM, melhor alternativa local ao Copilot, nativo no Continue.dev | Você quer autocompletar a cada tecla via Continue.dev |
| Qwen3 8B | Código em notebook, ideal para 8 GB de RAM | ~5 GB | o mais rápido aqui | Código melhorado, suporte a FIM, multilíngue | Você tem 8 GB de RAM e quer o melhor modelo de código local dessa faixa |
| Kimi K2.6 / K2.7 Code | Pesos abertos em escala de fronteira | 300+ GB (tag na nuvem no Ollama) | classe servidor | MoE 1T total/32B ativos, contexto 256K | Você tem hardware de estação ou servidor, ou aceita uma tag na nuvem |
| GPT-5.6 (nuvem) | APIs recentes, raciocínio complexo, desempenho máximo | N/D (nuvem) | <1 s | Melhor precisão, conhecimento recente, raciocínio em vários arquivos | Você precisa de desempenho máximo, latência em tempo real ou conhecimento recente de frameworks |
| Claude Sonnet 5 (nuvem) | Revisão de código, decisões de arquitetura, depuração | N/D (nuvem) | <1 s | Ótimo em compreender código, depurar e contexto de vários arquivos | Você prioriza precisão de depuração e revisão de código acima de custo ou privacidade |
Considerações regionais / LGPD
Brasil (LGPD): Usar LLMs locais para assistência de código garante que código proprietário, tokens de segurança e dados de clientes nunca saiam da infraestrutura da organização. Isso é especialmente importante para fintechs, healthtechs e qualquer empresa sujeita à LGPD (Lei nº 13.709/2018) que processa código com dados pessoais incorporados.
Para startups brasileiras: Continue.dev + Qwen3 8B (8 GB VRAM) é o stack mais acessível que garante conformidade com LGPD -- código permanece local, custo zero por completado.
Erros comuns ao escolher um LLM local para código
- Usar HumanEval como único critério -- HumanEval mede completação de função única. SWE-bench mede resolução de bugs reais. Para uso prático, SWE-bench é mais relevante.
- Julgar modelos MoE só pelos parâmetros ativos -- o Laguna XS 2.1 tem apenas 3B parâmetros ativos, mas os 33B precisam caber na memória (20 GB). Modelos MoE geram rápido para o tamanho, porém os pesos completos ainda exigem RAM -- por isso um modelo de 1T como o Kimi K2.6 exige 300+ GB localmente.
- Não configurar FIM para autocompletado -- Para completação de código inline no IDE, use modelos com suporte a FIM (Fill-in-the-Middle): Codestral 22B ou Qwen3 8B.
Perguntas frequentes
Qual é o melhor LLM local para programar?
O Qwen3.8 27B (Alibaba, Apache 2.0) — denso 27B, 18 GB, contexto 256K, 61,7 SWE-bench Pro segundo a Qwen. `ollama run qwen3.8`. Para programação agêntica com 16 GB: Devstral Small 2. Para sessões longas: Laguna XS 2.1. Para autocompletar no IDE: Codestral 22B. Para máquinas de 8 GB: Qwen3 8B.
Qual modelo Qwen é o melhor para programar?
O Qwen3.8 27B é a melhor escolha Qwen de uso geral para programar em uma GPU de 24 GB ou um Mac de 32 GB (18 GB, 61,7 SWE-bench Pro, segundo a Qwen). O Qwen3-Coder-Next (80B total / 3B ativos, 52 GB) serve a máquinas de 64 GB, o Qwen3-Coder 30B (19 GB) a completar com consciência do repositório e o Qwen3 8B (5 GB) a 8 GB de RAM.
O Qwen é o melhor LLM local para programar?
Na maior parte do hardware doméstico, o Qwen3.8 27B tem hoje as maiores pontuações de código informadas entre os modelos que rodam localmente, mas nenhum modelo vence em todas as tarefas. O Devstral Small 2 cabe em 16 GB e foi criado para ciclos agênticos, o Laguna XS 2.1 mira sessões longas e o Codestral 22B é mais especializado em autocompletar no IDE. As pontuações são dos fabricantes e usam arneses diferentes: teste com o seu próprio código.
Posso rodar o Kimi K2.6 ou o Kimi K2.7 Code localmente?
Somente em hardware de classe servidor. Ambos são modelos MoE de 1T de parâmetros (32B ativos). O Ollama os lista apenas como tags na nuvem (`kimi-k2.6:cloud`, `kimi-k2.7-code:cloud`), que não são inferência local. Builds GGUF da comunidade do K2.7 Code precisam de cerca de 310 GB (1 bit) a 350 GB (2 bits). Para programar localmente em hardware doméstico, use o Qwen3.8 27B, o Devstral Small 2 ou o Laguna XS 2.1.
O que são o Devstral Small 2 e o Laguna XS 2.1?
Ambos são modelos de programação agêntica. O Devstral Small 2 (Mistral AI, Apache 2.0) é um modelo de 24B com 15 GB e 65,8% no SWE-bench Verified segundo a Mistral -- `ollama run devstral-small-2`. O Laguna XS 2.1 (Poolside, 2 de julho de 2026) é um MoE de 33B total / 3B ativos com 20 GB e janela de contexto de 256K; marca 70,9% no SWE-bench Verified e 63,1% no SWE-bench Multilingual sob a licença OpenMDW-1.1 -- `ollama run laguna-xs-2.1`.
O que é o HumanEval e por que ele importa?
O HumanEval é um benchmark de 164 problemas de programação em Python. O modelo deve gerar um corpo de função correto para cada um. O pass@1 (porcentagem resolvida na primeira tentativa) é a métrica padrão. Ainda é usado para comparar modelos de código pequenos, mas testa funções isoladas, não projetos reais.
O que é fill-in-the-middle (FIM) e quais modelos o suportam?
FIM é a capacidade de completar código com o código antes e depois do cursor -- o padrão do autocompletar no IDE. Codestral 22B, Qwen3-Coder, DeepSeek-Coder e Starcoder2 suportam FIM. O Llama 3.1 8B (geral) não. Para integração com IDE, use um modelo compatível com FIM.
Modelos de código locais podem substituir o GitHub Copilot?
O Codestral 22B via Continue.dev pode cobrir a maioria das tarefas de autocompletar. Em raciocínio complexo com vários arquivos, modelos na nuvem costumam manter vantagem nas tarefas mais difíceis. Compromisso: modelos locais são mais lentos, mas totalmente privados e rodam no seu próprio hardware.
De quanta RAM preciso para LLMs de código locais?
Mínimo de 4 GB (modelos minúsculos de 3B), na prática 8 GB ou mais para um código utilizável. 16 GB rodam o Devstral Small 2 (15 GB). 24 GB de memória de GPU ou um Mac de 32 GB rodam o Qwen3.8 27B (18 GB) com folga. Regra prática: pesos Q4_K_M ocupam cerca de 0,6 GB por bilhão de parâmetros, mais memória para a janela de contexto.
Quanto contexto um arquivo Python de 500 linhas usa?
Aproximadamente 2.000-3.000 tokens para um arquivo Python de 500 linhas. O contexto padrão do Ollama (escalado pela VRAM) pode ser insuficiente. Defina pelo menos `PARAMETER num_ctx 16384` para revisar um único arquivo. Para análise de vários arquivos, use 32768 ou 65536.
Modelos de código locais são rápidos o bastante para desenvolvimento?
Sim, para fluxos iterativos. A velocidade depende da GPU, da quantização e do tamanho do contexto. Modelos pequenos como o Qwen3 8B respondem rápido em notebooks; modelos grandes são mais lentos por token. Esperar alguns segundos por resposta é aceitável para pedir e revisar, mas não para autocompletar a cada tecla, em que convém um modelo FIM pequeno.
LLMs locais podem substituir o GPT-5.6 para programar?
Não totalmente. Modelos locais (Qwen3.8 27B, Devstral Small 2) ficam atrás dos modelos de nuvem de ponta em conhecimento recente de frameworks (APIs posteriores ao corte de treinamento), raciocínio muito longo em vários arquivos (100 mil+ tokens) e precisão de depuração. Eles reduziram a distância em tarefas cotidianas com vários arquivos e mantêm seu código privado.
Qual linguagem o Qwen3-Coder suporta melhor?
Python é a linguagem principal de treinamento. JavaScript, TypeScript, Java, C++, Go, Rust e SQL são bem suportados. O modelo também lida com PHP, Ruby, Swift e Kotlin. Em linguagens que não são Python, as pontuações do HumanEval são menores, mas ainda competitivas.
O DeepSeek-Coder é seguro para código proprietário?
Ao rodar localmente via Ollama, o DeepSeek-Coder não faz conexões externas. Seu código permanece no seu hardware. A preocupação com dados do DeepSeek se aplica à API na nuvem (api.deepseek.com), não à inferência local com Ollama. A inferência local não envia código aos servidores da DeepSeek.
Posso usar modelos de código locais para gerar SQL?
Sim -- o Qwen3.8 27B e o Devstral Small 2 lidam com geração de SQL. Forneça o esquema das tabelas no contexto do prompt. Para consultas complexas com vários JOINs, use 32K de contexto para incluir o esquema completo. Defina um prompt de sistema: "Você é um especialista em SQL. Gere apenas SQL válido."
O que é o SWE-bench e por que ele substitui o HumanEval?
O SWE-bench testa se um modelo resolve issues reais do GitHub — ler bases de código, fazer mudanças em vários arquivos e escrever testes. Ao contrário do HumanEval (funções Python isoladas), o SWE-bench prevê o desempenho em fluxos de desenvolvimento reais. SWE-bench Verified e SWE-bench Pro são variantes diferentes e suas pontuações não são intercambiáveis. Em 2026, o SWE-bench é o benchmark principal para avaliar modelos de código em uso real.
Como conecto um modelo de código local ao VS Code?
Instale a extensão Continue.dev pelo marketplace do VS Code. Nas configurações do Continue, escolha o Ollama como provedor e informe seu modelo (por exemplo, `qwen3:8b`, `qwen3.8`, `codestral:22b`). A extensão se conecta ao Ollama em localhost:11434 automaticamente. Use Cmd+I (macOS) ou Ctrl+I (Windows) para acionar a geração de código em linha.
Fontes
- Equipe Qwen. (2026). Ficha do modelo "Qwen3.8-27B". huggingface.co -- Apache 2.0, contexto 256K, SWE-bench Pro 61,7, LiveCodeBench v6 90,3, Terminal Bench 2.1 73,0.
- Ollama. (2026). Página "qwen3.8" da biblioteca. ollama.com -- tag de 18 GB (Q4_K_M), contexto 256K.
- Mistral AI. (2026). "devstral-small-2" no Ollama. ollama.com -- 15 GB, SWE-bench Verified 65,8%, requer Ollama 0.13.3 ou superior.
- Poolside. (2026). "Introducing Laguna XS 2.1". poolside.ai -- modelo de programação agêntica, MoE 33B/3B ativos, SWE-bench Verified 70,9%, licença OpenMDW-1.1.
- Ollama. (2026). Página "laguna-xs-2.1" da biblioteca. ollama.com -- tag padrão de 20 GB, contexto 256K.
- Ollama. (2026). Página "qwen3-coder-next" da biblioteca. ollama.com -- 80B total / 3B ativos, 52 GB Q4_K_M.
- Ollama. (2026). Página "kimi-k2.6" da biblioteca. ollama.com -- apenas uma tag `:cloud` listada.
- Unsloth. (2026). Guia de execução local "Kimi K2.7 Code". unsloth.ai -- MoE 1T/32B ativos, 310–470 GB de memória quantizado.
- Ollama. (2026). Página "codestral" da biblioteca. ollama.com -- 22B, 13 GB, contexto 32K.
- Equipe Qwen. (2026). "Qwen3-Coder-Next Technical Report". arxiv.org -- arquitetura e resultados de programação agêntica do Qwen3-Coder-Next.
- DeepSeek AI. (2024). "DeepSeek-Coder-V2 Technical Report". arxiv.org/abs/2406.11931 -- arquitetura MoE e resultados de benchmarks de código do DeepSeek-Coder V2 Lite.