حقائق سريعة — نماذج LLM المحلية للبرمجة في لمحة
- الأفضل عموماً: Qwen3.8 27B (من Alibaba) — كثيف 27B، Apache 2.0، حجم 18 GB في Ollama، سياق 256K، و61.7 في SWE-bench Pro، و90.3 في LiveCodeBench v6 (بحسب Qwen).
- جيل Qwen السابق: Qwen 3.6 27B — 77.2% في SWE-bench Verified و53.5 في SWE-bench Pro (بحسب Qwen)؛ لا يزال بديلاً جيداً لكن Qwen3.8 27B حلّ محله.
- الأفضل للبرمجة الوكيلية بحجم 24B: Devstral Small 2 (من Mistral AI، فرنسا) — 15 GB، و65.8% في SWE-bench Verified، Apache 2.0، استدعاء الأدوات وتعديل ملفات متعددة. يتطلب Ollama 0.13.3 أو أحدث.
- الأفضل للجلسات الوكيلية الطويلة: Laguna XS 2.1 (من Poolside) — MoE بإجمالي 33B ونشط 3B، 20 GB، سياق 256K، و70.9% في SWE-bench Verified، و63.1% في SWE-bench Multilingual، ترخيص OpenMDW-1.1.
- MoE كبير لأجهزة 64 GB: Qwen3-Coder-Next — إجمالي 80B ونشط 3B، 52 GB (Q4)، سياق 256K.
- الأفضل للإكمال التلقائي في IDE: Codestral 22B (من Mistral) — محسّن لـ FIM، تكامل مع Continue.dev، 13 GB، سياق 32K.
- الأفضل لذاكرة 8 GB من RAM: Qwen3 8B — يستخدم 5 GB من VRAM، وأفضل توازن بين الجودة والسرعة.
- أوزان مفتوحة بحجم النماذج الرائدة: Kimi K2.6 وKimi K2.7 Code (من Moonshot AI) — MoE بإجمالي 1T ونشط 32B، سياق 256K. تقدّم Ollama وسوم `:cloud` فقط؛ وتحتاج إصدارات GGUF المحلية نحو 310–470 GB بحسب التكميم.
- تحوّل المعيار: أصبح SWE-bench Pro وVerified (مشكلات GitHub الحقيقية) المقياسين الرئيسيين للبرمجة العملية. ويبقى HumanEval (دوال Python منفردة) مفيداً لمقارنة النماذج الصغيرة.
- الإعداد الموصى به: بطاقة GPU بسعة 24 GB أو ذاكرة موحّدة 32 GB (Qwen3.8 27B بمساحة كافية)؛ و16 GB تكفي لـ Devstral Small 2.
🏆 أفضل نماذج LLM المحلية للبرمجة (اختيارات سريعة)
- الأفضل عموماً: Qwen3.8 27B — كثيف 27B، 18 GB، سياق 256K، و61.7 في SWE-bench Pro (بحسب Qwen). `ollama run qwen3.8`
- الأفضل للبرمجة الوكيلية بحجم 24B: Devstral Small 2 — تعديل ملفات متعددة، استدعاء أدوات، 15 GB. `ollama run devstral-small-2`
- الأفضل للجلسات الوكيلية الطويلة: Laguna XS 2.1 — MoE إجمالي 33B ونشط 3B، 20 GB، سياق 256K. `ollama run laguna-xs-2.1`
- MoE كبير (أجهزة 64 GB): Qwen3-Coder-Next — 80B/نشط 3B، 52 GB. `ollama run qwen3-coder-next`
- الأفضل للإكمال الواعي بالمستودع على 24 GB: Qwen3-Coder 30B — MoE بإجمالي 30B ونشط 3.3B، 19 GB، سياق 256K. `ollama run qwen3-coder:30b`
- الأفضل للإكمال التلقائي في IDE: Codestral 22B — محسّن لـ FIM مع Continue.dev، 13 GB. `ollama run codestral:22b`
- الأفضل لذاكرة 8 GB من RAM: Qwen3 8B — 5 GB من VRAM. `ollama run qwen3:8b`
- 👉 إن لم تكن متأكداً: Qwen3 8B على الحواسيب المحمولة بسعة 8–16 GB، وQwen3.8 27B عند توفر 24 GB من ذاكرة GPU أو الذاكرة الموحّدة.
- 👉 مع 16 GB: Devstral Small 2 هو الأنسب للبرمجة الوكيلية؛ أما Qwen3.8 27B (18 GB) فيحتاج بطاقة 24 GB أو جهاز Mac بذاكرة 32 GB.
- 👉 للجلسات الوكيلية الطويلة: جرّب Laguna XS 2.1 أو Devstral Small 2.
- 👉 للإكمال في IDE: استخدم Codestral 22B مع Continue.dev.
🛠️ممارسة: طابق حجم النموذج مع عتادك أولاً. مع 8 GB استخدم Qwen3 8B؛ ومع 16 GB استخدم Devstral Small 2؛ ومع 24 GB من ذاكرة GPU أو الذاكرة الموحّدة استخدم Qwen3.8 27B. ليس Kimi K2.6 وK2.7 Code خيارين محليين عمليين: فـ Ollama تقدّمهما كوسوم سحابية فقط، وتتطلب الإصدارات المحلية 300 GB أو أكثر.
في جملة واحدة
أفضل LLM محلي للبرمجة في 2026 هو Qwen3.8 27B (حجم 18 GB، و61.7 في SWE-bench Pro بحسب Qwen)، مع Devstral Small 2 للبرمجة الوكيلية على 16 GB، وLaguna XS 2.1 للجلسات الطويلة، وCodestral 22B للإكمال التلقائي في IDE، وQwen3 8B لذاكرة 8 GB من RAM.
بعبارات بسيطة
تشغيل نموذج برمجة محلياً أشبه بتثبيت مساعد برمجة بالذكاء الاصطناعي على لابتوبك — يبقي كودك خاصاً، ويعمل دون اتصال، لكنه أبطأ من واجهات السحابة مثل GitHub Copilot.
ما الذي يجعل LLM المحلي جيداً للبرمجة؟
في 2026 حلّ SWE-bench Pro وSWE-bench Verified إلى حد كبير محل HumanEval كمعيارين عمليين للبرمجة. فهما يختبران قدرة النموذج على حل مشكلات GitHub الحقيقية — تعديلات على ملفات متعددة، وفهم قواعد الكود، وكتابة الاختبارات — لا مجرد توليد دوال منفردة. تعلن Qwen نتيجة 61.7 في SWE-bench Pro لـ Qwen3.8 27B و77.2% في SWE-bench Verified لـ Qwen 3.6 27B السابق.
تُضبط نماذج الكود المتخصصة على مجموعات كبيرة من الكود (GitHub وStack Overflow والتوثيق) وغالباً ما تتضمن تدريب الإكمال في المنتصف (FIM) -- أي القدرة على إكمال الكود اعتماداً على السياق قبل المؤشر وبعده، وهو شرط للإكمال التلقائي في IDE.
تحقق النماذج العامة مثل Llama 3.1 8B نسبة 72% في HumanEval وهي تنافسية. لكن نماذج الكود المخصصة بالحجم نفسه تتفوق بنسبة 5-15% لأن بيانات تدريبها وضبطها تعطي الأولوية لدقة توليد الكود على مهام اللغة العامة.
📌ملاحظة: تستخدم نتائج SWE-bench المعلنة من الشركات أطر وكلاء ومجموعات مهام وإعدادات مختلفة (نتيجة Qwen 61.7 في SWE-bench Pro تستخدم إطار Claude Code مع مهام مصححة)، لذا فالرقمان المنشوران مؤشران تقريبيان لا مقارنة مباشرة. يبقى HumanEval مفيداً لمقارنة الدوال المنفردة، لكن SWE-bench أقدر على التنبؤ بالأداء في سير عمل التطوير الفعلي.
#1 Qwen3.8 27B -- أفضل LLM محلي للبرمجة عموماً
يُعدّ Qwen3.8 27B (من Alibaba، صدر في أغسطس 2026) أفضل LLM محلي للبرمجة على بطاقة GPU بسعة 24 GB أو جهاز Mac بذاكرة 32 GB. وهو نموذج كثيف بحجم 27B (جميع المعاملات نشطة لكل رمز) بترخيص Apache 2.0. تعلن Qwen نتيجة 61.7 في SWE-bench Pro و73.0 في Terminal Bench 2.1 و90.3 في LiveCodeBench v6. حجم التنزيل في Ollama هو 18 GB مع نافذة سياق 256K.
`ollama run qwen3.8`. يقبل النص والصور، ويدعم استدعاء الأدوات ووضع التفكير، ويصلح لتحليل الملفات المتعددة والتصحيح وإعادة الهيكلة. أعلنت Qwen نتيجة 53.5 في SWE-bench Pro لـ Qwen 3.6 27B السابق (و77.2% في SWE-bench Verified)؛ ويبقى `ollama run qwen3.6:27b` بديلاً صالحاً.
المواصفة | القيمة |
|---|---|
| SWE-bench Pro | 61.7 (بحسب Qwen) |
| LiveCodeBench v6 | 90.3 (بحسب Qwen) |
| البنية | كثيف (27B نشط) |
| حجم Ollama (Q4_K_M) | 18 GB |
| نافذة السياق | 256K رمز |
| الترخيص | Apache 2.0 |
| أمر Ollama | ollama run qwen3.8 |
🔍رؤية: تشغّل Qwen اختبار SWE-bench Pro بإطار Claude Code ومجموعة مهام منقحة صُححت فيها المهام الإشكالية، لذا فالنتيجة 61.7 ليست قابلة للمقارنة المباشرة بنتائج الشركات الأخرى. هي إشارة قوية معلنة من الشركة لا اختباراً مقارناً مباشراً.
#2 Devstral Small 2 -- الأفضل للبرمجة الوكيلية بحجم 24B
صُمم Devstral Small 2 (من Mistral AI) لسير عمل البرمجة الوكيلية — تعديل ملفات متعددة، وتوليد الكود مع استدعاء الأدوات، وحلقات التصحيح. بحجم 24B معامل، و15 GB في Ollama، و65.8% في SWE-bench Verified (بحسب Mistral)، وبترخيص Apache 2.0. `ollama run devstral-small-2` (يتطلب Ollama 0.13.3 أو أحدث).
هو الخيار الأفضل للمطورين الذين يستخدمون aider أو سير عمل على نمط Claude Code أو تعديلات كود متعددة الخطوات على جهاز 16 GB. يقرأ رسائل الأخطاء ويعدّل عدة ملفات ويدعم إدخال الصور.
المواصفة | القيمة |
|---|---|
| SWE-bench Verified | 65.8% (بحسب Mistral) |
| الأفضل لـ | سير عمل وكيلي، ملفات متعددة |
| حجم Ollama | 15 GB |
| نافذة السياق | 384K رمز (Ollama) |
| الترخيص | Apache 2.0 |
| أمر Ollama | ollama run devstral-small-2 |
💡نصيحة: البرمجة الوكيلية = استدل ← اكتب الكود ← شغّل ← لاحظ الأخطاء ← صحّح ← كرّر. يتولى Devstral Small 2 هذه الحلقة بحجم 15 GB، مما يجعله الخيار الوكيلي العملي لأجهزة 16 GB التي لا يتسع فيها Qwen3.8 27B (18 GB).
#3 Laguna XS 2.1 وQwen3-Coder-Next -- برمجة وكيلية طويلة الأمد
يستهدف Laguna XS 2.1 (من Poolside، 2 يوليو 2026) البرمجة الوكيلية طويلة الأمد. MoE بإجمالي 33B ونشط 3B، وسياق 256K، وترخيص OpenMDW-1.1، و70.9% في SWE-bench Verified و63.1% في SWE-bench Multilingual. الوسم الافتراضي في Ollama بحجم 20 GB (Q4_K_M). `ollama run laguna-xs-2.1`.
يُعدّ Qwen3-Coder-Next (من Alibaba، فبراير 2026) خيار MoE الأكبر لأجهزة 64 GB: إجمالي 80B ونشط 3B، و52 GB بتكميم Q4_K_M، وسياق 256K. `ollama run qwen3-coder-next`. أما لنموذج برمجة أصغر واعٍ بالمستودع على 24 GB فإن `ollama run qwen3-coder:30b` (إجمالي 30B ونشط 3.3B، 19 GB، Apache 2.0) هو البديل الراسخ.
إن أردت أكبر نافذة سياق لجلسات وكيلية تمتد ساعات فاختر Laguna XS 2.1؛ وإن أردت نموذجاً أوروبي المنشأ بترخيص Apache 2.0 وبحجم أصغر فاختر Devstral Small 2.
المواصفة | القيمة |
|---|---|
| حجم Laguna XS 2.1 | 20 GB (إجمالي 33B / نشط 3B) |
| SWE-bench لـ Laguna XS 2.1 | 70.9% Verified / 63.1% Multilingual |
| حجم Qwen3-Coder-Next | 52 GB (إجمالي 80B / نشط 3B) |
| نافذة السياق | 256K رمز (كلاهما) |
| أوامر Ollama | laguna-xs-2.1 / qwen3-coder-next |
🔍رؤية: تُبقي نماذج MoE جميع المعاملات في الذاكرة لكنها تحسب بعدة مليارات فقط لكل رمز، لذا تولّد بسرعة نسبة إلى حجمها، مع حاجتها إلى RAM لكامل الأوزان (20 GB لـ Laguna XS 2.1 و52 GB لـ Qwen3-Coder-Next).
#4 Codestral 22B -- الأفضل للإكمال التلقائي في IDE
يبقى Codestral 22B (من Mistral AI) نموذج FIM المخصص للإكمال التلقائي في IDE. مصمم للإكمال في المنتصف مع Continue.dev في VS Code وCursor. وهو أقدم نموذج في هذه الصفحة (إصدار Ollama عمره نحو عامين) ويبقى الخيار الأكثر تركيزاً على FIM.
`ollama run codestral:22b`. مُدرَّب على الإكمال بنمط IDE حيث يأتي السياق قبل المؤشر وبعده. قوي في Python وJavaScript وTypeScript وGo وRust. إصدار Ollama بنافذة سياق 32K.
للإكمال الواعي بالمستودع، يُعدّ `ollama run qwen3-coder:30b` أقوى بديل مفتوح الأوزان (Apache 2.0، 19 GB). ولنموذج برمجة صغير قادر على الاستدلال على 16 GB، يُعدّ `ollama run gpt-oss:20b` (أوزان مفتوحة من OpenAI، MoE إجمالي 21B ونشط 3.6B، استدلال قابل للضبط) خياراً جيداً أيضاً.
المواصفة | القيمة |
|---|---|
| الأفضل لـ | FIM (الإكمال التلقائي في IDE) |
| حجم Ollama | 13 GB |
| نافذة السياق | 32K رمز |
| دعم FIM | نعم (الاستخدام الأساسي) |
| تكامل IDE | Continue.dev وCursor |
| أمر Ollama | ollama run codestral:22b |
🔍رؤية: صُمم Codestral 22B من Mistral AI خصيصاً للإكمال بتقنية FIM (الإكمال في المنتصف). ومع Continue.dev يوفّر بديلاً محلياً للإكمال التلقائي في GitHub Copilot.
#5 Qwen3 8B -- أفضل نموذج برمجة لذاكرة 8 GB من RAM
Qwen3 8B هو التوصية لفئة 8 GB. أداء قوي في البرمجة، ومتعدد اللغات، ويستخدم 5 GB فقط من VRAM. يتوفر Qwen3.8 حالياً في Ollama بحجم 27B فقط، لذا يبقى Qwen3 8B أصغر خيارات Qwen الحالية. لمزيد من التفاصيل حول متطلبات VRAM لنماذج البرمجة الأخرى، راجع دليل متطلبات VRAM ←. `ollama run qwen3:8b`.
🔍رؤية: Qwen3 8B هو نقطة البداية الموصى بها لأجهزة 8 GB: دعم قوي لتعدد اللغات، واستدلال سريع، وجودة كود جيدة في المهام الفعلية.
لماذا ليس Kimi K2.6 وK2.7 Code خياراً محلياً عملياً
يُعدّ Kimi K2.6 وKimi K2.7 Code (من Moonshot AI) أكبر نماذج البرمجة مفتوحة الأوزان في هذه القائمة، لكنهما ليسا خياراً للأجهزة الاستهلاكية. كلاهما نموذج MoE بحجم 1T معامل و32B نشطة ونافذة سياق 256K. أعلنت Moonshot AI نتيجة 58.6 في SWE-bench Pro لـ Kimi K2.6؛ ويبني Kimi K2.7 Code على K2.6 لجلسات البرمجة الطويلة.
في Ollama يظهر كلاهما كوسمين سحابيين فقط (`kimi-k2.6:cloud` و`kimi-k2.7-code:cloud`)، وهما يرسلان طلباتك إلى خدمة Ollama المستضافة. أما التشغيل المحلي فيعني إصدار GGUF مجتمعياً: تذكر Unsloth نحو 310 GB بتكميم 1 بت و325–350 GB بتكميم 2 بت لـ K2.7 Code، أي أنهما لعتاد محطات العمل أو الخوادم لا الحواسيب المحمولة.
⚠️تحذير: الوسم `:cloud` ليس استدلالاً محلياً. إن كانت الخصوصية سبب اختيارك لنموذج محلي، فاستخدم Qwen3.8 27B أو Devstral Small 2 أو Laguna XS 2.1 بدلاً منه.
كيف تقارَن نماذج البرمجة؟ SWE-bench + HumanEval
النموذج | HumanEval | SWE-bench | RAM | FIM |
|---|---|---|---|---|
| Qwen3.8 27B | — | 61.7 (Pro) | 18 GB | — |
| Qwen 3.6 27B | — | 77.2% (Verified) / 53.5 (Pro) | ~22 GB | — |
| Devstral Small 2 | — | 65.8% (Verified) | 15 GB | — |
| Laguna XS 2.1 (MoE) | — | 70.9% (Verified) | 20 GB (نشط 3B) | — |
| Qwen3-Coder-Next (MoE) | — | يختلف بحسب الإطار | 52 GB (نشط 3B) | — |
| Kimi K2.6 (MoE) | — | 58.6 (Pro) | 300+ GB (سحابي في Ollama) | — |
| Codestral 22B | — | — | 13 GB | نعم (أساسي) |
| Qwen2.5-Coder 32B | — | — | 20 GB | نعم |
| Qwen3 8B | — | — | 5 GB | نعم |
| DeepSeek-R1 14B | — | — | 10 GB | لا |
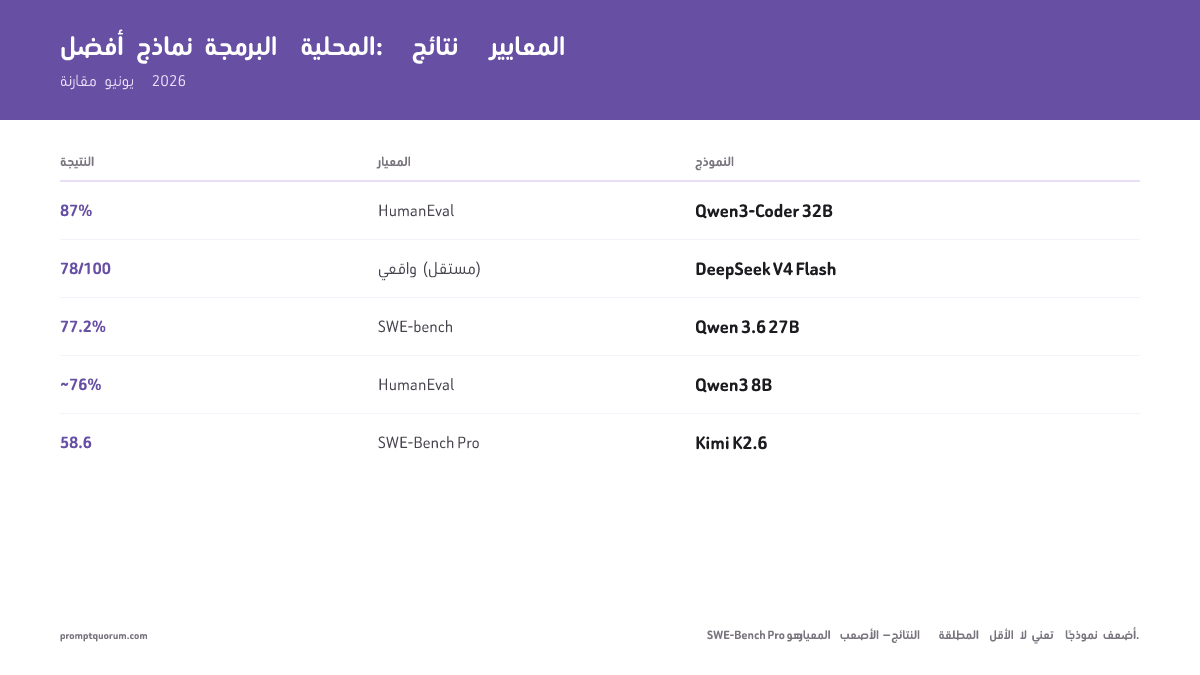
📌ملاحظة: يقيس HumanEval توليد دوال Python منفردة، بينما يقيس SWE-bench تعديلات كود حقيقية على ملفات متعددة. «Pro» و«Verified» نسختان مختلفتان من SWE-bench وغير قابلتين للتبادل: لا يمكن مقارنة نتيجة 77.2% في Verified بنتيجة 61.7 في Pro مباشرة. جميع النتائج معلنة من الشركات. أرقام HumanEval للنماذج الأقدم (Qwen2.5-Coder 32B وQwen3 8B) منقولة من إصدارات سابقة لهذه الصفحة ولم يُعاد التحقق منها.
أي نموذج يناسب أي مهمة برمجية؟
- 1تصحيح دوال Python وإعادة الهيكلة على ملفات متعددة -- Qwen3.8 27B هو الخيار الأول: النموذج الكثيف يُبقي جميع معاملاته الـ27B نشطة لكل رمز، وهذا يلائم الاستدلال على ملفات متعددة. أما Devstral Small 2 فهو البديل الأخف عند توفر 16 GB فقط. الاختيار: Qwen3.8 27B.
- 2الحلقات الوكيلية (تخطيط ← تعديل ← تشغيل الاختبارات ← تصحيح) -- صُمم Devstral Small 2 وLaguna XS 2.1 لاستدعاء الأدوات والجلسات الطويلة. يوفّر Laguna XS 2.1 سياق 256K بينما يستهلك Devstral Small 2 ذاكرة أقل. الاختيار: Laguna XS 2.1 للجلسات الطويلة وDevstral Small 2 لأجهزة 16 GB.
- 3FIM / الإكمال التلقائي في IDE (VS Code) -- يتطلب الإكمال في المنتصف نموذجاً مدرَّباً عليه. يعمل Codestral 22B وQwen3 8B عبر Continue.dev؛ أما نماذج Kimi وLaguna وDevstral فلا تركّز على FIM. الاختيار: Codestral 22B.
- 4السكربتات السريعة على حواسيب 8 GB المحمولة -- يتعامل Qwen3 8B مع سكربتات الاستخدام اليومي وSQL والكود النمطي بزمن استجابة منخفض. توقّع نتائج أضعف مع أنظمة الأنواع الكبيرة والتعديلات على ملفات متعددة. الاختيار: Qwen3 8B.
🔍رؤية: تحقق النماذج الأكبر نتائج أعلى من نماذج 8B في مهام نمط SWE-bench (التصحيح وإعادة الهيكلة على ملفات متعددة)؛ أما في السكربتات اليومية فتضيق الفجوة. اختر النموذج أولاً بحسب المهمة ثم بحسب ميزانية الذاكرة لديك.
أي نموذج برمجة يوازن أفضل توازن بين السرعة وجودة المخرجات؟
المهمة | Qwen3.8 27B | Devstral Small 2 | Qwen3 8B | Codestral 22B |
|---|---|---|---|---|
| إعادة هيكلة وتصحيح متعدد الملفات | الخيار الأول (كثيف، 18 GB) | جيد (15 GB) | محدود في التعديلات الكبيرة | ليس تخصصه |
| حلقات وكيلية مع أدوات | قوي (أدوات، تفكير) | مصمم لذلك | أساسي | ليس تخصصه |
| كود نمطي وواجهات REST واختبارات | قوي، أبطأ | قوي | سريع، تحقق من التحقق من المدخلات | سريع، عام |
| إكمال FIM (المؤشر في منتصف السطر) | ليس تخصصه | ليس تخصصه | مدعوم | الخيار الأفضل (FIM) |
💡نصيحة: الفكرة الأساسية: النماذج بحجم 18 GB و15 GB أبطأ لكل رمز من نماذج 8B لكنها أدق في المهام الثقيلة على الاستدلال. للإكمال التلقائي في IDE استخدم نماذج FIM المحسّنة فقط (Codestral 22B وQwen3 8B). يعتمد الأداء على GPU والتكميم وطول السياق، لذا اختبر على جهازك.
🛠️ممارسة: توصية عملية: اختر بحسب نوع المهمة. لتوليد الكود دفعياً أو لمراجعات إعادة الهيكلة استخدم Qwen3.8 27B. للحلقات الوكيلية على 16 GB استخدم Devstral Small 2. وللإكمال التلقائي الفوري في IDE استخدم Codestral 22B أو Qwen3 8B حيث تكون السرعة حاسمة.
أي LLM محلي للبرمجة يجب أن تستخدم؟
اختيار النموذج مهم، لكن طريقة توجيهه أهم لجودة الكود. تُحسّن تقنيات الأوامر المنظمة — تحديد اللغة والقيود وحالات الاختبار وصيغة المخرجات — دقة توليد الكود بدرجة كبيرة. يغطي دليل هندسة الأوامر 80 تقنية في الأساسيات والأطر وأساليب التقييم.
لسير عمل IDE متكامل حول هذه النماذج، راجع استبدال GitHub Copilot بنموذج LLM محلي — فمجموعة الأدوات المفتوحة (Continue.dev + Ollama + Qwen3-Coder) تتناسب جيداً مع الاختيارات أعلاه.
- 8 GB من RAM، تركيز على البرمجة: `ollama run qwen3:8b` -- 5 GB من VRAM، أفضل نموذج في هذه الفئة.
- 16 GB من RAM: `ollama run devstral-small-2` -- الأفضل للبرمجة الوكيلية بحجم 24B (تعديل ملفات متعددة وحلقات التصحيح)، 15 GB.
- GPU بسعة 24 GB أو Mac بذاكرة 32 GB (أفضل جودة): `ollama run qwen3.8` -- Qwen3.8 27B، 18 GB، و61.7 في SWE-bench Pro (بحسب Qwen).
- الجلسات الوكيلية الطويلة: `ollama run laguna-xs-2.1` -- 20 GB، سياق 256K، و70.9% في SWE-bench Verified.
- أجهزة 64 GB: `ollama run qwen3-coder-next` -- MoE بحجم 80B ونشط 3B، 52 GB.
- الإكمال التلقائي في IDE داخل VS Code: `ollama run codestral:22b` عبر Continue.dev -- محسّن لـ FIM وأفضل بديل محلي لـ Copilot.
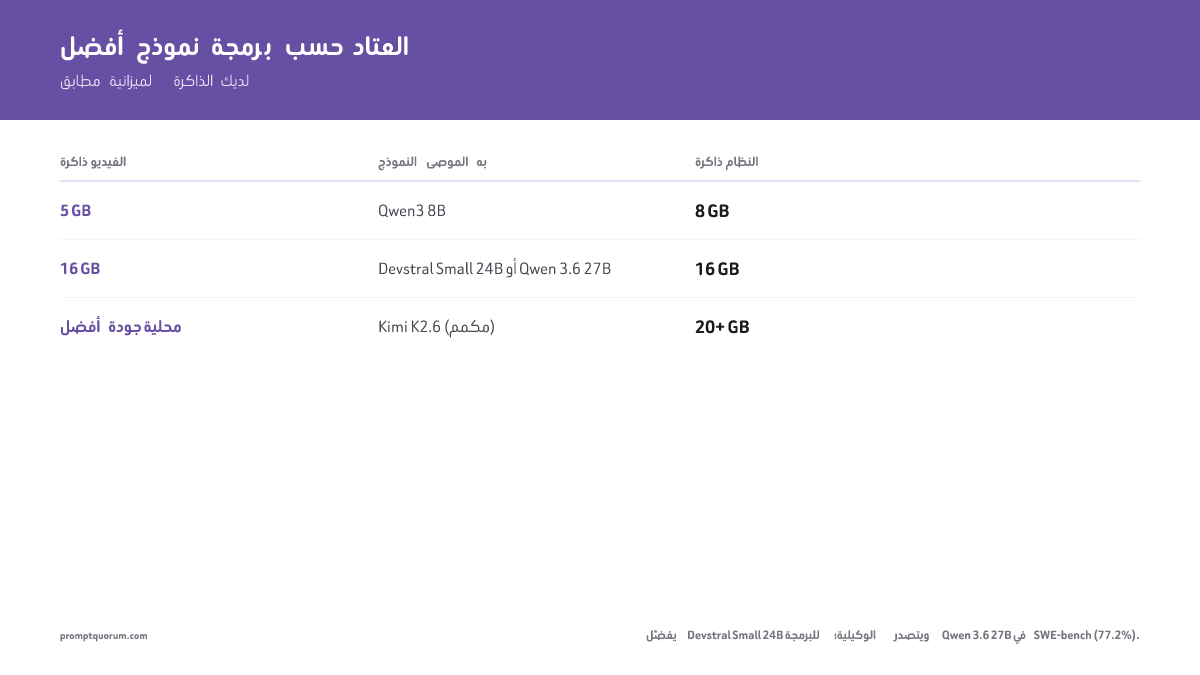
🛠️ممارسة: طابق حجم النموذج مع عتادك أولاً ثم حسّن لحالة استخدامك. مع 8 GB يكون Qwen3 8B الخيار الأفضل. ومع 16 GB استخدم Devstral Small 2. ومع 24 GB أو أكثر استخدم Qwen3.8 27B. نموذج يعمل بسلاسة أفضل من نموذج مثالي يتعثر.
أفضل نماذج LLM للبرمجة لـ 8 GB VRAM (RTX 3060 12GB / RTX 3070 8GB / RX 6800 16GB)
على الأجهزة بسعة 8 GB من RAM، Qwen3 8B هو أفضل خيار للبرمجة — يستخدم 5 GB فقط من VRAM، تاركاً 3 GB لبيئة التطوير والمتصفح والتطبيقات الأخرى. يتضمن Qwen3 8B دعم FIM (الملء في الوسط) للإكمال التلقائي في VS Code عبر Continue.dev.
- Qwen3 8B (موصى به) — 5 GB VRAM، 20–35 tok/ث، دعم FIM. `ollama run qwen3:8b`
- Phi-4 Mini 3.8B — 68% MMLU (استدلال)، 2.5 GB VRAM، الأفضل للاستدلال الخفيف. `ollama run phi4-mini`
- Llama 3.2 3B — 40–60 tok/ث، 2.5 GB VRAM، بديل جيد للإعدادات المحدودة جداً. `ollama run llama3.2:3b`
أفضل نماذج LLM للبرمجة لذاكرة 16 GB من VRAM (RTX 4070 Ti 16GB / RTX 5070 Ti 16GB / بطاقات 24 GB)
مع 16 GB يكون Devstral Small 2 (15 GB) هو الأنسب للبرمجة الوكيلية. أما Qwen3.8 27B (تنزيل 18 GB) فيحتاج GPU بسعة 24 GB أو Mac بذاكرة موحّدة 32 GB؛ وهو الخيار الأفضل متى توفرت هذه المساحة.
- Devstral Small 2 — الأفضل للبرمجة الوكيلية واستدعاء الأدوات وتعديل ملفات متعددة، 15 GB. `ollama run devstral-small-2`
- Qwen3.8 27B — الأفضل عموماً، كثيف 27B، 18 GB، سياق 256K، يتسع في بطاقة 24 GB. `ollama run qwen3.8`
- Qwen3-Coder 30B — MoE إجمالي 30B ونشط 3.3B، 19 GB، إكمال واعٍ بالمستودع على بطاقة 24 GB. `ollama run qwen3-coder:30b`
أفضل نماذج LLM للبرمجة لـ 6 GB VRAM (بطاقات GPU اقتصادية / رسوميات مدمجة)
للأجهزة بسعة 4–6 GB من VRAM (بطاقات GPU اقتصادية، أجهزة لابتوب قديمة، Intel iGPU)، Phi-4 Mini 3.8B هو أفضل خيار — يحقق أداء استدلال MMLU بنسبة 68% مستخدماً 2.5 GB من VRAM فقط. هذا يترك ~3.5 GB لنظامك.
- Phi-4 Mini 3.8B (موصى به) — 68% MMLU استدلال، 2.5 GB VRAM، ممتاز للمنطق والتصحيح. `ollama run phi4-mini`
- Qwen3 4B — نسخة أصغر، 4 GB VRAM، توازن جودة-سرعة للعتاد الاقتصادي. `ollama run qwen3:4b`
🧭 من يستخدم ماذا: الشخصيات والتوصيات
- المبتدئ (بلا خبرة في نماذج LLM المحلية): LM Studio + Qwen3 8B -- واجهة رسومية دون طرفية، ويتضمن FIM لإكمال الكود، 5 GB من VRAM.
- مطور الحاسوب المحمول (8–16 GB من RAM، برمجة يومية): Ollama + Qwen3 8B (أجهزة 8 GB) أو Devstral Small 2 (أجهزة 16 GB) -- جودة وأداء متوازنان ويعمل بسلاسة لساعات.
- المطور المتقدم (تصحيح وإعادة هيكلة واستدلال معقد، 24 GB فأكثر): Ollama + Qwen3.8 27B (نموذج كثيف، 18 GB) -- يتعامل مع سياق الملفات المتعددة وتصميم الخوارزميات.
- الجلسات الوكيلية الطويلة (تخطيط ← برمجة ← اختبار ← تكرار): Ollama + Laguna XS 2.1 (سياق 256K، و70.9% في SWE-bench Verified) أو Devstral Small 2 -- مصممان لاستدعاء الأدوات والتشغيل متعدد الخطوات.
- سير عمل يتمحور حول IDE (VS Code وCursor وJetBrains): Continue.dev + Codestral 22B -- محسّن لـ FIM للإكمال عند موضع المؤشر، وأفضل بديل محلي لـ Copilot.
- البيئات الحساسة للخصوصية (GDPR وHIPAA والكود المملوك): أي نموذج محلي أعلاه عبر Ollama (وليس وسم `:cloud`) -- بلا استدعاءات API خارجية للاستدلال، فيبقى الكود على جهازك ما دامت إضافات المحرر والأدوات الأخرى لا تستخدم الشبكة أيضاً.
⚠️تحذير: ❌ تجنّب: تشغيل Qwen3.8 27B (18 GB) على أجهزة تقل ذاكرة GPU أو الذاكرة الموحّدة فيها عن نحو 24 GB. فعندما يتجاوز النموذج إلى ذاكرة النظام تنخفض السرعة بشدة. استخدم Qwen3 8B أو Devstral Small 2 على الأجهزة الأصغر.
⚠️تحذير: ❌ تجنّب: استخدام النماذج العامة (Llama 3.1 8B) عندما تحتاج إلى إكمال تلقائي في IDE. فقط نماذج الكود المتخصصة ذات دعم FIM تعمل للإكمال داخل المحرر -- Codestral 22B وQwen3 8B.
🔍رؤية: مبتدئ ← متوسط ← متقدم هو أيضاً تدرّج في متطلبات العتاد. ابدأ بـ Qwen3 8B (8 GB)، وانتقل إلى Devstral Small 2 (16 GB) عند إضافة الأدوات وسير العمل، ثم إلى Qwen3.8 27B (24 GB فأكثر) عندما تحتاج أعلى جودة استدلال.
❌ متى لا تستخدم نماذج LLM المحلية للبرمجة
- تحتاج معرفة بالأطر الحالية (واجهات API لعام 2025+): تُدرَّب النماذج المحلية على تواريخ قطع ثابتة ولا تعرف واجهات API الصادرة بعد التدريب. لإصدارات الأطر الحديثة، زوّد الأمر بالتوثيق الحالي أو استخدم نموذجاً سحابياً رائداً مثل GPT-5.6 أو Claude Sonnet 5.
- تحتاج استدلالاً متعدد الملفات في قواعد كود كبيرة (100k+ رمز): تتدهور النماذج المحلية في السياقات الطويلة جداً. يصبح زمن الاستجابة باهظاً. تتعامل النماذج السحابية (GPT-5.6، Claude) مع سياقات 100k+ رمز بشكل أصلي. لإعادة الهيكلة المعمارية لخدمات كاملة، استخدم النماذج السحابية.
- يجب أن يكون زمن الاستجابة <300 مللي ثانية (برمجة تفاعلية في الوقت الفعلي): تعمل النماذج المحلية بسرعة 15-25 رمزاً/ث على CPU (أجهزة لابتوب نموذجية)، منتجةً تأخيراً بمقدار 5-10 ثوانٍ لكل استجابة. يكمل GitHub Copilot وClaude في بيئة التطوير الاقتراحات في <1 ثانية. للإكمال التلقائي على مستوى ضغطة المفتاح، النماذج المحلية بطيئة جداً.
- تحتاج أفضل دقة تصحيح: في مهام التصحيح المعقدة (تتبع مكدسات استدعاء دوال متعددة، تحديد أخطاء أنواع دقيقة)، تبقى النماذج السحابية الرائدة مثل GPT-5.6 وClaude Sonnet 5 متقدمة عادةً في مشكلات الكود الحقيقية. النماذج المحلية قوية في التوليد، بينما تميل النماذج الرائدة إلى التفوق في التشخيص.
- لا يمكنك تحمّل الهلوسات في الكود المُولَّد: قد تولّد النماذج المحلية الصغيرة كوداً صحيحاً نحوياً لكنه خاطئ منطقياً في المهام المعقدة، والنماذج السحابية الأكبر أكثر موثوقية عادةً. للكود الحرج (أنظمة الدفع والأمان) اشترط مراجعة بشرية لكل كود مُولَّد.
🔍رؤية: 👉 نماذج LLM المحلية أفضل لـ: الخصوصية + العمل دون اتصال + التحكم بالتكلفة — وليس لأقصى أداء. إذا كانت أقصى دقة أهم من هذه العوامل الثلاثة، استخدم واجهات السحابة.
📊 مقارنة أفضل نماذج LLM المحلية للبرمجة (مصفوفة القرار)
لست متأكداً أي نموذج برمجة تختار؟ يتيح لك PromptQuorum إرسال أمر واحد إلى عدة نماذج في آن واحد (Qwen3.8 وDevstral وGPT-5.6 وClaude) وعرض المخرجات وأزمنة الاستجابة الفعلية والدقة على كودك أنت جنباً إلى جنب. جرّب PromptQuorum مجاناً — 5 دقائق دون تسجيل.
النموذج | الأفضل لـ | VRAM | السرعة | نقطة القوة | متى تختاره |
|---|---|---|---|---|---|
| Qwen3.8 27B | الأفضل عموماً، استدلال متعدد الملفات | ~18 GB | حسب GPU | 61.7 في SWE-bench Pro (بحسب Qwen)، كثيف 27B، سياق 256K، Apache 2.0 | لديك GPU بسعة 24 GB أو Mac بذاكرة 32 GB وتريد أفضل جودة محلية |
| Devstral Small 2 | برمجة وكيلية بحجم 24B | ~15 GB | حسب GPU | 65.8% في SWE-bench Verified (بحسب Mistral)، استدعاء أدوات، ملفات متعددة، Apache 2.0 | تستخدم aider أو وكلاء بنمط Claude Code على 16 GB |
| Laguna XS 2.1 | برمجة وكيلية طويلة الأمد | ~20 GB (نشط 3B) | حسب GPU | 70.9% في SWE-bench Verified، سياق 256K، MoE إجمالي 33B ونشط 3B، OpenMDW-1.1 | تشغّل جلسات وكيلية لساعات وتحتاج سياق 256K |
| Qwen3-Coder-Next | MoE كبير على أجهزة 64 GB | ~52 GB (نشط 3B) | حسب GPU | MoE إجمالي 80B ونشط 3B، سياق 256K | لديك ذاكرة موحّدة 64 GB وتريد نموذج برمجة أكبر |
| Codestral 22B | الإكمال التلقائي في IDE (VS Code وCursor) | ~13 GB | حسب GPU | محسّن لـ FIM، أفضل بديل محلي لـ Copilot، أصلي في Continue.dev | تريد إكمالاً تلقائياً عند كل ضغطة مفتاح عبر Continue.dev |
| Qwen3 8B | برمجة على الحاسوب المحمول، الأفضل لذاكرة 8 GB | ~5 GB | الأسرع هنا | برمجة محسّنة، دعم FIM، متعدد اللغات | لديك 8 GB من RAM وتريد أفضل نموذج برمجة محلي لهذه الفئة |
| Kimi K2.6 / K2.7 Code | أوزان مفتوحة بحجم النماذج الرائدة | 300+ GB (وسم سحابي في Ollama) | فئة الخوادم | MoE إجمالي 1T ونشط 32B، سياق 256K | لديك عتاد محطة عمل أو خادم، أو تقبل وسماً سحابياً |
| GPT-5.6 (سحابي) | واجهات API الحديثة، استدلال معقد، أداء أقصى | غير متاح (سحابي) | <1 ث | أفضل دقة، معرفة حديثة، استدلال متعدد الملفات | تحتاج أداءً أقصى أو زمن استجابة فورياً أو معرفة حديثة بالأطر |
| Claude Sonnet 5 (سحابي) | مراجعة الكود وقرارات البنية والتصحيح | غير متاح (سحابي) | <1 ث | ممتاز في فهم الكود والتصحيح وسياق الملفات المتعددة | تفضّل دقة التصحيح ومراجعة الكود على التكلفة أو الخصوصية |
كيف تؤثر المتطلبات الإقليمية على اختيارك لنموذج البرمجة؟
الاتحاد الأوروبي / GDPR
لفرق تطوير البرمجيات في الاتحاد الأوروبي التي تعمل على قواعد كود خاصة، يعني توليد الكود محلياً أن الشيفرة المصدرية لا تغادر أبداً البنية التحتية للمؤسسة. تتطلب المادة 32 من GDPR تدابير أمان تقنية مناسبة -- وإرسال شيفرة مصدرية إلى واجهات ذكاء اصطناعي سحابية ينشئ علاقة معالج إضافية بموجب المادة 28. يلغي الاستدلال المحلي ذلك.
يعمل كل من Qwen3.8 27B (Alibaba، Apache 2.0) وDeepSeek-Coder V2 (DeepSeek، MIT) بالكامل محلياً. للمؤسسات في الاتحاد الأوروبي التي تفضّل نموذجاً ذا منشأ أوروبي: نماذج Mistral البرمجية (Mistral Small 3.1 وCodestral وDevstral Small 2) من Mistral AI (فرنسا)؛ يخضع Devstral Small 2 لترخيص Apache 2.0، بينما تختلف شروط ترخيص Codestral ويجب التحقق منها. يستخدم Laguna XS 2.1 ترخيص OpenMDW-1.1 (متساهل، والاستخدام التجاري مسموح، وغير معتمد من OSI) -- تأكد دائماً من شروط الترخيص قبل النشر التجاري. يصنّف قانون الذكاء الاصطناعي الأوروبي توليد الكود بمساعدة الذكاء الاصطناعي للبنية التحتية الحرجة كنشاط عالي الخطورة محتملاً -- والاستدلال داخل المنشأة يُبقي خط العمل ضمن محيطك الأمني القائم.
اليابان (METI)
تغطي إرشادات الأمن السيبراني من METI بشكل متزايد استخدام أدوات الذكاء الاصطناعي في تطوير البرمجيات. يتعامل Qwen3-Coder مع تعليقات الكود اليابانية وأعراف تسمية المتغيرات بشكل أصلي -- مفيد لقواعد الكود المطوّرة في اليابان ذات التوثيق المضمّن باليابانية. لسجلات الامتثال، يوفر وسم Ollama (مثلاً qwen2.5-coder:32b) معرّف الإصدار الدقيق الذي تتطلبه وثائق حوكمة الذكاء الاصطناعي من METI.
الصين
بموجب قانون أمن البيانات الصيني (数据安全法)، لا يمكن معالجة الشيفرة المصدرية للبنية التحتية المعلوماتية الحرجة بواسطة خدمات سحابية أجنبية. يُعدّ Qwen3.8 27B وQwen3-Coder (Alibaba، Apache 2.0) الخيار الطبيعي لسير عمل البرمجة في الشركات الصينية -- مطوّر صيني وترخيص Apache 2.0 ونشر محلي كامل عبر Ollama. Kimi K2.6 (من Moonshot AI) صيني المنشأ أيضاً لكنه يحتاج عتاداً بمستوى الخوادم للتشغيل المحلي. هذا ليس استشارة قانونية؛ تحقق من المتطلبات المنطبقة على حالتك.
ما الأخطاء الشائعة مع نماذج البرمجة المحلية؟
- استخدام HumanEval كمعيار وحيد لاختيار النماذج: يقيّم HumanEval توليد دوال Python الفردية. في التطوير الحقيقي، تحتاج استدلالاً متعدد الملفات وتوليد اختبارات وفهم قواعد الكود. SWE-bench متنبئ أفضل بأداء البرمجة الحقيقي. النموذج الذي يحقق نتيجة جيدة في SWE-bench رهان أفضل لسير العمل العملي من نموذج بنتيجة عالية في HumanEval ودون نتيجة في SWE-bench.
- تجاهل نماذج MoE لأن إجمالي عدد المعاملات يبدو كبيراً جداً: يملك Kimi K2.6 1T معامل إجمالاً لكن 32B فقط نشطة لكل رمز. تعمل نماذج MoE أسرع وتستخدم VRAM أقل مما يوحي به إجمالي عدد معاملاتها. نموذج MoE بـ 1T يمكن أن يعمل على العتاد الذي يتطلبه نموذج كثيف بحجم 70B.
- استخدام نموذج عام الأغراض بدلاً من نموذج خاص بالكود: يؤدي Qwen3 8B (خاص بالكود) أداءً أفضل في المهام الحقيقية من Llama 3.1 8B العام (عام الأغراض) رغم نتائج متشابهة في HumanEval. للإكمال التلقائي في بيئة التطوير، استخدم دائماً نموذجاً خاصاً بالكود مع دعم FIM.
- عدم ضبط طول السياق للمراجعة متعددة الملفات: يستخدم Ollama افتراضياً 2048 رمزاً. معظم ملفات الكود بين 1,000-3,000 رمز. اضبط `PARAMETER num_ctx 32768` في Modelfile لأي مهمة برمجة تتضمن ملفات كاملة أو دوال متعددة في السياق.
- استخدام Q3_K_S في نماذج البرمجة لتوفير RAM: التكميم دون Q4_K_M يتدهور دقة توليد الكود بشكل ملحوظ -- تزداد الأخطاء المنطقية والنحوية. لمهام البرمجة، استخدم Q4_K_M كحد أدنى. إذا كانت RAM محدودة، اختر نموذجاً أصغر بصيغة Q4_K_M بدلاً من نموذج أكبر بصيغة Q3_K_S.
- تحدد هندسة الموجّهات جودة المخرجات بصرف النظر عن النموذج: تحديد اللغة والقيود وحالات الاختبار ومعالجة الأخطاء في موجّهك يقلّل بشكل كبير الكود المهلوس. راجع كيف تكتب كوداً أفضل بالذكاء الاصطناعي للأنماط المثبتة في الإنتاج.
⚠️تحذير: لا تستخدم أبداً تكميماً دون Q4_K_M لنماذج البرمجة. يوفّر Q3_K_S ذاكرة RAM لكنه يُدخل أخطاء نحوية وأخطاء منطقية. هذه مقايضة لا تستحق العناء لتوليد الكود -- استخدم Q4_K_M أو اختر نموذجاً أصغر بدقة كاملة.
الأسئلة الشائعة
ما أفضل LLM محلي للبرمجة؟
Qwen3.8 27B (من Alibaba، بترخيص Apache 2.0) — كثيف 27B، 18 GB، سياق 256K، و61.7 في SWE-bench Pro بحسب Qwen. `ollama run qwen3.8`. للبرمجة الوكيلية على 16 GB: Devstral Small 2. للجلسات الطويلة: Laguna XS 2.1. للإكمال التلقائي في IDE: Codestral 22B. لأجهزة 8 GB: Qwen3 8B.
أي نموذج Qwen هو الأفضل للبرمجة؟
Qwen3.8 27B هو أفضل خيار Qwen عام للبرمجة على GPU بسعة 24 GB أو Mac بذاكرة 32 GB (18 GB، و61.7 في SWE-bench Pro بحسب Qwen). ويناسب Qwen3-Coder-Next (إجمالي 80B ونشط 3B، 52 GB) أجهزة 64 GB، وQwen3-Coder 30B (19 GB) الإكمال الواعي بالمستودع، وQwen3 8B (5 GB) ذاكرة 8 GB من RAM.
هل Qwen هو أفضل LLM محلي للبرمجة؟
على معظم العتاد الاستهلاكي، يملك Qwen3.8 27B حالياً أقوى نتائج البرمجة المعلنة بين النماذج التي تعمل محلياً، لكن لا يتفوق نموذج واحد في كل المهام. يناسب Devstral Small 2 أجهزة 16 GB ومصمم للحلقات الوكيلية، ويستهدف Laguna XS 2.1 الجلسات الطويلة، وCodestral 22B أكثر تخصصاً في الإكمال التلقائي داخل IDE. النتائج معلنة من الشركات بأطر اختبار مختلفة، لذا جرّب على كودك أنت.
هل يمكنني تشغيل Kimi K2.6 أو Kimi K2.7 Code محلياً؟
فقط على عتاد بمستوى الخوادم. كلاهما نموذج MoE بحجم 1T معامل (32B نشط). تُدرجهما Ollama كوسوم سحابية فقط (`kimi-k2.6:cloud` و`kimi-k2.7-code:cloud`) وهي ليست استدلالاً محلياً. تحتاج إصدارات GGUF المجتمعية من K2.7 Code نحو 310 GB (1 بت) إلى 350 GB (2 بت). للبرمجة المحلية على عتاد استهلاكي استخدم Qwen3.8 27B أو Devstral Small 2 أو Laguna XS 2.1.
ما هما Devstral Small 2 وLaguna XS 2.1؟
كلاهما نموذجا برمجة وكيلية. Devstral Small 2 (من Mistral AI، بترخيص Apache 2.0) نموذج بحجم 24B و15 GB ونتيجته 65.8% في SWE-bench Verified بحسب Mistral -- `ollama run devstral-small-2`. أما Laguna XS 2.1 (من Poolside، 2 يوليو 2026) فهو MoE بإجمالي 33B ونشط 3B وحجم 20 GB ونافذة سياق 256K؛ ويحقق 70.9% في SWE-bench Verified و63.1% في SWE-bench Multilingual بترخيص OpenMDW-1.1 -- `ollama run laguna-xs-2.1`.
ما هو HumanEval ولماذا هو مهم؟
HumanEval معيار من 164 مسألة برمجة بلغة Python. على النموذج توليد متن دالة صحيح لكل مسألة. المقياس القياسي هو pass@1 (نسبة الحل من المحاولة الأولى). ما زال يُستخدم لمقارنة نماذج الكود الصغيرة، لكنه يختبر دوالَّ منفردة لا مشاريع حقيقية.
ما هو الإكمال في المنتصف (FIM) وأي النماذج تدعمه؟
FIM هو القدرة على إكمال الكود بالاعتماد على الكود قبل المؤشر وبعده -- النمط الذي يستخدمه الإكمال التلقائي في IDE. يدعم FIM كل من Codestral 22B وQwen3-Coder وDeepSeek-Coder وStarcoder2، ولا يدعمه Llama 3.1 8B العام. للتكامل مع IDE استخدم نموذجاً يدعم FIM.
هل يمكن لنماذج البرمجة المحلية استبدال GitHub Copilot؟
يمكن لـ Codestral 22B عبر Continue.dev تغطية معظم مهام الإكمال التلقائي. وفي الاستدلال المعقد على ملفات متعددة تحتفظ النماذج السحابية عادةً بأفضلية في أصعب المهام. المقايضة: النماذج المحلية أبطأ لكنها خاصة تماماً وتعمل على عتادك أنت.
كم من RAM أحتاج لنماذج LLM المحلية للبرمجة؟
الحد الأدنى 4 GB (نماذج صغيرة بحجم 3B)، وعملياً 8 GB فأكثر لبرمجة قابلة للاستخدام. تشغّل 16 GB نموذج Devstral Small 2 (15 GB). وتشغّل 24 GB من ذاكرة GPU أو Mac بذاكرة 32 GB نموذج Qwen3.8 27B (18 GB) بمساحة كافية. قاعدة تقريبية: أوزان Q4_K_M تشغل نحو 0.6 GB لكل مليار معامل، إضافة إلى ذاكرة نافذة السياق.
كم من السياق يستهلك ملف Python من 500 سطر؟
نحو 2,000-3,000 رمز لملف Python من 500 سطر. قد يكون سياق Ollama الافتراضي (المتدرج بحسب VRAM) غير كافٍ. اضبط `PARAMETER num_ctx 16384` كحد أدنى لمراجعة ملف واحد. وللتحليل متعدد الملفات استخدم 32768 أو 65536.
هل نماذج البرمجة المحلية سريعة بما يكفي للتطوير؟
نعم لسير العمل التكراري. تعتمد السرعة على GPU والتكميم وطول السياق. النماذج الصغيرة مثل Qwen3 8B تستجيب بسرعة على الحواسيب المحمولة؛ والنماذج الكبيرة أبطأ لكل رمز. انتظار بضع ثوانٍ لكل استجابة مقبول في نمط الطلب والمراجعة، لكنه غير مقبول للإكمال عند كل ضغطة مفتاح حيث ينبغي استخدام نموذج FIM صغير.
هل يمكن لنماذج LLM المحلية استبدال GPT-5.6 في البرمجة؟
ليس بالكامل. تتأخر النماذج المحلية (Qwen3.8 27B وDevstral Small 2) عن النماذج السحابية الرائدة في المعرفة الحديثة بالأطر (واجهات API الصادرة بعد تاريخ قطع التدريب)، والاستدلال متعدد الملفات الطويل جداً (100k+ رمز)، ودقة التصحيح. وقد ضيّقت الفجوة في مهام الملفات المتعددة اليومية وتُبقي كودك خاصاً.
أي لغة يدعمها Qwen3-Coder بشكل أفضل؟
Python هي لغة التدريب الأساسية. وتُدعم JavaScript وTypeScript وJava وC++ وGo وRust وSQL جيداً. ويتعامل النموذج أيضاً مع PHP وRuby وSwift وKotlin. في اللغات غير Python تكون نتائج HumanEval أقل لكنها تبقى تنافسية.
هل DeepSeek-Coder آمن للكود المملوك؟
عند التشغيل محلياً عبر Ollama لا يُجري DeepSeek-Coder أي اتصالات خارجية. يبقى الكود على عتادك. ينطبق القلق بشأن بيانات DeepSeek على واجهته السحابية (api.deepseek.com) لا على الاستدلال المحلي عبر Ollama. لا يرسل الاستدلال المحلي أي كود إلى خوادم DeepSeek.
هل يمكنني استخدام نماذج البرمجة المحلية لتوليد SQL؟
نعم -- يتعامل Qwen3.8 27B وDevstral Small 2 مع توليد SQL. قدّم مخطط الجداول في سياق الأمر. وللاستعلامات المعقدة متعددة JOIN استخدم سياق 32K لتضمين المخطط كاملاً. اضبط أمر النظام: «أنت خبير SQL. ولّد SQL صالحاً فقط.»
ما هو SWE-bench ولماذا يحل محل HumanEval؟
يختبر SWE-bench قدرة النموذج على حل مشكلات GitHub الحقيقية — قراءة قواعد الكود وإجراء تعديلات على ملفات متعددة وكتابة الاختبارات. وعلى عكس HumanEval (دوال Python منفردة) يتنبأ SWE-bench بأداء النموذج في سير عمل التطوير الفعلي. SWE-bench Verified وSWE-bench Pro نسختان مختلفتان ونتائجهما غير قابلة للتبادل. في 2026 أصبح SWE-bench المعيار الرئيسي لتقييم نماذج البرمجة في الاستخدام الفعلي.
كيف أربط نموذج برمجة محلياً بـ VS Code؟
ثبّت إضافة Continue.dev من سوق VS Code. في إعدادات Continue اختر Ollama كمزوّد وحدّد نموذجك (مثل `qwen3:8b` أو `qwen3.8` أو `codestral:22b`). تتصل الإضافة بـ Ollama تلقائياً على localhost:11434. استخدم Cmd+I (macOS) أو Ctrl+I (Windows) لتشغيل توليد الكود المضمّن.
المصادر
- فريق Qwen. (2026). بطاقة النموذج «Qwen3.8-27B». huggingface.co -- Apache 2.0، سياق 256K، SWE-bench Pro بنتيجة 61.7، LiveCodeBench v6 بنتيجة 90.3، Terminal Bench 2.1 بنتيجة 73.0.
- Ollama. (2026). صفحة «qwen3.8» في المكتبة. ollama.com -- وسم 18 GB (Q4_K_M)، سياق 256K.
- Mistral AI. (2026). «devstral-small-2» في Ollama. ollama.com -- 15 GB، SWE-bench Verified بنتيجة 65.8%، يتطلب Ollama 0.13.3 أو أحدث.
- Poolside. (2026). «Introducing Laguna XS 2.1». poolside.ai -- نموذج برمجة وكيلية، MoE بإجمالي 33B ونشط 3B، SWE-bench Verified بنتيجة 70.9%، ترخيص OpenMDW-1.1.
- Ollama. (2026). صفحة «laguna-xs-2.1» في المكتبة. ollama.com -- الوسم الافتراضي 20 GB، سياق 256K.
- Ollama. (2026). صفحة «qwen3-coder-next» في المكتبة. ollama.com -- إجمالي 80B ونشط 3B، 52 GB بتكميم Q4_K_M.
- Ollama. (2026). صفحة «kimi-k2.6» في المكتبة. ollama.com -- لا يُدرج سوى وسم `:cloud`.
- Unsloth. (2026). دليل التشغيل المحلي لـ «Kimi K2.7 Code». unsloth.ai -- MoE بحجم 1T ونشط 32B، ومتطلبات ذاكرة 310–470 GB بعد التكميم.
- Ollama. (2026). صفحة «codestral» في المكتبة. ollama.com -- 22B، 13 GB، سياق 32K.
- فريق Qwen. (2026). «Qwen3-Coder-Next Technical Report». arxiv.org -- بنية Qwen3-Coder-Next ونتائجه في البرمجة الوكيلية.
- DeepSeek AI. (2024). «DeepSeek-Coder-V2 Technical Report». arxiv.org/abs/2406.11931 -- بنية MoE ونتائج معايير البرمجة لـ DeepSeek-Coder V2 Lite.