ما هو نموذج LLM المحلي "الصغير" ومتى تستخدمه؟
نموذج LLM المحلي الصغير هو عادةً نموذج بنحو 4 مليارات معامل أو أقل. عند تكميم 4 بت يبلغ حجم تنزيل هذه النماذج نحو 1-4 GB تقريبًا (باستثناء تصميم المعاملات الفعّالة في Gemma 4، انظر أدناه) -- وهو ضمن حدود الحواسيب المحمولة الاقتصادية ذات الذاكرة الإجمالية 4-8 GB.
تناسب النماذج الصغيرة التلخيص والأسئلة والأجوبة البسيطة وشرح مقاطع الشيفرة والترجمات القصيرة وإعادة الصياغة والتصنيف. ولا تناسب سلاسل الاستدلال الطويلة متعددة الخطوات، ولا توليد الشيفرة على نطاق واسع، ولا الكتابة الطويلة المتماسكة.
ما زالت فجوة الجودة بين نموذج 4B ونموذج 7-9B حقيقية. إن كان جهازك يملك 8 GB أو أكثر مع هامش، فإن نموذج 7-9B مثل Qwen3.5 9B (6.6-7.6 GB على Ollama) هو عادةً الخيار الأفضل. راجع أفضل نماذج LLM المحلية للمبتدئين لتوصيات نماذج 7B.
أي نموذج صغير يجب أن تستخدم؟ دليل قرار سريع
- 8 GB RAM أو أكثر وتريد أفضل جودة: Qwen3.5 4B (`ollama run qwen3.5:4b`).
- تريد الصور والنص في نموذج واحد ولديك 12 GB أو أكثر: Gemma 4 E4B (`ollama pull gemma4:e4b`).
- 4-6 GB RAM ومساعدة في الاستدلال أو البرمجة بالإنجليزية: Phi-4 Mini 3.8B (`ollama run phi4-mini`).
- 4 GB RAM، أو نصوص بغير الإنجليزية: Qwen3.5 2B (`ollama run qwen3.5:2b`).
- أقل من 3 GB RAM متاحة، أو جهاز من فئة Raspberry Pi: Qwen3.5 0.8B (`ollama run qwen3.5:0.8b`) مع قبول حدوده.
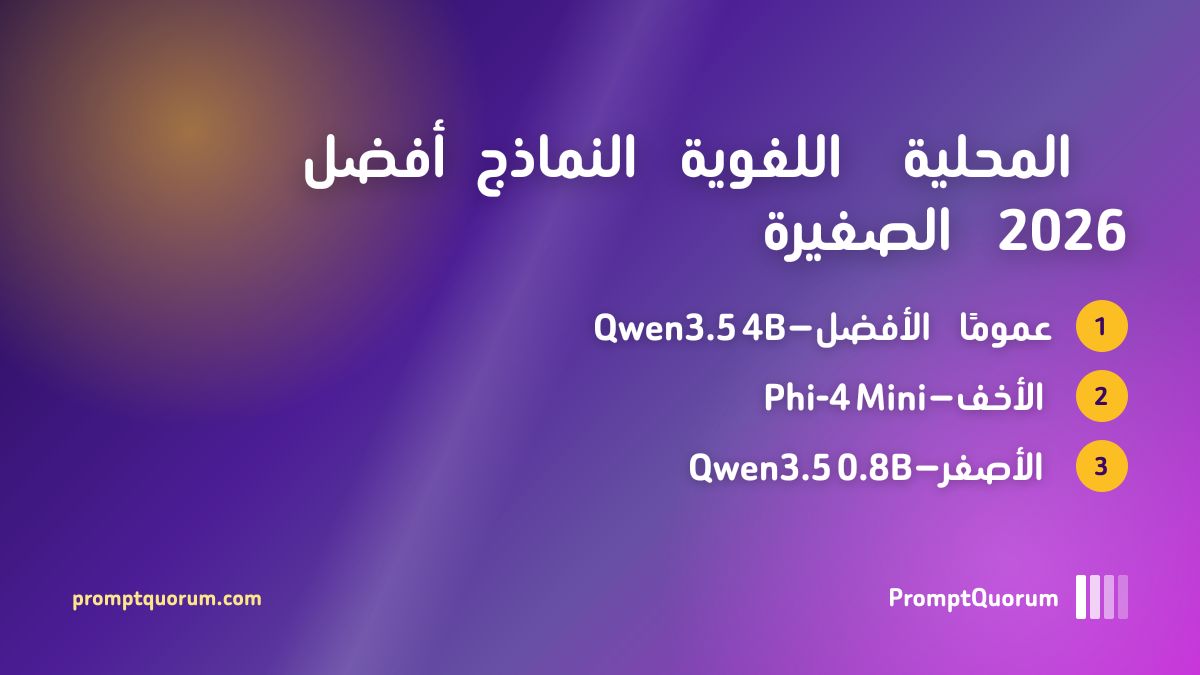
Qwen3.5 4B -- أفضل نموذج صغير بشكل عام (أفضل نموذج 4B)
Qwen3.5 4B هو أقوى نموذج في فئة 4B ضمن هذه المقارنة، بدرجات MMLU-Pro 79.1 وGPQA Diamond 76.2 وLiveCodeBench v6 55.8 على بطاقة النموذج الرسمية من Qwen. صدر ضمن سلسلة Qwen3.5 Small في أوائل 2026 بترخيص Apache 2.0، ويقبل النصوص والصور، ويدعم استدعاء الأدوات، وله نافذة سياق أصلية من 262,144 token.
أمران يجب معرفتهما. أولًا، تفكّر نماذج Qwen3.5 افتراضيًا، ما يحسّن الاستدلال لكنه بطيء على CPU -- أوقف التفكير للمهام البسيطة. ثانيًا، لا تذكر بطاقة النموذج أي وضع تستخدمه المعايير الرئيسية، كما يختلف إعداد التقييم لدى Qwen عن إعداد Google وMicrosoft، لذا قارن الأرقام بشكل استرشادي لا رقمًا برقم.
المواصفة | القيمة |
|---|---|
| MMLU-Pro | 79.1 (مُبلَّغ عنه من الجهة المطوّرة) |
| GPQA Diamond | 76.2 (مُبلَّغ عنه من الجهة المطوّرة) |
| LiveCodeBench v6 | 55.8 (مُبلَّغ عنه من الجهة المطوّرة) |
| حجم التنزيل (Ollama) | 3.3-4.0 GB |
| السياق | 256K token |
| الترخيص | Apache 2.0 |
| أمر Ollama | ollama run qwen3.5:4b |
Gemma 4 E4B -- أفضل نموذج متعدد الوسائط في فئة 4B
يسجّل Google Gemma 4 E4B نسبة 69.4% في MMLU-Pro و52.0% في LiveCodeBench v6 و58.6% في GPQA Diamond، بحسب بطاقة النموذج من Google. يعني "E4B" وجود 4.5B معامل فعّال؛ ومع التضمينات لكل طبقة يبلغ النموذج نحو 8B معامل، وهذا سبب أن تنزيل Ollama يبلغ 6.6-9.5 GB رغم تسمية "4B". يقبل النصوص والصور، وله نافذة سياق 128K، وصدر بترخيص Apache 2.0.
اختر E4B بدلًا من Qwen3.5 4B إن أردت منظومة Google، أو نتائج قوية متعددة اللغات (MMMLU بنسبة 76.6%)، أو درجة وكيلية Tau2 قدرها 42.2%. واختر Qwen3.5 4B إن أردت فئة الجودة نفسها بنحو نصف مساحة التخزين والذاكرة.
المواصفة | القيمة |
|---|---|
| MMLU Pro | 69.4% |
| LiveCodeBench v6 | 52.0% |
| GPQA Diamond | 58.6% |
| حجم التنزيل (Ollama) | 6.6-9.5 GB |
| السياق | 128K token |
| الترخيص | Apache 2.0 |
| أمر Ollama | ollama pull gemma4:e4b |
Phi-4 Mini 3.8B -- الأخف في فئة 4B (2.5 GB)
يسجّل Microsoft Phi-4 Mini نسبة 67.3% في MMLU و52.8% في MMLU-Pro بحسب بطاقة نموذجه، في تنزيل بحجم 2.5 GB -- أصغر بصمة بين نماذج فئة 4B هنا. ترخيصه MIT، وله نافذة سياق 128K، وقد دُرِّب على بيانات اصطناعية منتقاة تركّز على الاستدلال.
يتأخر عن Qwen3.5 4B وGemma 4 E4B في معايير الاستدلال (GPQA 25.2 مقابل 76.2 و58.6)، لذا اخترْه عندما تكون الذاكرة هي القيد -- أجهزة 4-6 GB -- أو عندما تريد ترخيص MIT المتساهل.
المواصفة | القيمة |
|---|---|
| MMLU (5-shot) | 67.3% |
| MMLU-Pro | 52.8% |
| GPQA Diamond | 25.2% |
| حجم التنزيل (Ollama) | 2.5 GB |
| السياق | 128K token |
| الترخيص | MIT |
| أمر Ollama | ollama run phi4-mini |
Qwen3.5 2B -- الأفضل لأجهزة 4 GB
Qwen3.5 2B هو الخيار الأفضل عندما لا يتسع نموذج 4B. تذكر بطاقة نموذج Qwen أن MMLU-Pro يبلغ 55.3 في وضع عدم التفكير و66.5 في وضع التفكير، وGPQA يبلغ 51.6 في وضع التفكير. حجم تنزيله 2.7-3.1 GB على Ollama، ويقبل الصور، وله نافذة سياق 256K، وترخيصه Apache 2.0.
مقارنةً بنموذج 0.8B فهو أكثر موثوقية بكثير في اتباع التعليمات (IFEval بقيمة 61.2 مقابل 52.1 بدون تفكير)، وهو أصغر نموذج هنا نستخدمه في أعمال التلخيص والأسئلة والأجوبة الفعلية.
المواصفة | القيمة |
|---|---|
| MMLU-Pro | 55.3% بدون تفكير / 66.5% مع التفكير |
| GPQA | 51.6% (مع التفكير) |
| حجم التنزيل (Ollama) | 2.7-3.1 GB |
| السياق | 256K token |
| الترخيص | Apache 2.0 |
| أمر Ollama | ollama run qwen3.5:2b |
Gemma 4 E2B -- خيار الأجهزة الطرفية ومتعدد الوسائط
يسجّل Google Gemma 4 E2B نسبة 60.0% في MMLU Pro و44.0% في LiveCodeBench v6 و43.4% في GPQA Diamond، بحسب بطاقة النموذج من Google. عدد المعاملات الفعّالة 2.3B (و5.1B مع التضمينات لكل طبقة). لا يعني رقم المعاملات الفعّالة ملفًا بحجم 2 GB: فـ Ollama يُدرج حجم التنزيل بـ 4.6-7.5 GB، لذا يحتاج ذاكرة أكبر من Qwen3.5 2B لنتائج من فئة مماثلة.
له نافذة سياق 128K، ويقبل الصور، وترخيصه Apache 2.0. يختلف أداء CPU بحسب العتاد والتكميم (تذكر Google نحو 7.6 tok/ثانية لفك الترميز على Raspberry Pi 5؛ وتتراوح تقارير x86 المستقلة بين 8 و48 tok/ثانية). اخترْه للأجهزة الطرفية حيث تريد أدوات Google؛ وفي غير ذلك فإن Qwen3.5 2B أخف.
المواصفة | القيمة |
|---|---|
| MMLU Pro | 60.0% |
| LiveCodeBench v6 | 44.0% |
| GPQA Diamond | 43.4% |
| حجم التنزيل (Ollama) | 4.6-7.5 GB |
| السياق | 128K token |
| الترخيص | Apache 2.0 |
| أمر Ollama | ollama pull gemma4:e2b |
Qwen3.5 0.8B -- أصغر نموذج يستحق التشغيل
Qwen3.5 0.8B هو أصغر نموذج في هذه المقارنة: تنزيل بحجم 1.2-1.3 GB على Ollama مع نافذة سياق 256K وترخيص Apache 2.0. تبلغ MMLU-Pro المُبلَّغ عنها من الجهة المطوّرة 29.7 (بدون تفكير) و42.3 (مع التفكير)، وGPQA 11.9 -- وهذا يكفي للتصنيف واستخراج الكلمات المفتاحية وإعادة الصياغة القصيرة، لا للاستدلال متعدد الخطوات ولا للإجابات الطويلة. استخدمه فقط عندما تكون RAM هي القيد الحاسم فعلًا (أقل من 3 GB متاحة)، أو على الحواسيب أحادية اللوحة، أو كمرشِّح أولي سريع داخل مسار معالجة.
المواصفة | القيمة |
|---|---|
| MMLU-Pro | 29.7% بدون تفكير / 42.3% مع التفكير |
| GPQA | 11.9% (مع التفكير) |
| حجم التنزيل (Ollama) | 1.2-1.3 GB |
| السياق | 256K token |
| أمر Ollama | ollama run qwen3.5:0.8b |
مقارنة كاملة: أفضل نماذج LLM المحلية الصغيرة (فئة 0.8B-4B)
النموذج | MMLU-Pro | GPQA Diamond | حجم التنزيل (Ollama) | السياق | الأفضل لـ |
|---|---|---|---|---|---|
| Qwen3.5 4B | 79.1 | 76.2 | 3.3-4.0 GB | 256K | أفضل نموذج 4B بشكل عام |
| Gemma 4 E4B | 69.4 | 58.6 | 6.6-9.5 GB | 128K | متعدد الوسائط، منظومة Google |
| Phi-4 Mini 3.8B | 52.8 | 25.2 | 2.5 GB | 128K | الأخف في فئة 4B، MIT |
| Qwen3.5 2B | 55.3 / 66.5 | 51.6 | 2.7-3.1 GB | 256K | أجهزة 4 GB |
| Gemma 4 E2B | 60.0 | 43.4 | 4.6-7.5 GB | 128K | الأجهزة الطرفية |
| Qwen3.5 0.8B | 29.7 / 42.3 | 11.9 | 1.2-1.3 GB | 256K | أصغر نموذج قابل للاستخدام |
الدرجات مُبلَّغ عنها من الجهات المطوّرة على بطاقة كل نموذج أو صفحته في Ollama، وتعتمد إعدادات تقييم مختلفة؛ وتعني الصيغة "أ / ب" وضع عدم التفكير / وضع التفكير. اعتبرها استرشادية. أحجام التنزيل هي النطاقات المُدرجة في Ollama وتشمل مشفّر الرؤية حيث يوجد.
نماذج LLM المحلية الصغيرة حسب المنطقة
الاتحاد الأوروبي / GDPR: للمهنيين في الاتحاد الأوروبي الذين يعملون بعتاد محدود -- العمل الميداني، والبيئات المعزولة، والحواسيب المحمولة المؤسسية الأقدم -- يمكن للنماذج المحلية الصغيرة تنفيذ الاستدلال بالكامل على الجهاز دون أي استدعاءات لواجهات سحابية، شريطة تعطيل التتبّع عن بُعد (telemetry) والمزامنة في بيئة التشغيل والتطبيقات. وتشغيل Qwen3.5 4B أو Phi-4 Mini على حاسوب محمول مؤسسي قياسي يُبقي كل النص المعالَج داخل الجهاز، بما يدعم أهداف تقليل البيانات في المادة 5 من GDPR؛ أما كون نشر معيّن متوافقًا فعلًا فيظل مرهونًا بمنظومتك الكاملة. التراخيص متساهلة: Phi-4 Mini بترخيص MIT، وGemma 4 وQwen3.5 بترخيص Apache 2.0. والخيارات الأوروبية المنشأ بهذا الحجم محدودة؛ راجع تشكيلة Mistral الحالية إن كان المنشأ الأوروبي شرطًا.
اليابان (METI): للمهام باللغة اليابانية في الفئة الصغيرة، يسجّل Qwen3.5 وGemma 4 E4B درجات MMMLU تقارب 76 على بطاقتيهما. وعلى جهاز محدود جرّب `ollama run qwen3.5:2b` أو `ollama run qwen3.5:4b` لتلخيص النصوص اليابانية أو ترجمتها. وتهم ميزة السرعة في النماذج الصغيرة للاستخدام المؤسسي على أجهزة المكاتب القياسية، وإن كانت السرعة الفعلية تعتمد على CPU والتكميم.
الصين: يُعد Qwen3.5 (من Alibaba، بترخيص Apache 2.0) الخيار الطبيعي لنشر النماذج الصغيرة باللغة الصينية. وفي عمليات نشر إنترنت الأشياء والحافة بموجب قانون أمن البيانات الصيني (数据安全法)، يعمل `ollama run qwen3.5:2b` على جهاز Linux بذاكرة نحو 4 GB ويعالج النص على الجهاز دون استدعاءات API خارجية؛ وتأكد من التزاماتك النظامية بشكل مستقل.
ما هي الأخطاء الشائعة عند تشغيل نماذج LLM المحلية الصغيرة؟
- ترك وضع التفكير مفعّلًا للمهام البسيطة: تفكّر نماذج Qwen3.5 افتراضيًا، فتستهلك token إضافية كثيرة قبل الإجابة. للدردشة والاستخراج على CPU، أوقفه (`--think=false` في Ollama) واحتفظ به للرياضيات والمنطق.
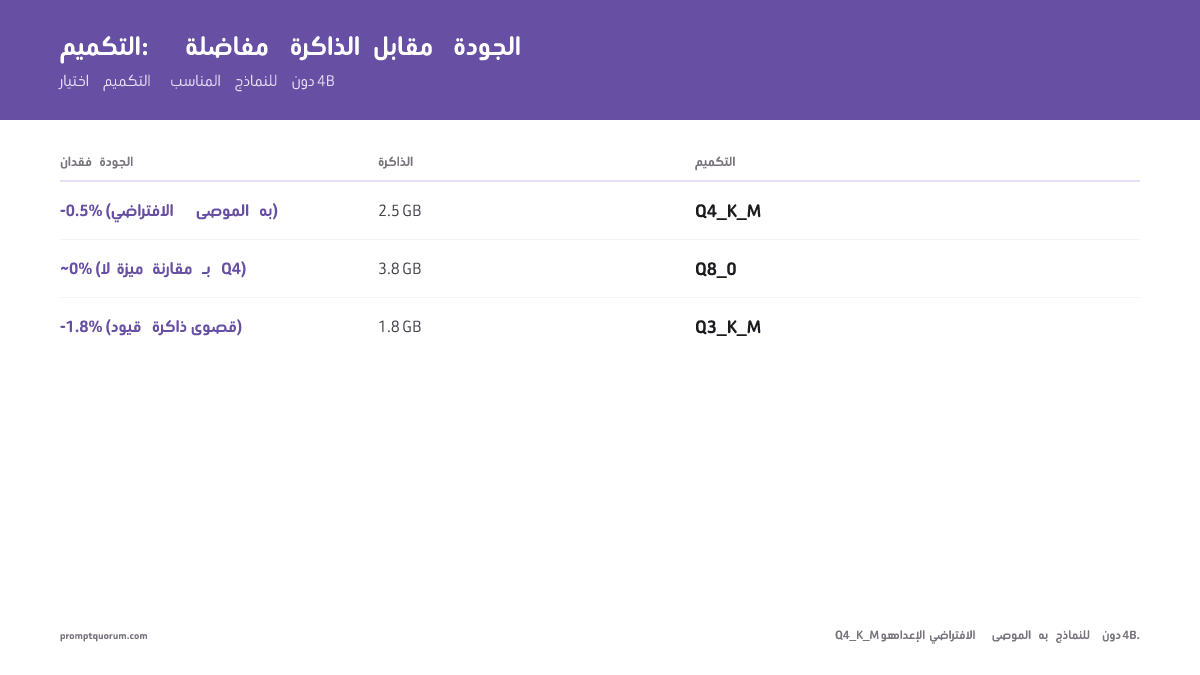
- استخدام تكميم Q8_0 بدلًا من Q4_K_M: يتطلب Q8_0 ضعف RAM تقريبًا مقارنة بـ Q4_K_M مع تحسّن جودة ضئيل على النطاق الصغير. وعلى جهاز بذاكرة 4 GB قد يُفعّل Q8_0 استخدام swap ويجعل الاستدلال أبطأ بعدة أضعاف. استخدم Q4_K_M كقيمة افتراضية للنماذج الصغيرة.
- تشغيل نموذج أساسي بدلًا من نسخة instruct: النماذج الأساسية نقاط تحقق قبل الضبط الدقيق، تتنبأ بالـ token التالي ولا تتبع التعليمات. اسأل أحدها "كم 2+2؟" وقد يكمل الجملة كاختبار بدلًا من الإجابة بـ "4". استخدم الوسوم الافتراضية الموضحة في هذه الصفحة، فهي مضبوطة على التعليمات.
- الحكم على Gemma 4 من اسمه "E2B/E4B": تسمية المعاملات الفعّالة تقلّل من حجم التنزيل الحقيقي. يبلغ Gemma 4 E4B ما بين 6.6 و9.5 GB على Ollama؛ تحقق من الحجم المُدرج قبل سحبه على جهاز بذاكرة 8 GB.
- توقّع جودة نموذج 7B فما فوق من نموذج صغير: تتعامل النماذج الصغيرة مع المهام القصيرة المحددة جيدًا. أما سلاسل الاستدلال الطويلة والكتابة المطوّلة وتوليد الشيفرة الدقيق فهي أضعف بوضوح من نماذج 7-9B. إذا كانت جودة المخرجات غير كافية، فانتقل إلى Qwen3.5 9B (6.6-7.6 GB على Ollama).
فهم التكميم: الموازنة بين RAM والجودة
أسئلة شائعة حول نماذج LLM المحلية الصغيرة
ما أفضل نموذج LLM صغير للتشغيل محليًا؟
لمعظم المستخدمين الذين تبلغ ذاكرتهم RAM سعة 8 GB أو أكثر، أفضل نموذج LLM محلي صغير في 2026 هو Qwen3.5 4B (Apache 2.0، `ollama run qwen3.5:4b`): فبحسب بطاقة النموذج الرسمية من Qwen يسجّل MMLU-Pro 79.1 وGPQA Diamond 76.2، متقدمًا على Gemma 4 E4B (69.4 / 58.6) وPhi-4 Mini (52.8 / 25.2). وعلى جهاز بذاكرة 4 GB انتقل إلى Qwen3.5 2B أو Phi-4 Mini. هذه أرقام مُبلَّغ عنها من الجهات المطوّرة وبإعدادات تقييم مختلفة، لذا اعتبر الفروق استرشادية لا دقيقة.
ما أفضل نموذج 4B؟
يُعد Qwen3.5 4B أقوى نموذج في فئة 4B ضمن هذه المقارنة بحسب معايير الاستدلال المُبلَّغ عنها من الجهة المطوّرة، كما يوفّر نافذة سياق 256K وحجم تنزيل نحو 3.3-4.0 GB على Ollama. أما Gemma 4 E4B (4.5B معامل فعّال، ونحو 8B مع التضمينات) فهو المنافس الأقرب والخيار الأفضل إن أردت منظومة Google، لكن تنزيله على Ollama يبلغ 6.6-9.5 GB. وPhi-4 Mini 3.8B هو الأخف بحجم 2.5 GB وبترخيص MIT، لكنه يتأخر عن النموذجين في معايير الاستدلال.
ما أصغر نموذج LLM يمكنك تشغيله محليًا؟
من بين النماذج التي تستحق التشغيل، يُعد Qwen3.5 0.8B الأصغر في هذه المقارنة -- تنزيل بحجم 1.2-1.3 GB على Ollama مع نافذة سياق 256K. وهو مناسب للتصنيف واستخراج الكلمات المفتاحية وإعادة الصياغة القصيرة، لكن MMLU-Pro المُبلَّغ عنه من الجهة المطوّرة (29.7 بدون تفكير) يدل على أنه سيخفق في أي مهمة متعددة الخطوات. توجد نماذج أصغر، لكن دون نحو 1B معامل يفقد النص تماسكه بعد بضع جمل، لذا تصلح للإكمال التلقائي أكثر من كونها مساعدًا.
ما أصغر نموذج LLM محلي ينتج مخرجات مفيدة؟
عند نحو 2B معامل تصبح المخرجات موثوقة للتلخيص والأسئلة والأجوبة البسيطة وإعادة الصياغة. يُعد Qwen3.5 2B (تنزيل 2.7-3.1 GB) أصغر نموذج هنا نستخدمه في العمل الفعلي؛ أما Qwen3.5 0.8B فهو الحد الأدنى للعتاد لا للجودة. وإن استطعت تخصيص 4 GB أو أكثر، فإن نموذج 4B يمثل قفزة كبيرة في التماسك مقابل زيادة طفيفة في الذاكرة.
هل يمكن لنموذج صغير العمل على هاتف؟
نعم. تصف Qwen نموذجي Qwen3.5 0.8B و2B بأنهما مصمَّمان للأجهزة الطرفية، وتضع Google نموذجي Gemma 4 E2B وE4B للهواتف والحواسيب المحمولة. لا يعمل Ollama وLM Studio على iOS أو Android، لذا يتطلب المحمول تطبيقًا أو إطار عمل منفصلًا، وتعتمد السرعة الفعلية بشدة على شريحة الهاتف وبيئة التشغيل. راجع قائمة النماذج في التطبيق نفسه قبل التنزيل.
هل النماذج الصغيرة جيدة للتلخيص؟
نعم -- التلخيص أحد أقوى حالات استخدامها. تملك النماذج الستة هنا نافذة سياق بحجم 128K token أو أكثر، فنادرًا ما يكون طول المستند هو القيد؛ القيد هو مدى اتباع النموذج للتعليمات عبر مُدخل طويل. يُعد Qwen3.5 4B وGemma 4 E4B الأكثر موثوقية؛ ومع نماذج 0.8B أبقِ المدخلات قصيرة والمخرجات بسيطة.
كم أسرع نموذج 2B من نموذج 7B على العتاد نفسه؟
أسرع بشكل ملحوظ على CPU، لكن النسبة تعتمد بشدة على العتاد والتكميم -- فأرقام Google نفسها لـ Gemma 4 E2B تُظهر نحو 7.6 tok/ثانية (فك الترميز) على Raspberry Pi 5، بينما تتراوح تقارير مستقلة على معالجات x86 بين 8 و48 tok/ثانية بحسب مستوى التكميم. وعلى GPU يتقلّص فارق السرعة لأن أداء GPU أقل تقييدًا بحجم النموذج. راجع اختبارات الأداء الحالية لعتادك تحديدًا بدلًا من افتراض مضاعف ثابت.
هل تدعم النماذج الصغيرة استدعاء الدوال؟
بعضها نعم. تذكر بطاقة نموذج Qwen3.5 من Qwen أن العائلة تتفوق في استدعاء الأدوات، ويسجّل Gemma 4 E4B درجة وكيلية Tau2 قدرها 42.2% على بطاقة Google (و24.5% لـ E2B)، لذا فإن E4B هو الخيار الأكثر أمانًا بين الاثنين لاستخدام الأدوات. راجع وثائق كل نموذج قبل بناء مسار يعتمد على مخرجات منظّمة، لأن الدعم يختلف بحسب الإصدار وبيئة التشغيل.
أي نموذج صغير أفضل للغات غير الإنجليزية؟
يتعادل Qwen3.5 4B وGemma 4 E4B عمليًا في معيار MMMLU متعدد اللغات (76.1 مقابل 76.6 على بطاقتيهما)، وكلاهما متقدم بوضوح على نماذج فئة 2B. وللصينية واليابانية والكورية والعربية على جهاز بذاكرة 4 GB، يُعد Qwen3.5 2B الخيار العملي. راجع مقارنة Qwen vs Llama vs Mistral متعددة اللغات لمقارنة أوسع للغات.
هل أستخدم وضع التفكير مع نموذج صغير؟
عادةً لا في المهام البسيطة. تفكّر نماذج Qwen3.5 افتراضيًا، فتستهلك token إضافية كثيرة قبل الإجابة وتبدو بطيئة على CPU. للدردشة وإعادة الصياغة والاستخراج، أوقف التفكير (في Ollama: `ollama run qwen3.5:4b --think=false`)؛ ولا تفعّله إلا للرياضيات والمنطق والمسائل متعددة الخطوات حيث تهم الدقة أكثر من السرعة.
هل ما زال Llama 3.2 يستحق الاستخدام؟
لم يعد مُرتَّبًا هنا. فنموذجا Llama 3.2 1B و3B (2024) أقدم من كل نموذج في هذه الصفحة، والنماذج الأحدث بحجم 2B-4B أعلاه أكثر قدرة بحجم مماثل. يبقى Llama 3.2 مفيدًا إن كانت أداة أو نسخة مضبوطة تعتمد عليها مبنية حوله.
كم RAM يحتاج نموذج 4B؟
خطّط لنحو 4-5 GB متاحة لنموذج 4B بتكميم 4 بت -- يُدرج Ollama نموذج Qwen3.5 4B بحجم 3.3-4.0 GB وPhi-4 Mini بحجم 2.5 GB -- إضافةً إلى مساحة لنافذة السياق ونظام التشغيل. جهاز 8 GB مريح؛ و4 GB غير كافٍ. أما Gemma 4 E4B فهو الاستثناء: حجم تنزيله المُدرج 6.6-9.5 GB، فيحتاج إلى جهاز بذاكرة 12-16 GB لاستخدام مريح.
هل يمكنني تشغيل نموذجين صغيرين في الوقت نفسه؟
نعم، إذا سمحت RAM الإجمالية. نموذجان من فئة 2B بتكميم Q4_K_M يستخدمان نحو 6 GB مجتمعين -- ممكن على جهاز بذاكرة 8 GB بنظام تشغيل خفيف. يستطيع Ollama إبقاء عدة نماذج محمّلة بحسب إعداداتك والذاكرة المتاحة، أو يمكنك تشغيل نسختين من Ollama على منفذين مختلفين (OLLAMA_HOST=:11434 وOLLAMA_HOST=:11435). هذا مفيد لاختبار A/B للمخرجات.
هل تصلح النماذج الصغيرة لـ RAG (التوليد المعزّز بالاسترجاع)؟
نعم لـ RAG البسيط. يستطيع Qwen3.5 4B وPhi-4 Mini الإجابة عن أسئلة حول مقاطع مستندات مُسترجعة بشكل موثوق. أما RAG على قواعد معرفة كبيرة تتطلب استدلالًا متعدد القفزات، فتؤدي نماذج 7B أو أكبر بثبات أعلى. تشغّل ميزة LocalDocs في GPT4All نموذجًا صغيرًا للأسئلة والأجوبة عن المستندات وتعمل جيدًا لمجموعات المستندات الشخصية.
المصادر
- بطاقات نماذج Qwen3.5-4B و-2B و-0.8B -- huggingface.co/Qwen/Qwen3.5-4B (المعايير، الترخيص، طول السياق)
- مكتبة Ollama: qwen3.5 -- ollama.com/library/qwen3.5 (الوسوم، أحجام التنزيل، السياق)
- بطاقة نموذج Google Gemma 4 -- huggingface.co/google/gemma-4-E4B-it (معايير E2B وE4B، الترخيص)
- مكتبة Ollama: gemma4 -- ollama.com/library/gemma4 (الوسوم، أحجام التنزيل، جدول المعايير)
- بطاقة نموذج Microsoft Phi-4-mini-instruct -- huggingface.co/microsoft/Phi-4-mini-instruct (MMLU وMMLU-Pro وGPQA، الترخيص)
- مكتبة Ollama: phi4-mini -- ollama.com/library/phi4-mini (حجم التنزيل، السياق)