Key Takeaways
- Melhor LLM pequeno geral (classe 4B): Qwen3.5 4B -- MMLU-Pro 79,1, GPQA Diamond 76,2, contexto de 256K, 3,3-4,0 GB no Ollama, Apache 2.0.
- Melhor alternativa de 4B: Gemma 4 E4B -- MMLU-Pro 69,4, multimodal, contexto de 128K; mais pesado em disco e RAM (6,6-9,5 GB no Ollama).
- Modelo mais leve da classe 4B: Phi-4 Mini 3.8B -- 2,5 GB, contexto de 128K, licença MIT, MMLU 67,3.
- Melhor para máquinas de 4 GB: Qwen3.5 2B -- 2,7-3,1 GB, contexto de 256K, roda onde os modelos de 4B não rodam.
- Menor modelo que vale a pena rodar: Qwen3.5 0.8B -- 1,2-1,3 GB, só para classificação e reescritas curtas.
O melhor LLM local pequeno em 2026 é o Qwen3.5 4B para máquinas com 8 GB de RAM, o Gemma 4 E4B se você quer o modelo multimodal da classe 4B do Google, o Phi-4 Mini 3.8B para a menor pegada (2,5 GB) e o Qwen3.5 2B ou 0.8B quando a RAM é o limite.
Se o seu computador tem 4-8 GB de RAM, você ainda pode rodar um modelo de IA capaz localmente -- basta escolher um pequeno. Os modelos de cerca de 4 bilhões de parâmetros hoje dão conta bem de resumo, perguntas e respostas, reescrita e código básico. Os modelos abaixo de 2 bilhões são os menores que dá para usar com algum proveito, mas só lidam com tarefas simples e curtas.
O que é um LLM local "pequeno" e quando você deve usar um?
Um LLM local pequeno é tipicamente um modelo com cerca de 4 bilhões de parâmetros ou menos. Com quantização de 4 bits, esses modelos têm download de aproximadamente 1-4 GB (o design de parâmetros efetivos do Gemma 4 é a exceção, veja abaixo) -- perfeitamente dentro dos limites de notebooks de entrada com 4-8 GB de memória total.
Os modelos pequenos são adequados para resumo, perguntas e respostas simples, explicação de trechos de código, traduções curtas, reescrita e classificação. Eles não são adequados para longas cadeias de raciocínio de várias etapas, geração de código em larga escala nem redação longa e coerente.
A diferença de qualidade entre um modelo de 4B e um de 7-9B ainda é real. Se a sua máquina tem 8 GB ou mais e folga, um modelo de 7-9B como o Qwen3.5 9B (6,6-7,6 GB no Ollama) costuma ser a melhor escolha. Consulte Melhores modelos LLM locais para iniciantes para recomendações de 7B.
Qual modelo pequeno você deve usar? Guia de decisão rápida
- 8 GB de RAM ou mais, quer a melhor qualidade: Qwen3.5 4B (`ollama run qwen3.5:4b`).
- Quer imagens e texto em um só modelo e tem 12 GB ou mais: Gemma 4 E4B (`ollama pull gemma4:e4b`).
- 4-6 GB de RAM, ajuda com raciocínio em inglês ou código: Phi-4 Mini 3.8B (`ollama run phi4-mini`).
- 4 GB de RAM, ou texto em outros idiomas: Qwen3.5 2B (`ollama run qwen3.5:2b`).
- Menos de 3 GB de RAM livres, ou um dispositivo da classe Raspberry Pi: Qwen3.5 0.8B (`ollama run qwen3.5:0.8b`), aceitando as limitações.
Qwen3.5 4B -- Melhor LLM pequeno geral (melhor modelo de 4B)
O Qwen3.5 4B é o modelo mais forte da classe 4B nesta comparação, com MMLU-Pro 79,1, GPQA Diamond 76,2 e LiveCodeBench v6 55,8 na própria ficha do modelo da Qwen. Foi lançado como parte da série Qwen3.5 Small no início de 2026 sob Apache 2.0, aceita texto e imagens, suporta chamadas de ferramentas e tem janela de contexto nativa de 262.144 tokens.
Duas coisas a saber. Primeiro, os modelos Qwen3.5 raciocinam por padrão, o que melhora o raciocínio, mas é lento na CPU -- desative o raciocínio em tarefas simples. Segundo, a ficha do modelo não informa qual modo os benchmarks de destaque usam, e a configuração de avaliação da Qwen difere da do Google e da Microsoft, então compare os números de forma indicativa, não ponto a ponto.
Especificação | Valor |
|---|---|
| MMLU-Pro | 79,1 (informado pelo fabricante) |
| GPQA Diamond | 76,2 (informado pelo fabricante) |
| LiveCodeBench v6 | 55,8 (informado pelo fabricante) |
| Download (Ollama) | 3,3-4,0 GB |
| Contexto | 256K tokens |
| Licença | Apache 2.0 |
| Comando Ollama | ollama run qwen3.5:4b |
Gemma 4 E4B -- Melhor modelo multimodal da classe 4B
O Google Gemma 4 E4B obtém 69,4% no MMLU-Pro, 52,0% no LiveCodeBench v6 e 58,6% no GPQA Diamond, segundo a ficha do modelo do Google. "E4B" significa 4,5B de parâmetros efetivos; incluindo os embeddings por camada, o modelo tem cerca de 8B de parâmetros, e por isso o download no Ollama é de 6,6-9,5 GB apesar do rótulo "4B". Aceita texto e imagens, tem janela de contexto de 128K e é lançado sob Apache 2.0.
Escolha o E4B em vez do Qwen3.5 4B se você quer o ecossistema do Google, bons resultados multilíngues (MMMLU 76,6%) ou uma pontuação agêntica Tau2 de 42,2%. Escolha o Qwen3.5 4B se quer a mesma classe de qualidade com cerca de metade do disco e da memória.
Especificação | Valor |
|---|---|
| MMLU Pro | 69,4% |
| LiveCodeBench v6 | 52,0% |
| GPQA Diamond | 58,6% |
| Download (Ollama) | 6,6-9,5 GB |
| Contexto | 128K tokens |
| Licença | Apache 2.0 |
| Comando Ollama | ollama pull gemma4:e4b |
Phi-4 Mini 3.8B -- Modelo mais leve da classe 4B (2,5 GB)
O Microsoft Phi-4 Mini obtém 67,3% no MMLU e 52,8% no MMLU-Pro segundo a ficha do modelo, em um download de 2,5 GB -- a menor pegada entre os modelos da classe 4B aqui. Tem licença MIT, janela de contexto de 128K e foi treinado com dados sintéticos curados, com foco em raciocínio.
Ele fica atrás do Qwen3.5 4B e do Gemma 4 E4B nos benchmarks de raciocínio (GPQA 25,2 vs 76,2 e 58,6), então escolha-o quando a memória for a restrição -- máquinas de 4-6 GB -- ou quando quiser a licença permissiva MIT.
Especificação | Valor |
|---|---|
| MMLU (5-shot) | 67,3% |
| MMLU-Pro | 52,8% |
| GPQA Diamond | 25,2% |
| Download (Ollama) | 2,5 GB |
| Contexto | 128K tokens |
| Licença | MIT |
| Comando Ollama | ollama run phi4-mini |
Qwen3.5 2B -- Melhor para máquinas de 4 GB
O Qwen3.5 2B é a melhor escolha quando um modelo de 4B não cabe. A ficha do modelo da Qwen informa MMLU-Pro 55,3 no modo sem raciocínio e 66,5 no modo com raciocínio, e GPQA 51,6 no modo com raciocínio. O download é de 2,7-3,1 GB no Ollama, aceita imagens, tem janela de contexto de 256K e licença Apache 2.0.
Em comparação com o modelo de 0.8B, é muito mais confiável em seguir instruções (IFEval 61,2 vs 52,1 sem raciocínio) e é o menor modelo aqui que usaríamos para trabalho de verdade com resumo e perguntas e respostas.
Especificação | Valor |
|---|---|
| MMLU-Pro | 55,3% sem raciocínio / 66,5% com raciocínio |
| GPQA | 51,6% (com raciocínio) |
| Download (Ollama) | 2,7-3,1 GB |
| Contexto | 256K tokens |
| Licença | Apache 2.0 |
| Comando Ollama | ollama run qwen3.5:2b |
Gemma 4 E2B -- Opção para edge e multimodal
O Google Gemma 4 E2B obtém 60,0% no MMLU Pro, 44,0% no LiveCodeBench v6 e 43,4% no GPQA Diamond, segundo a ficha do modelo do Google. Os parâmetros efetivos são 2,3B (5,1B incluindo os embeddings por camada). O número de parâmetros efetivos não significa um arquivo de 2 GB: o Ollama lista o download em 4,6-7,5 GB, então ele precisa de mais memória que o Qwen3.5 2B para resultados de classe semelhante.
Tem janela de contexto de 128K, aceita imagens e é Apache 2.0. A vazão na CPU varia conforme o hardware e a quantização (o Google informa ~7,6 tok/seg de decodificação em um Raspberry Pi 5; relatos independentes em x86 variam de 8 a 48 tok/seg). Escolha-o para dispositivos de borda em que você quer as ferramentas do Google; caso contrário, o Qwen3.5 2B é mais leve.
Especificação | Valor |
|---|---|
| MMLU Pro | 60,0% |
| LiveCodeBench v6 | 44,0% |
| GPQA Diamond | 43,4% |
| Download (Ollama) | 4,6-7,5 GB |
| Contexto | 128K tokens |
| Licença | Apache 2.0 |
| Comando Ollama | ollama pull gemma4:e2b |
Qwen3.5 0.8B -- O menor modelo que vale a pena rodar
O Qwen3.5 0.8B é o menor modelo desta comparação: um download de 1,2-1,3 GB no Ollama, com janela de contexto de 256K e licença Apache 2.0. O MMLU-Pro informado pelo fabricante é 29,7 (sem raciocínio) e 42,3 (com raciocínio), e o GPQA é 11,9 -- suficiente para classificação, extração de palavras-chave e reescritas curtas, não para raciocínio de várias etapas nem respostas longas. Use-o apenas quando a RAM for realmente a restrição (menos de 3 GB disponíveis), em computadores de placa única ou como pré-filtro rápido em um pipeline.
Especificação | Valor |
|---|---|
| MMLU-Pro | 29,7% sem raciocínio / 42,3% com raciocínio |
| GPQA | 11,9% (com raciocínio) |
| Download (Ollama) | 1,2-1,3 GB |
| Contexto | 256K tokens |
| Comando Ollama | ollama run qwen3.5:0.8b |
Comparativo completo: melhores LLMs locais pequenos (classe 0.8B-4B)
Modelo | MMLU-Pro | GPQA Diamond | Download (Ollama) | Contexto | Melhor para |
|---|---|---|---|---|---|
| Qwen3.5 4B | 79,1 | 76,2 | 3,3-4,0 GB | 256K | Melhor 4B geral |
| Gemma 4 E4B | 69,4 | 58,6 | 6,6-9,5 GB | 128K | Multimodal, ecossistema Google |
| Phi-4 Mini 3.8B | 52,8 | 25,2 | 2,5 GB | 128K | Mais leve da classe 4B, MIT |
| Qwen3.5 2B | 55,3 / 66,5 | 51,6 | 2,7-3,1 GB | 256K | Máquinas de 4 GB |
| Gemma 4 E2B | 60,0 | 43,4 | 4,6-7,5 GB | 128K | Dispositivos de borda |
| Qwen3.5 0.8B | 29,7 / 42,3 | 11,9 | 1,2-1,3 GB | 256K | O menor utilizável |
As pontuações são informadas pelos próprios fabricantes na ficha de cada modelo ou na página do Ollama e usam configurações de avaliação diferentes; "a / b" significa modo sem raciocínio / com raciocínio. Trate-as como indicativas. Os tamanhos de download são as faixas listadas pelo Ollama e incluem o codificador de visão quando o modelo tem um.
LLMs locais pequenos por região
Brasil / LGPD (ANPD) e UE / GDPR: Para profissionais brasileiros que rodam IA em hardware limitado -- trabalho de campo, ambientes isolados da rede, notebooks corporativos mais antigos -- os modelos locais pequenos podem executar a inferência inteiramente no dispositivo, sem chamadas a APIs na nuvem, desde que o runtime e os aplicativos estejam com telemetria e sincronização desativadas. Rodar o Qwen3.5 4B ou o Phi-4 Mini em um notebook corporativo comum mantém todo o texto processado no próprio aparelho, o que apoia o princípio da necessidade (minimização de dados) da LGPD, fiscalizada pela ANPD, e objetivos semelhantes do artigo 5 do GDPR para quem atende clientes europeus; se uma implantação específica está em conformidade ainda depende de toda a sua configuração. As licenças são permissivas: o Phi-4 Mini é MIT, e o Gemma 4 e o Qwen3.5 são Apache 2.0. As opções de origem europeia nesse tamanho são limitadas; confira a linha atual da Mistral se a origem europeia for um requisito.
Japão (METI): Para tarefas em japonês na faixa dos modelos pequenos, o Qwen3.5 e o Gemma 4 E4B registram pontuações MMMLU em torno de 76 nas respectivas fichas. Em uma máquina limitada, experimente `ollama run qwen3.5:2b` ou `ollama run qwen3.5:4b` para resumo ou tradução em japonês. A vantagem de velocidade dos modelos pequenos importa para o uso empresarial em hardware de escritório padrão, embora a velocidade real dependa da sua CPU e da quantização.
China: O Qwen3.5 (Alibaba, Apache 2.0) é a escolha natural para implantar modelos pequenos em chinês. Para implantações de IoT e edge sob a Lei de Segurança de Dados da China (数据安全法), `ollama run qwen3.5:2b` roda em um dispositivo Linux com cerca de 4 GB de RAM e processa o texto no próprio dispositivo, sem chamadas a APIs externas; confirme separadamente as suas próprias obrigações de conformidade.
Quais são os erros comuns ao rodar LLMs locais pequenos?
- Deixar o modo de raciocínio ligado em tarefas simples: Os modelos Qwen3.5 raciocinam por padrão e gastam muitos tokens extras antes de responder. Para chat e extração na CPU, desative-o (`--think=false` no Ollama) e reserve-o para matemática e lógica.
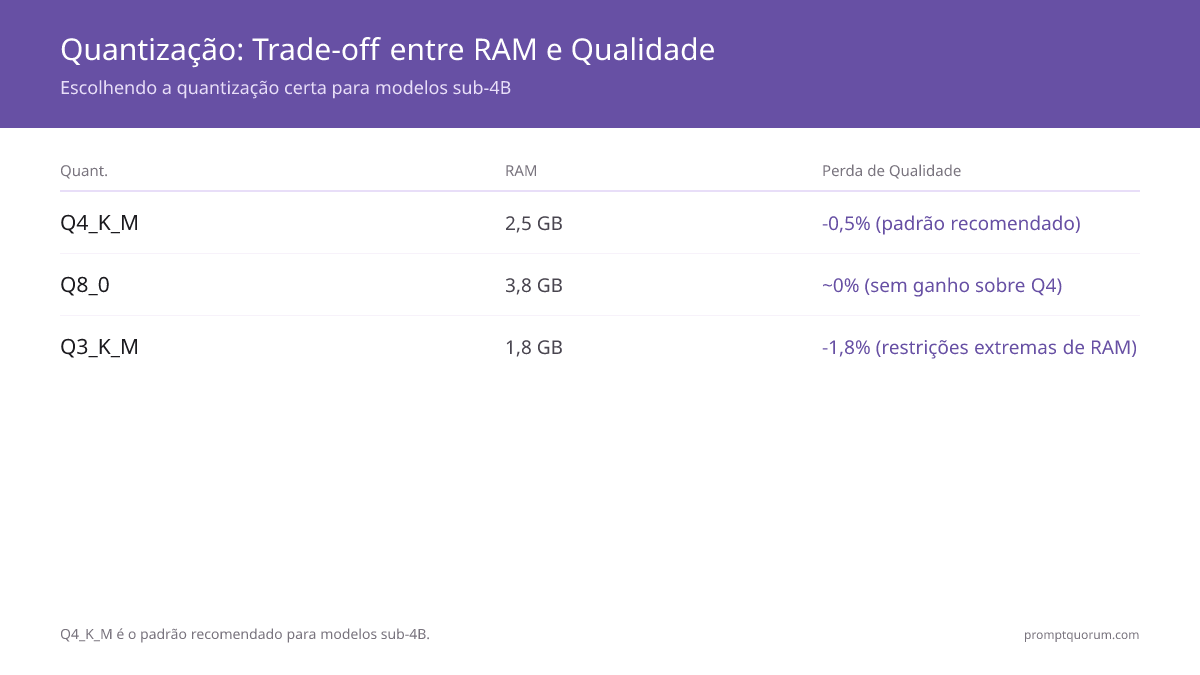
- Usar quantização Q8_0 em vez de Q4_K_M: O Q8_0 exige quase o dobro de RAM do Q4_K_M para uma melhora mínima de qualidade em pequena escala. Em uma máquina de 4 GB, o Q8_0 pode acionar o uso de swap e deixar a inferência várias vezes mais lenta. Use o Q4_K_M como padrão para modelos pequenos.
- Rodar um modelo base em vez da variante instruct: Os modelos base são checkpoints anteriores ao fine-tuning, que preveem o próximo token e não seguem instruções. Pergunte "Quanto é 2+2?" a um deles e ele pode continuar a frase como um quiz em vez de responder "4". Use as tags padrão mostradas nesta página, que são ajustadas para instruções.
- Julgar o Gemma 4 pelo nome "E2B/E4B": O rótulo de parâmetros efetivos subestima o download. O Gemma 4 E4B tem 6,6-9,5 GB no Ollama; confira o tamanho listado antes de baixá-lo em uma máquina de 8 GB.
- Esperar qualidade de modelo 7B ou maior de um modelo pequeno: Os modelos pequenos dão conta de tarefas curtas e bem definidas. Cadeias longas de raciocínio, redação longa e geração de código sofisticado são nitidamente mais fracas que nos modelos de 7-9B. Se a qualidade da saída for insuficiente, suba para o Qwen3.5 9B (6,6-7,6 GB no Ollama).
Entendendo a quantização: equilíbrio entre RAM e qualidade
Perguntas comuns sobre os modelos LLM locais pequenos
Qual é o melhor LLM pequeno para rodar localmente?
Para a maioria das pessoas com 8 GB de RAM ou mais, o melhor LLM local pequeno em 2026 é o Qwen3.5 4B (Apache 2.0, `ollama run qwen3.5:4b`): na própria ficha do modelo da Qwen, ele informa MMLU-Pro 79,1 e GPQA Diamond 76,2, à frente do Gemma 4 E4B (69,4 / 58,6) e do Phi-4 Mini (52,8 / 25,2). Em uma máquina de 4 GB, desça para o Qwen3.5 2B ou o Phi-4 Mini. São números informados pelos fabricantes, com configurações de avaliação diferentes, então trate as diferenças como indicativas, não exatas.
Qual é o melhor modelo de 4B?
O Qwen3.5 4B é o modelo mais forte da classe 4B nesta comparação, segundo os benchmarks de raciocínio informados pelo fabricante, e ainda tem janela de contexto de 256K e um download de cerca de 3,3-4,0 GB no Ollama. O Gemma 4 E4B (4,5B de parâmetros efetivos, cerca de 8B contando os embeddings) é o rival mais próximo e a melhor escolha se você quer o ecossistema do Google, mas o download no Ollama é de 6,6-9,5 GB. O Phi-4 Mini 3.8B é o mais leve, com 2,5 GB e licença MIT, mas fica atrás dos dois em benchmarks de raciocínio.
Qual é o menor LLM que você pode rodar localmente?
Entre os modelos que valem a pena rodar, o Qwen3.5 0.8B é o menor desta comparação -- um download de 1,2-1,3 GB no Ollama, com janela de contexto de 256K. Serve para classificação, extração de palavras-chave e reescritas curtas, mas o MMLU-Pro de 29,7 informado pelo fabricante (sem raciocínio) mostra que ele falha em qualquer tarefa de várias etapas. Existem modelos ainda menores, mas abaixo de cerca de 1B de parâmetros o texto deixa de se sustentar depois de poucas frases, então funcionam melhor como autocompletar do que como assistente.
Qual é o menor LLM local que produz resultados úteis?
Em torno de 2B de parâmetros é onde a saída se torna confiável para resumo, perguntas e respostas simples e reescrita. O Qwen3.5 2B (download de 2,7-3,1 GB) é o menor modelo aqui que usaríamos para trabalho de verdade; o Qwen3.5 0.8B é o piso em termos de hardware, não de qualidade. Se você puder dispor de 4 GB ou mais, um modelo de 4B é um grande salto em coerência por pouca memória adicional.
Um modelo pequeno pode rodar em um celular?
Sim. A Qwen descreve os modelos Qwen3.5 de 0.8B e 2B como feitos para dispositivos de borda, e o Google posiciona o Gemma 4 E2B e o E4B para celulares e notebooks. O Ollama e o LM Studio não rodam em iOS nem Android, então o mobile exige um aplicativo ou framework à parte, e a velocidade real depende muito do chip do celular e do runtime. Confira a lista de modelos do próprio aplicativo antes de baixar.
Os modelos pequenos são bons para resumo?
Sim -- o resumo é um dos casos de uso mais fortes deles. Todos os seis modelos aqui têm janela de contexto de 128K tokens ou mais, então o tamanho do documento raramente é o limite; o limite é o quanto o modelo segue instruções ao longo de uma entrada longa. O Qwen3.5 4B e o Gemma 4 E4B são os mais confiáveis; com modelos de 0.8B, mantenha as entradas curtas e as saídas simples.
Quanto mais rápido é um modelo 2B que um modelo 7B no mesmo hardware?
Bem mais rápido na CPU, embora o múltiplo dependa muito do hardware e da quantização -- os números do próprio Google para o Gemma 4 E2B mostram ~7,6 tok/seg de decodificação em um Raspberry Pi 5, enquanto relatos independentes em CPUs x86 variam de 8 a 48 tok/seg conforme o nível de quantização. Em uma GPU, a vantagem de velocidade diminui porque a vazão da GPU é menos limitada pelo tamanho do modelo. Consulte benchmarks atuais para o seu hardware em vez de presumir um múltiplo fixo.
Os modelos pequenos suportam chamadas de função?
Alguns sim. A ficha do modelo Qwen3.5 diz que a família se destaca em chamadas de ferramentas, e o Gemma 4 E4B informa 42,2% no Tau2 (avaliação agêntica) na ficha do Google (E2B: 24,5%), então o E4B é a escolha mais segura dos dois para uso de ferramentas. Consulte a documentação de cada modelo antes de criar um pipeline que dependa de saída estruturada, pois o suporte varia conforme a versão e o runtime.
Qual modelo pequeno é melhor para idiomas diferentes do inglês?
O Qwen3.5 4B e o Gemma 4 E4B estão praticamente empatados no benchmark multilíngue MMMLU (76,1 vs 76,6 nas respectivas fichas), e ambos estão claramente acima dos modelos da classe 2B. Para chinês, japonês, coreano ou árabe em uma máquina de 4 GB, o Qwen3.5 2B é a escolha prática. Consulte a comparação multilíngue Qwen vs Llama vs Mistral para uma comparação de idiomas mais ampla.
Devo usar o modo de raciocínio em um modelo pequeno?
Em geral, não para tarefas simples. Os modelos Qwen3.5 raciocinam por padrão, o que gasta muitos tokens extras antes de responder e parece lento na CPU. Para chat, reescrita e extração, desative o raciocínio (no Ollama: `ollama run qwen3.5:4b --think=false`); ative apenas para matemática, lógica ou problemas de várias etapas em que a precisão importa mais que a velocidade.
O Llama 3.2 ainda vale a pena?
Ele não está mais no ranking desta página. O Llama 3.2 1B e 3B (2024) são mais antigos que todos os modelos listados aqui, e os modelos mais novos de 2B-4B acima são mais capazes com tamanho semelhante. O Llama 3.2 continua útil se uma ferramenta ou um fine-tune do qual você depende foi construído em torno dele.
Quanta RAM um modelo de 4B precisa?
Conte com cerca de 4-5 GB livres para um modelo de 4B com quantização de 4 bits -- o Ollama lista o Qwen3.5 4B com 3,3-4,0 GB e o Phi-4 Mini com 2,5 GB -- mais espaço para a janela de contexto e o sistema operacional. Uma máquina de 8 GB é confortável; uma de 4 GB não é. O Gemma 4 E4B é a exceção: o download listado é de 6,6-9,5 GB, então ele pede uma máquina de 12-16 GB para uso confortável.
Posso rodar dois modelos pequenos simultaneamente?
Sim, se a RAM total permitir. Dois modelos da classe 2B com Q4_K_M usam cerca de 6 GB combinados -- viável em uma máquina de 8 GB com um sistema operacional leve. O Ollama pode manter vários modelos carregados conforme suas configurações e a memória disponível, ou você pode rodar duas instâncias do Ollama em portas diferentes (OLLAMA_HOST=:11434 e OLLAMA_HOST=:11435). Isso é útil para testes A/B de saídas.
Os modelos pequenos funcionam para RAG (geração aumentada por recuperação)?
Sim, para RAG simples. O Qwen3.5 4B e o Phi-4 Mini conseguem responder de forma confiável a perguntas sobre fragmentos de documentos recuperados. Para RAG sobre grandes bases de conhecimento que exigem raciocínio de múltiplos saltos, os modelos de 7B ou mais rendem de forma mais consistente. O recurso LocalDocs do GPT4All roda um modelo pequeno para perguntas e respostas sobre documentos e funciona bem para coleções pessoais de arquivos.
Fontes
- Fichas de modelo Qwen3.5-4B, -2B e -0.8B -- huggingface.co/Qwen/Qwen3.5-4B (benchmarks, licença, tamanho do contexto)
- Biblioteca Ollama: qwen3.5 -- ollama.com/library/qwen3.5 (tags, tamanhos de download, contexto)
- Ficha do modelo Google Gemma 4 -- huggingface.co/google/gemma-4-E4B-it (benchmarks do E2B e do E4B, licença)
- Biblioteca Ollama: gemma4 -- ollama.com/library/gemma4 (tags, tamanhos de download, tabela de benchmarks)
- Ficha do modelo Microsoft Phi-4-mini-instruct -- huggingface.co/microsoft/Phi-4-mini-instruct (MMLU, MMLU-Pro, GPQA, licença)
- Biblioteca Ollama: phi4-mini -- ollama.com/library/phi4-mini (tamanho do download, contexto)