"소형" 로컬 LLM이란 무엇이며 언제 사용해야 합니까?
소형 로컬 LLM은 일반적으로 약 40억 파라미터 이하의 모델입니다. 4비트 양자화에서 이 모델들의 다운로드 크기는 대략 1-4 GB이며(Gemma 4의 유효 파라미터 설계는 예외이며 아래에서 설명합니다), 전체 메모리가 4-8 GB인 보급형 노트북에서도 충분히 실행할 수 있습니다.
소형 모델은 요약, 간단한 Q&A, 코드 스니펫 설명, 짧은 번역, 문장 다듬기, 분류에 적합합니다. 길고 여러 단계로 이어지는 추론, 대규모 코드 생성, 일관성이 필요한 장문 작성에는 적합하지 않습니다.
4B 모델과 7-9B 모델 사이의 품질 격차는 여전히 존재합니다. 기기의 RAM이 8 GB 이상이고 여유가 있다면 Qwen3.5 9B(Ollama 6.6-7.6 GB) 같은 7-9B 모델이 대체로 더 나은 선택입니다. 7B 추천 모델은 입문자를 위한 최고의 로컬 LLM 모델을 참고하십시오.
어떤 소형 모델을 사용해야 합니까? 빠른 선택 가이드
- RAM 8 GB 이상, 최고 품질을 원하는 경우: Qwen3.5 4B(`ollama run qwen3.5:4b`).
- 이미지와 텍스트를 하나의 모델로 다루고 싶고 12 GB 이상인 경우: Gemma 4 E4B(`ollama pull gemma4:e4b`).
- RAM 4-6 GB, 영어 추론이나 코딩 지원이 필요한 경우: Phi-4 Mini 3.8B(`ollama run phi4-mini`).
- RAM 4 GB이거나 영어 이외의 텍스트를 다루는 경우: Qwen3.5 2B(`ollama run qwen3.5:2b`).
- 여유 RAM이 3 GB 미만이거나 Raspberry Pi급 기기인 경우: Qwen3.5 0.8B(`ollama run qwen3.5:0.8b`), 한계를 감안하고 사용하십시오.
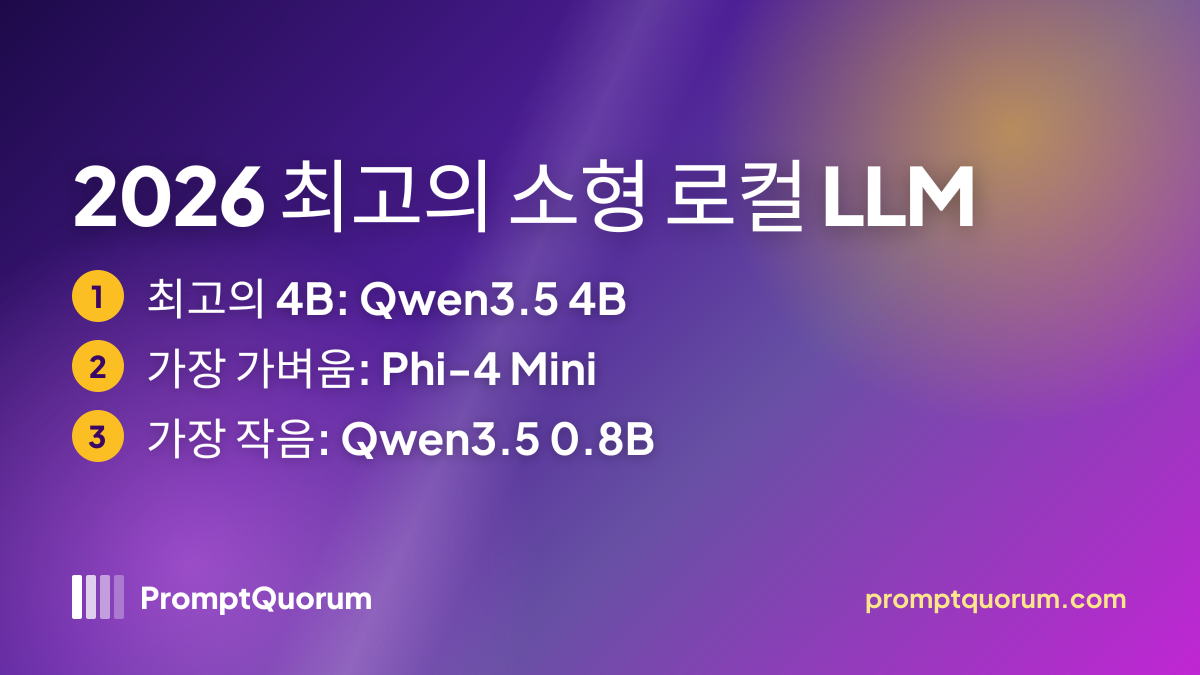
Qwen3.5 4B -- 전체 최고의 소형 LLM(최고의 4B 모델)
Qwen3.5 4B는 이 비교에서 가장 강력한 4B급 모델로, Qwen 자체 모델 카드 기준 MMLU-Pro 79.1, GPQA Diamond 76.2, LiveCodeBench v6 55.8을 기록했습니다. 2026년 초 Qwen3.5 Small 시리즈의 일부로 Apache 2.0 라이선스로 공개되었으며, 텍스트와 이미지를 입력받고 도구 호출을 지원하며 기본 컨텍스트 윈도우는 262,144 토큰입니다.
알아 둘 점이 두 가지 있습니다. 첫째, Qwen3.5 모델은 기본적으로 사고 모드로 동작하여 추론은 향상되지만 CPU에서는 느리므로, 간단한 작업에서는 사고를 끄십시오. 둘째, 모델 카드에는 대표 벤치마크가 어떤 모드로 측정되었는지 명시되어 있지 않고 Qwen의 평가 방식도 Google이나 Microsoft와 다르므로, 수치는 항목별 정확한 비교가 아니라 대략적인 방향성으로 비교하십시오.
항목 | 값 |
|---|---|
| MMLU-Pro | 79.1(벤더 보고) |
| GPQA Diamond | 76.2(벤더 보고) |
| LiveCodeBench v6 | 55.8(벤더 보고) |
| 다운로드(Ollama) | 3.3-4.0 GB |
| 컨텍스트 | 256K 토큰 |
| 라이선스 | Apache 2.0 |
| Ollama 명령어 | ollama run qwen3.5:4b |
Gemma 4 E4B -- 최고의 멀티모달 4B급 모델
Google Gemma 4 E4B는 Google 모델 카드 기준 MMLU Pro 69.4%, LiveCodeBench v6 52.0%, GPQA Diamond 58.6%를 기록했습니다. "E4B"는 유효 파라미터 4.5B를 의미하며, 레이어별 임베딩을 포함하면 모델은 약 8B 파라미터입니다. 이 때문에 "4B"라는 이름과 달리 Ollama 다운로드 크기가 6.6-9.5 GB입니다. 텍스트와 이미지를 입력받고, 128K 컨텍스트 윈도우를 갖추었으며, Apache 2.0 라이선스로 공개되어 있습니다.
Google 생태계, 강력한 다국어 성능(MMMLU 76.6%), 또는 Tau2 에이전트 점수 42.2%를 원한다면 Qwen3.5 4B 대신 E4B를 선택하십시오. 디스크와 메모리를 대략 절반만 쓰면서 같은 수준의 품질을 원한다면 Qwen3.5 4B를 선택하십시오.
항목 | 값 |
|---|---|
| MMLU Pro | 69.4% |
| LiveCodeBench v6 | 52.0% |
| GPQA Diamond | 58.6% |
| 다운로드(Ollama) | 6.6-9.5 GB |
| 컨텍스트 | 128K 토큰 |
| 라이선스 | Apache 2.0 |
| Ollama 명령어 | ollama pull gemma4:e4b |
Phi-4 Mini 3.8B -- 가장 가벼운 4B급 모델(2.5 GB)
Microsoft Phi-4 Mini는 모델 카드 기준 MMLU 67.3%, MMLU-Pro 52.8%를 기록하며, 다운로드 크기는 2.5 GB로 여기 소개한 4B급 모델 중 가장 작은 용량입니다. MIT 라이선스이고 128K 컨텍스트 윈도우를 갖추었으며, 추론에 초점을 맞춘 엄선된 합성 데이터로 학습되었습니다.
추론 벤치마크에서는 Qwen3.5 4B와 Gemma 4 E4B에 뒤처지므로(GPQA 25.2 대 76.2 및 58.6), 메모리가 제약인 4-6 GB 기기이거나 관대한 MIT 라이선스를 원할 때 선택하십시오.
항목 | 값 |
|---|---|
| MMLU (5-shot) | 67.3% |
| MMLU-Pro | 52.8% |
| GPQA Diamond | 25.2% |
| 다운로드(Ollama) | 2.5 GB |
| 컨텍스트 | 128K 토큰 |
| 라이선스 | MIT |
| Ollama 명령어 | ollama run phi4-mini |
Qwen3.5 2B -- 4 GB 기기에 최적
Qwen3.5 2B는 4B 모델이 들어가지 않을 때 가장 좋은 선택입니다. Qwen 모델 카드는 비사고 모드에서 MMLU-Pro 55.3, 사고 모드에서 66.5, 사고 모드 GPQA 51.6을 보고합니다. Ollama 다운로드 크기는 2.7-3.1 GB이고 이미지를 입력받으며 256K 컨텍스트 윈도우를 갖추었고 Apache 2.0 라이선스입니다.
0.8B 모델과 비교하면 지시 따르기에서 훨씬 안정적이며(IFEval 비사고 모드 61.2 대 52.1), 실제 요약과 Q&A 작업에 사용할 만하다고 판단하는 이 목록에서 가장 작은 모델입니다.
항목 | 값 |
|---|---|
| MMLU-Pro | 55.3% 비사고 / 66.5% 사고 |
| GPQA | 51.6%(사고) |
| 다운로드(Ollama) | 2.7-3.1 GB |
| 컨텍스트 | 256K 토큰 |
| 라이선스 | Apache 2.0 |
| Ollama 명령어 | ollama run qwen3.5:2b |
Gemma 4 E2B -- 엣지용 멀티모달 선택지
Google Gemma 4 E2B는 Google 모델 카드 기준 MMLU Pro 60.0%, LiveCodeBench v6 44.0%, GPQA Diamond 43.4%를 기록했습니다. 유효 파라미터는 2.3B(레이어별 임베딩 포함 시 5.1B)입니다. 유효 파라미터 수치가 2 GB 파일을 의미하는 것은 아닙니다. Ollama는 다운로드 크기를 4.6-7.5 GB로 표기하므로, 비슷한 급의 결과를 내는 Qwen3.5 2B보다 더 많은 메모리가 필요합니다.
128K 컨텍스트 윈도우를 갖추었고 이미지를 입력받으며 Apache 2.0 라이선스입니다. CPU 처리량은 하드웨어와 양자화에 따라 달라집니다(Google은 Raspberry Pi 5에서 디코딩 약 7.6 tok/sec를 보고하며, 독립적인 x86 측정 결과는 8-48 tok/sec 범위입니다). Google의 도구를 활용하고 싶은 엣지 디바이스에서 선택하고, 그렇지 않다면 Qwen3.5 2B가 더 가볍습니다.
항목 | 값 |
|---|---|
| MMLU Pro | 60.0% |
| LiveCodeBench v6 | 44.0% |
| GPQA Diamond | 43.4% |
| 다운로드(Ollama) | 4.6-7.5 GB |
| 컨텍스트 | 128K 토큰 |
| 라이선스 | Apache 2.0 |
| Ollama 명령어 | ollama pull gemma4:e2b |
Qwen3.5 0.8B -- 실행할 가치가 있는 가장 작은 모델
Qwen3.5 0.8B는 이 비교에서 가장 작은 모델로, Ollama 다운로드 크기 1.2-1.3 GB에 256K 컨텍스트 윈도우와 Apache 2.0 라이선스를 갖추고 있습니다. 벤더가 보고한 MMLU-Pro는 29.7(비사고)과 42.3(사고), GPQA는 11.9로, 분류, 키워드 추출, 짧은 문장 다듬기에는 충분하지만 여러 단계의 추론이나 긴 답변에는 적합하지 않습니다. RAM이 정말로 결정적 제약인 경우(사용 가능한 메모리 3 GB 미만), 싱글 보드 컴퓨터, 또는 파이프라인의 빠른 사전 필터로만 사용하십시오.
항목 | 값 |
|---|---|
| MMLU-Pro | 29.7% 비사고 / 42.3% 사고 |
| GPQA | 11.9%(사고) |
| 다운로드(Ollama) | 1.2-1.3 GB |
| 컨텍스트 | 256K 토큰 |
| Ollama 명령어 | ollama run qwen3.5:0.8b |
전체 비교: 최고의 소형 로컬 LLM(0.8B-4B급)
모델 | MMLU-Pro | GPQA Diamond | 다운로드(Ollama) | 컨텍스트 | 추천 용도 |
|---|---|---|---|---|---|
| Qwen3.5 4B | 79.1 | 76.2 | 3.3-4.0 GB | 256K | 전체 최고의 4B |
| Gemma 4 E4B | 69.4 | 58.6 | 6.6-9.5 GB | 128K | 멀티모달, Google 생태계 |
| Phi-4 Mini 3.8B | 52.8 | 25.2 | 2.5 GB | 128K | 가장 가벼운 4B급, MIT |
| Qwen3.5 2B | 55.3 / 66.5 | 51.6 | 2.7-3.1 GB | 256K | 4 GB 기기 |
| Gemma 4 E2B | 60.0 | 43.4 | 4.6-7.5 GB | 128K | 엣지 디바이스 |
| Qwen3.5 0.8B | 29.7 / 42.3 | 11.9 | 1.2-1.3 GB | 256K | 사용 가능한 최소 모델 |
점수는 각 모델의 자체 카드 또는 Ollama 페이지에서 벤더가 직접 보고한 값이며 평가 방식이 서로 다릅니다. "a / b"는 비사고 모드 / 사고 모드를 의미합니다. 대략적인 방향성으로 해석하십시오. 다운로드 크기는 Ollama에 표기된 범위이며, 비전 인코더가 있는 모델은 이를 포함합니다.
지역별 소형 로컬 LLM
EU / GDPR: 현장 작업, 에어갭 환경, 구형 기업 노트북처럼 제약된 하드웨어에서 AI를 실행하는 EU 전문가에게 런타임과 앱의 텔레메트리 및 동기화를 꺼 두었다면, 소형 로컬 모델은 클라우드 API 호출 없이 기기 안에서만 추론을 실행할 수 있습니다. 일반적인 업무용 노트북에서 Qwen3.5 4B나 Phi-4 Mini를 실행하면 처리되는 모든 텍스트가 기기 안에 머물러 GDPR 제5조의 데이터 최소화 목표에 부합하는 데 도움이 되지만, 개별 배포가 규정을 준수하는지는 전체 구성에 따라 달라집니다. 라이선스는 관대합니다. Phi-4 Mini는 MIT이고 Gemma 4와 Qwen3.5는 Apache 2.0입니다. 이 크기에서 EU 출신 선택지는 제한적이므로, EU 출신이 필수 요건이라면 Mistral의 현재 라인업을 확인하십시오.
일본 (METI): 소형 등급에서 일본어 작업의 경우 Qwen3.5와 Gemma 4 E4B 모두 모델 카드에서 MMMLU 약 76점을 기록합니다. 제약된 기기에서 일본어 요약이나 번역에는 `ollama run qwen3.5:2b` 또는 `ollama run qwen3.5:4b`를 사용해 보십시오. 소형 모델의 속도 이점은 표준 사무용 하드웨어를 쓰는 기업 환경에서 중요하지만, 실제 속도는 CPU와 양자화에 따라 달라집니다.
중국: Qwen3.5(Alibaba, Apache 2.0)는 중국어 소형 모델 배포에 자연스러운 선택입니다. 중국 데이터안전법(数据安全法) 하의 IoT 및 엣지 배포에서는 `ollama run qwen3.5:2b`가 RAM 약 4 GB의 Linux 기기에서 실행되며 외부 API 호출 없이 텍스트를 온디바이스로 처리합니다. 준수 의무는 별도로 직접 확인하십시오.
소형 로컬 LLM을 실행할 때 흔히 하는 실수는 무엇입니까?
- 간단한 작업에서 사고 모드를 켜 두는 것: Qwen3.5 모델은 기본적으로 사고 모드로 동작하여 답변 전에 많은 추가 토큰을 소모합니다. CPU에서의 대화와 정보 추출에는 사고를 끄고(Ollama에서 `--think=false`), 수학과 논리 문제에만 사용하십시오.
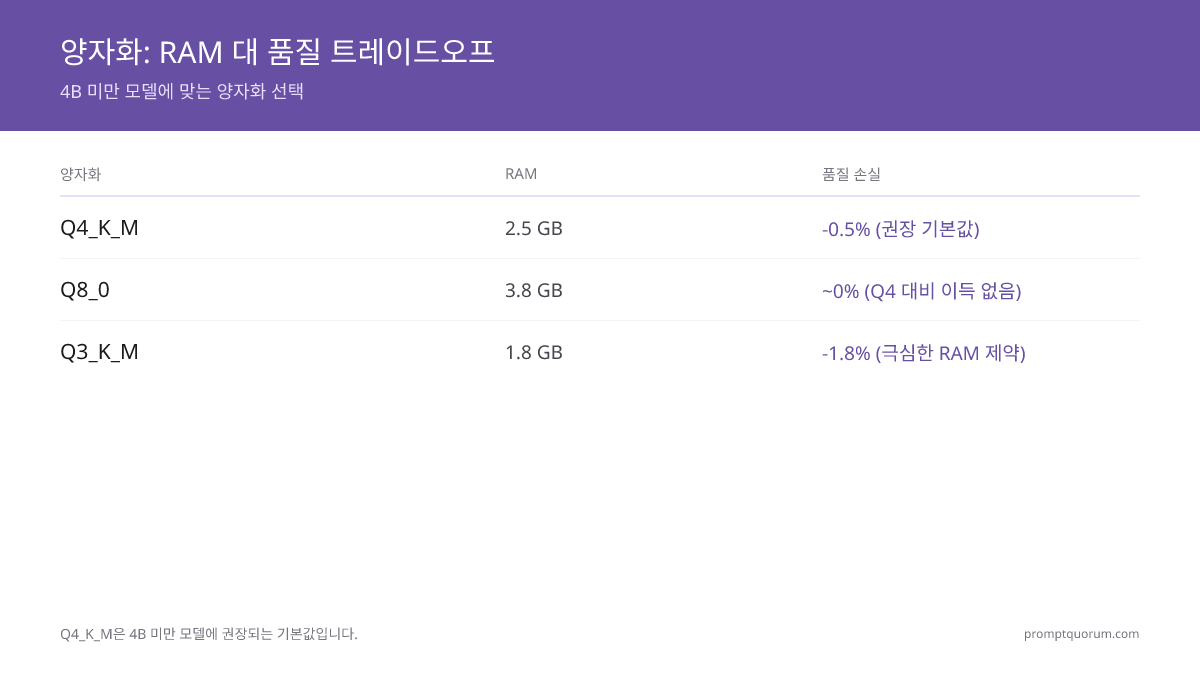
- Q4_K_M 대신 Q8_0 양자화를 사용하는 것: 소형 모델에서 Q8_0은 품질 향상이 미미한 데 비해 Q4_K_M의 거의 두 배에 가까운 RAM이 필요합니다. RAM 4 GB 기기에서는 Q8_0이 스왑을 일으켜 추론 속도가 몇 배 느려질 수 있습니다. 소형 모델에는 Q4_K_M을 기본값으로 사용하십시오.
- instruct 버전 대신 베이스 모델을 실행하는 것: 베이스 모델은 파인튜닝 이전의 체크포인트로, 다음 토큰을 예측할 뿐 지시를 따르지 않습니다. "2+2는 무엇입니까?"라고 물으면 "4"라고 답하는 대신 퀴즈처럼 문장을 이어 갈 수 있습니다. 이 페이지에 표시된 기본 태그는 지시 튜닝(instruction-tuned)된 버전이므로 그대로 사용하십시오.
- Gemma 4를 "E2B/E4B"라는 이름만 보고 판단하는 것: 유효 파라미터 표기는 다운로드 크기를 실제보다 작아 보이게 합니다. Gemma 4 E4B는 Ollama 기준 6.6-9.5 GB이므로, RAM 8 GB 기기에 받기 전에 표기된 크기를 확인하십시오.
- 소형 모델에 7B 이상의 품질을 기대하는 것: 소형 모델은 짧고 명확한 작업을 처리합니다. 긴 추론 과정, 장문 작성, 섬세한 코드 생성은 7-9B 모델보다 눈에 띄게 약합니다. 출력 품질이 부족하다면 Qwen3.5 9B(Ollama 6.6-7.6 GB)로 올리십시오.
양자화 이해: RAM과 품질의 트레이드오프
소형 로컬 LLM 모델에 관한 자주 묻는 질문
로컬에서 실행하기 가장 좋은 소형 LLM은 무엇입니까?
RAM 8 GB 이상인 대부분의 사용자에게 2026년 최고의 소형 로컬 LLM은 Qwen3.5 4B(Apache 2.0, `ollama run qwen3.5:4b`)입니다. Qwen 자체 모델 카드에는 MMLU-Pro 79.1, GPQA Diamond 76.2로 보고되어 있으며, 이는 Gemma 4 E4B(69.4 / 58.6)와 Phi-4 Mini(52.8 / 25.2)보다 높은 수치입니다. RAM 4 GB 기기에서는 Qwen3.5 2B 또는 Phi-4 Mini로 낮추십시오. 이 수치는 벤더가 직접 보고한 값이며 평가 방식이 서로 다르므로, 격차는 정확한 값이 아니라 대략적인 방향성으로 해석하십시오.
가장 좋은 4B 모델은 무엇입니까?
Qwen3.5 4B는 벤더가 보고한 추론 벤치마크 기준으로 이 비교에서 가장 강력한 4B급 모델이며, 256K 컨텍스트 윈도우와 Ollama 기준 약 3.3-4.0 GB의 다운로드 크기를 갖추고 있습니다. Gemma 4 E4B(유효 파라미터 4.5B, 임베딩 포함 시 약 8B)는 가장 가까운 경쟁 모델이며 Google 생태계를 원한다면 더 나은 선택이지만, Ollama 다운로드 크기는 6.6-9.5 GB입니다. Phi-4 Mini 3.8B는 2.5 GB로 가장 가볍고 MIT 라이선스이지만, 추론 벤치마크에서는 두 모델에 뒤처집니다.
로컬에서 실행할 수 있는 가장 작은 LLM은 무엇입니까?
실행할 가치가 있는 모델 중에서는 Qwen3.5 0.8B가 이 비교에서 가장 작습니다. Ollama 다운로드 크기는 1.2-1.3 GB이며 256K 컨텍스트 윈도우를 지원합니다. 분류, 키워드 추출, 짧은 문장 다듬기에는 충분하지만, 벤더가 보고한 MMLU-Pro 29.7(비사고 모드)이 보여 주듯 여러 단계가 필요한 작업에는 실패합니다. 더 작은 모델도 있으나 대략 1B 파라미터 미만에서는 몇 문장만 지나도 글의 일관성이 무너지므로, 어시스턴트보다는 자동 완성 용도에 더 적합합니다.
유용한 출력을 내는 가장 작은 로컬 LLM은 무엇입니까?
요약, 간단한 Q&A, 문장 다듬기에서 출력이 안정적으로 쓸 만해지는 지점은 대략 2B 파라미터입니다. Qwen3.5 2B(다운로드 2.7-3.1 GB)는 이 목록에서 실제 업무에 사용할 만하다고 판단하는 가장 작은 모델이며, Qwen3.5 0.8B는 품질이 아니라 하드웨어 측면의 최저선입니다. 4 GB 이상의 여유가 있다면 4B 모델은 추가 메모리가 많지 않으면서도 일관성이 크게 향상됩니다.
소형 모델을 스마트폰에서 실행할 수 있습니까?
예. Qwen은 Qwen3.5의 0.8B와 2B 모델을 엣지 디바이스용으로 설계했다고 설명하며, Google은 Gemma 4 E2B와 E4B를 스마트폰과 노트북용으로 내세우고 있습니다. 다만 Ollama와 LM Studio는 iOS나 Android에서 실행되지 않으므로 모바일에서는 별도의 앱이나 프레임워크가 필요하며, 실제 속도는 스마트폰 칩과 런타임에 따라 크게 달라집니다. 다운로드하기 전에 해당 앱의 모델 목록을 먼저 확인하십시오.
소형 모델은 요약에 적합합니까?
예. 요약은 소형 모델이 가장 잘하는 용도 중 하나입니다. 여기 소개한 6개 모델은 모두 128K 토큰 이상의 컨텍스트 윈도우를 갖추고 있어 문서 길이는 좀처럼 한계가 되지 않으며, 한계가 되는 것은 긴 입력 전반에서 모델이 지시를 얼마나 잘 따르는가입니다. Qwen3.5 4B와 Gemma 4 E4B가 가장 믿을 만하며, 0.8B 모델에서는 입력을 짧게, 출력을 단순하게 유지하십시오.
동일한 하드웨어에서 2B 모델은 7B 모델보다 얼마나 빠릅니까?
CPU에서는 눈에 띄게 빠르지만, 그 배율은 하드웨어와 양자화에 따라 크게 달라집니다. Google이 직접 밝힌 수치로 Gemma 4 E2B는 Raspberry Pi 5에서 디코딩 약 7.6 tok/sec이며, 독립적인 x86 CPU 측정 결과는 양자화 수준에 따라 8-48 tok/sec 범위입니다. GPU에서는 처리량이 모델 크기의 제약을 덜 받기 때문에 속도 이점이 줄어듭니다. 고정된 배율을 가정하지 말고 사용 중인 하드웨어에 맞는 최신 벤치마크를 확인하십시오.
소형 모델은 함수 호출(function calling)을 지원합니까?
일부는 지원합니다. Qwen3.5의 Qwen 모델 카드는 이 계열이 도구 호출에 뛰어나다고 밝히고 있으며, Gemma 4 E4B는 Google 카드에서 Tau2 에이전트 점수 42.2%(E2B: 24.5%)를 보고하므로 두 모델 중 도구 사용에는 E4B가 더 안전한 선택입니다. 지원 여부는 버전과 런타임에 따라 다르므로, 구조화된 출력에 의존하는 파이프라인을 구축하기 전에 각 모델의 문서를 확인하십시오.
영어 이외의 언어에는 어떤 소형 모델이 가장 좋습니까?
Qwen3.5 4B와 Gemma 4 E4B는 다국어 MMMLU 벤치마크에서 사실상 비슷하며(모델 카드 기준 76.1 대 76.6), 두 모델 모두 2B급 모델보다 한 단계 위입니다. RAM 4 GB 기기에서 중국어, 일본어, 한국어, 아랍어를 다룬다면 Qwen3.5 2B가 현실적인 선택입니다. 더 폭넓은 언어 비교는 Qwen vs Llama vs Mistral 다국어 비교를 참고하십시오.
소형 모델에서 사고(thinking) 모드를 사용해야 합니까?
간단한 작업에서는 대체로 사용하지 않는 편이 좋습니다. Qwen3.5 모델은 기본적으로 사고 모드로 동작하여 답변 전에 많은 추가 토큰을 소모하므로 CPU에서는 느리게 느껴집니다. 대화, 문장 다듬기, 정보 추출에는 사고를 끄고(Ollama에서: `ollama run qwen3.5:4b --think=false`), 속도보다 정확도가 중요한 수학, 논리, 다단계 문제에서만 켜십시오.
Llama 3.2는 아직도 사용할 가치가 있습니까?
이 페이지에서는 더 이상 순위에 포함하지 않습니다. Llama 3.2 1B와 3B(2024년)는 이 페이지의 모든 모델보다 오래되었으며, 위의 최신 2B-4B 모델이 비슷한 크기에서 더 뛰어납니다. 다만 사용 중인 도구나 파인튜닝 모델이 Llama 3.2를 기반으로 만들어졌다면 여전히 유용합니다.
4B 모델에는 RAM이 얼마나 필요합니까?
4비트 양자화의 4B 모델에는 여유 RAM 약 4-5 GB를 계획하십시오. Ollama는 Qwen3.5 4B를 3.3-4.0 GB, Phi-4 Mini를 2.5 GB로 표기하며, 여기에 컨텍스트 윈도우와 운영체제가 쓸 공간이 더 필요합니다. RAM 8 GB 기기라면 여유가 있고 4 GB는 부족합니다. Gemma 4 E4B는 예외로, 표기된 다운로드 크기가 6.6-9.5 GB이므로 편하게 쓰려면 12-16 GB 기기가 필요합니다.
소형 모델 두 개를 동시에 실행할 수 있습니까?
전체 RAM이 허용한다면 가능합니다. Q4_K_M의 2B급 모델 두 개는 합쳐서 대략 6 GB를 사용하므로, 운영체제 부담이 적은 RAM 8 GB 기기에서 실행할 수 있습니다. Ollama는 설정과 사용 가능한 메모리에 따라 여러 모델을 동시에 로드해 둘 수 있으며, 서로 다른 포트(OLLAMA_HOST=:11434와 OLLAMA_HOST=:11435)로 Ollama 인스턴스를 두 개 실행할 수도 있습니다. 출력을 A/B 테스트할 때 유용합니다.
소형 모델은 RAG(검색 증강 생성)에 사용할 수 있습니까?
간단한 RAG라면 가능합니다. Qwen3.5 4B와 Phi-4 Mini는 검색된 문서 조각을 바탕으로 한 질문에 안정적으로 답할 수 있습니다. 다단계 추론이 필요한 대규모 지식 베이스에 대한 RAG에는 7B 이상의 모델이 더 일관되게 동작합니다. GPT4All의 LocalDocs 기능은 소형 모델로 문서 Q&A를 수행하며 개인 문서 모음에 잘 맞습니다.
출처
- Qwen3.5-4B, -2B, -0.8B 모델 카드 -- huggingface.co/Qwen/Qwen3.5-4B (벤치마크, 라이선스, 컨텍스트 길이)
- Ollama 라이브러리: qwen3.5 -- ollama.com/library/qwen3.5 (태그, 다운로드 크기, 컨텍스트)
- Google Gemma 4 모델 카드 -- huggingface.co/google/gemma-4-E4B-it (E2B 및 E4B 벤치마크, 라이선스)
- Ollama 라이브러리: gemma4 -- ollama.com/library/gemma4 (태그, 다운로드 크기, 벤치마크 표)
- Microsoft Phi-4-mini-instruct 모델 카드 -- huggingface.co/microsoft/Phi-4-mini-instruct (MMLU, MMLU-Pro, GPQA, 라이선스)
- Ollama 라이브러리: phi4-mini -- ollama.com/library/phi4-mini (다운로드 크기, 컨텍스트)