Key Takeaways
- ✅ Largura de banda por chip: M5 153,6 GB/s · M5 Pro 307 GB/s · M5 Max 460 GB/s (GPU de 32 núcleos) ou 614 GB/s (GPU de 40 núcleos) · M5 Ultra até 1,2 TB/s. A velocidade de geração é aproximadamente largura de banda ÷ tamanho do modelo × 60–80 % — veja as seções de largura de banda abaixo.
- ✅ ENVIADO DESDE 22 DE SETEMBRO DE 2026: Mac mini M5 Pro a partir de US$1.699 (até 64 GB, 307 GB/s) — o Mac com M5 Pro mais barato já oferecido, abaixo do MacBook Pro.
- ✅ O Mac Studio M5 Max a partir de US$2.499 (até 128 GB, 614 GB/s) e o Mac Studio M5 Ultra a partir de US$5.499 (até 512 GB, até 1,2 TB/s) já são enviados. A configuração de 512 GB do M5 Ultra chega no fim de outubro de 2026 e deve custar bem acima de US$10.000.
- O Mac Studio não oferece mais o nível M5 Pro: começa no M5 Max. O Mac mini passou a ser a porta de entrada do chip M5 Pro.
- O MacBook Pro 16" M5 Max (disponível desde março de 2026) tem a mesma largura de banda do Mac Studio M5 Max em cada nível de GPU: 460 GB/s (GPU de 32 núcleos) e 614 GB/s (GPU de 40 núcleos), sem penalidade pelo formato.
- Todas as configurações M5 Pro/Max: 307–614 GB/s de largura de banda (RTX 4090 com 1.008 GB/s, mas limitada a 24 GB de VRAM). O M5 Ultra chega a até 1,2 TB/s.
- Operação silenciosa: as ventoinhas do MacBook Pro ficam audíveis sob inferência sustentada; as do Mac Studio e do Mac mini raramente aceleram em cargas típicas de LLM local.
- O MLX costuma ser o mecanismo mais rápido no Apple Silicon. O Ollama adicionou um backend MLX em março de 2026 (prévia, Ollama 0.19, inicialmente para modelos selecionados em Macs com mais de 32 GB); os demais modelos continuam usando o backend Metal do llama.cpp.
- Memória unificada: de 24 GB (Mac mini M5 Pro, base) a 512 GB (Mac Studio M5 Ultra) disponíveis para qualquer modelo. Sem um teto de VRAM separado como nas GPUs dedicadas.
O M5 Pro oferece 307 GB/s, o M5 Max 460–614 GB/s e o M5 Ultra até 1,2 TB/s de largura de banda de memória, e esse número — não a contagem de núcleos — define quantos tokens por segundo um Mac gera; o Mac mini M5 Pro começa em US$1.699, o Mac Studio M5 Max em US$2.499 e o Mac Studio M5 Ultra em US$5.499.
Os Macs com Apple Silicon usam memória unificada: CPU, GPU e mecanismo de IA compartilham o mesmo pool de memória rápida. Assim, um M5 Max de 128 GB carrega um modelo 70B inteiro que nenhuma GPU NVIDIA de consumo (24–32 GB de VRAM) comporta, e a opção de 512 GB do M5 Ultra vai ainda mais longe.
🔄 Atualização de 11 de outubro de 2026: a data de envio de 22 de setembro de 2026 já passou, então o Mac mini M5 Pro, o Mac Studio M5 Max e o Mac Studio M5 Ultra (96–256 GB) estão disponíveis; só a configuração de 512 GB do M5 Ultra segue pendente (fim de outubro de 2026). Esta atualização adiciona seções sobre largura de banda de memória, substitui faixas de tokens por segundo que ultrapassavam o teto de largura de banda de cada chip e inclui as primeiras medições independentes do M5 Ultra, da análise da MacStories. Os valores de tokens/s do Mac mini M5 Pro e do Mac Studio M5 Max continuam sendo estimativas derivadas da largura de banda e de resultados do MacBook Pro, não medições nesses equipamentos.
Por que o Apple Silicon M5 importa para LLM local
O Apple Silicon representa uma arquitetura radicalmente diferente para cargas de IA. Veja por que isso importa para quem usa LLMs locais.
- Arquitetura de memória unificada: M5 Pro e M5 Max compartilham um único pool de memória rápida (de 24 a 128 GB) acessado ao mesmo tempo por CPU, GPU e Neural Engine. Sem gargalo entre VRAM e RAM. Os modelos ficam em memória rápida e a inferência continua ágil.
- A largura de banda de memória é o verdadeiro gargalo: a geração de um LLM é limitada pela memória, não pelo cálculo: cada token gerado lê os pesos do modelo uma vez. O M5 Max, com 460–614 GB/s, fica atrás dos 1.008 GB/s da RTX 4090 em modelos pequenos, mas comporta até 128 GB contra 24 GB e roda modelos que uma 4090 não consegue carregar. O M5 Ultra supera a 4090 com até 1,2 TB/s e comporta até 512 GB.
- A «VRAM» de um Mac é memória unificada: não existe um pool de VRAM separado. A GPU usa a mesma memória do macOS e, por padrão, o macOS deixa a GPU reservar cerca de dois terços a três quartos da RAM total (a proporção varia com o tamanho da RAM). Em um Mac de 64 GB, conte com uns 48 GB para modelo mais contexto; o limite pode ser elevado com `sudo sysctl iogpu.wired_limit_mb=<MB>` (volta ao padrão ao reiniciar).
- Arquitetura Apple Fusion (novidade do M5): M5 Pro e M5 Max separam CPU e GPU em dois dies de 3 nm distintos em um único pacote, permitindo escalar e otimizar a térmica de forma independente e melhorando a eficiência energética em relação a chips monolíticos.
- Neural Accelerator em cada núcleo de GPU: cada núcleo de GPU inclui um acelerador neural dedicado que complementa o Neural Engine compartilhado. Mecanismos que os aproveitam, como o MLX e o backend MLX do Ollama, processam prompts mais rápido em chips da família M5.
- Salto geracional em relação ao M4: a Apple afirma até 30 % mais desempenho de CPU multithread sobre M4 Pro e M4 Max. Para a geração de LLM, o que importa é a largura de banda: M5 Pro 307 GB/s contra 273 GB/s do M4 Pro (+12 %) e 614 GB/s contra 546 GB/s nos M5 Max e M4 Max topo de linha (+12 %). O processamento de prompts melhora mais, graças aos aceleradores neurais por núcleo.
- Thunderbolt 5 (M5 Pro/Max): M5 Pro e M5 Max têm Thunderbolt 5 com 80 Gbps de largura de banda base (o dobro do Thunderbolt 4), útil para armazenamento externo rápido e vários monitores.
- Wi-Fi 7 e Bluetooth 6 pelo chip Apple N1: os sistemas M5 incluem o novo chip sem fio N1 com Wi-Fi 7 e Bluetooth 6.0 de baixa latência, útil com clientes de inferência remota ou APIs de modelos na nuvem.
- O MLX amadurece rápido: o framework MLX da Apple oferece suporte a Llama 3.3, Qwen, Mistral e Gemma com kernels otimizados. O Ollama tem um backend MLX para Apple Silicon desde março de 2026 (prévia), a princípio limitado a modelos selecionados.
- A eficiência energética é real: estima-se que o M5 Max consuma cerca de 65–100 W sob inferência sustentada (uma estimativa, não um número da Apple; a Apple indica até 480 W de potência contínua máxima para o chassi do Mac Studio). Um mês de inferência contínua (720 horas) a 100 W dá cerca de 72 kWh, aproximadamente US$8–12 de eletricidade nos EUA. Uma RTX 4090 a 350 W custa cerca de US$40–60 no mesmo mês.
- Operação silenciosa: as ventoinhas do Mac Studio raramente ficam audíveis em cargas típicas de LLM; a MacStories não conseguiu ouvir a ventoinha do Mac Studio M5 Ultra no uso diário. As do MacBook Pro ficam audíveis sob inferência sustentada.
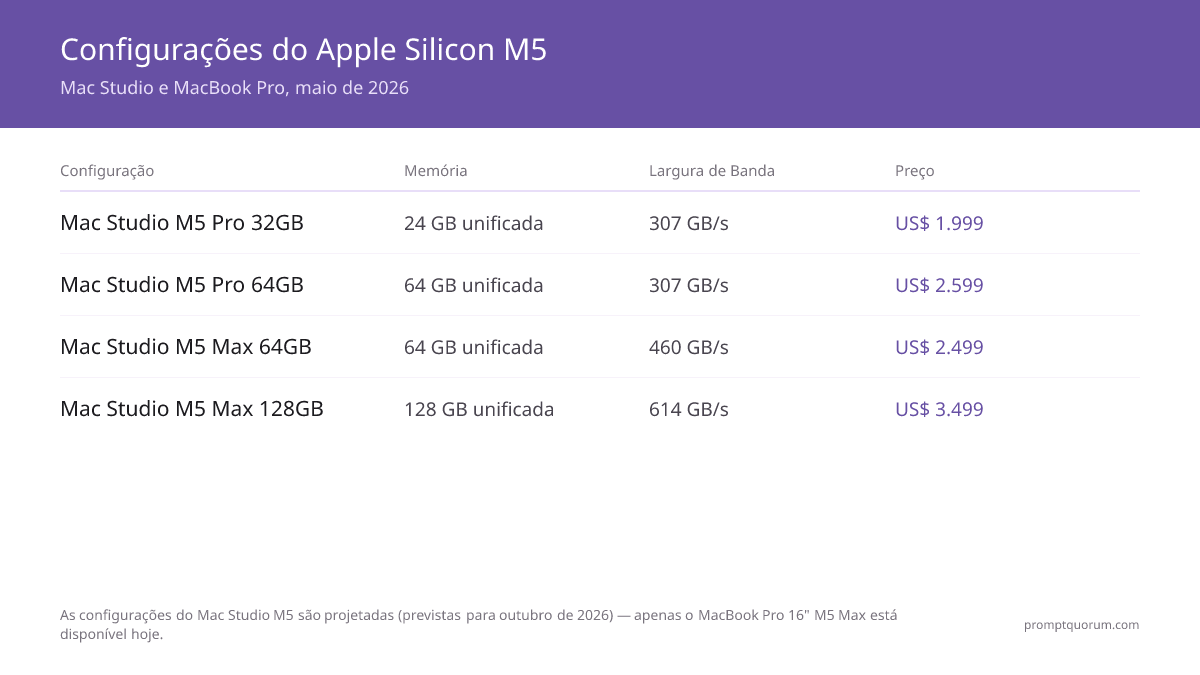
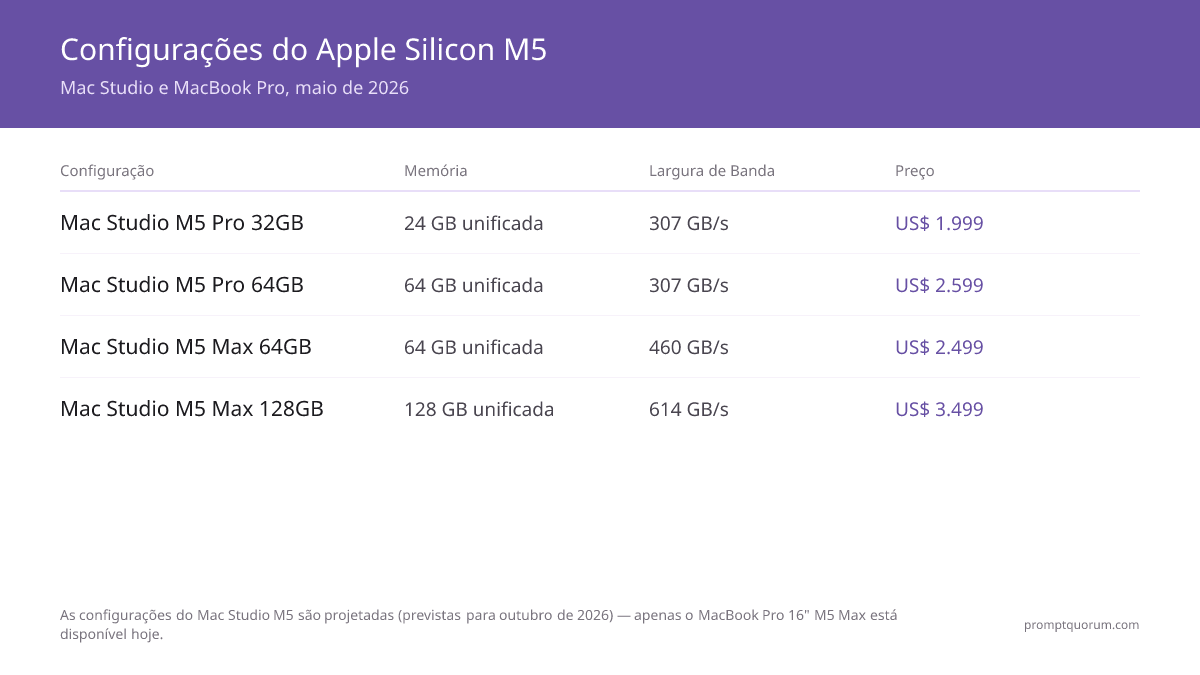
Tabela comparativa Apple Silicon M5
As configurações abaixo usam os preços da Apple do anúncio de 25 de agosto de 2026. Mac mini, Mac Studio e MacBook Pro são enviados desde 22 de setembro de 2026, exceto a configuração de 512 GB do Mac Studio M5 Ultra (fim de outubro de 2026, esperada bem acima de US$10.000). Preços: preços em USD da Apple Store. Até agora só o M5 Ultra tem medições independentes de tokens/s: veja a seção de desempenho para o que é medido e o que é estimado.
Configuração | Chip | Núcleos GPU | Memória | Largura de banda | Preço | Ideal para |
|---|---|---|---|---|---|---|
| Mac mini M5 Pro 24 GB | M5 Pro | 16 | 24GB unificada | 307 GB/s | US$1.699 | M5 Pro mais barato, 7B–14B |
| Mac mini M5 Pro 64 GB | M5 Pro | 20 | 64GB unificada | 307 GB/s | US$2.699 | Modelos 30B, 64 GB mais barato |
| Mac Studio M5 Max 36 GB | M5 Max | 32 | 36GB unificada | 460 GB/s | US$2.499 | Entrada econômica de mesa |
| Mac Studio M5 Max 64 GB | M5 Max | 40 | 64GB unificada | 614 GB/s | US$3.499 | 70B Q4, melhor custo-benefício |
| Mac Studio M5 Max 128 GB | M5 Max | 40 | 128GB unificada | 614 GB/s | US$5.099 | 70B Q5, usuários avançados |
| Mac Studio M5 Ultra 96 GB | M5 Ultra | 64 | 96GB unificada | Até 1,2 TB/s | US$5.499 | Maiores modelos locais |
| Mac Studio M5 Ultra 512 GB | M5 Ultra | 80 | 512GB unificada | Até 1,2 TB/s | USUS$10.000+ (est.) | Modelos gigantes, envio fim de out. |
| MacBook Pro 16" M5 Max 64 GB | M5 Max | 32 | 64GB unificada | 460 GB/s | US$3.499 | Portátil, 70B Q4 |
| MacBook Pro 16" M5 Max 128 GB | M5 Max | 40 | 128GB unificada | 614 GB/s | US$4.499 | Portátil, 70B Q5 |
Largura de banda de memória do M5, M5 Pro, M5 Max e M5 Ultra comparada
A largura de banda de memória é a especificação que decide a velocidade de geração de LLMs locais no Apple Silicon e o número que a maioria dos compradores procura. A tabela traz o valor oficial de cada chip; o M5 Max tem dois níveis: 460 GB/s com a GPU de 32 núcleos e 614 GB/s com a de 40 núcleos. Os valores são máximos teóricos.
A largura de banda de memória do Apple M5 é de 153,6 GB/s (M5), 307 GB/s (M5 Pro), 460 GB/s (M5 Max com GPU de 32 núcleos), 614 GB/s (M5 Max com GPU de 40 núcleos) e até 1,2 TB/s (M5 Ultra).
A largura de banda é a rapidez com que o chip lê o modelo da memória. Gerar um token lê (quase) o modelo inteiro uma vez, então um Mac nunca gera mais rápido do que sua largura de banda dividida pelo tamanho do modelo.
- M5 Pro vs M5 Max: o M5 Max tem 1,5× (GPU de 32 núcleos, 460 GB/s) ou 2× (GPU de 40 núcleos, 614 GB/s) a largura de banda do M5 Pro; espere uma geração na mesma proporção mais rápida com o mesmo modelo.
- M5 Max vs M5 Ultra: o M5 Ultra une dois chips M5 Max e dobra os 614 GB/s do M5 Max de 40 núcleos para cerca de 1,2 TB/s — 50 % a mais que os 819 GB/s do M3 Ultra da geração anterior.
- Capacidade vs largura de banda: mais memória não deixa um chip mais rápido. Um M5 Max com GPU de 40 núcleos tem os mesmos 614 GB/s com 64 GB ou 128 GB; a memória extra só permite carregar modelos maiores ou mais modelos.
Chip | Núcleos GPU | Memória máx. | Largura de banda | Presente em |
|---|---|---|---|---|
| M5 | 8–10 | 32GB | 153,6 GB/s | MacBook Air, MacBook Pro 14" |
| M5 Pro | 16–20 | 64GB | 307 GB/s | MacBook Pro, Mac mini |
| M5 Max (GPU 32 núcleos) | 32 | 36GB+ | 460 GB/s | MacBook Pro, Mac Studio |
| M5 Max (GPU 40 núcleos) | 40 | 128GB | 614 GB/s | MacBook Pro, Mac Studio |
| M5 Ultra | 64–80 | 512GB | 1,2 TB/s (1,228,8 GB/s) | Mac Studio |
| M4 Max (referência) | 40 | 128GB | 546 GB/s | Geração anterior |
| RTX 4090 (referência) | n/d | 24GB VRAM | 1,008 GB/s | GPU dedicada |
Como a largura de banda vira tokens por segundo
A tabela abaixo é aritmética, não benchmark: teto de tokens/s = largura de banda ÷ tamanho do arquivo do modelo. Na prática a geração fica abaixo, por causa de leituras do cache KV, sobrecarga do mecanismo e térmica. Modelos Mixture-of-Experts leem só seus especialistas ativos por token e por isso podem ser mais rápidos que um modelo denso do mesmo tamanho de arquivo.
O limite superior da velocidade de geração é a largura de banda de memória dividida pelo tamanho do arquivo do modelo — por exemplo, 614 GB/s ÷ 42,5 GB (Llama 3.3 70B Q4) ≈ 14 tokens/s — e mecanismos bem otimizados costumam atingir 60–80 % disso.
Escolha o chip pelo maior modelo que pretende rodar e depois consulte esta tabela de tetos: se o teto for menor que 10 tokens/s, o modelo parecerá lento por mais núcleos de GPU que você compre.
- Como ler a tabela: os valores são tetos teóricos em tokens/s. Multiplique por 0,6–0,8 para uma faixa realista — para Llama 3.3 70B Q4 em um M5 Max de 614 GB/s, isso dá cerca de 9–12 tokens/s.
- Verificação independente: a MacStories mediu 48 tokens/s gerando com Qwen3.8 27B em um Mac Studio M5 Ultra (prompt de 6.091 tokens), contra 59 tokens/s em uma RTX 5090 (1,79 TB/s de largura de banda). A velocidade real acompanhou a largura de banda, não a contagem de núcleos.
- Regra de dimensionamento: o arquivo do modelo mais o cache KV precisam caber em cerca de dois terços a três quartos da memória unificada; um modelo 70B Q4 (~42,5 GB) pede um Mac de 64 GB, e as variantes Q5 e Q8 pedem 128 GB.
Modelo (Q4_K_M) | Tamanho arquivo | M5 Pro 307 | M5 Max 460 | M5 Max 614 | M5 Ultra 1,2 TB/s |
|---|---|---|---|---|---|
| Llama 3,1 8B | ~4,9GB | ~63 | ~94 | ~125 | ~250 |
| Mistral Small 24B | ~14GB | ~22 | ~33 | ~44 | ~88 |
| Qwen3 32B | ~20GB | ~15 | ~23 | ~31 | ~61 |
| Llama 3,3 70B | ~42,5GB | ~7 | ~11 | ~14 | ~29 |
Mac mini M5 Pro: nova entrada econômica para LLM local
Em 25 de agosto de 2026, a Apple colocou pela primeira vez um chip M5 Pro no Mac mini; antes, o M5 Pro só existia no MacBook Pro. Com US$1.699–2.699 e 24–64 GB de memória unificada, o Mac mini M5 Pro é o jeito mais barato de chegar ao teto de 64 GB do M5 Pro e custa menos que o MacBook Pro M5 Pro. O Mac Studio agora começa no M5 Max. Disponível desde 22 de setembro de 2026.
- CPU: M5 Pro de 15 ou 18 núcleos
- GPU: GPU M5 Pro de 16 ou 20 núcleos
- Memória: 24 GB de base, configurável para 48 ou 64 GB de memória unificada LPDDR5X
- Largura de banda de memória: 307 GB/s (idêntica à do M5 Pro no MacBook Pro)
- Armazenamento: SSD de 512 GB–2 TB (configurável)
- Portas: Thunderbolt 5 (novo no Mac mini)
- Conectividade: Wi-Fi 7, Bluetooth 6
- Preço: US$1.699 (CPU de 15 núcleos/GPU de 16 núcleos, 24 GB); US$2.699 (CPU de 18 núcleos/GPU de 20 núcleos, 64 GB)
- Disponibilidade: enviado desde 22 de setembro de 2026
Mac Studio M5 Max 36 GB: configuração básica
O Mac Studio M5 Max básico começa em US$2.499 com GPU de 32 núcleos e 36 GB de memória unificada; opções com mais memória vêm com o nível de GPU de 40 núcleos descrito abaixo. Enviado desde 22 de setembro de 2026. O Mac Studio não oferece mais nenhum nível M5 Pro: este é agora o Mac Studio mais barato.
- CPU: M5 Max de 18 núcleos
- GPU: GPU M5 Max de 32 núcleos
- Memória: 36 GB de memória unificada LPDDR5X neste nível de GPU
- Largura de banda de memória: 460 GB/s (idêntica à do M5 Max de 32 núcleos no MacBook Pro)
- Armazenamento: SSD de 512 GB–8 TB (configurável)
- Portas: Thunderbolt 5
- Consumo: estimado em 65–100 W sob inferência sustentada; ventoinhas raramente giram
- Preço: US$2.499
- Disponibilidade: enviado desde 22 de setembro de 2026
Mac Studio M5 Max 48–128 GB: melhor custo-benefício para LLM local 70B
O Mac Studio M5 Max com GPU de 40 núcleos começa em US$3.099 (48 GB) e pode ser configurado até 128 GB por US$5.099. É o nível que cumpre o posicionamento de «melhor custo-benefício para 70B»: 64 GB custam US$3.499 com os 614 GB/s completos. Enviado desde 22 de setembro de 2026.
- CPU: M5 Max de 18 núcleos
- GPU: GPU M5 Max de 40 núcleos
- Memória: 48 GB de base, configurável para 64 ou 128 GB de memória unificada LPDDR5X
- Largura de banda de memória: 614 GB/s (idêntica à do M5 Max de 40 núcleos no MacBook Pro)
- Armazenamento: SSD de 512 GB–8 TB
- Portas: Thunderbolt 5
- Consumo: estimado em 65–100 W sob inferência sustentada; atividade moderada das ventoinhas com uso intenso de vários modelos
- Preço: US$3.099 (48 GB); US$3.499 (64 GB); US$5.099 (128 GB)
- Disponibilidade: enviado desde 22 de setembro de 2026
Mac Studio M5 Ultra: novo nível de desempenho máximo
O Mac Studio M5 Ultra é um novo nível de topo acima do M5 Max, a partir de US$5.499 com 96 GB e escalando até 512 GB. As configurações de 96–256 GB são enviadas desde 22 de setembro de 2026; a de 512 GB chega no fim de outubro de 2026 e deve custar bem acima de US$10.000. Ela iguala o teto de 512 GB do M3 Ultra da geração anterior com 50 % mais largura de banda.
- CPU: M5 Ultra de 30 núcleos (36 núcleos configurável)
- GPU: 64 núcleos na base, 80 núcleos configurável
- Memória: 96 GB de base, configurável para 256 GB agora e 512 GB no fim de outubro de 2026
- Largura de banda de memória: até 1,2 TB/s (1.228,8 GB/s; 50 % acima dos 819 GB/s do M3 Ultra)
- Armazenamento: SSD de 1–16 TB
- Portas: Thunderbolt 5
- Preço: US$5.499 (base de 96 GB: CPU de 30 núcleos/GPU de 64 núcleos); 512 GB esperado bem acima de US$10.000
- Disponibilidade: enviado desde 22 de setembro de 2026 (96–256 GB); fim de outubro de 2026 (512 GB)
MacBook Pro 16" M5 Max: LLM local portátil
O MacBook Pro 16" M5 Max (US$3.499–4.499) usa o mesmo silício M5 Max do Mac Studio em formato portátil. A largura de banda de memória coincide com a do Mac Studio em cada nível de GPU: 460 GB/s com a GPU de 32 núcleos e 614 GB/s com a de 40 núcleos. Note que o MacBook Pro de 64 GB usa a GPU de 32 núcleos, enquanto o Mac Studio de 64 GB usa a de 40 núcleos. A limitação térmica sob inferência sustentada é o preço da portabilidade.
- CPU: M5 Max de 18 núcleos (6 super + 12 de desempenho)
- GPU: GPU M5 Max de 32 ou 40 núcleos
- Memória: 64 GB ou 128 GB de memória unificada
- Tela: Liquid Retina XDR de 16,2 polegadas, 3456×2234
- Largura de banda de memória: 460 GB/s (64 GB, GPU de 32 núcleos) ou 614 GB/s (128 GB, GPU de 40 núcleos)
- Armazenamento: SSD de 512 GB–8 TB
- Bateria: informada em horas de reprodução de vídeo; a inferência sustentada a esgota muito mais rápido
- Peso: 2,14 kg
- Portas: 3× Thunderbolt 5, HDMI 2.1, leitor SD, saída de fone
- Preço: US$3.499 (64 GB, GPU de 32 núcleos) a US$4.499 (128 GB, GPU de 40 núcleos)
🏆 Nossas recomendações: qual Mac comprar para LLM local
Recomendações claras conforme o caso de uso.
- 🏆 💰 M5 PRO MAIS BARATO: Mac mini M5 Pro (US$1.699, disponível) • Por quê: primeiro Mac mini com M5 Pro. Fica abaixo de qualquer forma anterior de ter um M5 Pro, inclusive o MacBook Pro. A base de 24 GB atende 7B–14B; configurado com 64 GB, atende 30B. • Para quem: compradores do primeiro Apple Silicon atentos ao orçamento. • Comprar na Apple Store →
- 🥇 MELHOR CUSTO-BENEFÍCIO PARA 70B: Mac Studio M5 Max 64 GB (US$3.499, disponível) • Por quê: roda Llama 3.3 70B Q4 a cerca de 9–12 tokens/s estimados com os 614 GB/s completos. A refrigeração de desktop evita limitação térmica. • Para quem: desenvolvedores que padronizam um fluxo 70B sem necessidade de portabilidade. • Comprar na Apple Store →
- 🔥 POTÊNCIA MÁXIMA: Mac Studio M5 Ultra 96 GB (US$5.499, disponível) • Por quê: nível de topo. Até 1,2 TB/s de largura de banda — o dobro do M5 Max. A configuração de 512 GB chega no fim de outubro de 2026 para os maiores modelos locais. • Situação: já há as primeiras medições independentes (MacStories: 48 tokens/s com Qwen3.8 27B contra 59 em uma RTX 5090). • Comprar na Apple Store →
- 💼 MELHOR PORTÁTIL: MacBook Pro 16" M5 Max (US$3.499 com 64 GB e 460 GB/s; US$4.499 com 128 GB e 614 GB/s) • Por quê: o mesmo silício M5 Max do Mac Studio em um notebook com tela Liquid Retina XDR. Aceite 10–15 % menos de velocidade sustentada pela limitação térmica. • Alternativa: o Mac Studio M5 Max de 64 GB (US$3.499) custa o mesmo com 614 GB/s e melhor refrigeração sustentada se você não precisa de portabilidade. • Comprar na Apple Store →
Desempenho de LLMs locais: estimativas derivadas da largura de banda e resultados independentes do M5 Ultra
Até agora só o M5 Ultra tem medições independentes de terceiros (MacStories, ao final desta seção). Para M5 Pro e M5 Max, as faixas abaixo são estimativas: cada uma corresponde a 60–80 % do teto de largura de banda (largura de banda ÷ tamanho do arquivo do modelo), conferida com relatos da comunidade e resultados do MacBook Pro; não são medições de laboratório no chassi do Mac mini ou do Mac Studio. As faixas são rotuladas por largura de banda porque o MacBook Pro de 64 GB (460 GB/s) e o Mac Studio de 64 GB (614 GB/s) diferem. Espere ±10–15 % conforme a versão do macOS, do mecanismo, a quantização e o tamanho do contexto. Os valores de referência da RTX 4090 são aproximados, da comunidade.
- ## Llama 3.1 8B (Q4_K_M, ~4,9 GB) • M5 Pro (307 GB/s): 38–50 tokens/s • M5 Max (460 GB/s): 56–75 tokens/s • M5 Max (614 GB/s): 75–100 tokens/s • Referência (RTX 4090): 90–120 tokens/s
- ## Mistral Small 24B (Q4_K_M, ~14 GB) • M5 Pro (307 GB/s): 13–17 tokens/s • M5 Max (460 GB/s): 19–26 tokens/s • M5 Max (614 GB/s): 26–34 tokens/s
- ## Qwen3 32B (Q4_K_M, ~20 GB) • M5 Pro (307 GB/s): 9–12 tokens/s • M5 Max (460 GB/s): 14–19 tokens/s • M5 Max (614 GB/s): 19–25 tokens/s
- ## Llama 3.3 70B (Q4_K_M, ~42,5 GB) • M5 Pro 64 GB (307 GB/s): 4–6 tokens/s • M5 Max (460 GB/s): 6–9 tokens/s • M5 Max (614 GB/s): 9–12 tokens/s • M5 Ultra: teto de cerca de 29 tokens/s (ainda sem medição independente com 70B) • Referência (RTX 4090): 6–10 tokens/s com descarga parcial para a CPU
- ## Llama 3.3 70B (Q5_K_M, ~50 GB) • M5 Pro 64 GB: folga insuficiente • M5 Max 128 GB (614 GB/s): 7–10 tokens/s • Referência (RTX 4090): não é possível (limite de VRAM)
- ## Llama 3.3 70B (Q8_0, ~75 GB) • M5 Max 128 GB (614 GB/s): 5–7 tokens/s • RTX 4090: não é possível (exige descarga multi-GPU)
- ## Resultados independentes do M5 Ultra (MacStories, unidade de 256 GB, oMLX) • Qwen3.8 27B, prompt de 6.091 tokens: M5 Ultra 48 tokens/s de geração, 1.701 tokens/s de leitura de prompt, 4,0 s até o primeiro token — RTX 5090: 59 tokens/s, 3.031 tokens/s, 2,0 s • Qwen3.8 27B com contexto longo (geração): 38,9 tokens/s a 64K, 32,4 a 128K, 24,3 a 256K — RTX 5090: 49,6, 40,4, 30,0 • Flash-Next, prompt curto: 108 tokens/s no M5 Ultra contra 70 em um M3 Ultra (+54 %)
- ## Metodologia As faixas de M5 Pro e M5 Max são derivadas como 60–80 % de largura de banda ÷ tamanho do arquivo do modelo e comparadas com resultados da comunidade, como o teste MLX vs GGUF citado em nossa página de benchmarks M5 Pro vs M5 Max. Os números do M5 Ultra são medições próprias da MacStories com oMLX 0.7.0.dev2 no macOS 27.0; os nomes dos modelos são deles. Trate qualquer valor de tokens/s do M5 Ultra para modelos não listados acima como não verificado.
Apple Silicon M5 vs estação de trabalho PC para LLM local
Apple Silicon e NVIDIA têm filosofias diferentes. Veja a comparação honesta.
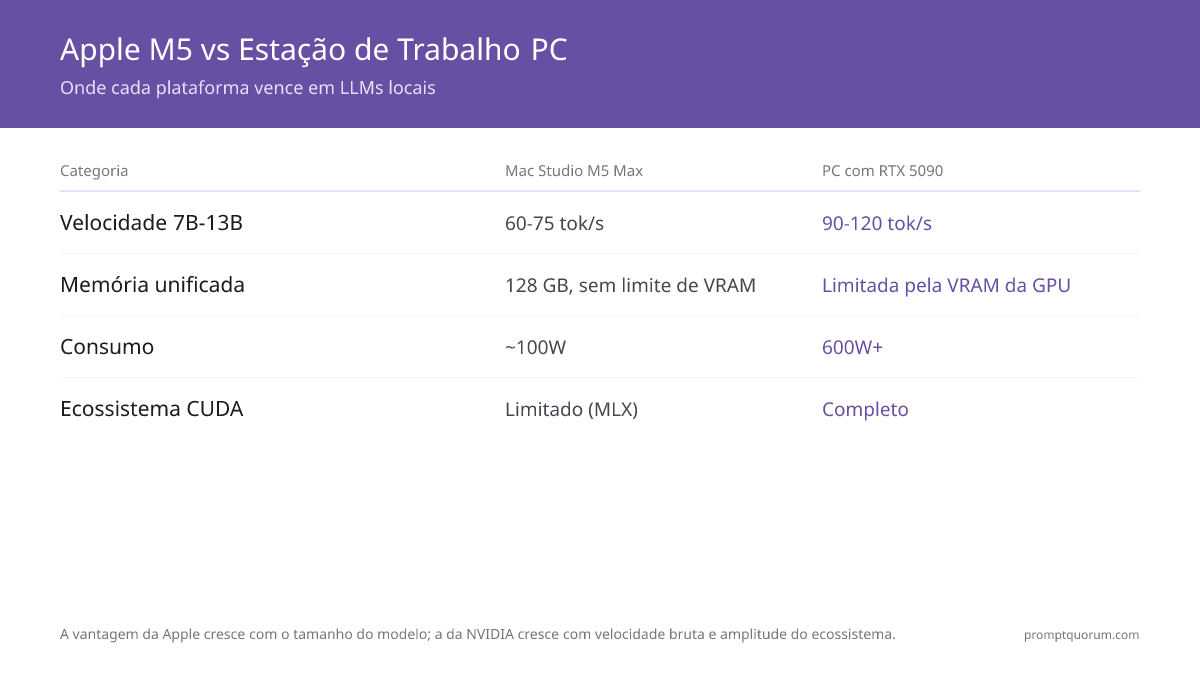
- ## Mac Studio M5 Max/Ultra vence em: • Memória unificada: até 128 GB (M5 Max) ou 512 GB (M5 Ultra) disponíveis para qualquer modelo, sem teto de VRAM • Eficiência energética: cerca de 100 W contra mais de 600 W em um PC equivalente • Operação silenciosa: ventoinhas raramente audíveis em cargas típicas • Ecossistema macOS: integração com MLX, Metal e Core ML • Custo total de propriedade: menos eletricidade em 3 anos • Modelos acima de 32 GB: uma RTX 5090 chega no máximo a 32 GB de VRAM
- ## A estação PC (RTX 4090/5090) vence em: • Velocidade bruta em modelos que cabem na VRAM: a MacStories mediu uma RTX 5090 a 59 tokens/s contra 48 no M5 Ultra com Qwen3.8 27B, e leitura de prompt cerca de 1,8× mais rápida (3.031 contra 1.701 tokens/s) • Amplitude do ecossistema CUDA: mais modelos, ferramentas e código de pesquisa • Fine-tuning: PyTorch + CUDA domina em relação ao MLX • Flexibilidade de upgrade: trocar a GPU, adicionar mais VRAM • Preço em níveis baixos: uma RTX 4070 Ti econômica (US$800–1.200) supera o M5 Pro em modelos pequenos • IA além de LLM: Stable Diffusion, treinamento e multimodal costumam ser mais rápidos em NVIDIA
- ## O veredito honesto Para inferência pura de LLM local com modelos de 30B–70B, o Mac Studio M5 Max de 128 GB (US$5.099) compete diretamente com PCs de mais de US$4.500, e o Mac Studio M5 Ultra eleva o teto para modelos que pedem 256 GB ou 512 GB. A vantagem da memória unificada é real e mensurável. Para modelos que cabem em 24–32 GB de VRAM, um PC com RTX 4090 ou 5090 é mais rápido que qualquer Mac. A vantagem da Apple diminui em modelos menores. Para fine-tuning, treinamento, Stable Diffusion em escala ou PyTorch em produção, PC + NVIDIA vence. O MLX está melhorando, mas ainda há lacunas.
MLX vs Ollama vs llama.cpp no Apple Silicon
Três mecanismos de inferência principais funcionam no M5. Qual é o ideal para você?
- ## MLX (nativo da Apple) • Desempenho: costuma dar os maiores tokens/s no M5; otimização Metal nativa e suporte aos Neural Accelerators. • Suporte a modelos: em crescimento (Llama, Qwen, Mistral, Gemma disponíveis) • Configuração: voltada a Python, exige familiaridade com a linha de comando • Ideal para: usuários avançados que querem o máximo desempenho • Contrapartida: menos amigável que o Ollama
- ## Ollama (multiplataforma) • Desempenho: modelos GGUF usam o backend Metal do llama.cpp; um backend MLX (prévia desde o Ollama 0.19, março de 2026) acelera modelos selecionados, principalmente em chips M5 • Suporte a modelos: a maior biblioteca de modelos. Novos modelos toda semana. • Configuração: um comando para instalar, funciona de imediato • Ideal para: iniciantes e a maioria dos desenvolvedores. API REST para integração. • Contrapartida: pode ser mais lento que o MLX nativo quando existe uma versão MLX do modelo (a diferença varia conforme modelo e versão)
- ## llama.cpp (multiplataforma, controle máximo) • Desempenho: competitivo com o Ollama quando otimizado (o Ollama o usa para modelos GGUF) • Personalização: maior controle sobre quantização e parâmetros de inferência • Configuração: exige compilação e experiência com a linha de comando • Ideal para: pesquisadores, fluxos de quantização personalizados • Contrapartida: curva de aprendizado mais íngreme que a do Ollama
- ## Recomendação por tipo de usuário • Iniciantes: Ollama (funciona de imediato, documentação extensa) • Desenvolvedores: API REST do Ollama (fácil de integrar em aplicações) • Usuários avançados: MLX diretamente (desempenho máximo) • Pesquisadores: llama.cpp (personalização máxima)
Início rápido no macOS (10 passos)
O caminho mais rápido para rodar seu primeiro LLM local de 70B no Apple Silicon.
- 1Compre seu Mac
Why it matters: Mac mini M5 Pro para orçamento/entrada, Mac Studio M5 Max ou M5 Ultra para potência de mesa, ou MacBook Pro 16" M5 Max para portabilidade. - 2Configuração inicial do macOS
Why it matters: Use o Assistente de Migração (transferência de um Mac antigo) ou uma instalação limpa. Mantenha o macOS atualizado: a Apple entrega melhorias de desempenho do Metal em versões intermediárias. - 3Instale o Homebrew
Why it matters: /bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)" — gerenciador de pacotes para todo o resto. - 4Instale o Ollama
Why it matters: brew install ollama — instalação simples com um comando. - 5Inicie o serviço do Ollama
Why it matters: ollama serve (roda em primeiro plano) ou use o Ollama.app na pasta Aplicativos. - 6Baixe um primeiro modelo de teste
Why it matters: ollama pull llama3.1:8b — verifique a instalação com um modelo pequeno (download de ~4 GB). - 7Teste a inferência básica
Why it matters: ollama run llama3.1:8b "Explain local LLMs in one sentence" --verbose — a linha eval rate mostra seus tokens/s. - 8Baixe o modelo grande de destino
Why it matters: ollama pull llama3.1:70b-instruct-q4_K_M (download de ~40 GB). Leva 20–40 min em conexão rápida e exige um Mac de 64 GB ou mais. - 9Monitore o desempenho
Why it matters: O asitop mostra o uso de recursos do Apple Silicon. Em um segundo terminal: brew install asitop && asitop. - 10Opcional: instale o LM Studio como interface gráfica
Why it matters: Baixe em lmstudio.ai. Mais fácil que a linha de comando para quem não é desenvolvedor; inclui um mecanismo MLX para Apple Silicon.
Como acelerar o Ollama no Apple Silicon M5
A maioria das instalações do Ollama no Apple Silicon já usa o caminho rápido por padrão, então a lista abaixo trata de remover o que freia sem você notar, não de ajustes exóticos.
Confirme com `ollama ps` que o modelo roda 100% na GPU, libere memória unificada, reduza o tamanho do contexto, use quantização Q4, ative flash attention e mantenha o MacBook Pro na tomada e elevado: a velocidade de geração é limitada pela largura de banda, então o maior ganho é escolher um modelo que caiba nela.
O Ollama costuma ser rápido por padrão em um Mac M5: a maioria dos problemas de velocidade vem de algo consumindo sua memória unificada, de um modelo grande demais para a sua largura de banda ou de um notebook superaquecendo, não de uma configuração esquecida.
- Ajuste primeiro o modelo à sua largura de banda. Os tokens/s ficam limitados perto de largura de banda ÷ tamanho do arquivo do modelo (veja a seção de largura de banda acima). Um modelo 70B de 42 GB em um M5 Pro de 307 GB/s não passa de uns 7 tokens/s por mais que você ajuste; um modelo 32B de 20 GB chega a uns 15. Trocar por um modelo ou quantização menores é o maior ganho disponível.
- Confirme que o modelo está totalmente descarregado na GPU e não caindo para a CPU. Rode `ollama ps` com um modelo carregado: a coluna PROCESSOR deve indicar 100% GPU. Uma divisão parcial com a CPU geralmente significa que o modelo não cabe na memória que o macOS permite à GPU, não que falte uma configuração.
- Libere memória unificada antes de uma sessão longa. A memória é compartilhada entre o macOS e o modelo: um navegador com muitas abas, o Docker Desktop ou o Xcode em segundo plano podem tirar vários GB do Ollama. Feche-os antes de carregar um modelo grande e confira a memória disponível com o Monitor de Atividade ou o `asitop`. Em modelos grandes, o limite de memória da GPU pode ser elevado com `sudo sysctl iogpu.wired_limit_mb=<MB>` (volta ao padrão ao reiniciar).
- Reduza a janela de contexto se não precisar dela. Defina um `num_ctx` menor no Modelfile ou na requisição da API (por exemplo, 4096 em vez de 32K) para conversas curtas: isso reduz a pressão de memória do cache KV e acelera a geração.
- Ative flash attention e um cache KV quantizado. `OLLAMA_FLASH_ATTENTION=1` e `OLLAMA_KV_CACHE_TYPE=q8_0` reduzem a memória do cache KV e aceleram contextos longos com uma pequena perda de qualidade.
- Ajuste a quantização às suas necessidades reais de qualidade. Q4_K_M é nitidamente mais rápida que Q8_0 ou Q5_K_M, com perda de qualidade pequena e geralmente aceitável (veja o guia de quantização). Se um modelo roda mais devagar que os benchmarks acima, tente a variante Q4 antes de culpar o hardware.
- Mantenha o MacBook Pro na tomada e elevado para inferência sustentada. O MacBook Pro pode limitar 10–15 % após 2–3 horas de carga contínua, conforme o calor se acumula no chassi mais fino. Um suporte que melhore o fluxo de ar e o uso na tomada atrasam a limitação. Em sessões de mais de algumas horas, a refrigeração do Mac Studio mantém o desempenho total.
- Atualize o macOS e o Ollama. A Apple entrega melhorias de desempenho do Metal em versões intermediárias e o Ollama lança regularmente backends mais rápidos, inclusive suporte a MLX para mais modelos. Rodar uma versão antiga em silício M5 novo desperdiça desempenho.
- Evite rodar vários modelos ao mesmo tempo sem necessidade. Cada modelo carregado reserva sua parte da memória unificada. `OLLAMA_MAX_LOADED_MODELS` controla quantos modelos o Ollama mantém residentes ao mesmo tempo.
# Check whether a model is fully offloaded to GPU (PROCESSOR column)
ollama ps

# Measure real speed: the "eval rate" line is generation tokens/sec
ollama run llama3.1:8b --verbose

# Faster long-context inference: flash attention + 8-bit KV cache
OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 ollama serve

# Or limit Ollama to one resident model at a time
OLLAMA_MAX_LOADED_MODELS=1 ollama serve

# Smaller context window in a Modelfile: PARAMETER num_ctx 4096
Matriz de decisão: qual configuração de Mac comprar
Use esta matriz para achar a melhor opção conforme o caso de uso. Com a mesma memória, escolha a de maior largura de banda.
- 1. Orçamento em primeiro lugar, aceitando modelos menores (7–14B): Mac mini M5 Pro 24 GB (US$1.699) — o M5 Pro mais barato de todos
- 2. Quer modelos de 30B em uma mesa econômica: Mac mini M5 Pro 64 GB (US$2.699)
- 3. Quer rodar modelos 70B com folga: Mac Studio M5 Max 64 GB (US$3.499)
- 4. Precisa de 70B Q5 com janelas de contexto de 32K+: Mac Studio M5 Max 128 GB (US$5.099)
- 5. Precisa de 256–512 GB para os maiores modelos locais: Mac Studio M5 Ultra (US$5.499–10.000+)
- 6. LLM local portátil, aceitando a limitação térmica: MacBook Pro 16" M5 Max 64 GB (US$3.499)
- 7. Já está no ecossistema macOS (Xcode, Final Cut Pro): qualquer variante do Mac Studio M5
- 8. Pesquisa/fine-tuning com experimentos MLX: Mac Studio M5 Max 128 GB ou M5 Ultra (folga de memória)
- 9. Quer o máximo de silêncio e operação em repouso: Mac Studio (ventoinhas raramente giram em carga normal)
- 10. Orçamento de US$4.000+ e quer portabilidade: MacBook Pro 16" M5 Max 128 GB (US$4.499)
- 11. Considerando alternativas: PC com RTX 4090 (US$3.000+) ou mini PC AMD Ryzen AI Max+ (US$1.600–2.000)
Quando o Apple Silicon M5 é a escolha errada para LLM local
O Apple Silicon é excelente, mas não universal. Evite o Mac para LLM local nestes cenários.
- Você precisa de fluxos só CUDA: a maior parte da inferência de LLM roda no Apple Silicon, mas fine-tuning com torch.cuda, kernels CUDA do vLLM e código de pesquisa CUDA proprietário não rodam no MLX. Se a maior parte do seu trabalho é específica de CUDA, escolha uma GPU RTX.
- Você trabalha muito com Stable Diffusion: modelos de difusão geralmente rodam mais devagar no M5 que em uma RTX 4090. Se geração de imagens é 30 % ou mais do seu fluxo, PC + RTX vence.
- Orçamento é prioridade absoluta: um PC de US$1.500 com RTX 4070 Ti supera o Mac mini M5 Pro em velocidade com modelos pequenos. Se só o orçamento importa, o PC é mais barato.
- Você precisa poder fazer upgrade: a RAM e o armazenamento do Mac Studio são fixos na compra. PCs permitem upgrades graduais. Em 5+ anos de uso, o PC pode sair mais barato.
- Você exige tokens/s de três dígitos em modelos pequenos: a RTX 4090 chega a 90–120 tokens/s com Llama 8B. Para o M5 Max, estimam-se 75–100. Para alto throughput (vários usuários), a NVIDIA ainda vence.
- Você ainda não usa macOS: trocar de ecossistema saindo de Windows/Linux só por LLM local não compensa, a menos que você queira o macOS por outros motivos.
- Você precisa de inferência de produção 24/7: o Mac Studio é excelente, mas pensado para picos. Para inferência contínua com SLA, estações NVIDIA corporativas são mais seguras.
Perguntas frequentes
Qual é a largura de banda de memória do M5 Pro, M5 Max e M5 Ultra?
O M5 tem 153,6 GB/s, o M5 Pro 307 GB/s, o M5 Max 460 GB/s (GPU de 32 núcleos) ou 614 GB/s (GPU de 40 núcleos) e o M5 Ultra até 1,2 TB/s (1.228,8 GB/s). Para a geração de LLM, a largura de banda importa mais que a contagem de núcleos de GPU, porque cada token lê uma vez os pesos do modelo na memória.
Quanta VRAM tem um Mac M5?
Nenhuma separada: um Mac M5 tem memória unificada compartilhada por CPU e GPU. Por padrão, o macOS deixa a GPU usar cerca de dois terços a três quartos da RAM total, então um Mac de 64 GB oferece uns 48 GB a um modelo. O M5 Pro vai até 64 GB, o M5 Max até 128 GB e o M5 Ultra até 512 GB.
Como faço o Ollama rodar mais rápido em um MacBook Pro M5?
Escolha um modelo adequado à sua largura de banda, confirme com `ollama ps` que ele roda 100% na GPU, feche apps que consomem muita memória, reduza o `num_ctx` se não precisar de contexto longo, use quantização Q4_K_M em vez de Q5/Q8, ative `OLLAMA_FLASH_ATTENTION=1` e mantenha o MacBook Pro na tomada e elevado em sessões de mais de 2–3 horas. Veja a seção de aceleração acima para a lista completa.
O Mac Studio M5 Max roda Llama 3.3 70B?
Sim, com 64 GB ou 128 GB. O 70B Q4 (~42,5 GB) precisa de 64 GB e roda a cerca de 6–9 tokens/s estimados no chip de 460 GB/s e 9–12 tokens/s no de 614 GB/s. O 70B Q5 (~50 GB) pede a configuração de 128 GB e roda a cerca de 7–10 tokens/s estimados.
Como o M5 Max se compara à RTX 4090 para LLM local?
O M5 Max é mais lento em modelos pequenos que cabem em 24 GB (cerca de 75–100 contra 90–120 tokens/s estimados com Llama 8B). Em modelos 70B, a 4090 não os comporta e recorre à descarga para a CPU, com uns 6–10 tokens/s, enquanto um M5 Max de 614 GB/s os roda a cerca de 9–12 tokens/s estimados com mais ou menos um terço do consumo.
64 GB de RAM bastam ou preciso de 128 GB?
Para um único modelo 70B Q4: 64 GB bastam. Para 70B Q5 ou Q8, vários modelos simultâneos, contextos longos ou fine-tuning: recomendam-se 128 GB. A quantidade de memória não muda a velocidade: um Mac Studio M5 Max de 64 GB e um de 128 GB têm os mesmos 614 GB/s.
Qual a diferença entre M5 Pro e M5 Max para LLM?
O M5 Pro tem GPU de 16/20 núcleos, 307 GB/s de largura de banda e até 64 GB. O M5 Max tem GPU de 32/40 núcleos, 460/614 GB/s e até 128 GB. Como a velocidade de geração acompanha a largura de banda, o M5 Max é cerca de 1,5× (460 GB/s) a 2× (614 GB/s) mais rápido com o mesmo modelo. O M5 Ultra (só no Mac Studio) vai além: até GPU de 80 núcleos, até 1,2 TB/s e até 512 GB.
Qual a velocidade do Mac Studio M5 Ultra para LLMs locais?
A MacStories mediu 48 tokens/s gerando com Qwen3.8 27B em um M5 Ultra de 256 GB (RTX 5090: 59) e 108 tokens/s com um modelo Flash-Next menor, cerca de 54 % mais rápido que um M3 Ultra. O teto de largura de banda para um modelo 70B Q4 é de cerca de 29 tokens/s; ainda não há resultado independente com 70B.
O MacBook Pro sofre limitação térmica em inferência de LLM sustentada?
Sim, após 2–3 horas de inferência contínua, o MacBook Pro pode perder 10–15 % de desempenho (estimativa). O Mac Studio mantém o desempenho total 24/7.
Posso rodar Stable Diffusion no Apple Silicon?
Sim, o Stable Diffusion XL roda no M5 a cerca de 8–12 s/imagem (mais lento que uma RTX 4070, com uns 3 s). O MLX oferece suporte nativo.
O MLX é mais rápido que o Ollama no Mac?
Em geral, para modelos que têm versão MLX: o MLX costuma ser mais rápido que modelos GGUF no llama.cpp, com diferenças de cerca de 10 % a 2× conforme o modelo e a versão. O Ollama adicionou um backend MLX em março de 2026 que reduz a diferença em modelos compatíveis. Escolha pelo seu fluxo de trabalho, não pela velocidade bruta.
Quanta energia o Mac Studio M5 Max usa em inferência de LLM?
Estima-se 65–100 W sustentados para o M5 Max sob carga de LLM; a Apple indica até 480 W de potência contínua máxima para o chassi do Mac Studio, que a inferência sozinha não atinge. Um mês de inferência 24/7 (720 horas) a 100 W dá ~72 kWh, cerca de US$8–12 de eletricidade nos EUA; um setup com RTX 4090 custa uns US$40–60.
O Mac mini já tem M5 Pro?
Sim. O Mac mini M5 Pro começa em US$1.699 (24 GB, até 64 GB), 307 GB/s de largura de banda, Thunderbolt 5, e é enviado desde 22 de setembro de 2026 — o Mac com M5 Pro mais barato já oferecido.
O Mac Studio ainda oferece configuração M5 Pro?
Não. Desde a atualização de 25 de agosto de 2026, o Mac Studio começa no M5 Max (US$2.499). O Mac mini passou a ser a porta de entrada do chip M5 Pro.
O que é o Mac Studio M5 Ultra e quanta memória ele suporta?
O M5 Ultra é um chip acima do M5 Max, exclusivo do Mac Studio, a partir de US$5.499 (96 GB). Escala para 256 GB agora e 512 GB no fim de outubro de 2026 (esperado bem acima de US$10.000), com até 1,2 TB/s de largura de banda.
Posso fazer fine-tuning de modelos no Apple Silicon?
Sim, o fine-tuning com LoRA funciona bem. O fine-tuning de todos os pesos é mais lento que em uma GPU de desktop (ainda sem suporte a treinamento distribuído).
O Apple Silicon é bom para inferência, mas ruim para treinamento?
Em parte. A inferência é excelente. Treinamento/fine-tuning funciona, mas é mais lento que na NVIDIA. O framework MLX melhora rapidamente.
Como o Neural Engine ajuda com LLMs?
A geração de tokens é limitada pela largura de banda de memória, não pelo Neural Engine. Em chips da família M5, os aceleradores neurais de cada núcleo de GPU aceleram o processamento do prompt (tempo até o primeiro token) nos mecanismos que os usam, como o MLX e o backend MLX do Ollama.
Posso rodar vários modelos ao mesmo tempo em um M5 Max de 128 GB?
Sim. 128 GB permitem dois modelos de 32B, ou um de 70B mais um de 14B, ao mesmo tempo com velocidade razoável.
Quanto tempo leva para configurar um LLM local no Mac?
De 15 a 30 minutos, de um Mac zerado até o primeiro modelo 70B via Ollama (incluindo 20–40 min de download em internet rápida).
O Apple Silicon funciona com os modelos de pesos abertos mais recentes?
A maioria das famílias de pesos abertos — Llama, Qwen, Mistral, Gemma, DeepSeek — roda via llama.cpp (GGUF) ou MLX poucos dias após o lançamento. Consulte a comunidade MLX no Hugging Face e a biblioteca do Ollama para ver a lista atual.
Devo comprar o Mac mini M6 ou o Mac mini M5 Pro para LLM local?
O M6 é o Mac mini de entrada (US$899, 16–32 GB, cerca de 153–170 GB/s) e serve para modelos pequenos. O M5 Pro (US$1.699, até 64 GB, 307 GB/s) tem cerca do dobro da largura de banda e da memória, então é a escolha para LLM local.
Vale a pena um Mac Studio recondicionado?
Sim. A Apple vende Macs recondicionados com um ano de garantia, geralmente com desconto em relação ao preço de um novo.
O M5 Max de 64 GB ou de 128 GB é a melhor compra?
Compre 64 GB para um único modelo 70B Q4 e modelos de 32B; 128 GB para 70B Q5/Q8, contextos longos ou vários modelos ao mesmo tempo. Olhe também o nível de GPU: no MacBook Pro, 64 GB vêm com o chip de 460 GB/s e 128 GB com o de 614 GB/s.