Key Takeaways
- ✅ Ancho de banda por chip: M5 153,6 GB/s · M5 Pro 307 GB/s · M5 Max 460 GB/s (GPU de 32 núcleos) o 614 GB/s (GPU de 40 núcleos) · M5 Ultra hasta 1,2 TB/s. La velocidad de generación es aproximadamente ancho de banda ÷ tamaño del modelo × 60–80 % — consulta las secciones de ancho de banda más abajo.
- ✅ DISPONIBLE DESDE EL 22 DE SEPTIEMBRE DE 2026: Mac mini M5 Pro desde 1.699 $ (hasta 64 GB, 307 GB/s) — el Mac con M5 Pro más barato jamás ofrecido, por debajo del MacBook Pro.
- ✅ El Mac Studio M5 Max desde 2.499 $ (hasta 128 GB, 614 GB/s) y el Mac Studio M5 Ultra desde 5.499 $ (hasta 512 GB, hasta 1,2 TB/s) ya se envían. La configuración de 512 GB del M5 Ultra llega a finales de octubre de 2026 y se espera muy por encima de 10.000 $.
- El Mac Studio ya no ofrece nivel M5 Pro: empieza en el M5 Max. El Mac mini es ahora la puerta de entrada al chip M5 Pro.
- El MacBook Pro 16" M5 Max (disponible desde marzo de 2026) comparte el mismo ancho de banda que el Mac Studio M5 Max en cada nivel de GPU: 460 GB/s (GPU de 32 núcleos) y 614 GB/s (GPU de 40 núcleos), sin penalización por el formato.
- Todas las configuraciones M5 Pro/Max: 307–614 GB/s de ancho de banda (RTX 4090 con 1.008 GB/s, pero limitada a 24 GB de VRAM). El M5 Ultra alcanza hasta 1,2 TB/s.
- Funcionamiento silencioso: los ventiladores del MacBook Pro se oyen con inferencia sostenida; los del Mac Studio y el Mac mini rara vez se activan con cargas típicas de LLM local.
- MLX suele ser el motor más rápido en Apple Silicon. Ollama añadió un backend MLX en marzo de 2026 (vista previa, Ollama 0.19, al principio para modelos seleccionados en Macs con más de 32 GB); el resto de modelos siguen usando el backend Metal de llama.cpp.
- Memoria unificada: de 24 GB (Mac mini M5 Pro base) a 512 GB (Mac Studio M5 Ultra) disponibles para cualquier modelo. Sin un tope de VRAM separado como en las GPU dedicadas.
El M5 Pro ofrece 307 GB/s, el M5 Max 460–614 GB/s y el M5 Ultra hasta 1,2 TB/s de ancho de banda de memoria, y ese número — no el de núcleos — determina cuántos tokens por segundo genera un Mac; el Mac mini M5 Pro parte de 1.699 $, el Mac Studio M5 Max de 2.499 $ y el Mac Studio M5 Ultra de 5.499 $.
Los Mac con Apple Silicon usan memoria unificada: CPU, GPU y motor de IA comparten el mismo conjunto de memoria rápida. Así, un M5 Max de 128 GB puede cargar un modelo 70B completo que ninguna GPU NVIDIA de consumo (24–32 GB de VRAM) admite, y la opción de 512 GB del M5 Ultra llega aún más lejos.
🔄 Actualización del 11 de octubre de 2026: ya pasó la fecha de envío del 22 de septiembre de 2026, así que el Mac mini M5 Pro, el Mac Studio M5 Max y el Mac Studio M5 Ultra (96–256 GB) están disponibles; solo la configuración de 512 GB del M5 Ultra sigue pendiente (finales de octubre de 2026). Esta actualización añade secciones de ancho de banda de memoria, sustituye los rangos de tokens por segundo que superaban el techo de ancho de banda de cada chip e incorpora las primeras mediciones independientes del M5 Ultra del análisis de MacStories. Las cifras de tokens/s del Mac mini M5 Pro y del Mac Studio M5 Max siguen siendo estimaciones derivadas del ancho de banda y de resultados del MacBook Pro, no mediciones en esos equipos.
Por qué importa Apple Silicon M5 para LLM local
Apple Silicon representa una arquitectura radicalmente distinta para cargas de IA. Por esto importa a quienes usan LLM locales.
- Arquitectura de memoria unificada: M5 Pro y M5 Max comparten un único conjunto de memoria rápida (de 24 a 128 GB) al que acceden CPU, GPU y Neural Engine a la vez. Sin cuello de botella VRAM/RAM. Los modelos permanecen en memoria rápida y la inferencia sigue ágil.
- El ancho de banda de memoria es el verdadero cuello de botella: la generación de un LLM está limitada por la memoria, no por el cálculo: cada token generado lee los pesos del modelo una vez. El M5 Max, con 460–614 GB/s, queda por detrás de los 1.008 GB/s de la RTX 4090 en modelos pequeños, pero admite hasta 128 GB frente a 24 GB, así que ejecuta modelos que una 4090 no puede alojar. El M5 Ultra supera a la 4090 con hasta 1,2 TB/s y admite hasta 512 GB.
- La «VRAM» en un Mac es memoria unificada: no existe un conjunto de VRAM separado. La GPU usa la misma memoria que macOS y, por defecto, macOS permite a la GPU reservar aproximadamente entre dos tercios y tres cuartos de la RAM total (la proporción varía con el tamaño). En un Mac de 64 GB, cuenta con unos 48 GB para modelo más contexto; el límite se puede subir con `sudo sysctl iogpu.wired_limit_mb=<MB>` (se restablece al reiniciar).
- Arquitectura Apple Fusion (nueva en M5): M5 Pro y M5 Max separan CPU y GPU en dos dies de 3 nm distintos dentro de un mismo paquete, lo que permite escalar y optimizar la térmica de forma independiente y mejora la eficiencia energética frente a chips monolíticos.
- Neural Accelerator en cada núcleo de GPU: cada núcleo de GPU incluye un acelerador neuronal dedicado que complementa al Neural Engine compartido. Los motores que los aprovechan, como MLX y el backend MLX de Ollama, procesan los prompts más rápido en chips de la familia M5.
- Salto generacional frente a M4: Apple afirma hasta un 30 % más de rendimiento de CPU multihilo frente a M4 Pro y M4 Max. Para la generación de LLM lo relevante es el ancho de banda: M5 Pro 307 GB/s frente a 273 GB/s del M4 Pro (+12 %), y 614 GB/s frente a 546 GB/s en el M5 Max y M4 Max superiores (+12 %). El procesamiento de prompts mejora más gracias a los aceleradores neuronales por núcleo.
- Thunderbolt 5 (M5 Pro/Max): M5 Pro y M5 Max incluyen Thunderbolt 5 con 80 Gbps de ancho de banda base (el doble que Thunderbolt 4), útil para almacenamiento externo rápido y varias pantallas.
- Wi-Fi 7 y Bluetooth 6 mediante el chip Apple N1: los sistemas M5 incluyen el nuevo chip inalámbrico N1 con Wi-Fi 7 y Bluetooth 6.0 de baja latencia, útil con clientes de inferencia remota o API de modelos en la nube.
- MLX madura rápido: el framework MLX de Apple admite Llama 3.3, Qwen, Mistral y Gemma con kernels optimizados. Ollama ofrece un backend MLX para Apple Silicon desde marzo de 2026 (vista previa), limitado al principio a modelos seleccionados.
- La eficiencia energética es real: se estima que el M5 Max consume unos 65–100 W con inferencia sostenida (es una estimación, no una cifra de Apple; Apple indica hasta 480 W de potencia continua máxima para el chasis del Mac Studio). Un mes de inferencia continua (720 horas) a 100 W son unos 72 kWh, aproximadamente 8–12 $ de electricidad en EE. UU. Una RTX 4090 a 350 W cuesta unos 40–60 $ el mismo mes.
- Funcionamiento silencioso: los ventiladores del Mac Studio rara vez se oyen con cargas típicas de LLM; MacStories no pudo oír el ventilador del Mac Studio M5 Ultra en el uso diario. Los del MacBook Pro sí se oyen con inferencia sostenida.
Tabla comparativa Apple Silicon M5
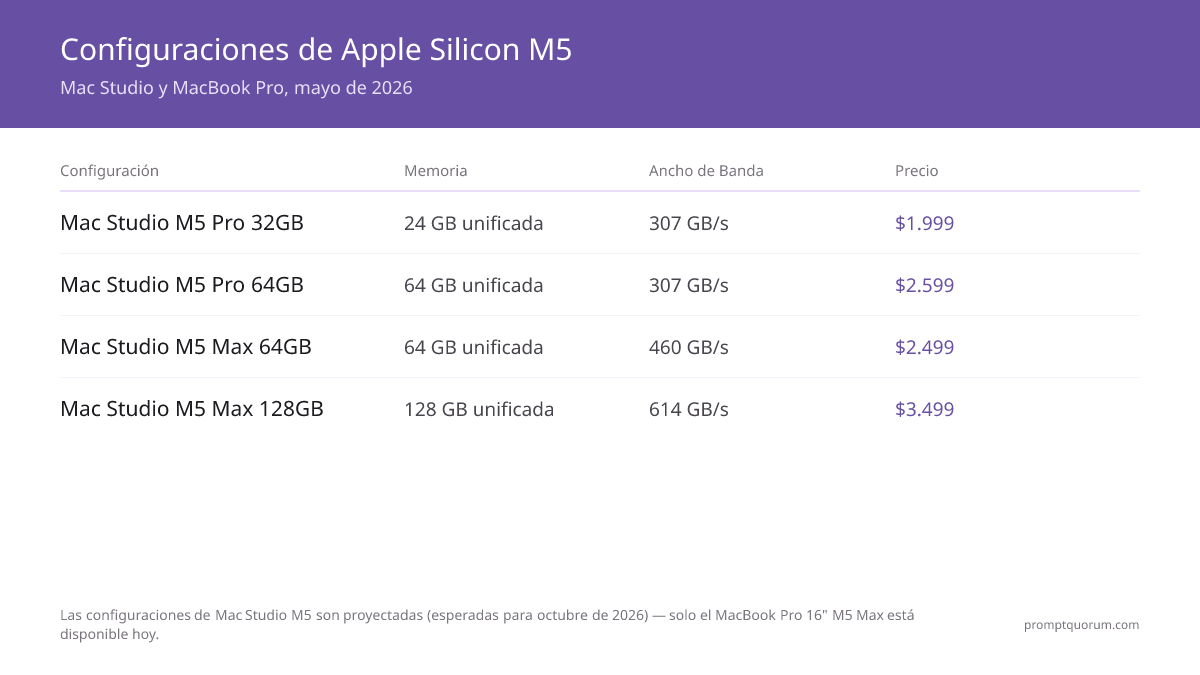
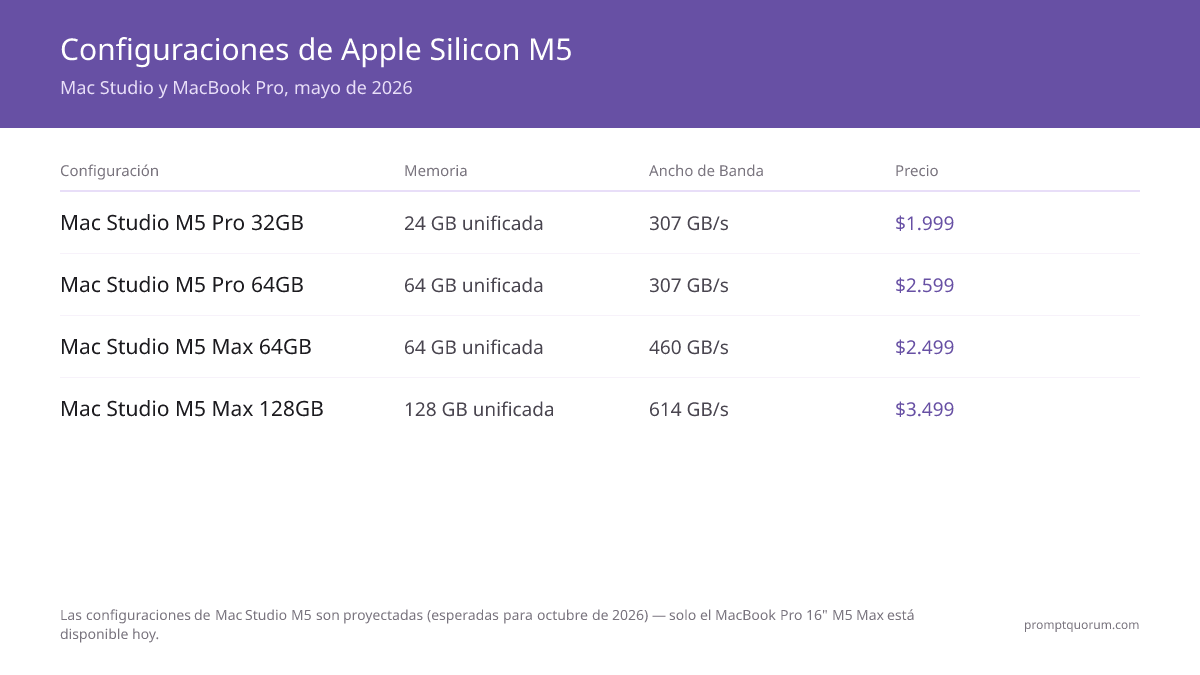
Las configuraciones siguientes usan los precios de Apple del anuncio del 25 de agosto de 2026. Mac mini, Mac Studio y MacBook Pro se envían desde el 22 de septiembre de 2026, salvo la configuración de 512 GB del Mac Studio M5 Ultra (finales de octubre de 2026, se espera muy por encima de 10.000 $). Precios: precios en USD del Apple Store. Hasta ahora solo el M5 Ultra cuenta con mediciones independientes de tokens/s: consulta la sección de rendimiento para ver qué está medido y qué estimado.
Configuración | Chip | Núcleos GPU | Memoria | Ancho de banda | Precio | Ideal para |
|---|---|---|---|---|---|---|
| Mac mini M5 Pro 24 GB | M5 Pro | 16 | 24GB unificada | 307 GB/s | 1.699 $ | M5 Pro más barato, 7B–14B |
| Mac mini M5 Pro 64 GB | M5 Pro | 20 | 64GB unificada | 307 GB/s | 2.699 $ | Modelos 30B, 64 GB más barato |
| Mac Studio M5 Max 36 GB | M5 Max | 32 | 36GB unificada | 460 GB/s | 2.499 $ | Entrada de escritorio económica |
| Mac Studio M5 Max 64 GB | M5 Max | 40 | 64GB unificada | 614 GB/s | 3.499 $ | 70B Q4, mejor valor |
| Mac Studio M5 Max 128 GB | M5 Max | 40 | 128GB unificada | 614 GB/s | 5.099 $ | 70B Q5, usuarios avanzados |
| Mac Studio M5 Ultra 96 GB | M5 Ultra | 64 | 96GB unificada | Hasta 1,2 TB/s | 5.499 $ | Los modelos locales más grandes |
| Mac Studio M5 Ultra 512 GB | M5 Ultra | 80 | 512GB unificada | Hasta 1,2 TB/s | 10.000+ $ (est.) | Modelos enormes, envío fin de oct. |
| MacBook Pro 16" M5 Max 64 GB | M5 Max | 32 | 64GB unificada | 460 GB/s | 3.499 $ | Portátil, 70B Q4 |
| MacBook Pro 16" M5 Max 128 GB | M5 Max | 40 | 128GB unificada | 614 GB/s | 4.499 $ | Portátil, 70B Q5 |
Ancho de banda de memoria de M5, M5 Pro, M5 Max y M5 Ultra comparado
El ancho de banda de memoria es la especificación que decide la velocidad de generación de los LLM locales en Apple Silicon y el dato que más buscan los compradores. La tabla recoge la cifra oficial de cada chip; el M5 Max tiene dos niveles: 460 GB/s con la GPU de 32 núcleos y 614 GB/s con la de 40 núcleos. Las cifras son máximos teóricos.
El ancho de banda de memoria del Apple M5 es de 153,6 GB/s (M5), 307 GB/s (M5 Pro), 460 GB/s (M5 Max con GPU de 32 núcleos), 614 GB/s (M5 Max con GPU de 40 núcleos) y hasta 1,2 TB/s (M5 Ultra).
El ancho de banda es la rapidez con la que el chip puede leer el modelo de la memoria. Generar un token lee (casi) todo el modelo una vez, así que un Mac nunca puede generar más rápido que su ancho de banda dividido por el tamaño del modelo.
- M5 Pro vs M5 Max: el M5 Max tiene 1,5× (GPU de 32 núcleos, 460 GB/s) o 2× (GPU de 40 núcleos, 614 GB/s) el ancho de banda del M5 Pro, así que cabe esperar una generación igual de más rápida con el mismo modelo.
- M5 Max vs M5 Ultra: el M5 Ultra une dos chips M5 Max y duplica los 614 GB/s del M5 Max con GPU de 40 núcleos hasta unos 1,2 TB/s: un 50 % más que los 819 GB/s del M3 Ultra de la generación anterior.
- Capacidad vs ancho de banda: más memoria no hace más rápido a un chip. Un M5 Max con GPU de 40 núcleos tiene los mismos 614 GB/s con 64 GB que con 128 GB; la memoria extra solo permite cargar modelos más grandes o más modelos.
Chip | Núcleos GPU | Memoria máx. | Ancho de banda | Se encuentra en |
|---|---|---|---|---|
| M5 | 8–10 | 32GB | 153,6 GB/s | MacBook Air, MacBook Pro 14" |
| M5 Pro | 16–20 | 64GB | 307 GB/s | MacBook Pro, Mac mini |
| M5 Max (GPU 32 núcleos) | 32 | 36GB+ | 460 GB/s | MacBook Pro, Mac Studio |
| M5 Max (GPU 40 núcleos) | 40 | 128GB | 614 GB/s | MacBook Pro, Mac Studio |
| M5 Ultra | 64–80 | 512GB | 1,2 TB/s (1,228,8 GB/s) | Mac Studio |
| M4 Max (referencia) | 40 | 128GB | 546 GB/s | Generación anterior |
| RTX 4090 (referencia) | n/d | 24GB VRAM | 1,008 GB/s | GPU dedicada |
Cómo el ancho de banda se convierte en tokens por segundo
La tabla siguiente es aritmética, no un benchmark: techo de tokens/s = ancho de banda ÷ tamaño del archivo del modelo. En la práctica la generación queda por debajo por las lecturas de la caché KV, la sobrecarga del motor y la térmica. Los modelos Mixture-of-Experts leen solo sus expertos activos por token, así que pueden ir más rápido que un modelo denso del mismo tamaño de archivo.
El límite superior de la velocidad de generación es el ancho de banda de memoria dividido por el tamaño del archivo del modelo — por ejemplo 614 GB/s ÷ 42,5 GB (Llama 3.3 70B Q4) ≈ 14 tokens/s — y los motores bien optimizados suelen alcanzar entre el 60 y el 80 % de ese valor.
Elige el chip según el modelo más grande que quieras ejecutar y comprueba después esta tabla de techos: si el techo es inferior a 10 tokens/s, el modelo se sentirá lento por muchos núcleos de GPU que compres.
- Cómo leer la tabla: los valores son techos teóricos en tokens/s. Multiplica por 0,6–0,8 para un rango realista: para Llama 3.3 70B Q4 en un M5 Max de 614 GB/s son aproximadamente 9–12 tokens/s.
- Comprobación independiente: MacStories midió 48 tokens/s generando con Qwen3.8 27B en un Mac Studio M5 Ultra (prompt de 6.091 tokens), frente a 59 tokens/s en una RTX 5090 (1,79 TB/s de ancho de banda). La velocidad real siguió al ancho de banda, no al número de núcleos.
- Regla de dimensionamiento: el archivo del modelo más la caché KV deben caber en aproximadamente dos tercios a tres cuartos de la memoria unificada, así que un modelo 70B Q4 (~42,5 GB) pide un Mac de 64 GB; Q5 y Q8 piden 128 GB.
Modelo (Q4_K_M) | Tamaño archivo | M5 Pro 307 | M5 Max 460 | M5 Max 614 | M5 Ultra 1,2 TB/s |
|---|---|---|---|---|---|
| Llama 3,1 8B | ~4,9GB | ~63 | ~94 | ~125 | ~250 |
| Mistral Small 24B | ~14GB | ~22 | ~33 | ~44 | ~88 |
| Qwen3 32B | ~20GB | ~15 | ~23 | ~31 | ~61 |
| Llama 3,3 70B | ~42,5GB | ~7 | ~11 | ~14 | ~29 |
Mac mini M5 Pro: nueva entrada económica para LLM local
El 25 de agosto de 2026 Apple incorporó por primera vez un chip M5 Pro en el Mac mini; antes el M5 Pro solo estaba en el MacBook Pro. Con 1.699–2.699 $ y 24–64 GB de memoria unificada, el Mac mini M5 Pro es la forma más barata de llegar al tope de 64 GB del M5 Pro y queda por debajo del MacBook Pro M5 Pro. El Mac Studio empieza ahora en el M5 Max. Disponible desde el 22 de septiembre de 2026.
- CPU: M5 Pro de 15 o 18 núcleos
- GPU: GPU M5 Pro de 16 o 20 núcleos
- Memoria: 24 GB base, configurable a 48 o 64 GB de memoria unificada LPDDR5X
- Ancho de banda de memoria: 307 GB/s (idéntico al M5 Pro del MacBook Pro)
- Almacenamiento: SSD de 512 GB–2 TB (configurable)
- Puertos: Thunderbolt 5 (nuevo en el Mac mini)
- Conectividad: Wi-Fi 7, Bluetooth 6
- Precio: 1.699 $ (CPU de 15 núcleos/GPU de 16 núcleos, 24 GB); 2.699 $ (CPU de 18 núcleos/GPU de 20 núcleos, 64 GB)
- Disponibilidad: en envío desde el 22 de septiembre de 2026
Mac Studio M5 Max 36 GB: configuración base
El Mac Studio M5 Max base parte de 2.499 $ con GPU de 32 núcleos y 36 GB de memoria unificada; las opciones de más memoria llegan con el nivel de GPU de 40 núcleos que se describe más abajo. En envío desde el 22 de septiembre de 2026. El Mac Studio ya no ofrece ningún nivel M5 Pro: este es ahora el Mac Studio más barato.
- CPU: M5 Max de 18 núcleos
- GPU: GPU M5 Max de 32 núcleos
- Memoria: 36 GB de memoria unificada LPDDR5X en este nivel de GPU
- Ancho de banda de memoria: 460 GB/s (idéntico al M5 Max de 32 núcleos del MacBook Pro)
- Almacenamiento: SSD de 512 GB–8 TB (configurable)
- Puertos: Thunderbolt 5
- Consumo: estimado 65–100 W con inferencia sostenida; los ventiladores rara vez giran
- Precio: 2.499 $
- Disponibilidad: en envío desde el 22 de septiembre de 2026
Mac Studio M5 Max 48–128 GB: mejor valor para LLM local 70B
El Mac Studio M5 Max con GPU de 40 núcleos parte de 3.099 $ (48 GB) y se configura hasta 128 GB por 5.099 $. Este es el nivel que cumple el posicionamiento de «mejor valor para 70B»: 64 GB cuestan 3.499 $ con los 614 GB/s completos. En envío desde el 22 de septiembre de 2026.
- CPU: M5 Max de 18 núcleos
- GPU: GPU M5 Max de 40 núcleos
- Memoria: 48 GB base, configurable a 64 o 128 GB de memoria unificada LPDDR5X
- Ancho de banda de memoria: 614 GB/s (idéntico al M5 Max de 40 núcleos del MacBook Pro)
- Almacenamiento: SSD de 512 GB–8 TB
- Puertos: Thunderbolt 5
- Consumo: estimado 65–100 W con inferencia sostenida; actividad moderada de ventiladores con uso intensivo de varios modelos
- Precio: 3.099 $ (48 GB); 3.499 $ (64 GB); 5.099 $ (128 GB)
- Disponibilidad: en envío desde el 22 de septiembre de 2026
Mac Studio M5 Ultra: nuevo nivel de máximo rendimiento
El Mac Studio M5 Ultra es un nuevo nivel superior por encima del M5 Max: parte de 5.499 $ con 96 GB y escala hasta 512 GB. Las configuraciones de 96–256 GB se envían desde el 22 de septiembre de 2026; la de 512 GB llega a finales de octubre de 2026 y se espera muy por encima de 10.000 $. Iguala el tope de 512 GB del M3 Ultra de la generación anterior con un 50 % más de ancho de banda.
- CPU: M5 Ultra de 30 núcleos (36 núcleos configurable)
- GPU: 64 núcleos en la base, 80 núcleos configurable
- Memoria: 96 GB base, configurable a 256 GB ahora y 512 GB a finales de octubre de 2026
- Ancho de banda de memoria: hasta 1,2 TB/s (1.228,8 GB/s; un 50 % más que los 819 GB/s del M3 Ultra)
- Almacenamiento: SSD de 1–16 TB
- Puertos: Thunderbolt 5
- Precio: 5.499 $ (base de 96 GB: CPU de 30 núcleos/GPU de 64 núcleos); 512 GB se espera muy por encima de 10.000 $
- Disponibilidad: en envío desde el 22 de septiembre de 2026 (96–256 GB); finales de octubre de 2026 (512 GB)
MacBook Pro 16" M5 Max: LLM local portátil
El MacBook Pro 16" M5 Max (3.499–4.499 $) usa el mismo silicio M5 Max que el Mac Studio en formato portátil. El ancho de banda coincide con el del Mac Studio en cada nivel de GPU: 460 GB/s con la GPU de 32 núcleos y 614 GB/s con la de 40 núcleos. Ten en cuenta que el MacBook Pro de 64 GB usa la GPU de 32 núcleos, mientras que el Mac Studio de 64 GB usa la de 40 núcleos. La limitación térmica con inferencia sostenida es el precio de la portabilidad.
- CPU: M5 Max de 18 núcleos (6 super + 12 de rendimiento)
- GPU: GPU M5 Max de 32 o 40 núcleos
- Memoria: 64 GB o 128 GB de memoria unificada
- Pantalla: Liquid Retina XDR de 16,2 pulgadas, 3456×2234
- Ancho de banda de memoria: 460 GB/s (64 GB, GPU de 32 núcleos) o 614 GB/s (128 GB, GPU de 40 núcleos)
- Almacenamiento: SSD de 512 GB–8 TB
- Batería: se indica en horas de reproducción de vídeo; la inferencia sostenida la agota mucho más rápido
- Peso: 2,14 kg
- Puertos: 3× Thunderbolt 5, HDMI 2.1, ranura SD, conector de auriculares
- Precio: 3.499 $ (64 GB, GPU de 32 núcleos) a 4.499 $ (128 GB, GPU de 40 núcleos)
🏆 Nuestras recomendaciones: qué Mac comprar para LLM local
Recomendaciones claras según el caso de uso.
- 🏆 💰 M5 PRO MÁS BARATO: Mac mini M5 Pro (1.699 $, disponible) • Por qué: primer Mac mini con M5 Pro. Queda por debajo de cualquier forma anterior de conseguir un M5 Pro, incluido el MacBook Pro. La base de 24 GB sirve para 7B–14B; con 64 GB, para 30B. • Para quién: compradores primerizos de Apple Silicon con presupuesto ajustado. • Comprar en Apple Store →
- 🥇 MEJOR VALOR PARA 70B: Mac Studio M5 Max 64 GB (3.499 $, disponible) • Por qué: ejecuta Llama 3.3 70B Q4 a unos 9–12 tokens/s estimados con los 614 GB/s completos. La refrigeración de escritorio evita la limitación térmica. • Para quién: desarrolladores que estandarizan un flujo de trabajo 70B sin necesidad de portabilidad. • Comprar en Apple Store →
- 🔥 MÁXIMA POTENCIA: Mac Studio M5 Ultra 96 GB (5.499 $, disponible) • Por qué: nivel superior. Hasta 1,2 TB/s de ancho de banda, el doble que el M5 Max. La configuración de 512 GB llega a finales de octubre de 2026 para los modelos locales más grandes. • Estado: ya hay primeras mediciones independientes (MacStories: 48 tokens/s con Qwen3.8 27B frente a 59 en una RTX 5090). • Comprar en Apple Store →
- 💼 MEJOR PORTÁTIL: MacBook Pro 16" M5 Max (3.499 $ con 64 GB y 460 GB/s; 4.499 $ con 128 GB y 614 GB/s) • Por qué: el mismo silicio M5 Max del Mac Studio en un portátil con pantalla Liquid Retina XDR. Asume un 10–15 % menos de velocidad sostenida por la limitación térmica. • Alternativa: el Mac Studio M5 Max de 64 GB (3.499 $) cuesta lo mismo con 614 GB/s y mejor refrigeración sostenida si no necesitas portabilidad. • Comprar en Apple Store →
Rendimiento de LLM locales: estimaciones basadas en el ancho de banda y resultados independientes del M5 Ultra
Hasta ahora solo el M5 Ultra cuenta con mediciones independientes de terceros (MacStories, al final de esta sección). Para M5 Pro y M5 Max, los rangos siguientes son estimaciones: cada uno equivale al 60–80 % del techo de ancho de banda (ancho de banda ÷ tamaño del archivo del modelo), contrastado con informes de la comunidad y resultados del MacBook Pro; no son mediciones de laboratorio en el chasis del Mac mini o del Mac Studio. Los rangos se etiquetan por ancho de banda porque el MacBook Pro de 64 GB (460 GB/s) y el Mac Studio de 64 GB (614 GB/s) difieren. Cuenta con ±10–15 % según la versión de macOS, del motor, la cuantización y la longitud de contexto. Las cifras de referencia de la RTX 4090 son aproximadas, de la comunidad.
- ## Llama 3.1 8B (Q4_K_M, ~4,9 GB) • M5 Pro (307 GB/s): 38–50 tokens/s • M5 Max (460 GB/s): 56–75 tokens/s • M5 Max (614 GB/s): 75–100 tokens/s • Referencia (RTX 4090): 90–120 tokens/s
- ## Mistral Small 24B (Q4_K_M, ~14 GB) • M5 Pro (307 GB/s): 13–17 tokens/s • M5 Max (460 GB/s): 19–26 tokens/s • M5 Max (614 GB/s): 26–34 tokens/s
- ## Qwen3 32B (Q4_K_M, ~20 GB) • M5 Pro (307 GB/s): 9–12 tokens/s • M5 Max (460 GB/s): 14–19 tokens/s • M5 Max (614 GB/s): 19–25 tokens/s
- ## Llama 3.3 70B (Q4_K_M, ~42,5 GB) • M5 Pro 64 GB (307 GB/s): 4–6 tokens/s • M5 Max (460 GB/s): 6–9 tokens/s • M5 Max (614 GB/s): 9–12 tokens/s • M5 Ultra: techo de unos 29 tokens/s (sin medición independiente con 70B todavía) • Referencia (RTX 4090): 6–10 tokens/s con descarga parcial a CPU
- ## Llama 3.3 70B (Q5_K_M, ~50 GB) • M5 Pro 64 GB: margen insuficiente • M5 Max 128 GB (614 GB/s): 7–10 tokens/s • Referencia (RTX 4090): no es posible (límite de VRAM)
- ## Llama 3.3 70B (Q8_0, ~75 GB) • M5 Max 128 GB (614 GB/s): 5–7 tokens/s • RTX 4090: no es posible (requiere descarga multi-GPU)
- ## Resultados independientes del M5 Ultra (MacStories, unidad de 256 GB, oMLX) • Qwen3.8 27B, prompt de 6.091 tokens: M5 Ultra 48 tokens/s de generación, 1.701 tokens/s de lectura de prompt, 4,0 s hasta el primer token — RTX 5090: 59 tokens/s, 3.031 tokens/s, 2,0 s • Qwen3.8 27B con contexto largo (generación): 38,9 tokens/s a 64K, 32,4 a 128K, 24,3 a 256K — RTX 5090: 49,6, 40,4, 30,0 • Flash-Next, prompt corto: 108 tokens/s en el M5 Ultra frente a 70 en un M3 Ultra (+54 %)
- ## Metodología Los rangos de M5 Pro y M5 Max se derivan como el 60–80 % de ancho de banda ÷ tamaño del archivo del modelo y se contrastan con resultados de la comunidad, como la prueba MLX vs GGUF citada en nuestra página de benchmarks M5 Pro vs M5 Max. Las cifras del M5 Ultra son mediciones propias de MacStories con oMLX 0.7.0.dev2 en macOS 27.0; los nombres de modelo son suyos. Trata cualquier cifra de tokens/s del M5 Ultra para modelos no listados arriba como no verificada.
Apple Silicon M5 vs workstation PC para LLM local
Apple Silicon y NVIDIA son filosofías distintas. Esta es la comparación honesta.
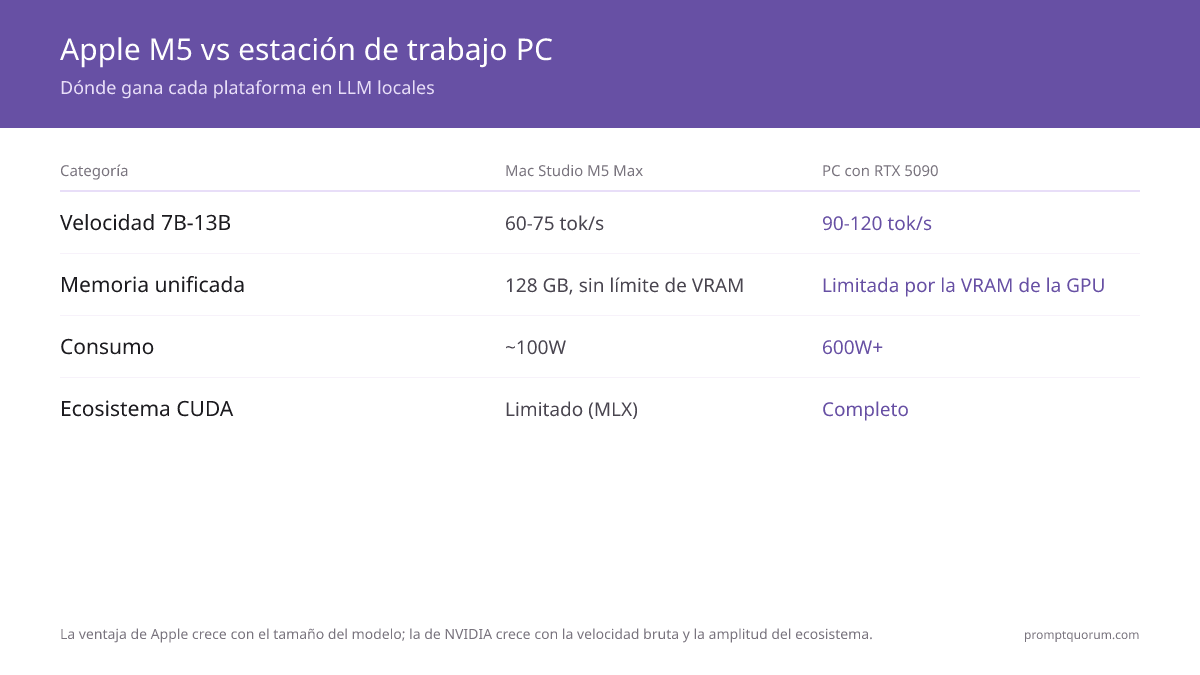
- ## Mac Studio M5 Max/Ultra gana en: • Memoria unificada: hasta 128 GB (M5 Max) o 512 GB (M5 Ultra) disponibles para cualquier modelo, sin tope de VRAM • Eficiencia energética: aprox. 100 W frente a más de 600 W en un PC equivalente • Funcionamiento silencioso: ventiladores rara vez audibles con cargas típicas • Ecosistema macOS: integración con MLX, Metal y Core ML • Coste total de propiedad: menos electricidad a 3 años • Modelos de más de 32 GB: una RTX 5090 llega como máximo a 32 GB de VRAM
- ## La workstation PC (RTX 4090/5090) gana en: • Velocidad bruta con modelos que caben en la VRAM: MacStories midió una RTX 5090 a 59 tokens/s frente a 48 en el M5 Ultra con Qwen3.8 27B, y una lectura de prompt unas 1,8× más rápida (3.031 frente a 1.701 tokens/s) • Amplitud del ecosistema CUDA: más modelos, herramientas y código de investigación • Ajuste fino: PyTorch + CUDA domina frente a MLX • Flexibilidad de actualización: cambiar GPU, añadir más VRAM • Precio en niveles bajos: una RTX 4070 Ti económica (800–1.200 $) supera al M5 Pro con modelos pequeños • IA que no es LLM: Stable Diffusion, entrenamiento y multimodal suelen ser más rápidos en NVIDIA
- ## El veredicto honesto Para inferencia de LLM local pura con modelos de 30B–70B, el Mac Studio M5 Max de 128 GB (5.099 $) compite directamente con PC de más de 4.500 $, y el Mac Studio M5 Ultra eleva el techo a modelos que necesitan 256 GB o 512 GB. La ventaja de la memoria unificada es real y medible. Para modelos que caben en 24–32 GB de VRAM, un PC con RTX 4090 o 5090 es más rápido que cualquier Mac. La ventaja de Apple se reduce con modelos más pequeños. Para ajuste fino, entrenamiento, Stable Diffusion a gran escala o PyTorch en producción, gana PC + NVIDIA. MLX mejora, pero quedan diferencias.
MLX vs Ollama vs llama.cpp en Apple Silicon
Tres motores de inferencia principales funcionan en M5. ¿Cuál te conviene?
- ## MLX (nativo de Apple) • Rendimiento: suele dar los tokens/s más altos en M5; optimización Metal nativa y soporte de los Neural Accelerators. • Soporte de modelos: en crecimiento (Llama, Qwen, Mistral, Gemma disponibles) • Instalación: orientada a Python, requiere soltura con la línea de comandos • Ideal para: usuarios avanzados que buscan el máximo rendimiento • Contrapartida: menos amigable que Ollama
- ## Ollama (multiplataforma) • Rendimiento: los modelos GGUF usan el backend Metal de llama.cpp; un backend MLX (vista previa desde Ollama 0.19, marzo de 2026) acelera modelos seleccionados, sobre todo en chips M5 • Soporte de modelos: la mayor biblioteca de modelos. Nuevos modelos cada semana. • Instalación: un solo comando, funciona de inmediato • Ideal para: principiantes y la mayoría de desarrolladores. API REST para integrar. • Contrapartida: puede ser más lento que MLX nativo cuando existe una versión MLX del modelo (la diferencia varía según modelo y versión)
- ## llama.cpp (multiplataforma, máximo control) • Rendimiento: competitivo con Ollama cuando está optimizado (Ollama lo usa para modelos GGUF) • Personalización: el mayor control sobre cuantización y parámetros de inferencia • Instalación: requiere compilación y experiencia con la línea de comandos • Ideal para: investigadores, flujos de cuantización personalizados • Contrapartida: curva de aprendizaje más empinada que Ollama
- ## Recomendación por tipo de usuario • Principiantes: Ollama (funciona de inmediato, documentación extensa) • Desarrolladores: API REST de Ollama (fácil de integrar en aplicaciones) • Usuarios avanzados: MLX directamente (máximo rendimiento) • Investigadores: llama.cpp (máxima personalización)
Configuración rápida en macOS (10 pasos)
El camino más rápido para ejecutar tu primer LLM local de 70B en Apple Silicon.
- 1Compra tu Mac
Why it matters: Mac mini M5 Pro para presupuesto/entrada, Mac Studio M5 Max o M5 Ultra para potencia de escritorio, o MacBook Pro 16" M5 Max para portabilidad. - 2Configuración inicial de macOS
Why it matters: Usa el Asistente de migración (traspaso desde un Mac anterior) o una instalación limpia. Mantén macOS actualizado: Apple publica mejoras de rendimiento de Metal en versiones puntuales. - 3Instala Homebrew
Why it matters: /bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)" — gestor de paquetes para todo lo demás. - 4Instala Ollama
Why it matters: brew install ollama — instalación sencilla con un solo comando. - 5Inicia el servicio de Ollama
Why it matters: ollama serve (se ejecuta en primer plano) o usa Ollama.app desde la carpeta Aplicaciones. - 6Descarga un primer modelo de prueba
Why it matters: ollama pull llama3.1:8b — verifica la instalación con un modelo pequeño (descarga de ~4 GB). - 7Prueba la inferencia básica
Why it matters: ollama run llama3.1:8b "Explain local LLMs in one sentence" --verbose — la línea eval rate muestra tus tokens/s. - 8Descarga el modelo grande objetivo
Why it matters: ollama pull llama3.1:70b-instruct-q4_K_M (descarga de ~40 GB). Tarda 20–40 min con buena conexión y requiere un Mac de 64 GB o más. - 9Supervisa el rendimiento
Why it matters: asitop muestra el uso de recursos de Apple Silicon. En una segunda terminal: brew install asitop && asitop. - 10Opcional: instala LM Studio como interfaz gráfica
Why it matters: Descárgalo de lmstudio.ai. Más sencillo que la línea de comandos para quienes no son desarrolladores; incluye un motor MLX para Apple Silicon.
Cómo acelerar Ollama en Apple Silicon M5
La mayoría de instalaciones de Ollama en Apple Silicon ya usan la vía rápida por defecto, así que la lista siguiente trata de quitar lo que frena sin que se note, no de ajustes exóticos.
Comprueba con `ollama ps` que el modelo corre al 100 % en GPU, libera memoria unificada, reduce la longitud de contexto, usa una cuantización Q4, activa flash attention y mantén el MacBook Pro conectado y elevado: la velocidad de generación está limitada por el ancho de banda, así que la mayor mejora es elegir un modelo que encaje con él.
Ollama suele ser rápido por defecto en un Mac M5: la mayoría de problemas de velocidad vienen de algo que consume tu memoria unificada, de un modelo demasiado grande para tu ancho de banda o de un portátil que se sobrecalienta, no de un ajuste olvidado.
- Ajusta primero el modelo a tu ancho de banda. Los tokens/s quedan limitados cerca de ancho de banda ÷ tamaño del archivo del modelo (consulta la sección de ancho de banda arriba). Un modelo 70B de 42 GB en un M5 Pro de 307 GB/s no pasa de unos 7 tokens/s por mucho que lo ajustes; un modelo 32B de 20 GB llega a unos 15. Pasar a un modelo o cuantización más pequeños es la mayor mejora posible.
- Confirma que el modelo está totalmente descargado en la GPU y no recurre a la CPU. Ejecuta `ollama ps` con un modelo cargado: la columna PROCESSOR debe indicar 100% GPU. Un reparto parcial con CPU suele significar que el modelo no cabe en la memoria que macOS permite usar a la GPU, no que falte un ajuste.
- Libera memoria unificada antes de una sesión larga. La memoria se comparte entre macOS y el modelo: un navegador con muchas pestañas, Docker Desktop o Xcode en segundo plano pueden quitarle varios GB a Ollama. Ciérralos antes de cargar un modelo grande y revisa la memoria libre con el Monitor de Actividad o `asitop`. En modelos grandes, el límite de memoria de la GPU se puede subir con `sudo sysctl iogpu.wired_limit_mb=<MB>` (se restablece al reiniciar).
- Reduce la ventana de contexto si no la necesitas. Define un `num_ctx` menor en el Modelfile o en la petición a la API (p. ej. 4096 en lugar de 32K) para chats cortos: reduce la presión de memoria de la caché KV y acelera la generación.
- Activa flash attention y una caché KV cuantizada. `OLLAMA_FLASH_ATTENTION=1` y `OLLAMA_KV_CACHE_TYPE=q8_0` reducen la memoria de la caché KV y aceleran los contextos largos con una pequeña pérdida de calidad.
- Ajusta la cuantización a tus necesidades reales de calidad. Q4_K_M es claramente más rápida que Q8_0 o Q5_K_M con una pérdida de calidad pequeña y normalmente aceptable (consulta la guía de cuantización). Si un modelo va más lento que los benchmarks de arriba, prueba la variante Q4 antes de culpar al hardware.
- Mantén el MacBook Pro conectado y elevado para inferencia sostenida. El MacBook Pro puede limitarse un 10–15 % tras 2–3 horas de carga continua por el calor acumulado en el chasis más delgado. Un soporte que mejore la ventilación y trabajar conectado a la corriente retrasan la limitación. En sesiones de más de unas horas, la refrigeración del Mac Studio mantiene el rendimiento completo.
- Actualiza macOS y Ollama. Apple publica mejoras de rendimiento de Metal en versiones puntuales y Ollama lanza con regularidad backends más rápidos, incluido soporte MLX para más modelos. Usar una versión antigua en silicio M5 nuevo desaprovecha rendimiento.
- Evita ejecutar varios modelos a la vez salvo que lo necesites. Cada modelo cargado reserva su parte de memoria unificada. `OLLAMA_MAX_LOADED_MODELS` controla cuántos modelos mantiene Ollama residentes a la vez.
# Check whether a model is fully offloaded to GPU (PROCESSOR column)
ollama ps

# Measure real speed: the "eval rate" line is generation tokens/sec
ollama run llama3.1:8b --verbose

# Faster long-context inference: flash attention + 8-bit KV cache
OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 ollama serve

# Or limit Ollama to one resident model at a time
OLLAMA_MAX_LOADED_MODELS=1 ollama serve

# Smaller context window in a Modelfile: PARAMETER num_ctx 4096
Matriz de decisión: qué configuración de Mac comprar
Usa esta matriz para encontrar la mejor opción según tu caso de uso. Con la misma memoria, elige la de mayor ancho de banda.
- 1. Prima el presupuesto y aceptas modelos más pequeños (7–14B): Mac mini M5 Pro 24 GB (1.699 $), el M5 Pro más barato jamás
- 2. Quieres modelos de 30B en un escritorio económico: Mac mini M5 Pro 64 GB (2.699 $)
- 3. Quieres ejecutar modelos 70B con comodidad: Mac Studio M5 Max 64 GB (3.499 $)
- 4. Necesitas 70B Q5 con ventanas de contexto de 32K+: Mac Studio M5 Max 128 GB (5.099 $)
- 5. Necesitas 256–512 GB para los modelos locales más grandes: Mac Studio M5 Ultra (5.499–10.000+ $)
- 6. LLM local portátil, aceptando la limitación térmica: MacBook Pro 16" M5 Max 64 GB (3.499 $)
- 7. Ya estás en el ecosistema macOS (Xcode, Final Cut Pro): cualquier variante del Mac Studio M5
- 8. Investigación/ajuste fino con experimentos MLX: Mac Studio M5 Max 128 GB o M5 Ultra (margen de memoria)
- 9. Quieres el máximo silencio y funcionamiento en reposo: Mac Studio (los ventiladores rara vez giran con carga normal)
- 10. Presupuesto de 4.000 $ o más y quieres portabilidad: MacBook Pro 16" M5 Max 128 GB (4.499 $)
- 11. Valoras alternativas: PC con RTX 4090 (desde 3.000 $) o mini PC AMD Ryzen AI Max+ (1.600–2.000 $)
Cuándo Apple Silicon M5 no es la opción adecuada para LLM local
Apple Silicon es excelente, pero no universal. Evita el Mac para LLM local en estos casos.
- Necesitas flujos de trabajo solo CUDA: la mayor parte de la inferencia de LLM funciona en Apple Silicon, pero el ajuste fino con torch.cuda, los kernels CUDA de vLLM y el código de investigación CUDA propietario no corren en MLX. Si la mayoría de tu trabajo es específico de CUDA, elige una GPU RTX.
- Haces mucho trabajo con Stable Diffusion: los modelos de difusión suelen ir más lentos en M5 que en una RTX 4090. Si la generación de imágenes es el 30 % o más de tu flujo, gana PC + RTX.
- El presupuesto es la prioridad absoluta: un PC de 1.500 $ con RTX 4070 Ti supera al Mac mini M5 Pro en velocidad con modelos pequeños. Si solo importa el precio, el PC es más barato.
- Necesitas poder actualizar la estación de trabajo: la RAM y el almacenamiento del Mac Studio son fijos en la compra. Los PC permiten mejoras graduales. Con más de 5 años de uso, el PC puede salir más barato.
- Exiges tokens/s de tres cifras con modelos pequeños: la RTX 4090 alcanza 90–120 tokens/s con Llama 8B. Para el M5 Max se estiman 75–100. Para alto rendimiento (varios usuarios), NVIDIA sigue ganando.
- No usas macOS: cambiar de ecosistema desde Windows/Linux solo por LLM local no compensa, salvo que también quieras macOS por otros motivos.
- Necesitas inferencia de producción 24/7: el Mac Studio es excelente pero está pensado para ráfagas. Para inferencia continua con SLA, las workstations NVIDIA empresariales son más seguras.
Preguntas frecuentes
¿Cuál es el ancho de banda de memoria del M5 Pro, M5 Max y M5 Ultra?
El M5 tiene 153,6 GB/s, el M5 Pro 307 GB/s, el M5 Max 460 GB/s (GPU de 32 núcleos) o 614 GB/s (GPU de 40 núcleos) y el M5 Ultra hasta 1,2 TB/s (1.228,8 GB/s). Para la generación de LLM importa más el ancho de banda que el número de núcleos de GPU, porque cada token lee una vez los pesos del modelo desde la memoria.
¿Cuánta VRAM tiene un Mac M5?
Ninguna por separado: un Mac M5 tiene memoria unificada compartida por CPU y GPU. Por defecto, macOS permite a la GPU usar aproximadamente entre dos tercios y tres cuartos de la RAM total, así que un Mac de 64 GB ofrece unos 48 GB a un modelo. El M5 Pro llega a 64 GB, el M5 Max a 128 GB y el M5 Ultra a 512 GB.
¿Cómo hago que Ollama vaya más rápido en un MacBook Pro M5?
Elige un modelo adecuado a tu ancho de banda, confirma con `ollama ps` que corre al 100 % en GPU, cierra aplicaciones que consuman mucha memoria, reduce `num_ctx` si no necesitas un contexto largo, usa cuantización Q4_K_M en lugar de Q5/Q8, activa `OLLAMA_FLASH_ATTENTION=1` y mantén el MacBook Pro conectado y elevado en sesiones de más de 2–3 horas. Consulta la sección de aceleración arriba para la lista completa.
¿Puede el Mac Studio M5 Max ejecutar Llama 3.3 70B?
Sí, con 64 GB o 128 GB. 70B Q4 (~42,5 GB) necesita 64 GB y corre a unos 6–9 tokens/s estimados en el chip de 460 GB/s y 9–12 tokens/s en el de 614 GB/s. 70B Q5 (~50 GB) pide la configuración de 128 GB y corre a unos 7–10 tokens/s estimados.
¿Cómo se compara el M5 Max con la RTX 4090 para LLM local?
El M5 Max es más lento con modelos pequeños que caben en 24 GB (unos 75–100 frente a 90–120 tokens/s estimados con Llama 8B). Con modelos 70B la 4090 no puede alojarlos y recurre a descarga a CPU con unos 6–10 tokens/s, mientras que un M5 Max de 614 GB/s los ejecuta a unos 9–12 tokens/s estimados con aproximadamente un tercio del consumo.
¿Bastan 64 GB de RAM o necesito 128 GB?
Para un único modelo 70B Q4: 64 GB bastan. Para 70B Q5 o Q8, varios modelos simultáneos, contextos largos o ajuste fino: se recomiendan 128 GB. La cantidad de memoria no cambia la velocidad: un Mac Studio M5 Max de 64 GB y uno de 128 GB tienen ambos 614 GB/s.
¿Qué diferencia hay entre M5 Pro y M5 Max para LLM?
El M5 Pro tiene GPU de 16/20 núcleos, 307 GB/s de ancho de banda y hasta 64 GB. El M5 Max tiene GPU de 32/40 núcleos, 460/614 GB/s y hasta 128 GB. Como la velocidad de generación escala con el ancho de banda, el M5 Max es aproximadamente 1,5× (460 GB/s) a 2× (614 GB/s) más rápido con el mismo modelo. El M5 Ultra (solo Mac Studio) llega más lejos: hasta GPU de 80 núcleos, hasta 1,2 TB/s y hasta 512 GB.
¿Qué tan rápido es el Mac Studio M5 Ultra para LLM local?
MacStories midió 48 tokens/s generando con Qwen3.8 27B en un M5 Ultra de 256 GB (RTX 5090: 59) y 108 tokens/s con un modelo Flash-Next más pequeño, un 54 % más rápido que un M3 Ultra. El techo de ancho de banda para un modelo 70B Q4 es de unos 29 tokens/s; aún no se ha publicado un resultado independiente con 70B.
¿El MacBook Pro sufre limitación térmica con inferencia LLM sostenida?
Sí, tras 2–3 horas de inferencia continua el MacBook Pro puede perder un 10–15 % de rendimiento (estimación). El Mac Studio mantiene el rendimiento completo 24/7.
¿Puedo ejecutar Stable Diffusion en Apple Silicon?
Sí, Stable Diffusion XL corre en M5 a unos 8–12 s/imagen (más lento que una RTX 4070, con unos 3 s). MLX lo admite de forma nativa.
¿MLX es más rápido que Ollama en Mac?
Normalmente, con modelos que tienen versión MLX: MLX suele ser más rápido que los modelos GGUF en llama.cpp, con diferencias de entre un 10 % y 2× según modelo y versión. Ollama añadió en marzo de 2026 un backend MLX que reduce la diferencia en modelos compatibles. Elige según tu flujo de trabajo, no por la velocidad bruta.
¿Cuánta electricidad consume el Mac Studio M5 Max con inferencia LLM?
Se estiman 65–100 W sostenidos para el M5 Max con carga de LLM; Apple indica hasta 480 W de potencia continua máxima para el chasis del Mac Studio, que la inferencia por sí sola no alcanza. Un mes de inferencia 24/7 (720 horas) a 100 W son ~72 kWh, unos 8–12 $ de electricidad en EE. UU.; un equipo con RTX 4090 cuesta unos 40–60 $.
¿El Mac mini tiene ya M5 Pro?
Sí. El Mac mini M5 Pro parte de 1.699 $ (24 GB, hasta 64 GB), 307 GB/s de ancho de banda y Thunderbolt 5, y se envía desde el 22 de septiembre de 2026: el Mac con M5 Pro más barato jamás ofrecido.
¿El Mac Studio sigue ofreciendo una configuración M5 Pro?
No. Desde la actualización del 25 de agosto de 2026, el Mac Studio empieza en el M5 Max (2.499 $). El Mac mini es ahora la puerta de entrada al chip M5 Pro.
¿Qué es el Mac Studio M5 Ultra y cuánta memoria admite?
El M5 Ultra es un chip por encima del M5 Max, exclusivo del Mac Studio, desde 5.499 $ (96 GB). Escala a 256 GB ahora y a 512 GB a finales de octubre de 2026 (se espera muy por encima de 10.000 $), con hasta 1,2 TB/s de ancho de banda.
¿Puedo hacer ajuste fino de modelos en Apple Silicon?
Sí, el ajuste fino con LoRA funciona bien. El ajuste fino de todos los pesos es más lento que en una GPU de escritorio (aún sin soporte de entrenamiento distribuido).
¿Apple Silicon es bueno para inferencia pero malo para entrenar?
En parte. La inferencia es excelente. El entrenamiento/ajuste fino funciona pero es más lento que en NVIDIA. El framework MLX mejora rápidamente.
¿Cómo ayuda el Neural Engine con los LLM?
La generación de tokens está limitada por el ancho de banda de memoria, no por el Neural Engine. En chips de la familia M5, los aceleradores neuronales de cada núcleo de GPU aceleran el procesamiento del prompt (tiempo hasta el primer token) en los motores que los usan, como MLX y el backend MLX de Ollama.
¿Puedo ejecutar varios modelos a la vez en un M5 Max de 128 GB?
Sí. 128 GB permiten dos modelos de 32B, o uno de 70B más uno de 14B, a la vez con velocidad decente.
¿Cuánto tarda la configuración de un LLM local en Mac?
De 15 a 30 minutos desde un Mac recién arrancado hasta ejecutar el primer modelo 70B con Ollama (incluyendo 20–40 min de descarga con internet rápido).
¿Apple Silicon funciona con los modelos de pesos abiertos más recientes?
La mayoría de familias de pesos abiertos (Llama, Qwen, Mistral, Gemma, DeepSeek) funcionan con llama.cpp (GGUF) o MLX a los pocos días de lanzarse. Consulta la comunidad MLX en Hugging Face y la biblioteca de Ollama para ver la lista actual.
¿Debería comprar el Mac mini M6 o el Mac mini M5 Pro para LLM local?
El M6 es el Mac mini de entrada (899 $, 16–32 GB, aprox. 153–170 GB/s) y sirve para modelos pequeños. El M5 Pro (1.699 $, hasta 64 GB, 307 GB/s) tiene aproximadamente el doble de ancho de banda y memoria, así que es la opción para LLM local.
¿Vale la pena un Mac Studio reacondicionado?
Sí. Apple vende Macs reacondicionados con un año de garantía, normalmente con un descuento respecto al precio de uno nuevo.
¿Es mejor comprar el M5 Max con 64 GB o con 128 GB?
Compra 64 GB para un único modelo 70B Q4 y modelos de 32B; 128 GB para 70B Q5/Q8, contextos largos o varios modelos a la vez. Fíjate también en el nivel de GPU: en el MacBook Pro, 64 GB vienen con el chip de 460 GB/s y 128 GB con el de 614 GB/s.