关键要点
- ✅ 各芯片带宽:M5 153.6GB/s · M5 Pro 307GB/s · M5 Max 460GB/s(32核GPU)或614GB/s(40核GPU) · M5 Ultra最高1.2TB/s。生成速度大致等于带宽 ÷ 模型大小 × 60–80%——详见下方带宽章节。
- ✅ 自2026年9月22日起发货:Mac mini M5 Pro起价$1,699(最高64GB,307GB/s)——有史以来最便宜的M5 Pro Mac,比MacBook Pro更便宜。
- ✅ Mac Studio M5 Max起价$2,499(最高128GB,614GB/s)和Mac Studio M5 Ultra起价$5,499(最高512GB,最高1.2TB/s)已在发货。512GB配置的M5 Ultra将于2026年10月下旬发货,预计价格远超$10,000。
- Mac Studio不再提供M5 Pro档位,起步即为M5 Max。Mac mini现在是M5 Pro芯片的入门选择。
- MacBook Pro 16英寸M5 Max(自2026年3月起有售)在相同GPU档位下与Mac Studio M5 Max的内存带宽相同:460GB/s(32核GPU)和614GB/s(40核GPU),不存在因机身形态造成的带宽损失。
- 所有M5 Pro/Max配置:内存带宽307–614GB/s(RTX 4090为1,008GB/s,但显存仅24GB)。M5 Ultra最高可达1.2TB/s。
- 运行安静:MacBook Pro在持续推理时风扇会变得可闻;Mac Studio和Mac mini在典型本地LLM负载下风扇很少高速运转。
- MLX通常是Apple Silicon上最快的运行时。Ollama于2026年3月加入了MLX后端(预览版,Ollama 0.19,最初面向32GB以上Mac上的部分模型);其他模型仍通过llama.cpp的Metal后端运行。
- 统一内存:从24GB(Mac mini M5 Pro基础款)到512GB(Mac Studio M5 Ultra),任何模型均可使用。没有独立显卡那样的显存上限。
📍 简单一句话
M5 Pro提供307GB/s、M5 Max提供460–614GB/s、M5 Ultra提供最高1.2TB/s的内存带宽,决定Mac每秒生成多少token的是这个数字,而不是核心数;Mac mini M5 Pro起价$1,699,Mac Studio M5 Max起价$2,499,Mac Studio M5 Ultra起价$5,499。
💬 简单来说
Apple Silicon Mac采用统一内存:CPU、GPU和AI引擎共用同一块高速内存。因此128GB的M5 Max可以完整载入一个70B模型,而任何单张消费级NVIDIA显卡(24–32GB显存)都放不下;M5 Ultra的512GB选项则走得更远。
🔄 2026年10月11日更新:2026年9月22日的发货日期已过,Mac mini M5 Pro、Mac Studio M5 Max和Mac Studio M5 Ultra(96–256GB)现已有货;只有512GB配置的M5 Ultra仍在等待(2026年10月下旬)。本次更新新增了内存带宽章节,替换了超出各芯片带宽上限的每秒token数区间,并加入了MacStories评测中首批独立的M5 Ultra实测数据。Mac mini M5 Pro和Mac Studio M5 Max的每秒token数仍是由带宽和MacBook Pro结果推算的估计值,并非在这些机身上的实测。
为什么Apple Silicon M5对本地LLM很重要
Apple Silicon为AI工作负载带来了截然不同的架构。以下是它对本地LLM用户的意义。
- 统一内存架构:M5 Pro和M5 Max共用单一的高速内存池(24GB至128GB),CPU、GPU和神经网络引擎可同时访问。没有显存/内存瓶颈,模型驻留在高速内存中,推理保持流畅。
- 内存带宽才是真正的瓶颈:LLM生成受限于内存而非算力——每生成一个token都要读取一遍模型权重。M5 Max的460–614GB/s在小模型上不及RTX 4090的1,008GB/s,但它可容纳最高128GB(4090仅24GB),因此能运行4090放不下的模型。M5 Ultra最高1.2TB/s,超过4090,且可容纳最高512GB。
- Mac上的“显存”就是统一内存:不存在独立的显存池。GPU与macOS共用同一块内存,默认情况下macOS允许GPU锁定大约三分之二到四分之三的总内存(比例随内存大小而变)。64GB的Mac可为模型和上下文预留约48GB;可用`sudo sysctl iogpu.wired_limit_mb=<MB>`提高上限(重启后恢复)。
- Apple Fusion架构(M5新增):M5 Pro和M5 Max将CPU和GPU拆分到同一封装内两个独立的3nm芯片上,可独立扩展并优化散热,相比单片式芯片提升能效。
- 每个GPU核心内置神经加速器:每个GPU核心都包含专用神经加速器,与共享的神经网络引擎互补。MLX以及Ollama的MLX后端等能利用它们的运行时,在M5系列芯片上处理提示词更快。
- 相比M4的代际提升:苹果宣称多线程CPU性能比M4 Pro和M4 Max最高提升30%。对LLM生成而言,关键是带宽:M5 Pro为307GB/s,M4 Pro为273GB/s(+12%);顶配M5 Max为614GB/s,M4 Max为546GB/s(+12%)。得益于每核心的神经加速器,提示词处理的提升更大。
- Thunderbolt 5(M5 Pro/Max):M5 Pro和M5 Max配备Thunderbolt 5,基础带宽80Gbps(Thunderbolt 4的两倍),适合高速外置存储和多显示器。
- 通过Apple N1芯片支持Wi-Fi 7和蓝牙6:M5系统搭载新的N1无线芯片,支持Wi-Fi 7和蓝牙6.0,延迟更低,适合使用远程推理客户端或云端模型API。
- MLX框架快速成熟:苹果的MLX框架以优化内核支持Llama 3.3、Qwen、Mistral和Gemma。Ollama自2026年3月起为Apple Silicon提供MLX后端(预览版),最初仅限部分模型。
- 能效是真实的:M5 Max持续推理时功耗估计约65–100W(为估计值,非苹果官方数据;苹果标称Mac Studio整机最大持续功率为480W)。以100W连续推理一个月(720小时)约耗电72度,美国电费约$8–12。350W的RTX 4090同期约$40–60。
- 运行安静:Mac Studio的风扇在典型LLM负载下很少可闻;MacStories表示日常使用中听不到M5 Ultra Mac Studio的风扇声。MacBook Pro的风扇在持续推理时会变得可闻。
Apple Silicon M5对比表
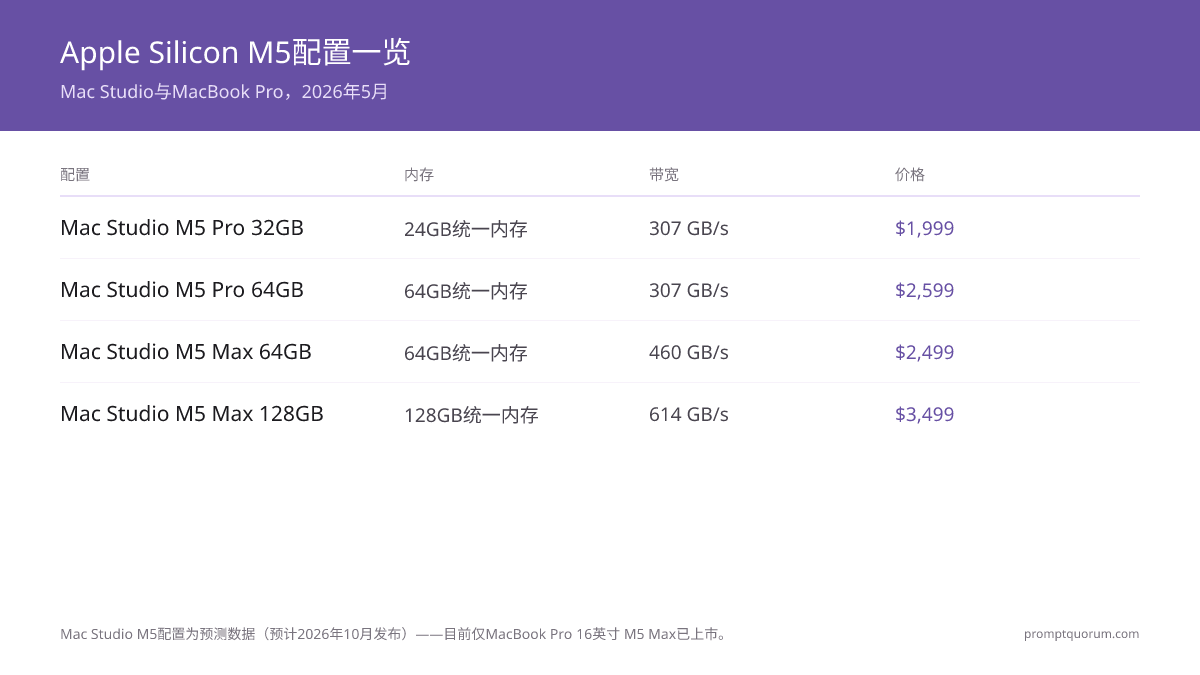
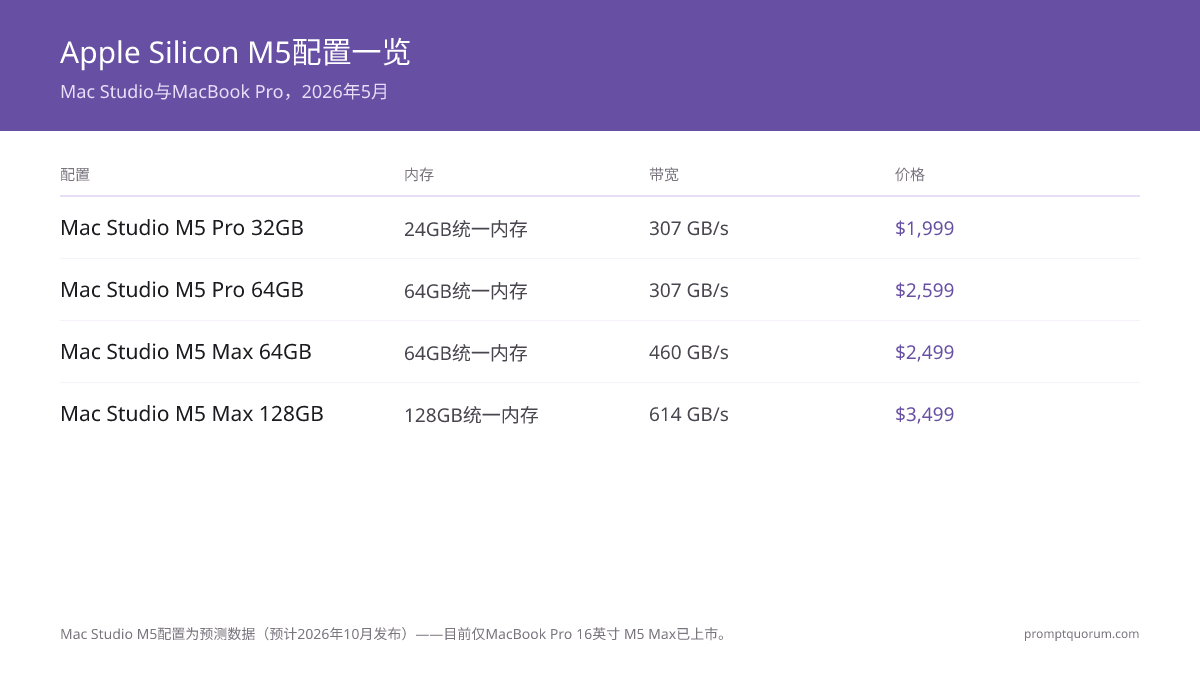
以下配置采用苹果2026年8月25日发布时的零售价。Mac mini、Mac Studio和MacBook Pro自2026年9月22日起发货,Mac Studio M5 Ultra 512GB配置除外(2026年10月下旬,预计价格远超$10,000)。价格:Apple Store美元价格。目前只有M5 Ultra有独立的第三方每秒token数实测——哪些是实测、哪些是估计,请见性能章节。
配置 | 芯片 | GPU核心 | 内存 | 带宽 | 价格 | 适合 |
|---|---|---|---|---|---|---|
| Mac mini M5 Pro 24GB | M5 Pro | 16 | 24GB 统一内存 | 307 GB/s | $1,699 | 最便宜的M5 Pro,7B–14B |
| Mac mini M5 Pro 64GB | M5 Pro | 20 | 64GB 统一内存 | 307 GB/s | $2,699 | 30B模型,最便宜的64GB |
| Mac Studio M5 Max 36GB | M5 Max | 32 | 36GB 统一内存 | 460 GB/s | $2,499 | 入门级桌面 |
| Mac Studio M5 Max 64GB | M5 Max | 40 | 64GB 统一内存 | 614 GB/s | $3,499 | 70B Q4,最佳性价比 |
| Mac Studio M5 Max 128GB | M5 Max | 40 | 128GB 统一内存 | 614 GB/s | $5,099 | 70B Q5,高阶用户 |
| Mac Studio M5 Ultra 96GB | M5 Ultra | 64 | 96GB 统一内存 | 最高1.2 TB/s | $5,499 | 最大的本地模型 |
| Mac Studio M5 Ultra 512GB | M5 Ultra | 80 | 512GB 统一内存 | 最高1.2 TB/s | $10,000+(预估) | 超大模型,10月下旬发货 |
| MacBook Pro 16" M5 Max 64GB | M5 Max | 32 | 64GB 统一内存 | 460 GB/s | $3,499 | 便携,70B Q4 |
| MacBook Pro 16" M5 Max 128GB | M5 Max | 40 | 128GB 统一内存 | 614 GB/s | $4,499 | 便携,70B Q5 |
M5、M5 Pro、M5 Max和M5 Ultra内存带宽对比
内存带宽是决定Apple Silicon上本地LLM生成速度的规格,也是多数买家搜索的数字。表中列出各芯片的官方数值;M5 Max有两档带宽:32核GPU版为460GB/s,40核GPU版为614GB/s。数值均为理论最大值。
📍 简单一句话
Apple M5的内存带宽:M5为153.6GB/s,M5 Pro为307GB/s,M5 Max(32核GPU)为460GB/s,M5 Max(40核GPU)为614GB/s,M5 Ultra最高1.2TB/s。
💬 简单来说
带宽是芯片从内存读取模型的速度。生成一个token(几乎)要读取整个模型一遍,因此Mac的生成速度永远不会超过带宽除以模型大小。
- M5 Pro vs M5 Max:M5 Max的带宽是M5 Pro的1.5倍(32核GPU,460GB/s)或2倍(40核GPU,614GB/s),相同模型的生成速度也会相应更快。
- M5 Max vs M5 Ultra:M5 Ultra将两颗M5 Max连接起来,把40核GPU版M5 Max的614GB/s翻倍至约1.2TB/s——比上一代M3 Ultra的819GB/s高50%。
- 容量 vs 带宽:更大的内存不会让芯片更快。40核GPU的M5 Max无论64GB还是128GB,带宽都是614GB/s;额外的内存只能让你载入更大或更多的模型。
芯片 | GPU核心 | 最大内存 | 带宽 | 搭载机型 |
|---|---|---|---|---|
| M5 | 8–10 | 32GB | 153.6 GB/s | MacBook Air、14英寸MacBook Pro |
| M5 Pro | 16–20 | 64GB | 307 GB/s | MacBook Pro、Mac mini |
| M5 Max(32核GPU) | 32 | 36GB+ | 460 GB/s | MacBook Pro、Mac Studio |
| M5 Max(40核GPU) | 40 | 128GB | 614 GB/s | MacBook Pro、Mac Studio |
| M5 Ultra | 64–80 | 512GB | 1.2 TB/s (1,228.8 GB/s) | Mac Studio |
| M4 Max(参照) | 40 | 128GB | 546 GB/s | 上一代 |
| RTX 4090(参照) | 不适用 | 24GB VRAM | 1,008 GB/s | 独立显卡 |
带宽如何转化为每秒token数
下表是算术推算,而非基准测试:每秒token数上限 = 带宽 ÷ 模型文件大小。由于KV缓存读取、运行时开销和散热,实际生成速度会更低。混合专家(MoE)模型每个token只读取被激活的专家,因此可能比相同文件大小的稠密模型更快。
📍 简单一句话
生成速度的上限是内存带宽除以模型文件大小——例如614GB/s ÷ 42.5GB(Llama 3.3 70B Q4)≈ 14 token/秒——优化良好的运行时通常能达到其60–80%。
💬 简单来说
先按想运行的最大模型选择芯片,再查看这张上限表:如果上限低于10 token/秒,无论买多少GPU核心,模型都会让人觉得慢。
- 如何阅读此表:数值为理论上限(token/秒)。乘以0.6–0.8即得到现实区间——614GB/s的M5 Max运行Llama 3.3 70B Q4,大约为9–12 token/秒。
- 独立验证:MacStories在M5 Ultra Mac Studio上用Qwen3.8 27B生成测得48 token/秒(6,091个token的提示词),RTX 5090(带宽1.79TB/s)为59 token/秒。实际速度跟随的是带宽而非核心数。
- 容量估算规则:模型文件加KV缓存必须装进统一内存的约三分之二到四分之三,因此70B Q4模型(约42.5GB)需要64GB的Mac;Q5和Q8版本需要128GB。
模型(Q4_K_M) | 文件大小 | M5 Pro 307 | M5 Max 460 | M5 Max 614 | M5 Ultra 1.2TB/s |
|---|---|---|---|---|---|
| Llama 3.1 8B | ~4.9GB | ~63 | ~94 | ~125 | ~250 |
| Mistral Small 24B | ~14GB | ~22 | ~33 | ~44 | ~88 |
| Qwen3 32B | ~20GB | ~15 | ~23 | ~31 | ~61 |
| Llama 3.3 70B | ~42.5GB | ~7 | ~11 | ~14 | ~29 |
Mac mini M5 Pro:本地LLM的全新低价入门选择
苹果于2026年8月25日首次把M5 Pro芯片放进Mac mini,此前M5 Pro只出现在MacBook Pro中。24GB–64GB统一内存、$1,699–$2,699的Mac mini M5 Pro,是达到M5 Pro 64GB内存上限最便宜的方式,价格低于MacBook Pro M5 Pro。Mac Studio现在起步即为M5 Max。自2026年9月22日起发货。
- CPU:15核或18核M5 Pro
- GPU:16核或20核M5 Pro GPU
- 内存:基础24GB,可选配48GB或64GB LPDDR5X统一内存
- 内存带宽:307GB/s(与MacBook Pro中的M5 Pro相同)
- 存储:512GB–2TB SSD(可选配)
- 接口:Thunderbolt 5(Mac mini首次配备)
- 连接:Wi-Fi 7、蓝牙6
- 价格:$1,699(15核CPU/16核GPU,24GB);$2,699(18核CPU/20核GPU,64GB)
- 供货:自2026年9月22日起发货
Mac Studio M5 Max 36GB:基础配置
基础款Mac Studio M5 Max起价$2,499,配32核GPU和36GB统一内存;更大的内存选项见下方40核GPU档。自2026年9月22日起发货。Mac Studio已完全不再提供M5 Pro档位——这是现在最便宜的Mac Studio。
- CPU:18核M5 Max
- GPU:32核M5 Max GPU
- 内存:该GPU档位为36GB LPDDR5X统一内存
- 内存带宽:460GB/s(与MacBook Pro中32核M5 Max相同)
- 存储:512GB–8TB SSD(可选配)
- 接口:Thunderbolt 5
- 功耗:持续推理估计65–100W;风扇很少转动
- 价格:$2,499
- 供货:自2026年9月22日起发货
Mac Studio M5 Max 48–128GB:70B本地LLM的最佳性价比
40核GPU的Mac Studio M5 Max起价$3,099(48GB),最高可配到128GB,售价$5,099。“70B最佳性价比”正是由这一档实现的:64GB为$3,499,且享有完整的614GB/s带宽。自2026年9月22日起发货。
- CPU:18核M5 Max
- GPU:40核M5 Max GPU
- 内存:基础48GB,可选配64GB或128GB LPDDR5X统一内存
- 内存带宽:614GB/s(与MacBook Pro中40核M5 Max相同)
- 存储:512GB–8TB SSD
- 接口:Thunderbolt 5
- 功耗:持续推理估计65–100W;多模型高负载时风扇适度运转
- 价格:$3,099(48GB);$3,499(64GB);$5,099(128GB)
- 供货:自2026年9月22日起发货
Mac Studio M5 Ultra:全新的最强性能档位
Mac Studio M5 Ultra是位于M5 Max之上的全新旗舰档位,起价$5,499(96GB),最高可扩展到512GB。96GB–256GB配置自2026年9月22日起发货;512GB配置于2026年10月下旬发货,预计价格远超$10,000。它在带宽高出50%的情况下,与上一代M3 Ultra的512GB内存上限持平。
- CPU:30核M5 Ultra(可选36核)
- GPU:基础64核,可选80核
- 内存:基础96GB,现可选配256GB,512GB将于2026年10月下旬提供
- 内存带宽:最高1.2TB/s(1,228.8GB/s;比M3 Ultra的819GB/s高50%)
- 存储:1TB–16TB SSD
- 接口:Thunderbolt 5
- 价格:$5,499(96GB基础款:30核CPU/64核GPU);512GB预计远超$10,000
- 供货:自2026年9月22日起发货(96–256GB);2026年10月下旬(512GB)
MacBook Pro 16英寸M5 Max:便携本地LLM
MacBook Pro 16英寸M5 Max($3,499–$4,499)以便携形态提供与Mac Studio相同的M5 Max芯片。在每个GPU档位上,内存带宽都与Mac Studio一致——32核GPU为460GB/s,40核GPU为614GB/s。请注意:64GB的MacBook Pro使用32核GPU,而64GB的Mac Studio使用40核GPU。持续推理时的热降频是便携性的代价。
- CPU:18核M5 Max(6个超级核心+12个性能核心)
- GPU:32核或40核M5 Max GPU
- 内存:64GB或128GB统一内存
- 显示屏:16.2英寸Liquid Retina XDR,3456×2234
- 内存带宽:460GB/s(64GB,32核GPU)或614GB/s(128GB,40核GPU)
- 存储:512GB–8TB SSD
- 电池:以视频播放时长标称;持续推理耗电快得多
- 重量:2.14公斤
- 接口:3个Thunderbolt 5、HDMI 2.1、SD卡槽、耳机孔
- 价格:$3,499(64GB,32核GPU)至$4,499(128GB,40核GPU)
🏆 我们的推荐:本地LLM该买哪款Mac
按使用场景给出明确的推荐。
- 🏆 💰 最便宜的M5 Pro:Mac mini M5 Pro($1,699,现货发售) • 原因:首款M5 Pro Mac mini,比包括MacBook Pro在内的任何获得M5 Pro的方式都便宜。24GB基础款可运行7B–14B,配到64GB可运行30B。 • 适合:注重预算、首次购买Apple Silicon的用户。 • 在Apple Store购买 →
- 🥇 70B最佳性价比:Mac Studio M5 Max 64GB($3,499,现货发售) • 原因:以完整614GB/s带宽运行Llama 3.3 70B Q4,估计约9–12 token/秒。桌面级散热意味着不会热降频。 • 适合:不需要便携、标准化70B工作流的开发者。 • 在Apple Store购买 →
- 🔥 最强性能:Mac Studio M5 Ultra 96GB($5,499,现货发售) • 原因:旗舰档位。带宽最高1.2TB/s——是M5 Max的两倍。512GB配置于2026年10月下旬发货,面向最大的本地模型。 • 状态:已有首批独立实测(MacStories:Qwen3.8 27B为48 token/秒,RTX 5090为59)。 • 在Apple Store购买 →
- 💼 最佳便携:MacBook Pro 16英寸M5 Max(64GB、460GB/s为$3,499;128GB、614GB/s为$4,499) • 原因:与Mac Studio同款M5 Max芯片,装在配Liquid Retina XDR显示屏的笔记本里。需接受因热降频导致持续速度下降10–15%。 • 替代方案:如果不需要便携,64GB的Mac Studio M5 Max($3,499)价格相同,带宽614GB/s,持续散热更好。 • 在Apple Store购买 →
本地LLM性能:基于带宽的估计与M5 Ultra独立实测
目前只有M5 Ultra有独立的第三方实测(MacStories,见本节末尾)。对于M5 Pro和M5 Max,下列区间是估计值:每个区间为带宽上限(带宽 ÷ 模型文件大小)的60–80%,并与社区报告和MacBook Pro结果交叉核对,并非在Mac mini或Mac Studio机身上的实验室测量。区间按内存带宽标注,因为64GB的MacBook Pro(460GB/s)和64GB的Mac Studio(614GB/s)并不相同。受macOS版本、运行时版本、量化和上下文长度影响,会有±10–15%的波动。RTX 4090参照数据为社区的大致数字。
- ## Llama 3.1 8B(Q4_K_M,约4.9GB) • M5 Pro(307GB/s):38–50 token/秒 • M5 Max(460GB/s):56–75 token/秒 • M5 Max(614GB/s):75–100 token/秒 • 参照(RTX 4090):90–120 token/秒
- ## Mistral Small 24B(Q4_K_M,约14GB) • M5 Pro(307GB/s):13–17 token/秒 • M5 Max(460GB/s):19–26 token/秒 • M5 Max(614GB/s):26–34 token/秒
- ## Qwen3 32B(Q4_K_M,约20GB) • M5 Pro(307GB/s):9–12 token/秒 • M5 Max(460GB/s):14–19 token/秒 • M5 Max(614GB/s):19–25 token/秒
- ## Llama 3.3 70B(Q4_K_M,约42.5GB) • M5 Pro 64GB(307GB/s):4–6 token/秒 • M5 Max(460GB/s):6–9 token/秒 • M5 Max(614GB/s):9–12 token/秒 • M5 Ultra:上限约29 token/秒(暂无70B独立实测) • 参照(RTX 4090):部分卸载到CPU时6–10 token/秒
- ## Llama 3.3 70B(Q5_K_M,约50GB) • M5 Pro 64GB:余量不足 • M5 Max 128GB(614GB/s):7–10 token/秒 • 参照(RTX 4090):无法运行(显存限制)
- ## Llama 3.3 70B(Q8_0,约75GB) • M5 Max 128GB(614GB/s):5–7 token/秒 • RTX 4090:无法运行(需要多GPU卸载)
- ## M5 Ultra独立实测结果(MacStories,256GB机器,oMLX) • Qwen3.8 27B,6,091个token的提示词:M5 Ultra生成48 token/秒,提示词读取1,701 token/秒,首个token耗时4.0秒——RTX 5090:59 token/秒、3,031 token/秒、2.0秒 • Qwen3.8 27B长上下文(生成):64K时38.9,128K时32.4,256K时24.3 token/秒——RTX 5090:49.6、40.4、30.0 • Flash-Next,短提示词:M5 Ultra为108 token/秒,M3 Ultra为70(+54%)
- ## 方法说明 M5 Pro和M5 Max的区间按带宽 ÷ 模型文件大小的60–80%推算,并与社区结果(例如我们M5 Pro vs M5 Max基准页面引用的MLX与GGUF对比测试)比对。M5 Ultra的数据是MacStories在macOS 27.0上使用oMLX 0.7.0.dev2的实测;模型名称沿用其原文。对于上文未列出的模型,任何M5 Ultra的每秒token数均应视为未经验证。
Apple Silicon M5 vs PC工作站(本地LLM)
Apple Silicon与NVIDIA理念不同。以下是坦率的对比。
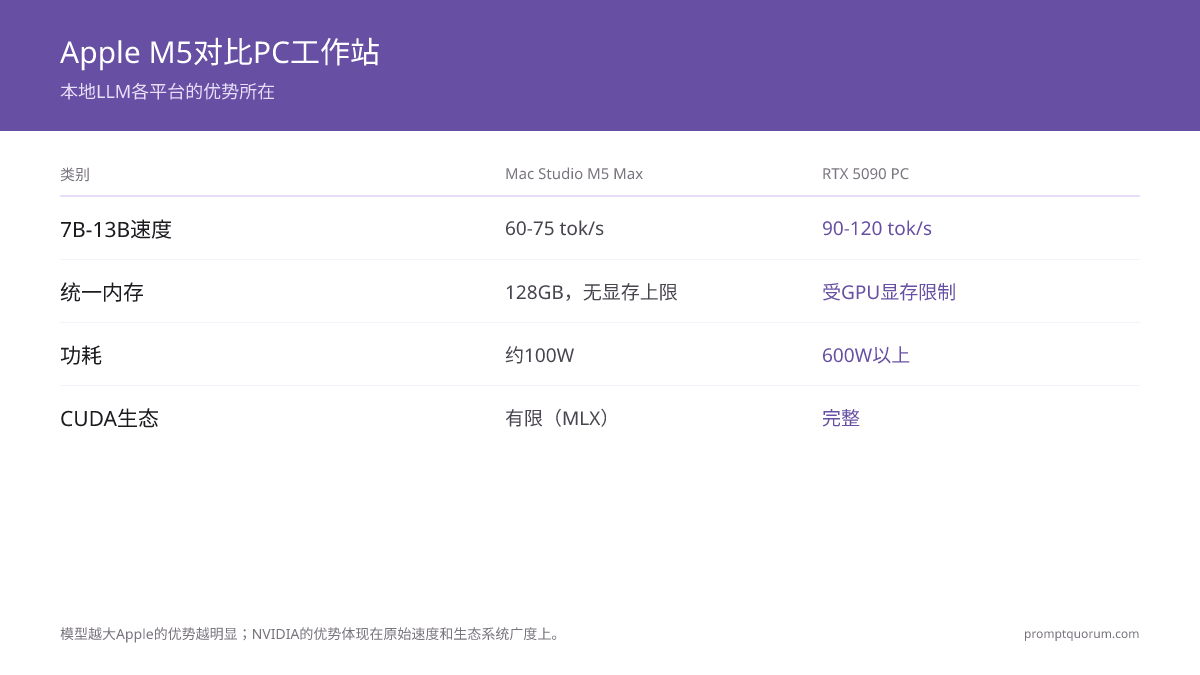
- ## Mac Studio M5 Max/Ultra胜出之处: • 统一内存:最高128GB(M5 Max)或512GB(M5 Ultra)可用于任何模型,没有显存上限 • 能效:约100W,同等PC则超过600W • 运行安静:典型负载下风扇很少可闻 • macOS生态:MLX、Metal、Core ML集成 • 总拥有成本:3年内电费更低 • 32GB以上的模型:RTX 5090的显存最高只有32GB
- ## PC工作站(RTX 4090/5090)胜出之处: • 装得进显存的模型的原始速度:MacStories测得Qwen3.8 27B上RTX 5090为59 token/秒,M5 Ultra为48,提示词读取约快1.8倍(3,031对1,701 token/秒) • CUDA生态广度:更多的模型、工具和研究代码 • 微调:PyTorch + CUDA对MLX占优 • 升级灵活:可更换GPU、增加显存 • 低价位档次:入门的RTX 4070 Ti($800–1,200)在小模型上胜过M5 Pro • LLM以外的AI:Stable Diffusion、训练、多模态在NVIDIA上通常更快
- ## 坦率的结论 对于30B–70B模型的纯本地LLM推理,Mac Studio M5 Max 128GB($5,099)可直接与$4,500以上的PC整机竞争,而Mac Studio M5 Ultra把上限推到了需要256GB或512GB的模型。统一内存的优势是真实且可衡量的。 对于能装进24–32GB显存的模型,搭载RTX 4090或5090的PC比任何Mac都快。模型越小,苹果的优势越小。 对于微调、训练、大规模Stable Diffusion或生产环境的PyTorch,PC + NVIDIA更胜一筹。MLX在进步,但差距仍在。
Apple Silicon上的MLX vs Ollama vs llama.cpp
M5上主要有三种推理引擎。哪一种适合你?
- ## MLX(苹果原生) • 性能:通常是M5上每秒token数最高的;原生Metal优化并支持神经加速器。 • 模型支持:持续增长(Llama、Qwen、Mistral、Gemma均可用) • 安装:以Python为主,需要熟悉命令行 • 最适合:追求最高性能的高阶用户 • 取舍:不如Ollama易用
- ## Ollama(跨平台) • 性能:GGUF模型通过llama.cpp的Metal后端运行;MLX后端(自Ollama 0.19、2026年3月起为预览版)可加速部分模型,尤其是M5系列芯片 • 模型支持:最大的模型库,每周新增模型 • 安装:一条命令即可安装,开箱即用 • 最适合:初学者和大多数开发者。提供REST API便于集成。 • 取舍:当模型有MLX版本时可能比原生MLX慢(差距因模型和版本而异)
- ## llama.cpp(跨平台,最底层的控制) • 性能:优化后与Ollama相当(Ollama对GGUF模型使用它) • 定制:对量化和推理参数的控制最多 • 安装:需要编译和命令行经验 • 最适合:研究人员、自定义量化流程 • 取舍:学习曲线比Ollama更陡
- ## 按用户类型推荐 • 初学者:Ollama(立即可用,文档丰富) • 开发者:Ollama REST API(易于集成到应用中) • 高阶用户:直接使用MLX(最高性能) • 研究人员:llama.cpp(最大定制性)
macOS快速上手(10步)
在Apple Silicon上运行第一个70B本地LLM的最快路径。
- 1购买你的Mac
Why it matters: 预算/入门选Mac mini M5 Pro,桌面性能选Mac Studio M5 Max或M5 Ultra,便携选MacBook Pro 16英寸M5 Max。 - 2macOS初始设置
Why it matters: 使用迁移助理(从旧Mac迁移)或全新安装。保持macOS为最新——苹果会在小版本更新中提供Metal性能改进。 - 3安装Homebrew
Why it matters: /bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)" — 后续所有软件的包管理器。 - 4安装Ollama
Why it matters: brew install ollama — 一条命令轻松安装。 - 5启动Ollama服务
Why it matters: ollama serve(前台运行),或使用“应用程序”文件夹中的Ollama.app。 - 6拉取第一个测试模型
Why it matters: ollama pull llama3.1:8b — 用小模型验证安装(下载约4GB)。 - 7测试基本推理
Why it matters: ollama run llama3.1:8b "Explain local LLMs in one sentence" --verbose — eval rate一行显示你的每秒token数。 - 8拉取目标大模型
Why it matters: ollama pull llama3.1:70b-instruct-q4_K_M(下载约40GB)。网速快时需20–40分钟,并需要64GB或更大内存的Mac。 - 9监控性能
Why it matters: asitop显示Apple Silicon的资源使用情况。在第二个终端中运行:brew install asitop && asitop。 - 10可选:安装LM Studio作为图形界面
Why it matters: 从lmstudio.ai下载。对非开发者比命令行更简单;包含面向Apple Silicon的MLX引擎。
如何在Apple Silicon M5上加速Ollama
Apple Silicon上的大多数Ollama安装默认已走快速路径,因此下面的清单是去除悄悄拖慢速度的因素,而不是做特殊调优。
📍 简单一句话
用`ollama ps`确认模型100%在GPU上运行,释放统一内存,缩短上下文长度,使用Q4量化,启用flash attention,并让MacBook Pro接通电源、垫高散热——生成速度受带宽限制,因此最大的收益来自选择与带宽匹配的模型。
💬 简单来说
Ollama在M5 Mac上通常默认就很快——大多数速度问题来自占用统一内存的其他东西、对你的带宽来说过大的模型,或过热的笔记本,而不是漏掉的某个设置。
- 先让模型匹配你的带宽。每秒token数大致被限制在带宽 ÷ 模型文件大小附近(见上方带宽章节)。307GB/s的M5 Pro上42GB的70B模型,无论怎么调优都超不过约7 token/秒;20GB的32B模型可达约15。换成更小的模型或量化是最大的提速手段。
- 确认模型已完全卸载到GPU,而不是回退到CPU。载入模型后运行`ollama ps`——PROCESSOR一列应显示100% GPU。CPU/GPU拆分通常意味着模型放不进macOS允许GPU使用的内存,而不是缺少某个设置。
- 长时间使用前释放统一内存。内存由macOS和模型共用——后台开着许多标签页的浏览器、Docker Desktop或Xcode,可能占走Ollama数GB内存。载入大模型前先退出它们,并用活动监视器或`asitop`检查可用内存。对大模型可用`sudo sysctl iogpu.wired_limit_mb=<MB>`提高GPU内存上限(重启后恢复)。
- 不需要时缩小上下文窗口。对简短对话,在Modelfile或API请求中设置较小的`num_ctx`(如4096而不是32K)——可降低KV缓存的内存压力并加快生成。
- 启用flash attention和量化KV缓存。`OLLAMA_FLASH_ATTENTION=1`和`OLLAMA_KV_CACHE_TYPE=q8_0`可减少KV缓存内存占用,以很小的质量损失加快长上下文处理。
- 让量化匹配你的实际质量需求。Q4_K_M明显比Q8_0或Q5_K_M更快,质量损失很小且通常可接受(见量化指南)。如果某个模型比上面的基准更慢,先试试Q4版本,再怀疑硬件。
- 持续推理时让MacBook Pro接通电源并垫高。MacBook Pro在连续负载2–3小时后可能降频10–15%,因为较薄的机身内热量积聚。改善气流的支架和使用交流电源可推迟降频。对于超过数小时的会话,Mac Studio的散热能保持全部性能。
- 更新macOS和Ollama。苹果在小版本更新中提供Metal性能改进,Ollama也会定期发布更快的后端——包括对更多模型的MLX支持。在新的M5芯片上运行旧版本会白白浪费性能。
- 除非需要,避免同时运行多个模型。每个已载入的模型都会占用自己的那份统一内存。`OLLAMA_MAX_LOADED_MODELS`控制Ollama同时驻留的模型数量。
# Check whether a model is fully offloaded to GPU (PROCESSOR column)
ollama ps

# Measure real speed: the "eval rate" line is generation tokens/sec
ollama run llama3.1:8b --verbose

# Faster long-context inference: flash attention + 8-bit KV cache
OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 ollama serve

# Or limit Ollama to one resident model at a time
OLLAMA_MAX_LOADED_MODELS=1 ollama serve

# Smaller context window in a Modelfile: PARAMETER num_ctx 4096
决策矩阵:该买哪种Mac配置
用这个矩阵按使用场景找到最适合你的配置。内存相同时,选带宽更高的。
- 1. 预算优先,愿意用较小的模型(7–14B):Mac mini M5 Pro 24GB($1,699)——史上最便宜的M5 Pro
- 2. 想在低预算桌面上运行30B模型:Mac mini M5 Pro 64GB($2,699)
- 3. 想舒适地运行70B模型:Mac Studio M5 Max 64GB($3,499)
- 4. 需要32K以上上下文窗口的70B Q5:Mac Studio M5 Max 128GB($5,099)
- 5. 需要256GB–512GB来运行最大的本地模型:Mac Studio M5 Ultra($5,499–$10,000+)
- 6. 便携的本地LLM,可接受热降频:MacBook Pro 16英寸M5 Max 64GB($3,499)
- 7. 已在macOS生态中(Xcode、Final Cut Pro):任意Mac Studio M5配置
- 8. 用MLX做研究/微调实验:Mac Studio M5 Max 128GB或M5 Ultra(内存余量)
- 9. 想要最大程度的安静和待机运行:Mac Studio(正常负载下风扇很少转动)
- 10. 预算$4,000以上且需要便携:MacBook Pro 16英寸M5 Max 128GB($4,499)
- 11. 考虑替代方案:PC RTX 4090($3,000以上)或AMD Ryzen AI Max+迷你主机($1,600–2,000)
什么时候Apple Silicon M5不是本地LLM的正确选择
Apple Silicon很出色,但并非万能。在以下情况下应避免为本地LLM选择Mac。
- 你需要仅限CUDA的工作流:大多数LLM推理可在Apple Silicon上运行,但使用torch.cuda的微调、vLLM的CUDA内核以及专有CUDA研究代码无法在MLX上运行。如果你的工作大部分依赖CUDA,请选RTX GPU。
- 你大量使用Stable Diffusion:扩散模型在M5上通常比RTX 4090慢。如果图像生成占你工作流的30%以上,PC + RTX更有利。
- 预算是绝对优先:$1,500的RTX 4070 Ti PC在小模型推理速度上胜过Mac mini M5 Pro。如果只看预算,PC更便宜。
- 你需要工作站可升级:Mac Studio的内存和存储在购买时即固定。PC允许逐步升级。使用5年以上,PC长期可能更便宜。
- 你要求小模型达到三位数的每秒token数:RTX 4090在Llama 8B上可达90–120 token/秒。M5 Max估计为75–100。对于高吞吐推理(服务多用户),NVIDIA仍然领先。
- 你本来就不使用macOS:仅为本地LLM从Windows/Linux切换生态不值得,除非你出于其他原因也想用macOS。
- 你需要7×24小时生产级推理:Mac Studio很出色,但为突发使用而设计。对于有SLA要求的持续推理,企业级NVIDIA工作站更稳妥。
常见问题
M5 Pro、M5 Max和M5 Ultra的内存带宽是多少?
M5为153.6GB/s,M5 Pro为307GB/s,M5 Max为460GB/s(32核GPU)或614GB/s(40核GPU),M5 Ultra最高1.2TB/s(1,228.8GB/s)。对LLM生成而言,带宽比GPU核心数更重要,因为每个token都要从内存读取一遍模型权重。
M5 Mac有多少显存?
没有独立显存——M5 Mac采用CPU和GPU共用的统一内存。默认情况下macOS允许GPU使用约三分之二到四分之三的总内存,因此64GB的Mac可给模型约48GB。M5 Pro最高64GB,M5 Max最高128GB,M5 Ultra最高512GB。
如何让Ollama在MacBook Pro M5上跑得更快?
选择与带宽匹配的模型,用`ollama ps`确认其100%在GPU上运行,关闭占用内存的后台应用,不需要长上下文时降低`num_ctx`,使用Q4_K_M量化而非Q5/Q8,启用`OLLAMA_FLASH_ATTENTION=1`,并在超过2–3小时的会话中让MacBook Pro接通电源并垫高。完整清单见上方加速章节。
Mac Studio M5 Max能运行Llama 3.3 70B吗?
可以,配64GB或128GB。70B Q4(约42.5GB)需要64GB,460GB/s的芯片上估计约6–9 token/秒,614GB/s的芯片上9–12 token/秒。70B Q5(约50GB)需要128GB配置,估计约7–10 token/秒。
M5 Max与RTX 4090在本地LLM上相比如何?
在24GB能装下的小模型上,M5 Max更慢(Llama 8B估计75–100对90–120 token/秒)。对70B模型,4090放不下,只能回退到CPU卸载,约6–10 token/秒,而614GB/s的M5 Max估计约9–12 token/秒,功耗约为三分之一。
64GB内存够用,还是需要128GB?
单个70B Q4模型:64GB足够。70B Q5或Q8、多个并发模型、长上下文或微调:建议128GB。内存容量不会改变速度——64GB和128GB的Mac Studio M5 Max带宽都是614GB/s。
M5 Pro和M5 Max在LLM方面有什么区别?
M5 Pro为16/20核GPU,带宽307GB/s,最高64GB。M5 Max为32/40核GPU,460/614GB/s,最高128GB。由于生成速度随带宽扩展,相同模型下M5 Max比M5 Pro快约1.5倍(460GB/s)到2倍(614GB/s)。M5 Ultra(仅Mac Studio)更进一步:最高80核GPU、最高1.2TB/s、最高512GB。
Mac Studio M5 Ultra运行本地LLM有多快?
MacStories在256GB的M5 Ultra上用Qwen3.8 27B生成测得48 token/秒(RTX 5090为59),在较小的Flash-Next模型上为108 token/秒,比M3 Ultra快约54%。70B Q4模型的带宽上限约为29 token/秒;目前尚无70B的独立结果。
MacBook Pro在持续LLM推理时会热降频吗?
会。连续推理2–3小时后,MacBook Pro性能可能下降10–15%(估计)。Mac Studio可全天候保持全部性能。
我可以在Apple Silicon上运行Stable Diffusion吗?
可以,Stable Diffusion XL在M5上每张图约8–12秒(比RTX 4070的约3秒慢)。MLX原生支持。
在Mac上MLX比Ollama更快吗?
通常如此,针对有MLX版本的模型:MLX一般比llama.cpp上的GGUF模型更快,据报道差距从约10%到2倍不等,取决于模型和版本。Ollama于2026年3月加入的MLX后端缩小了对受支持模型的差距。请根据工作流而非原始速度来选择。
Mac Studio M5 Max做LLM推理耗电多少?
M5 Max在LLM负载下估计持续65–100W;苹果标称Mac Studio整机最大持续功率为480W,仅靠推理达不到。以100W 24/7推理一个月(720小时)约72度电,美国电费约$8–12;RTX 4090方案约$40–60。
Mac mini现在有M5 Pro了吗?
有。Mac mini M5 Pro起价$1,699(24GB,最高64GB),带宽307GB/s,配备Thunderbolt 5,自2026年9月22日起发货——史上最便宜的M5 Pro Mac。
Mac Studio还提供M5 Pro配置吗?
不提供。自2026年8月25日的更新起,Mac Studio从M5 Max($2,499)起步。Mac mini现在是M5 Pro芯片的入门选择。
Mac Studio M5 Ultra是什么,支持多少内存?
M5 Ultra是位于M5 Max之上的芯片,仅用于Mac Studio,起价$5,499(96GB)。现可扩展到256GB,2026年10月下旬提供512GB(预计远超$10,000),带宽最高1.2TB/s。
我可以在Apple Silicon上微调模型吗?
可以,LoRA微调效果良好。全权重微调比桌面GPU慢(尚不支持分布式训练)。
Apple Silicon适合推理但不适合训练吗?
部分如此。推理表现出色。训练/微调可行,但比NVIDIA慢。MLX框架正在快速改进。
神经网络引擎对LLM有何帮助?
token生成受限于内存带宽,而非神经网络引擎。在M5系列芯片上,每个GPU核心内的神经加速器会在能利用它们的运行时(如MLX和Ollama的MLX后端)中加快提示词处理(首个token时间)。
我可以在M5 Max 128GB上同时运行多个模型吗?
可以。128GB允许同时运行两个32B模型,或一个70B加一个14B,速度尚可。
在Mac上设置本地LLM通常需要多久?
从全新Mac到通过Ollama运行第一个70B模型需15–30分钟(含网速快时20–40分钟的模型下载)。
Apple Silicon能运行最新的开源权重模型吗?
大多数开源权重系列——Llama、Qwen、Mistral、Gemma、DeepSeek——在发布后几天内即可通过llama.cpp(GGUF)或MLX运行。请查看Hugging Face上的MLX社区和Ollama模型库获取最新列表。
本地LLM该买Mac mini M6还是Mac mini M5 Pro?
M6是入门级Mac mini($899,16–32GB,带宽约153–170GB/s),适合小模型。M5 Pro($1,699,最高64GB,307GB/s)的带宽和内存约为其两倍,是本地LLM的首选。
翻新的Mac Studio值得考虑吗?
值得。苹果销售翻新Mac并提供一年保修,价格通常比新品更低。
M5 Max选64GB还是128GB更好?
单个70B Q4模型和32B级模型选64GB;70B Q5/Q8、长上下文或同时运行多个模型选128GB。还要看GPU档位:MacBook Pro上64GB搭配460GB/s的芯片,128GB搭配614GB/s的芯片。