Key Takeaways
- ✅ 칩별 대역폭: M5 153.6GB/s · M5 Pro 307GB/s · M5 Max 460GB/s(32코어 GPU) 또는 614GB/s(40코어 GPU) · M5 Ultra 최대 1.2TB/s. 생성 속도는 대략 대역폭 ÷ 모델 크기 × 60–80%입니다. 아래 대역폭 섹션을 참고하세요.
- ✅ 2026년 9월 22일부터 출하 중: Mac mini M5 Pro는 $1,699부터(최대 64GB, 307GB/s)로, MacBook Pro보다 저렴한 역대 최저가 M5 Pro Mac입니다.
- ✅ Mac Studio M5 Max($2,499부터, 최대 128GB, 614GB/s)와 Mac Studio M5 Ultra($5,499부터, 최대 512GB, 최대 1.2TB/s)가 출하 중입니다. 512GB M5 Ultra 구성은 2026년 10월 하순에 출하되며 $10,000를 크게 웃돌 전망입니다.
- Mac Studio는 더 이상 M5 Pro 등급을 제공하지 않으며 M5 Max부터 시작합니다. M5 Pro 칩의 진입점은 이제 Mac mini입니다.
- MacBook Pro 16인치 M5 Max(2026년 3월부터 판매)는 같은 GPU 등급에서 Mac Studio M5 Max와 메모리 대역폭이 같습니다. 460GB/s(32코어 GPU)와 614GB/s(40코어 GPU)이며 폼팩터로 인한 대역폭 손해는 없습니다.
- 모든 M5 Pro/Max 구성: 메모리 대역폭 307–614GB/s(RTX 4090은 1,008GB/s이지만 VRAM은 24GB). M5 Ultra는 최대 1.2TB/s에 이릅니다.
- 조용한 동작: MacBook Pro는 지속적인 추론 시 팬 소음이 들리지만, Mac Studio와 Mac mini는 일반적인 로컬 LLM 부하에서 팬이 거의 돌지 않습니다.
- MLX는 보통 Apple Silicon에서 가장 빠른 런타임입니다. Ollama는 2026년 3월 MLX 백엔드를 추가했습니다(프리뷰, Ollama 0.19, 처음에는 32GB 초과 Mac의 일부 모델 대상). 나머지 모델은 llama.cpp의 Metal 백엔드로 실행됩니다.
- 통합 메모리: 24GB(Mac mini M5 Pro 기본)부터 512GB(Mac Studio M5 Ultra)까지 어떤 모델에도 사용할 수 있습니다. 개별 GPU처럼 별도의 VRAM 상한이 없습니다.
M5 Pro는 307GB/s, M5 Max는 460–614GB/s, M5 Ultra는 최대 1.2TB/s의 메모리 대역폭을 제공하며, Mac이 초당 몇 개의 토큰을 생성하는지는 코어 수가 아니라 이 수치가 결정합니다. Mac mini M5 Pro는 $1,699, Mac Studio M5 Max는 $2,499, Mac Studio M5 Ultra는 $5,499부터 시작합니다.
Apple Silicon Mac은 통합 메모리를 사용합니다. CPU, GPU, AI 엔진이 같은 고속 메모리 풀을 공유하기 때문에, 128GB M5 Max는 단일 소비자용 NVIDIA GPU(VRAM 24–32GB)로는 담을 수 없는 70B 모델 전체를 불러올 수 있고, M5 Ultra의 512GB 옵션은 그보다 더 나아갑니다.
🔄 2026년 10월 11일 업데이트: 2026년 9월 22일 출하일이 지나 Mac mini M5 Pro, Mac Studio M5 Max, Mac Studio M5 Ultra(96–256GB)를 구매할 수 있습니다. 512GB M5 Ultra 구성만 아직 대기 중입니다(2026년 10월 하순). 이번 업데이트에서는 메모리 대역폭 섹션을 추가하고, 각 칩의 대역폭 상한을 넘던 초당 토큰 범위를 교체했으며, MacStories 리뷰의 첫 독립 M5 Ultra 측정값을 추가했습니다. Mac mini M5 Pro와 Mac Studio M5 Max의 초당 토큰 수치는 대역폭과 MacBook Pro 결과에서 도출한 추정치이며, 해당 본체에서 측정한 값이 아닙니다.
로컬 LLM에 Apple Silicon M5가 중요한 이유
Apple Silicon은 AI 워크로드를 위한 근본적으로 다른 아키텍처입니다. 로컬 LLM 사용자에게 중요한 이유를 정리했습니다.
- 통합 메모리 아키텍처: M5 Pro와 M5 Max는 CPU, GPU, Neural Engine이 동시에 접근하는 단일 고속 메모리 풀(24GB–128GB)을 공유합니다. VRAM/RAM 병목이 없고, 모델이 고속 메모리에 머물러 추론 응답성이 유지됩니다.
- 메모리 대역폭이 진짜 병목: LLM 생성은 연산이 아니라 메모리에 좌우되며, 토큰 하나를 생성할 때마다 모델 가중치를 한 번 읽습니다. M5 Max의 460–614GB/s는 소형 모델에서 RTX 4090의 1,008GB/s에 못 미치지만, 24GB 대비 최대 128GB를 담을 수 있어 4090에 들어가지 않는 모델을 실행합니다. M5 Ultra는 최대 1.2TB/s로 4090을 넘어서며 최대 512GB를 담습니다.
- Mac의 'VRAM'은 통합 메모리: 별도의 VRAM 풀은 없습니다. GPU는 macOS와 같은 메모리를 사용하며, 기본적으로 macOS는 GPU가 전체 RAM의 약 3분의 2에서 4분의 3을 고정하도록 허용합니다(비율은 RAM 크기에 따라 다름). 64GB Mac에서는 모델과 컨텍스트에 약 48GB를 예상하세요. 한도는 `sudo sysctl iogpu.wired_limit_mb=<MB>`로 올릴 수 있습니다(재부팅 시 초기화).
- Apple Fusion 아키텍처(M5 신규): M5 Pro와 M5 Max는 CPU와 GPU를 한 패키지 안의 별도 3nm 다이로 분리하여 독립적인 확장과 열 최적화를 가능하게 하고, 모놀리식 칩보다 전력 효율을 높입니다.
- 모든 GPU 코어의 뉴럴 액셀러레이터: 각 GPU 코어에 AI 워크로드용 전용 뉴럴 액셀러레이터가 있어 공유 Neural Engine을 보완합니다. MLX나 Ollama의 MLX 백엔드처럼 이를 활용하는 런타임에서는 M5 계열 칩에서 프롬프트 처리가 더 빨라집니다.
- M4 대비 세대 향상: Apple은 M4 Pro/M4 Max 대비 멀티스레드 CPU 성능이 최대 30% 향상되었다고 밝힙니다. LLM 생성에서 중요한 것은 대역폭입니다. M5 Pro 307GB/s 대 M4 Pro 273GB/s(+12%), 최상위 M5 Max 614GB/s 대 M4 Max 546GB/s(+12%)입니다. 코어별 뉴럴 액셀러레이터 덕분에 프롬프트 처리 향상 폭은 더 큽니다.
- Thunderbolt 5(M5 Pro/Max): M5 Pro와 M5 Max는 기본 80Gbps(Thunderbolt 4의 두 배)의 Thunderbolt 5를 지원하여 고속 외장 스토리지와 다중 디스플레이에 유리합니다.
- Apple N1 칩의 Wi-Fi 7과 Bluetooth 6: M5 시스템에는 Wi-Fi 7과 Bluetooth 6.0을 지원하는 새 N1 무선 칩이 들어 있어 원격 추론 클라이언트나 클라우드 모델 API 사용 시 응답성이 좋아집니다.
- 빠르게 성숙하는 MLX 프레임워크: Apple의 MLX 프레임워크는 최적화된 커널로 Llama 3.3, Qwen, Mistral, Gemma를 지원합니다. Ollama는 2026년 3월부터 Apple Silicon용 MLX 백엔드를 제공하고 있으며(프리뷰), 처음에는 일부 모델로 제한되었습니다.
- 전력 효율은 실제입니다: M5 Max는 지속적인 추론 시 약 65–100W로 추정됩니다(Apple 공식 수치가 아닌 추정치이며, Apple은 Mac Studio 본체의 최대 연속 전력을 480W로 표기합니다). 100W로 한 달(720시간) 연속 추론하면 약 72kWh로, 미국 전기요금 기준 약 $8–12입니다. 350W의 RTX 4090은 같은 기간 약 $40–60입니다.
- 조용한 동작: Mac Studio 팬은 일반적인 LLM 부하에서 거의 들리지 않습니다. MacStories는 일상 사용 중 M5 Ultra Mac Studio의 팬 소리를 들을 수 없었다고 보고했습니다. MacBook Pro 팬은 지속적인 추론 시 들립니다.
Apple Silicon M5 비교표
아래 구성은 2026년 8월 25일 발표 당시 Apple 판매 가격 기준입니다. Mac mini, Mac Studio, MacBook Pro는 2026년 9월 22일부터 출하 중이며, Mac Studio M5 Ultra 512GB 구성만 2026년 10월 하순입니다($10,000를 크게 웃돌 전망). 가격: Apple Store 미국 달러 가격. 현재 독립적인 초당 토큰 측정값이 있는 칩은 M5 Ultra뿐이며, 측정과 추정의 구분은 성능 섹션을 참고하세요.
구성 | 칩 | GPU 코어 | 메모리 | 대역폭 | 가격 | 추천 용도 |
|---|---|---|---|---|---|---|
| Mac mini M5 Pro 24GB | M5 Pro | 16 | 24GB 통합 | 307 GB/s | $1,699 | 최저가 M5 Pro, 7B–14B |
| Mac mini M5 Pro 64GB | M5 Pro | 20 | 64GB 통합 | 307 GB/s | $2,699 | 30B 모델, 최저가 64GB |
| Mac Studio M5 Max 36GB | M5 Max | 32 | 36GB 통합 | 460 GB/s | $2,499 | 저가 데스크톱 입문 |
| Mac Studio M5 Max 64GB | M5 Max | 40 | 64GB 통합 | 614 GB/s | $3,499 | 70B Q4, 최고 가성비 |
| Mac Studio M5 Max 128GB | M5 Max | 40 | 128GB 통합 | 614 GB/s | $5,099 | 70B Q5, 파워 유저 |
| Mac Studio M5 Ultra 96GB | M5 Ultra | 64 | 96GB 통합 | 최대 1.2 TB/s | $5,499 | 최대 규모 로컬 모델 |
| Mac Studio M5 Ultra 512GB | M5 Ultra | 80 | 512GB 통합 | 최대 1.2 TB/s | $10,000+ (추정) | 초대형 모델, 10월 하순 출하 |
| MacBook Pro 16" M5 Max 64GB | M5 Max | 32 | 64GB 통합 | 460 GB/s | $3,499 | 휴대용, 70B Q4 |
| MacBook Pro 16" M5 Max 128GB | M5 Max | 40 | 128GB 통합 | 614 GB/s | $4,499 | 휴대용, 70B Q5 |
M5, M5 Pro, M5 Max, M5 Ultra 메모리 대역폭 비교
메모리 대역폭은 Apple Silicon에서 로컬 LLM 생성 속도를 결정하는 사양이자 구매자들이 가장 많이 검색하는 수치입니다. 표는 칩별 공식 수치를 보여 줍니다. M5 Max는 32코어 GPU 버전이 460GB/s, 40코어 GPU 버전이 614GB/s로 두 단계가 있습니다. 수치는 이론상 최대값입니다.
Apple M5 메모리 대역폭은 M5 153.6GB/s, M5 Pro 307GB/s, M5 Max(32코어 GPU) 460GB/s, M5 Max(40코어 GPU) 614GB/s, M5 Ultra 최대 1.2TB/s입니다.
대역폭은 칩이 메모리에서 모델을 읽어 오는 속도입니다. 토큰 하나를 생성할 때 모델 전체를 (거의) 한 번 읽으므로, Mac은 대역폭을 모델 크기로 나눈 값보다 빠르게 생성할 수 없습니다.
- M5 Pro vs M5 Max: M5 Max는 M5 Pro의 1.5배(32코어 GPU, 460GB/s) 또는 2배(40코어 GPU, 614GB/s) 대역폭을 가지므로, 같은 모델에서 그만큼 더 빠르게 생성됩니다.
- M5 Max vs M5 Ultra: M5 Ultra는 M5 Max 두 개를 연결하여 40코어 GPU M5 Max의 614GB/s를 약 1.2TB/s로 두 배 늘립니다. 이전 세대 M3 Ultra의 819GB/s보다 50% 높습니다.
- 용량 vs 대역폭: 메모리가 많다고 칩이 빨라지지는 않습니다. 40코어 GPU M5 Max는 64GB든 128GB든 614GB/s로 동일하며, 추가 메모리는 더 큰 모델이나 더 많은 모델을 불러오게 해 줄 뿐입니다.
칩 | GPU 코어 | 최대 메모리 | 대역폭 | 탑재 제품 |
|---|---|---|---|---|
| M5 | 8–10 | 32GB | 153.6 GB/s | MacBook Air, 14" MacBook Pro |
| M5 Pro | 16–20 | 64GB | 307 GB/s | MacBook Pro, Mac mini |
| M5 Max(32코어 GPU) | 32 | 36GB+ | 460 GB/s | MacBook Pro, Mac Studio |
| M5 Max(40코어 GPU) | 40 | 128GB | 614 GB/s | MacBook Pro, Mac Studio |
| M5 Ultra | 64–80 | 512GB | 1.2 TB/s (1,228.8 GB/s) | Mac Studio |
| M4 Max(참고) | 40 | 128GB | 546 GB/s | 이전 세대 |
| RTX 4090(참고) | 해당 없음 | 24GB VRAM | 1,008 GB/s | 개별 GPU |
대역폭이 초당 토큰이 되는 과정
아래 표는 벤치마크가 아니라 산술입니다. 상한 토큰/초 = 대역폭 ÷ 모델 파일 크기. 실제 생성은 KV 캐시 읽기, 런타임 오버헤드, 열 때문에 이보다 낮게 나옵니다. Mixture-of-Experts 모델은 토큰마다 활성 전문가만 읽기 때문에, 같은 파일 크기의 밀집 모델보다 빠르게 실행될 수 있습니다.
생성 속도의 상한은 메모리 대역폭을 모델 파일 크기로 나눈 값입니다. 예를 들어 614GB/s ÷ 42.5GB(Llama 3.3 70B Q4) ≈ 14토큰/초이며, 잘 최적화된 런타임은 보통 그 60–80%에 도달합니다.
실행하려는 가장 큰 모델을 기준으로 칩을 고른 뒤 이 상한 표를 확인하세요. 상한이 10토큰/초 미만이라면 GPU 코어를 아무리 늘려도 모델이 느리게 느껴집니다.
- 표 읽는 법: 값은 이론상 토큰/초 상한입니다. 현실적인 범위는 0.6–0.8을 곱해 구하세요. 614GB/s M5 Max에서 Llama 3.3 70B Q4는 대략 9–12토큰/초입니다.
- 독립 검증: MacStories는 M5 Ultra Mac Studio에서 Qwen3.8 27B 생성 속도를 48토큰/초(6,091토큰 프롬프트)로 측정했으며, RTX 5090(대역폭 1.79TB/s)은 59토큰/초였습니다. 실제 속도는 코어 수가 아니라 대역폭을 따랐습니다.
- 용량 산정 기준: 모델 파일과 KV 캐시는 통합 메모리의 약 3분의 2에서 4분의 3 안에 들어가야 하므로, 70B Q4 모델(약 42.5GB)에는 64GB Mac이 필요하고 Q5와 Q8에는 128GB가 필요합니다.
모델(Q4_K_M) | 파일 크기 | M5 Pro 307 | M5 Max 460 | M5 Max 614 | M5 Ultra 1.2TB/s |
|---|---|---|---|---|---|
| Llama 3.1 8B | ~4.9GB | ~63 | ~94 | ~125 | ~250 |
| Mistral Small 24B | ~14GB | ~22 | ~33 | ~44 | ~88 |
| Qwen3 32B | ~20GB | ~15 | ~23 | ~31 | ~61 |
| Llama 3.3 70B | ~42.5GB | ~7 | ~11 | ~14 | ~29 |
Mac mini M5 Pro: 로컬 LLM을 위한 새로운 저가 진입점
Apple은 2026년 8월 25일 Mac mini에 처음으로 M5 Pro 칩을 탑재했습니다. 이전에는 M5 Pro가 MacBook Pro에만 있었습니다. 24GB–64GB 통합 메모리에 $1,699–$2,699인 Mac mini M5 Pro는 M5 Pro의 64GB 메모리 상한에 도달하는 가장 저렴한 방법이며 MacBook Pro M5 Pro보다 저렴합니다. Mac Studio는 이제 M5 Max부터 시작합니다. 2026년 9월 22일부터 출하 중입니다.
- CPU: 15코어 또는 18코어 M5 Pro
- GPU: 16코어 또는 20코어 M5 Pro GPU
- 메모리: 기본 24GB, 48GB 또는 64GB LPDDR5X 통합 메모리로 변경 가능
- 메모리 대역폭: 307GB/s(MacBook Pro의 M5 Pro와 동일)
- 저장 장치: 512GB–2TB SSD(변경 가능)
- 포트: Thunderbolt 5(Mac mini 최초)
- 연결: Wi-Fi 7, Bluetooth 6
- 가격: $1,699(15코어 CPU/16코어 GPU, 24GB), $2,699(18코어 CPU/20코어 GPU, 64GB)
- 제공 상태: 2026년 9월 22일부터 출하 중
Mac Studio M5 Max 36GB: 기본 구성
기본 Mac Studio M5 Max는 32코어 GPU와 36GB 통합 메모리로 $2,499부터 시작하며, 더 큰 메모리 옵션은 아래의 40코어 GPU 등급에서 제공됩니다. 2026년 9월 22일부터 출하 중입니다. Mac Studio에는 M5 Pro 등급이 아예 없어졌으며, 이것이 가장 저렴한 Mac Studio입니다.
- CPU: 18코어 M5 Max
- GPU: 32코어 M5 Max GPU
- 메모리: 이 GPU 등급에서는 36GB LPDDR5X 통합 메모리
- 메모리 대역폭: 460GB/s(MacBook Pro의 32코어 M5 Max와 동일)
- 저장 장치: 512GB–8TB SSD(변경 가능)
- 포트: Thunderbolt 5
- 전력: 지속 추론 시 약 65–100W 추정, 팬은 거의 돌지 않음
- 가격: $2,499
- 제공 상태: 2026년 9월 22일부터 출하 중
Mac Studio M5 Max 48–128GB: 70B 로컬 LLM 최고 가성비
40코어 GPU Mac Studio M5 Max는 $3,099(48GB)부터 시작하며 최대 128GB까지 $5,099로 구성할 수 있습니다. '70B 최고 가성비'라는 포지션을 실제로 충족하는 등급이며, 64GB는 $3,499에 614GB/s 전체 대역폭으로 제공됩니다. 2026년 9월 22일부터 출하 중입니다.
- CPU: 18코어 M5 Max
- GPU: 40코어 M5 Max GPU
- 메모리: 기본 48GB, 64GB 또는 128GB LPDDR5X 통합 메모리로 변경 가능
- 메모리 대역폭: 614GB/s(MacBook Pro의 40코어 M5 Max와 동일)
- 저장 장치: 512GB–8TB SSD
- 포트: Thunderbolt 5
- 전력: 지속 추론 시 약 65–100W 추정, 다중 모델 고부하 시 팬이 적당히 동작
- 가격: $3,099(48GB), $3,499(64GB), $5,099(128GB)
- 제공 상태: 2026년 9월 22일부터 출하 중
Mac Studio M5 Ultra: 새로운 최고 성능 등급
Mac Studio M5 Ultra는 M5 Max 위에 새로 생긴 최상위 등급으로, 96GB 구성의 $5,499부터 시작해 512GB까지 확장됩니다. 96–256GB 구성은 2026년 9월 22일부터 출하 중이며, 512GB 구성은 2026년 10월 하순에 출하되고 $10,000를 크게 웃돌 전망입니다. 이전 세대 M3 Ultra의 512GB 상한을 50% 더 높은 대역폭으로 맞춥니다.
- CPU: 30코어 M5 Ultra(36코어로 변경 가능)
- GPU: 기본 64코어, 80코어로 변경 가능
- 메모리: 기본 96GB, 현재 256GB까지, 512GB는 2026년 10월 하순
- 메모리 대역폭: 최대 1.2TB/s(1,228.8GB/s, M3 Ultra의 819GB/s보다 50% 높음)
- 저장 장치: 1TB–16TB SSD
- 포트: Thunderbolt 5
- 가격: $5,499(기본 96GB: 30코어 CPU/64코어 GPU), 512GB는 $10,000를 크게 웃돌 전망
- 제공 상태: 2026년 9월 22일부터 출하 중(96–256GB), 2026년 10월 하순(512GB)
MacBook Pro 16인치 M5 Max: 휴대용 로컬 LLM
MacBook Pro 16인치 M5 Max($3,499–$4,499)는 Mac Studio와 같은 M5 Max 실리콘을 휴대용 폼팩터로 제공합니다. 메모리 대역폭은 각 GPU 등급에서 Mac Studio와 일치합니다. 32코어 GPU는 460GB/s, 40코어 GPU는 614GB/s입니다. 다만 64GB MacBook Pro는 32코어 GPU를, 64GB Mac Studio는 40코어 GPU를 사용한다는 점에 유의하세요. 지속 추론 시의 열 스로틀링이 휴대성의 대가입니다.
- CPU: 18코어 M5 Max(슈퍼 6 + 성능 12코어)
- GPU: 32코어 또는 40코어 M5 Max GPU
- 메모리: 64GB 또는 128GB 통합 메모리
- 디스플레이: 16.2인치 Liquid Retina XDR, 3456×2234
- 메모리 대역폭: 460GB/s(64GB, 32코어 GPU) 또는 614GB/s(128GB, 40코어 GPU)
- 저장 장치: 512GB–8TB SSD
- 배터리: 동영상 재생 시간으로 표기되며, 지속 추론 시에는 훨씬 빨리 소모됩니다
- 무게: 2.14kg
- 포트: Thunderbolt 5 ×3, HDMI 2.1, SD 카드 슬롯, 헤드폰 잭
- 가격: $3,499(64GB, 32코어 GPU) ~ $4,499(128GB, 40코어 GPU)
🏆 추천: 로컬 LLM용으로 어떤 Mac을 살까
사용 사례별로 명확한 추천을 정리했습니다.
- 🏆 💰 최저가 M5 PRO: Mac mini M5 Pro($1,699, 출하 중) • 이유: 최초의 M5 Pro Mac mini. MacBook Pro를 포함해 M5 Pro를 얻는 기존 어떤 방법보다 저렴합니다. 24GB 기본은 7B–14B, 64GB로 구성하면 30B를 다룹니다. • 대상: 예산을 중시하는 첫 Apple Silicon 구매자. • Apple Store에서 구매 →
- 🥇 70B 최고 가성비: Mac Studio M5 Max 64GB($3,499, 출하 중) • 이유: 614GB/s 전체 대역폭으로 Llama 3.3 70B Q4를 추정 약 9–12토큰/초로 실행합니다. 데스크톱 냉각 덕분에 열 스로틀링이 없습니다. • 대상: 휴대성이 필요 없고 70B 워크플로로 표준화하려는 개발자. • Apple Store에서 구매 →
- 🔥 최고 성능: Mac Studio M5 Ultra 96GB($5,499, 출하 중) • 이유: 최상위 등급. 최대 1.2TB/s 대역폭으로 M5 Max의 두 배입니다. 512GB 구성은 2026년 10월 하순에 출하되어 가장 큰 로컬 모델을 다룹니다. • 상태: 첫 독립 측정값이 나왔습니다(MacStories: Qwen3.8 27B에서 48토큰/초, RTX 5090은 59). • Apple Store에서 구매 →
- 💼 최고의 휴대용: MacBook Pro 16인치 M5 Max(64GB·460GB/s $3,499, 128GB·614GB/s $4,499) • 이유: Mac Studio와 같은 M5 Max 실리콘을 Liquid Retina XDR 디스플레이 노트북에 담았습니다. 열 스로틀링으로 지속 속도가 10–15% 낮아지는 점은 감수해야 합니다. • 대안: 휴대성이 필요 없다면 같은 가격의 Mac Studio M5 Max 64GB($3,499)가 614GB/s와 더 나은 지속 냉각을 제공합니다. • Apple Store에서 구매 →
로컬 LLM 성능: 대역폭 기반 추정과 M5 Ultra 독립 측정 결과
현재 독립적인 제3자 측정값이 있는 칩은 M5 Ultra뿐입니다(MacStories, 이 섹션 끝에 표기). M5 Pro와 M5 Max의 아래 범위는 추정치입니다. 각 범위는 대역폭 상한(대역폭 ÷ 모델 파일 크기)의 60–80%이며 커뮤니티 보고와 MacBook Pro 결과로 교차 확인했고, Mac mini나 Mac Studio 본체에서 한 실험실 측정이 아닙니다. 64GB MacBook Pro(460GB/s)와 64GB Mac Studio(614GB/s)가 서로 다르므로 범위는 메모리 대역폭 기준으로 표기합니다. macOS 버전, 런타임 버전, 양자화, 컨텍스트 길이에 따라 ±10–15% 차이가 날 수 있습니다. RTX 4090 참고 수치는 커뮤니티의 대략적인 값입니다.
- ## Llama 3.1 8B(Q4_K_M, 약 4.9GB) • M5 Pro(307GB/s): 38–50토큰/초 • M5 Max(460GB/s): 56–75토큰/초 • M5 Max(614GB/s): 75–100토큰/초 • 참고(RTX 4090): 90–120토큰/초
- ## Mistral Small 24B(Q4_K_M, 약 14GB) • M5 Pro(307GB/s): 13–17토큰/초 • M5 Max(460GB/s): 19–26토큰/초 • M5 Max(614GB/s): 26–34토큰/초
- ## Qwen3 32B(Q4_K_M, 약 20GB) • M5 Pro(307GB/s): 9–12토큰/초 • M5 Max(460GB/s): 14–19토큰/초 • M5 Max(614GB/s): 19–25토큰/초
- ## Llama 3.3 70B(Q4_K_M, 약 42.5GB) • M5 Pro 64GB(307GB/s): 4–6토큰/초 • M5 Max(460GB/s): 6–9토큰/초 • M5 Max(614GB/s): 9–12토큰/초 • M5 Ultra: 상한 약 29토큰/초(70B 독립 측정은 아직 없음) • 참고(RTX 4090): 부분 CPU 오프로드로 6–10토큰/초
- ## Llama 3.3 70B(Q5_K_M, 약 50GB) • M5 Pro 64GB: 여유 부족 • M5 Max 128GB(614GB/s): 7–10토큰/초 • 참고(RTX 4090): 불가능(VRAM 한계)
- ## Llama 3.3 70B(Q8_0, 약 75GB) • M5 Max 128GB(614GB/s): 5–7토큰/초 • RTX 4090: 불가능(멀티 GPU 오프로드 필요)
- ## M5 Ultra 독립 측정 결과(MacStories, 256GB 장비, oMLX) • Qwen3.8 27B, 6,091토큰 프롬프트: M5 Ultra 생성 48토큰/초, 프롬프트 읽기 1,701토큰/초, 첫 토큰까지 4.0초 — RTX 5090은 59토큰/초, 3,031토큰/초, 2.0초 • Qwen3.8 27B 긴 컨텍스트(생성): 64K에서 38.9, 128K에서 32.4, 256K에서 24.3토큰/초 — RTX 5090은 49.6, 40.4, 30.0 • Flash-Next, 짧은 프롬프트: M5 Ultra 108토큰/초, M3 Ultra 70(+54%)
- ## 방법론 M5 Pro와 M5 Max 범위는 대역폭 ÷ 모델 파일 크기의 60–80%로 도출한 뒤, 저희 M5 Pro vs M5 Max 벤치마크 페이지에서 인용한 MLX 대 GGUF 테스트 같은 커뮤니티 결과와 비교했습니다. M5 Ultra 수치는 MacStories가 macOS 27.0에서 oMLX 0.7.0.dev2로 직접 측정한 값이며, 모델 이름도 그쪽 표기입니다. 위에 나열되지 않은 모델의 M5 Ultra 초당 토큰 수치는 검증되지 않은 것으로 취급하세요.
Apple Silicon M5 vs PC 워크스테이션(로컬 LLM)
Apple Silicon과 NVIDIA는 철학이 다릅니다. 솔직한 비교는 다음과 같습니다.
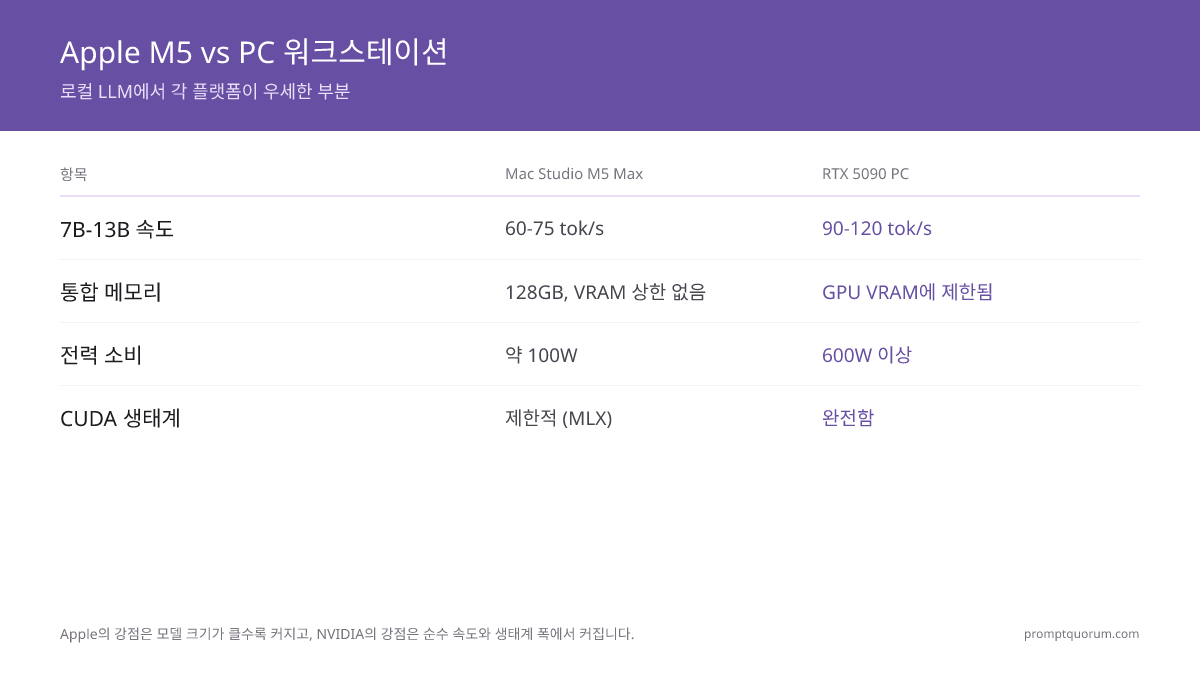
- ## Mac Studio M5 Max/Ultra가 앞서는 점: • 통합 메모리: 최대 128GB(M5 Max) 또는 512GB(M5 Ultra)를 어떤 모델에도 사용 가능, VRAM 상한 없음 • 전력 효율: 동급 PC의 600W+ 대비 약 100W • 조용한 동작: 일반적인 부하에서 팬 소리가 거의 들리지 않음 • macOS 생태계: MLX, Metal, Core ML 통합 • 총소유비용: 3년간 전기요금이 적음 • 32GB 초과 모델: RTX 5090의 VRAM은 최대 32GB
- ## PC 워크스테이션(RTX 4090/5090)이 앞서는 점: • VRAM에 들어가는 모델의 순수 속도: MacStories는 Qwen3.8 27B에서 RTX 5090 59토큰/초, M5 Ultra 48토큰/초를 측정했고 프롬프트 읽기는 약 1.8배 빠름(3,031 대 1,701토큰/초) • CUDA 생태계의 폭: 더 많은 모델, 도구, 연구 코드 • 파인튜닝: PyTorch + CUDA가 MLX보다 우세 • 업그레이드 유연성: GPU 교체, VRAM 추가 • 저가 등급 가격: 저렴한 RTX 4070 Ti($800–1,200)가 소형 모델에서 M5 Pro를 앞섬 • LLM 이외의 AI: Stable Diffusion, 학습, 멀티모달은 일반적으로 NVIDIA가 더 빠름
- ## 솔직한 결론 30B–70B 모델의 순수 로컬 LLM 추론에서는 Mac Studio M5 Max 128GB($5,099)가 $4,500 이상의 PC 빌드와 직접 경쟁하며, Mac Studio M5 Ultra는 256GB나 512GB가 필요한 모델까지 상한을 끌어올립니다. 통합 메모리의 이점은 실제이며 측정 가능합니다. VRAM 24–32GB에 들어가는 모델에서는 RTX 4090 또는 5090 PC가 어떤 Mac보다 빠릅니다. 모델이 작을수록 Apple의 이점은 줄어듭니다. 파인튜닝, 학습, 대규모 Stable Diffusion, 운영 환경 PyTorch에서는 PC + NVIDIA가 앞섭니다. MLX가 개선되고 있지만 격차는 남아 있습니다.
Apple Silicon의 MLX vs Ollama vs llama.cpp
M5에서는 세 가지 주요 추론 엔진이 동작합니다. 어떤 것이 맞을까요?
- ## MLX(Apple 네이티브) • 성능: M5에서 보통 가장 빠른 토큰/초. 네이티브 Metal 최적화와 뉴럴 액셀러레이터 지원. • 모델 지원: 확대 중(Llama, Qwen, Mistral, Gemma 사용 가능) • 설정: Python 중심, 명령줄에 익숙해야 함 • 적합한 사용자: 최대 성능을 원하는 파워 유저 • 단점: Ollama보다 사용하기 불편함
- ## Ollama(크로스 플랫폼) • 성능: GGUF 모델은 llama.cpp의 Metal 백엔드로 실행. MLX 백엔드(Ollama 0.19, 2026년 3월부터 프리뷰)는 일부 모델, 특히 M5 계열 칩에서 가속 • 모델 지원: 가장 큰 모델 라이브러리. 매주 새 모델 추가 • 설정: 명령어 하나로 설치, 바로 동작 • 적합한 사용자: 초보자와 대부분의 개발자. 연동용 REST API • 단점: 모델의 MLX 빌드가 있는 경우 네이티브 MLX보다 느릴 수 있음(차이는 모델과 버전에 따라 다름)
- ## llama.cpp(크로스 플랫폼, 가장 세밀한 제어) • 성능: 최적화하면 Ollama와 대등(Ollama가 GGUF 모델에 사용) • 사용자 지정: 양자화와 추론 파라미터를 가장 세밀하게 제어 • 설정: 컴파일과 명령줄 전문 지식 필요 • 적합한 사용자: 연구자, 맞춤형 양자화 워크플로 • 단점: Ollama보다 학습 곡선이 가파름
- ## 사용자 유형별 추천 • 초보자: Ollama(바로 동작, 문서 풍부) • 개발자: Ollama REST API(애플리케이션에 연동하기 쉬움) • 파워 유저: MLX 직접 사용(최대 성능) • 연구자: llama.cpp(최대 사용자 지정)
macOS 빠른 시작(10단계)
Apple Silicon에서 첫 70B 로컬 LLM을 실행하는 가장 빠른 길입니다.
- 1Mac 구매
Why it matters: 예산/입문은 Mac mini M5 Pro, 데스크톱 성능은 Mac Studio M5 Max 또는 M5 Ultra, 휴대성은 MacBook Pro 16인치 M5 Max. - 2macOS 초기 설정
Why it matters: 이전 Mac에서 옮기려면 마이그레이션 어시스턴트를, 아니면 새로 설치합니다. macOS를 최신으로 유지하세요. Apple은 Metal 성능 개선을 포인트 릴리스로 제공합니다. - 3Homebrew 설치
Why it matters: /bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)" — 이후 모든 설치에 쓰는 패키지 관리자입니다. - 4Ollama 설치
Why it matters: brew install ollama — 명령어 하나로 쉽게 설치합니다. - 5Ollama 서비스 시작
Why it matters: ollama serve(포그라운드에서 실행) 또는 응용 프로그램 폴더의 Ollama.app을 사용합니다. - 6첫 테스트 모델 받기
Why it matters: ollama pull llama3.1:8b — 작은 모델로 설치를 확인합니다(약 4GB 다운로드). - 7기본 추론 테스트
Why it matters: ollama run llama3.1:8b "Explain local LLMs in one sentence" --verbose — eval rate 줄에 초당 토큰 수가 표시됩니다. - 8목표 대형 모델 받기
Why it matters: ollama pull llama3.1:70b-instruct-q4_K_M(약 40GB 다운로드). 빠른 회선에서 20–40분이 걸리며 64GB 이상 Mac이 필요합니다. - 9성능 모니터링
Why it matters: asitop은 Apple Silicon의 리소스 사용량을 보여 줍니다. 두 번째 터미널에서 brew install asitop && asitop을 실행합니다. - 10선택 사항: GUI용 LM Studio 설치
Why it matters: lmstudio.ai에서 다운로드합니다. 개발자가 아니라면 명령줄보다 쉬우며 Apple Silicon용 MLX 엔진을 포함합니다.
Apple Silicon M5에서 Ollama 속도 높이기
Apple Silicon의 대부분의 Ollama 설치는 이미 기본적으로 빠른 경로를 사용하므로, 아래 체크리스트는 특별한 튜닝이 아니라 은근히 속도를 떨어뜨리는 요소를 제거하는 데 초점을 둡니다.
`ollama ps`로 모델이 100% GPU에서 실행되는지 확인하고, 통합 메모리를 확보하고, 컨텍스트 길이를 줄이고, Q4 양자화를 쓰고, flash attention을 켜고, MacBook Pro는 전원에 연결해 받침대 위에 두세요. 생성 속도는 대역폭이 한계이므로 가장 큰 개선은 대역폭에 맞는 모델을 고르는 것입니다.
Ollama는 보통 M5 Mac에서 기본 설정만으로도 이미 빠릅니다. 속도 문제의 대부분은 놓친 설정이 아니라 통합 메모리를 차지하는 다른 작업, 대역폭에 비해 큰 모델, 또는 과열되는 노트북에서 비롯됩니다.
- 먼저 모델을 대역폭에 맞추세요. 토큰/초는 대역폭 ÷ 모델 파일 크기 근처에서 상한이 정해집니다(위 대역폭 섹션 참고). 307GB/s M5 Pro에서 42GB 70B 모델은 어떻게 튜닝해도 약 7토큰/초를 넘기지 못하고, 20GB 32B 모델은 약 15에 이릅니다. 더 작은 모델이나 양자화로 바꾸는 것이 가장 큰 속도 향상입니다.
- 모델이 CPU로 폴백하지 않고 GPU에 완전히 오프로드되었는지 확인하세요. 모델이 로드된 상태에서 `ollama ps`를 실행하면 PROCESSOR 열이 100% GPU로 표시되어야 합니다. CPU와 나뉘어 있다면 설정이 빠진 것이 아니라, macOS가 GPU에 허용한 메모리에 모델이 들어가지 않는다는 뜻인 경우가 많습니다.
- 긴 세션 전에 통합 메모리를 확보하세요. 메모리는 macOS와 모델이 공유합니다. 탭이 많은 브라우저, Docker Desktop, 백그라운드의 Xcode가 Ollama에서 수 GB를 빼앗을 수 있습니다. 큰 모델을 로드하기 전에 종료하고 활성 상태 보기나 `asitop`으로 여유 메모리를 확인하세요. 큰 모델에서는 `sudo sysctl iogpu.wired_limit_mb=<MB>`로 GPU 메모리 한도를 올릴 수 있습니다(재부팅 시 초기화).
- 필요 없다면 컨텍스트 윈도우를 줄이세요. 짧은 대화에서는 Modelfile이나 API 요청에서 `num_ctx`를 작게(32K 대신 4096 등) 설정하면 KV 캐시 메모리 부담이 줄고 생성이 빨라집니다.
- flash attention과 양자화된 KV 캐시를 켜세요. `OLLAMA_FLASH_ATTENTION=1`과 `OLLAMA_KV_CACHE_TYPE=q8_0`은 KV 캐시 메모리를 줄이고 약간의 품질 손실로 긴 컨텍스트를 빠르게 합니다.
- 양자화를 실제 품질 요구에 맞추세요. Q4_K_M은 Q8_0이나 Q5_K_M보다 눈에 띄게 빠르고 품질 손실은 작아 대체로 허용 가능합니다(양자화 가이드 참고). 위 벤치마크보다 느리다면 하드웨어를 의심하기 전에 Q4 변형을 받아 보세요.
- 지속 추론에는 MacBook Pro를 전원에 연결하고 받침대로 높이세요. 얇은 섀시에 열이 쌓여 MacBook Pro는 2–3시간 연속 부하 후 10–15% 스로틀링될 수 있습니다. 공기 흐름을 개선하는 스탠드와 AC 전원 사용이 스로틀링을 늦춥니다. 몇 시간을 넘는 세션에서는 Mac Studio의 냉각이 전체 성능을 유지합니다.
- macOS와 Ollama를 업데이트하세요. Apple은 Metal 성능 개선을 포인트 릴리스로 제공하고, Ollama도 더 빠른 백엔드를 정기적으로 내놓으며 MLX 지원 모델도 늘고 있습니다. 새 M5 실리콘에서 오래된 버전을 쓰면 성능을 놓칩니다.
- 필요하지 않다면 여러 모델을 동시에 실행하지 마세요. 로드된 각 모델은 통합 메모리의 일부를 점유합니다. `OLLAMA_MAX_LOADED_MODELS`로 Ollama가 한 번에 상주시키는 모델 수를 제어할 수 있습니다.
# Check whether a model is fully offloaded to GPU (PROCESSOR column)
ollama ps

# Measure real speed: the "eval rate" line is generation tokens/sec
ollama run llama3.1:8b --verbose

# Faster long-context inference: flash attention + 8-bit KV cache
OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 ollama serve

# Or limit Ollama to one resident model at a time
OLLAMA_MAX_LOADED_MODELS=1 ollama serve

# Smaller context window in a Modelfile: PARAMETER num_ctx 4096
의사결정 매트릭스: 어떤 Mac 구성을 살까
이 매트릭스로 사용 사례에 가장 맞는 구성을 찾으세요. 메모리가 같다면 대역폭이 더 높은 쪽을 고르세요.
- 1. 예산 우선, 작은 모델(7–14B)로 시험: Mac mini M5 Pro 24GB($1,699) — 역대 최저가 M5 Pro
- 2. 저예산 데스크톱에서 30B 모델 실행: Mac mini M5 Pro 64GB($2,699)
- 3. 70B 모델을 여유 있게 실행: Mac Studio M5 Max 64GB($3,499)
- 4. 32K 이상 컨텍스트의 70B Q5 필요: Mac Studio M5 Max 128GB($5,099)
- 5. 가장 큰 로컬 모델을 위해 256GB–512GB 필요: Mac Studio M5 Ultra($5,499–$10,000+)
- 6. 휴대용 로컬 LLM, 열 스로틀링 감수: MacBook Pro 16인치 M5 Max 64GB($3,499)
- 7. 이미 macOS 생태계 사용(Xcode, Final Cut Pro): 어떤 Mac Studio M5 구성이든 가능
- 8. MLX 실험으로 연구/파인튜닝: Mac Studio M5 Max 128GB 또는 M5 Ultra(메모리 여유)
- 9. 최대한의 정숙함과 유휴 동작: Mac Studio(일반 부하에서 팬이 거의 돌지 않음)
- 10. 예산 $4,000 이상, 휴대성 필요: MacBook Pro 16인치 M5 Max 128GB($4,499)
- 11. 대안 검토: PC RTX 4090($3,000+) 또는 AMD Ryzen AI Max+ 미니 PC($1,600–2,000)
로컬 LLM에 Apple Silicon M5가 맞지 않는 경우
Apple Silicon은 훌륭하지만 만능은 아닙니다. 다음 상황에서는 로컬 LLM용으로 Mac을 피하세요.
- CUDA 전용 워크플로가 필요한 경우: 대부분의 LLM 추론은 Apple Silicon에서 동작하지만, torch.cuda 기반 파인튜닝, vLLM CUDA 커널, 독점 CUDA 연구 코드는 MLX에서 실행되지 않습니다. 작업 대부분이 CUDA 의존적이라면 RTX GPU를 선택하세요.
- Stable Diffusion을 많이 쓰는 경우: 확산 모델은 일반적으로 M5에서 RTX 4090보다 느립니다. 이미지 생성이 워크플로의 30% 이상이라면 PC + RTX가 유리합니다.
- 예산이 절대 우선인 경우: $1,500짜리 RTX 4070 Ti PC는 소형 모델 추론 속도에서 Mac mini M5 Pro를 앞섭니다. 예산만 중요하다면 PC가 더 저렴합니다.
- 워크스테이션 업그레이드가 필요한 경우: Mac Studio의 RAM과 저장 장치는 구매 시 고정됩니다. PC는 단계적으로 업그레이드할 수 있습니다. 5년 이상 사용한다면 PC가 장기적으로 더 저렴할 수 있습니다.
- 소형 모델에서 세 자릿수 토큰/초를 원하는 경우: RTX 4090은 Llama 8B에서 90–120토큰/초에 도달합니다. M5 Max는 75–100으로 추정됩니다. 여러 사용자를 서비스하는 고처리량 추론에서는 여전히 NVIDIA가 앞섭니다.
- macOS를 이미 쓰고 있지 않은 경우: 로컬 LLM만을 위해 Windows/Linux에서 생태계를 바꾸는 것은, 다른 이유로도 macOS를 원하는 경우가 아니라면 가치가 없습니다.
- 24시간 운영 환경 추론이 필요한 경우: Mac Studio는 훌륭하지만 단발성 사용에 맞춰 설계되었습니다. SLA가 있는 연속 추론에는 엔터프라이즈 NVIDIA 워크스테이션이 더 안전합니다.
자주 묻는 질문
M5 Pro, M5 Max, M5 Ultra의 메모리 대역폭은 얼마입니까?
M5는 153.6GB/s, M5 Pro는 307GB/s, M5 Max는 460GB/s(32코어 GPU) 또는 614GB/s(40코어 GPU), M5 Ultra는 최대 1.2TB/s(1,228.8GB/s)입니다. 토큰마다 모델 가중치를 메모리에서 한 번씩 읽기 때문에, LLM 생성에서는 GPU 코어 수보다 대역폭이 더 중요합니다.
M5 Mac의 VRAM은 얼마입니까?
별도의 VRAM은 없습니다. M5 Mac은 CPU와 GPU가 공유하는 통합 메모리를 갖습니다. 기본적으로 macOS는 GPU가 전체 RAM의 약 3분의 2에서 4분의 3을 쓰도록 허용하므로, 64GB Mac은 모델에 약 48GB를 줍니다. M5 Pro는 최대 64GB, M5 Max는 최대 128GB, M5 Ultra는 최대 512GB입니다.
MacBook Pro M5에서 Ollama를 더 빠르게 하려면 어떻게 합니까?
대역폭에 맞는 모델을 고르고, `ollama ps`로 100% GPU에서 실행되는지 확인하고, 메모리를 많이 쓰는 백그라운드 앱을 닫고, 긴 컨텍스트가 필요 없다면 `num_ctx`를 낮추고, Q5/Q8 대신 Q4_K_M 양자화를 쓰고, `OLLAMA_FLASH_ATTENTION=1`을 켜고, 2–3시간을 넘는 세션에서는 MacBook Pro를 전원에 연결해 높이세요. 전체 체크리스트는 위 속도 최적화 섹션을 참고하세요.
Mac Studio M5 Max로 Llama 3.3 70B를 실행할 수 있습니까?
예, 64GB 또는 128GB 구성에서 가능합니다. 70B Q4(약 42.5GB)는 64GB가 필요하며 460GB/s 칩에서 추정 약 6–9토큰/초, 614GB/s 칩에서 9–12토큰/초입니다. 70B Q5(약 50GB)는 128GB 구성이 적합하며 추정 약 7–10토큰/초입니다.
로컬 LLM에서 M5 Max는 RTX 4090과 어떻게 비교됩니까?
24GB에 들어가는 소형 모델에서는 M5 Max가 더 느립니다(Llama 8B 기준 추정 75–100 대 90–120토큰/초). 70B 모델은 4090이 담을 수 없어 CPU 오프로드로 약 6–10토큰/초가 나오는 반면, 614GB/s M5 Max는 약 3분의 1의 전력으로 추정 약 9–12토큰/초로 실행합니다.
RAM 64GB로 충분합니까, 128GB가 필요합니까?
단일 70B Q4 모델에는 64GB로 충분합니다. 70B Q5나 Q8, 여러 동시 모델, 긴 컨텍스트, 파인튜닝에는 128GB를 권장합니다. 메모리 용량은 속도를 바꾸지 않습니다. 64GB와 128GB Mac Studio M5 Max 모두 614GB/s입니다.
LLM 용도로 M5 Pro와 M5 Max의 차이는 무엇입니까?
M5 Pro는 16/20코어 GPU, 307GB/s 대역폭, 최대 64GB입니다. M5 Max는 32/40코어 GPU, 460/614GB/s, 최대 128GB입니다. 생성 속도가 대역폭에 비례하므로 같은 모델에서 M5 Max는 M5 Pro보다 약 1.5배(460GB/s)에서 2배(614GB/s) 빠릅니다. M5 Ultra(Mac Studio 전용)는 더 나아가 최대 80코어 GPU, 최대 1.2TB/s, 최대 512GB입니다.
Mac Studio M5 Ultra의 로컬 LLM 속도는 얼마나 됩니까?
MacStories는 256GB M5 Ultra에서 Qwen3.8 27B 생성을 48토큰/초(RTX 5090은 59), 더 작은 Flash-Next 모델에서 108토큰/초로 측정했으며, 이는 M3 Ultra보다 약 54% 빠릅니다. 70B Q4 모델의 대역폭 상한은 약 29토큰/초이며, 70B 독립 결과는 아직 공개되지 않았습니다.
지속적인 LLM 추론 시 MacBook Pro가 열 스로틀링됩니까?
예, 2–3시간 연속 추론 후 MacBook Pro는 성능이 10–15% 떨어질 수 있습니다(추정). Mac Studio는 24시간 내내 전체 성능을 유지합니다.
Apple Silicon에서 Stable Diffusion을 실행할 수 있습니까?
예, Stable Diffusion XL은 M5에서 이미지당 약 8–12초에 실행됩니다(RTX 4070의 약 3초보다 느림). MLX가 기본 지원합니다.
Mac에서 MLX가 Ollama보다 빠릅니까?
MLX 빌드가 있는 모델에서는 대체로 그렇습니다. MLX는 llama.cpp의 GGUF 모델보다 보통 빠르며, 모델과 버전에 따라 약 10%에서 2배까지 차이가 보고됩니다. Ollama가 2026년 3월 추가한 MLX 백엔드는 지원 모델에서 그 격차를 줄입니다. 순수 속도가 아니라 워크플로에 따라 선택하세요.
LLM 추론 시 Mac Studio M5 Max의 전력 소비는 얼마입니까?
LLM 부하에서 M5 Max는 지속적으로 약 65–100W로 추정됩니다. Apple은 Mac Studio 본체의 최대 연속 전력을 480W로 표기하지만, 추론만으로는 여기에 이르지 않습니다. 100W로 한 달(720시간) 24시간 추론하면 약 72kWh로 미국 전기요금 기준 약 $8–12이며, RTX 4090 구성은 약 $40–60입니다.
Mac mini에도 이제 M5 Pro가 있습니까?
예. Mac mini M5 Pro는 $1,699부터(24GB, 최대 64GB), 대역폭 307GB/s, Thunderbolt 5로 2026년 9월 22일부터 출하 중입니다. 역대 최저가 M5 Pro Mac입니다.
Mac Studio에 여전히 M5 Pro 구성이 있습니까?
아니요. 2026년 8월 25일 업데이트 이후 Mac Studio는 M5 Max($2,499)부터 시작합니다. M5 Pro 칩의 진입점은 이제 Mac mini입니다.
Mac Studio M5 Ultra는 무엇이며 메모리는 얼마나 지원합니까?
M5 Ultra는 M5 Max 위에 있는 Mac Studio 전용 칩으로 $5,499(96GB)부터 시작합니다. 현재 256GB, 2026년 10월 하순에 512GB($10,000를 크게 웃돌 전망)까지 확장되며 대역폭은 최대 1.2TB/s입니다.
Apple Silicon에서 모델을 파인튜닝할 수 있습니까?
예, LoRA 파인튜닝은 잘 동작합니다. 전체 가중치 파인튜닝은 데스크톱 GPU보다 느립니다(아직 분산 학습 지원 없음).
Apple Silicon은 추론에는 좋지만 학습에는 나쁩니까?
부분적으로 그렇습니다. 추론은 훌륭합니다. 학습/파인튜닝도 가능하지만 NVIDIA보다 느립니다. MLX 프레임워크는 빠르게 개선되고 있습니다.
Neural Engine은 LLM에 어떤 도움이 됩니까?
토큰 생성은 Neural Engine이 아니라 메모리 대역폭이 한계입니다. M5 계열 칩에서는 각 GPU 코어 안의 뉴럴 액셀러레이터가 이를 활용하는 런타임(MLX, Ollama의 MLX 백엔드 등)에서 프롬프트 처리(첫 토큰까지의 시간)를 빠르게 합니다.
M5 Max 128GB에서 여러 모델을 동시에 실행할 수 있습니까?
예. 128GB로 32B 모델 두 개, 또는 70B와 14B를 무리 없는 속도로 동시에 실행할 수 있습니다.
Mac에서 로컬 LLM을 설정하는 데 보통 얼마나 걸립니까?
초기 상태의 Mac에서 Ollama로 첫 70B 모델을 실행하기까지 15–30분입니다(빠른 인터넷에서 20–40분의 모델 다운로드 포함).
Apple Silicon은 최신 오픈 웨이트 모델과 호환됩니까?
Llama, Qwen, Mistral, Gemma, DeepSeek 등 대부분의 오픈 웨이트 계열은 출시 후 며칠 안에 llama.cpp(GGUF) 또는 MLX로 실행됩니다. 현재 목록은 Hugging Face의 MLX 커뮤니티와 Ollama 라이브러리를 확인하세요.
로컬 LLM용으로 Mac mini M6와 M5 Pro 중 무엇을 사야 합니까?
M6는 입문형 Mac mini($899, 16–32GB, 약 153–170GB/s)로 소형 모델에 적합합니다. M5 Pro($1,699, 최대 64GB, 307GB/s)는 대역폭과 메모리가 약 두 배이므로 로컬 LLM용으로는 이쪽입니다.
리퍼비시 Mac Studio도 고려할 만합니까?
예. Apple은 1년 보증이 있는 리퍼비시 Mac을 판매하며, 보통 새 제품 가격보다 저렴합니다.
M5 Max는 64GB와 128GB 중 어느 쪽이 나은가요?
단일 70B Q4 모델과 32B급 모델에는 64GB, 70B Q5/Q8, 긴 컨텍스트, 여러 모델 동시 실행에는 128GB를 선택하세요. GPU 등급도 확인하세요. MacBook Pro에서는 64GB가 460GB/s 칩, 128GB가 614GB/s 칩과 함께 제공됩니다.