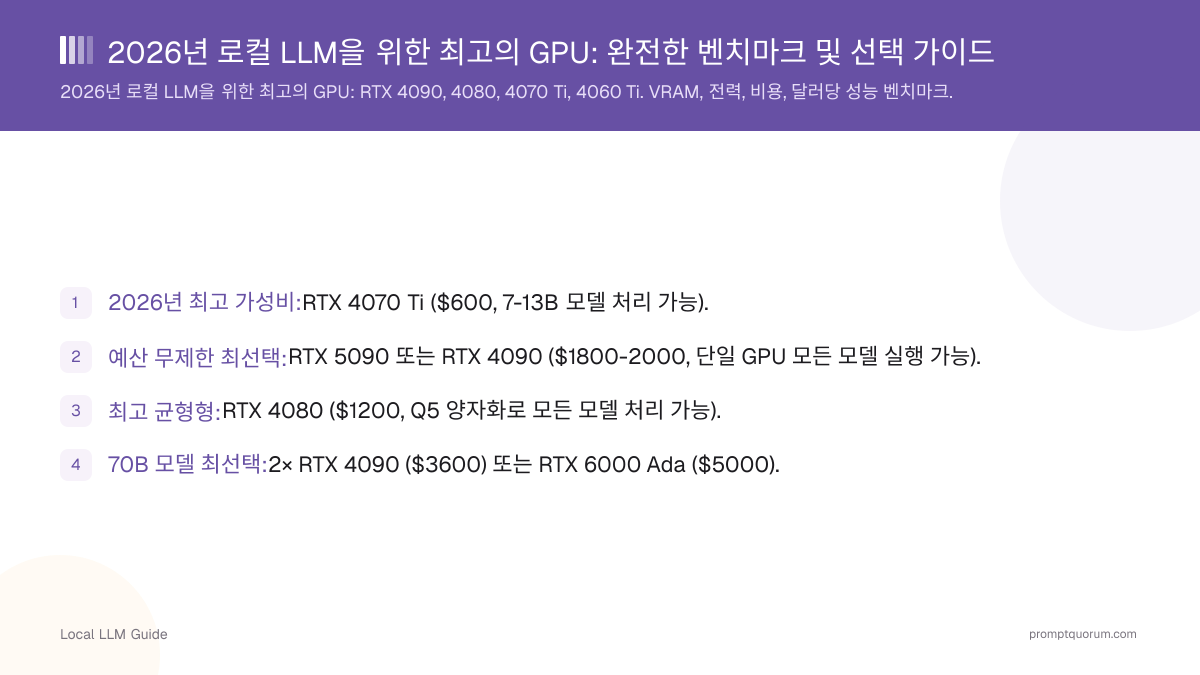
Key Takeaways
- 2026년 최고 가성비: RTX 4070 Ti ($600, 7-13B 모델 처리 가능).
- 예산 무제한 최선택: RTX 5090 또는 RTX 4090 ($1800-2000, 단일 GPU 모든 모델 실행 가능).
- 최고 균형형: RTX 4080 ($1200, Q5 양자화로 모든 모델 처리 가능).
- 70B 모델 최선택: 2× RTX 4090 ($3600) 또는 RTX 6000 Ada ($5000).
- NVIDIA가 압도적입니다. AMD와 Intel은 크게 뒤처져 있습니다.
로컬 LLM에 가장 적합한 GPU는 예산과 원하는 속도에 따라 다릅니다: 예산이 무제한이라면 RTX 4090이 최선의 선택이고, RTX 4070 Ti는 최고의 가성비를 제공하며, RTX 4080은 균형 잡힌 중간 옵션이고, 전반적으로 NVIDIA가 시장을 주도하고 있습니다.
단 하나의 최고의 GPU는 없습니다 -- 얼마를 쓸 수 있는지에 달려 있습니다. 예산이 문제가 되지 않는다면 최대 속도와 VRAM을 위해 RTX 4090을 선택하세요. 가성비를 가장 원한다면 RTX 4070 Ti가 딱 맞는 지점입니다. 그 중간을 원한다면 RTX 4080이 가격과 성능의 균형을 맞춰줍니다. 거의 모든 로컬 LLM 소프트웨어가 NVIDIA 카드에 맞춰 먼저 개발되고 테스트되므로, NVIDIA 카드가 안전한 기본 선택입니다.
가격 및 성능별 GPU 등급 비교
등급 | GPU | VRAM | 속도 (7B) | 가격 |
|---|---|---|---|---|
| 보급형 | RTX 4070 Ti | 12 GB | 80 tok/초 | $600-700 |
| 보급-중급형 | RTX 5070 | 12 GB | 85 tok/초 | $550 |
| 중급형 | RTX 4080 | 16 GB | 120 tok/초 | $1200 |
| 프리미엄 | RTX 4090 | 24 GB | 150 tok/초 | $1800 |
| 프리미엄 | RTX 5090 | 32 GB | 160 tok/초 | $1999 |

보급형 ($400-700)
RTX 4070 Ti (추천): $600, 12 GB VRAM, 80 tok/초. 개인 사용에 최고의 가성비.
RTX 5070 (신형, 2026년 초): $550, 12 GB. RTX 4070 Ti 대비 약간의 속도 향상.
RTX 4070 (구형): $400, 12 GB. 약간 느림. 새 시스템 구축에는 비추천.
중급형 ($800-1500)
RTX 4080 ($1200): 16 GB VRAM, 120 tok/초. 7-13B 모든 모델에 적합합니다.
RTX 5080 (신형, 2026년 초): $1199, 16 GB. RTX 4080 대비 약 15% 빠릅니다.
RTX 4080 Super: 사실상 RTX 4080과 동일하며 가격도 같습니다.
고급형 ($1600+)
RTX 4090 ($1800): 24 GB VRAM, 150 tok/초. 가장 빠른 소비자용 GPU. 단일 GPU로 모든 모델 실행 가능합니다.
RTX 5090 ($1999): 32 GB VRAM, 160 tok/초. 최신 플래그십. RTX 4090 대비 속도 향상은 미미합니다.
RTX 6000 Ada ($5000): 서버 GPU, 48 GB. 프로덕션 배포용입니다.
내 GPU에 맞는 로컬 LLM 모델
GPU 등급이 실행 가능한 모델 크기를 결정합니다 — 그 반대가 아닙니다. 아래 표는 각 GPU의 VRAM을 Q4_K_M에서 편안하게 실행되는 가장 큰 모델과 매칭한 것으로, 다른 GPU 가이드에서 참조하는 것과 동일한 모델 계열(Qwen3, Gemma 4, DeepSeek, Llama)을 사용합니다.
GPU (VRAM) | 최적 모델 | 양자화 | 속도 | 참고 |
|---|---|---|---|---|
| RTX 4070 Ti / RTX 5070 (12 GB) | Qwen3 14B (dense) | Q4_K_M | ~35-45 tok/초 | 보급형 RTX 3060과 동일한 12 GB 등급이지만 3-4배 더 빠릅니다. Qwen3 8B는 60+ tok/초로 실행됩니다. |
| RTX 4080 / RTX 5080 (16 GB) | gpt-oss:20b 또는 Gemma 4 E12B | Q4_K_M | ~55-65 tok/초 | 16 GB는 gpt-oss:20b(총 21B/활성 3.6B MoE)의 최소 요구 사양이며, 더 긴 컨텍스트 창을 위한 여유가 있습니다. |
| RTX 4090 / RX 7900 XTX (24 GB) | Q5의 dense 32-34B, 또는 1.78-bit의 Llama 4 Scout | Q5_K_M / IQ1_S | ~90-100 tok/초 (34B) / ~20 tok/초 (Scout) | Llama 4 Scout(활성 17B/총 109B MoE)는 Q4에서 ~55 GB가 필요합니다 — 2-bit 미만의 공격적인 양자화로만 24 GB에 들어갑니다. |
| RTX 5090 (32 GB) | Q8의 dense 34B, 또는 ~2-bit의 Llama 4 Scout | Q8_0 / IQ2_XS | ~130-150 tok/초 (34B) | RTX 4090 대비 추가된 8 GB는 주로 동일한 모델 크기에서 더 높은 품질의 양자화를 가능하게 할 뿐, 더 큰 모델 클래스로의 도약을 의미하지 않습니다. |
| 2× RTX 4090 (합산 48 GB) | Llama 3.3 70B | Q5_K_M | ~100 tok/초 | 70B급 모델의 실질적인 진입점입니다. 단일 RTX 6000 Ada(48 GB)가 전문가용 대안입니다. |

AMD 및 Intel GPU: 2026년 8월 현황
AMD (ROCm): 개선되고 있으며 가격 경쟁력도 있습니다 — RX 7900 XTX는 RTX 4080과 대등합니다. ROCm 드라이버 지원은 CUDA보다 더 많은 설정 작업이 필요합니다(2026년 8월 기준, ROCm 6.x) — 구매 전 최신 호환성 목록을 확인하세요. AMD 생태계를 선호하는 분께 좋은 선택입니다.
RX 7900 XTX(24 GB)에 최적인 모델: RTX 4090과 동일한 등급 — Q5의 dense 32-34B 모델, 또는 1.78-bit의 공격적인 양자화를 적용한 Llama 4 Scout — 이지만 CUDA 대신 ROCm을 통해 실행되며, 동일한 VRAM 등급에서 일반적으로 10-20% 더 느립니다.
Intel Arc A770: 실용적인 LLM 사용에는 너무 느립니다. 추천하지 않습니다.
권장 사항: 안정성과 생태계 성숙도를 위해 NVIDIA를 선택하십시오.
역사적 비교: GPU 성능이 얼마나 성장했는가
맥락: GPU 성능이 얼마나 빠르게 발전했는지:
GPU | VRAM | 속도 (7B) | 가격 |
|---|---|---|---|
| RTX 2080 (2019) | 8 GB | 10 tok/초 | $700 |
| RTX 3090 (2020) | 24 GB | 25 tok/초 | $1500 |
| RTX 4070 (2022) | 12 GB | 60 tok/초 | $600 |
| RTX 4090 (2022) | 24 GB | 150 tok/초 | $1800 |
| RTX 5090 (2026) | 32 GB | 160 tok/초 | $2000 |
흔한 GPU 선택 실수
- 2026년에 RTX 3090 구매하기. 구형이며 느립니다. 어떤 가격에도 가치가 없습니다. 현세대(40/50 시리즈)만 구매하십시오.
- VRAM이 많을수록 빠르다고 생각하기. VRAM 용량은 속도에 영향을 주지 않습니다. RTX 4080 (16 GB)이 RTX 3090 (24 GB)보다 빠릅니다.
- 개인 사용에 RTX 6000이 필요하다고 생각하기. 엄청난 과잉 사양입니다. RTX 4090이 개인 모델을 손쉽게 처리합니다.
- 2년 이상의 미래를 대비해 구매하기. GPU 기술은 빠르게 발전합니다. 현재 필요에 맞게 구매하고 2년 후에 업그레이드하십시오.
자주 묻는 질문
로컬 LLM에 얼마나 많은 VRAM이 필요합니까?
12 GB VRAM은 7B 및 13B 모델을 편안하게 처리합니다(Q5 양자화). 16 GB는 최대 20B 모델을 처리합니다. 24 GB (RTX 4090)는 Q5에서 34B를 포함한 모든 단일 GPU 모델을 실행합니다. 70B 모델의 경우 2× 24 GB GPU가 필요하거나 Q2–Q3 공격적 양자화가 필요하지만 품질이 심각하게 저하됩니다.
RTX 4090은 로컬 LLM에 가격 대비 가치가 있습니까?
네, 13B–34B 모델을 정기적으로 실행하거나 최대 추론 속도가 필요한 경우에 가치가 있습니다. $1,800에 RTX 4090은 24 GB VRAM과 7B 모델에서 150 tok/초를 제공합니다. 7B 모델만 실행한다면 $600의 RTX 4070 Ti가 80 tok/초를 제공합니다 — 비용의 33%로 성능의 80%를 얻을 수 있습니다.
로컬 LLM에 AMD GPU를 구매해야 합니까?
AMD는 2026년에도 로컬 LLM에 실용적인 선택지입니다. 특히 AMD 생태계를 선호하는 경우에는 더욱 그렇습니다. 대부분의 LLM 프레임워크(vLLM, llama.cpp, Ollama)는 먼저 CUDA에 최적화되어 있으며, ROCm 드라이버 지원은 CUDA보다 더 많은 설정 작업이 필요합니다(2026년 8월 기준, ROCm 6.x) — 구매 전 최신 호환성 목록을 확인하세요. AMD의 RX 7900 XTX는 가격 면에서 경쟁력이 있습니다.
로컬에서 70B 모델을 실행하기에 가장 적합한 GPU는 무엇입니까?
2× RTX 4090 GPU ($3,600 총 비용, 48 GB 합산 VRAM)가 최고의 소비자 옵션입니다. 이것은 Llama 3.3 70B를 Q5 양자화로 약 100 tok/초에 실행합니다. 단일 RTX 6000 Ada ($5,000, 48 GB)가 전문적인 대안입니다. 단일 소비자 GPU에서 70B 실행은 피하십시오 — 필요한 Q2 양자화는 품질을 심각하게 저하시킵니다.
VRAM 크기가 로컬 LLM 성능에 어떤 영향을 미칩니까?
VRAM 크기는 실행할 수 있는 모델 크기를 결정합니다 — VRAM이 많을수록 더 큰 모델을 실행할 수 있습니다. VRAM 크기는 메모리에 맞는 모델의 추론 속도에는 직접적인 영향을 미치지 않습니다. RTX 4080 (16 GB, 120 tok/초)은 VRAM이 적음에도 불구하고 RTX 3090 (24 GB, 25 tok/초)보다 빠릅니다. 이는 메모리 대역폭과 컴퓨트 아키텍처가 더 중요하기 때문입니다.
로컬 LLM에 새 GPU 세대가 필요합니까?
네 — RTX 40 시리즈 이상(2026년에는 50 시리즈)을 구매하십시오. RTX 30 시리즈(3090, 3080)는 현저히 느립니다. 오늘 같은 가격대에서 3090은 25 tok/초인 반면 4090은 150 tok/초입니다. RTX 2080 (8 GB)은 3B 모델 이상에는 실용적이지 않습니다. 새 시스템 구축에는 현세대 하드웨어만 권장합니다.
2026년 로컬 LLM용 32 GB VRAM을 탑재한 GPU는 무엇입니까?
RTX 5090(32 GB, 약 $1,999)은 현재 32 GB VRAM을 탑재한 유일한 주류 소비자용 GPU입니다. 24 GB RTX 4090 대비 추가된 8 GB는 주로 동일한 모델 크기에서 더 높은 품질의 양자화(34B dense 모델에서 Q5 대신 Q8)를 가능하게 할 뿐, 더 큰 모델 클래스로의 접근을 의미하지 않습니다. Llama 4 Scout(활성 17B/총 109B MoE)는 32 GB에 들어가려면 여전히 ~2-bit의 공격적인 양자화가 필요합니다. 비압축 70B급 모델에는 여전히 총 48 GB(2× RTX 4090 또는 단일 RTX 6000 Ada)가 필요합니다.
AMD RX 7900 XTX는 로컬 LLM 추론에 적합합니까?
네, RTX 4090과 동일한 모델 크기에 적합합니다 — 24 GB VRAM은 Q5의 dense 32-34B 모델과 1.78-bit의 공격적인 양자화를 적용한 Llama 4 Scout를 수용합니다. 트레이드오프는 소프트웨어 측면에 있습니다: ROCm은 CUDA보다 더 많은 드라이버 및 프레임워크 설정이 필요하며(구매 전 최신 llama.cpp/Ollama/vLLM 호환성 목록을 확인하십시오), 추론 처리량은 동일한 VRAM 등급에서 일반적으로 CUDA보다 10-20% 뒤처집니다.
출처
- NVIDIA GPU 사양 -- nvidia.com/en-us/geforce
- TechPowerUp GPU 데이터베이스 -- techpowerup.com/gpu-specs
- LLM 성능 벤치마크 -- github.com/vllm-project/vllm/tree/main/benchmarks